登录社区云,与社区用户共同成长
邀请您加入社区
【代码】mmlspark.lightgbm.LightGBMClassifier参数明。
为了提高训练效率,在fast AT 中采用快速梯度符号法FGSM,只计算一次梯度,但是鲁棒性不能令人满意。一个原因是可能来自初始化方式,现有的fast AT通常使用随机样本的不可知初始化,这虽然促进了运行效率,但是阻碍了进一步改进鲁棒性。在本文中以图像分类为重点,提出了一种基于样本的对抗性初始化来增强基于FGSM的快速AT,称为FGSM-SDI,依赖于样本的初始化由生成网络计算,生成网络不仅基于良
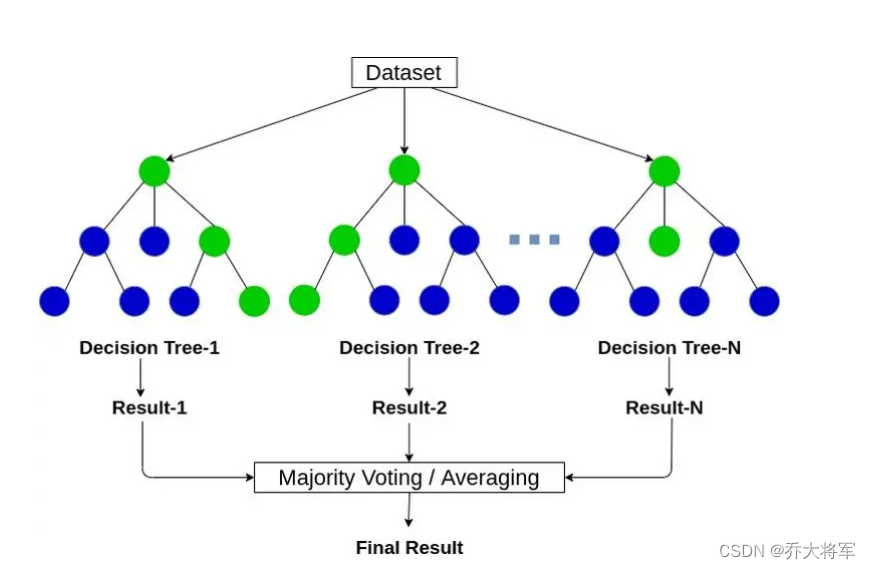
集成学习(Ensemble Learning)是一种通过结合多个模型的预测结果来提高整体预测性能的技术。相比于单个模型,集成学习通过多个基学习器的“集体智慧”来增强模型的泛化能力,通常能够提高模型的稳定性和准确性。Bagging:通过并行训练多个模型并对其结果进行平均或投票来减少方差Boosting:通过按顺序训练多个模型,每个模型都试图纠正前一个模型的错误,从而减少偏差Stacking:通过训练
这篇文章是围绕Retinex理论进行的,结构上:在检测器的基础上增加了一条分支作为主要的功能模块;同时将零样本建立在一个较大的伪标注生成网络之上,感觉建立在这种笨拙的伪标注生成网络上的零样本学习多少有点自欺欺人了。其实总体感觉没什么亮点。。。但是或许就像作者自己说的他们是第一批专注于ZSDA(zero-shot day-night domain adaptation)的人,对一些参照组的设置和损失
集成算法(Enseamable learning)集成算法一般考虑树模型,KNN就不太适合目的:让机器学习效果更好,单个不好,一起干,三个诸葛亮Bagging:训练多个分类器取平均,,其中表示分类器的个数,表示单个训练器。Boosting:从弱学习器开始加强,通过加权的方式来进行训练公式:可以看出这种方法的最终结果是在上个结果的基础上加上一个补充值(个人理解)表示在上个结果加上此次补充后结果的损失
Boosting(提升)是一种集成学习方法,通过组合多个弱学习器来构建一个强学习器。与Bagging不同,Boosting采用了序列化的方式构建模型,每个弱学习器都是在前一个弱学习器的基础上进行训练,通过逐步调整样本的权重或难易程度来提高模型的预测性能。简而言之:没新加入一个弱学习器,整体能力就会得到提升代表算法有:Adaboost,GBDT,XGBoost,LightGBM初始化样本权重:对于包
XGBoost算法案例实战——信用评分模型