
Boosting Object Detection with Zero-Shot Day-Night Domain Adaptation(零镜头昼夜自适应目标检测)
以往:图像增强或基于低亮度的图像数据集进行检测
本文:不需要真实低亮度的数据,将光照充足的场景推广到低亮度的场景
- 设计了一个带有光照不变性强化策略的反射representation学习模块,以学习基于Retinex的光照不变性;
- 交换-再分解-趋同程序通过执行两次连续的图像分解并且引入了二次分解一致性损失函数,从而改进了普通的Retinex图像再分解进程。
Intro
一般目标检测难以拓展到低亮度图像,因此常用低亮度方法是图像增强或基于低亮度的图像数据集进行微调,然而对成对的低光和高光图像的大量需求和低亮度图像的标注很少。
[27] Attila Lengyel, Sourav Garg, Michael Milford, and Jan C van Gemert. Zero-shot day-night domain adaptation with a physics prior. In ICCV, 2021. 2, 3, 5, 6, 7
[40] Rundong Luo, Wenjing Wang, Wenhan Yang, and Jiaying Liu. Similarity min-max: Zero-shot day-night domain adaptation. In ICCV, 2023. 2, 3, 5, 6
基于这两篇论文的思想,作者提出这样一种零样本的昼夜自适应模式,如下图
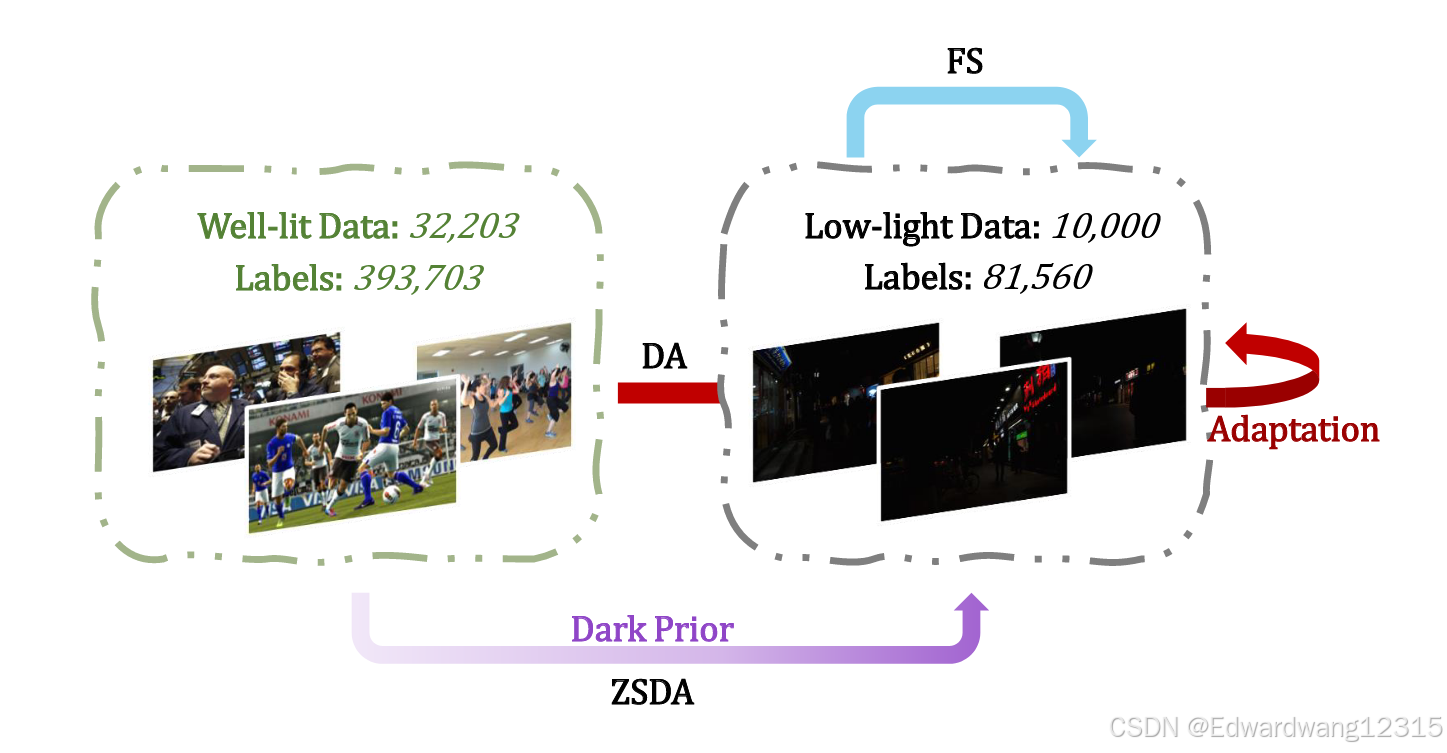
图中的检测器只用正常光照的图像训练,他将低光场景视为正常亮度下目标检测的泛化目标:照明变化导致的识别差别与干扰。
本文先利用物理启发的低亮度图像生成通道生成暗图并且与原图搭配组队;然后把暗图分解为范围内不变信息与特定信息(即反射率和照明条件),其中只保留了反射率信息作为检测器学习对象,作者说这种思想来源于low-level的Retinex理论。
对反射representation的学习模块
作者在YOLOv3和DSFD框架上建立了DAI-Net,并提出了一种对反射representation的学习模块。
[29] Jian Li, Yabiao Wang, Changan Wang, Ying Tai, Jianjun Qian, Jian Yang, Chengjie Wang, Jilin Li, and Feiyue Huang. Dsfd: dual shot face detector. In CVPR, 2019. 2, 5, 6, 7, 8, 1
[54] Joseph Redmon and Ali Farhadi. Yolov3: An incremental improvement. arXiv preprint arXiv:1804.02767, 2018. 2, 5
其中这个学习模块从成对的靓图与暗图中分解出不因光照变化的反射信息:先使用预训练的Retinex分解网络生成伪标注值,学习模块再利用这种标注值进行优化,作者在这里设计了一个针对光照不变性的强化策略;
图像分解的改进程序
设计了一个交换-再分解-趋同程序来改进图像分解过程:对亮图暗图的反射信息分解后,交换亮图的反射信息重建一对新的图,然后再分解产生新的一组反射信息。作者引入了二次分解的一致性损失函数,以促进反射信息提取的准确性。
与本文思想相似的几篇文章
[27] Attila Lengyel, Sourav Garg, Michael Milford, and Jan C van Gemert. Zero-shot day-night domain adaptation with a physics prior. In ICCV, 2021. 2, 3, 5, 6, 7
[40] Rundong Luo, Wenjing Wang, Wenhan Yang, and Jiaying Liu. Similarity min-max: Zero-shot day-night domain adaptation. In ICCV, 2023. 2, 3, 5, 6
[65] Wenjing Wang, Wenhan Yang, and Jiaying Liu. Hla-face: Joint high-low adaptation for low light face detection. In CVPR, 2021. 1, 3, 5, 6
Method
基于Retinex学习反射representation
基于Retinex理论,图像可以被分解为反射矩阵和光照矩阵,而且满足,同时这个理论揭示了图像的可视度受光照矩阵的影响但是反射矩阵是独立的。所以设计了模块学习反射representation。
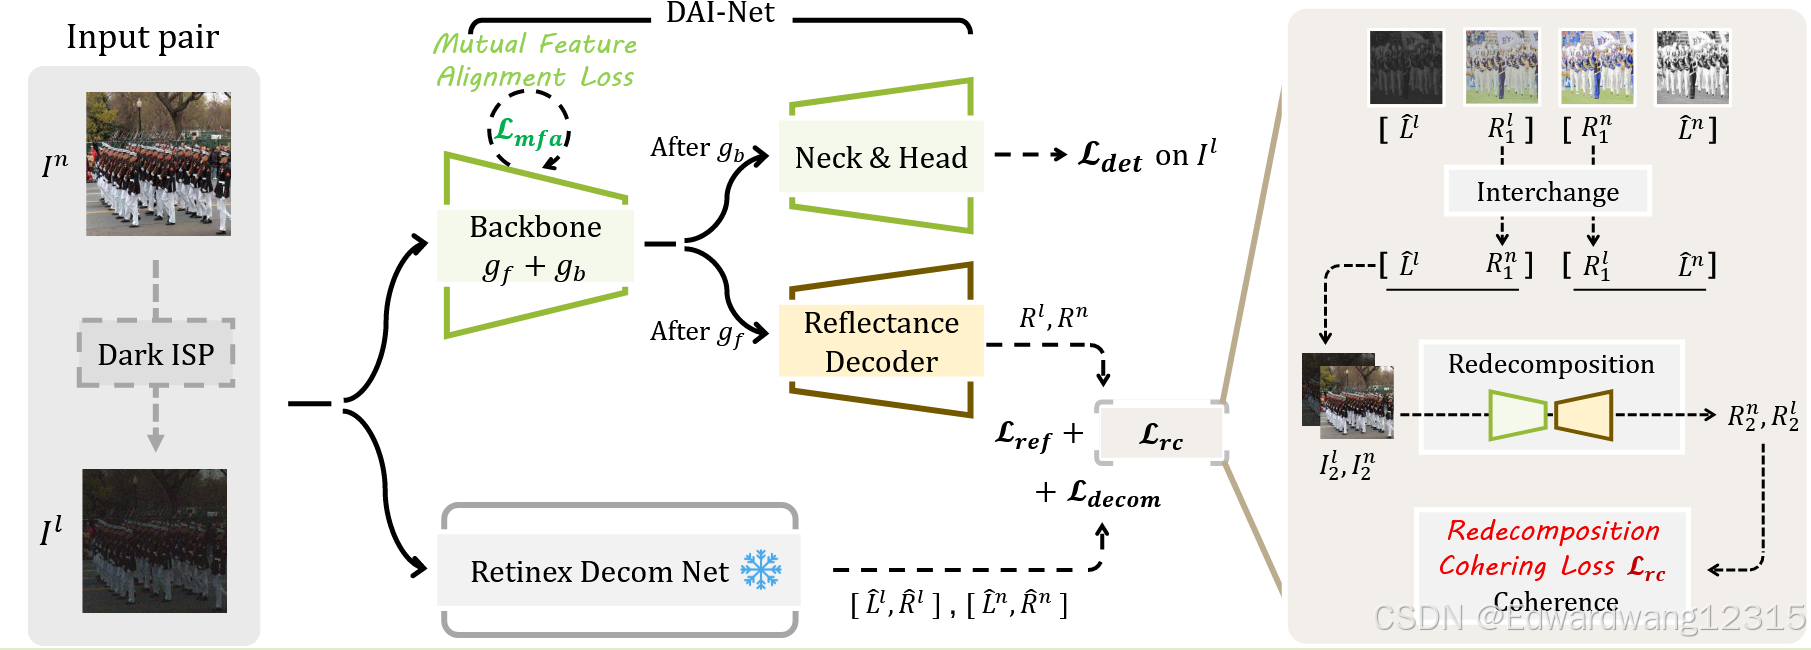
图中绿色框为检测器整体——backbone&neck&head,在第2个卷积层后将low-level特征引入到分解器中以生成亮暗条件下的反射图。
疑问:这里用Retinex分解网络作为监督学习的对照组,为什么不直接把他的网络模拟到解码器中?
Lmfa 用KL散度来衡量Fl和Fn的分布一致性; Lrc 表示经过交换-再分解-趋同前后的反射图偏差; Lref 表示分解器和分解网络输出偏差;
Lrecon 表示重组的I2和原I1的损失;Lir 表示不同光照下的反射图数据波动;Lsmooth 表示光照图计算损失;Ldecom 为Lrecon、Lir与Lsmooth的线性表示。
最终将这五个损失函数线性叠加表示整个过程的损失。
Experiment
低亮度人脸识别
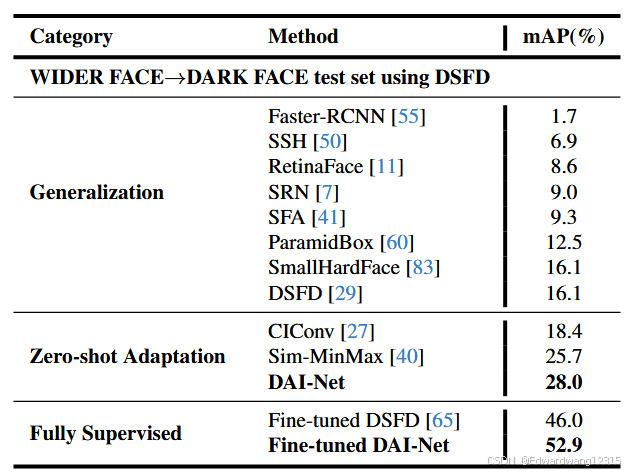
这里的比对组设置比较有趣,依次证明了:主检测器选择的是人脸识别最优的DSFD,则在正常亮度下本方法等于DSFD;
低亮度下的自适应模块选择的是最好的ZSDA;全监督下本网络结构较裸DSFD有很大提升。
一般性检测比较
在WIDER FACE→DARKFACE下比较了多种常用的人脸识别方法,证明DSFD泛化效果最优。
低亮度目标的零样本方法比较
在WIDER FACE→DARKFACE下,把不同的ZSDA方法搭配DSFD的表现,与本方法搭配DSFD的表现进行比较。
全监督下的比较
在DarkFace数据集上进行有监督调优,证明了本方法与模型原型相比,展现出了低亮度环境自适应的独到之处。
低亮度目标检测
在YOLO基础检测器上搭配不同的暗域检测方法进行比较。
分类任务

消融实验
基础结构
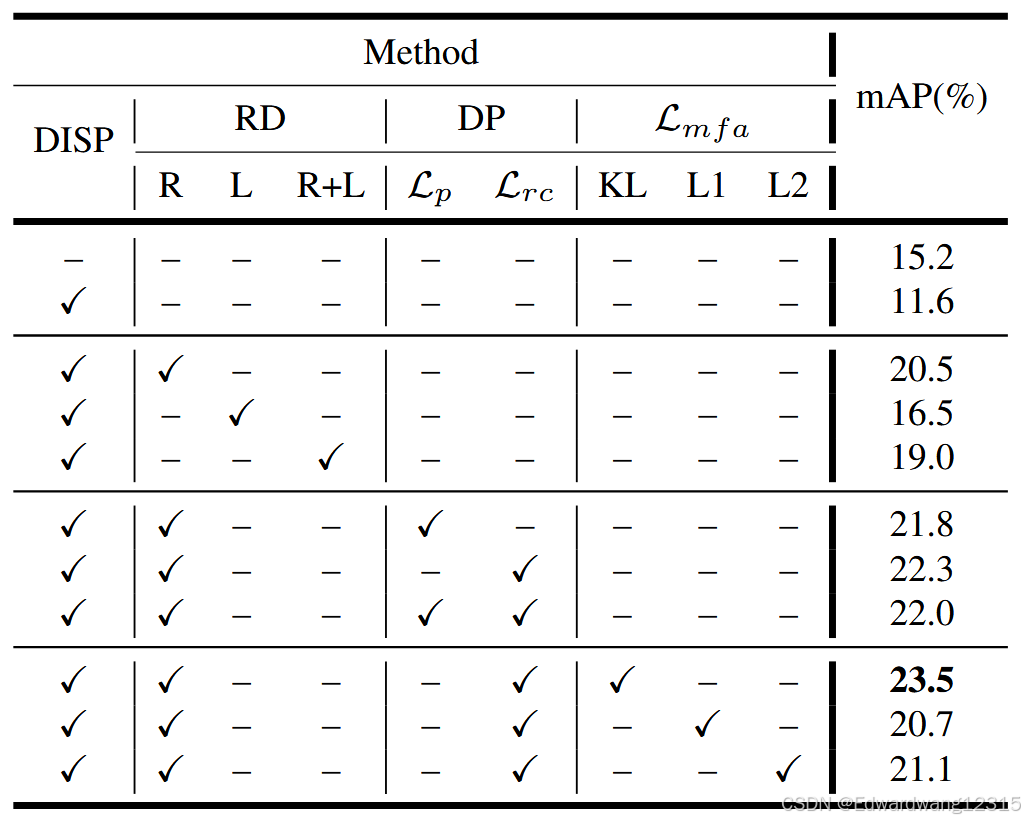
选用vanillaDSFD模型,使用ISP生成的暗图训练会降低性能,结论是合成的暗图与实际有差别,学习到的策略不对。
反射图解码器
解码器的加入提升检测效果,因为反射图是与光照无关的,同时为了验证该结论,作者设置了光照解码器作对比,证明了反射图是提升效果的学习目标。
再分解过程
提到了两个损失函数:Lrecon和Lrc,其中Lrc的影响占据主要部分,同时更多次分解并未带来更好的性能,因此只使用二次分解。
特征对齐
KL散度模型用来评估特征值对齐效果很好。
总结
这篇文章是围绕Retinex理论进行的,结构上:在检测器的基础上增加了一条分支作为主要的功能模块;同时将零样本建立在一个较大的伪标注生成网络之上,感觉建立在这种笨拙的伪标注生成网络上的零样本学习多少有点自欺欺人了。其实总体感觉没什么亮点。。。
但是或许就像作者自己说的他们是第一批专注于ZSDA(zero-shot day-night domain adaptation)的人,对一些参照组的设置和损失函数的设想挺让人大开眼界的:如整个的交换-再分解-趋同过程,通过对提取出的不变层进行交换复原,再与原图比对;在每一个可能导致反射图出现偏差的地方都设置了损失函数。
觉得或许可以改进的地方:损失函数的来源太乱了,没有一个比较规范的设定,这个问题应该来源于整体结构太简单了。
更多推荐

 16
 0
- 0


 已为社区贡献1条内容

所有评论(0)