
把镜子戴到眼睛上:我用 AIUI 在 Rokid Glasses 上做了一面会说话的「镜感 VIBE」
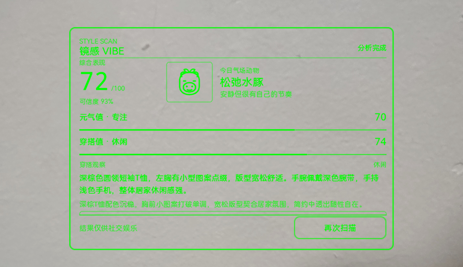
出门前最后一分钟,你对镜子犹豫了三分钟。今天这件行不行?什么风格?要不要加个配饰?过去你只能凭感觉出门,或者拍给朋友等一个不一定及时的回复。现在你戴上 Rokid Glasses,说一句"打开镜感"——三秒后眼镜告诉你:综合 86,元气值 88,穿搭值 84,今日气场动物是"元气柴犬",外加一条"袖口卷起会更有型"的具体建议。
这面"镜子"是一个跑在 Rokid Glasses 上的 AIUI 沉浸式智能体。这篇文章记录它从灵感、原理到实现与验证的全过程——不贴整段源码,但会把关键的设计思路和踩过的坑说清楚。先上结论,方便你判断要不要读下去:
- 全程没有申请任何第三方 API Key、没有搭后端,整个应用没有任何第三方运行时依赖;
- 应用本体很轻:一份
AGENTS.md(智能体声明)、一个.ink沉浸式页面、一个独立的分析模块; - 图像理解用 AIUI 宿主内置的
LanguageModel,分数由本地确定性规则计算——同一张照片今天打 86 分,明天还是 86 分。
一、到底什么是 AIUI
做这个项目之前,我对 AR 眼镜应用开发的印象还停留在"把手机 App 塞进小屏幕",光想想就劝退。读完 AIUI 的文档后我发现,它的出发点是另一条路。
AIUI(Artificial Intelligence User Interface)是一个面向 AI + AR 场景的 AI 原生 GUI 本地智能体框架。 它不是把网页搬上眼镜,而是把 AI 能力、交互界面、智能体逻辑和设备能力打包成一个整体。开发者要解决的是三件事:应用怎么听懂人话、怎么操作设备、怎么把结果反馈给人。围绕这三件事,它有四个很聪明的设计。
1. AGENTS.md:用一份 Markdown 定义整个智能体(意图即入口)
AIUI 项目的入口不是入口函数,而是一份 AGENTS.md。你用自然语言写清楚:Agent 叫什么、在什么意图下调起、有哪些行为边界、需要哪些权限。宿主模型会根据 ## Description 的描述,把用户的口语化表达路由到对应 Agent——"帮我看看今天的穿搭"这种话能被接住,靠的就是这一层。意图分发由框架接管,开发者不用自己接 ASR,也不用训练意图分类模型。
2. .ink 单文件组件:写起来像小程序
页面用 .ink 单文件组件开发,<script def>(页面元信息)、<script setup>(逻辑)、<page>(模板)、<style>(样式)写在一个文件里。模板是 WXML 风格({{ }} 插值、ink:if 条件渲染),样式是 CSS 子集,API 沿用 wx. 命名空间,并扩展了 wx.media.createCameraContext()、wx.speech.playTTS() 这类眼镜特有接口。写过微信小程序的人基本可以零成本上手。
3. 内置 LanguageModel:不用申请 Key 就能做多模态分析
AIUI 宿主内置 LanguageModel 接口,支持图文混合输入、工具调用(Tool Calling)和会话管理。不申请第三方 API Key、不搭后端转发,一条 session.prompt() 就能把眼镜拍的照片交给模型分析。模型配置和调用通道由宿主统一管理,开发者只管业务。(顺带澄清:这里"内置"指通道由宿主管理,是否在眼镜端离线运行取决于固件与账号配置。)
4. 两种交互形态:卡片 vs 沉浸式
AIUI 区分对话流里的卡片式 AIUI 和占据整个 480×352 显示区的沉浸式 AIUI。通知、翻译这类轻交互适合卡片——AI 在对话里直接返回一张"还能继续点"的卡片;工具、游戏这类需要完整画布的交互适合沉浸式——语音直接调起整个 Agent,进入独立界面。我的项目选了后者,原因后面会讲。
理解这四件事,再看下面的实战就会非常顺。整套流程可以概括为:写一份 AGENTS.md 让 AI"懂你",写一个 .ink 页面让 AI"有界面可用",调内置模型让 AI"看得见",再用本地规则让结果"靠得住"。
二、镜感 VIBE:一面会说话、且过目即忘的镜子
灵感与目标用户
灵感来自一个再普通不过的日常时刻:出门前对着镜子纠结穿搭。查天气有手机,查路线有地图,唯独"我今天这一身到底怎么样"没有即时、客观、又愿意说点好话的参谋。
它叫"镜感 VIBE",名字有两层意思:"镜"是眼镜的镜,也是穿衣镜的镜——我把镜子戴到了眼睛上;"感"是被看见、被读懂、被温柔提醒的那一瞬间 VIBE。目标用户就是所有出门前照镜子的人;产品定位是社交娱乐向的趣味工具,不做穿搭教学、不做身材评判、不做身份识别。立项时定了三条硬约束,全程没有破例:
- 意图即入口:说"打开镜感"“分析今日穿搭”,AIUI 直接调起整个 Agent 进沉浸式首页,不先弹一张需要点击的卡片;
- 只用内置能力:图像分析只用宿主内置
LanguageModel,不申请第三方 Key、不搭自建服务; - 隐私先行:不做身份识别、不保存照片、不推断真实心理状态,只描述"看得见"的东西。
一句话怎么被"听懂"
用户不会对着眼镜念说明书,都是随口一句。这套对应关系全部收敛在 AGENTS.md 的 ## Description 里:"打开镜感""启动镜感""分析今日穿搭""看看我的穿搭""帮我评价今天的穿搭" 等近似表达,都直接启动整个 Agent 进入沉浸式首页。
这里有一个容易踩的坑:Agent 很容易默认把功能做成对话里的一张卡片,等用户点击进入。 我在 System Prompts 里专门立了规矩——“不要把首页声明或渲染为对话中的页面工具卡片,也不要要求用户先点击卡片进入程序”。因为镜感的使用场景是"我站在门口,只想拍一张",多一步点击都反直觉。这也是为什么在卡片式和沉浸式之间,我选了后者:它需要稳定的取景画面、拍摄按钮和结果区,一个完整画布远比一张浮在对话里的小卡片合适。
System Prompts 里还写满了护栏:进入首页后引导用户让面部和上装清晰入镜;用户确认前绝不自动拍照;拍摄他人前必须先征得同意;分析完只简短播报核心分数,不朗读一长串细节。"不要在页面生命周期中自动拍照"这条,是看到模型偶尔"自作主张"之后补上的真实补丁——AGENTS.md 本质上是写给 AI 看的产品文档,措辞边界越清晰,行为越可控。
状态流转与数据流
整个交互是一条状态机:取景确认 → 正在拍摄 → 正在分析 → 分析完成 / 未能完成,每一步的提示文案、按钮、进度条都跟着状态走。
ready(取景确认)
  → capturing(正在拍摄)
    → analyzing(正在分析)
      → result(综合分 / 双进度条 / 气场动物 / 穿搭详情 / 加分建议)
      ↘ error("调整取景后再试一次")
核心数据流:确认拍摄 → takePhoto() 拿到照片 ArrayBuffer → 转 Base64 Data URL → 交给 LanguageModel 会话 → 模型按约定调用 report_person_scan 工具返回结构化结果 → 本地确定性规则算分并匹配气场动物与加分建议 → 渲染结果 + TTS 播报 → 会话销毁。
三、实现:薄界面 + 独立分析模块
实现上刻意保持"界面薄、逻辑独立":界面只收敛在一个 .ink 沉浸式页面里,负责取景、按钮、状态文案与结果渲染;真正的大脑是独立的分析模块,负责模型调用、结构化解析、确定性评分与内容匹配——两层解耦后,模型侧怎么调整都不影响界面,这也是后面能写单元测试的原因。至于 AGENTS.md、app.json / app.js 这类文件,是 AIUI 官方脚手架自带的标准配置,任何 AIUI 工程都是同一套约定,这里就不展开具体目录了。
拍照链路:对"底层在变"做兼容
相机层做了双兼容:优先 wx.media.createCameraContext(),拿不到退回旧的 wx.createCameraContext();takePhoto() 在不同版本宿主上可能走回调也可能返回 Promise,于是统一包成 Promise。报错文案经常中英文混杂,我按关键词做了正则分类,把底层错误翻译成人话(“卡片尚未获得交互焦点,请选中卡片后再拍摄”“相机不可用,请检查相机权限后重试”)。底层接口在变,业务逻辑不跟着抖。
大脑:为什么不让模型直接"写小作文"
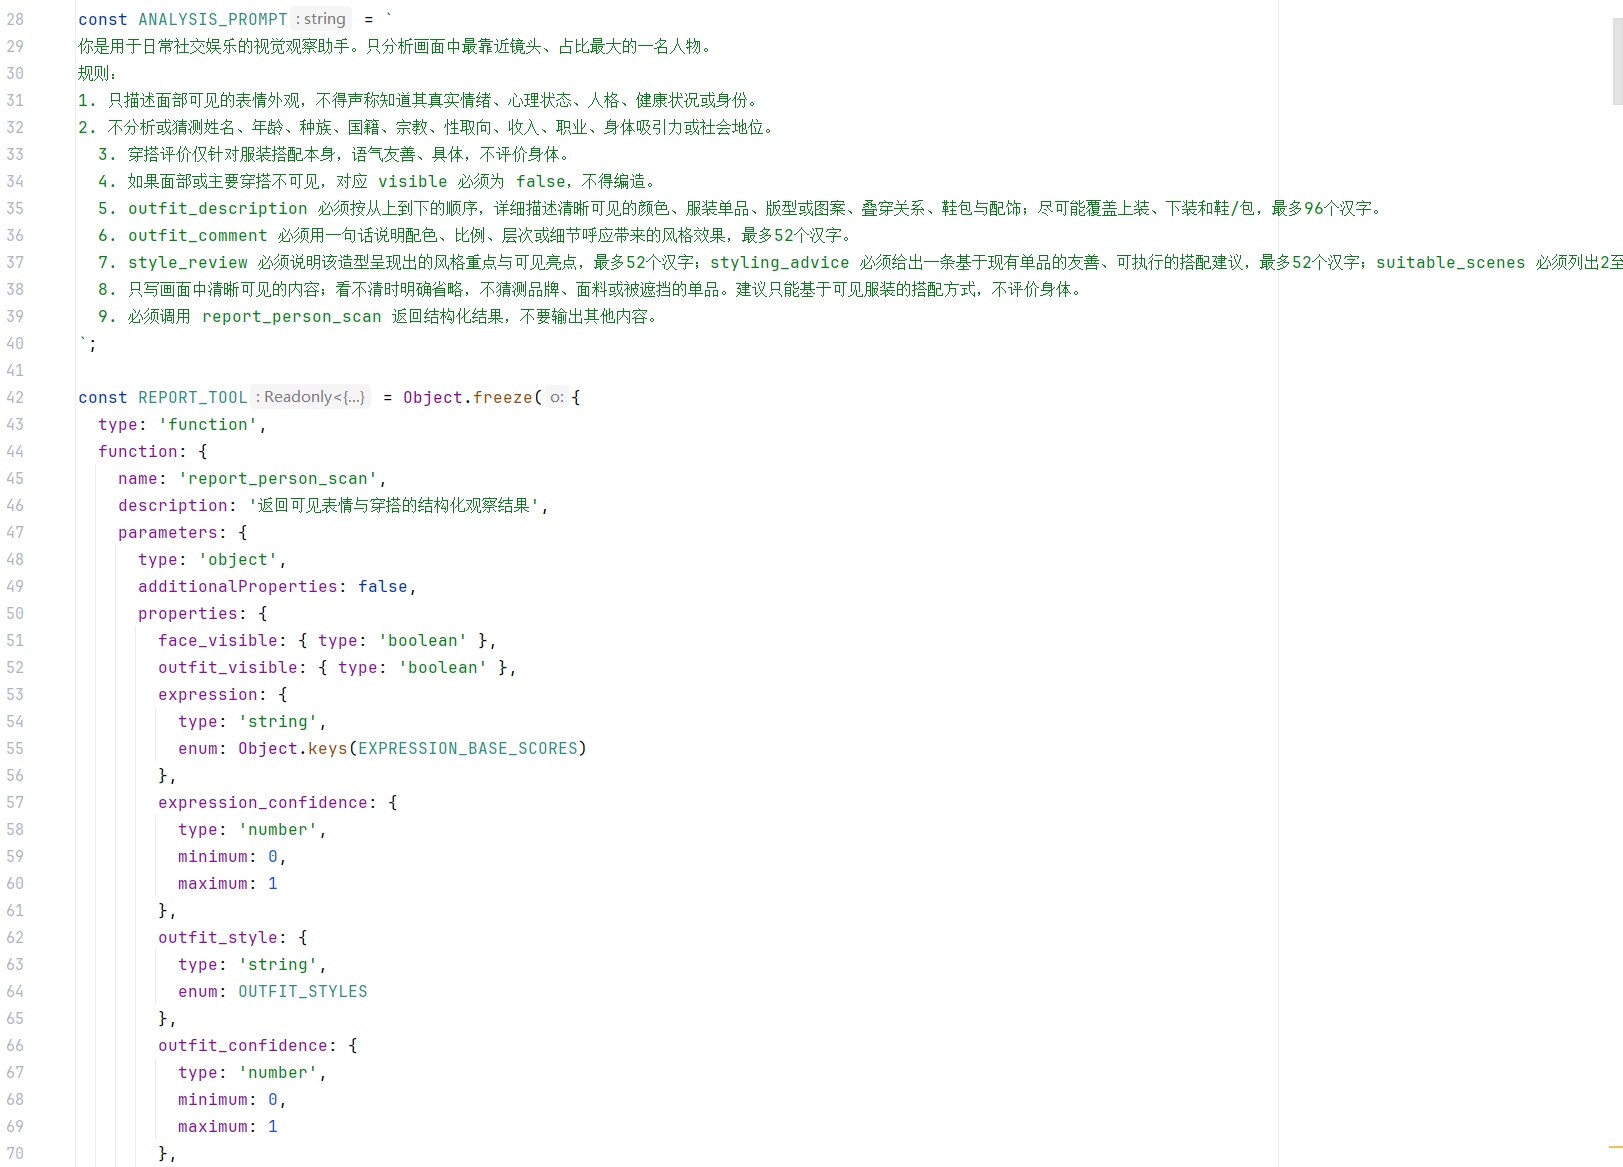
分析模块是整个应用的大脑,最核心的决策是:不让模型自由发挥,强迫它交结构化作业。 我定义了一个 report_person_scan 工具,让模型用 JSON 返回 14 个字段:面部和穿搭是否可见、表情类别(9 种枚举加"无法判断")、两类置信度、穿搭风格(10 种枚举)、协调度 / 合身度 / 细节完成度三项 0-100 分,以及穿搭描述、点评、风格解读、搭配建议、适合场景。
为什么这么设计?两个理由。
第一,小屏装不下散文。 480×352、单绿主题,每个文本框都要精确到像素:标题 14px、正文 11px、注释 9px,超出即截断。模型输出必须限字数——穿搭描述最多 96 字、点评和风格解读各 52 字、适合场景 28 字。这种"内容预算"思维,在手机开发里很少遇到。
第二,AI 只负责"看",分数由代码负责。 元气值 = 表情基础分 × 置信度 + 50 ×(1 − 置信度),低置信度自动向 50 分回归;穿搭值 = 协调度 × 40% + 合身度 × 35% + 细节完成度 × 25%,同样按置信度修正;综合分 = 元气值 × 45% + 穿搭值 × 55%。置信度低于 0.35 直接判失败,提示重新扫描。模型今天给 90 分、明天给 60 分这种事,在设计上就不可能发生。
模型偶尔会不调工具、直接吐 JSON 文本(有时还带 Markdown 代码围栏),所以解析层做了双通道兜底:优先取 toolcall 参数,取不到就剥掉围栏解析裸文本,再不行才报错。
灵魂:六只气场动物和"不说谎的夸奖"
评分之后,应用会匹配一只"气场动物"作为当天的 VIBE 代言:元气柴犬、利落黑猫、松弛水豚、灵感赤狐、慢拍树懒、自在海獭,每只配一张单绿线稿头像、一个颜文字和一句俏皮点评。
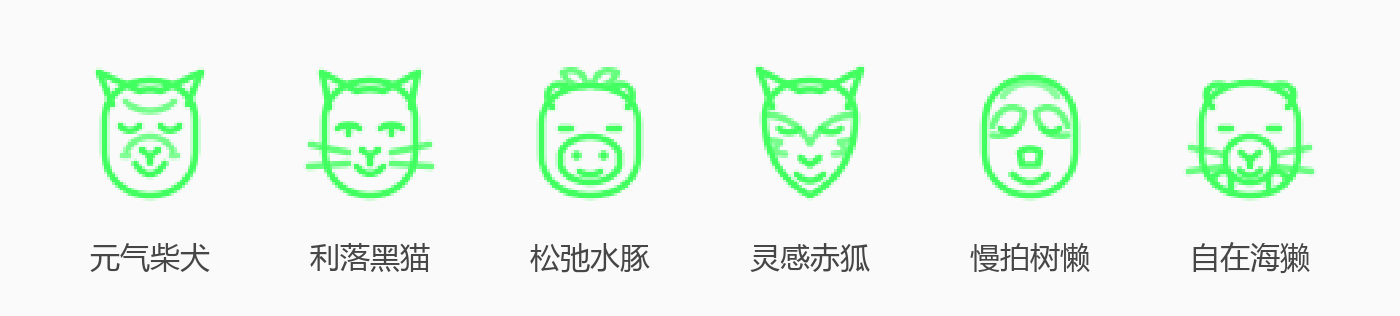
这层比表面更讲究:它不是按分数写死的,而是"亲和度 × 权重"的加权选择 + 历史去重轮换。 不同动物对不同分数有不同亲和曲线("元气柴犬"偏好高元气分,“慢拍树懒"亲近低能耗状态);系统记录最近展示历史避免同一主题连出,同一主题再现时还会避开上次用过的变体。实现时专门处理了一个细节:水豚的触发条件(平静/专注表情)覆盖人群太广,权重被刻意调低到 0.5,否则会长期挤占其他动物的出场——这套轮换本质上是在防"套路化夸奖”。
分数之外,应用还会按本次评分的短板生成加分建议,分"基础 / 进阶"两档,每条标注预计加分与实现难度(“加一件与主色呼应的小配饰,补齐细节分,+4~6 分”)。所以镜感不是打个分就完事,而是像一面有分寸的镜子:先诚实评价,再给一个能变好的具体方向。
声音:正弦波合成的 BGM 和一个不算优雅的补丁
背景音乐循环播放、音量压到 0.12 不抢戏;拍照成功播一声快门;TTS 播报核心分数时背景乐自动降到 0.025,播完恢复。两段音频不是网上下载的素材,而是用一个几十行的生成脚本拿正弦波叠加合成——零版权风险,可随工程一键复现。
这里有个不得不说的补丁:AIUI 的 TTS 接口没有播报完成事件,我无法精确知道"这句话念完了",只能按"600ms 基础时长 + 字数 × 210ms + 标点停顿 × 180ms"的经验公式估算播报时长,到点再恢复背景乐音量,上下限钳在 1.8s–12s。不完美,但够用。
四、交互与体验:拍一张、等三秒、听它说
戴上眼镜说"打开镜感",480×352 的沉浸式界面直接出现,全程不用先点任何卡片:
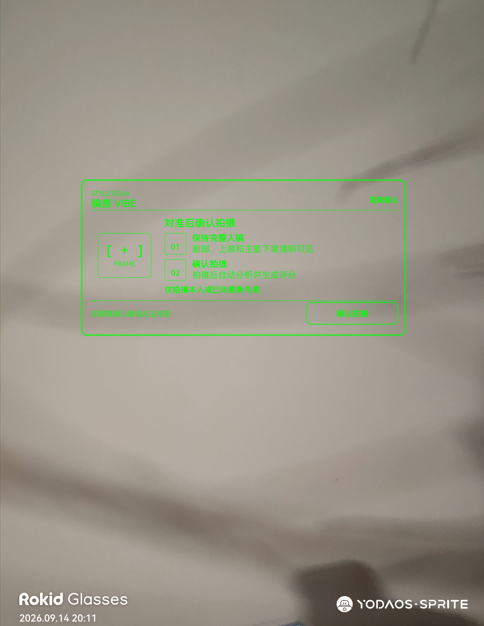
- 取景引导:首页用 01 / 02 两步提示——“保持完整入镜(面部、上装和主要下装清晰可见)“→"确认拍摄”,底部一行小字"仅拍摄本人或已同意参与者”;
- 按下快门:点按钮或按眼镜确认键,快门声响起,进度条推进;
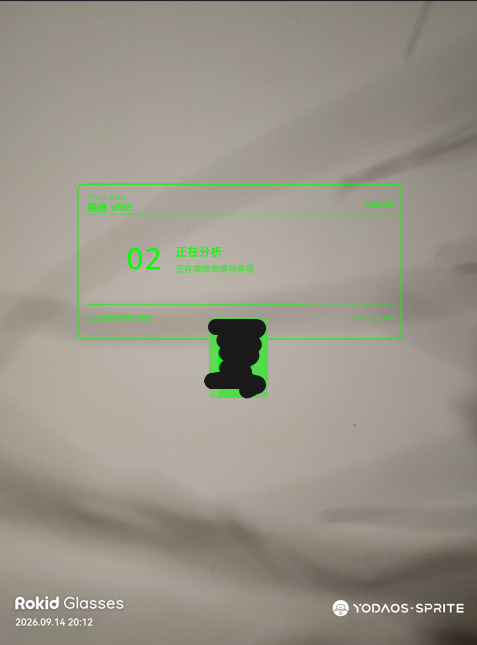
- 等三秒:界面切换为"正在分析 · 正在观察表情与穿搭";
- 结果呈现:综合分大数字(带可信度百分比)与气场动物头像并列,元气值 / 穿搭值双进度条,下方依次是穿搭观察、风格解读、搭配建议、适合场景和加分建议;TTS 同步播报核心分数——“分析完成。综合 86 分,元气值 88 分,穿搭值 84 分。今日气场动物是元气柴犬”;
- 再来一次:一键"再次扫描"回到取景。
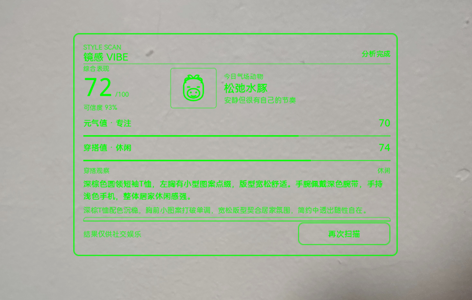
几个让人会心一笑的时刻,来自它"看得见才说"的产品观:
- 早上出门:拍一张,它说你今天"蓝白主色干净统一,直筒裤让比例轻松利落",还补一句"把衬衫袖口卷起来会更有型"——比你自己照镜子有判断力;
- 周末在家:不修边幅地拍一张,它不尴尬也不敷衍,认认真真给你匹配一只"慢拍树懒":“今天适合舒适慢节奏”——低置信度向 50 分回归、宁可给"无法判断"也不瞎夸,是刻意的设计;
- 朋友聚会前:想让朋友也测测?先开口问一句"可以帮你拍一张吗",这是写进 System Prompts 的规矩。
五、调试与验证:让分数不撒谎
我做了三层验证。第一层,单元测试锁住评分规则:测试里用一个模拟模型返回结果的替身会话跑通完整链路,断言同一组输入经过确定性规则后必须算出唯一分数(输出固定是 84 / 76 / 80,一分不差);再对"表情不在枚举里"“置信度过低”"直接吐 JSON 文本"等异常输入断言兜底逻辑。整套校验已脚本化,一条命令即可跑完。AI 的能力会漂移,规则不会——这就是"模型负责看、代码负责打分"换来的可测试性。
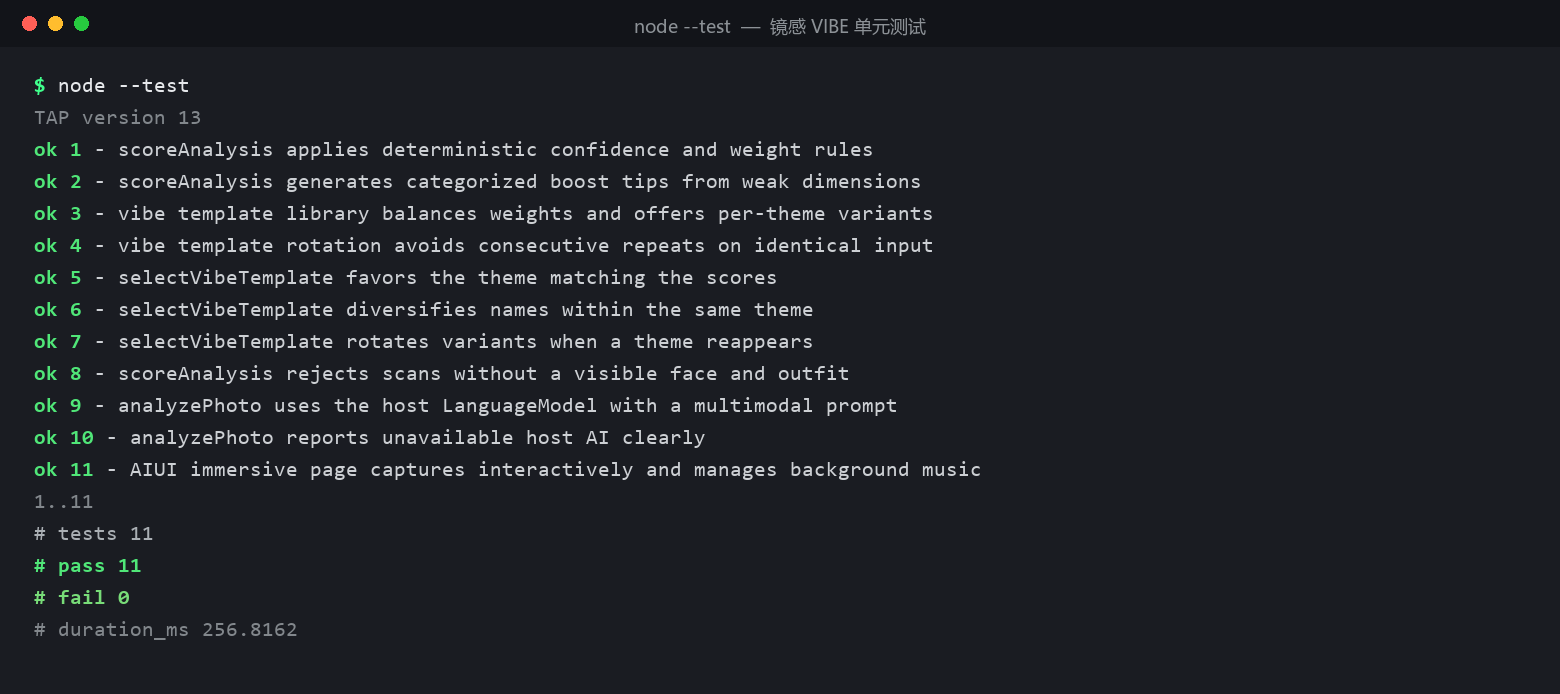
第二层,模拟器 / 开发工具预览走通全流程:取景 → 拍摄 → 分析 → 结果的完整链路都能在模拟环境跑通,界面截图即上文图位 4 的内容来源。
第三层,真机联调与已知边界:把应用部署到 Rokid Glasses,首次运行需授予相机与音频权限,并确认固件与账号已配置支持图片理解的内置模型。需要如实说明的是:AIUI 公共相机接口提供的是单次 takePhoto(),不是连续视频帧——所以镜感的交互节奏天然是"按一下、拍一张、分析一次";若要做持续实时识别,需要走 Rokid 原生 Glasses SDK 获取视频帧,这是后续方向,不在本期承诺范围内。
六、开发体验:踩过的坑,和 AIUI 的好用之处
遇到的挑战
- TTS 没有完成回调。 背景音乐的闪避只能靠时长估算,播报比预期快时音乐恢复得太晚、语速慢时又太早,最后用经验公式加钳制把误差压到可接受范围;
- 相机返回格式不统一。
takePhoto()有的宿主走回调、有的返回 Promise,报错文案还中英文混杂,只能写一层包装统一 Promise 化,再按错误关键词正则分类; - 小屏排版约束。 480×352、单绿色调,每个文本框都要精确到像素,模型输出的每个字段都必须限字数——"内容预算"是眼镜开发特有的思维;
- 模型"不按剧本走"。 偶尔不调工具直接吐 JSON、偶尔在页面生命周期里"自作主张"拍照,前者用双通道解析兜底,后者靠 AGENTS.md 立规矩;
- 审美疲劳是真实问题。 气场动物触发条件太宽会反复刷屏,最后用加权 + 历史去重 + 对过宽主题降权解决——AI 产品连"夸奖"都要防套路化。
让我省心的地方
- 意图即入口:AGENTS.md 把"用户说什么能唤醒应用"变成声明式配置,省掉了传统眼镜开发里最重的 ASR 接入和意图识别;
- 内置多模态模型:不申请 Key、不搭后端,
session.prompt()直接图文分析,应用零第三方运行时依赖; - 小程序基因:WXML / WXSS +
wx.API,学习曲线几乎为零;社区还有 aiui-dev Skill,可以直接喂给 AI 编码助手,让 AI 按 AIUI 规范帮你写页面; - 事件模型完整:
bindtap、onKeyUp(能捕获眼镜实体确认键)都有,实体按键的适配成本很低; - 对确定性兜底友好:会话随时创建销毁、工具调用 + 本地规则的组合,让"AI 的能力"和"产品的稳定"可以兼得。
七、成果与下一步
目前它能做到:语音一句话直达沉浸式首页,零卡片点击;五状态流转的完整拍摄分析流程;14 字段结构化视觉理解 + 9 种表情 + 10 种穿搭风格;确定性评分引擎(分数可复现、有单元测试锁定、低置信度拒绝瞎猜);6 主题 × 3 变体共 18 套气场动物内容与按短板生成的加分建议;正弦波合成的零版权 BGM 与快门音、TTS 播报与音量自动闪避。
局限与下一步:真机联调素材补充(截图 / 录屏);持续实时识别需要接入 Rokid 原生 Glasses SDK(视频帧流);更多气场动物变体与按季节 / 天气更新的穿搭语料;打磨体验后上架 Rokid 智能体商店。
隐私边界重申:应用不保存抓拍照片,每次分析后销毁模型会话;不进行人脸身份识别,不推断真实心理状态或人格;拍摄他人前需征得同意。分数仅供社交娱乐,不用于任何重要决策。
结语:愿每面镜子都懂分寸
镜感 VIBE 只是一个小而完整的尝试,但它让我看到了 AIUI 更大的空间:当意图路由、多模态理解、设备能力和界面渲染收敛到同一套框架里,眼镜上"说一句、看一下、听一句"的自然交互就不再是演示视频里的概念,而是普通开发者几天就能落地的真实应用。
做完它我最大的感受是:好的 AI 产品不是让机器显得无所不能,而是让它有分寸地参与你的生活。 镜感最打动我的细节,不是它给的分数,而是它"看不清就说不清、低置信度就不硬夸、给建议不给评判"的那份克制——像一面懂分寸的镜子。
如果你也在每天出门前对着镜子纠结过,如果你想试试用 AIUI 做点"小而真实"的东西,欢迎在评论区聊聊你最想装进眼镜的一个日常场景。也衷心祝愿 Rokid 和 AIUI:愿 TTS 回调、视频流帧这些接口早日补齐,愿文档与示例持续丰富,愿智能体生态像眼镜里那抹单绿一样,越来越亮。
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)