
【论文阅读】Text-IF: Leveraging Semantic Text Guidance for Degradation-Aware and Interactive Image Fusion
Text-IF: Leveraging Semantic Text Guidance for Degradation-Aware and Interactive Image Fusion
现有方法存在的问题
受环境条件限制,原始采集的红外和可见光图像可能会出现劣化,融合图像质量较低。可见光图像容易受到退化问题的影响,例如低光、过度曝光等。红外图像不可避免地受到噪声(包括热噪声、电子噪声和环境噪声)、对比度降低和其他相关影响的影响。当前的融合方法缺乏自适应解决退化问题的能力,导致融合图像质量低下。依靠手动预处理来增强图像存在灵活性和效率问题。

本文贡献
1.为了适应复杂的退化条件,我们解决了图像融合和退化的综合问题 -有意识的处理。它突破了图像融合质量提升的限制。
2.我们引入了语义交互引导模块来融合文本和图像的信息。该方法不仅实现了多模态图像融合,而且实现了多模态信息融合。
3.所提出的方法最终增加了定制融合结果的自由度。它提供了交互式融合,可以生成更灵活、高质量和用户所需的结果,而无需事先具备专业知识或预定义规则。
研究方法

问题表述
一般的图像融合方法将图像融合任务表述为以两个源图像(例如,Ivis、Iir)作为输入和融合网络(例如,θn)以获得固定图像融合结果。该网络旨在学习与融合任务对应的映射预定义融合函数Fif。简单来说,可以描述为:
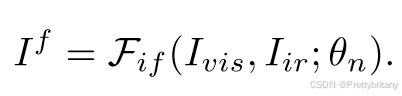
这意味着融合网络倾向于学习相对固定的融合策略。而且,在复杂的环境中,例如源图像退化,这种任务范式是无能为力的。我们研究利用文本来打破传统的单一融合结果以及在退化过程中难以提高质量的问题,并探索新颖的文本引导图像融合范式。由于文本语义的引入,这个融合任务被重写为:
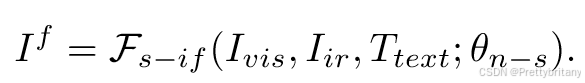
在文本语义信息引导下,原始映射融合函数Fif被扩展为Fs−if。通过文本语义Ttext的交互,图像融合网络θn−s可以根据用户给出的文本实现更加定制化和灵活的融合效果。同时,面对各种源图像劣化,它还可以自由地恢复和融合图像。
图像融合流水线
图像编码器.图像编码器分别将源可见光图像和红外图像作为输入。考虑到空间和深层信息提取,为了获得全面而准确的表示,我们采用基于 Transformer/Restormer[37] 的块作为基本特征提取器。简单来说,可以表述如下:
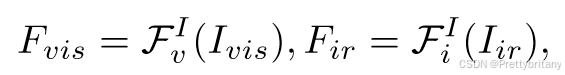
交叉融合层.交叉融合层旨在整合来自不同模态的特征信息。为了全面整合所有维度的特征,首先使用交叉注意力(CR-ATT)来交互不同模态的特征。具体可以表示为:
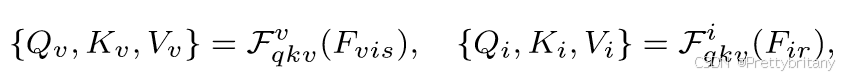
其中Fvis、Fir表示可见光编码器和红外编码器的特征。随后,我们交换两种模式的查询 Q 以进行空间交互:
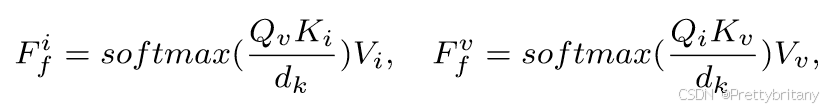
其中 dk 是缩放因子。最后,我们通过 F0 f = Concat(F i f,Fv f ) 将交叉注意力计算得到的结果连接起来,得到融合特征。
语义交互融合解码器.交叉融合层输出的特征首先通过自注意力(SE-ATT)增强,随后,它由语义文本特征交互引导。
语义交互融合解码器被设计为交互文本语义特征 Ftext ∈ RN×L 和图像融合特征 Ff 。具体来说,它是由基于 Transformer 的解码器块和语义交互指导模块(SIGM)构建的,这将在第 3.3节中介绍。融合解码器块和SIGM在多级级联中紧密耦合在一起,以达到密集调节和引导的效果。简而言之,语义交互融合解码器可以描述为:
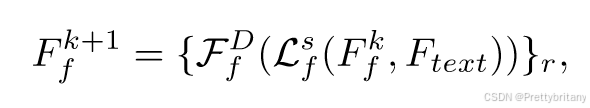
其中F k f 表示第k块阶段的图像融合特征。 {·}r 表示多级重复。 F D f 和 Ls f 表示基于 Transformer 的块和 SIGM。请注意,解码器级别之间需要上采样,以对应于编码器处的下采样。
文本交互引导架构
预设的图像融合管道可以有效地获得相应的融合特征Ff 。而文本交互引导架构是耦合文本语义信息和图像融合的关键部分。
文本语义编码器.给定一个文本Ttext,它提供相应的语义特征来引导图像融合网络获得指定的融合结果(例如,指定任务类型和退化类型),文本交互引导架构的文本语义编码器应该将其传输到文本嵌入。CLIP作为大型预训练视觉语言模型,在文本特征提取上有很好的效果。我们倾向于从 CLIP 中冻结好的文本编码器,以保持良好的语言一致性。用 {·}e 表示冻结权重,该过程可以表示为:
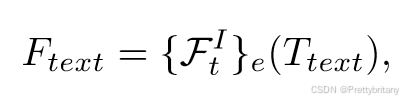
其中 Ftext ∈ RN×L 表示文本语义特征。在不同但语义相似的文本中,提取的特征应该在简化的欧几里德空间中接近。
此外,我们设计了 MLP Φim 来挖掘这种联系,并进一步映射文本语义信息和语义参数。因此,可得:
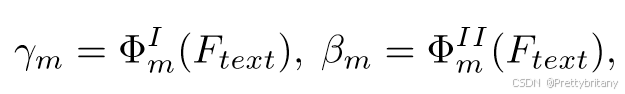
其中 ΦIm 和 ΦII m 是 Φm 的块操作,形成语义参数。
语义交互指导模块(SIGM).在语义交互引导模块中,语义参数通过特征调制和融合特征F i f 进行交互,从而获得引导的效果。特征调制包括尺度缩放和偏置控制,分别从两个角度调整特征。特别是使用残差连接来降低网络拟合的难度。为了简单起见,可以描述为:
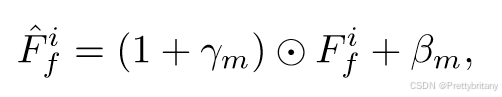
其中 ⊙ 表示哈达玛积。 F i f 表示融合特征。 ˆ Fi f 是带有文本语义信息的。
损失函数
损失函数很大程度上决定了提取的源信息的类型以及源信息之间的比例关系。从文本引导的角度来看,我们不仅希望通过文本自由来解决各种退化问题。还期望文本能够根据用户的需求自主选择融合任务对应的最优损失。因此,在文本引导图像融合任务中,损失函数的构造是一种开集多点映射的关系。
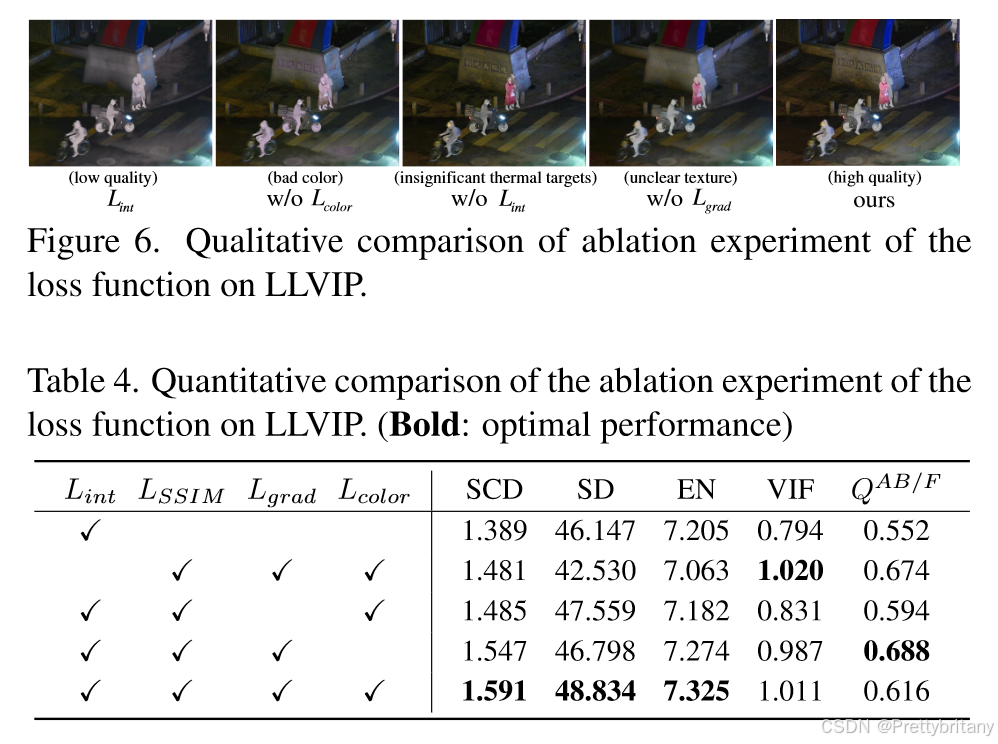
与融合相关的损失包括强度损失、结构相似性(SSIM)损失[40]、最大梯度损失和颜色一致性损失。考虑到退化,我们采用手动获得的高质量可见光图像Ig vis 和红外图像Ig ir 作为损失的约束。
强度损失.为了突出红外和可见光图像中的显着目标,将结果的强度值最大化以确保目标显着性。它定义为:
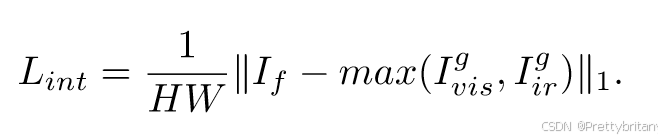
结构相似性损失.结构相似性损失衡量融合图像和源图像,使得融合图像在结构上与源图像相似。其表达式为:
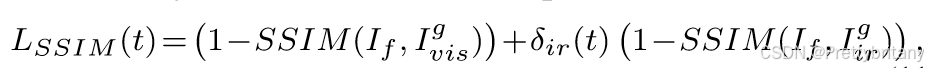
其中δir(t)表示红外结构相似性损失的比率,它是文本语义的函数。
颜色一致性损失.它使融合图像和可见图像的颜色保持一致。我们将图像转置到 YCbCr 空间,并用 Cb 和 Cr 通道的欧几里得距离对其进行约束。可以表示为:
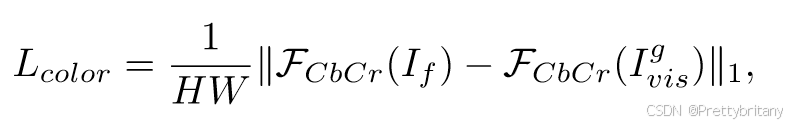
其中 FCbCr 表示 RGB 到 CbCr 的传递函数。
总体损耗.整体损失函数是融合相关损失的组合,并受语义信息调节。简单来说,可以表示为:
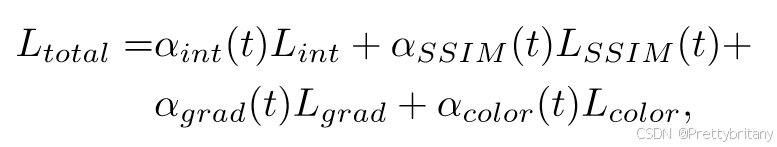
其中αint(t)、αSSIM(t)、αgrad(t)和αcolor(t)是与任务t相关的语义调节超参数。融合结果的权衡起着很大的作用。
实验结果
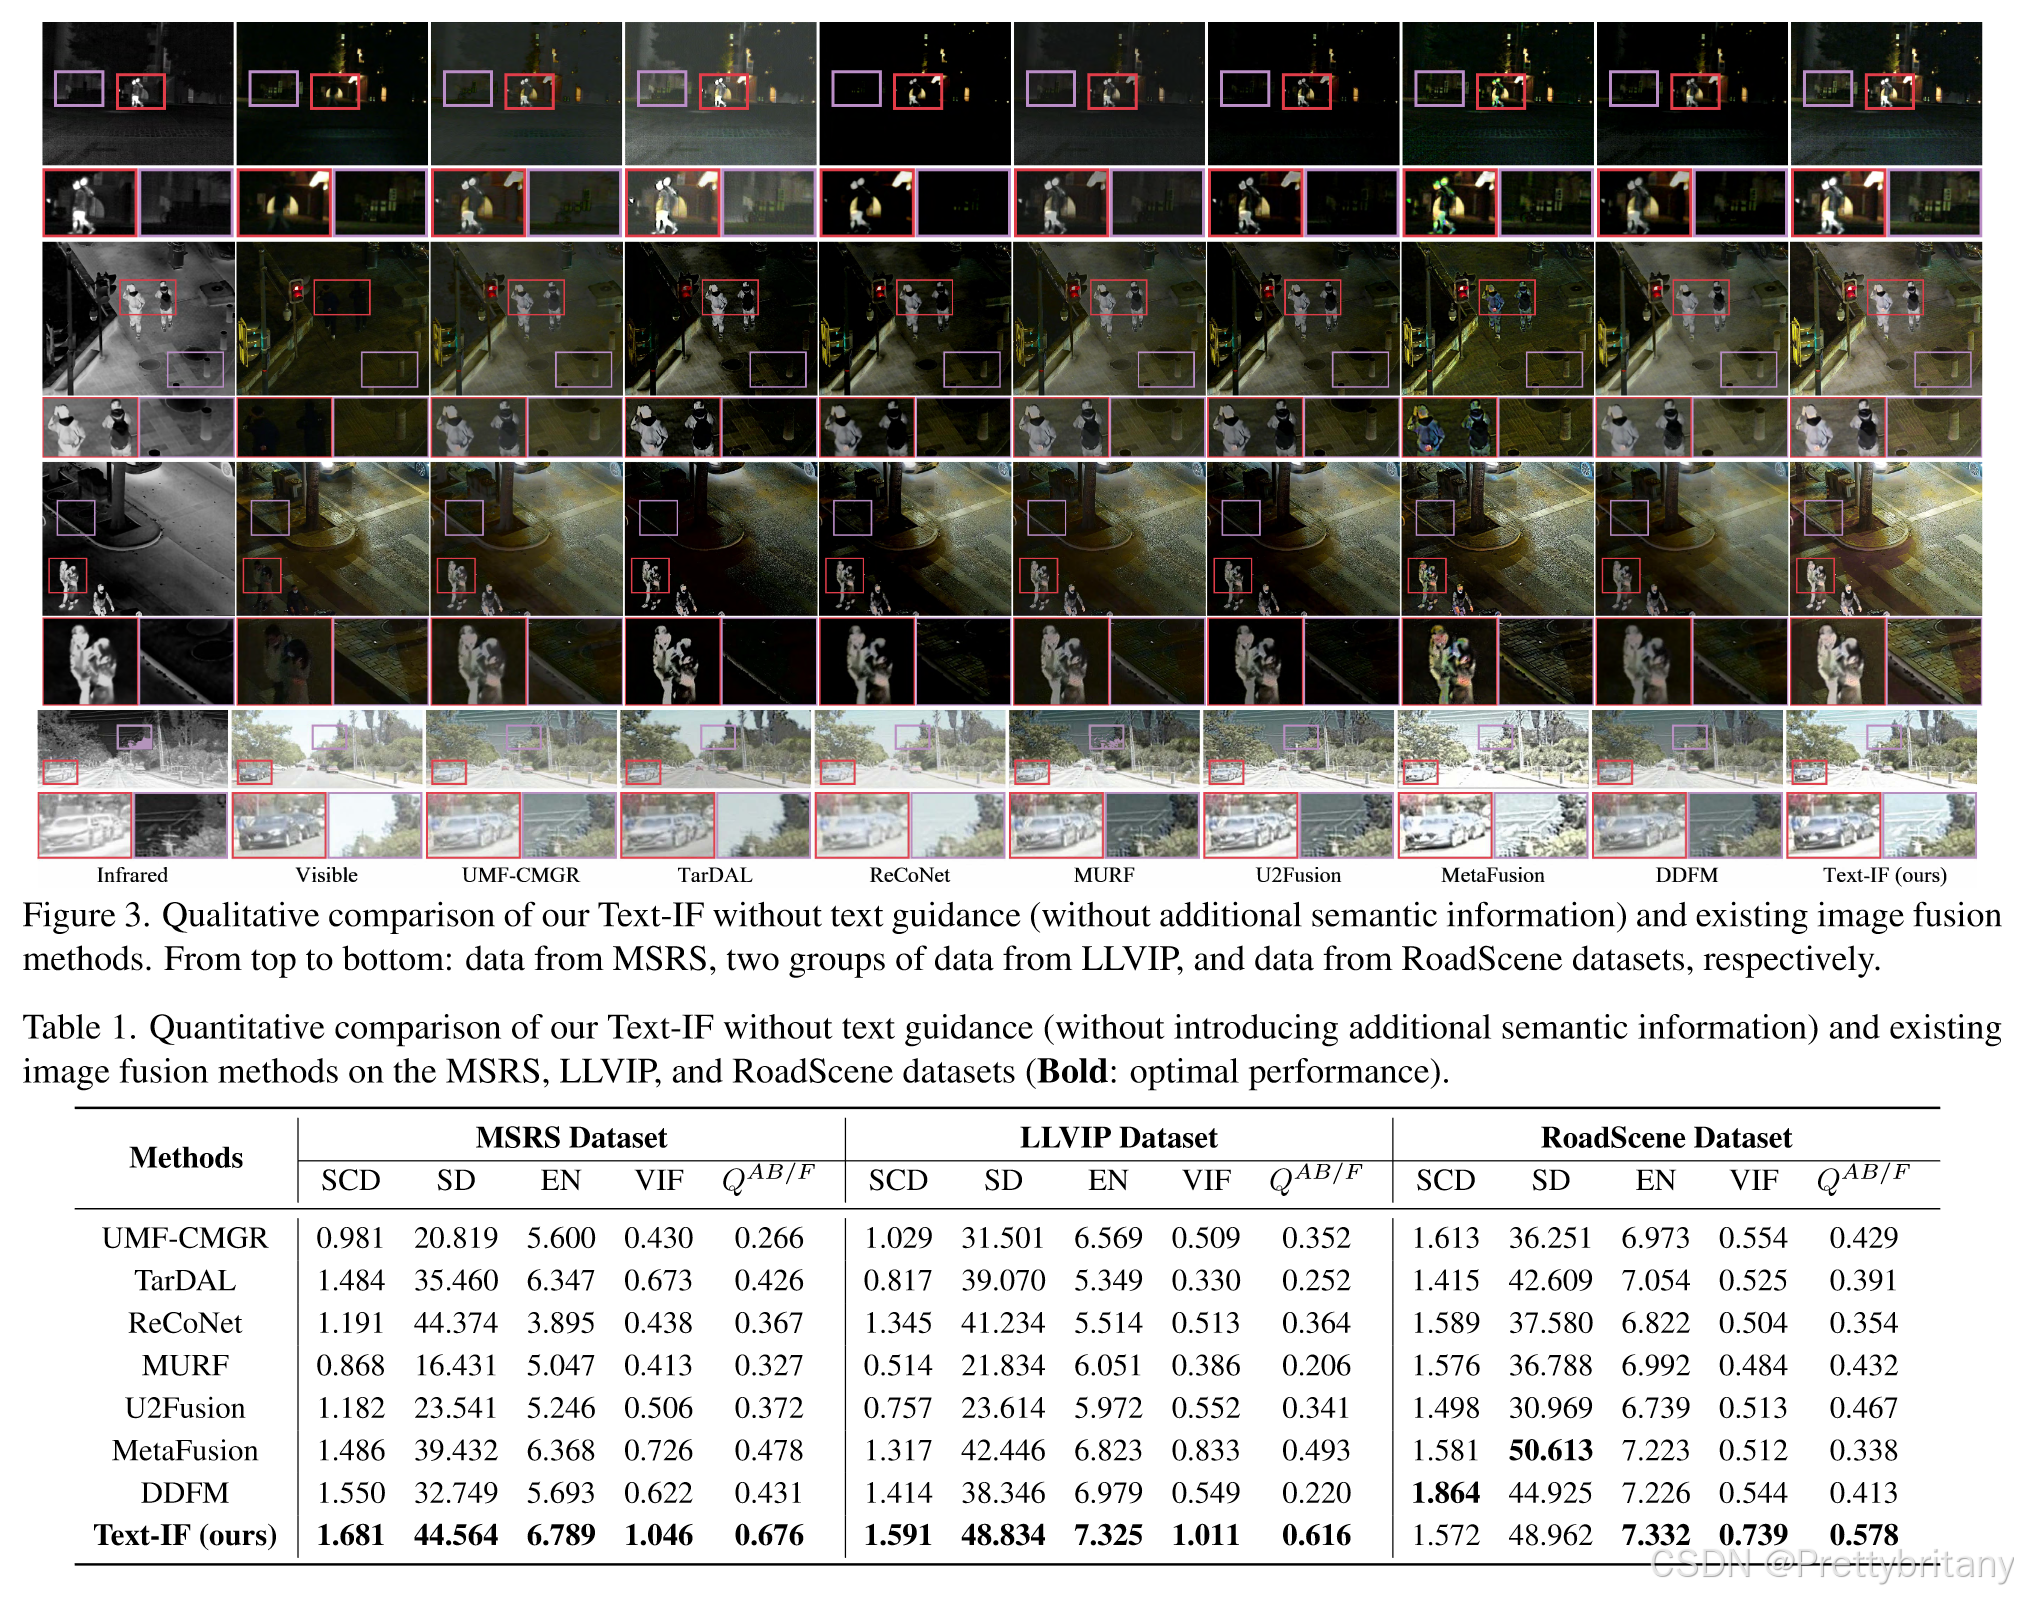
无文本引导的比较
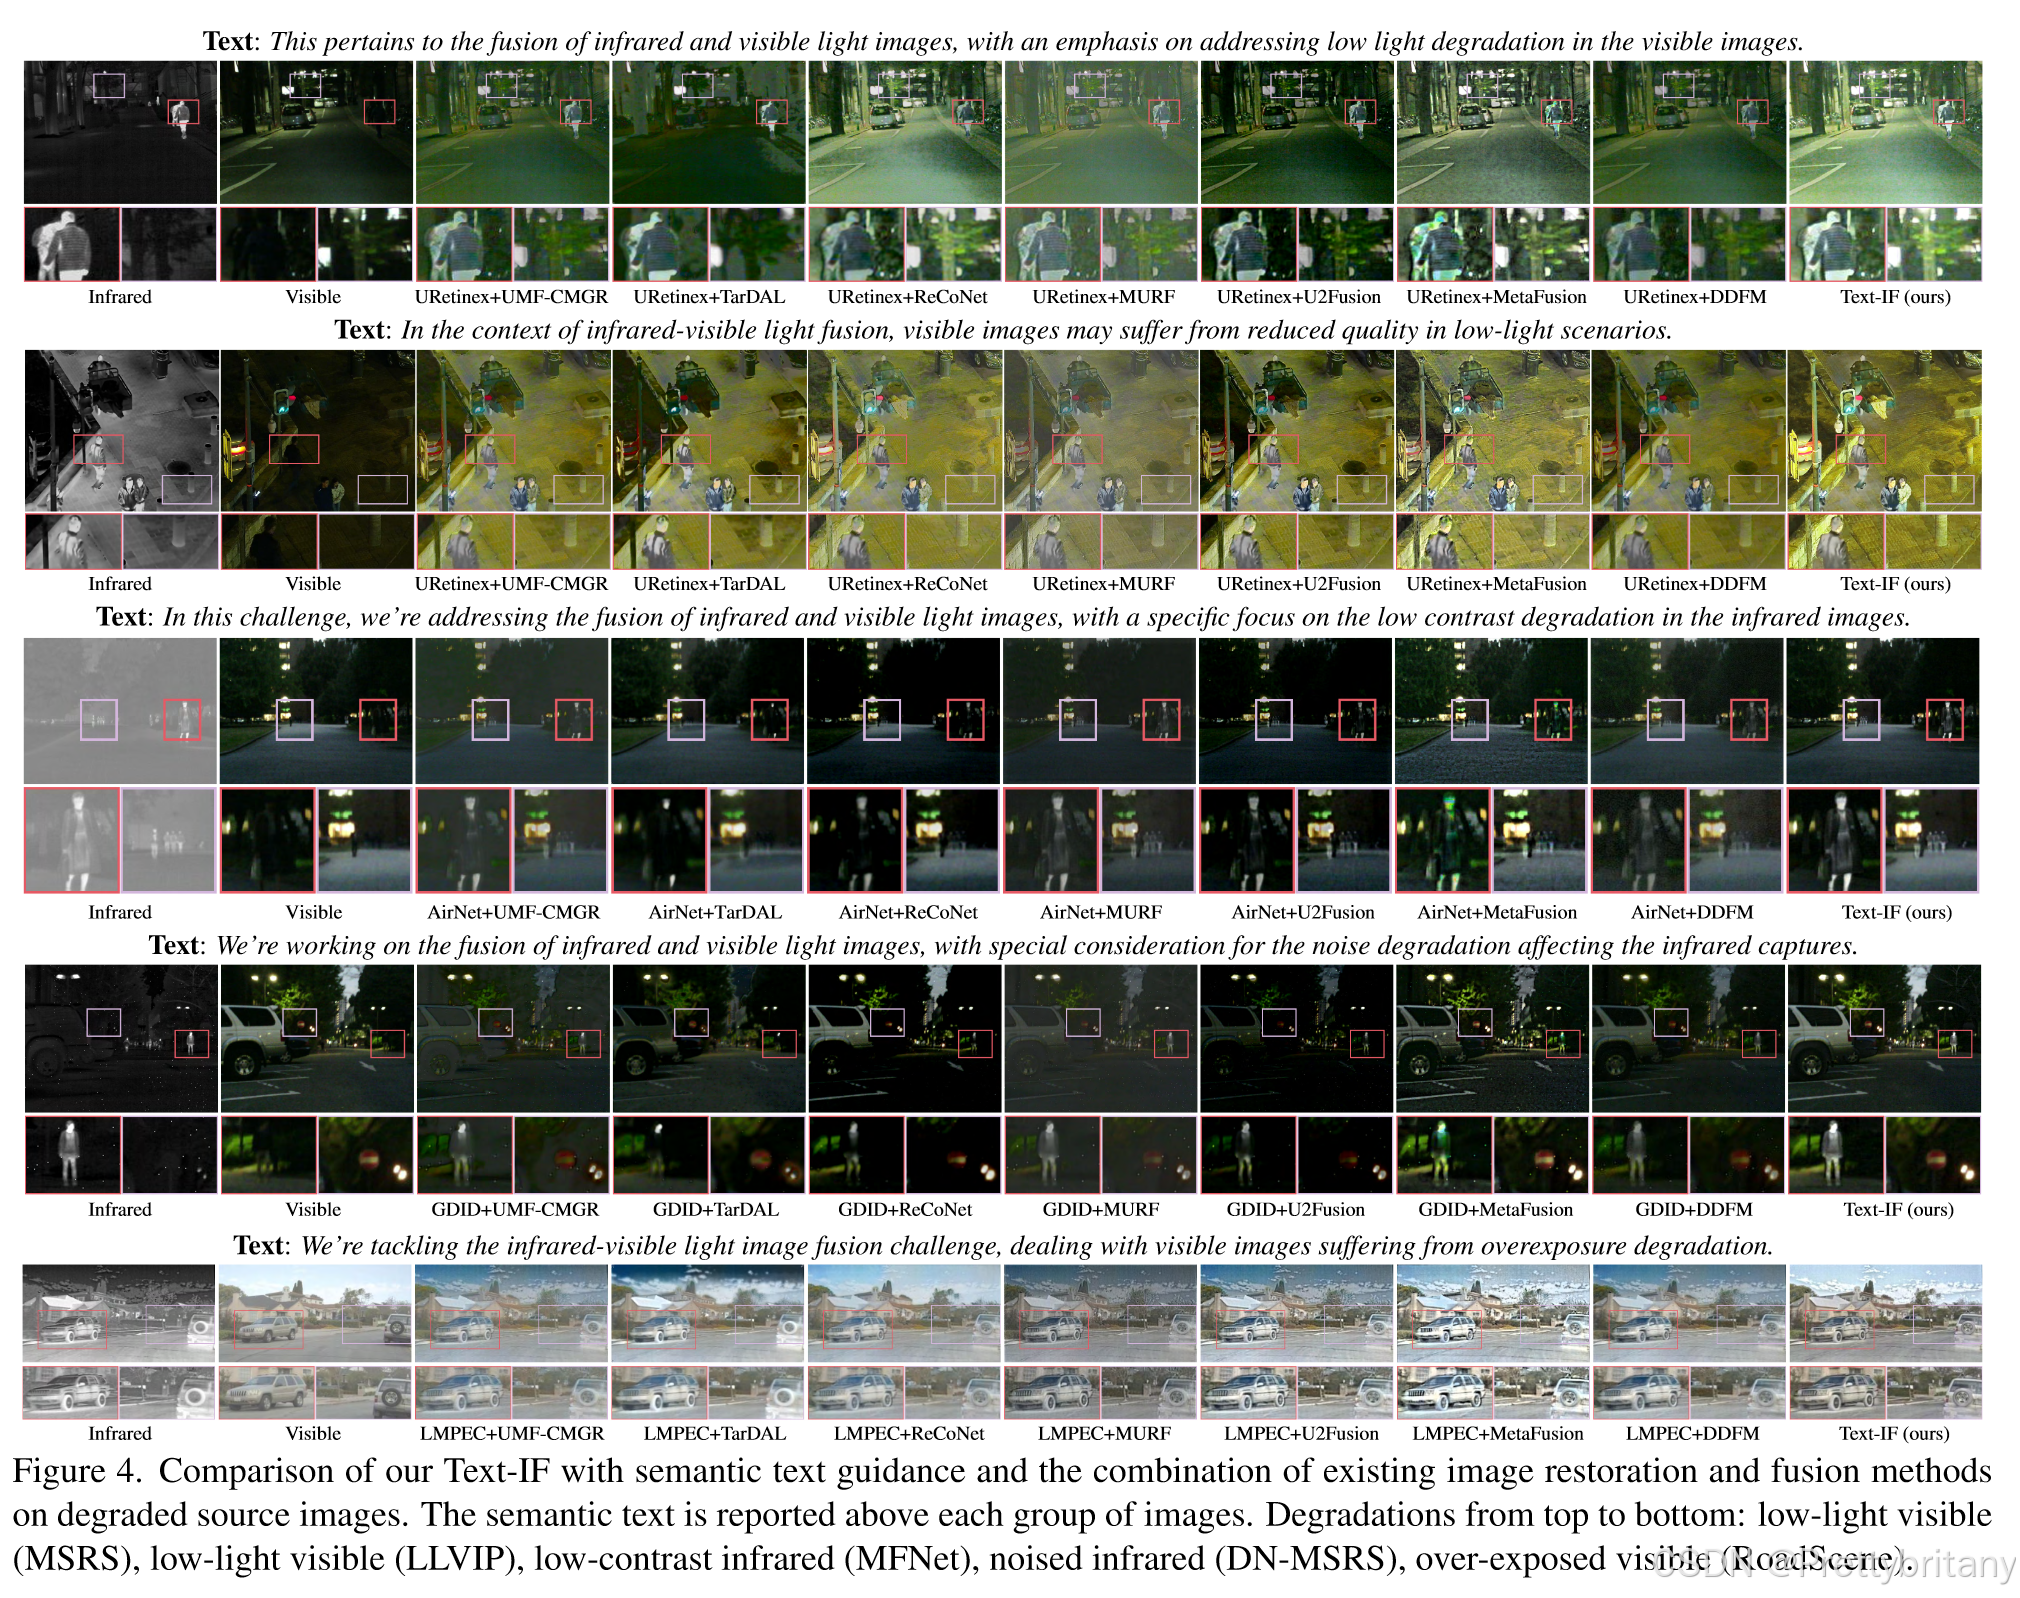
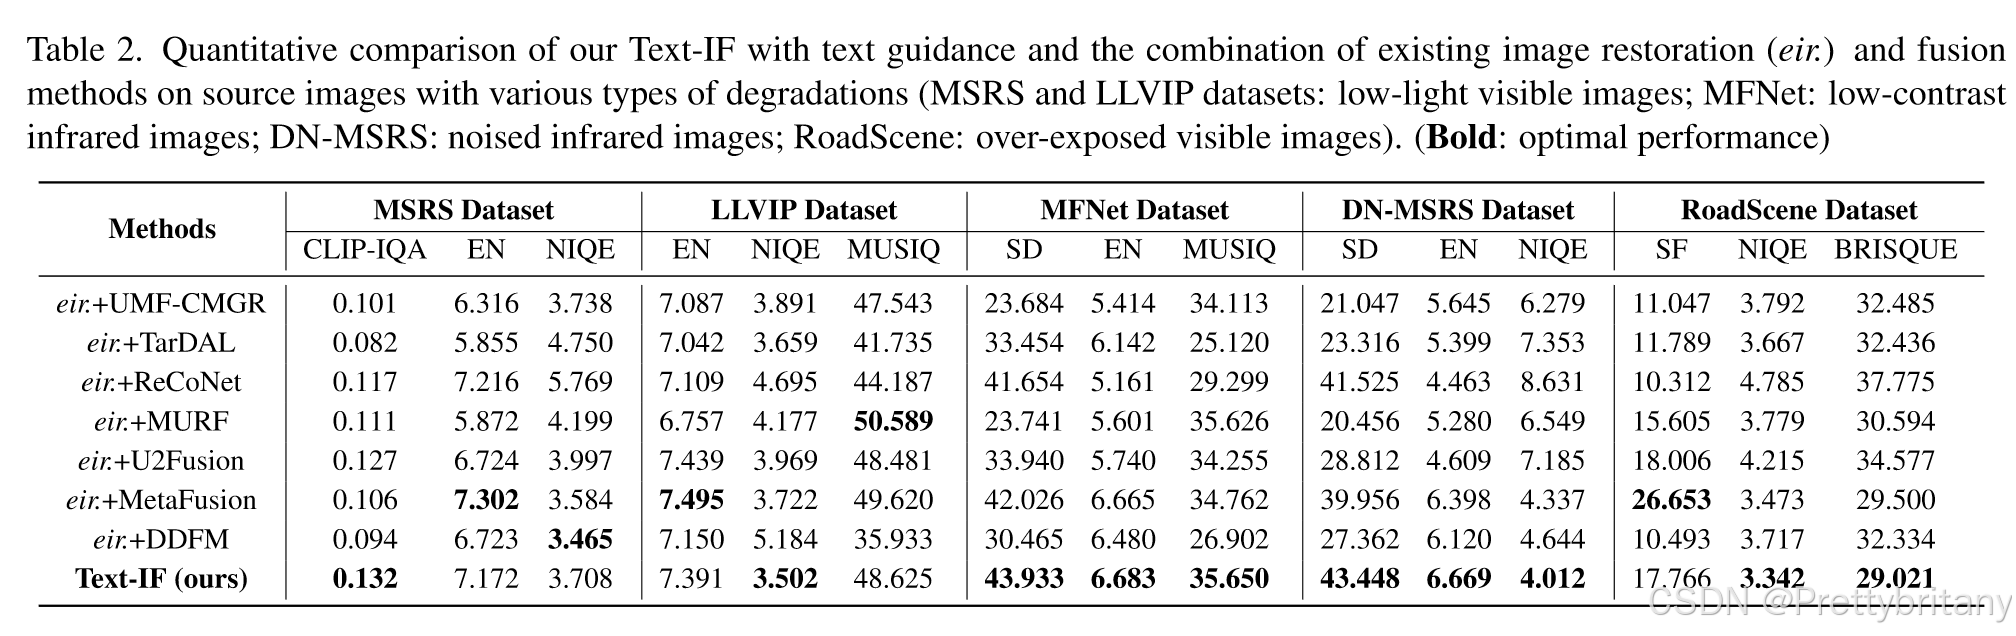
有文本引导的比较
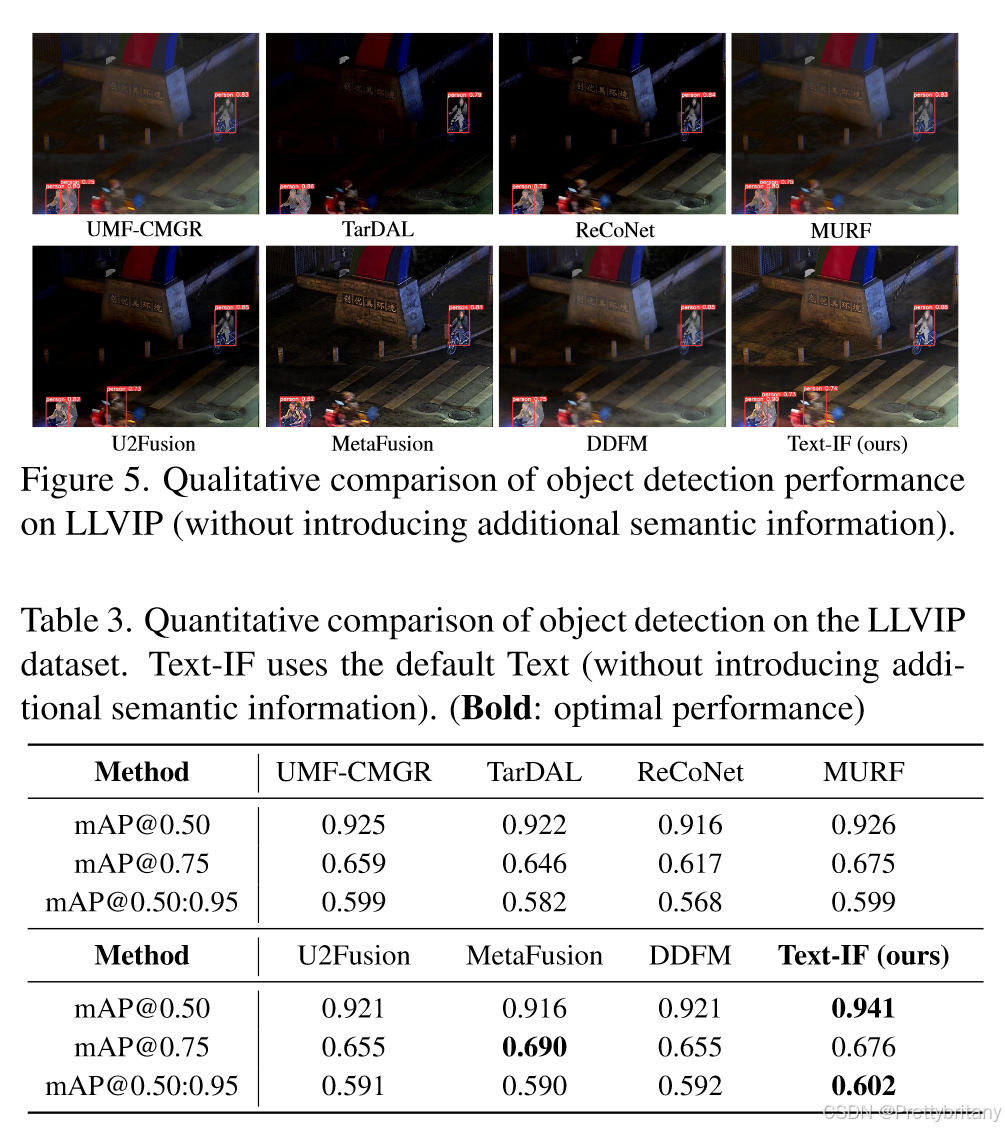
高级别任务的表现
消融实验
结论
在本文中,我们扩展了图像融合任务,提出了一种新颖的文本引导图像融合框架,以解决现有方法难以解决退化的复杂场景融合并获得用户所需的具有交互性的融合图像的问题。通过图像融合管道、文本语义特征提取和语义交互引导模块,实现文本语义引导的图像融合的目标。大量的实验结果表明该方法在融合性能和退化处理方面都具有明显的优势。使得根据交互式用户文本自由输入生成相应的融合图像成为可能,这对实践和后续的理论研究起到了促进作用。
更多推荐

 30
 0
- 0


 已为社区贡献2条内容

所有评论(0)