登录社区云,与社区用户共同成长
邀请您加入社区
对于低维度数据集,或者高维度数据集在使用pca等方法降维后,有时需要根据标签画出3维图,不同类别标签使用不同颜色。如下图所示,x,y,z为数据特征,根据类别使用不同颜色。可见,特征混叠严重,需要更换降维方法。以下,将以 kaggle中Instant Gratification数据集(二分类数据集)为例,在使用pca降维后,根据类别使用不同颜色画图。
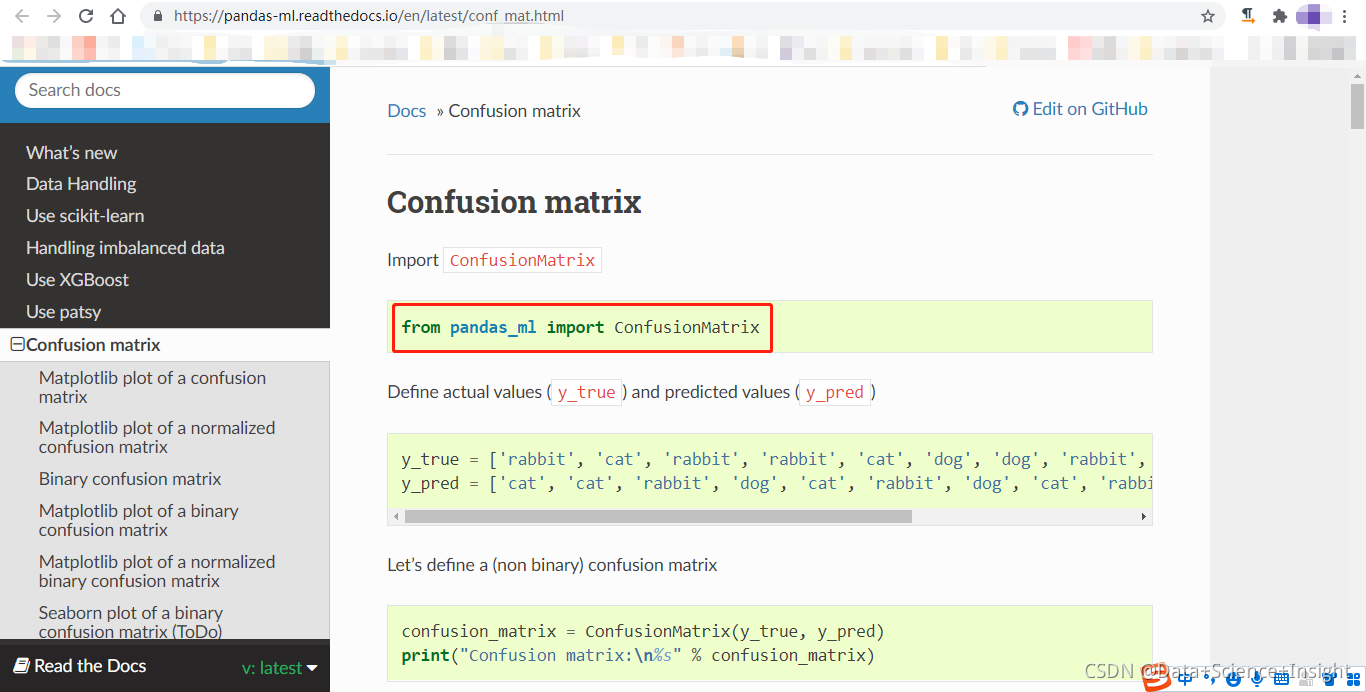
Python使用pandas_ml输出混淆矩阵以及从混淆矩阵衍生出来的其他指标:TP、TN、FP、FN、TPR、TNR(SPC)、PPV、NPV、FPR、FDR、FNR、ACC、F1、MCC等目录Python使用pandas_ml输出混淆矩阵以及从混淆矩阵衍生出来的其他指标:TP、TN、FP、FN、TPR、TNR(SPC)、PPV、NPV、FPR、FDR、FNR、ACC、F1、MCC等#panda
sklearn pandas系统环境1.安装pandas系统环境CentOS Linux release 7.7.1908 (Core)Linux version 3.10.0-1062.1.1.el7.x86_64 (mockbuild@kbuilder.bsys.centos.org) (gcc version 4.8.5 20150623 (Red Hat 4.8.5-39) (GCC...
数据集使用MovieLens数据集import pandas as pdimport numpy as npheader = ['user_id', 'item_id', 'rating', 'timestamp']dataset = pd.read_csv('../data/u.data',sep='\t',names=header)#计算唯一用户和电影的数量# unique对...
最近在做数学建模,要使用深度森林算法,于是我安装了相应的模块,但是在调用的时候,scikit-learn中的函数一直报错,如下图于是查找资料,但是找到的资料都是GitHub上的英文解决方案,因此我自己做了笔记,来帮助其他人解决这个问题。
pandas读取csv,sklearn.model_selection.train_test_split 划分训练集和验证集。
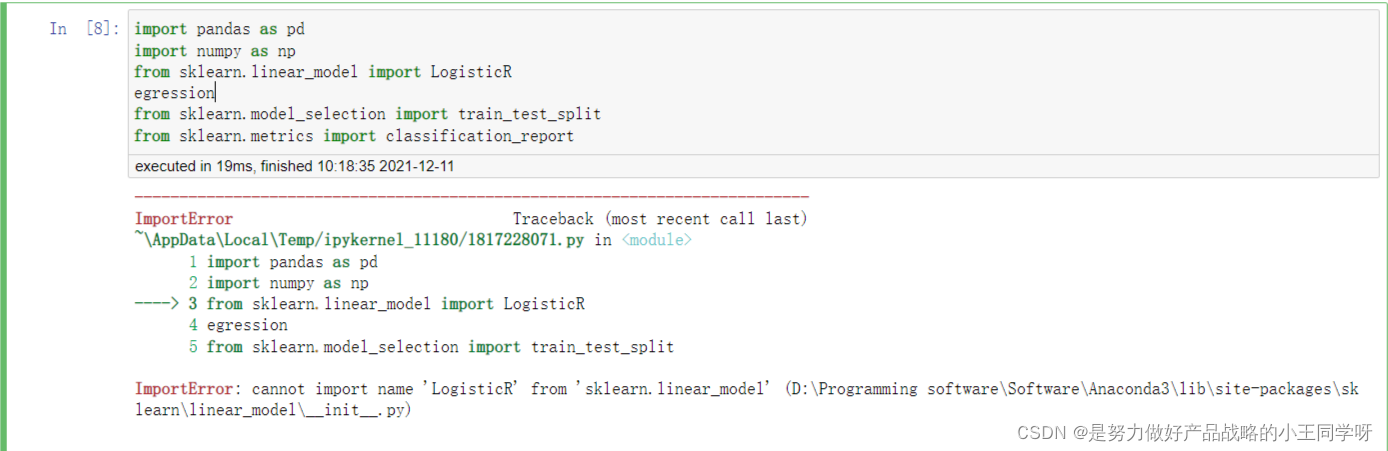
1.问题:调用sklearn出现诸如ImportError: cannot import name 'LogisticR' from 'sklearn.linear_model' (D:\Programming software\Software\Anaconda3\lib\site-packages\sklearn\linear_model\__init__.py)2.环境:我是python3,
之前下载一直失败,终于找到原因了。果然还是得多尝试,还有坚持不放弃。终于成为下图,import sklearn下方终于没有小红波浪线了。可以发现下载库时,不是直接下载sklearn库,而是下载。
使用sklearn。
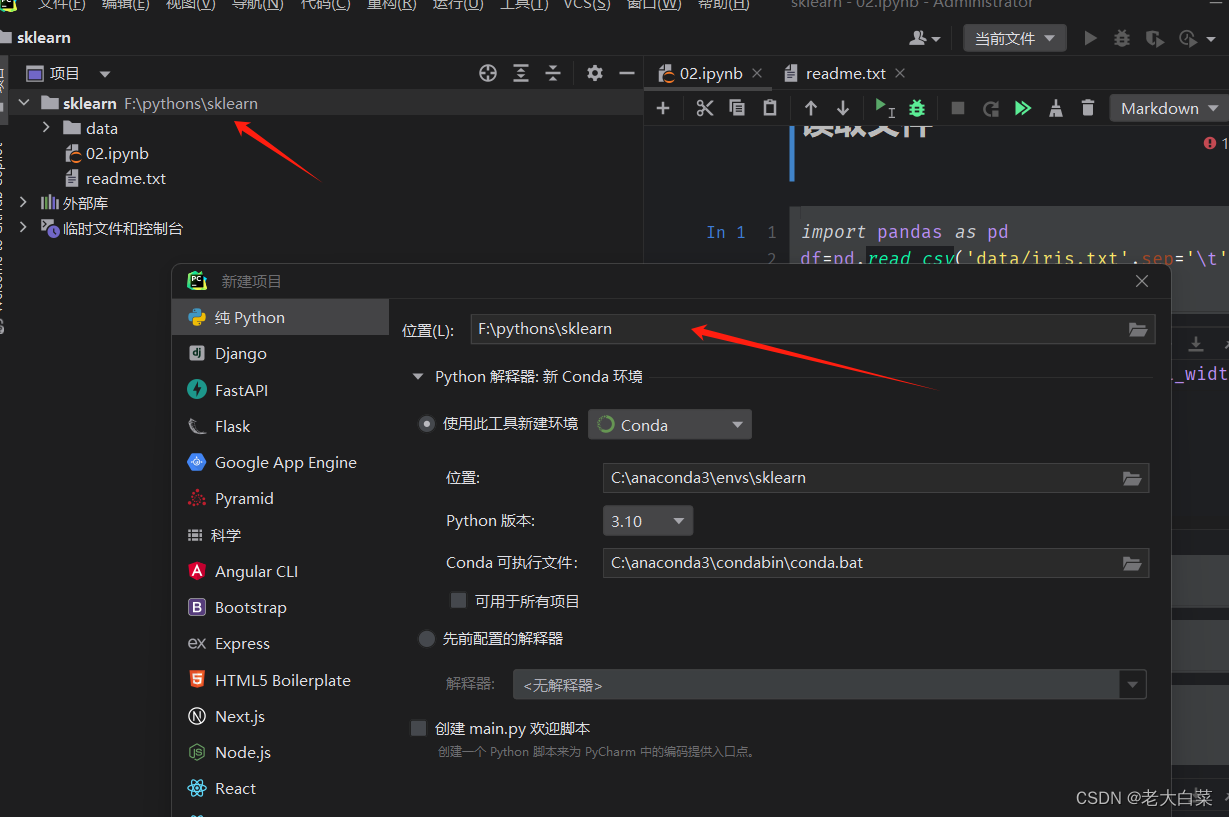
运行在jupyter 进行开发。即一个WEB端的开发工具。能适时显示开发的输出。后缀用的是ipynb.pycharm也可以支持。但也要提示按装jupyter.这里我们用pycharm进行项目创建。创建一个jupyter的文件。或直接用andcoda。
原因是python电脑的默认python版本过高,不支持安装scikit_learn==0.20.0。进入pycharm选择项目为interpreter为新创建创建的anaconda环境。在anaconda文件下的envs内寻找所创建的虚拟环境的python.exe地址。如果python版本为python3.8或更高版本进行以下操作。(如果有django记得把django环境配置也换了以防万一)寻
原因:当前设定的镜像源已经不支持该包了,所以需要重新设定。以管理员身份打开anaconda prompt。
随机森林就是通过集成学习的思想将多棵树集成的一种算法,它的基本单元是决策树,而它的本质属于机器学习的一大分支——集成学习(Ensemble Learning)方法。直观角度来解释,每棵决策树都是一个分类器(假设现在针对的是分类问题),那么对于一个输入样本,N棵树会有N个分类结果。而随机森林集成了所有的分类投票结果,将投票次数最多的类别指定为最终的输出,这就是一种最简单的 Bagging 思想。
用Anaconda + Pycharm,进行深度学习的导包和python的运行。包括通过Anaconda进行sklearn的安装。
pycharm安装sklearn方法
本文记录在python第三方库sklearn的两个评分函数 sklearn.metrics.roc_auc_score(计算AUC) 和 sklearn.metrics.f1_score(计算F1)中的参数“average”的几种方式。
K-邻近算法概述、KNN实现流程,机器学习流程,欧式距离、Scikit-learn使用K-近邻算法APIsklearn.neighbors.KNeighborsClassifier(n_neighbors=5)、kNN邻近算法距离度量、曼哈顿距离、切比雪夫距离、闵可夫斯基距离、标准化欧氏距离、余弦距离、汉明距离、杰卡德距离、马氏距离
pycharm 明明解释器里已经下载了sklearn,但还是显示找不到sklearn解决办法
【代码】【入门教程】使用pytorch和sklearn分别实现多元线性回归。
sklearn.metrics.classification_report中的Micro/Macro/Weighted Average指标
主要介绍可KNN算法的思想、基于sklearn代码的实现及其交叉验证和网格搜索
本关任务:利用sklearn对数据进行标准化。为什么要进行标准化在机器学习中常忽略数据的分布,仅仅对数值做零均值、单位标准差的处理。在一个机器学习算法的目标函数里的很多元素所有特征都近似零均值,方差具有相同的阶。如果某个特征的方差的数量级大于其它的特征,那么,这个特征可能在目标函数中占主导地位,这使得模型不能从其它特征有效地学习。三种标准化方式Z-score标准化公式:结果:对每个特征/每列来说所
1 概述1.1 什么叫“维度”对于数组和Series来说,维度就是功能shape返回的结果,shape中返回了几个数字,就是几维。索引以外的数据,不分行列的叫一维(此时shape返回唯一的维度上的数据个数),有行列之分叫二维(shape返回行*列),也称为表。一张表最多二维,复数的表构成了更高的维度。但一个数组中存在2张3行4列的表时,shape返回的是(2,3,4)。数组中的每一张表,都可以是一
众所周知,average_precision_score计算的是PR曲线下的面积,然而import numpy as npfrom sklearn.metrics import average_precision_scorey_true = np.array([0, 0, 1, 1,1,1])y_scores = np.array([0, 0.5, 0.4, 1,1,1])print (avera
本文资源:链接:https://pan.baidu.com/s/1my30wyqOk_WJD0jjM7u4TQ提取码:xxe0--来自百度网盘超级会员V1的分享中文都讲完了,英文没有什么好说的,相关的理论知识可以看之前的博客中文词向量:word2vec之skip-gram实现(不使用框架实现词向量模型)_Richard_Kim的博客-CSDN博客中文词向量:使用pytorch实现CBOW训练_Ri
线性回归的定义是:目标值预期是输入变量的线性组合。线性模型形式简单、易于建模,但却蕴含着机器学习中一些重要的基本思想。线性回归,是利用数理统计中回归分析,来确定两种或两种以上变量间相互依赖的定量关系的一种统计分析方法,运用十分广泛。优点:结果易于理解,计算不复杂缺点:对非线性的数据拟合不好适用数据类型:数值型和标称型对于单变量线性回归,例如:前面房价例子中房子的大小预测房子的价格。f(x)=w1∗
解决问题问题信息问题代码问题分析解决问题注意问题信息 •我们在pycharm中使用graphviz绘制决策树时,可能会出现下述图片中中文字体乱码的问题: •参考网上修改各种配置文件的方法,一般是不能解决问题的!,此博客介绍一种不修改配置
在phycharm中,通过pip install sklearn 方式安装sklearn出错,出现use of REX.w is meaningless (default operand size is 64)类似语句,最后安装出错。出现这个问题时,不仅安装不了sklearn,同时其他的panda类似的库也安装不了,同样报类似语句。这个问题,网上直接查PHYcharm资源解决较少,但是use of
官方文档链接:(以recall_score为例子)https://scikit-learn.org/stable/modules/generated/sklearn.metrics.recall_score.htmlprecision_score,recall_score,f1_score都需要一个average的参数。这个参数对于多类/多标签目标是必需的。如果没有(None),则返回每个类的分数
引用sklearn模型,fit之后进行模型评估时,出现该错误,代码如下:from sklearn.tree import DecisionTreeClassifierfrom sklearn.metrics import f1_scoreregressor = DecisionTreeClassifier(random_state=42)regressor.fit(X_train,y_t...
import torchfrom torch.autograd import Variableimport matplotlib.pyplot as pltfrom sklearn import datasetsfrom torch import nnfrom sklearn.model_selection import train_test_splitdigits = datas...
决策树、ID3、C4.5以及CART算法决策树模型在监督学习中非常常见,可用于分类和回归。虽然将多棵弱决策树的Bagging、Random Forest、Boosting等tree ensemble 模型更为常见,但是“完全生长”决策树因为其简单直观,具有很强的解释性,也有广泛的应用,而且决策树是tree ensemble 的基础,值得好好理解。
本文探讨了机器学习在智能制造业中的应用与挑战。在质量检测方面,机器学习克服了传统人工检查的局限性,通过CNN等算法实现高效缺陷识别;在设备故障预测方面,随机森林、GBDT等算法提升了预测准确性。文章还分析了数据收集、模型选择与部署等关键技术方法,并指出当前面临的数据质量、模型可解释性和实时性等挑战。展望未来,随着技术进步,机器学习将在智能制造中发挥更大作用,推动生产管理向高效智能化方向发展。
基于图像识别实现基本的水质检测功能