
机器学习之决策树
·
目录
前言
在机器学习中,决策树(Decision Tree)是一种重要的分类和回归方法。它以树形结构为基础,通过一系列的决策规则将数据集分割为不同的类别或预测值。本文主要介绍在机器学习中如何使用决策树思想去解决实际问题,博主结合自身所学,总结归纳了决策树中常用的API。
一、概述
1、决策树的基本概念
决策树是一种基本的分类与回归方法,它通过一系列的决策规则将数据集分割为不同的类别或预测值。在决策树中,每个内部节点代表一个属性,每条边代表一个属性取值,每个叶子节点代表一个类别或预测值。决策树的生成过程通常包括特征选择、树的构建和剪枝三个步骤。
2、决策树的构建过程
- 数据处理:对原始数据进行预处理,包括数据清洗、缺失值处理、异常值处理等,以确保数据的准确性和可靠性。
- 特征选择:根据某种评估标准(如信息增益、Gini指数等),选择能够最好地划分数据集的特征。特征选择是构建决策树的关键步骤,它直接影响到决策树的性能和准确性。
- 决策树模型构建:通过递归地对子数据集进行划分,根据选定的特征将数据集划分为多个子集,并递归地对每个子集进行同样的划分过程。当满足一定的停止条件(如子集数量、信息增益下降等)时,停止递归划分,生成叶子节点。
- 决策树可视化:将构建好的决策树以图形化的方式展示出来,方便用户理解和分析。
3、决策树的优缺点
优点:
- 计算量小,运算速度快:决策树算法相对简单,计算量较小,能够快速地处理大规模数据集。
- 判断步骤清晰,易于理解:决策树以树形结构展示决策过程,使得判断步骤清晰明了,易于理解和解释。
- 不需要太多的数据预处理:决策树算法对数据预处理的要求相对较低,不需要进行复杂的特征缩放或归一化等操作。
缺点:
- 对连续性的字段比较难预测:决策树算法在处理连续性字段时可能需要将其离散化,这可能会导致信息损失和预测精度下降。
- 对有时间顺序的数据需要很多预处理工作:对于有时间顺序的数据集,决策树算法可能需要进行更多的预处理工作来提取有用的特征。
- 当类别太多时,错误可能就会增加的比较快:在类别较多的情况下,决策树算法可能会出现过拟合现象,导致模型在测试集上的性能下降。
4、决策树的应用场景
决策树在机器学习领域有着广泛的应用,包括垃圾邮件分类、疾病诊断、客户信用评级等分类问题,以及房价预测、股票价格预测等回归问题。此外,决策树还可以与其他机器学习算法结合使用,以提高模型的性能和准确性。
二、决策树
1、定义

2、构建过程

3、注意事项

4、API

三、ID3决策树
1、信息增益

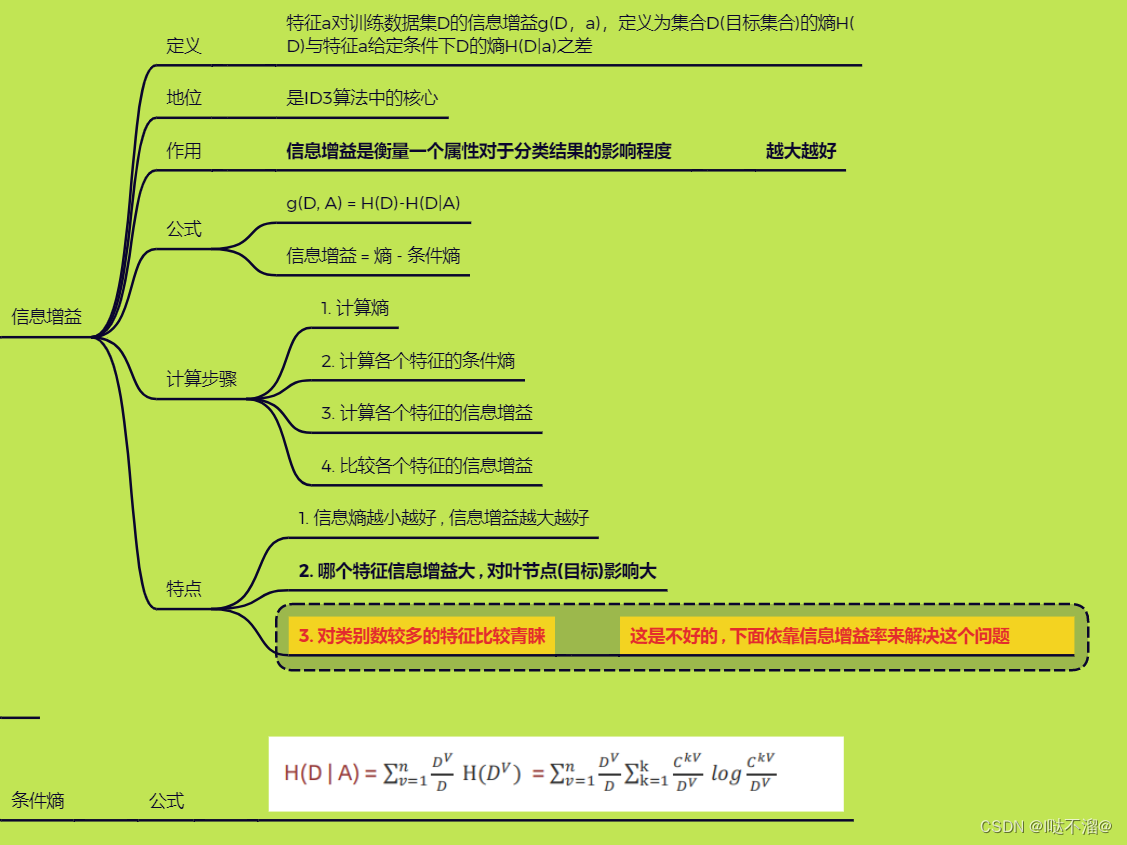
2、ID3的构建过程

3、举例说明

四、C4.5决策树
1、信息增益率

2、举例说明

五、CART分类决策树
1、定义和分类

2、基尼值和基尼指数

3、构建过程

六、CART回归树
1、定义和特点

2、构建过程

3、CART回归树和分类树的区别

七、三种树结构的对比

八、剪枝
1、定义和作用

2、代码实现

3、优缺点

九、总结
总之,决策树是机器学习领域的重要算法之一,它以树形结构为基础,通过一系列的决策规则将数据集分割为不同的类别或预测值。在实际应用中,我们可以根据具体问题的特点和需求选择合适的决策树算法进行建模和预测。
更多推荐

 30
 0
- 0


 已为社区贡献1条内容

所有评论(0)