
阿里面试官问:为什么Transformer的FFN需要升维再降维?
阿里面试官问:为什么Transformer的FFN需要升维再降维?
面试题
为什么Transformer的FFN需要升维再降维?
标准答案
1.FFN并非简单的嵌入空间建模
FFN的目标不是直接在输入维度上进行建模,而是通过一系列线性变换来拟合一个高维的映射空间。若仅使用线性基,理论上我们只需使用等同于输入维度的基数量。然而,所有可能的平滑映射组成的空间是无限维的,因而需要通过升维来完整表示这一空间。
2. 升维的作用:近似无限维空间
FFN的第一个线性层及激活函数组合,可以看作是在学习一组基函数,每个神经元可以视作一个简单的分类器,用以近似输入数据的高维映射。升维操作有效扩展了网络的自由度,使得模型能够学习更多的特征表示,从而提升模型的拟合能力。
3. 降维的目的:限制计算复杂度
尽管升维有助于捕捉更多的信息,但理论上需要无限多的自由度来表达完整的光滑映射。然而,实践中我们不可能拥有无限的计算资源,因此必须通过降维来控制网络的规模和计算复杂度。降维操作通过将高维表示映射回较低维空间,有效地控制了模型的复杂度。
4. 键值对存储的视角
从另一个角度来看,FFN可以类比为一种键值对存储结构。第一个线性层生成“键”,即为每个token计算一组召回权重;第二个线性层则计算“值”,并与召回权重进行加权求和。这种方式类似于通过大规模的记忆存储(升维)来提升网络的长期记忆能力。
5. 基于聚类的视角
FFN也可以理解为基于软聚类的向量量化。第一个线性层为每个token分配一个聚类簇权重,而第二个线性层则提供每个簇的代表性输出。这种视角下,升维操作实际上是在增加聚类簇的数量,从而降低量化误差。
6. 升维的局限性
尽管升维带来更多的特征表示,但隐藏维度(或键值对数量)并非越大越好。过多的隐藏维度可能导致信息瓶颈和过拟合,甚至使模型难以有效传递信息。因此,合理的升维和降维设置是确保模型高效和稳定的关键。综上所述,FFN的升维操作本质上是为了拟合一个更高维的映射空间,从而提升模型的表达能力和拟合精度。通过合理的升维与降维,可以平衡计算效率和模型性能。
如何系统的去学习大模型LLM ?
作为一名热心肠的互联网老兵,我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。
但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的 AI大模型资料 包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
😝有需要的小伙伴,可以V扫描下方二维码免费领取🆓

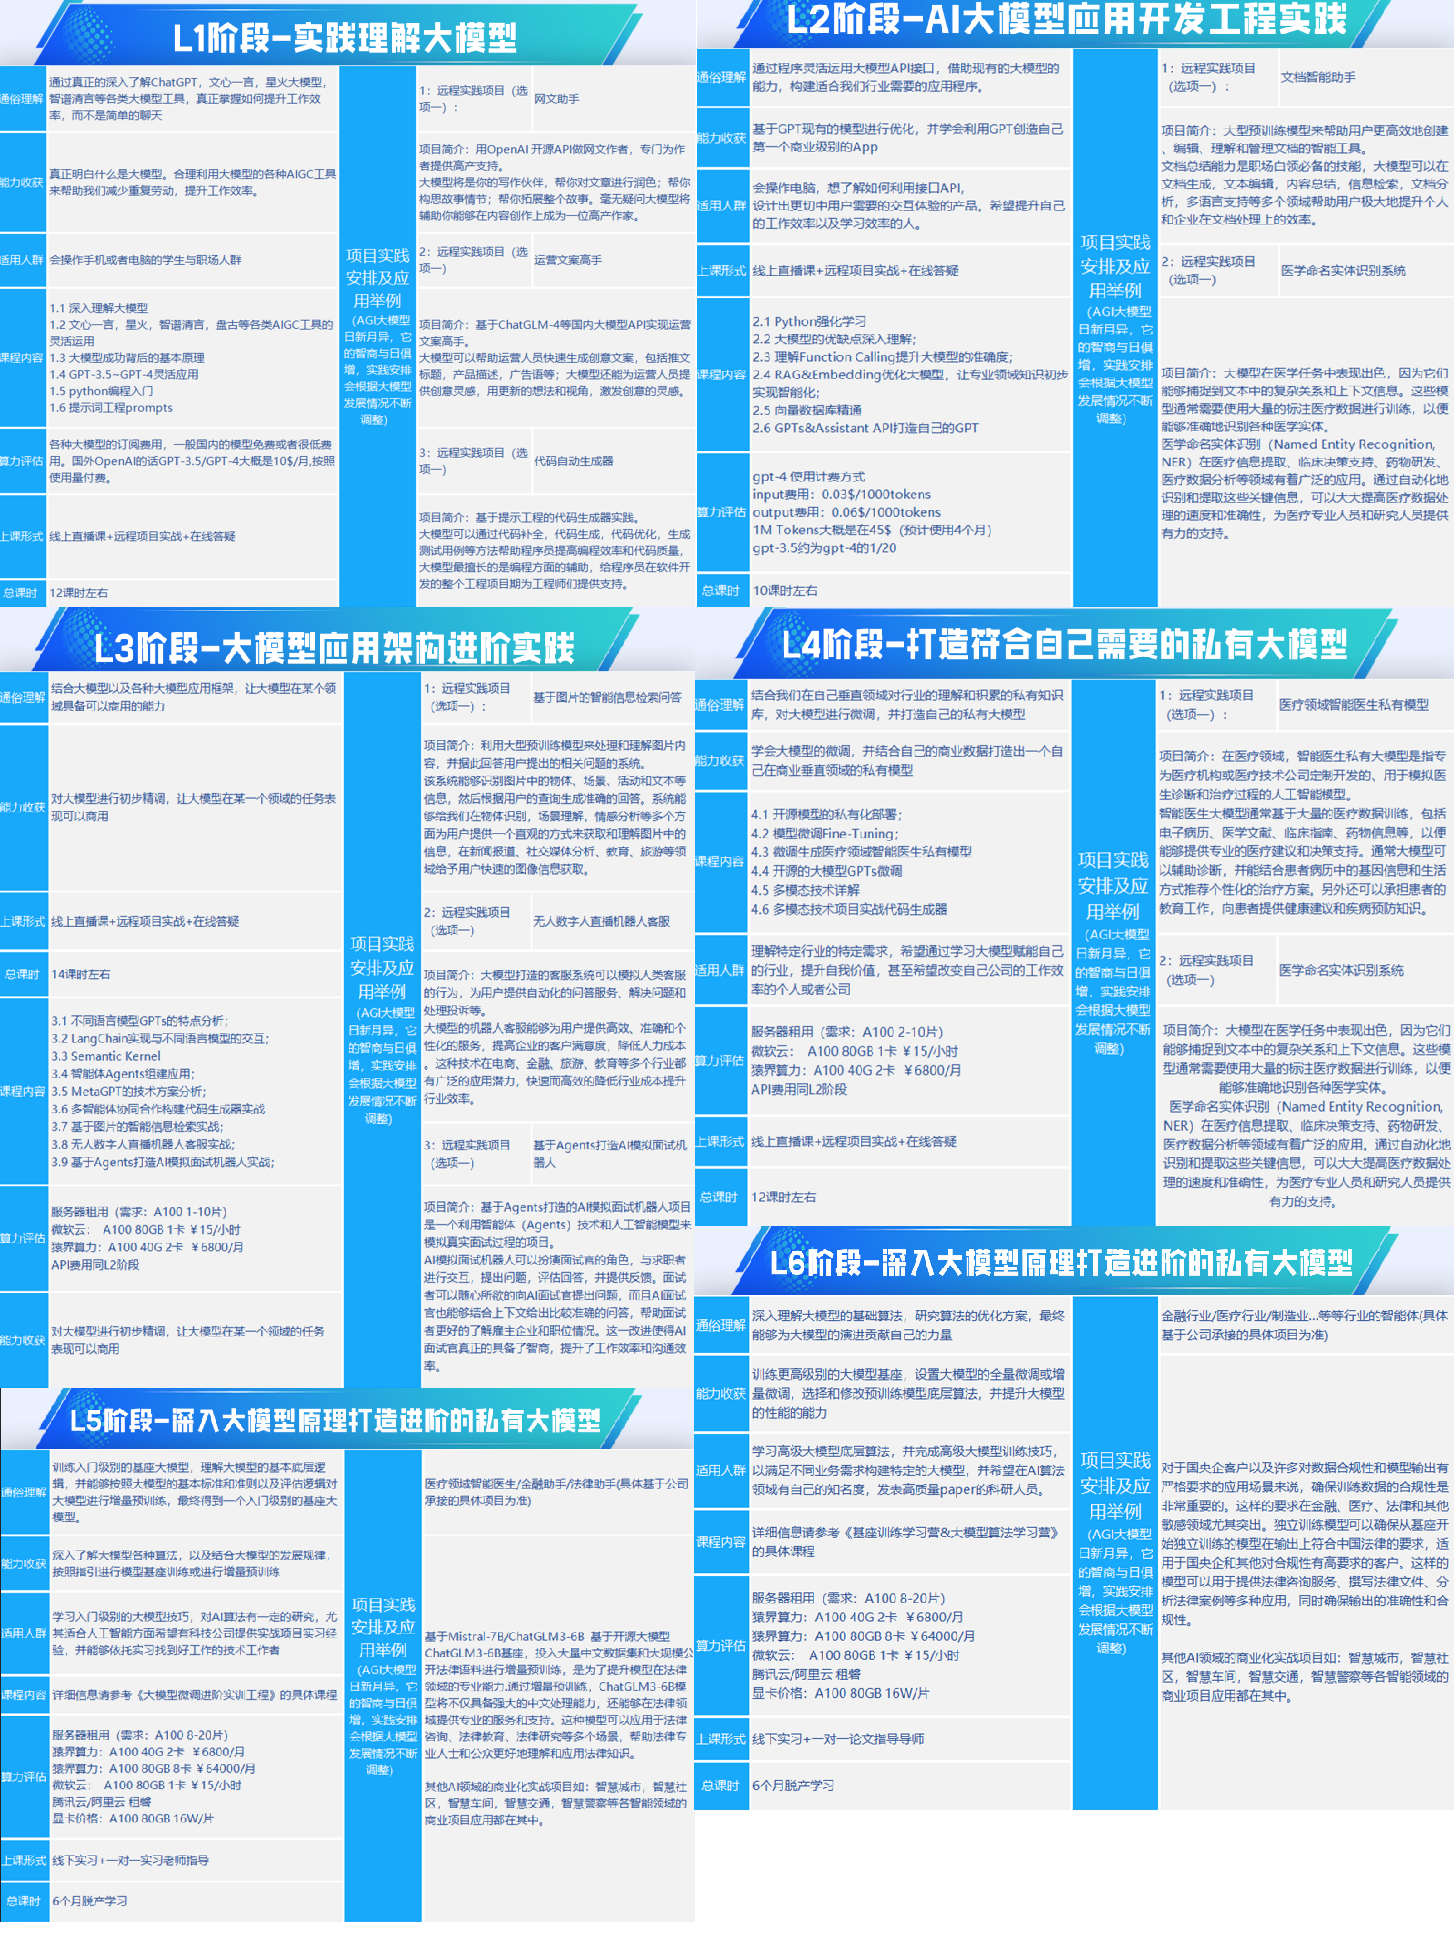
一、全套AGI大模型学习路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!
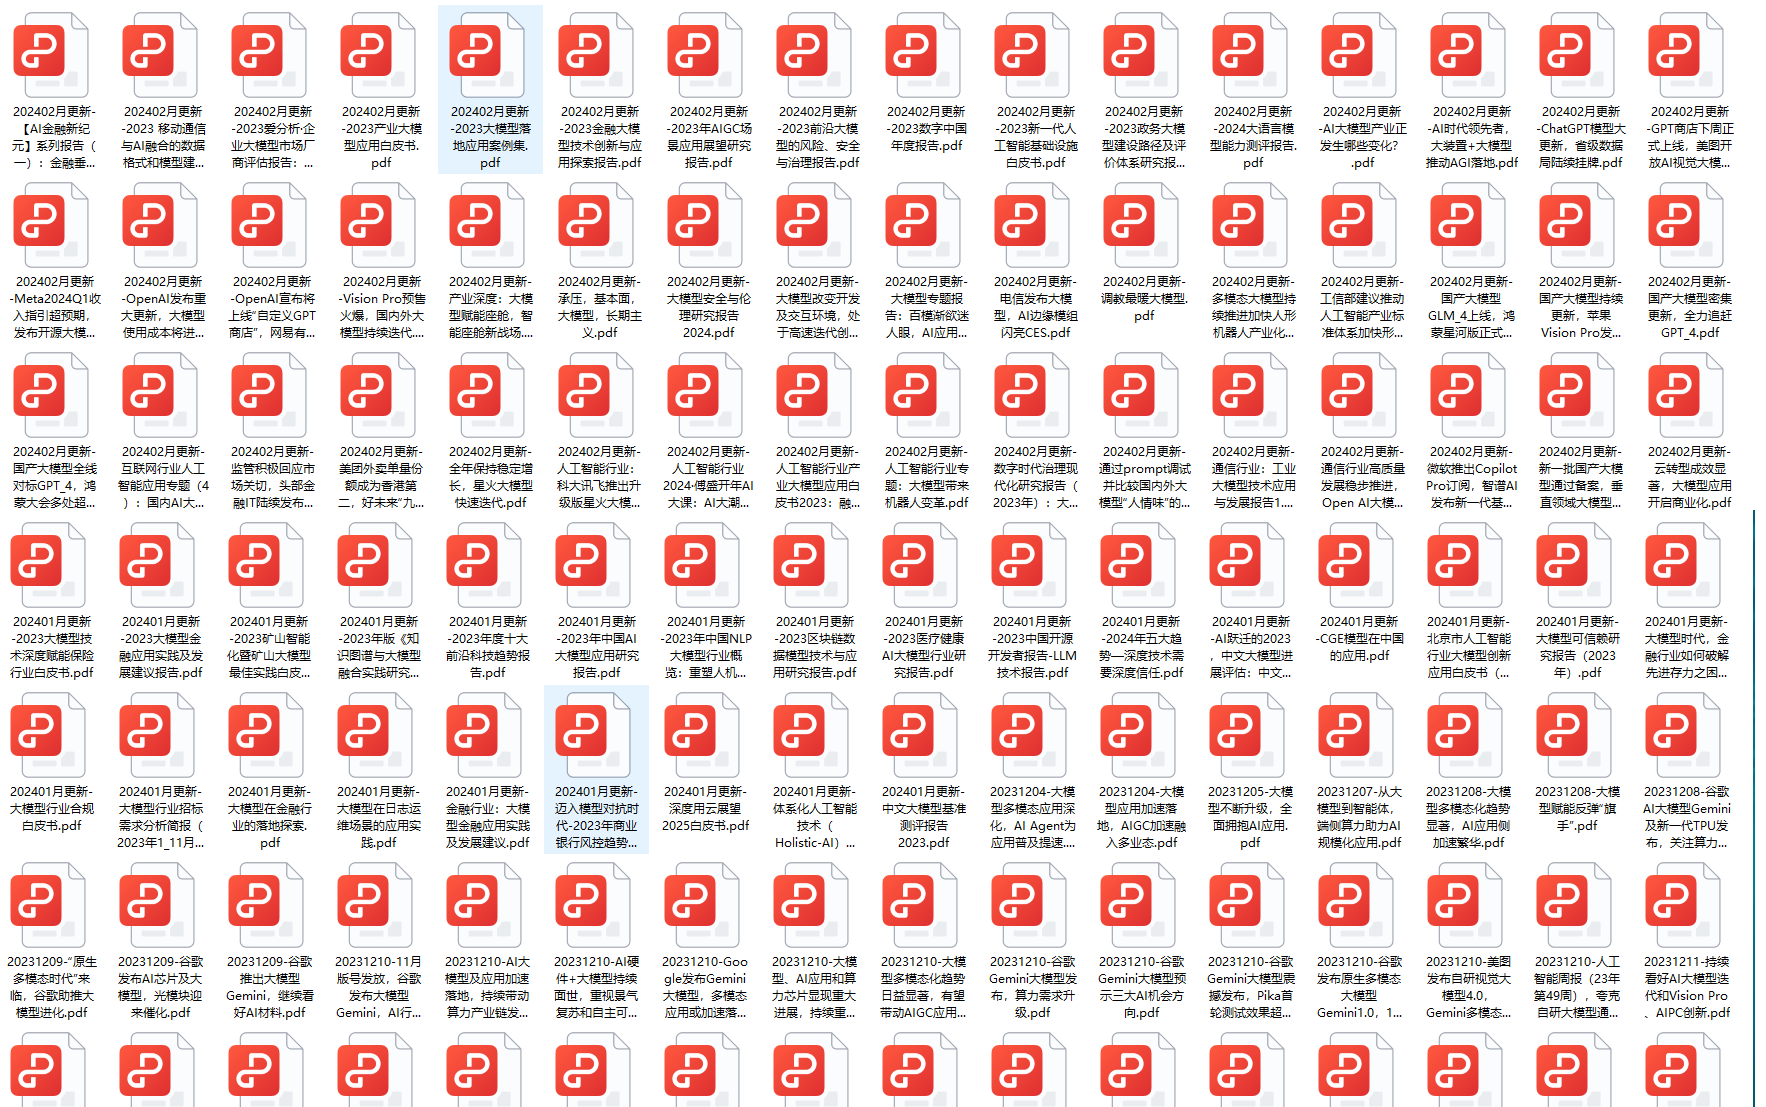
二、640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。
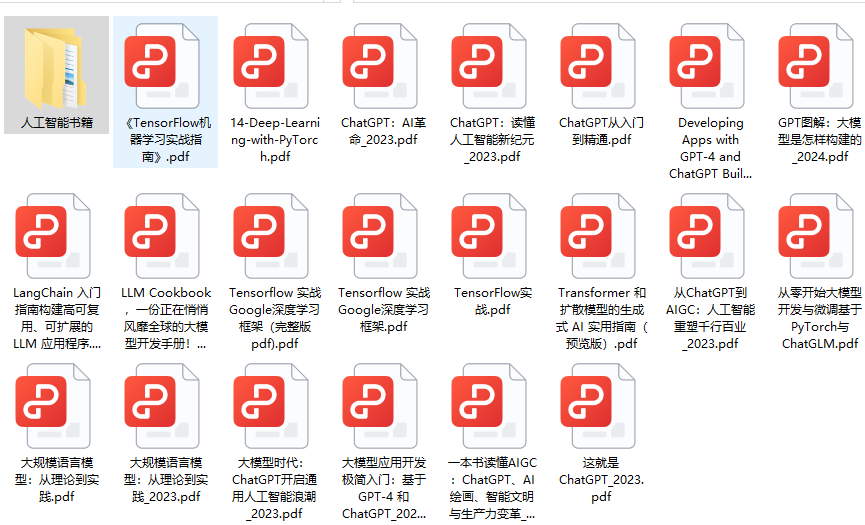
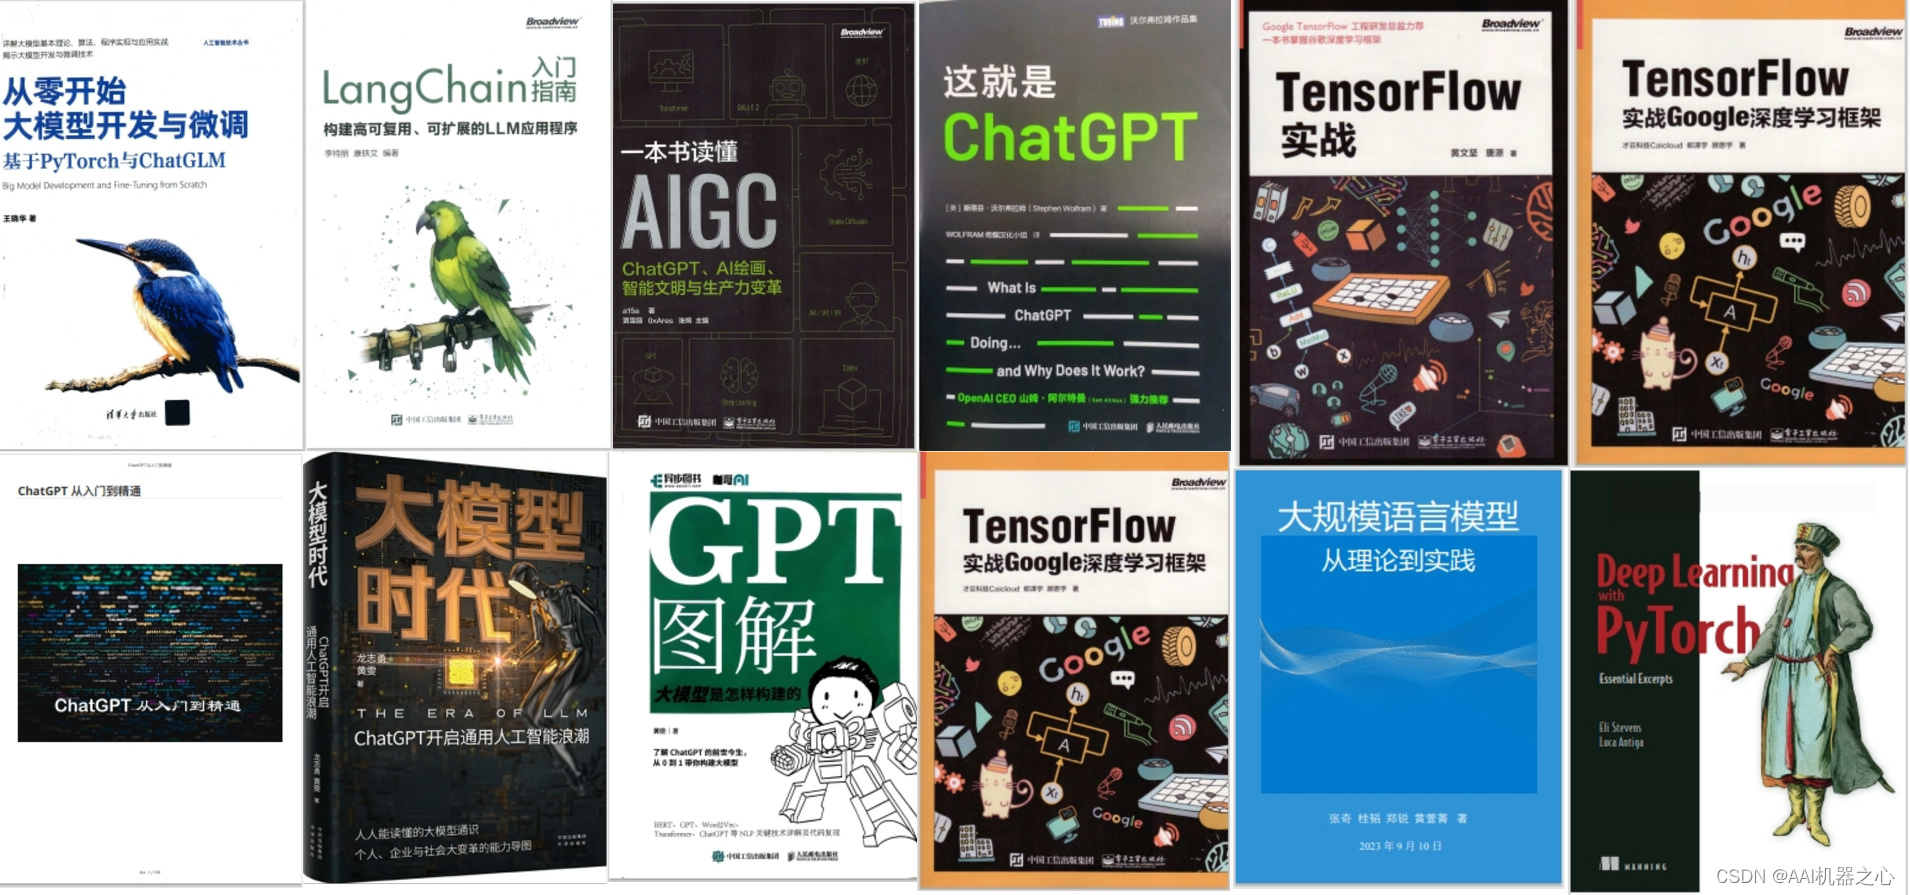
三、AI大模型经典PDF籍
随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。
四、AI大模型商业化落地方案

阶段1:AI大模型时代的基础理解
- 目标:了解AI大模型的基本概念、发展历程和核心原理。
- 内容:
- L1.1 人工智能简述与大模型起源
- L1.2 大模型与通用人工智能
- L1.3 GPT模型的发展历程
- L1.4 模型工程
- L1.4.1 知识大模型
- L1.4.2 生产大模型
- L1.4.3 模型工程方法论
- L1.4.4 模型工程实践 - L1.5 GPT应用案例
阶段2:AI大模型API应用开发工程
- 目标:掌握AI大模型API的使用和开发,以及相关的编程技能。
- 内容:
- L2.1 API接口
- L2.1.1 OpenAI API接口
- L2.1.2 Python接口接入
- L2.1.3 BOT工具类框架
- L2.1.4 代码示例 - L2.2 Prompt框架
- L2.2.1 什么是Prompt
- L2.2.2 Prompt框架应用现状
- L2.2.3 基于GPTAS的Prompt框架
- L2.2.4 Prompt框架与Thought
- L2.2.5 Prompt框架与提示词 - L2.3 流水线工程
- L2.3.1 流水线工程的概念
- L2.3.2 流水线工程的优点
- L2.3.3 流水线工程的应用 - L2.4 总结与展望
- L2.1 API接口
阶段3:AI大模型应用架构实践
- 目标:深入理解AI大模型的应用架构,并能够进行私有化部署。
- 内容:
- L3.1 Agent模型框架
- L3.1.1 Agent模型框架的设计理念
- L3.1.2 Agent模型框架的核心组件
- L3.1.3 Agent模型框架的实现细节 - L3.2 MetaGPT
- L3.2.1 MetaGPT的基本概念
- L3.2.2 MetaGPT的工作原理
- L3.2.3 MetaGPT的应用场景 - L3.3 ChatGLM
- L3.3.1 ChatGLM的特点
- L3.3.2 ChatGLM的开发环境
- L3.3.3 ChatGLM的使用示例 - L3.4 LLAMA
- L3.4.1 LLAMA的特点
- L3.4.2 LLAMA的开发环境
- L3.4.3 LLAMA的使用示例 - L3.5 其他大模型介绍
- L3.1 Agent模型框架
阶段4:AI大模型私有化部署
- 目标:掌握多种AI大模型的私有化部署,包括多模态和特定领域模型。
- 内容:
- L4.1 模型私有化部署概述
- L4.2 模型私有化部署的关键技术
- L4.3 模型私有化部署的实施步骤
- L4.4 模型私有化部署的应用场景
学习计划:
- 阶段1:1-2个月,建立AI大模型的基础知识体系。
- 阶段2:2-3个月,专注于API应用开发能力的提升。
- 阶段3:3-4个月,深入实践AI大模型的应用架构和私有化部署。
- 阶段4:4-5个月,专注于高级模型的应用和部署。
这份完整版的大模型 LLM 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】
😝有需要的小伙伴,可以Vx扫描下方二维码免费领取🆓

更多推荐


 23
 0
- 0


 已为社区贡献8条内容

所有评论(0)