
使用通俗的语言解释一下Word2Vec 是如何生成词嵌入(word embeddings)的
前言
前几天,在我学习word2vec的时候,实在是没有办法理解(蒟蒻)这个模型是怎么运行的,在经过我多方查阅之后,终于理解了其的运行原理,所以通过这篇博客,来分享我的喜悦以及记录我的思路与理解(如果可以帮助到同样被这个问题困扰的人,那就更好WWW)多说无益,接下来正式开始!
第一部分:背景介绍以及知识铺垫
1.1:背景介绍
在传统的 NLP 方法中,单词通常被表示为稀疏的 one-hot 向量。假设词汇表大小为 ,每个单词都对应于一个长度为 的向量,其中只有一个位置为 1,其余为 0。这种表示方式虽然简单,但有明显的缺点:
- 维度灾难:当词汇量很大时,one-hot 向量的维度也会很高,增加了计算复杂度。
- 缺乏语义信息:one-hot 向量无法捕捉单词之间的语义和语法关系。
因此,研究者们开始探索如何将单词表示为低维度的稠密向量(通常是 50-300 维),并且这些向量能够捕捉单词之间的语义和语法关系。
Word2Vec 的提出
Word2Vec 的提出解决了上述问题,它通过深度学习模型将单词映射到低维连续向量空间中,并且这些向量能够有效捕捉单词之间的语义和语法关系。
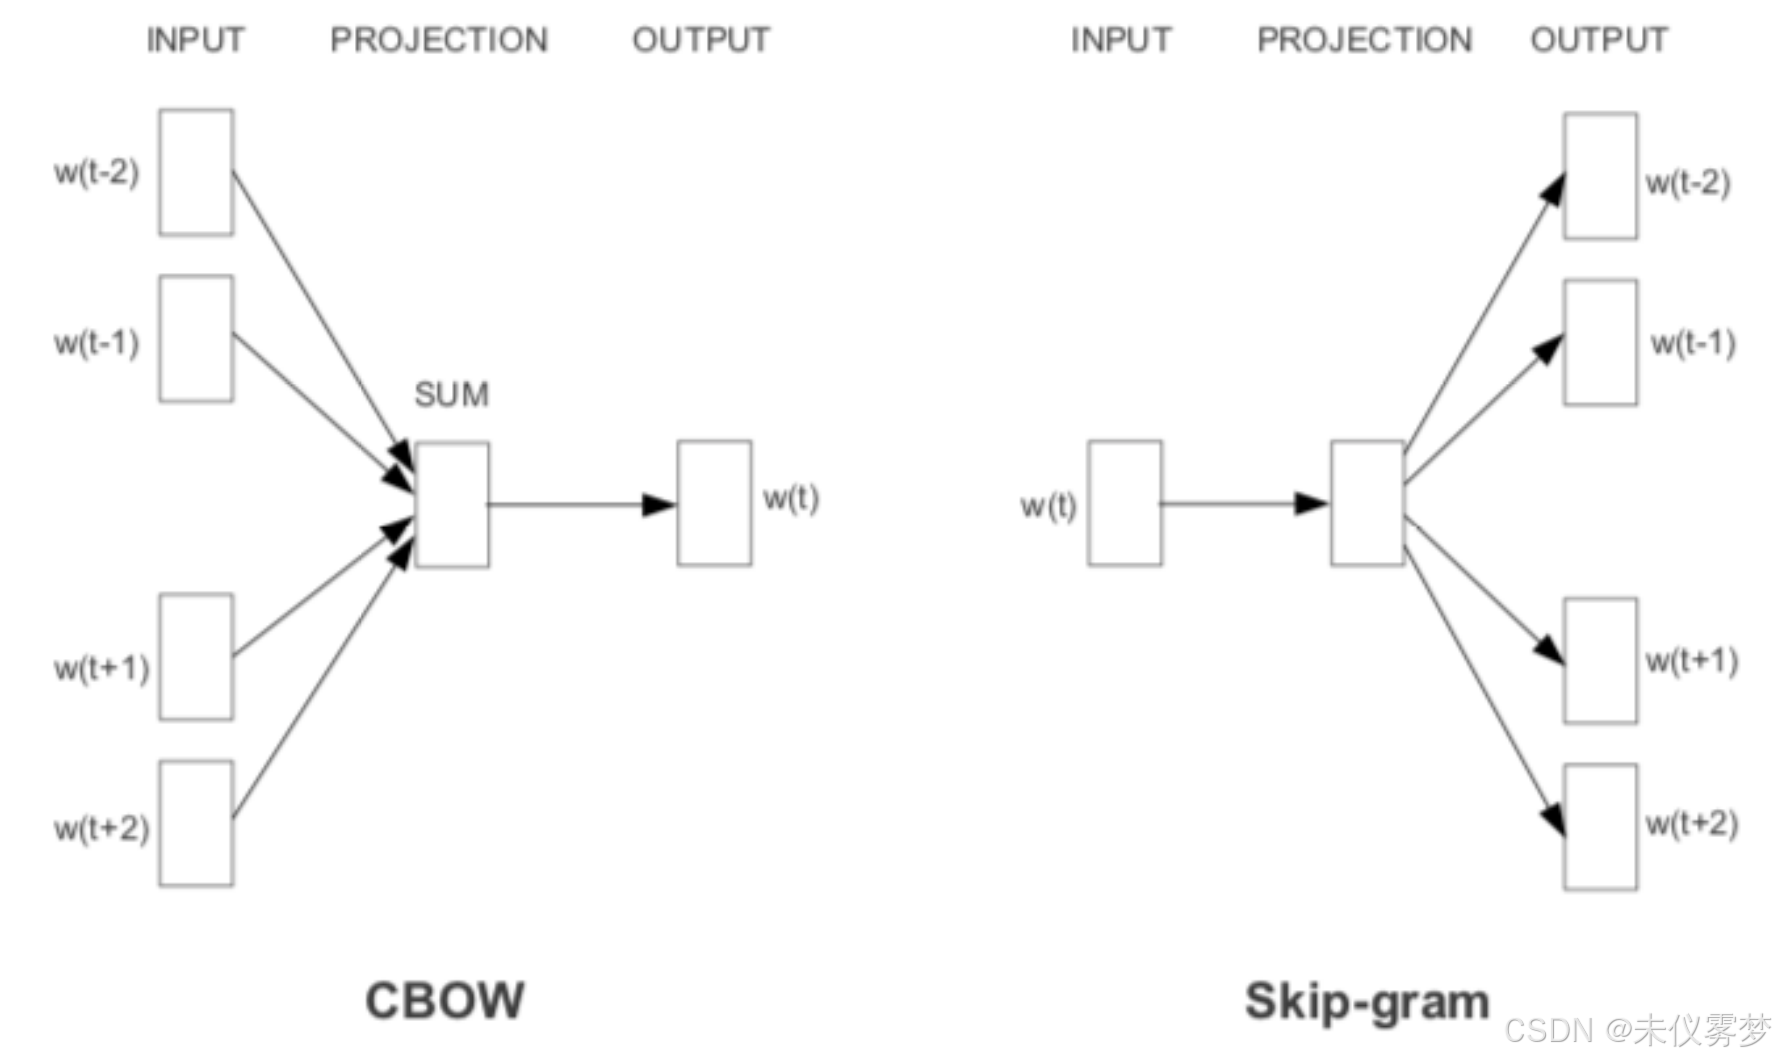
Word2Vec 主要包括两种模型:
- CBOW(Continuous Bag of Words):根据上下文单词预测目标单词。
- Skip-Gram:根据目标单词预测上下文单词。
1.2:知识铺垫
讲讲在推导过程中会用到的几个函数以及它的作用
1.2.1One-Hot编码简介
One-Hot编码是一种将类别型变量转换为数值型变量的方法,常用于机器学习模型中。由于许多机器学习算法无法直接处理类别数据,因此需要将类别数据转换为数值形式。One-Hot编码通过为每个类别创建一个新的二进制列(取值为0或1)来表示该类别是否存在。
One-Hot编码的步骤
- 确定类别数量:假设我们有N个不同的类别。
- 创建新列:为每个类别创建一个新的列,列的数量等于类别的数量N。
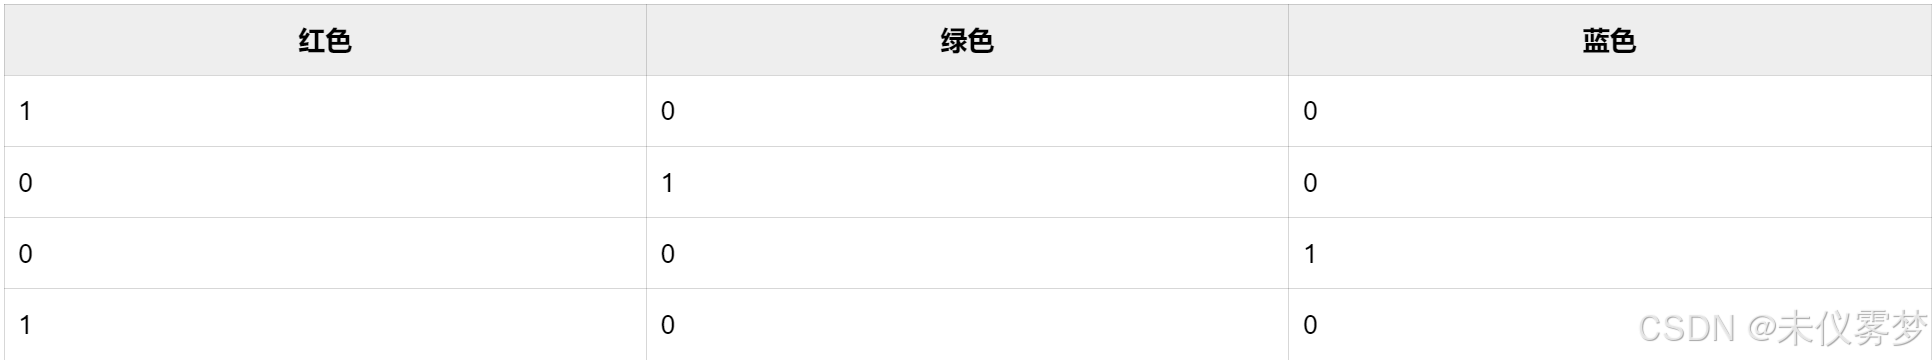
- 填充值:对于每一个样本,如果它属于某个类别,则在对应的列中填充1,否则填充0。
假设我们有一个数据集,其中包含一个“颜色”列,可能的值为“红色”、“绿色”和“蓝色”。我们希望将“颜色”列转换为One-Hot编码。
One-Hot编码后的数据
1.2.2softmax函数
Softmax 是 Word2Vec 中用于概率归一化的关键工具。它的作用是将模型输出的得分(logits)转换为概率分布,便于计算损失函数。
假设模型的输出是一个向量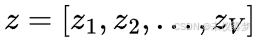 ,其中
 是词汇表的大小。Softmax 函数的公式如下:
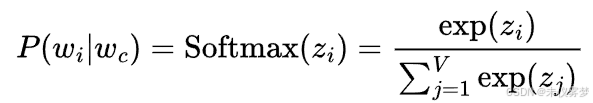
简略推导过程(详细过程见我的另一篇博客):
这里:
 是上下文词(context word)。
-
 是目标词(target word)。
-
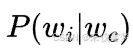 表示给定上下文词,目标词的概率。
Softmax 的主要作用是将输出分布转换为概率分布,从而可以通过最大似然估计来优化模型。
1.2.3似然函数与最大似然估计 (MLE)
在 Word2Vec 中,目标是最大化给定上下文词的条件下目标词的似然概率。具体来说,Word2Vec 的目标是通过优化以下似然函数来学习词向量:
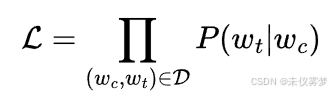
其中:
-
 是训练数据集。
-
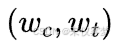 是上下文词和目标词的配对。
为了便于优化,通常将乘积转换为对数似然(log-likelihood),并对数似然函数取负值,得到损失函数:
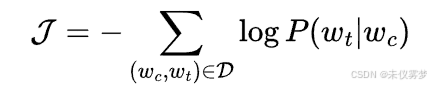
最大似然估计的目标是最小化这个损失函数,从而使模型更好地预测目标词。(最大似然函数的推导细节见另一博客)
第二部分:过程推导
Word2Vec 主要有两种模型架构:Skip-Gram 和 Continuous Bag of Words (CBOW)。接下来我们将以 Skip-Gram 为例,详细解释 Word2Vec 的工作原理和推导过程。
2.1 Skip-Gram 模型简介
Skip-Gram 模型的目标是通过给定中心词(center word)预测其上下文词(context words)。假设我们有一个句子,Skip-Gram 会根据中心词来预测其周围的单词。
2.2 模型架构
Skip-Gram 模型的输入是一个单词,输出是该单词周围窗口内的上下文单词。模型的核心部分是一个简单的神经网络,它有两层:
- 输入层:将单词表示为 one-hot 向量。
- 隐藏层:将单词映射到一个低维稠密的向量空间(即词嵌入)。
- 输出层:预测上下文单词的概率分布。
2.3 具体步骤
2.3.1 输入表示
假设词汇表大小为 ,每个单词被表示为一个 one-hot 向量
 ,其中只有一个元素为 1,其余为 0。例如,如果词汇表中有 5 个单词,第三个单词的 one-hot 向量为
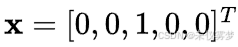 。
2.3.2 隐藏层
隐藏层是一个全连接层,它将 one-hot 向量映射到一个低维稠密的向量空间。假设词嵌入的维度为 ,那么隐藏层的权重矩阵
 是一个
 的矩阵。隐藏层的输出
 可以表示为:
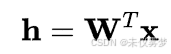
由于是 one-hot 向量, 实际上就是中与对应行。例如,如果是第三个单词的 one-hot 向量,那么就是的第三行。
需要注意的是,权重矩阵是随机初始化的,这是神经网络训练的常见做法。具体来说,Word2Vec 的两个权重矩阵(输入层到隐藏层的权重矩阵)和 (隐藏层到输出层的权重矩阵)在训练开始时通常是随机初始化的。
在 Word2Vec 中,权重矩阵通常采用以下方法初始化:
从均匀分布中随机采样权重值。例如,权重值可以从区间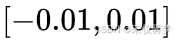 中随机采样。 例子:
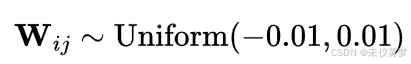
Word2Vec 的权重矩阵在训练开始时是随机初始化的,通常采用均匀分布或正态分布。随机初始化有助于打破对称性,促进梯度传播,并提高模型的训练效率。在训练过程中,权重会通过梯度下降法逐步优化,最终生成能够捕捉语义关系的词嵌入。
2.3.3 输出层
输出层的目标是根据隐藏层的输出来预测上下文单词的分布。输出层的权重矩阵是一个 的矩阵。输出层的未归一化得分
 可以表示为:
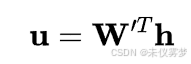
然后,我们通过 softmax 函数将转换为概率分布:
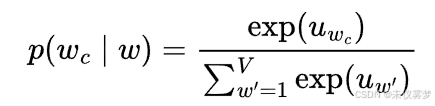
那么为什么要归一化呢?
未归一化得分表示的是模型对每个上下文词的“原始打分”。这些分数有以下特点:
- 未归一化:这些分数还没有被归一化为概率值,它们的总和不一定为 1。
- 相对大小有意义:分数的大小反映了模型认为某个上下文词与中心词的“相关性”有多强。分数越高,表示模型认为这个词更可能是上下文词。
其中中的每个 表示模型对词汇表中第
 个单词的“相关性打分”。具体来说:
得分 的大小反映了模型认为第个单词与中心词的“相关性”有多强。得分越高,表示模型认为该单词越可能是上下文词。
2.3.4损失函数
Skip-Gram 模型的目标是最大化给定中心词时,上下文单词出现的条件概率。因此,损失函数是负的对数似然:
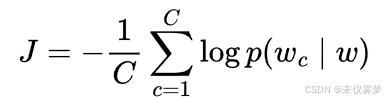
其中, 是上下文滑动窗口的大小。
什么是滑动窗口?
滑动窗口是一个固定大小的窗口,用于在目标词的周围选择上下文词。假设窗口大小为 ,窗口会从目标词的左侧或右侧滑动,选择最接近的 个词作为上下文词。
例如,在句子 "I love natural language processing." 中:
- 如果窗口大小
 ,目标词是
"natural",那么其上下文词为"love"和"language"。
滑动窗口的作用
滑动窗口在 Skip-gram 中的主要作用是:
- 定义上下文范围:滑动窗口限定了目标词的上下文词数量,从而定义了模型需要预测的上下文词的边界。
- 构建训练样本:通过滑动窗口,模型可以生成大量目标词和上下文词的配对样本,用于训练词向量。
- 捕捉局部上下文信息:窗口大小决定了模型能够捕捉的上下文范围。较小的窗口更关注局部上下文(如词法和语法关系),而较大的窗口可以捕捉更多的语义信息。
2.3.5 梯度下降
为了优化损失函数,我们使用梯度下降法来更新权重矩阵和。
1.损失函数
Skip-Gram 模型的损失函数是负对数似然(Negative Log-Likelihood, NLL),公式为:
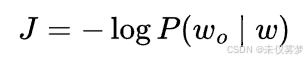
其中,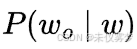 是给定中心词
 时,目标上下文词
 的预测概率。
2.反向传播算法
反向传播算法通过链式法则计算损失函数对权重矩阵 和
 的梯度。具体步骤如下:
(1) 计算损失函数对 的梯度
首先,计算损失函数对未归一化得分 的梯度。
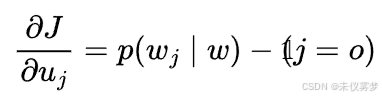
其中:
-
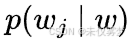 是 softmax 输出的概率。
- 𝟙
 是指示函数,当
 时为 1,否则为 0。
因此, 是一个
 -维向量,形式为:
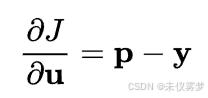
其中:
 是 softmax 输出的概率分布向量。
 是目标中心词
 的 one-hot 向量。
(2) 计算损失函数对 的梯度
通过链式法则,损失函数对输出层权重矩阵 的梯度为:
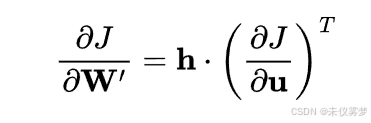
也就是:
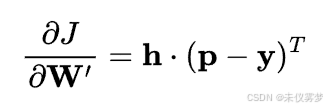
(3) 计算损失函数对 的梯度
损失函数对隐藏层输出 的梯度为:
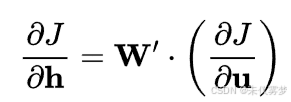
(4)计算损失函数对 的梯度
由于 是上下文词向量的平均值,损失函数对每个上下文词向量的梯度为:
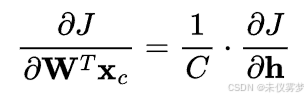
因此,损失函数对输入层权重矩阵 的梯度为:
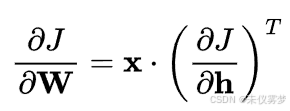
以下是反向传播算法的伪代码:
# 输入:中心词 x, 目标上下文词 y, 隐藏层输出 h, 未归一化得分 u, softmax输出 p
# 输出:梯度 dW 和 dW'

# 计算损失函数对 u 的梯度 (V 维向量)
dJ_du = p - y

# 计算损失函数对 W' 的梯度 (d x V 矩阵)
dW' = np.outer(h, dJ_du)

# 计算损失函数对 h 的梯度 (d 维向量)
dJ_dh = W' @ dJ_du

# 计算损失函数对 W 的梯度 (V x d 矩阵)
dW = np.outer(x, dJ_dh)

# 返回梯度和
return dW, dW'
最终,通过梯度下降法更新权重矩阵:
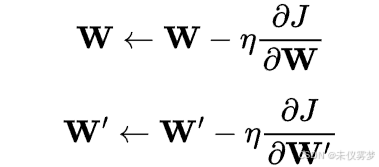
其中,  是学习率。
(/////燃尽了,累死我了。。。。。。。。。。。。写的有点乱啊hhhh。。。。至于反向传播那块还是自己推导一下吧,感觉写的有点乱。。。投降了,以后有时间再改)
更多推荐

 12
 0
- 0


 已为社区贡献1条内容

所有评论(0)