
A Comprehensive Study of Real-Time Object Detection Networks Across Multiple Domains跨多个领域的实时目标检测网络综述
《A Comprehensive Study of Real-Time Object Detection Networks Across Multiple Domains: A Survey》是一篇较为全面的实时目标检测综述,其对常见的开源实时目标检测算法进行了比较研究,从精度、速度、鲁棒性、消耗能量等角度做了细致的比较,非常值得参考。这里是自己的论文阅读记录,感兴趣的话可以参考一下,如果想要直接阅读原文,可以看这里,如下所示:
摘要
基于深度神经网络的目标检测器不断发展,并被应用于多种应用中,每个应用都有其独特的需求。虽然安全关键型应用需要高精度和可靠性,但低延迟任务需要资源和能源高效的网络。实时检测网络在具有高影响力的现实世界应用中是必需的,但它们往往过分强调精度和速度的改进,而忽略了多功能性、鲁棒性、资源和能源效率等其他能力。现有的网络缺乏参考基准,也没有设计新网络的标准评估指南,导致比较模糊和不一致。因此,我们对多个实时检测网络(基于锚点、基于关键点和基于Transformer)进行了全面研究,涵盖了广泛的数据集,并报告了广泛的指标结果。我们还研究了图像大小、锚点维度、置信度阈值和架构层等变量对整体性能的影响。我们分析了检测网络在分布偏移、自然损坏和对抗攻击下的鲁棒性。此外,我们提供了校准分析,以评估预测的可靠性。最后,为了突出实际影响,我们进行了两个独特的案例研究,分别针对自动驾驶和医疗应用。为了进一步评估网络在关键实时应用中的能力,我们在边缘设备上部署了检测网络,并报告了性能。我们广泛的实证研究可以作为工业界在现有网络中做出明智选择的指南。我们还希望激励研究界朝着新的方向发展,关注更广泛和全面的设计和评估网络,以产生更深远的影响。
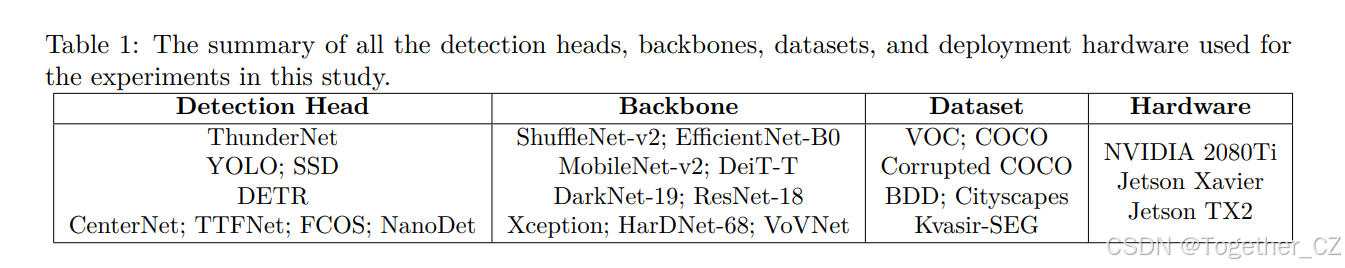
表1:本研究中所有实验所用的检测头、骨干网络、数据集和部署硬件的汇总。
1. 引言
近年来,深度神经网络的进步在目标检测领域取得了显著突破。目标检测通过提供对象实例的位置以及类别标签和置信度分数,结合了分类和定位。检测器应用于多个领域,如自动驾驶系统(ADS)、监控、机器人和医疗。ADS需要在实时中准确检测车辆、交通标志和其他障碍物,并且为了确保安全,它们需要在不同的光照和天气条件下可靠和一致地执行。医疗应用需要高精度,即使速度不是非常快。低延迟应用需要在边缘设备上部署,因此需要快速且足够紧凑的检测器以适应低功耗硬件设备。不同的应用有不同的标准,现实世界的设置有时间和资源限制。因此,检测器需要资源和能源高效,以确保在具有高影响力的现实世界应用中部署。这需要对实时检测网络在不同标准上进行详细分析。
已经提出了许多实时检测网络,这些网络实现了最先进的性能,而它们主要关注报告精度和速度,忽略了简单性、多功能性和能源效率等其他指标。随着新的检测器频繁提出,缺乏标准评估框架,趋势更多地朝着短视的方向发展,只关注名义上的改进。此外,使用的参数存在模糊性,使得重现性和公平比较变得困难。低估资源和能源消耗等指标也可能导致负面环境影响(Badar et al., 2021)。一些综述论文(Liu et al., 2018a; Zhao et al., 2018b; Zou et al., 2019)提供了多年来检测网络的概述,但某些差距使它们无法作为标准基准。大多数分析仅限于部分网络(主要是较旧的两阶段架构),并且不关注实时检测器。因此,这不会证明在实时应用中比较和选择网络是有益的。此外,重点是精度和速度,但网络能力如泛化、鲁棒性和可靠性未被涵盖。研究仅限于少数网络和数据集,结果仅在桌面GPU上报告。这些不足之处在公平和详细地比较现有检测网络以选择特定应用的网络以及设计新的目标检测器时提出了挑战,因为没有详细的参考基准或标准评估指南。
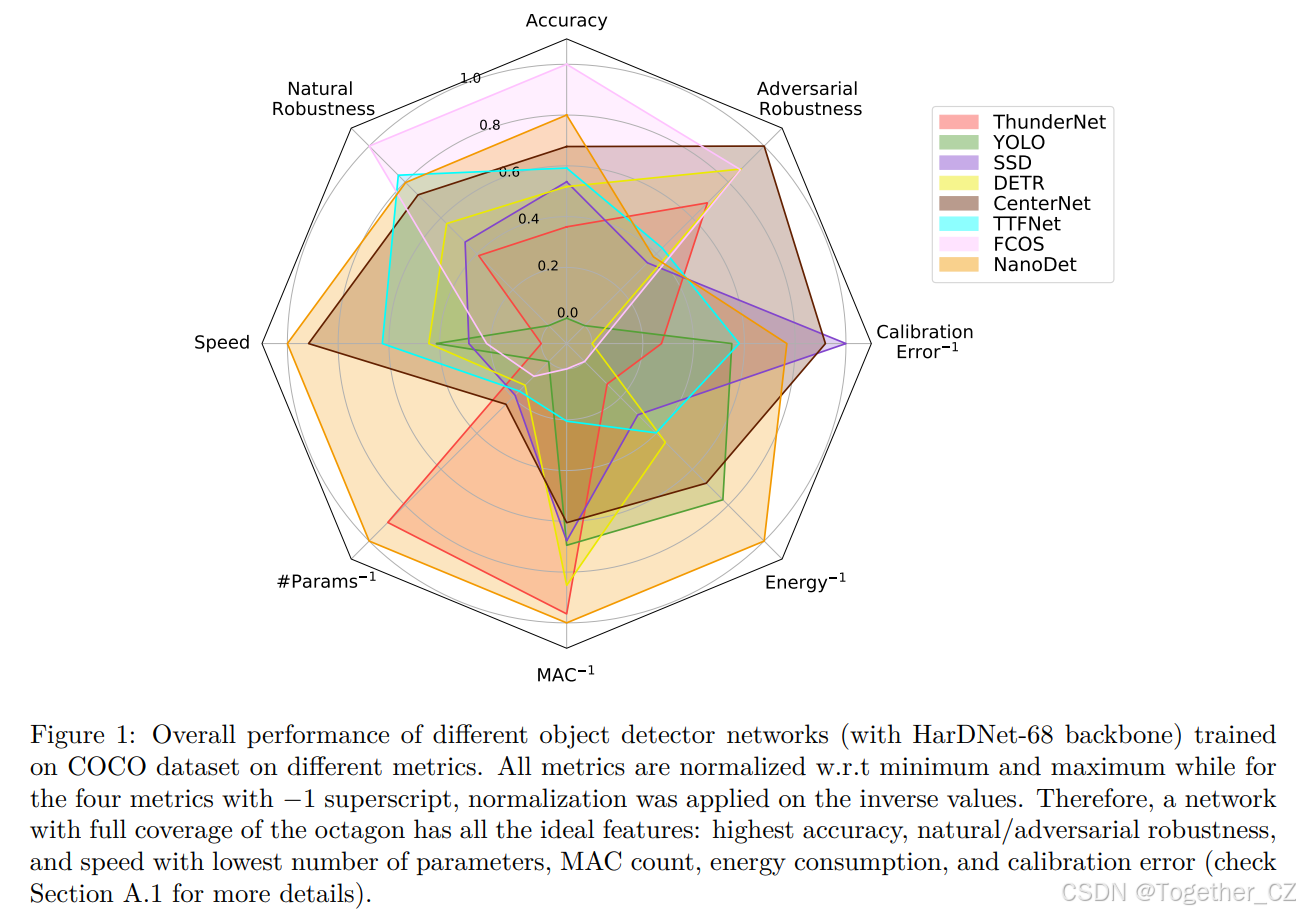
图1:使用HarDNet-68骨干网络在COCO数据集上训练的不同目标检测网络在各项指标上的整体表现。所有指标均相对于最小值和最大值进行了归一化处理,而对于带有-1上标的四个指标,归一化处理则应用于其倒数值。因此,覆盖整个八边形的网络具备所有理想特征:最高精度、自然/对抗鲁棒性、速度最快、参数数量最少、MAC计数最少、能耗最低以及校准误差最小(详见附录A.1)。
因此,我们对多个检测器在不同数据集上的实时目标检测进行了全面研究,并提供了两个关于自动驾驶和医疗应用的案例研究。除了精度和推理时间外,我们还评估了每个模型的资源和能源消耗,以估计环境影响。我们选择了多个网络,并创建了一个统一的框架,其中可以轻松分析不同的主干(或特征提取器)和检测头的组合(表1)。为了进一步详细评估性能增益/损失,我们解耦了图像大小、锚点大小、置信度阈值和架构层类型等不同变量的影响。为了统一评估,我们遵循标准的实验流程,并报告所有使用的参数。每个组合在两个广泛使用的通用数据集(PASCAL VOC(Everingham et al., 2010)和MS COCO(Lin et al., 2014))上进行训练和测试。网络在实时应用中应具有对变化的光照和天气条件的鲁棒性,因此我们进一步进行了广泛的鲁棒性分析,以分析网络在分布偏移和自然损坏下的结果。对于安全关键型应用,网络还应对包含人类眼睛无法察觉的变化的对抗图像具有鲁棒性,因此我们评估了网络对这些攻击的鲁棒性。同样,对于这些应用,不确定性度量有助于及时决策,因此我们还提供了每个网络的可靠性分析。最后,为了展示实际影响,我们在自动驾驶和医疗领域进行了两个独特的案例研究。对于前者,我们报告了在更相关的Berkeley Deep Drive(BDD)(Yu et al., 2018)数据集上的检测器性能,我们还展示了泛化能力,并在分布外(OOD)数据集Cityscapes(Cordts et al., 2016)上报告了性能。为了突出检测器实时部署的可行性,我们在嵌入式硬件上部署了NVIDIA TensorRT优化的模型,并在低功耗设备上报告了实时性能。对于医疗案例研究,我们展示了网络从医学图像中检测息肉的能力,这些息肉用于检测患者中的癌症。这些应用涵盖了两个不同的领域,具有不同的需求,我们的案例研究提供了一个独特的视角,超越了标准基准,评估了检测器在更多相关和适用于实时应用的多样化数据集上的能力。
我们的全面分析总结在图1中,其中每个顶点对应一个指标,八种不同的颜色代表不同的检测器(更多细节请参见附录A.1)。我们报告了八个指标,即精度、自然和对抗损坏的鲁棒性、速度、参数数量、MAC(乘积累加操作)计数、能源消耗和校准误差(用于衡量可靠性)。该图表示理想网络应占据整个八边形,这样的网络具有最高的精度、鲁棒性和速度,最少的参数和MAC计数,同时消耗最低的能源,并且校准最好。唯一为移动设备设计的实时两阶段检测器ThunderNet在资源方面效率高,但在精度、自然鲁棒性方面表现不佳,并且是最慢的网络之一。基于锚点的检测器YOLO在能源消耗方面表现第二好,校准处于中等水平,但在速度、精度和鲁棒性方面落后。另一个基于锚点的检测器SSD处于中间范围,在精度和速度之间提供了良好的平衡。它还具有最佳的校准分数,更可靠。基于Transformer的检测器DETR在对抗鲁棒性方面排名第二,但校准分数最低,因此预测不太可靠。CenterNet对对抗攻击具有最高的鲁棒性,是第二快的,并且在所有其他指标上也处于良好范围。TTFNet处于中间范围。FCOS具有最高的精度和鲁棒性,但在其他指标上表现不佳。NanoDet是最快的,在精度和资源消耗方面排名第二。这四个属于无锚点基于关键点的检测器类别。总体而言,NanoDet在大多数顶点上达到最高点,校准得分平均,因此是适用于需要在低功耗设备上以高速和高精度运行的应用的候选者。
除了这些广泛的分析外,我们还提取了有用的见解和细节。基于关键点的方法通常在精度和速度方面优于基于锚点和两阶段的方法。我们还注意到,虽然更高的MAC计数可能导致更高的能源消耗,但它们不一定能提高精度。所有检测器在中型和大型对象上提供更高的精度,但在小型对象检测方面表现不佳。FCOS在配对较重的骨干网络(如HarDNet-68)时相对在检测小型对象方面表现更好。我们观察到,增加输入图像大小并不总是有益的,因为速度的下降往往超过精度的增加。基于锚点的检测器预测受锚点大小的影响具有不确定性,使得它们难以适应新的数据集。基于关键点的检测器往往在多个数据集上泛化良好。不同置信度阈值下的精度和速度变化表明了结果重现的模糊性。由于Transformer使用注意力块来捕捉全局上下文,因此它们对变化的图像大小不太敏感,并提供一致的性能。校准结果显示,基于关键点的方法谨慎且不够自信,因此在安全关键型应用中证明有用。但有趣的是,DETR在所有网络中最为过度自信。随着Transformer越来越受到关注,这种详细分析将提供更多关于这种新架构范式的能力和陷阱的见解。ADS案例研究揭示了在一个设备上看到的性能趋势不一定能转化为部署中使用的嵌入式硬件。医疗案例研究表明,相对较高的精度网络可能没有更高的召回值,这在医疗数据中更为重要(因为假阴性比假阳性更有害)。
总体而言,我们强调了标准评估指南的重要性,可以解决当前文献中的模糊比较和重要指标的遗漏。为此,我们通过提供整体视图和更深入的架构和分析视图,提供了实时检测的全面视图。工业界可以通过参考广泛的结果,根据应用需求做出明智的检测器选择。我们还希望鼓励研究界更多地关注基本和具有深远影响的问题,而不是名义上的性能改进。由于新的检测网络频繁引入,本研究可以作为设计新检测器的先例。
表1总结了本研究中使用的所有网络(检测头和骨干)、数据集和硬件。论文的贡献总结如下:
-
对九个特征提取网络和八个检测头的组合进行了广泛的实证研究,涵盖了两阶段、单阶段、基于锚点、基于关键点和基于Transformer的架构。
-
在基准数据集上详细报告了精度、速度、可学习参数数量、MAC计数和能源消耗的结果。
-
研究了图像大小、锚点大小、置信度阈值和特定架构设计布局等变量对整体性能的影响。
-
对所有网络在十五种不同自然损坏和对抗攻击下的鲁棒性进行了分析。
-
通过评估所有网络的校准分数,进行了可靠性分析。
-
在更相关的BDD数据集上进行了自动驾驶系统的案例研究。并通过在Cityscapes数据集上测试网络,报告了分布外数据的泛化性能。
-
在边缘设备Jetson-Xavier和Jetson-Tx2上部署了TensorRT优化的检测器。
-
通过在Kvasir-SEG数据集上进行分析,检测癌症息肉,进行了医疗应用的案例研究。
2. 相关工作
Logothetis & Sheinberg (1996) 进行了最初的调查,从神经科学的角度探讨视觉对象识别。Grauman & Leibe (2011) 和 Andreopoulos & Tsotsos (2013) 多年来进行了基于计算机视觉的视觉对象识别系统的调查。然而,这些调查完全集中在基于几何属性和纹理的经典计算机视觉技术上,涵盖了更广泛的对象识别主题,而不是专门检测。鉴于近年来目标检测的快速发展,更多的调查(Liu et al., 2018a; Zhao et al., 2018b; Zou et al., 2019)已经发表,提供了基于深度学习的检测技术的广泛覆盖。Huang et al. (2017) 在COCO数据集上对三个目标检测器和三个骨干进行了基准测试。该论文报告了Faster R-CNN(Ren et al., 2015)、R-FCN(Dai et al., 2016)和SSD(Liu et al., 2016)检测器与MobileNet(Howard et al., 2017)、ResNet-101(He et al., 2016)和InceptionResNet-V2(Szegedy et al., 2016a)骨干的精度和速度。他们主要关注两阶段检测器,除了SSD,并在单个数据集(即MS COCO数据集)上分析了结果。Wu et al. (2020) 深入探讨了深度学习在目标检测中的最新进展,并提供了从传统方法到基于深度学习方法的目标检测演变信息。他们主要提供属于R-CNN家族的两阶段检测器的结果。精度再次成为主要关注点,而泛化、资源消耗、能源、鲁棒性和其他指标被忽略。结果报告了资源密集型骨干网络,如VGG-16或ResNet-101,不符合实时检测调查的资格。
所有调查论文提供了多年来检测的概述,但存在未解决的缺点和差距。首先,新的检测器设计,如无锚点和基于Transformer的检测器,尚未被考虑。其次,未比较架构的能源消耗、MAC计数和参数计数等指标,以提供更详细的资源分析。第三,其他相关能力如鲁棒性、可靠性和分布外泛化被忽略,从而无法获得所有检测器的整体分析。第四,没有调查关注实时检测,因此不能作为为实时应用选择(从现有网络中)或设计新网络的指南。
我们专注于实时目标检测,并使用标准化的(即插即用风格)管道来评估大量特征提取器,涵盖基于锚点、基于关键点和基于Transformer的检测器。我们解耦了影响检测结果的各种因素,如图像大小、锚点大小、可变形层和置信度阈值,这有助于以更灵活的方式分析网络。这促进了跨广泛指标和数据集的检测模型公平比较框架,从而提供了关于网络设计考虑的全面和独特见解。我们进一步对不同损坏和对抗攻击进行了广泛的鲁棒性分析。对抗攻击的鲁棒性主要在图像识别领域报告,而在目标检测中较少。为了填补这一空白,我们报告了所有检测网络在不同攻击强度下的鲁棒性性能。我们还进行了校准研究,以评估预测的可靠性。此外,为了分析实时性能,我们在低功耗嵌入式设备Nvidia TX2和Xavier上对所有网络进行了基准测试。最后,我们在自动驾驶和医疗领域提出了两个独特的案例研究。
3. 目标检测:简要概述
目标检测通过提供对象实例的类别标签和边界框坐标,结合了分类和定位。基于卷积神经网络(CNN)的目标检测器通常分为两类,即两阶段和单阶段检测方法。
3.1 两阶段检测
两阶段检测器由单独的区域提议网络(RPN)和分类组成。从RPN中提取的感兴趣区域(ROI)的特征被传递到分类头,以确定类别标签,并传递到回归头以确定边界框(Girshick et al., 2014; Girshick, 2015; Ren et al., 2015; He et al., 2017; He et al., 2015)。基于区域的卷积神经网络(RCNN)使用选择性搜索算法在图像中找到可能代表对象的像素区域,并通过CNN传递候选区域(Girshick et al., 2014)。从CNN中提取的特征成为支持向量机(SVM)的输入,该SVM对区域进行分类,并成为回归器的输入,该回归器预测边界框。RCNN需要渐进的多阶段训练,速度较慢。为了克服RCNN的不足,Fast-RCNN提出了一些修改(Girshick, 2015)。首先,不是使用CNN提取选择性搜索提出的区域的特征,而是使用CNN直接提取整个图像的特征。从提取的特征中,区域感兴趣(ROI)池化层对与提议的图像区域对应的特征进行池化。其次,SVM分类器和回归器分别被全连接层取代。Faster-RCNN进一步改进了区域提议的缓慢选择性搜索算法。从骨干CNN提取的特征被发送到额外的基于CNN的区域提议网络(RPN),该网络提供区域提议(Ren et al., 2015)。然而,尽管具有高精度,上述两阶段检测方法不适用于实时应用(Liu et al., 2018a; Zhao et al., 2018b; Zou et al., 2019)。提出了一个名为ThunderNet(Qin et al., 2019)的轻量级两阶段检测器,具有高效的RPN和小的骨干网络,用于实时检测(第5.1节)。
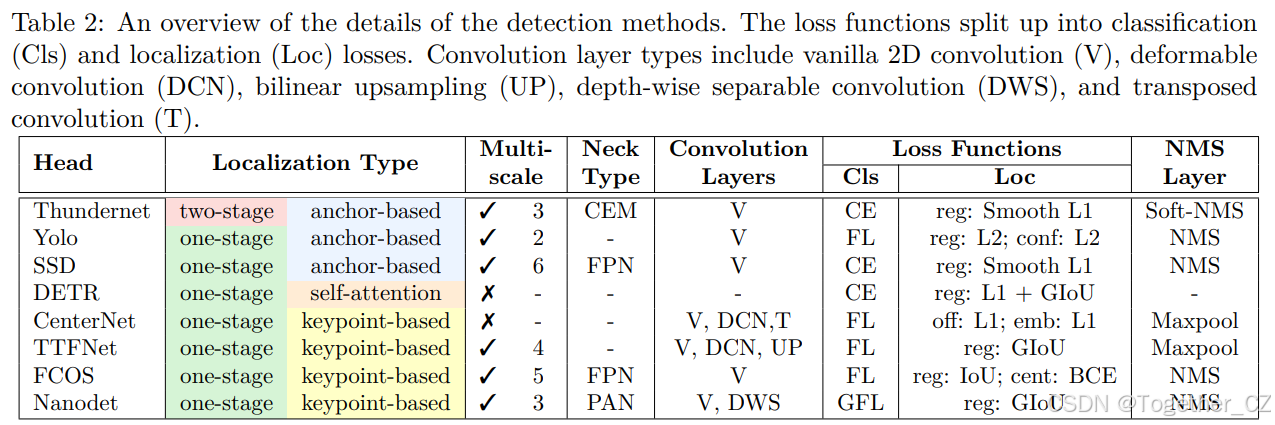
表2:检测方法的详细概览。损失函数分为分类损失(Cls)和定位损失(Loc)。卷积层类型包括普通2D卷积(V)、可变形卷积(DCN)、双线性上采样(UP)、深度可分离卷积(DWS)和转置卷积(T)。
3.2 单阶段检测
单阶段检测器由一个单一的端到端前馈网络组成,在一个整体设置中执行分类和回归。这些检测器没有单独的提议生成阶段,而是将图像上的所有位置视为潜在提议。每个位置用于预测类别概率、边界框位置和置信度分数。置信度分数决定了网络对其类别预测的确定程度。单阶段检测器的主要两类是基于锚点和基于关键点的检测器。
基于锚点的检测器使用预定义的锚点框(或先验)来辅助预测。这种方法的显著例子是You Only Look Once(YOLO;Redmon et al. (2016); Redmon & Farhadi (2017, 2018))和Single Shot Detector(SSD;Liu et al. (2016))。YOLO通过将输入图像可视化为网格单元来工作,其中每个单元负责预测一个边界框,如果框的中心落在单元内。每个网格单元预测多个边界框,并输出位置和类别标签及其置信度分数。SSD是第一个单阶段检测器,其精度与当代两阶段检测器相当,同时保持实时速度。SSD预测固定锚点集的不同尺度的分数和框偏移,这些锚点在从特征金字塔网络(FPN)提取的多个特征图的每个位置上进行预测。FPN促进了多分辨率特征(Lin et al., 2017a)。
基于锚点的检测器具有处理超参数的缺点,如锚点的数量、宽高比和大小,这些参数高度依赖于数据集。这导致了无锚点(即基于关键点)目标检测器的新范式。基于关键点的方法将对象视为点,而不是将它们建模为边界框。关键点(如对象的角点或中心)被估计,宽度和高度从这些点回归,而不是预定义的锚点。引入了几个基于关键点的网络,如CornerNet、CenterNet、FCOS、NanoDet和TTFNet(Law & Deng, 2018; Zhou et al., 2019a; Tian et al., 2019; Lyu, 2020; Liu et al., 2020)。
尽管基于锚点和基于关键点的检测器在通用目标检测中取得了显著的精度,但它们主要由基于CNN的架构主导,缺乏全局上下文。
表2提供了检测方法的概述。损失函数分为分类(Cls)和定位(Loc)损失。卷积层类型包括普通2D卷积(V)、可变形卷积(DCN)、双线性上采样(UP)、深度可分离卷积(DWS)和转置卷积(T)。
4. 目标检测公式
在这里,我们首先解释检测网络的所有基本组件,然后解释目标检测中的主要挑战。
4.1 基本组件
目标检测问题可以形式化为:给定任意图像IiIi和预定义的对象类别列表,目标检测模型不仅对图像中存在的对象实例类型进行分类,还以边界框的形式返回每个对象的位置,其中bi={(x1,y1),(x2,y2)}是边界框的左上角和右下角坐标。目标检测器,无论是单阶段还是两阶段,通常由特征提取器(以下简称骨干)和检测头组成。骨干通常是基于CNN的网络,提取场景中最显著的表示(从低级到高级特征)。大多数骨干使用步幅的池化/卷积层逐步减少特征图的大小,并增加网络的感受野。输出特征图然后传递到检测头,检测头执行分类和回归,以确定对象实例的标签和位置(图2显示了通用目标检测的概述)。
4.1.1 损失函数
我们简要概述了用于训练目标检测器的损失函数。通常使用两个目标函数来训练基于CNN的检测器,即分类和回归损失。分类损失通常由交叉熵(CE)损失定义:
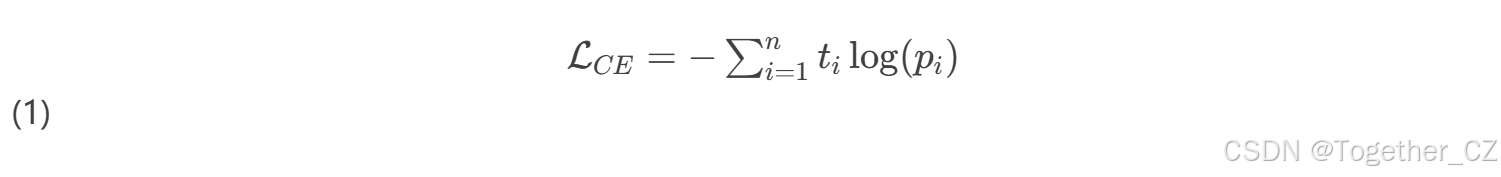
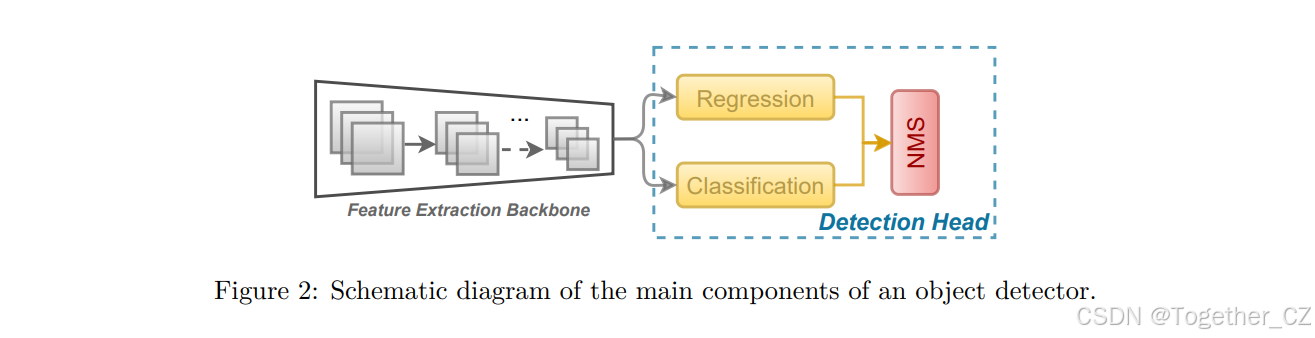
图2:目标检测器主要组件的示意图。
其中ti是真实标签,pi是第i类的softmax概率。然而,CE损失不考虑不平衡数据集,其中不频繁的例子比频繁出现的对象更难学习。因此,Lin et al. (2017b) 提出了焦点损失(FL),通过为困难样本分配更多重要性,同时降低简单样本的损失贡献,解决了类别不平衡问题,
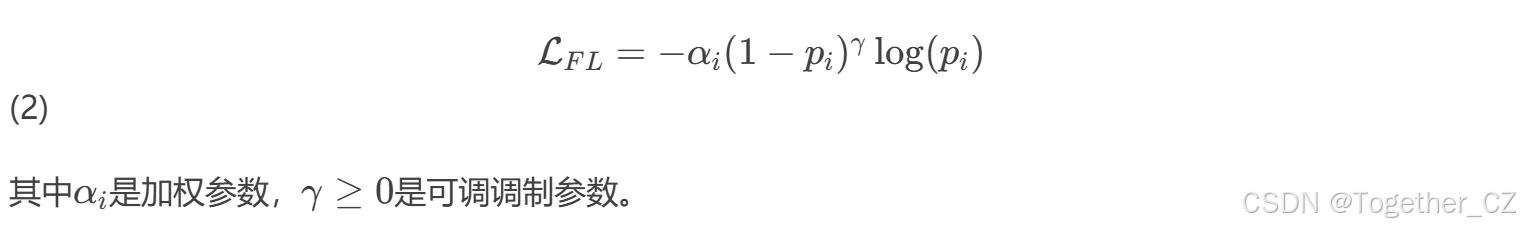
回归损失通常是真实边界框和预测边界框之间所有四个边界框坐标上的L1(最小绝对偏差)或L2(最小平方误差)损失。
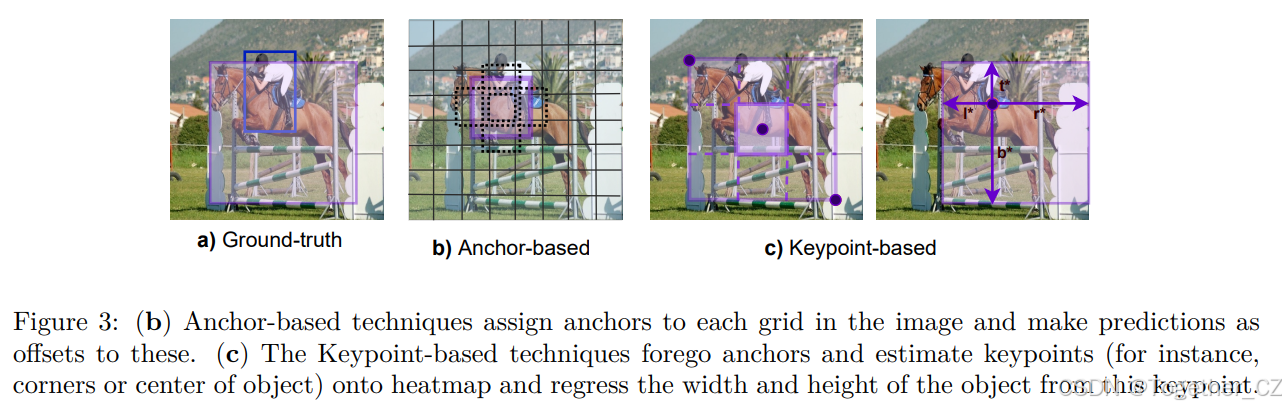
图3:(b) 基于锚点技术为图像中的每个网格分配锚点,并根据这些锚点进行偏移预测。(c) 基于关键点技术摒弃锚点,估计关键点(例如,对象的角点或中心)到热图上,并从该关键点回归对象的宽度和高度。
4.1.2 锚点框 vs. 关键点
基于锚点的目标检测技术使用锚点框(也称为文献中的先验框)的概念。在这种方法中,图像被划分为网格,每个网格单元可以分配多个预定义的锚点框(图3b)。这些框旨在捕捉特定对象类别的尺度和宽高比,通常根据训练数据集中的对象大小选择。计算锚点和真实边界框之间的交并比(IoU),具有最高重叠的锚点用于预测该对象的位置和类别。当锚点与真实框的重叠高于给定阈值时,它被视为正锚点。网络不是直接预测边界框,而是预测平铺锚点框的偏移量,并为每个锚点返回一组唯一的预测。使用锚点框有助于检测多个对象、不同尺度的对象和重叠对象。
然而,基于锚点的方法有两个主要缺点。首先,需要大量锚点框以确保与真实框有足够的重叠,实际上,只有一小部分锚点与真实框重叠。这创建了正锚点和负锚点之间的巨大不平衡,从而增加了训练时间。其次,锚点框的大小、形状和宽高比高度依赖于数据集,因此需要对每个数据集进行微调。然而,这些选择是使用启发式方法(使用数据集的真实边界框)进行的,这在多尺度架构中变得更加复杂,每个尺度使用不同的特征和自己的一组锚点。
为了缓解上述问题,提出了基于关键点的目标检测技术,这些技术不使用锚点(Law & Deng, 2018; Zhou et al., 2019a; Tian et al., 2019)。检测问题被重新表述为逐像素预测,类似于分割。使用CNN的特征创建热图,其中强度峰值表示相关对象的关键点,如角点或中心。除了这些,还有额外的分支预测框的尺寸(宽度和高度)。热图预测和嵌入用于估计预测框的正确位置和大小。对于中心关键点,预测从中心到对象边界框四边的距离以进行检测(图3c)。
4.1.3 非最大抑制(NMS)
目标检测器产生过多的提议,其中许多是冗余的。为了去除密集的重复预测,检测器通常使用称为NMS的后处理步骤。NMS模块首先按置信度分数对每个实例的预测提议进行排序,并选择具有最高置信度的提议。随后,对每个实例的近似重复提议集执行Jaccard重叠,
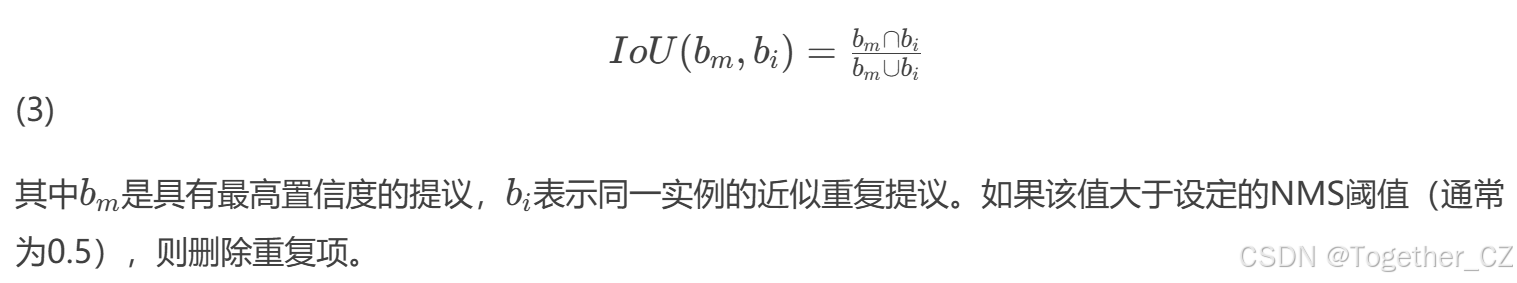
然而,NMS的一个相关问题是,当提议(对于不同实例)彼此接近或在某些情况下重叠时,有效提议被拒绝。这在拥挤场景中尤其如此。因此,提出了Soft-NMS以改进NMS约束。在Soft-NMS中,与bm略有重叠的检测提议的分数衰减,同时确保与bm重叠更高的提议衰减更多,从而可以去除重复项。这是通过计算置信度分数(提议bi)与bm的IoU的负积来完成的,如下所示:
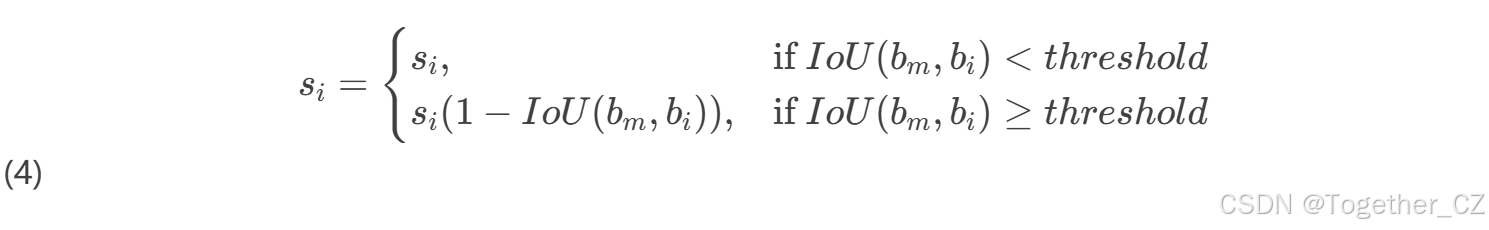
基于关键点的检测器不使用基于IoU的NMS,因为它们处理热图上的点而不是重叠的框。这些网络中的NMS是一个简单的基于峰值的最大池操作,计算成本较低。
4.2 目标检测的挑战
目标检测作为计算机视觉问题具有固有的挑战性,因为理想检测器必须在合理的能源和计算成本下提供高精度和高性能。在第8节中,我们讨论了几种骨干和检测头组合的优缺点,以展示精度和速度之间的权衡。
检测精度和推理速度也取决于图像大小和对象大小。虽然更高的图像分辨率通过从场景中提取更多信息来提高精度,但它也会降低推理速度。因此,选择在精度和速度之间提供正确平衡的图像大小至关重要。此外,对象大小在检测精度中起主要作用。虽然检测器可以对中型到大型对象实现高精度,但几乎所有检测器在场景中检测小型对象时都表现不佳(Liu et al., 2021)。在第9.1和9.2节中,我们研究了对象大小和图像大小对检测精度和速度的影响。
为了提供高精度,检测器需要对具有显著类内变化(例如,对象的大小、形状和类型的变化)、姿态和非刚性变形的现实世界对象进行鲁棒的定位和分类。对于基于锚点的检测器,锚点的优化是一个挑战,因为它们依赖于数据集。在第9.3节中,我们展示了锚点大小变化如何影响检测精度。
另一个主要挑战是在不同天气(雨、雪、暴风雪)和光照条件下保持一致的性能。对于自动驾驶等应用,检测器还必须考虑杂乱的背景、拥挤的场景和相机效果。我们在第11节中提供了对检测器鲁棒性的详细研究。
最后,深度神经网络往往依赖于捷径学习线索,因此过度拟合训练数据分布,无法泛化到分布外(OOD)数据。由于对未见数据的泛化是最重要的关注点,我们在第13节中提供了对分布内和分布外数据的详细分析。
5. 目标检测头
由于我们研究的范围是实时目标检测,我们关注一个两阶段检测器:ThunderNet(Qin et al., 2019),两个基于锚点的检测器:SSD(Liu et al., 2016),YOLO(Redmon & Farhadi, 2017),四个(无锚点)基于关键点的检测器:CenterNet(Zhou et al., 2019a),FCOS(Tian et al., 2019),NanoDet(Lyu, 2020)和TTFNet(Liu et al., 2020),以及一个基于Transformer的检测器:DETR(Carion et al., 2020)。
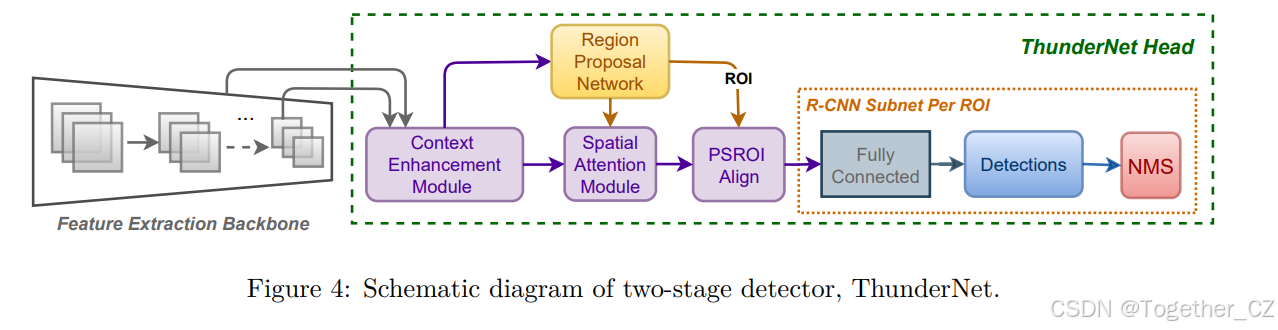
图4:两阶段检测器ThunderNet的示意图。
5.1 ThunderNet
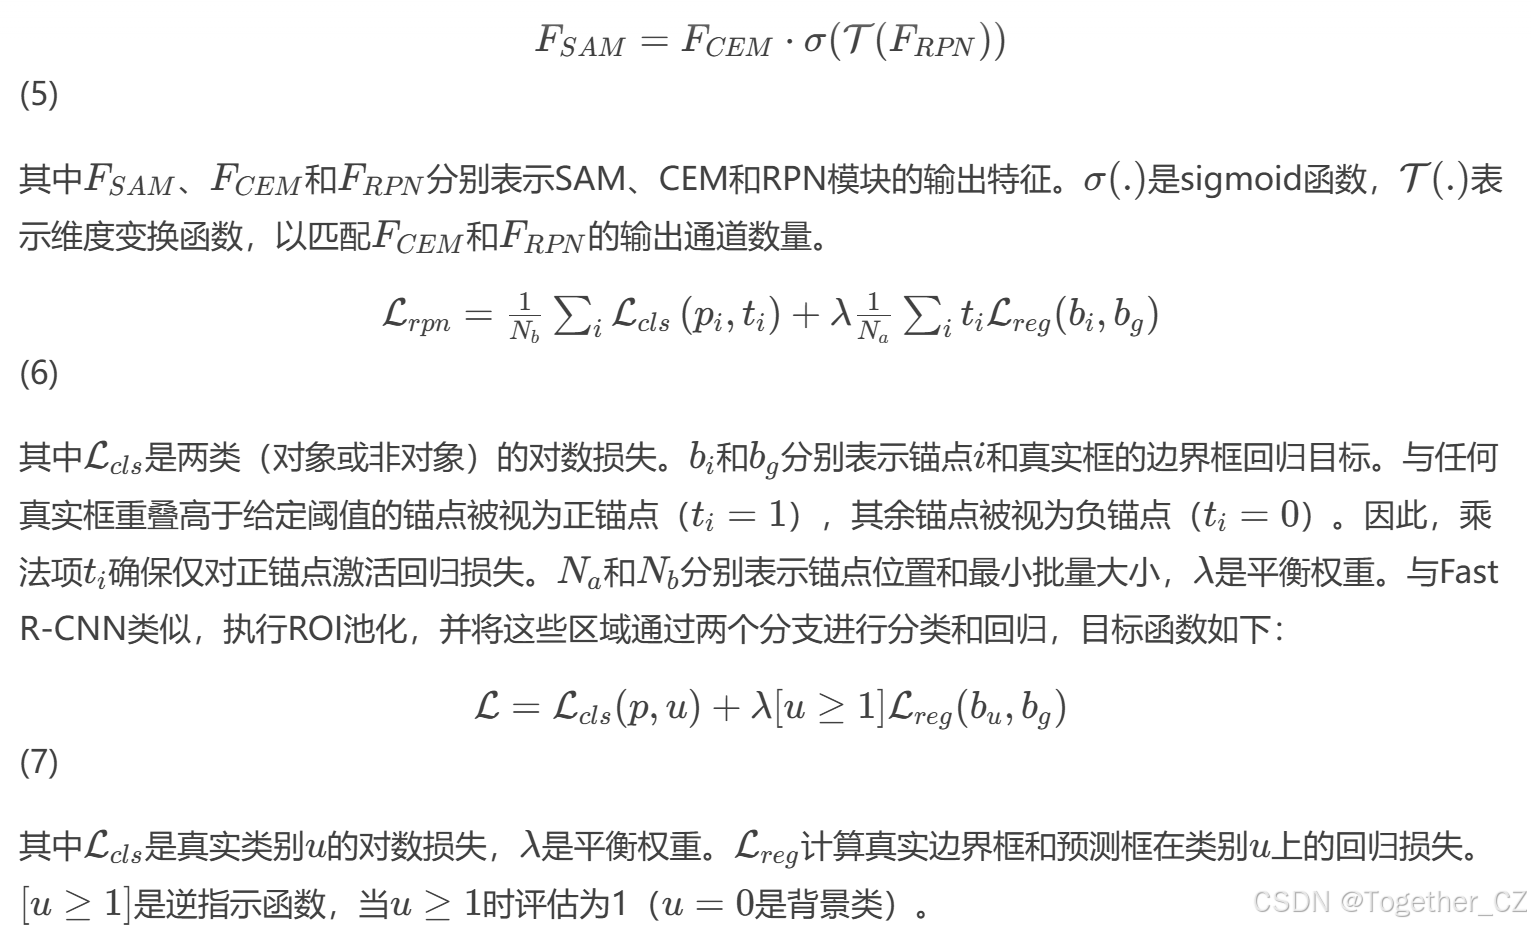
ThunderNet重新审视了两阶段检测器架构,并在Lighthead-RCNN(Li et al., 2017)的基础上进行了改进,使用ShuffleNet-v2(Ma et al., 2018)的变体作为骨干。检测头在网络的早期阶段增加了通道数量,以编码低级特征并提高精度。ThunderNet使用两个新模块:上下文增强模块(CEM)和空间注意力模块(SAM)。CEM从三个不同尺度聚合特征,通过利用局部和全局特征扩大感受野。SAM通过加强前景特征并抑制背景特征来细化特征(图4)。SAM模块的输出为:
5.2 You Only Look Once (YOLO)
YOLO(Redmon et al., 2016)是一个针对实时处理的单阶段目标检测网络。YOLO将图像划分为网格单元,每个单元预测一个由边界框和分数定义的对象。如果对象的中心位于其中,则该对象属于特定网格单元。YOLO快速且简单,但召回率较低。Redmon & Farhadi (2017) 提出了YOLO v2以提高YOLO的精度和速度。YOLO v2不是对边界框进行任意猜测,而是在每个网格中使用不同大小和宽高比的锚点来覆盖整个图像的不同位置和尺度。通过在特定数据集上使用基于IoU的k-Means聚类计算锚点大小,可以使锚点更准确。网络预测每个锚点框的偏移量。YOLO v2通过连接两个特征图尺度(图5)在单个特征图上进行边界框预测。YOLO的其他多个版本已经推出,所有这些版本都建立在YOLO v2的基本概念上,但通过许多技巧实现了更高的性能。由于我们试图在一个公平和简单的框架上进行评估,在本研究中,我们仅考虑YOLO v2版本,因为它简单、快速,并且具有最少的技巧包。
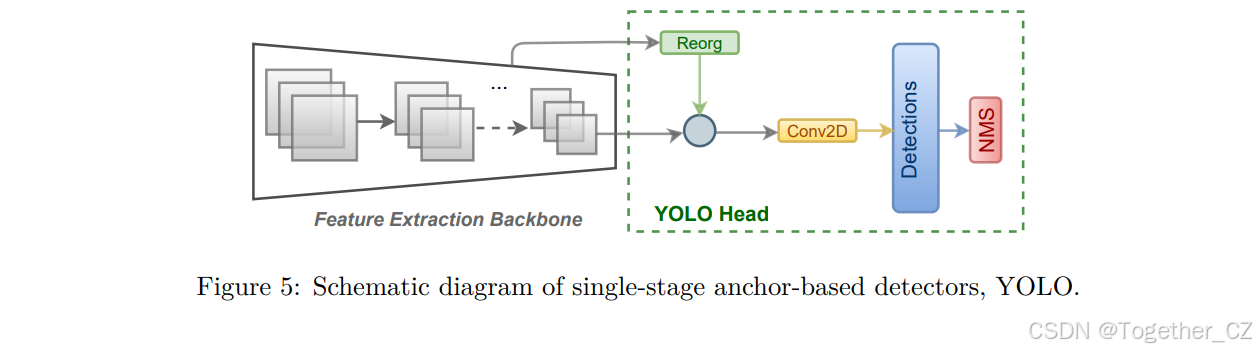
图5:基于锚点的单阶段检测器YOLO的示意图。
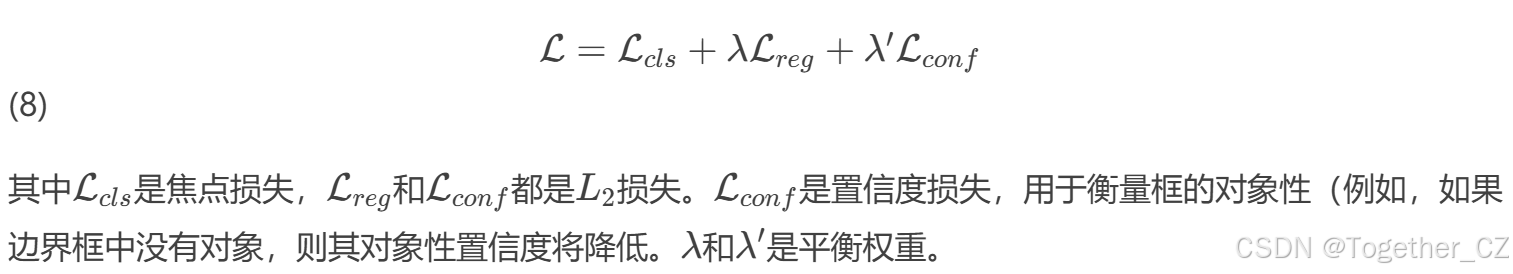
损失函数由分类损失、定位损失和置信度损失(用于衡量框的对象性)组成:
5.3 单发多框检测器(SSD)
SSD(Liu et al., 2016)具有前馈CNN,为场景中的多个对象实例生成边界框、置信度分数和分类标签。SSD使用多个特征图从逐渐减少的分辨率中模拟不同大小的输入图像,同时在不同尺度上共享计算。浅层特征图用于学习较小对象的粗略特征,深层特征用于定位场景中的较大对象。
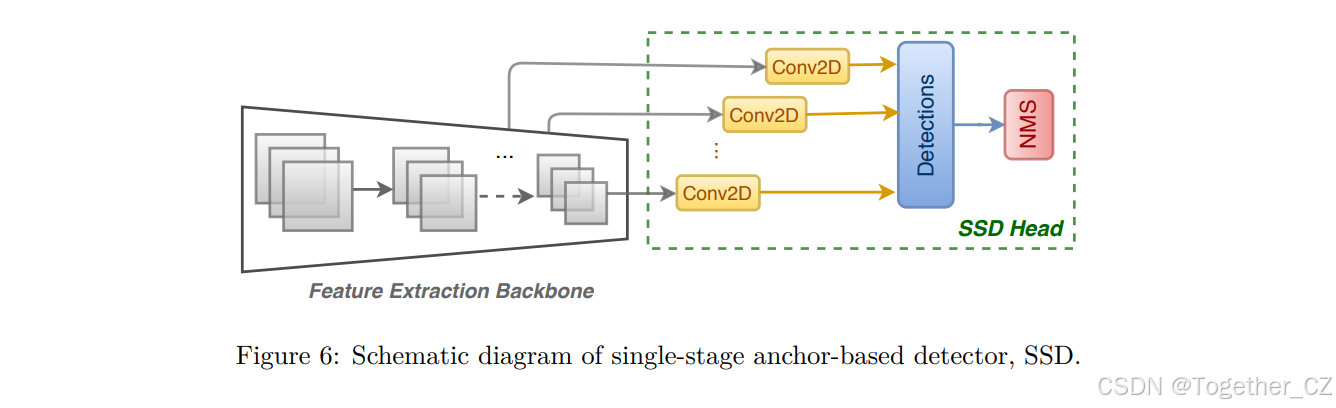
图6:基于锚点的单阶段检测器SSD的示意图。
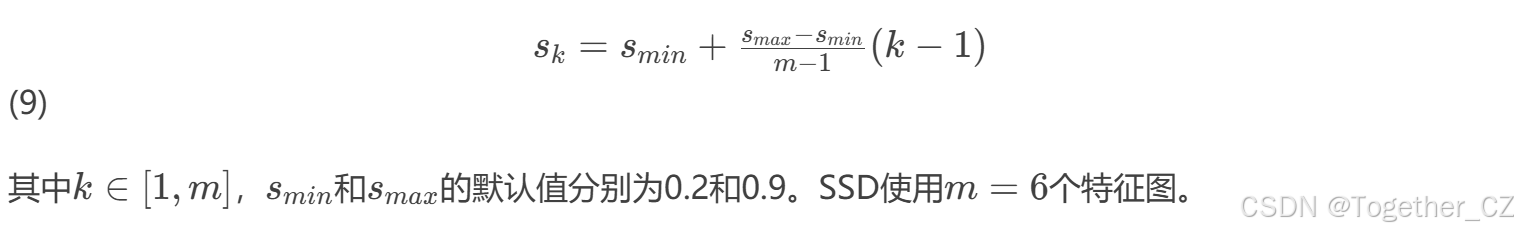
检测头为每个特征图尺度使用单独的预定义锚点框,并结合所有默认锚点在不同尺度和宽高比下的预测(图6)。每个特征图k的锚点尺度和大小定义为:
SSD生成一组多样化的预测,覆盖各种形状和大小的对象实例。SSD使用匹配策略来确定哪些锚点对应于真实框,并使用具有最高重叠的锚点来预测该对象的位置和类别。目标函数源自多框目标(He et al., 2015),并扩展到多个类别。整体目标函数为:
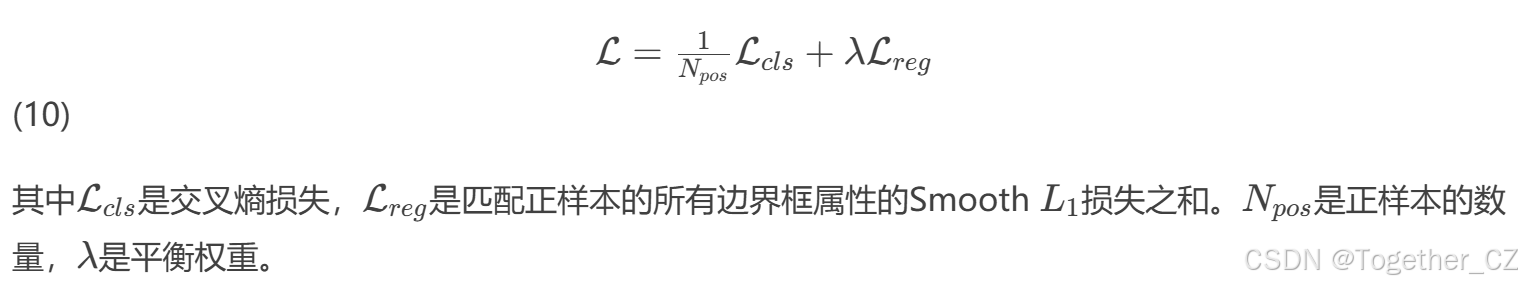
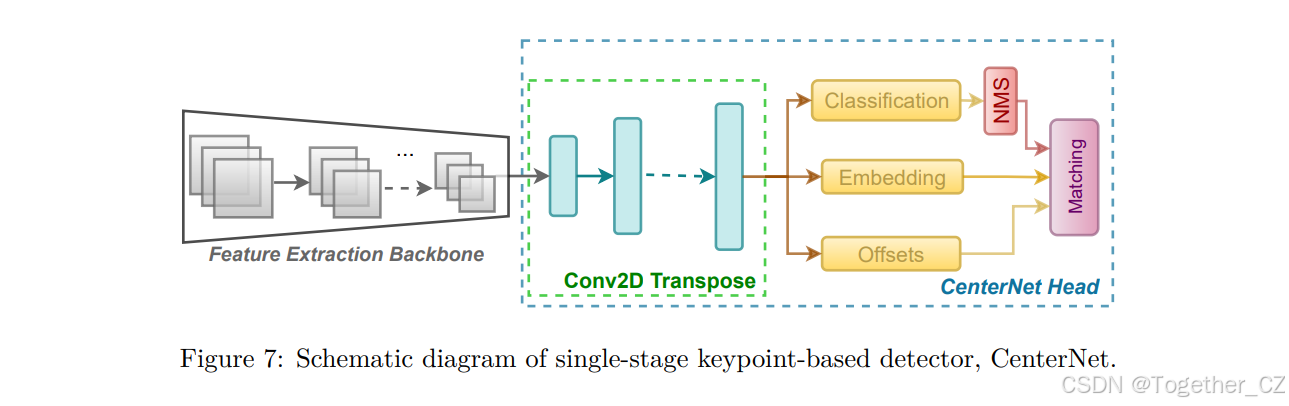
图7:基于关键点的单阶段检测器CenterNet的示意图。
5.4 CenterNet
基于锚点的检测器必须处理超参数,如锚点的数量、宽高比和大小,这些参数也高度依赖于数据集。CornerNet被提出作为基于锚点方法的第一个替代方案,将目标检测问题简化为关键点估计问题(Law & Deng, 2018)。
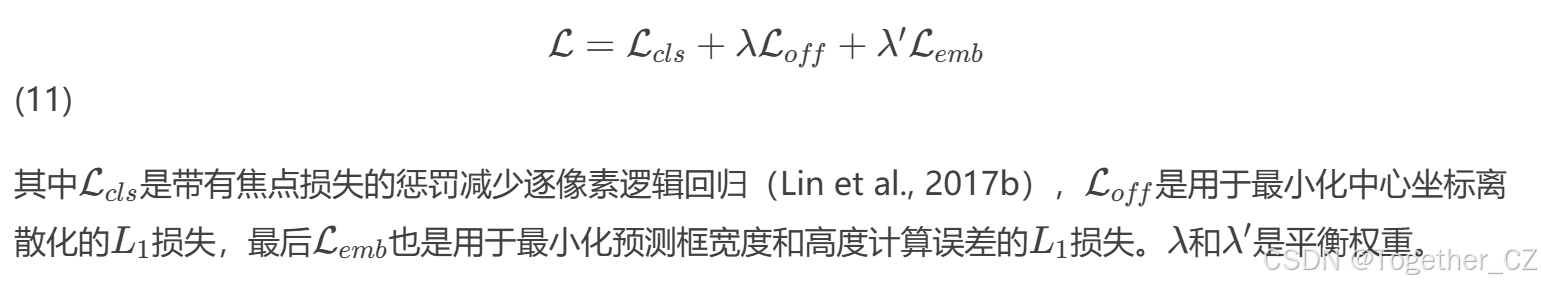
在多个方法中(Law et al., 2019; Zhou et al., 2019a,b),我们使用CenterNet(Zhou et al., 2019a),因为它不仅比CornerNet实现了更高的精度,而且简化了关键点估计。检测算法通过三个转置卷积层增强骨干网络,以包含高分辨率输出。第一个分支输出热图以估计关键点或对象的中心点,热图的数量等于类别数量。通过在真实框的中心使用高斯核创建真实热图。峰值用于估计实例的中心并确定实例类别。还有两个分支生成热图:嵌入分支回归框的尺寸,即宽度和高度,偏移分支考虑将中心坐标映射到原始输入维度时引起的离散化误差(见图7)。整体目标函数为:
5.5 全卷积单阶段目标检测(FCOS)
FCOS,一个全卷积的无锚点检测器,将目标检测重新表述为逐像素预测问题,类似于语义分割(Tian et al., 2019)。检测器使用多级预测和FPN(Lin et al., 2017a)来提高召回率并解决重叠边界框的模糊性。从不同尺度获得五个特征图,并在每个层上执行逐像素回归。这增加了召回率,但在远离对象中心的位置产生低质量预测。为了避免这种情况,添加了一个额外的分支,以预测位置的中心性(图8)。
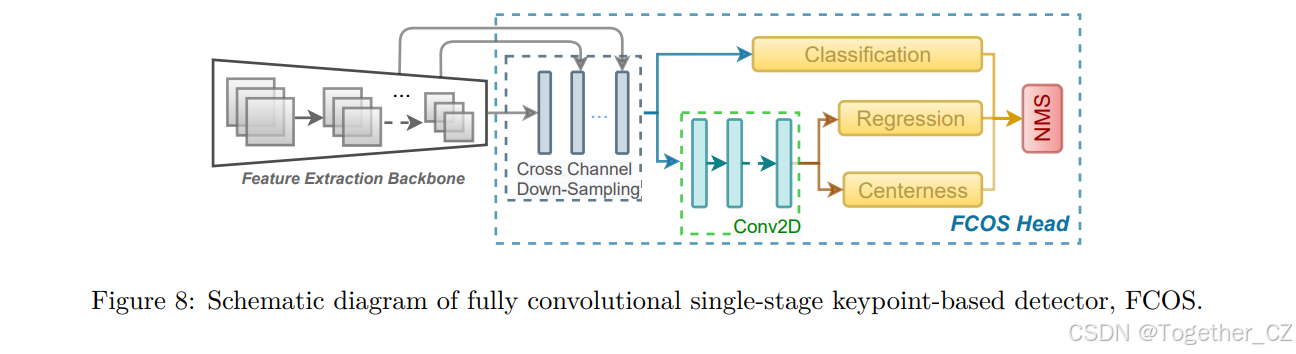
图8:全卷积单阶段基于关键点的检测器FCOS的示意图。
整体损失函数为:
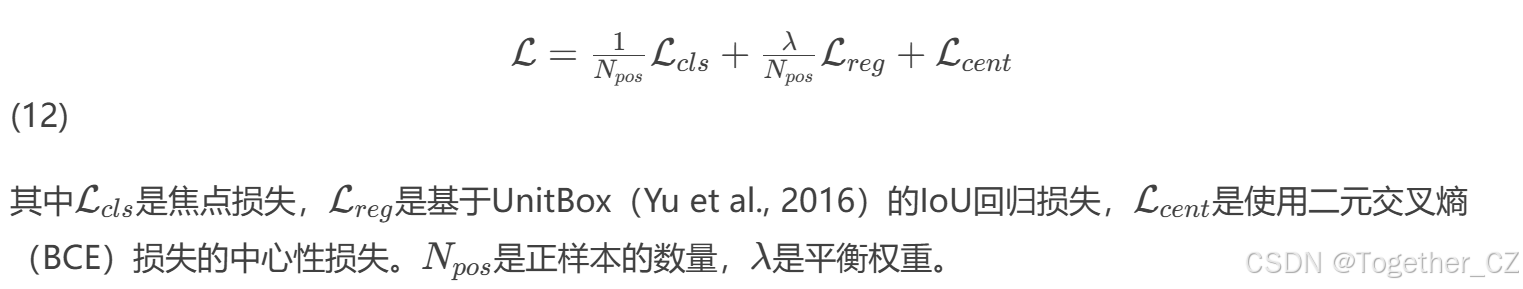
IoU回归基于UnitBox(Yu et al., 2016),是一种输入为IoU的交叉熵损失形式。与独立优化坐标的L2损失不同,IoU损失将其视为一个单元。最终分数由中心性分数加权。因此,该分支降低远离对象中心预测的分数,这有助于最终的NMS过滤掉低质量预测。
5.6 NanoDet
受FCOS启发,NanoDet被引入为轻量级无锚点检测器(Lyu, 2020)。所提出的检测器使用自适应训练样本选择(ATSS)模块(Zhang et al., 2020),该模块根据对象特征自动选择正负训练样本。检测器使用广义焦点损失(GFL)(Li et al., 2020)进行分类和回归。GFL旨在将焦点损失从离散扩展到连续域以更好地优化。这是质量焦点损失(QFL)和分布焦点损失(DFL)的组合。QFL结合分类和IoU质量以提供一个分数,DFL将预测框视为连续分布并对其进行优化。广义IoU损失(GIoU)对于非重叠情况很有用,因为它通过缓慢移动到目标框来增加预测框的大小以与目标框重叠。用于训练NanoDet的总体损失函数为:
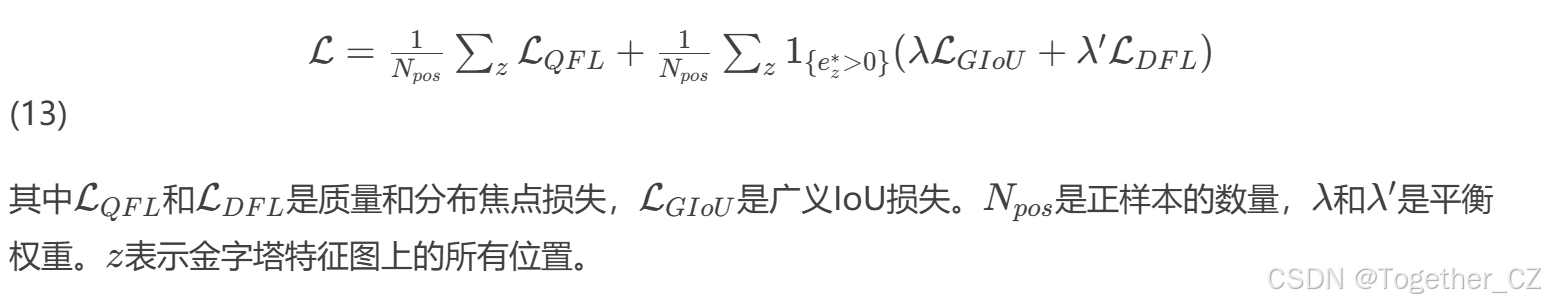
虽然FCOS使用五个特征图并通过多级FPN传递,但NanoDet使用三个特征图并通过三个单独的路径聚合网络(PAN)(Liu et al., 2018b)块传递。PAN类似于FPN,但通过添加自底向上路径增强来增强低级特征。来自PAN块的输出连接到单独的检测头,这些检测头为特定特征图计算分类标签和边界框。NanoDet还移除了FCOS中存在的中心性分支,从而使其成为更快的变体。三个头的输出最终传递到NMS,以获得输入图像的最终框和分类标签(见图9)。
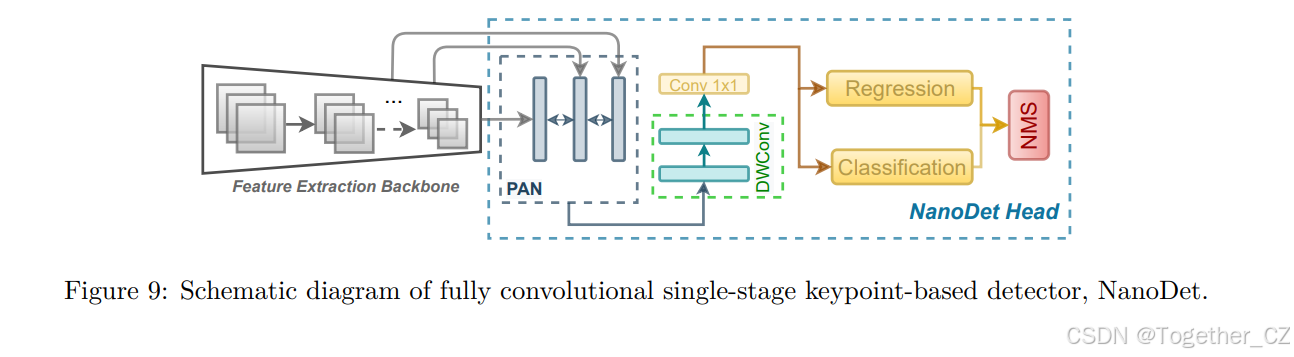
图9:全卷积单阶段基于关键点的检测器NanoDet的示意图。
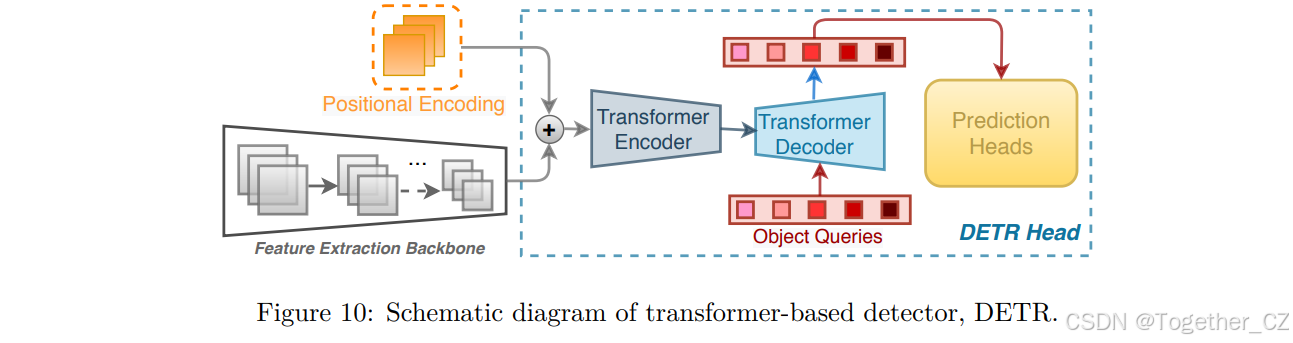
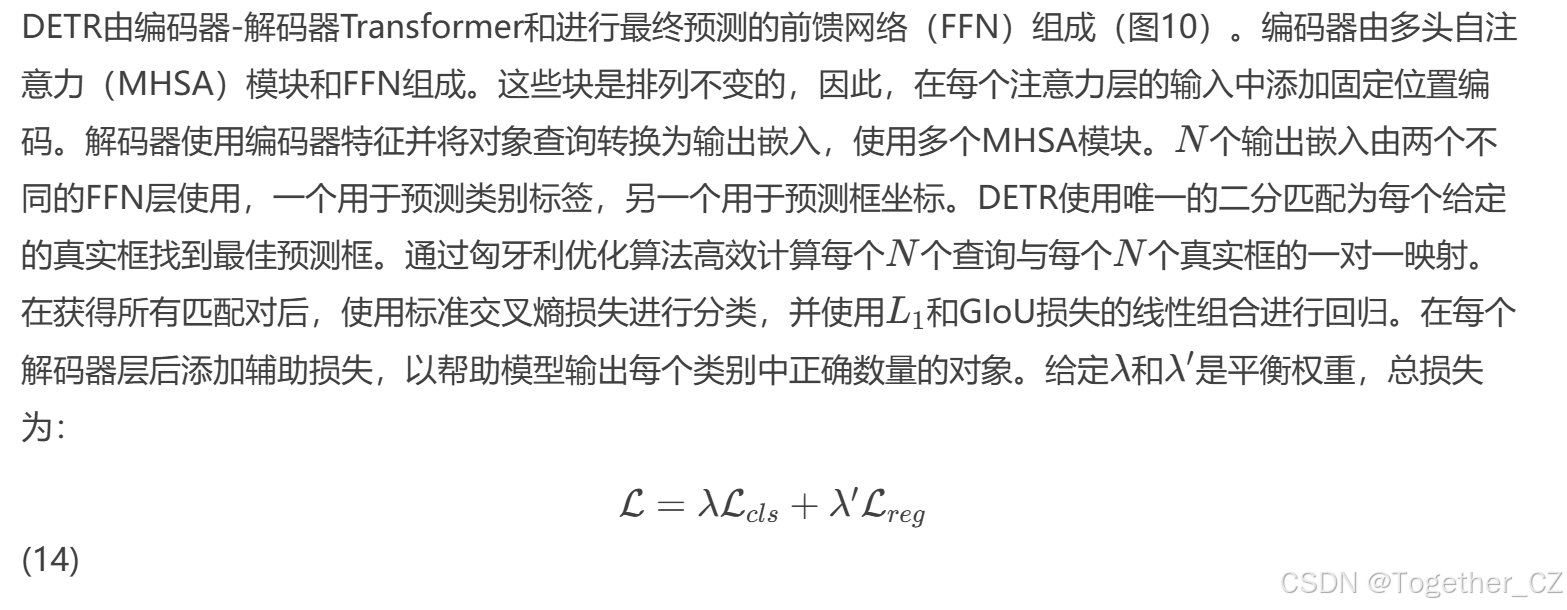
图10:基于Transformer的检测器DETR的示意图。
5.7 检测Transformer(DETR)
Transformer是计算机视觉中的新设计范式,依赖于注意力机制,首次在目标检测中由DETR引入(Carion et al., 2020)。DETR将目标检测任务视为直接集合预测问题,消除了重复边界框预测。Transformer通过使用自注意力模块捕捉整个图像上下文中的对象之间的成对关系,从而避免重复预测。这与使用NMS等后处理步骤消除重复预测的传统目标检测器相比,是一个优势,从而创建了一个计算瓶颈。
5.8 训练时间友好网络(TTFNet)
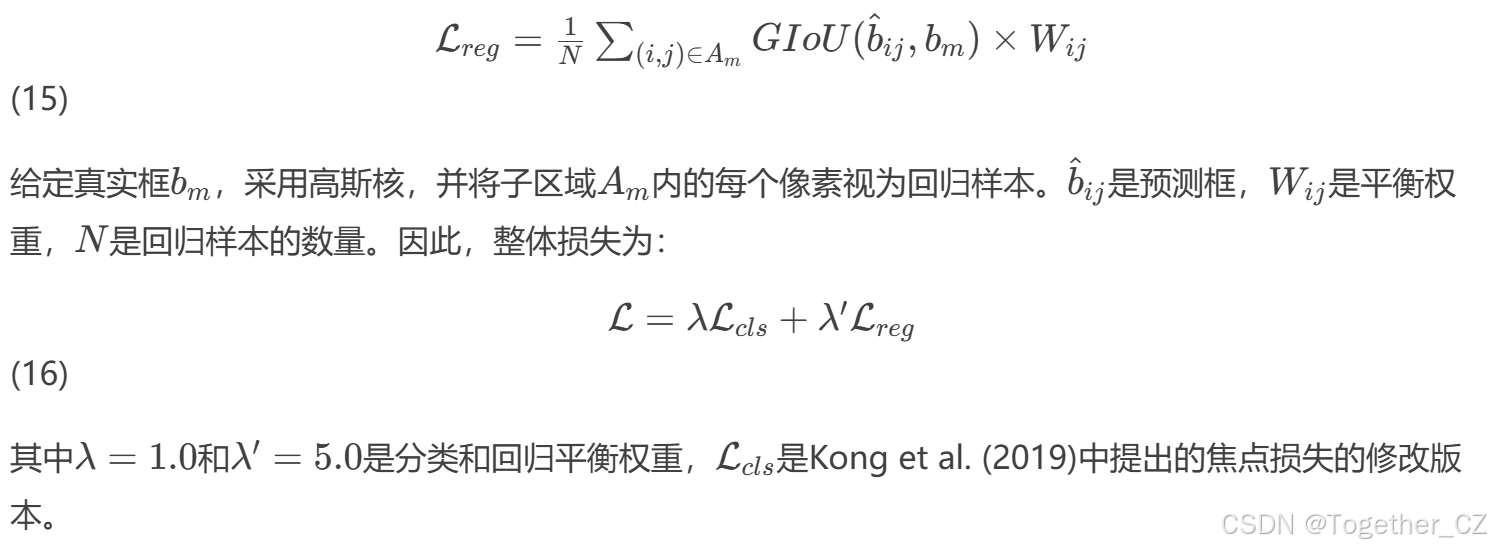
受CenterNet(Zhou et al., 2019a)启发,TTFNet使用相同的策略,其中检测被视为中心定位和边界框大小回归的两部分问题(Liu et al., 2020)。对于中心定位,TTFNet采用高斯核在对象中心附近产生更高激活的热图,类似于CenterNet,但此外还考虑了边界框的宽高比。对于大小回归,TTFNet不仅选择中心像素作为训练样本,还提出将高斯区域中的所有像素视为训练样本。此外,这些样本由目标大小和高斯概率计算的权重加权,从而利用更多信息。动机是编码更多训练样本类似于增加批量大小,这有助于扩展学习率和加速训练过程。
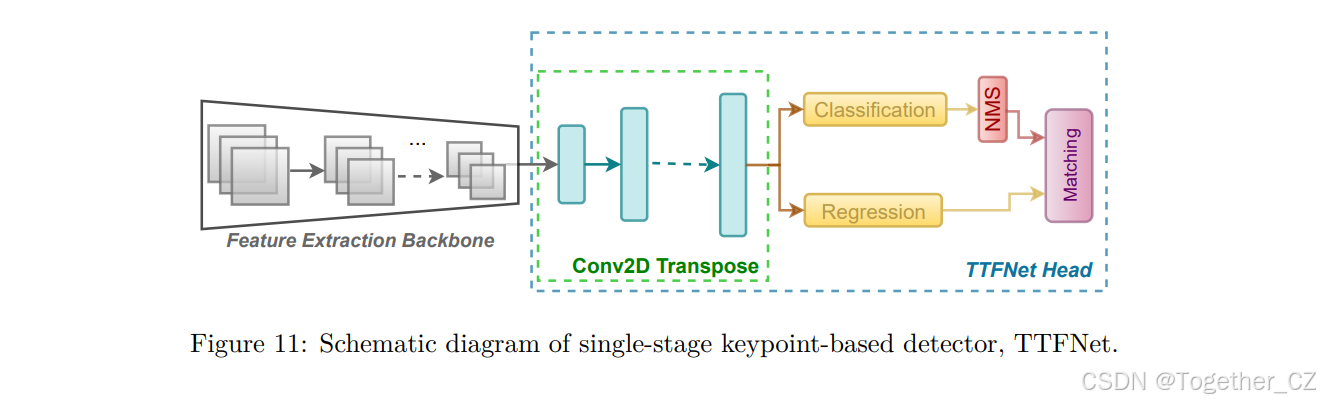
图11:基于关键点的单阶段检测器TTFNet的示意图。
TTFNet通过在对象中心周围构建子区域并仅从该区域提取训练样本来修改高斯核(图11)。高斯概率用作权重,以强调靠近目标中心的样本,从而缓解重叠模糊性。由于对象大小存在较大差异,较大对象产生的样本显著多于较小对象,因此较小对象的贡献可以忽略不计,这可能会影响检测精度。因此,引入了一种损失平衡策略,充分利用较大对象中的更多注释信息,同时保留较小对象的信息。
6. 骨干网络
在本研究中,我们选择了九个特征提取器作为骨干网络,基于速度、能源和内存效率等因素,特别适用于实时应用。以下,我们按时间顺序介绍骨干网络。
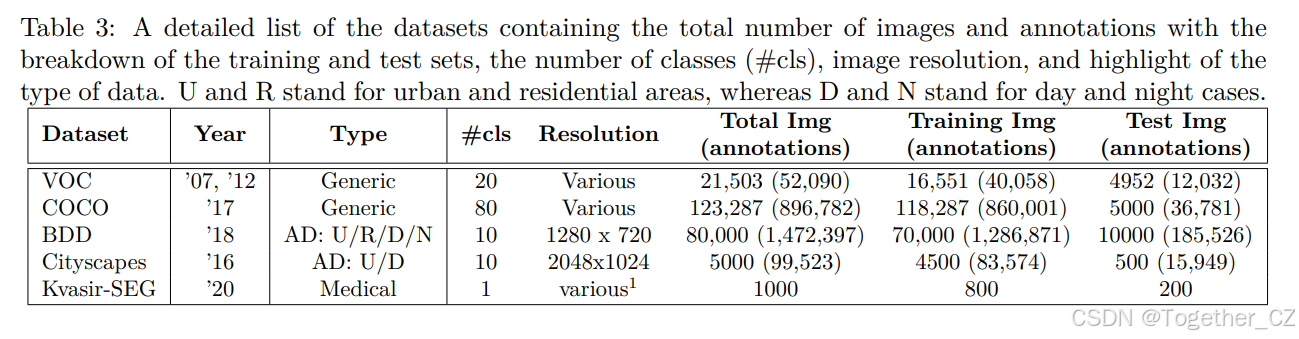
表3:包含数据集详细信息的列表,包括图像和注释的总数,训练集和测试集的细分,类别数量(#cls),图像分辨率,以及数据类型的亮点。U和R分别代表城市和住宅区,而D和N分别代表白天和夜间情况。
ResNet:He et al. (2016) 将网络层重新表述为学习残差函数的残差跳跃连接。具有跳跃连接的网络更容易优化,并且随着深度的增加可以获得显著的精度。本研究中考虑的轻量级变体ResNet-18由四个残差块组成,每个块有两个卷积层,后跟批量归一化层。
DarkNet:Redmon & Farhadi (2017) 提出了计算轻量级的特征提取器DarkNet,作为其实时目标检测算法YOLO的一部分。DarkNet通过减少参数数量改进了VGG-16。为了实时检测的目的,本研究中仅考虑DarkNet-19。
Xception:Chollet (2017) 提出的Xception是对Inception-V3(Szegedy et al., 2016b)的改进,完全基于深度可分离卷积(DWS;Kaiser et al. (2017))。所提出的架构是36个深度可分离卷积层的线性堆栈,结构化为14个模块,所有模块都有残差连接,除了第一个和最后一个。
MobileNet:Sandler et al. (2018) 设计的MobileNet-v2是专为嵌入式设备上的实时目标检测设计的轻量级骨干网络。该架构使用线性瓶颈和深度可分离卷积的倒置残差块。由于跳跃连接存在于网络的狭窄部分,因此参数数量较少。此外,网络包含输入和输出瓶颈之间的跳跃连接,以实现特征重用。
ShuffleNet-v2:Ma et al. (2018) 设计的ShuffleNet-v2通过减少内存访问成本来优化推理延迟。该架构的构建块包括通道分割操作,将输入分为两部分,每个部分通过残差块传递。引入通道混洗操作以实现两部分之间的信息传输,以提高精度。每个构建块的高效率使得可以使用更多特征通道和更大的网络容量。
VoVNet:Lee et al. (2019) 提出的VoVNet是用于实时检测的能源高效骨干网络。它使用一次性聚合(OSA)模块构建,该模块仅在最后一个特征图上连接所有中间特征。OSA块具有相同输入/输出通道的卷积层,以最小化MAC计数,从而提高GPU计算效率。本研究中使用VoVNet-39,这是更快和更节能的变体。
EfficientNet:Tan & Le (2019) 设计的EfficientNet使用自动多目标架构搜索进行优化,以实现精度和MAC计数的平衡。所提出的架构通过重新调整和平衡网络深度、宽度和分辨率来实现高精度。该架构的构建块使用Mobile Inverted Bottleneck Convolutions(MBConv),还包括挤压和激励(SE)模块(Hu et al., 2018)。在提出的多个版本中,我们使用EfficientNet-B0,这是该架构的最轻量级版本。
HarDNet:Chao et al. (2019) 提出的Harmonic Densely Connected Networks(HarDNet)在MAC计数和内存流量方面实现了高效率。HarDNet在减少DRAM(动态随机存取存储器)方面在所有其他骨干网络中脱颖而出。稀疏化方案提出了层之间的连接模式,使其类似于重叠的2的幂谐波波(因此得名)。所提出的连接模式形成了一组称为谐波密集块(HDB)的层,而不是考虑所有层,深度为LL的HDB中的梯度仅通过“log LL”层传递。HDB的输出是层LL及其所有前奇数层的串联,偶数层的输出在HDB完成后被丢弃。此外,使用步幅-8而不是许多CNN网络中采用的步幅-16来增强局部特征提取。除了减少特征图的流量外,它还提供了其他优势,如低延迟时间、更高的精度和更高的速度。在提出的多个版本中,我们使用HarDNet-68进行本研究。
DeiT:Touvron et al. (2021) 修改了视觉Transformer,以用作密集预测任务的特征提取器。所提出的架构Data-efficient image Transformer(DeiT)由重复的自注意力、前馈层和额外的蒸馏模块组成。为了提取有意义的图像表示,从最终Transformer块学习的嵌入被发送到额外的块,以在发送到检测头之前获得不同尺度的特征。本研究中使用该架构的最小版本,即DeiT-T(其中T代表tiny)。
7. 实证评估
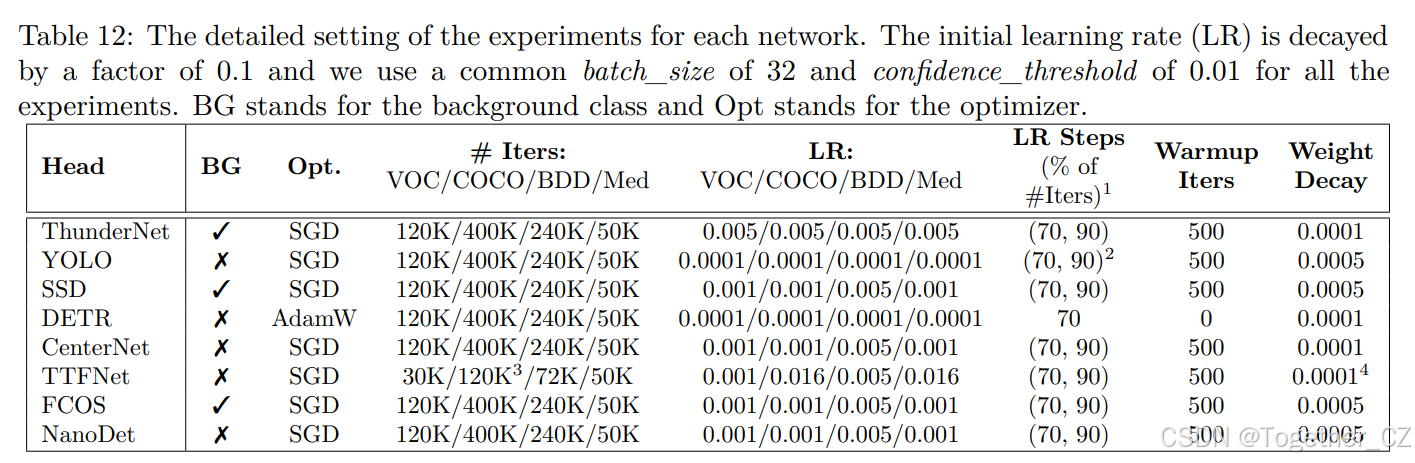
我们简要介绍了数据集、评估指标和实验设置。所有数据集的总体摘要见表3。所有检测器的实验设置和超参数细节在附录中的表12中概述。
7.1 数据集
PASCAL VOC,以下简称VOC(Everingham et al., 2010),包含20个对象类别,分为两个数据集,即VOC 2007和2012,共有21,493张图像,包含52,090个注释。我们将VOC '07和'12的训练和验证集合并用于训练。最终测试在VOC '07测试集上进行,包含4952张图像。
COCO(Lin et al., 2014)是一个更具挑战性的数据集,包含80个对象类别。按照Zhou et al. (2019a)的方法,我们使用2017年的数据集分割,其中包含118,287张图像(860,001个标记实例)用于训练。最终测试使用5000张图像,包含36,781个实例。
BDD(Yu et al., 2018)是自动驾驶领域最大和最具挑战性的数据集之一。它包含各种驾驶场景,包括城市、高速公路和农村地区,以及各种天气和昼/夜驾驶条件,代表了现实生活中的驾驶挑战。训练集包含69,863张图像,包含约128万个标记实例,测试集包含10,000张图像,包含185,526个标记实例,涵盖10个对象类别。
Cityscapes(Cordts et al., 2016)是一个记录良好的数据集,用于具有挑战性的城市场景中的完整场景理解。我们从实例分割和标记注释中提取边界框,然后将注释分组为10个超类别,以匹配BDD的类别。对于分布外评估,我们使用了500张图像的测试集,包含15,949个边界框。
Corrupted COCO。为了测试模型的鲁棒性,我们创建了一个数据集,通过在原始COCO数据集上添加不同的损坏来模拟现实世界场景中的外部影响(Michaelis et al., 2019)。有15种不同的损坏,我们将其分为四组:噪声、模糊、天气和数字效果。噪声包括高斯噪声、脉冲噪声和散粒噪声。模糊组包括散焦、玻璃、运动和缩放模糊效果。我们使用亮度、雾、霜和雪来模拟不同的天气条件。最后,我们通过添加对比度、弹性变换、JPEG压缩和像素化来模拟数字效果。这些15种损坏在5个不同的严重级别上应用。严重级别从1(较轻的损坏)到5(最严重的损坏)。
Kvasir-SEG(Jha et al., 2020)是一个用于定位胃肠道区域息肉的生物医学数据集。该数据集包含1000张图像,每张图像中都有息肉的分割掩码。数据集还包括从分割掩码中获得的边界框。这里,数据集分为800张图像用于训练,200张图像用于测试。
7.2 评估指标
目标检测器以边界框和类别标签的形式进行预测。在这里,我们首先通过计算预测边界框和真实边界框之间的重叠来测量重叠,计算交并比(IoU)(给定在等式3中)。根据IoU阈值,预测框被分类为真阳性(TP)、假阳性(FP)或假阴性(FN)。接下来,我们计算精确率和召回率,
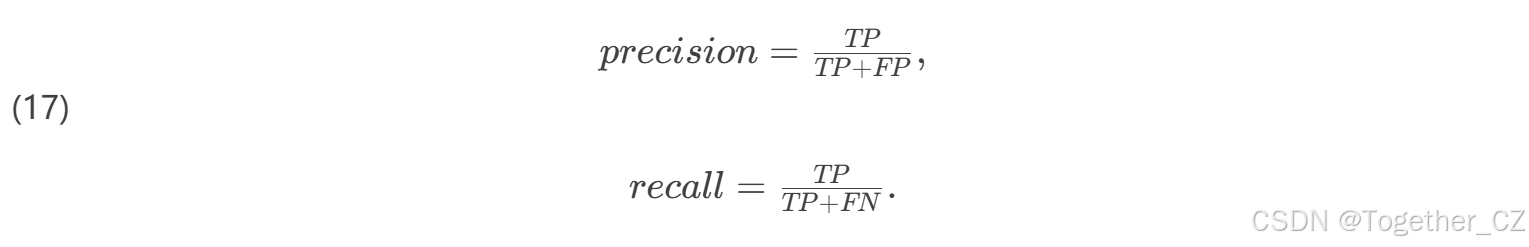
精确率衡量预测的准确性,而召回率显示模型找到所有正样本的能力。高精确率但低召回率意味着更多的FN,反之亦然意味着更多的FP。精确率-召回率(PR)曲线显示了不同阈值下精确率和召回率之间的权衡。它是向下倾斜的,因为随着阈值的降低,更多的预测被做出(高召回率),但它们不太精确(低精确率)。我们在不同IoU阈值下计算所有召回值(在0和1之间)的平均精确率(AP),可以解释为PR曲线下面积。最后,通过在所有类别上平均AP来计算mAP(平均平均精确率)。PASCAL VOC挑战(Everingham et al., 2010)在0.5 IoU阈值下评估mAP(@IoU:0.5),而COCO挑战(Lin et al., 2014)设置十个不同的阈值@IoU:[0.5-0.95],步长为0.05。在某些应用中,如医疗,召回率度量比精确率更重要,因为更多的FN比FP更有害。通过在所有IoU上平均召回率来计算平均召回率,并报告为平均平均召回率(mAR)。我们还报告了F1分数指标,该指标衡量精确率和召回率之间的平衡。F1分数计算如下:
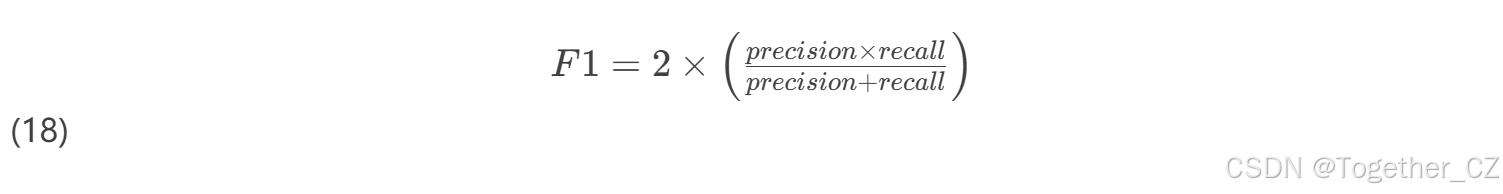
我们计算检测器的卷积、批量归一化和全连接层的乘积累加操作(MAC)计数,并报告可学习参数的数量(以百万为单位)。我们还报告了每个主干和检测头组合的每秒帧数(FPS)的推理速度。推理速度对500张图像进行计算并平均,以消除任何偏差。
最后,鉴于能源高效AI的趋势(Schwartz et al., 2019),我们计算了模型在整个测试数据集上的推理能源消耗。我们使用NVIDIA管理库(NVDIA, 2019)计算GPU在推理期间的近似功耗。数据集上的推理能源消耗以千焦(kJ)为单位报告,我们不包括其他组件的功耗。
7.3 实验设置
所有网络在我们的存储库中重新实现。在执行其他实验之前,首先重现相应论文的原始结果。我们的完整框架在PyTorch 1.7(Paszke et al., 2019)中,包括所有主干和检测头,以执行所有训练和评估。为了在不同目标检测网络之间进行公平比较,我们对训练和评估使用一致且统一的方案。
除非另有说明,否则我们所有的实验都使用以下训练方案。重要的是要注意,一些检测头(如YOLO和DETR)在其原始实现中使用多尺度训练,但为了统一的训练方案,我们使用图像大小为512的单尺度训练。所有图像首先通过每通道减去ImageNet均值(Russakovsky et al., 2015)进行归一化。对于检测头,使用默认的PyTorch权重初始化,固定种子值,并使用预训练的ImageNet权重进行主干。对于数据增强,我们使用扩展、随机水平翻转、随机裁剪和随机光度失真,包括在[0.5, 1.5]范围内的随机对比度、饱和度和[-18, +18]范围内的色调。
我们使用批量大小为32,并使用动量为0.9的随机梯度下降(SGD)优化器(Bottou, 2010)进行训练,学习率衰减因子为0.1。学习率调度器的选择确保所有模型的收敛。唯一的例外是DETR,我们遵循作者并使用AdamW(Loshchilov & Hutter, 2017)优化器。NMS阈值设置为0.45,置信度阈值设置为0.01(如果适用)。对于所有实验,我们在NVIDIA RTX 2080Ti GPU上评估模型,除非另有说明。Pytorch模型使用NVIDIA TensorRT(版本8.0)转换为优化的推理引擎,以便在嵌入式硬件上部署。TRT转换通过融合网络中的多个层(包括卷积和批量归一化层)来优化网络,以实现并行处理。推理能源消耗使用NVIDIA NVML API(Corporation, 2020)在单个干净机器上计算,运行应用程序最少。
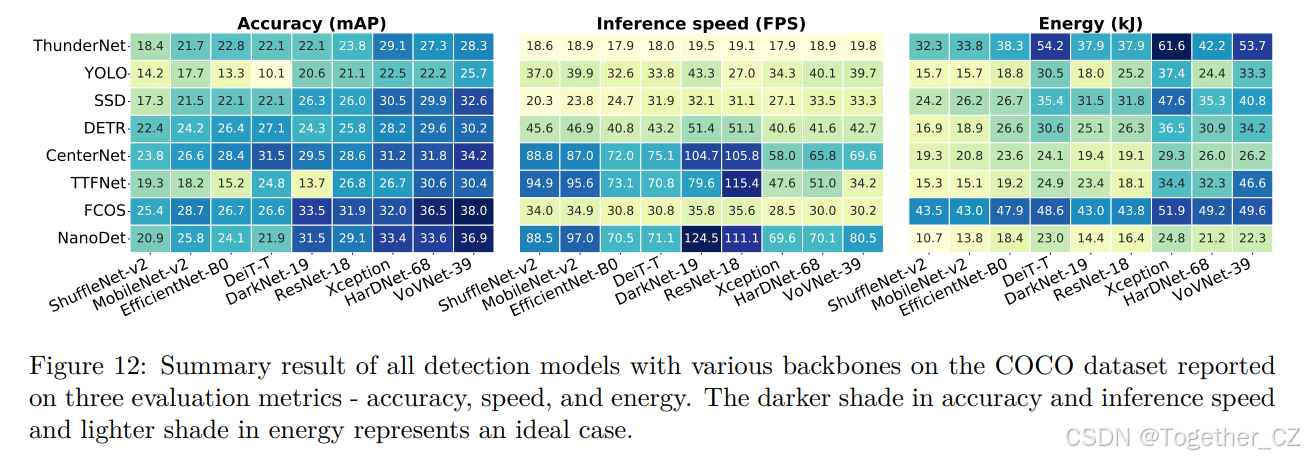
图12:所有检测模型在COCO数据集上使用不同骨干网络的总结结果,报告了三个评估指标——准确性、速度和能耗。在准确性和推理速度中,较深的阴影代表理想情况,而在能耗中,较浅的阴影代表理想情况。
8. 结果
我们在图12中提供了所有网络的总体结果概述,以展示三个指标(推理精度、速度和能源消耗)在COCO数据集上的总体趋势。主干和检测头按“精度”作为关键指标排序,结果从低到高排列。为了更容易进行性能分析,我们将主干和检测头分为三个范围,即低、中和高,其中低和高是表现最差和最好的主干和检测头组合,中间范围包含平均表现的网络。
精度:图12显示,三个主干,即VoVNet-39、HarDNet-68和Xception,在所有检测头上始终实现高精度,属于高范围。VoVNet和HarDNet的精度归功于One-Shot Aggregation(OSA)模块和局部特征增强模块,而36个CNN层的线性堆栈有助于Xception。中间范围由ResNet-18、DarkNet-19和DetT-T占据。ResNet和DarkNet都是轻量级架构,DetT享受自注意力模块的好处,有助于全局上下文。最后,EfficientNet-B0、MobileNet-v2和ShuffleNet-v2,这些主要设计用于减少MAC计数的精简网络,实现了最低的精度。
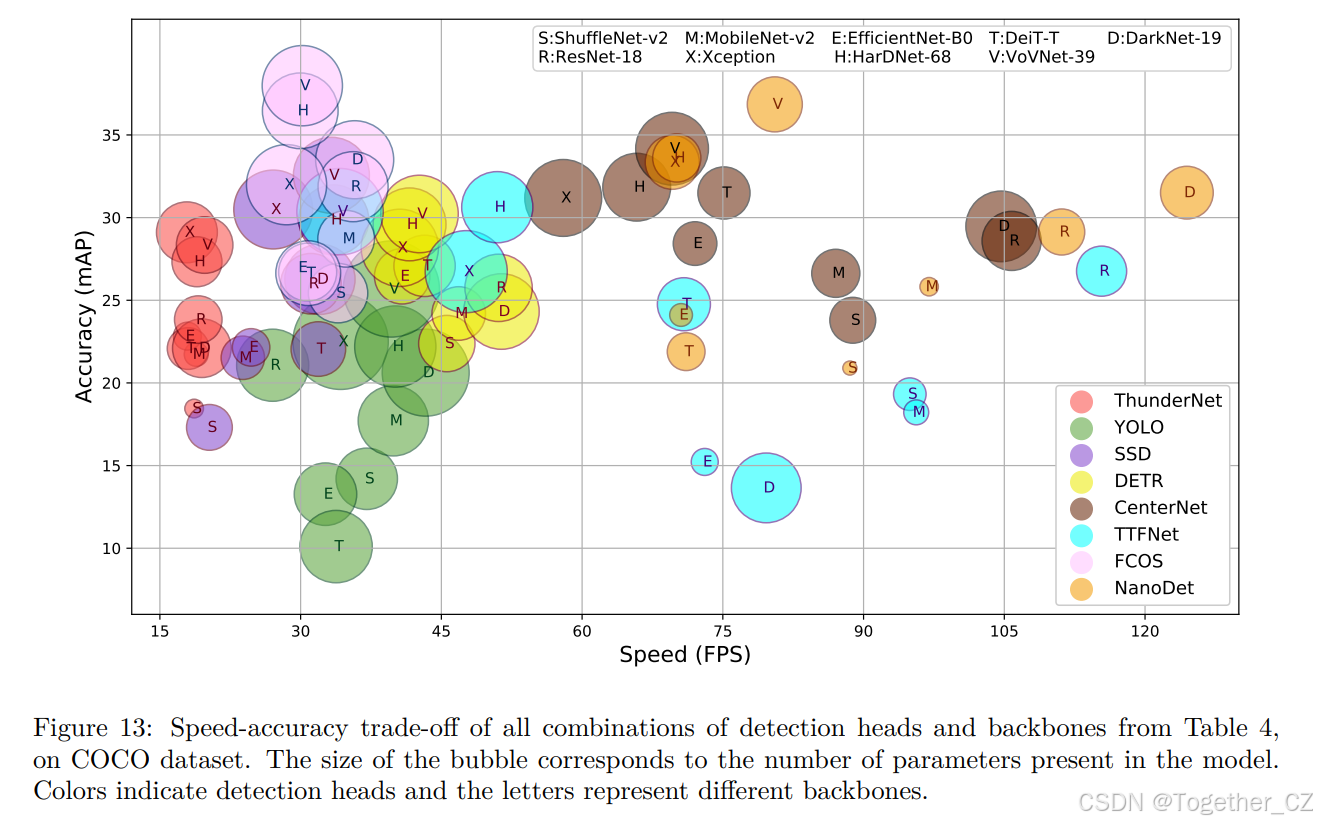
图13:表4中所有检测头和骨干网络组合在COCO数据集上的速度-准确性权衡。气泡的大小对应模型中的参数数量。颜色表示检测头,字母代表不同的骨干网络。
在检测头中,单阶段基于关键点的检测器,如NanoDet、FCOS、TTFNet和CenterNet,始终实现高精度。所有这些检测器都是基于关键点估计的方法,不再有定义基于对象大小的锚点大小的麻烦。FCOS具有FPN进行多尺度预测,并有一个中心性分支来过滤掉低质量预测。NanoDet结合了PAN,增强了低级特征,并使用GLoU损失来细化位置。TTFNet和CenterNet也结合了多个分辨率,并进一步细化位置。DETR中的注意力模块提高了精度,但由于骨干仍然是CNN,性能被推到中间范围。SSD也占据中间范围,在精度和速度之间提供了良好的平衡。YOLO和ThunderNet,分别是基于锚点和两阶段检测器,占据了较低的范围。
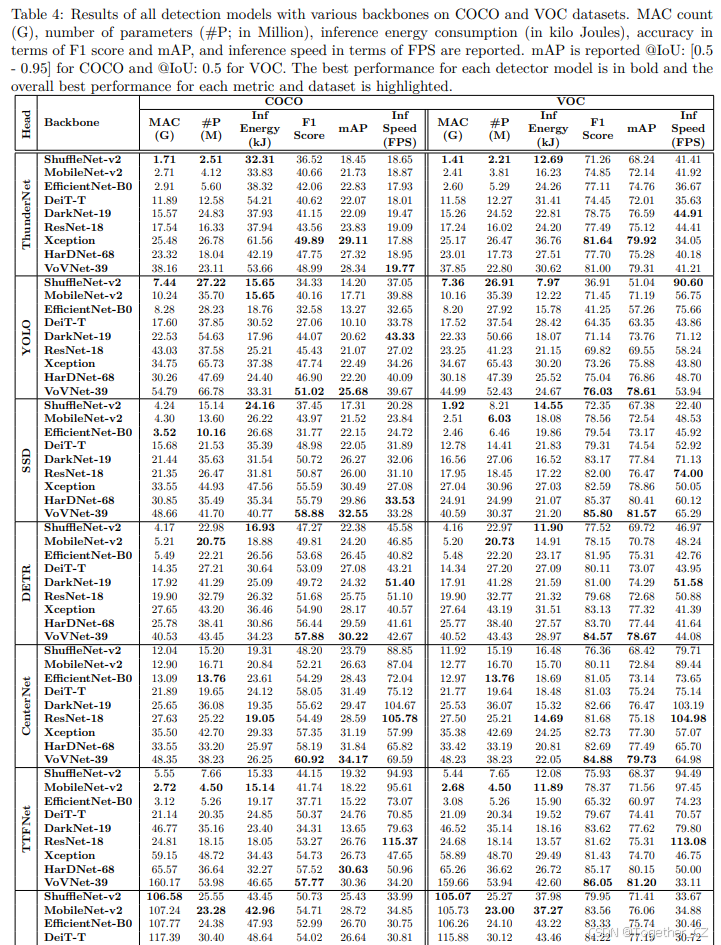
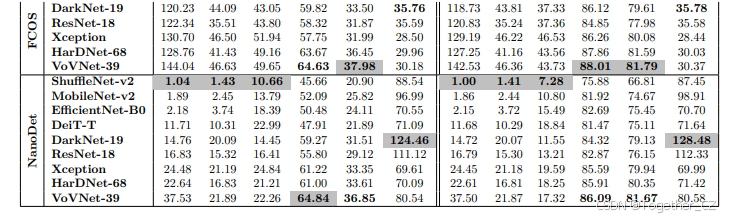
表4:所有检测模型在COCO和VOC数据集上使用不同骨干网络的结果。报告了MAC计数(G)、参数数量(#P;以百万计)、推理能耗(以千焦计)、F1分数和mAP的准确性,以及以FPS为单位的推理速度。COCO数据集的mAP报告为@IoU: [0.5 - 0.95],VOC数据集的mAP报告为@IoU: 0.5。每个检测模型的最佳性能以粗体显示,每个指标和数据集的整体最佳性能以高亮显示。
速度:图12(中间图)中的推理速度显示了与精度不同的趋势。在精度方面处于中间范围的网络是最快的,即ResNet-18、DarkNet-19和DetT-T,从而在精度和速度之间实现了良好的权衡。尽管ShuffleNet-v2是最不准确的,但由于其修剪的架构设计用于低延迟,推理速度非常高。VoVNet-39和HarDNet-68在精度方面处于最高范围,在速度方面处于中间范围。然而,Xception由于其大的卷积层堆栈,是最慢的。
在检测头中,CenterNet、TTFNet和NanoDet是最快的,并且显著优于其他检测器。CenterNet和TTFNet没有NMS瓶颈(因为它使用基于热图峰值的最大池NMS而不是基于IoU的NMS),这有助于提高推理速度。FCOS具有最高的精度,但在速度方面处于最低范围,因为它具有五个特征图和额外的中心性分支的重型架构。NanoDet类似于FCOS,但具有更优化和轻量级的架构,只有三个特征图,没有单独的分支,从而提高了推理速度。DETR处于中间范围,因为Transformer架构不如CNN那样硬件优化(Ivanov et al., 2020)。SSD和YOLO也处于中间范围,实现了平均速度。两阶段检测器ThunderNet是最慢的。
进一步,图13显示了所有检测头和主干组合(72个组合)在COCO数据集上的速度、精度和参数权衡。每个气泡的大小表示网络中的参数数量。大多数组合的结果在15到50 FPS的速度范围内,而NanoDet和CenterNet在所有主干上实现了更高的速度。
能源和资源:图12(最后一图)显示,在主干中,低范围网络消耗的能源最少,因为这些网络非常小,这在较低的参数数量(表4中)中也有体现。DarkNet被证明是非常节能的。在检测头中,高范围检测器表现良好,除了FCOS,因为架构比其他基于关键点的检测器更重。NanoDet,专门设计用于在移动硬件上运行,消耗的能源最少。SSD和DETR在能源消耗方面保持中间范围。ThunderNet由于在分类和回归阶段之外还有提议阶段,消耗的能源比单阶段检测器更多。
详细分析:
表4提供了八个检测头和九个主干在两个不同数据集(VOC和COCO)上的更多详细信息。我们报告了详细的精度(mAP和F1分数)、推理速度(FPS)、推理能源消耗(kJ)以及资源信息,如GMAC计数和参数数量(百万)。VOC在复杂性上较为简单,类别数量为20,与COCO相比,精度(mAP和F1分数)在更高的范围内。然而,网络在两个数据集上显示了相似的趋势。FCOS + VoVNet-39组合具有最高的精度,而NanoDet+DarkNet-19组合在两个数据集上都具有最高的推理速度。在中间范围的主干中,DetT-T显示了较低的MAC计数。资源在两个数据集上相似,除了SSD,当数据集从VOC更改为COCO时,参数数量增加(在某些情况下增加约2倍)。由于SSD使用六个特征图,每个特征图具有单独的锚点框,因此当类别数量增加时,资源开销更大。这种影响在无锚点设计中不那么显著。
总体而言,在高范围的主干中,HarDNet-68和VoVNet-39在所有指标上表现良好,但Xception在所有指标上表现不佳,除了精度。中间范围由ResNet-18、DarkNet-19和DetT-T组成,在精度和速度之间提供了良好的平衡。DetT-T由于没有卷积,是最资源友好的,具有最少的MAC计数。在检测头中,NanoDet实现了高精度和速度,同时计算效率高。CenterNet和TTFNet也提供了良好的平衡,而TTFNet在训练时间上更快。DETR(类似于NanoDet)在与较轻的主干配对时显示了较低的MAC计数。我们的详细结果为根据特定需求选择网络提供了地图集,并在设计和测试新架构时作为比较基线。
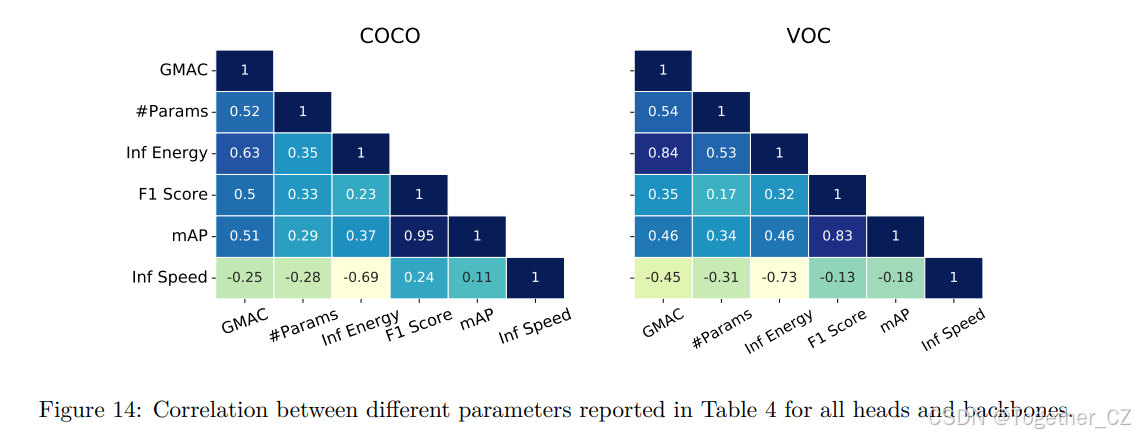
图14:表4中所有检测头和骨干网络的不同参数之间的相关性。
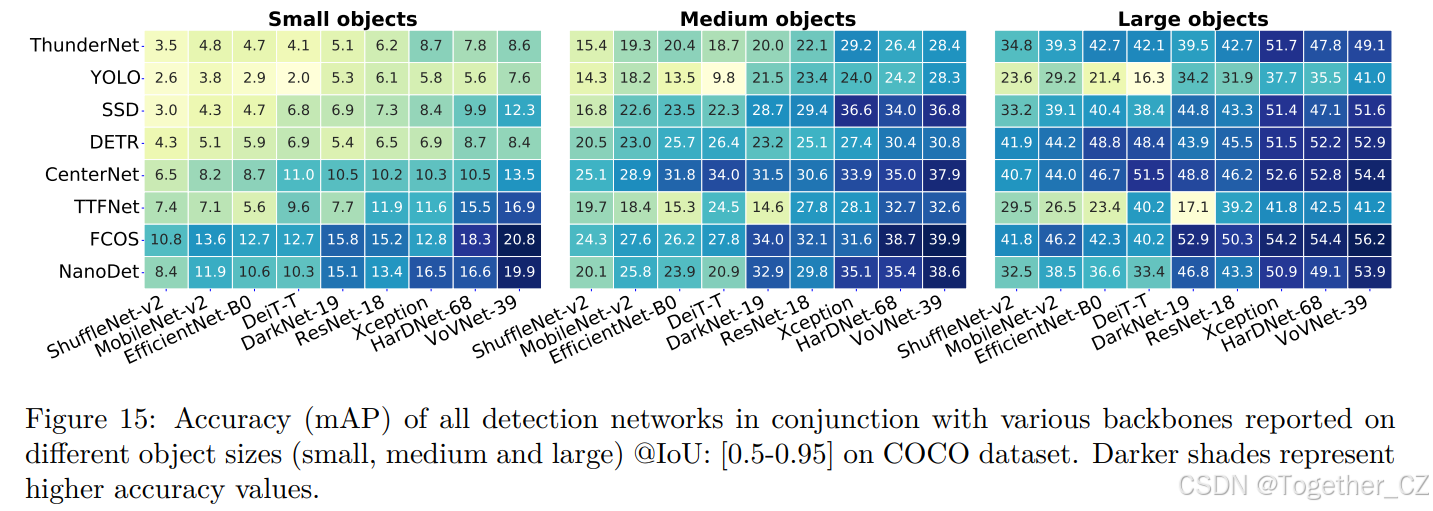
图15:所有检测网络在不同骨干网络下的准确性(mAP),报告了不同对象大小(小、中、大)@IoU: [0.5-0.95]在COCO数据集上的表现。较深的阴影代表较高的准确性值。
为了进一步展示在不同指标上评估网络的重要性,我们在图14中报告了表4中所有主干和检测头的所有指标之间的皮尔逊相关性。由于图是对称的,仅显示下三角形。如所见,精度与所有其他指标正相关,GMAC与F1分数最高相关。速度仅与推理能源高度负相关。能源与GMAC具有最高的正相关性,表明具有更多MAC操作的网络往往消耗更多能源。
COCO数据集上每个检测器的定性结果在附录中的图23中展示。
9. 解耦不同影响
网络的精度可以依赖于多个因素,因此在本节中,我们提供了进一步的分析,以解耦这些变量。我们研究了网络在不同对象大小(小、中和大)上的性能。我们还展示了使用不同分辨率的输入图像进行训练时的精度增益/损失。置信度阈值参数在报告性能时的作用通过示例解释。对于基于锚点的方法,我们展示了网络对不同锚点大小的敏感性。最后,我们解耦了一个架构元素,即可变形卷积(DCN)层在网络中的作用,以理解精度和速度之间的权衡。本节提供了对许多未被重视的变量对目标检测器性能影响的罕见展望,以提供一个全面的画面,有助于部署和设计架构。
9.1 对象大小的影响
小型对象检测对大多数目标检测器来说是一个具有挑战性的问题(Liu et al., 2021)。为了展示不同大小的对象的网络性能,我们比较了主干和检测头在三个不同大小(小、中和大)上的精度。图15显示,所有主干和检测头在检测小型对象时都难以获得高精度。在这种情况下,TTFNet、NanoDet和FCOS表现优于其他检测器,尤其是当它们与表现最好的重型主干(如HarDNet-68或VoVNet-39)配对时(见表4)。较高分辨率的特征图从较重的骨干网络中提取,结合FPN/PAN在这些检测头中,对它们有利。中型和大型对象的精度明显更好。总体而言,FCOS和NanoDet在所有大小的对象上表现更好。TTFNet、CenterNet和SSD处于中间范围,使用较快的骨干网络可以在需要更高推理速度的应用中成为不错的选择。FCOS的稳定性能可以归因于其使用五个不同分辨率的特征图的较重架构。
为了进一步分析,我们考虑所有检测头与HarDNet-68骨干网络配对,因为它在更复杂的COCO数据集上提供了最佳的折衷。
9.2 输入图像大小的影响
训练中使用的图像分辨率在最终精度中起主要作用。所有先前的实验使用的图像分辨率为512×512。为了分析其他输入分辨率的精度和速度权衡,我们使用不同的图像大小进行训练,包括256、384、512和736。图像大小选择为“16的偶数倍”,这是多个检测头常用的特征图。
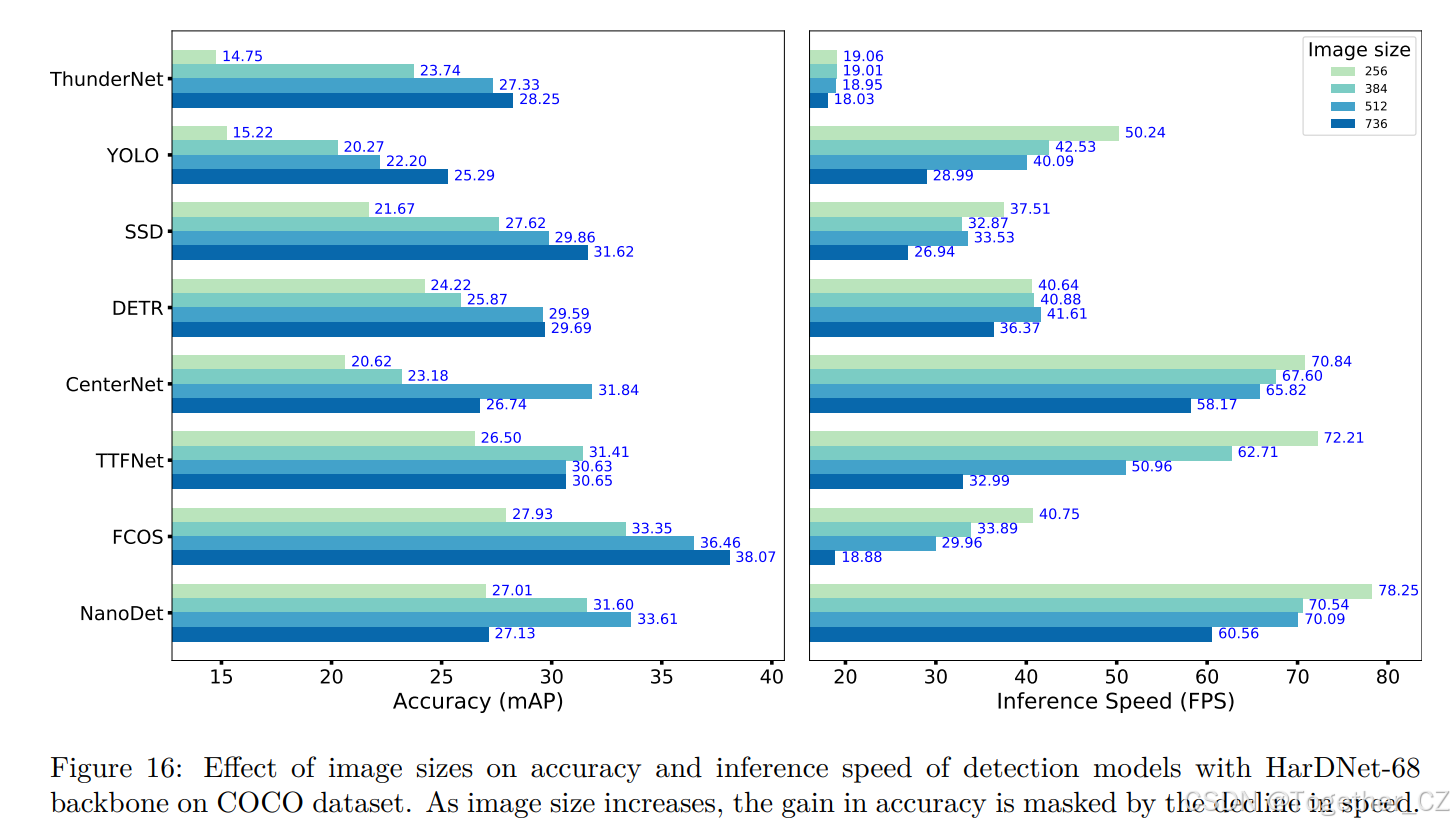
图16:图像大小对使用HarDNet-68骨干网络的检测模型在COCO数据集上的准确性和推理速度的影响。随着图像尺寸的增加,准确性的提升被速度的下降所掩盖。
图16展示了不同图像大小对精度和推理速度的影响。大多数检测头的精度遵循“收益递减”的趋势。在大多数情况下,从256到384的图像分辨率显著提高了精度。然而,随着图像大小的进一步增加,增益减少,在某些情况下,从512到736的图像大小甚至降低了精度。此外,我们观察到,更高的图像分辨率的精度增益被更大的速度下降所掩盖。例如,FCOS从分辨率512到736的精度增益约为4.4%,但速度下降了37%,因此切换到更高的分辨率并不是一个高效的选择。YOLO、TTFNet和FCOS的速度下降在增加分辨率时更为显著,因为多分辨率特征连接中的操作数量随着图像大小增加。DETR由于使用注意力块捕捉图像的全局上下文,对变化的图像大小不太敏感,而ThunderNet由于每个样本的单独区域提议,对变化的图像大小也不太敏感。
9.3 锚点框大小的影响
锚点大小和宽高比需要与数据集中对象的大小一致,因此是基于锚点网络的重要参数。锚点大小也需要事先知道,因此难以适应新数据集。在我们研究的八个检测头中,SSD、YOLO和ThunderNet使用基于锚点的方法进行检测。为了分析锚点对检测性能的影响,我们对所有三个基于锚点的检测头进行了实验,锚点框的大小由其宽度和高度定义。目的是在锚点的宽度和高度上添加一些偏移,并分析网络的速度和精度变化。我们没有线性增加/减少锚点维度,而是从高斯分布中采样偏移,并将其添加到原始锚点的宽度和高度,以创建修改后的锚点维度。此外,在整个实验中,修改后的锚点保持不变。原始锚点的宽度和高度(从这些网络的原始架构中)被视为基线。
表5:锚框大小对使用HarDNet-68骨干网络的三种基于锚点的检测网络在COCO数据集上的准确性(mAP)和推理速度(FPS)的影响(@IoU: [0.5, 0.95])。数值以相对于原始锚框大小的百分比变化报告。每个检测器的最佳性能以粗体显示。没有共同的规律,性能随锚框大小的变化呈现出非确定性的方式。
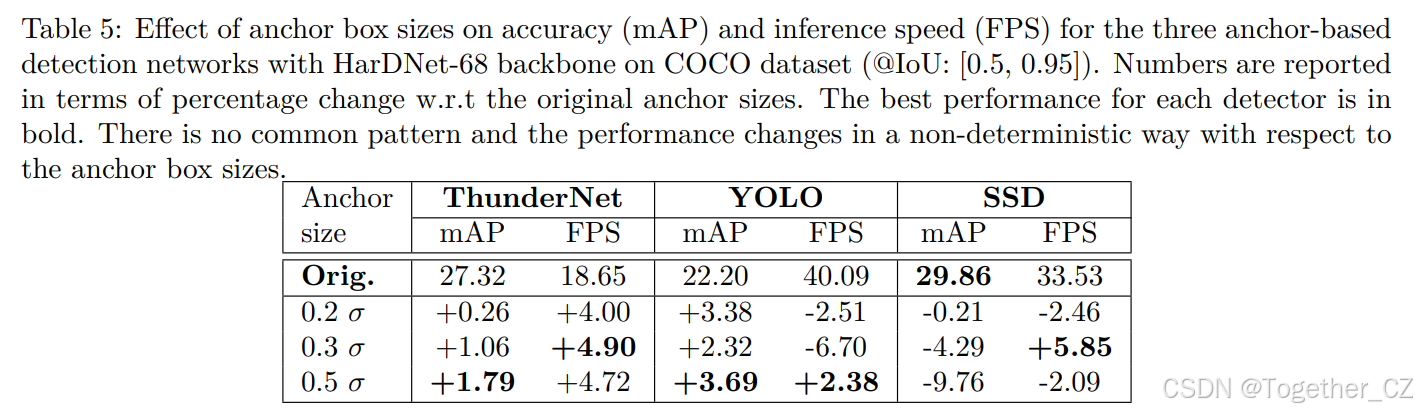
表6:置信度阈值对使用HarDNet-68骨干网络的检测器在COCO数据集上的性能和推理速度(FPS)的影响(@IoU: [0.5-0.95])。结果显示,较低的阈值产生更高的准确性,而较高的阈值产生更高的速度。
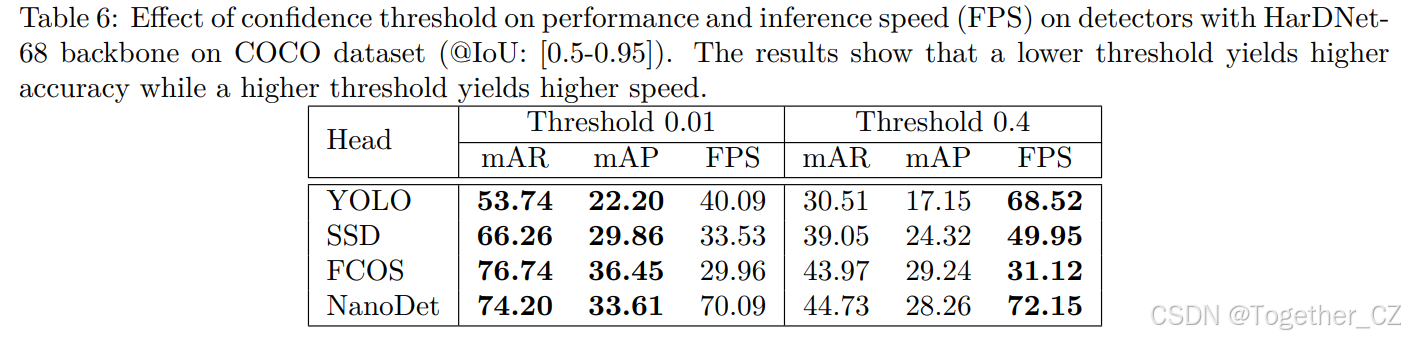
表7:可变形卷积层(DCN)对准确性和效率指标的影响。使用HarDNet-68骨干网络的检测器在COCO和BDD数据集上进行训练和测试(@IoU: [0.5-0.95])。使用DCN带来的准确性提升是以速度降低和资源需求及能耗增加为代价的。
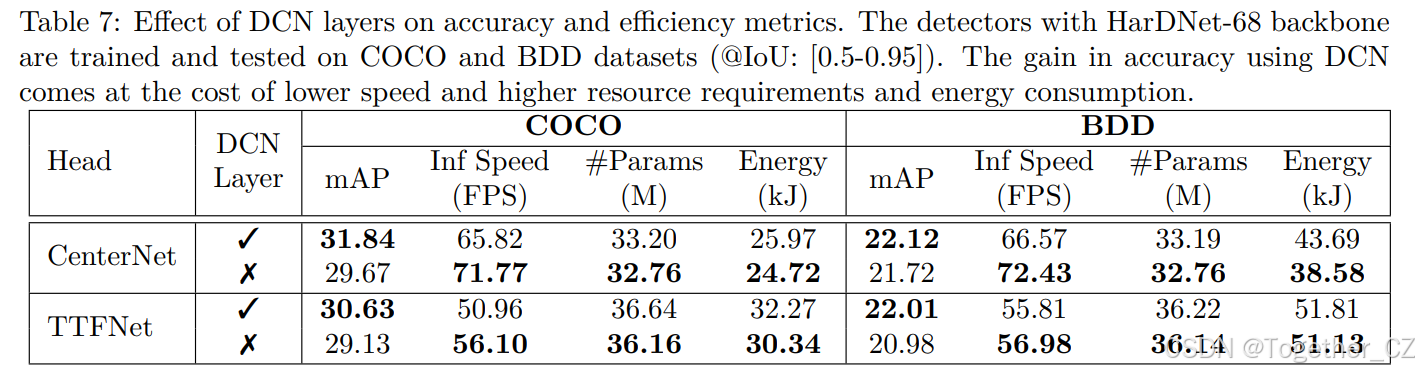
表5显示了修改后的锚点在精度(mAP)和推理速度(FPS)方面的变化百分比。我们观察到,不同大小的锚点对精度的影响遵循随机模式,精度与速度之间没有相关性。ThunderNet对锚点大小的变化不太敏感,在精度方面,而其推理速度持续提升。SSD对这些变化非常敏感,其精度在所有三个锚点大小集上下降,而速度在一个集上增加。YOLO的精度在变化中提高,但推理速度没有一致的变化。锚点大小以非确定性的方式影响检测,证明通过修改锚点来提高检测不是一个简单直接的任务。
9.4 置信度阈值的影响
目标检测器产生许多框,并使用阈值过滤掉冗余和低置信度的预测。改变此阈值会影响精确率和召回率。因此,置信度阈值在计算精度和推理速度中起关键作用。由于这些参数未明确提及,重现先前目标检测文献中的结果存在差异。使用不同的阈值显示了精度和推理数字的显著差异。为了展示这种不一致性,我们使用不同的置信度阈值分析网络,并报告每个的mAR和mAP,以及速度。
ThunderNet具有基于区域的提议,并使用Soft-NMS,分数衰减而不是固定硬阈值,因此此参数不影响结果。CenterNet和TTFNet使用最大池选择预测,而DETR消除了传统检测模块,因此不使用此阈值。因此,仅考虑YOLO、SSD、FCOS和NanoDet进行此研究。表6显示,使用更高的阈值时精度下降,而使用更低的阈值时速度显著增加。例如,YOLO的mAP通过将阈值从0.01更改为0.4下降了约22%,而速度增加了约71%。对于医疗成像等应用,召回率度量更相关,以消除假阴性病例,精度下降更为显著,因此可能产生更高的影响。此分析旨在鼓励未来工作中的透明度和公平比较,这将有助于重现性。
9.5 可变形卷积层的影响
Dai et al. (2017) 引入了可变形卷积(DCN)层,有助于检测具有几何变形的对象。传统卷积在图像上使用固定矩形网格,基于定义的内核大小。在DCN中,每个网格点可以通过可学习的偏移量移动,即网格是可变形的。DCN基准主要关注精度增益,而不是其他指标。为了获得更多关于速度和资源需求的信息,我们分析了在原始提出的架构中使用DCN的两个检测器,即CenterNet和TTFNet的效果。
表7提供了这两个检测器在有无DCN层时的精度、速度、参数数量和能源消耗。结果在两个数据集(COCO和BDD)上报告。在BDD数据集上,用标准卷积层替换DCN层在CenterNet中导致精度下降1.8%,而速度提高了8%以上。使用DCN层还增加了参数数量,并导致13%的更高能源消耗。在COCO数据集上,将DCN层从TTFNet更改为标准卷积层将精度降低不到5%,而速度提高了10%,能源消耗改善了约6%。这些结果表明,使用DCN层在精度和速度以及资源需求之间存在固有的权衡。
总体而言,本节为新的设计考虑提供了指南,并根据应用标准选择现有架构。
10. 目标检测器的校准
许多应用,尤其是安全关键型应用,需要检测网络具有高精度和可靠性。检测器不仅需要准确,还应在可能不正确时指示。模型校准提供了模型不确定性的洞察,可以随后传达给最终用户或在进一步处理模型输出时使用。它指的是与整体准确性可能性相关的预测概率。大多数工作仅关注提高网络的预测精度,但拥有一个校准良好的模型也很重要。大而准确的网络往往过于自信(Guo et al., 2017)且校准不佳。因此,有必要重新审视和衡量最先进检测器的校准情况,以获得完整的评估。
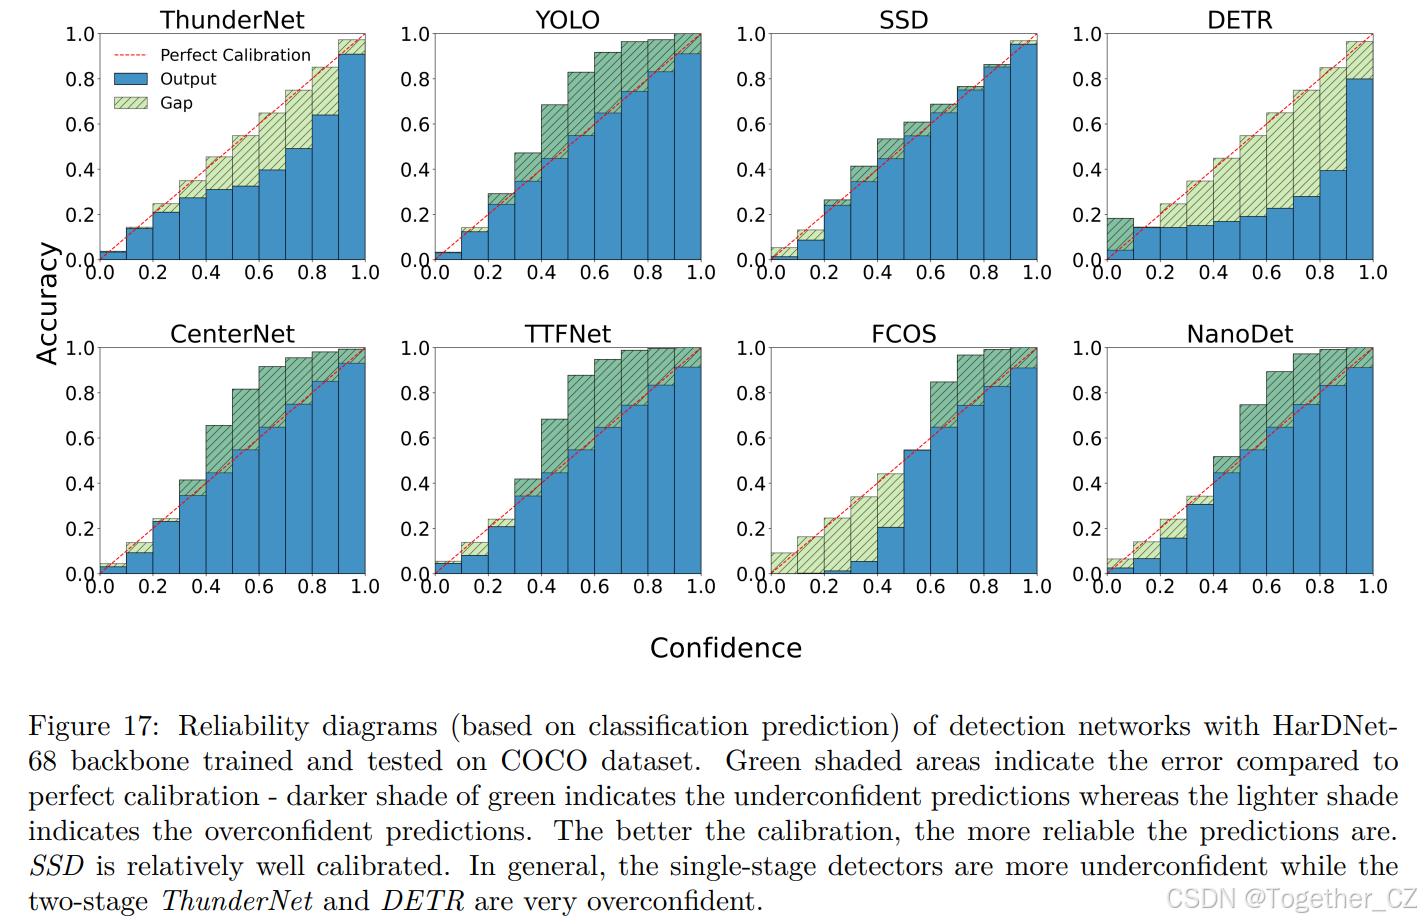
图17:使用HarDNet-68骨干网络在COCO数据集上训练和测试的检测网络的可靠性图(基于分类预测)。绿色阴影区域表示与完美校准的误差——较深的绿色阴影表示预测不足,而较浅的绿色阴影表示过度自信的预测。校准越好,预测越可靠。SSD的校准相对较好。总体而言,单阶段检测器较为不足自信,而两阶段的ThunderNet和DETR则非常过度自信。
表8:使用HarDNet-68骨干网络在COCO数据集上训练和测试的检测网络的校准误差。每一行显示特定维度的误差:仅分类置信度(ECE)和置信度+边界框(D-ECE)。所有检测器中最低的校准误差以高亮显示。
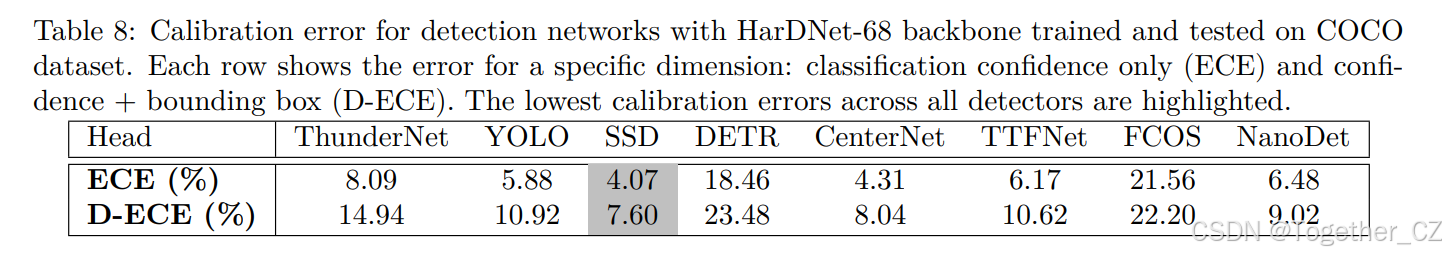
大多数关于校准的工作集中在分类领域,但Kuppers et al. (2020) 包括边界框预测以及分类标签来评估检测器的整体校准。预期校准误差(ECE)(Naeini et al., 2015)是衡量校准的常见指标,衡量预测置信度和准确性之间的期望差异。在分类领域,此分数表示分类准确性与估计置信度之间的偏差。检测ECE(D-ECE)(Kuppers et al., 2020)衡量观察到的平均精度(AP)与分类和边界框属性的置信度之间的偏差。置信度空间和边界框空间被划分为相等的区间,并通过迭代所有区间并累积每个区间中AP和置信度之间的差异来计算D-ECE。一维情况仅考虑置信度,但我们使用多维D-ECE情况,结合所有因素:pp、cxcx、cycy、ww、hh,分别表示类别概率、中心坐标、宽度和预测的高度。
可靠性图(DeGroot & Fienberg, 1983)用于直观表示模型校准,其中准确性作为置信度的函数绘制。
可靠性分数和图在表8和图17中提供。在可靠性图中,对角线表示完美校准,绿色阴影表示校准误差。在基于锚点的检测器中,SSD相对校准良好,而YOLO则不够自信。所有基于关键点的方法(图中的最后一行)都倾向于不够自信,对它们的预测更加谨慎,因此在安全关键型应用中更有利。然而,基于Transformer的(DETR)和两阶段(ThunderNet)检测器都非常过度自信,这在安全关键型应用中可能不可取。校准误差在包括定位时增加(如D-ECE所示)。VOC数据集的可靠性图在图20中提供。我们进一步提供了所有检测器在COCO数据集上训练并在Corrupted COCO数据集上测试的可靠性图,如图21所示。在分布外校准分析变体中,非常相似的模式成立。更多细节见附录A.4。
我们注意到,分类领域有几种校准解决方案,如直方图分箱(Zadrozny & Elkan, 2001)、逻辑校准/Platt缩放(Platt et al., 1999)、温度缩放(Guo et al., 2017)和beta校准(Kull et al., 2017)。然而,将这些应用于目标检测可能效果不佳,因此其他工作(Neumann et al., 2018; Kuppers et al., 2020)提出了获取目标检测校准估计的方法。在本研究中,我们专注于比较不同检测器的可靠性,而不深入探讨改进其校准的解决方案。
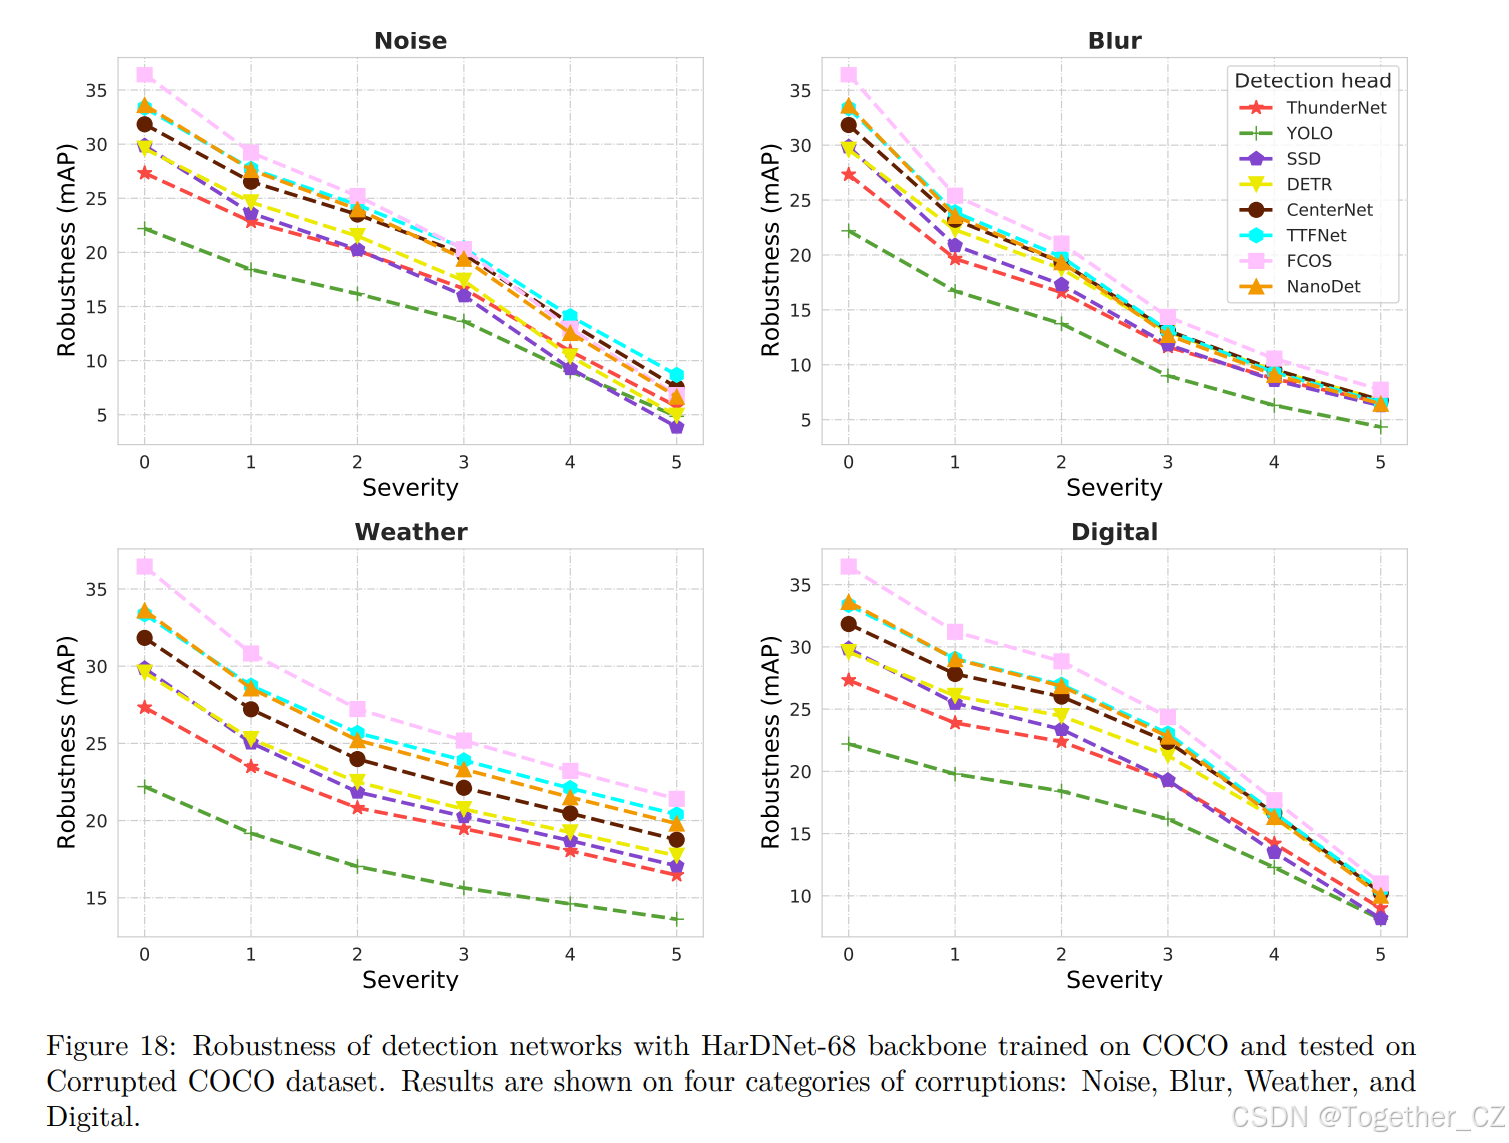
图18:使用HarDNet-68骨干网络在COCO数据集上训练并在损坏的COCO数据集上测试的检测网络的鲁棒性。结果显示在四类损坏类别上:噪声、模糊、天气和数字。
11. 自然鲁棒性
实时目标检测应用,如自动驾驶,对安全性和精度有巨大要求。在这些应用中使用的目标检测器需要在各种因素(如变化的天气条件、光照和其他成像效果)下保持一致的预测。公共数据集没有涵盖所有这些效果,因此我们通过添加不同的损坏来模拟它们。如第7.1节所述,Corrupted COCO数据集是通过在原始COCO数据集上添加15种不同的损坏创建的。
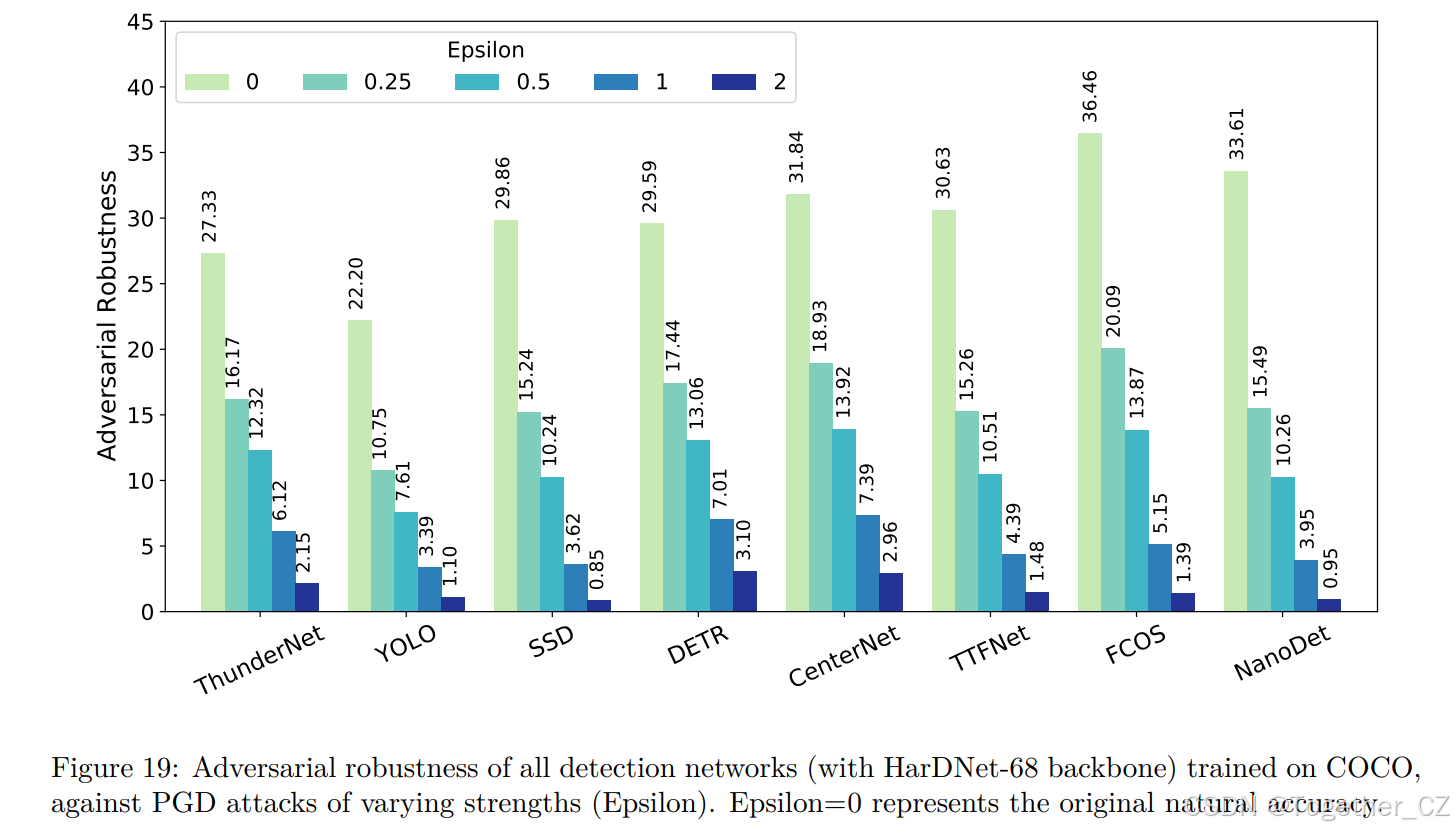
图19:所有使用HarDNet-68骨干网络在COCO数据集上训练的检测网络对抗不同强度(Epsilon)的PGD攻击的对抗鲁棒性。Epsilon=0表示原始的自然准确性。
图18显示了每个检测头在四个损坏类别(噪声、模糊、天气和数字效果)上的结果。精度值是该特定类别中所有损坏的平均值。严重级别0是网络在原始数据上的性能。所有网络在所有损坏上的性能都下降,并且随着严重级别的增加,下降速度更快。在噪声、模糊和数字效果上,网络的性能下降相对更快,而在天气类别上下降较慢。对于所有损坏类别,FCOS是最鲁棒的,而YOLO是最不鲁棒的。在独立数据测试集(IID)上按精度排序的检测头(图12)在分布外设置(OOD)上仍然成立(Miller et al., 2021)。FCOS在IID测试集上表现最准确,在具有挑战性的OOD设置(即自然损坏数据)上继续保持这一性能。总体而言,基于关键点的检测器相对于其他检测器对自然损坏更具鲁棒性,如图中上部簇所示。
详细分析:
为了提供更详细的分析,我们在图22中展示了每个网络在所有十五种不同损坏上的结果。在每个热图中,我们通过在所有损坏上平均计算平均损坏精度(mCA)。所有检测器在三种噪声(高斯、脉冲和散粒噪声)上显示出相似的性能下降趋势。FCOS和TTFNet在噪声损坏上下降最少,相对于其他检测器更具鲁棒性。在模糊损坏中,散焦和运动模糊的下降更为稳定,而在玻璃模糊上,精度在严重级别3后急剧下降。在缩放模糊上,所有检测器的性能从严重级别1开始急剧下降。所有检测器在不同亮度和雾损坏上比霜和雪更具鲁棒性。在雪条件下,所有检测器的性能最差,趋势相似。在数字效果中,网络在弹性变换和JPEG压缩上比像素化和对比度更具鲁棒性。所有模型在对比度变化上最不鲁棒,YOLO最不鲁棒。每个网络在不同类型损坏上的预测可视化在附录中的图24中展示。
12. 对抗鲁棒性
多项工作显示了深度神经网络对对抗攻击的脆弱性。对抗扰动是人类眼睛无法察觉的噪声,当添加到数据中时,会导致网络做出错误预测。在安全关键型应用中,如自动驾驶,鲁棒性至关重要,以防止网络做出不及时的决策。因此,对抗攻击的鲁棒性是目标检测的关键指标。然而,它在文献中并不突出。在这里,我们评估所有八个检测网络对对抗攻击的鲁棒性。
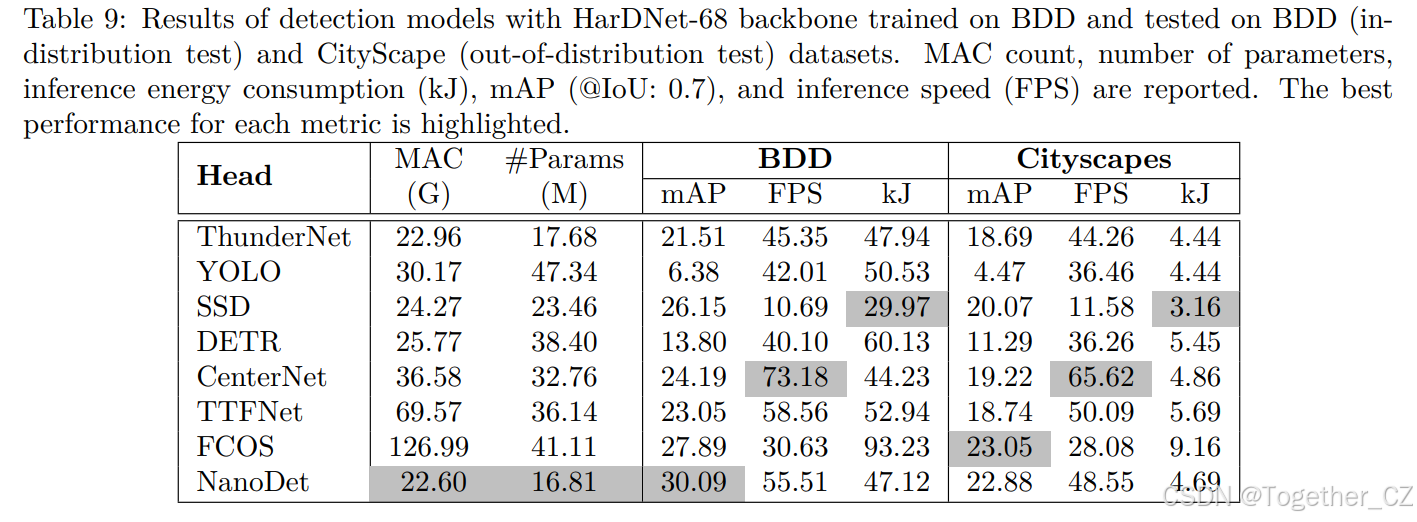
表9:使用HarDNet-68骨干网络在BDD数据集上训练并在BDD(分布内测试)和CityScape(分布外测试)数据集上测试的检测模型的结果。报告了MAC计数、参数数量、推理能耗(kJ)、mAP(@IoU: 0.7)和推理速度(FPS)。每个指标的最佳性能以高亮显示。
我们采用基于梯度的攻击,利用网络的梯度信息生成扰动。投影梯度下降(PGD)(Madry et al., 2017)是一种常见的非目标攻击,最大化训练损失以生成在epsilon边界内的对抗扰动。我们使用分类损失和回归损失作为PGD攻击的目标。我们在不同攻击强度下执行PGD攻击,并报告结果精度。图19显示,随着攻击强度的增加,性能下降。Epsilon=0时的精度是指在原始测试集上的干净精度。CenterNet和DETR表现出一致且更好的鲁棒性,相对于其他检测器。FCOS在自然精度上最高,对非常弱的攻击表现出良好的抵抗力,但对更高扰动的性能急剧下降。TTFNet和ThunderNet是下一个最佳表现者。YOLO、NanoDet和SSD占据了下一个范围。
13. 案例研究:自动驾驶
实时目标检测在自动驾驶(AD)领域至关重要,网络需要学习城市道路和高速公路上存在的各种对象,如行人、车辆和道路标志。大多数检测网络的基准是在VOC和COCO数据集上提供的,这些数据集主要包含家庭对象。这些数据集上的结果不足以评估网络在AD设置中的能力。因此,我们使用BDD数据集(Yu et al., 2018)进行现实世界的AD案例研究,这是该领域最大和最具挑战性的数据集之一。首先,我们展示了所有网络在这个复杂数据集上的性能。然后,我们通过使用在BDD上训练的模型并在不同数据集(即Cityscapes(Cordts et al., 2016))上测试来解决分布外(OOD)泛化问题。最后,我们在嵌入式设备上部署所有在BDD上训练的模型,并报告数字,以展示每个网络的实时应用能力。如第9.5节所示,由于DCN的精度增益不显著,相对于速度下降,我们在本节中统一考虑所有网络,不使用DCN层。
13.1 分布内数据的泛化
在表9中,我们展示了在BDD验证集上获得的结果。与Zhao et al. (2018a)类似,我们在IoU=0.7时计算模型的精度(mAP)。NanoDet表现出最佳精度。FCOS是下一个最准确的,但在速度和能源消耗上表现不佳。CenterNet是最快的,精度略低。SSD消耗的能源最少,YOLO的精度最低。有趣的是,BDD数据集中的对象位置偏差导致生成较少的区域提议,从而使ThunderNet更快。每个检测器在BDD上的定性结果在附录中的图25中展示。
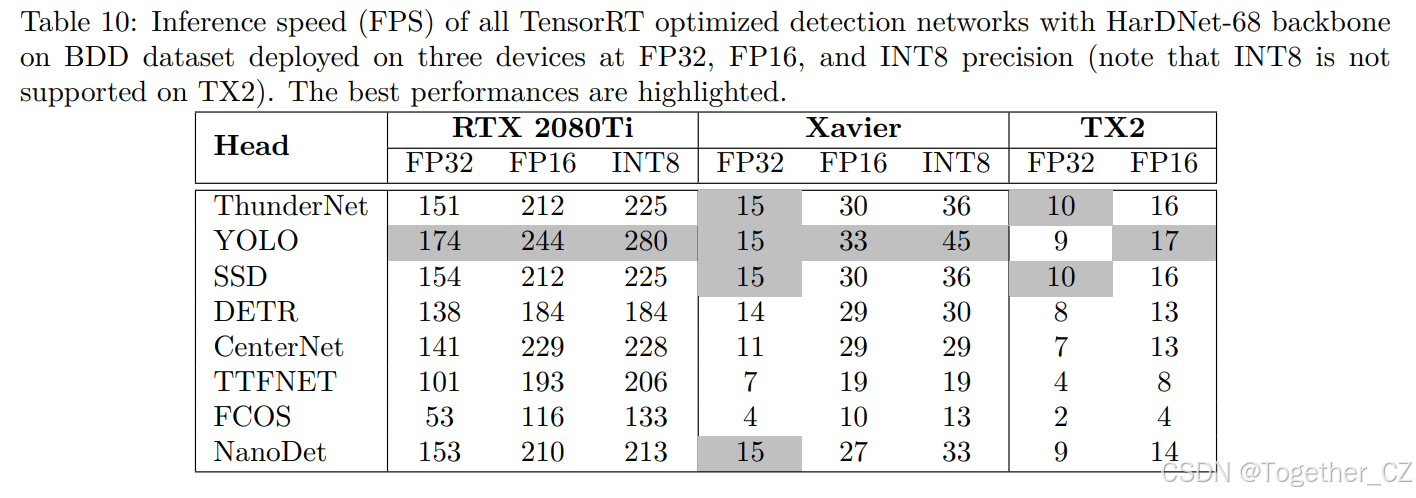
表10:所有使用HarDNet-68骨干网络在BDD数据集上部署在三种设备上并经过TensorRT优化的检测网络的推理速度(FPS),精度分别为FP32、FP16和INT8(注意TX2不支持INT8)。最佳性能以高亮显示。
13.2 分布外数据的泛化
分布外泛化是AD场景中的主要挑战之一。部署在现实世界应用中的网络需要适应未见数据并保持一致的性能。然而,大多数深度学习基准在测试集上显示结果,这些测试集与训练数据具有相同的分布(Geirhos et al., 2020)。因此,为了测试网络对分布偏移的鲁棒性,我们使用在BDD上训练的模型并在Cityscapes数据上测试。我们从Cityscapes的实例分割和标记注释中提取边界框。在表9中,我们观察到FCOS具有最佳精度,NanoDet紧随其后。CenterNet是最快的网络,SSD在两个数据集上都是最节能的。总体而言,基于关键点的检测器是跨具有挑战性的AD数据集泛化的良好候选者。
13.3 嵌入式设备上的性能
AD应用具有电源和资源限制,因为网络部署在车载边缘设备上。实时检测网络在低功耗设备上的性能至关重要。为了部署,我们使用TensorRT库(ten)将网络转换为优化的推理引擎。TensorRT是NVIDIA的并行编程模型,可以优化神经网络以在嵌入式或汽车产品平台上部署。这些引擎然后在三个不同范围的NVIDIA GPU上测试:(1)2080Ti,一个常用的桌面GPU;(2)Jetson-Xavier,一个强大的移动GPU;和(3)Jetson-TX2,一个低功耗移动GPU。
表10显示了所有八个检测器在三种精度模式(FP32、FP16和INT8)下的推理速度。性能趋势可能与之前看到的不同,因为它取决于不同层的优化程度。优化通过融合后续层并使计算并行来实现。基于锚点的检测器ThunderNet、YOLO和SSD具有相对简单的架构,并在优化后实现了最高的速度增益。YOLO由于其最简单的架构,在所有平台上都得到了最多的优化,并且是最快的。然而,所有基于关键点的检测器从优化中获得的速度增益最少。DETR处于中间范围,因为Transformer架构相对较新,不如其他卷积层那样由TensorRT引擎优化。
这个独特的案例研究揭示了在一个设备上看到的性能趋势不一定能转化为其他硬件。这个基准在为实时AD应用选择模型以部署在边缘设备时非常有用。
14. 案例研究:医疗
深度学习的最新进展使AI模型能够协助外科医生和放射科医生诊断和治疗危及生命的疾病。手动检测需要专业知识,耗时,并且可能受到人为错误的影响。AI检测解决方案有助于降低成本和资源,并提供准确的检测工具。
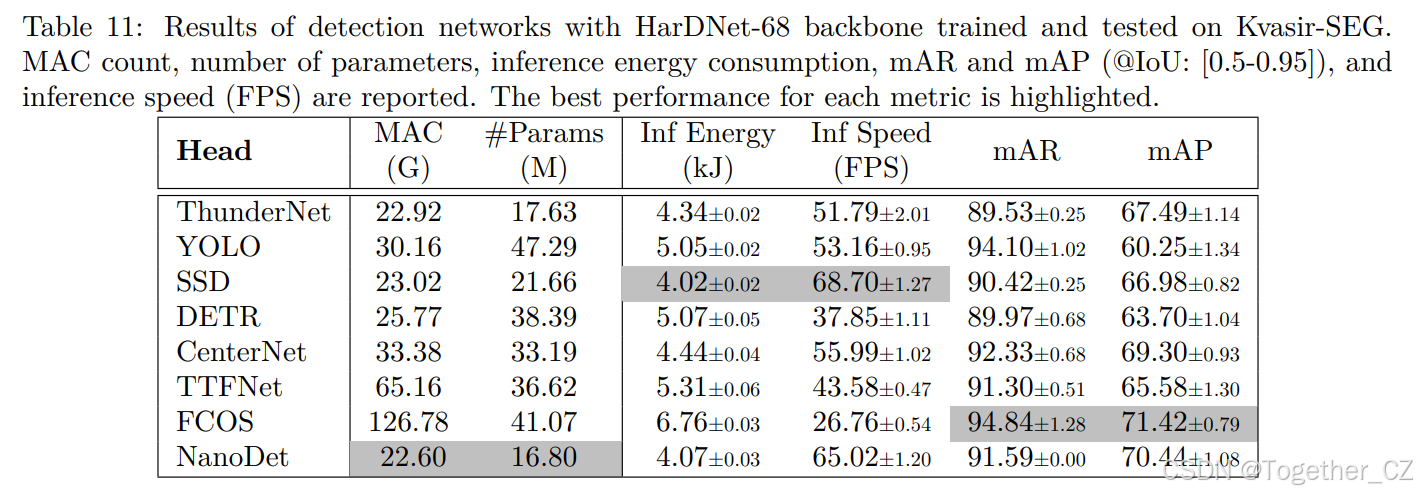
表11:使用HarDNet-68骨干网络在Kvasir-SEG数据集上训练和测试的检测网络的结果。报告了MAC计数、参数数量、推理能耗、mAR和mAP(@IoU: [0.5-0.95])以及推理速度(FPS)。每个指标的最佳性能以高亮显示。
一个应用是使用DNN检测医学图像中的息肉。结肠和直肠(结直肠癌)通常由结肠或直肠内壁上发现的息肉引起。在早期阶段检测这些息肉并进行治疗对于癌症治疗至关重要。医学图像与标准数据集(如COCO和VOC)具有截然不同的分布。因此,标准基准可能无法提供关于选择哪种模型的重要信息。此外,不同的指标根据应用的不同而更具相关性。虽然标准基准关注精度指标,但在医疗行业中,召回率更为重要,因为更多的假阴性比假阳性更有害。
为了解决这种新的数据分布和指标,我们专门针对医学图像进行了一个案例研究,通过在Kvasir-SEG数据集上评估检测器。表11展示了在Kvasir-SEG测试集上获得的结果。召回率对于此应用更为重要,因此我们报告了平均召回率(mAR)以及mAP。某些网络如YOLO可能没有最高的精度,但在召回率方面表现良好。FCOS具有最高的召回率和精度,使其成为此类测试用例的理想候选者。在速度方面,SSD是最快的,而NanoDet紧随其后。每个检测器的定性结果在附录中的图26中展示。
15. 讨论
我们提供了一个全面的实时目标检测网络研究,涵盖了特征提取器和检测器的组合(从两阶段、单阶段、基于锚点、基于关键点和基于Transformer的架构),在不同数据集和领域中使用标准化的实验设置。我们报告了广泛的指标结果,包括精度、速度、资源和能源消耗,以及鲁棒性和校准分析。我们评估了检测器对自然和对抗损坏的鲁棒性。此外,我们提供了详细的见解,以获得对不同变量对最终结果影响的完整理解。我们研究了骨干架构、图像大小、对象大小、置信度阈值和特定架构层等变量的影响。我们还为自动驾驶和医疗应用贡献了两个独特的案例研究。我们进一步优化并在嵌入式硬件上基准测试网络,以检查网络在边缘设备上部署的可行性。
第8节中的组合结果表明,基于关键点的检测器往往在多个数据集上泛化良好,因为不再需要优化基于对象大小的锚点大小。NanoDet在精度和速度方面表现良好,同时计算效率高。CenterNet是第二快的,并且在所有其他指标上也表现良好,TTFNet处于中间范围。FCOS具有最高的精度,但在其他指标上表现不佳,而基于Transformer的检测器DETR处于中间范围。在骨干中,现代网络设计用于低内存流量,如HarDNet,在精度和推理速度以及能源消耗方面提供了最佳平衡。所有检测器在检测小型对象时表现不佳,FCOS在配对较重的骨干网络(如HarDNet-68或VoVNet-39)时相对在检测小型对象方面表现更好。锚点大小的变化以非确定性的方式影响性能,使得它们难以泛化。我们报告了切换到更高图像大小或使用DCN层时的精度-速度-资源需求权衡。在自然损坏的鲁棒性方面,所有网络在所有十五种损坏上的性能下降,并且随着严重程度的增加,下降速度更快。总体而言,基于关键点的检测器相对于其他检测器对自然损坏更具鲁棒性。FCOS是最鲁棒的,而YOLO是最不鲁棒的。FCOS和TTFNet对噪声和模糊损坏相对更具鲁棒性,但所有检测器在雪天条件下失败。CenterNet对对抗扰动表现出最高的鲁棒性,而FCOS和DETR对这些攻击也相当抵抗。在可靠性分析中,SSD相对校准良好,而基于关键点的检测器在预测中更为谨慎,因此在安全关键型应用中证明有用。ThunderNet和DETR非常过度自信。因此,对基于Transformer的检测器在这些各种设置中的分析将提供更多关于这种新架构范式的能力和陷阱的见解。AD案例研究报告了在更相关的BDD数据集上的性能,并报告了在分布外数据上的泛化性能。在三个不同GPU(桌面和嵌入式)上的部署显示,嵌入式硬件上的性能趋势与桌面GPU不同。基于锚点的检测器,如SSD和YOLO,由于其简单架构,得到了更好的优化,并在边缘设备上运行得更快。这个研究有助于根据应用的硬件能力比较和选择网络。医疗案例研究强调了召回率指标(相对于仅精度结果)的重要性,我们观察到最准确的网络不一定在召回率指标上表现最好。这些案例研究涵盖了两个不同的领域,具有不同的需求,提供了一个独特的视角,超越了标准基准,评估了检测器在更多相关和适用于实时应用的多样化数据集上的能力。
更广泛的影响声明
我们提供了一个全面和综合的分析,涵盖了跨多个数据集和领域的基于深度学习的实时目标检测网络,在一个标准管道中。我们展示了所有高层次的通用结果,同时也深入到封装的详细直觉。我们的广泛分析还提供了关于新架构范式(Transformer vs CNNs)的能力和陷阱的见解。不同的应用有不同的标准,我们的研究可以作为工业界根据各自应用需求评估不同权衡的指南。由于新的检测网络频繁引入,我们还希望激励研究界使用本研究作为新设计的先例。本研究强调了标准化、透明和公平管道的重要性,并强调了从名义改进转向更广泛视角的必要性。我们希望这将为未来的研究铺平新的道路。
附录 A 附录
整体性能图
图1显示了所有检测器在不同指标上的整体性能。结果来自使用图像分辨率512和HarDNet-68骨干在COCO数据集上训练的检测器。每个顶点对应一个指标,八种不同的颜色代表不同的检测头。我们报告了八个指标:精度(mAP)、自然鲁棒性(mAP)、速度(FPS)、参数数量、MAC计数、能源消耗(kJ)、校准误差(衡量可靠性)和对抗鲁棒性(mAP)。为了获得每个检测器的自然鲁棒性值,我们平均了所有十五种损坏在所有五个严重级别上的精度(图22)。对于对抗鲁棒性,我们平均了所有四个攻击强度(Epsilon: [0.25, 0.5, 1, 2])的鲁棒性精度(图19)。校准误差是表8中的D-ECE分数。其余指标值来自表4。
考虑到理想应用,一个表现良好的检测器应具有最高的精度、最高的(自然/对抗)鲁棒性、最高的速度、最少的参数数量、最少的MAC计数、最低的能源和低校准误差。因此,对于精度、鲁棒性和速度指标,自然更高的值更好。但对于其他指标,更低的值更好。所以,我们使用这些指标的逆值:参数数量、MAC计数、能源消耗和校准误差(因此在图中带有上标“-1”)。然后我们将每个指标归一化到0和1之间:
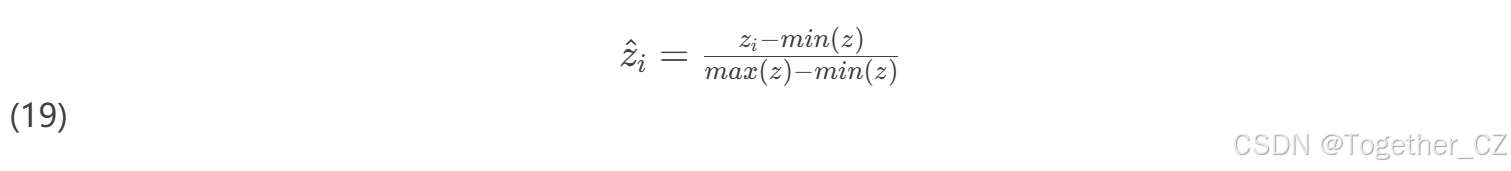
因此,理想网络应占据整个八边形,即所有指标的值为1。
实现细节
在这里,我们简要讨论实现挑战和细节。
ThunderNet的官方代码未发布。ShuffleNet-v2在论文中介绍,但ImageNet预训练权重不可用,必须训练,以重现结果,而且,并非所有超参数都在论文中包含,这使得实现非常困难和具有挑战性。最近,一些非官方存储库共享了ThunderNet的TensorFlow和Pytorch实现。
YOLOv2使用DarkNet实现,这是一个用C和CUDA实现的开放源代码框架。但是,这与其他存储库的结构不同,因此很难使用。有许多非官方的PyTorch存储库,但没有完全重现结果,并且有许多未解决的问题。
表12:每个网络实验的详细设置。初始学习率(LR)按0.1的因子衰减,我们为所有实验使用相同的批量大小(batch_size)32和置信度阈值(confidence_threshold)0.01。BG代表背景类别,Opt代表优化器。
SSD有多个良好的存储库,超参数也很好地表格化,以重现结果。
CenterNet和TTFNet使用DCN层,原始存储库为旧版本的Pytorch构建了这些层。这些需要为新升级的版本重新构建,并且不容易获得。TTFNet设计为在较少的epoch内训练,需要一些调整以找到特定数据集的最佳epoch。TTFNet的训练时间更快,但找到收敛参数有点挑战。
NanoDet尽管有一个良好的存储库,但没有出版物。使用存储库很容易重现结果,但一些概念和损失函数来自多个不同的工作,出版物将增强学习体验。
FCOS和DETR都有良好的存储库,很容易重现。
另一方面,对于TensorRT转换,我们需要遵循两个步骤:(i)将模型导出为ONNX格式,和(ii)将模型从ONNX转换为TensorRT引擎。这两个步骤的复杂性取决于模型中存在的自定义层的数量及其在TensorRT开源软件(OSS)中的支持可用性。SSD、YOLO、FCOS和NanoDet在最后只有一个自定义层,即NMS层,在TRT-OSS中有支持。因此,通过一些额外的工作,这些模型可以转换为TensorRT推理引擎。CenterNet、TTFNet和DETR没有任何自定义层,这使得它们更容易转换,无需任何额外的工作。ThunderNet包含额外的自定义层,如ROI提议和ROI对齐。由于这些层在TRT-OSS中不完全支持,在导出为ONNX时必须选择等效层,这使得转换非常困难和具有挑战性。请注意,除了自定义层外,函数如“上采样”和“收集”在ONNX和TensorRT中是版本敏感的。
资源分析
MAC计数是神经网络中乘积累加操作的度量。然而,我们注意到,在线可用的标准浮点运算计数库可能无法准确计算使用多头注意力模块的基于Transformer架构的MAC。这些库通常设计用于使用卷积神经网络,并不考虑基于Transformer的架构。
为了解决这个问题,我们评估了各种浮点运算计数库,并最终选择使用fvcore(v0.1.5)库来计算我们的基于Transformer骨干(DEIT-T)和检测器(DETR)的浮点运算。我们选择这个库是因为它能够准确计算基于Transformer架构的MAC,以及神经网络中使用的常见层。我们还发现,使用fvcore库计算的CNN架构的MAC计数与我们之前使用的库相同。
分布外数据的可靠性分析
第10节中提供了分布内COCO数据集的校准结果。在这里,我们报告分布外版本的校准结果,通过在第7.1节中创建的Corrupted COCO数据集上测试网络。COCO验证集包含5000张图像,我们为每张样本应用随机损坏,并评估此集合上的校准。可靠性图在图21中提供,其中对角线表示完美校准,绿色阴影表示校准差距。
实验设置细节
表12提供了每个网络的实验设置的详细信息。初始学习率(LR)按0.1的因子衰减,我们为所有实验使用32的批量大小和0.01的置信度阈值。BG表示背景类,Opt表示优化器。
可靠性分析
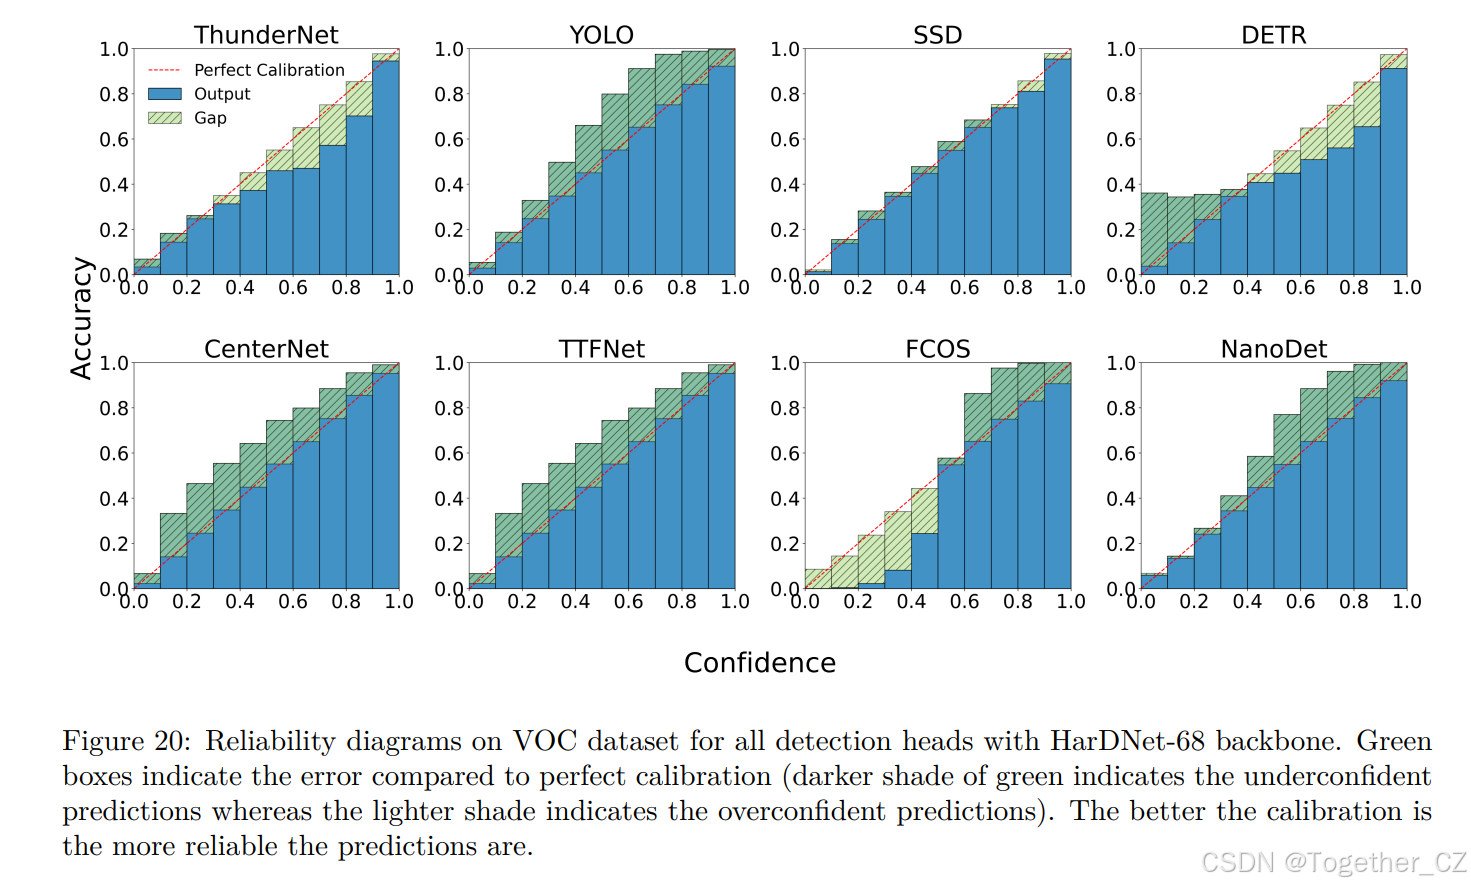
图20显示了使用HarDNet-68骨干在VOC数据集上的所有检测头的可靠性图。绿色框表示与完美校准的误差(较暗的绿色阴影表示不够自信的预测,而较浅的阴影表示过度自信的预测)。校准越好,预测越可靠。
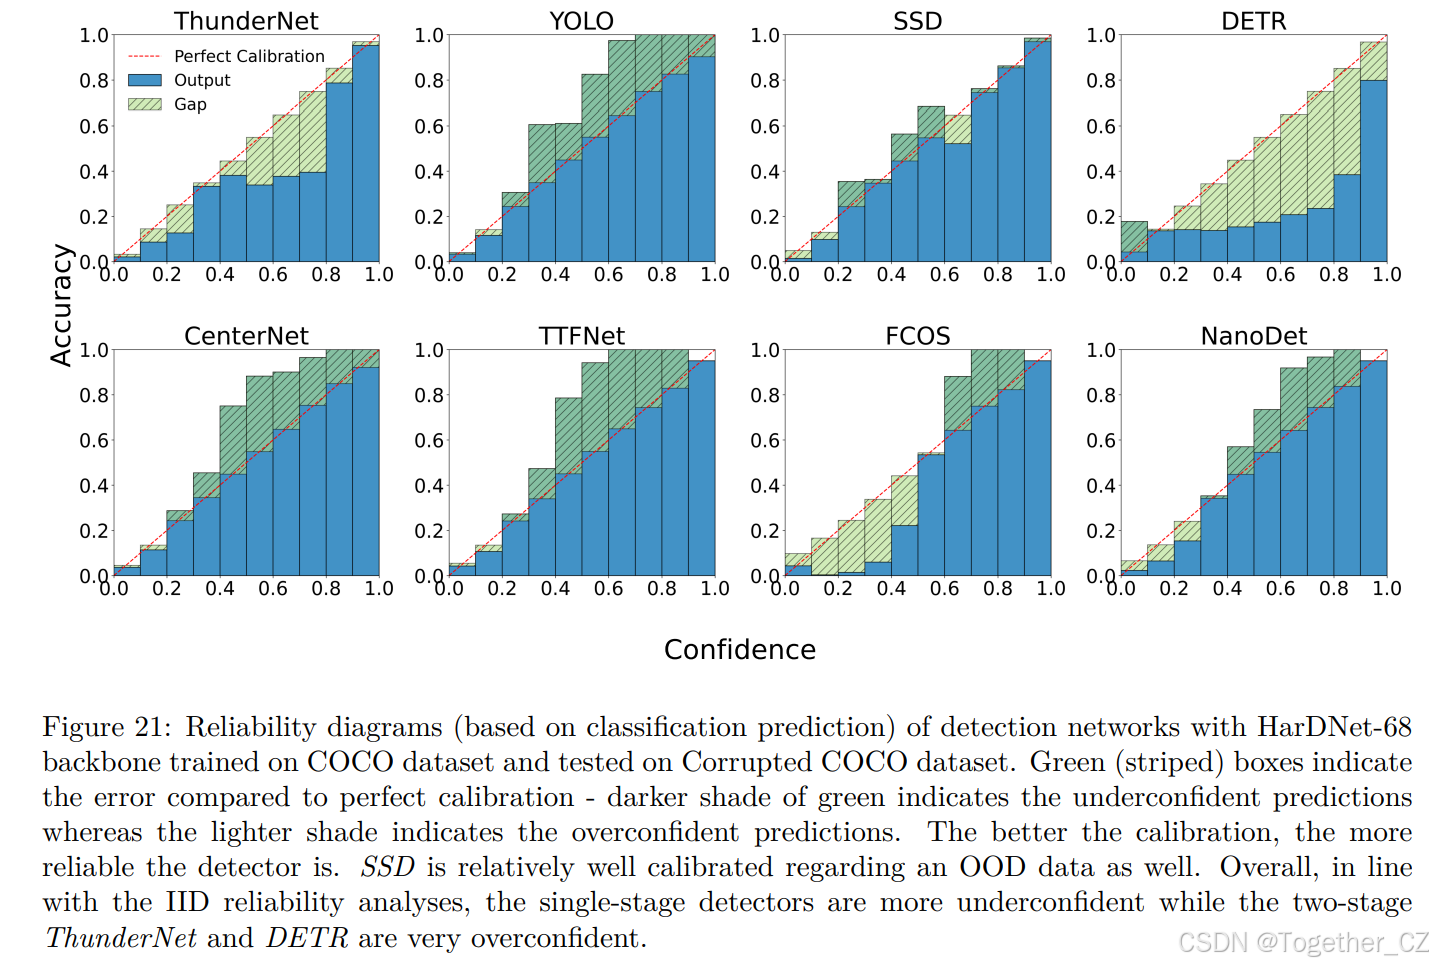
图21显示了使用HarDNet-68骨干在COCO数据集上训练并在Corrupted COCO数据集上测试的所有检测头的可靠性图。对角线表示完美校准,绿色(条纹)框表示与完美校准的误差(较暗的绿色阴影表示不够自信的预测,而较浅的阴影表示过度自信的预测)。校准越好,检测器越可靠。SSD在分布外数据上也相对校准良好。总体而言,与分布内可靠性分析一致,单阶段检测器更为不够自信,而两阶段ThunderNet和DETR非常过度自信。
定性结果
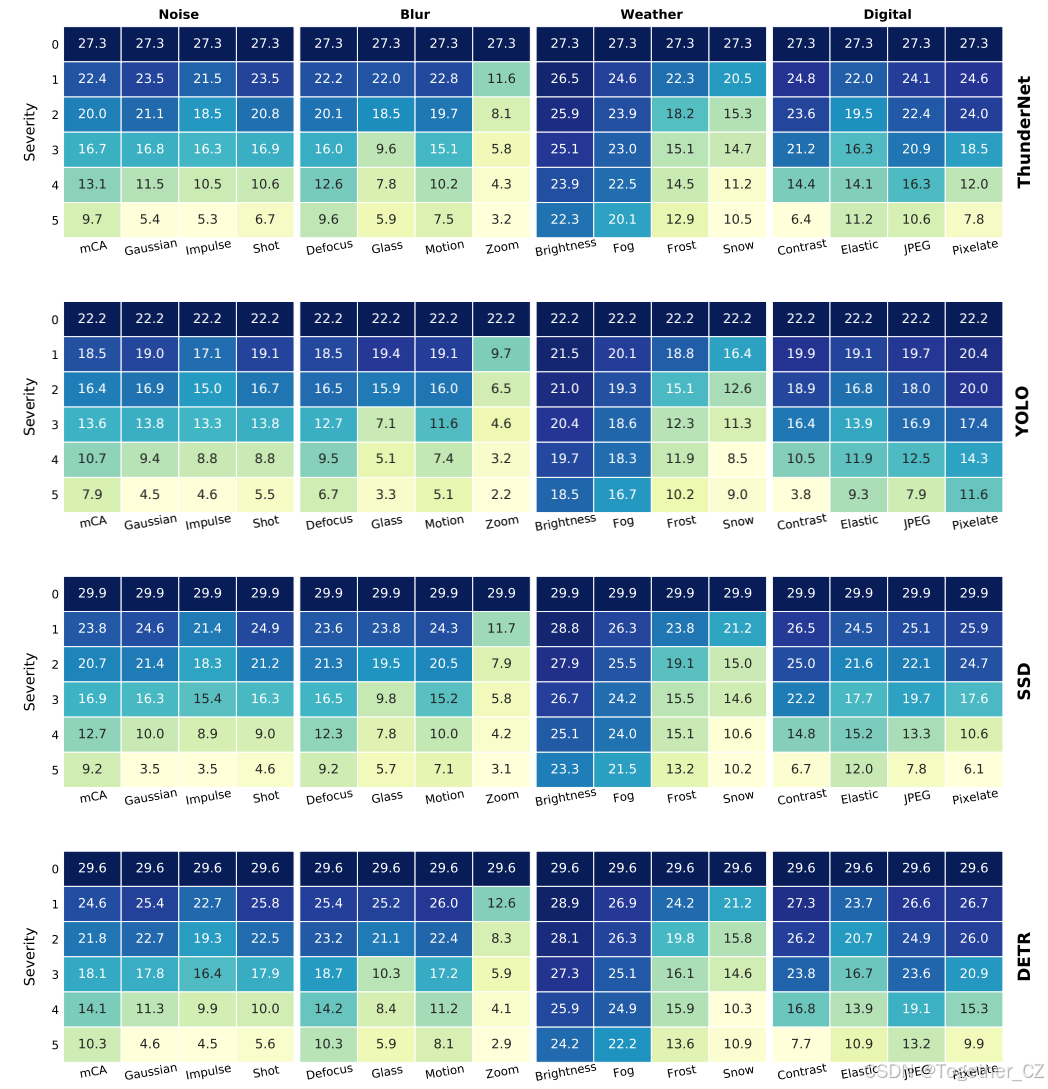
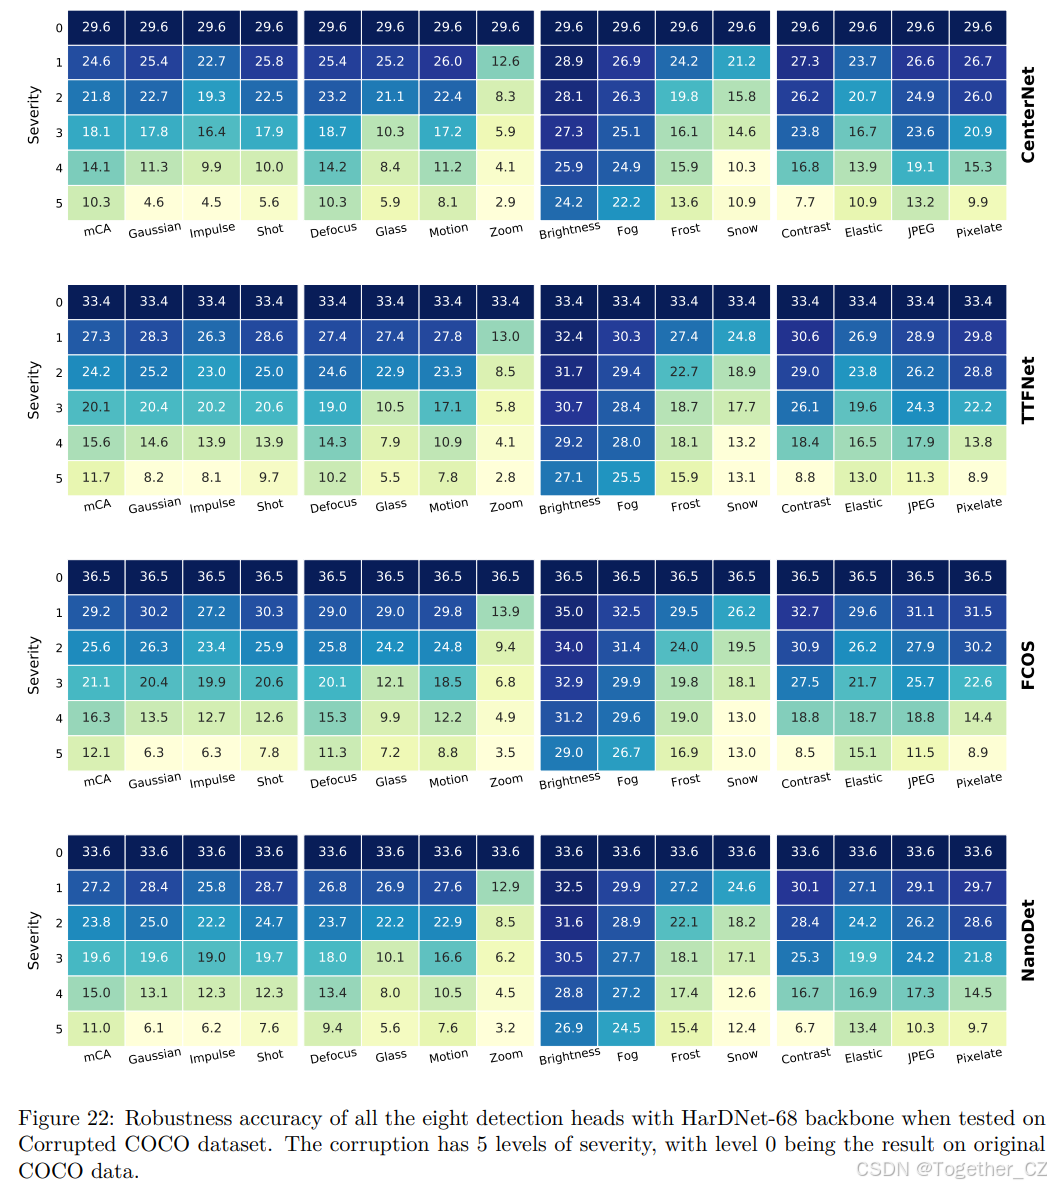
图22显示了所有八个检测头在HarDNet-68骨干上测试Corrupted COCO数据集时的鲁棒性精度。损坏有5个严重级别,级别0是原始COCO数据的结果。
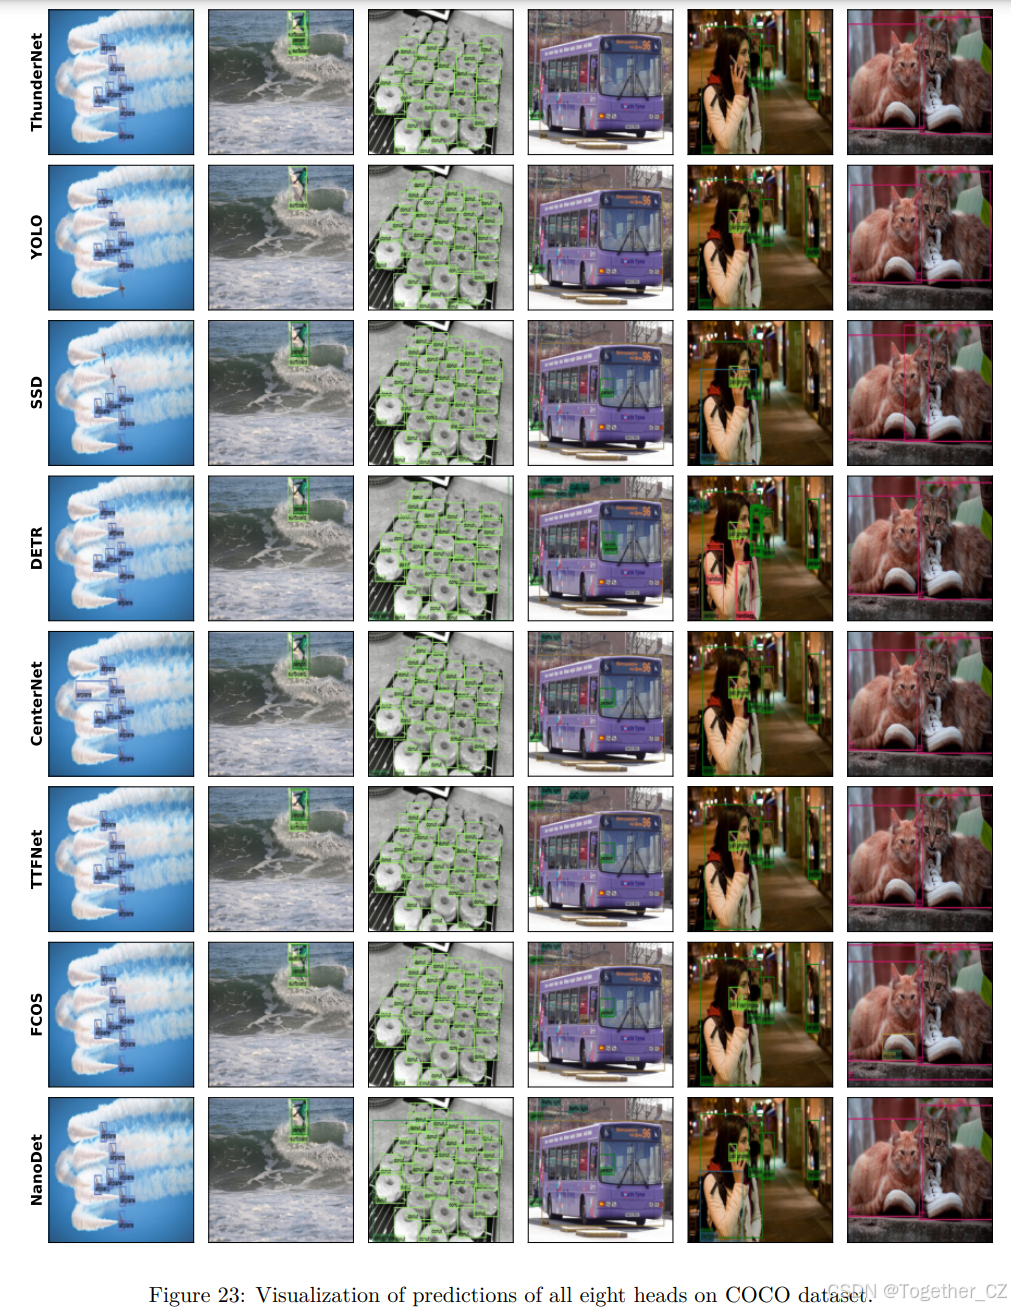
图23显示了所有八个检测头在COCO数据集上的预测可视化。
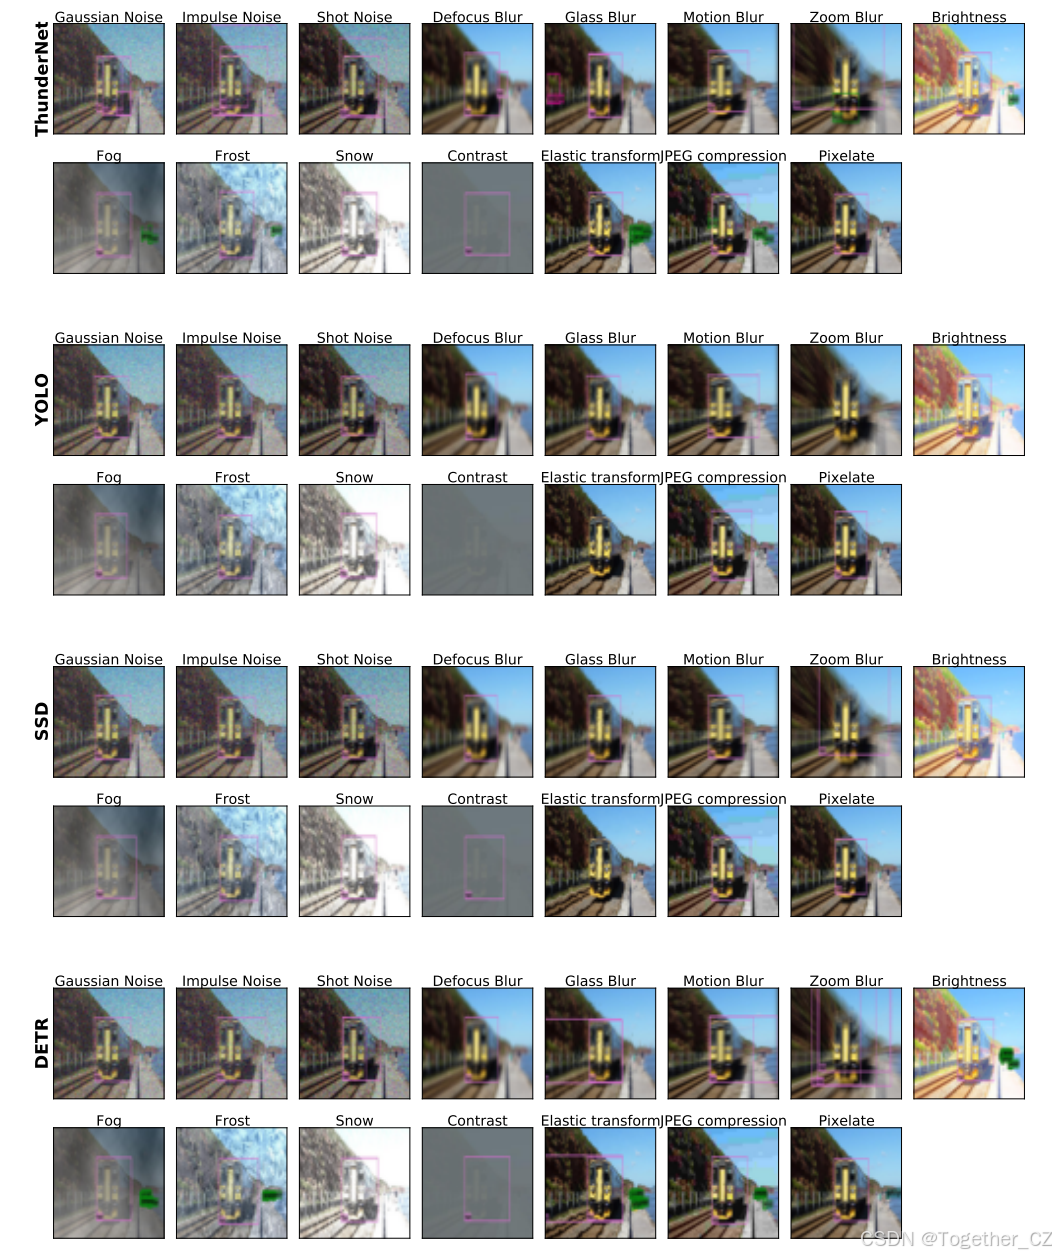
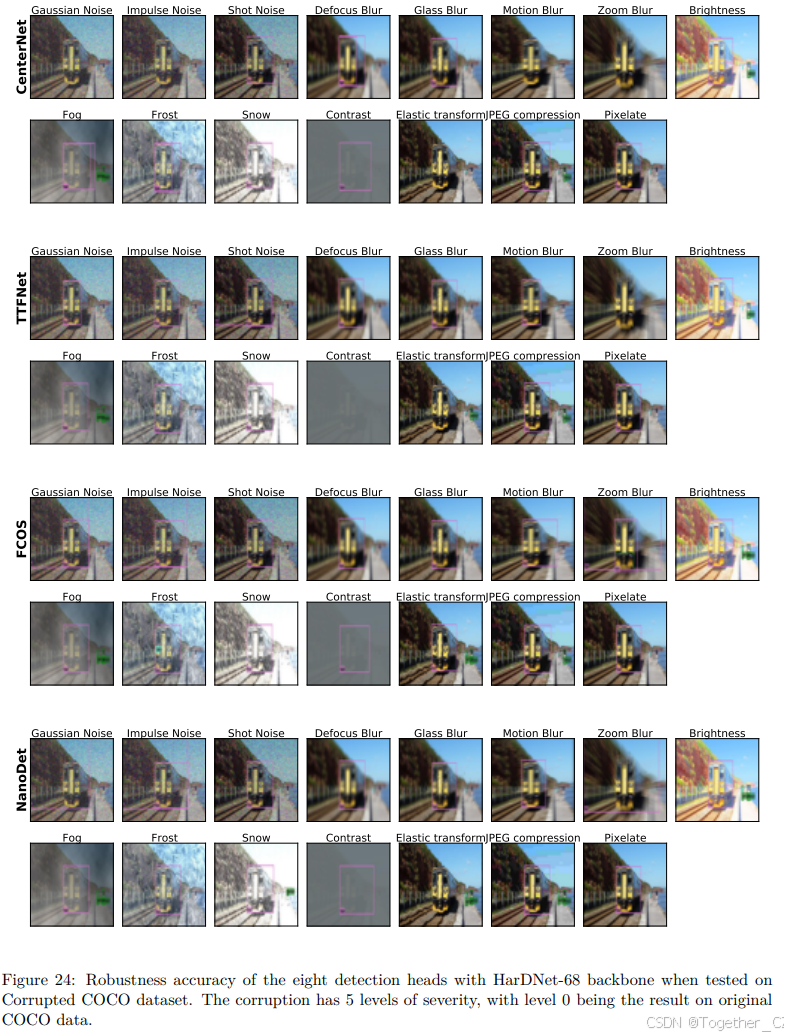
图24显示了所有八个检测头在HarDNet-68骨干上测试Corrupted COCO数据集时的鲁棒性精度。损坏有5个严重级别,级别0是原始COCO数据的结果。
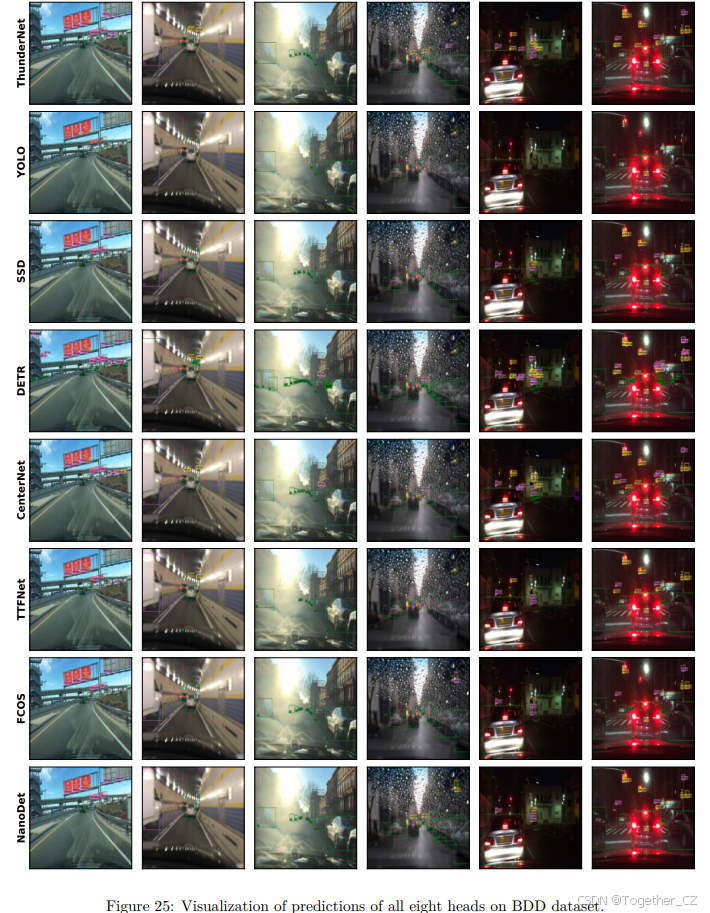
图25显示了所有八个检测头在BDD数据集上的预测可视化。
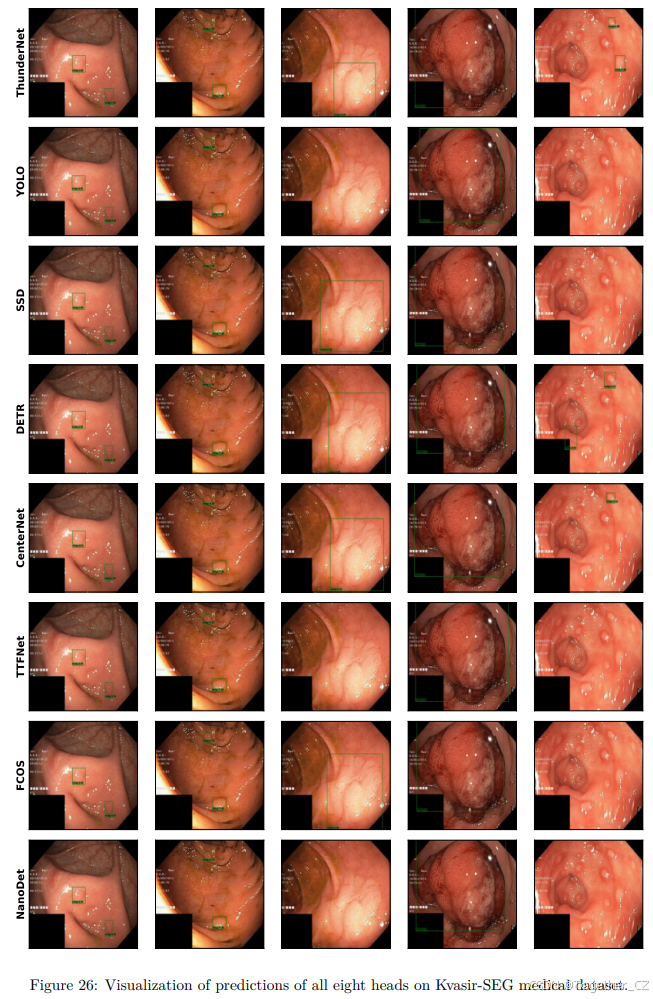
图26显示了所有八个检测头在Kvasir-SEG医学数据集上的预测可视化。
更多推荐
 25
 0
- 0


 已为社区贡献5条内容

所有评论(0)