
YoLov1目标检测——知识点笔记
一、了解图像分类、目标检测、语义分割及实例分割的区别:
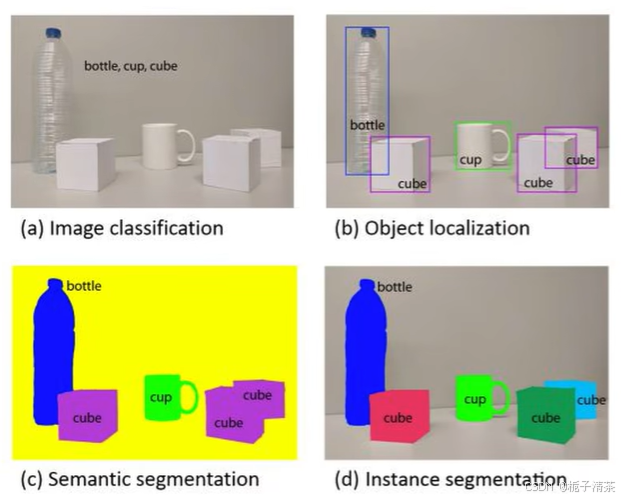
图像分类:输入图像输出类别。如上图(a)所示。
目标检测:输入图像输出图像中每一个物体的类别。能把每个物体的矩形框画出来,并对每个物体做分类。如上图(b)所示。
语义分割:对每一个像素分类,不管这几个像素是属于哪几个物体,只在意它属于什么类别。能把每个像素类别输出来,不区分不同物体的像素。例如,上图(c)中同类别的物体像素相同,所有cube都归为一个类别。
实例分割:要把同一个类别的不同实力给它区分出来。把同一类别不同物体的像素也区分出来了。例如,上图(d)中每一个cube都被区分出来了。
二、YoLov1的提出背景及原因(用来做什么的)?
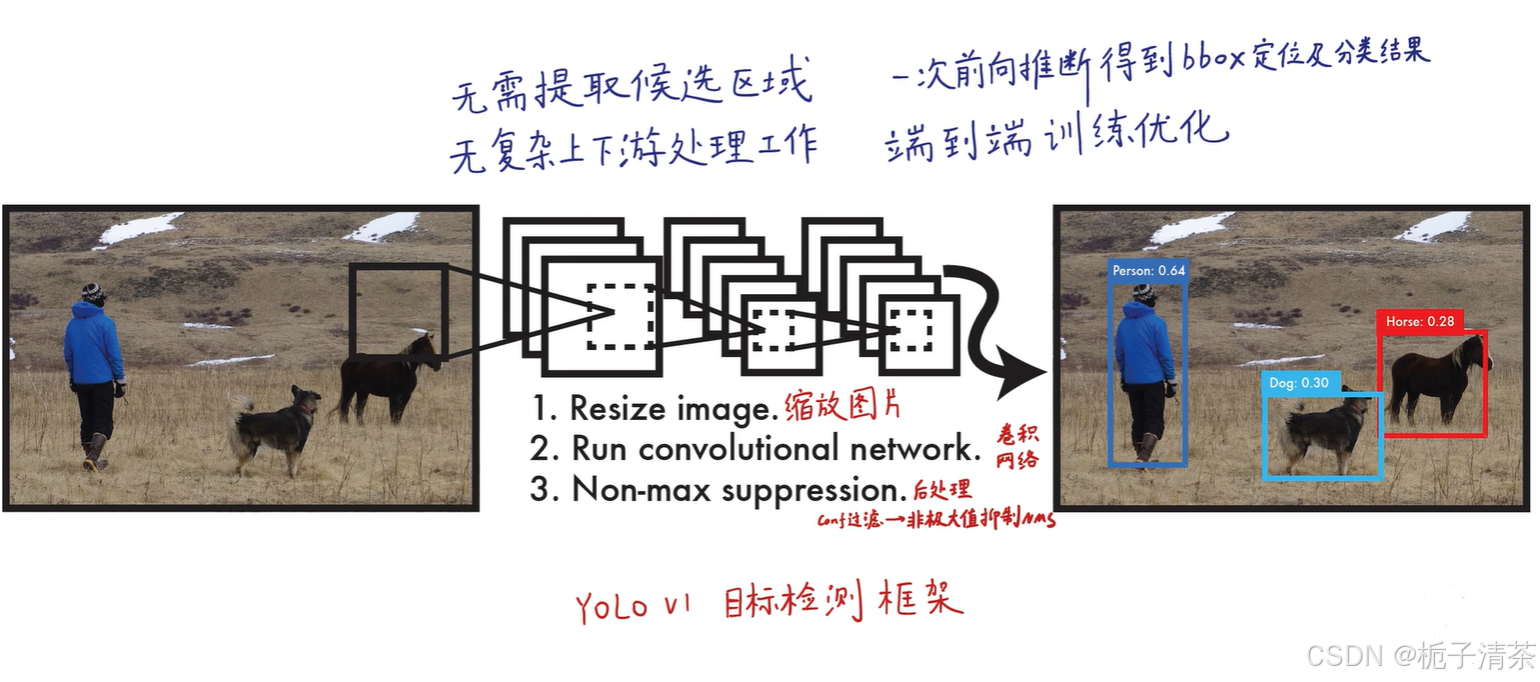
YOLOv1的提出背景是为了解决传统目标检测算法计算时间长、无法实现实时处理的问题。 在YoLov1提出之前,目标检测方法主要采用基于RCNN、Fast R-CNN等深度学习算法,这些方法虽然精度较高,但需要耗费很长时间进行计算,因此无法实现实时处理。在之前 two-stage 方法中,例如 R-CNN 把检测问题分成两部分,先生成候选区域(region proposal),再用分类器对区域分类,多阶段训练导致不易优化。而YoLov1无需提取候选区域,也无复杂的上下游处理工作,一次向前推得到bounding box定位及分类结果,实现端到端的训练优化。
三、YoLov1的工作原理(流程):
1、预测阶段(向前推断):
(深度卷积神经网络)
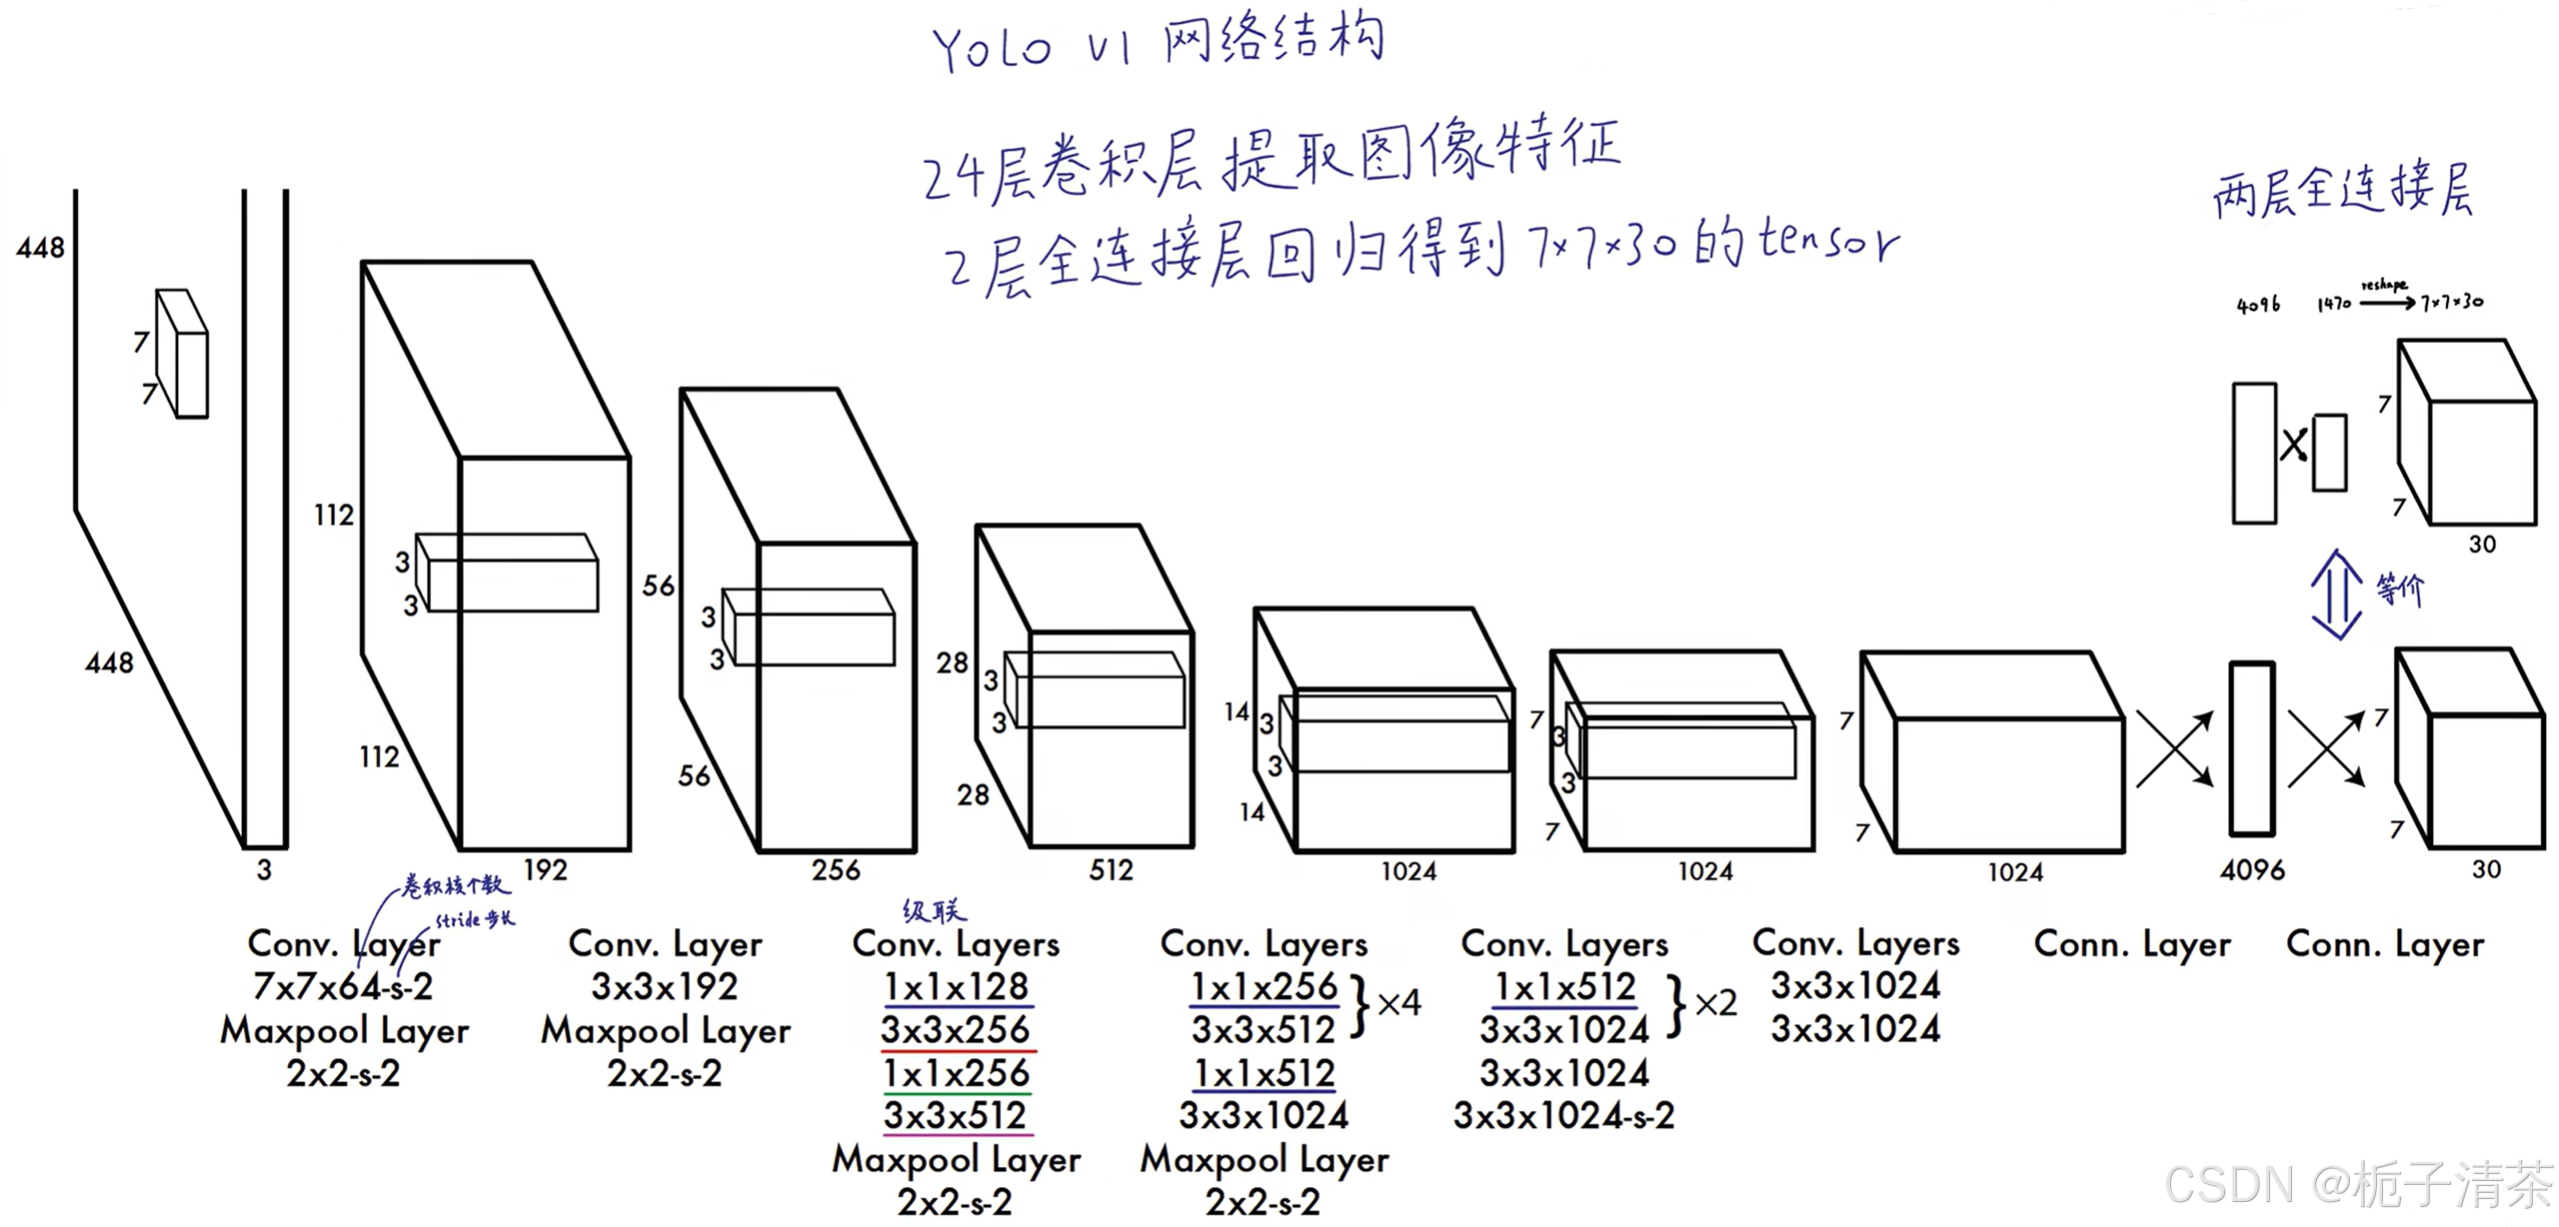
输入448×448的rgb图片,先经过24层卷积层提取图像特征,再经过2层全连接层回归得到7×7×30的tensor,相当于30个通道的7×7的特征图。

每个grid cell包含两个bounding box和20个类别概率,每个bounding box又包含了中心点坐标(x,y)宽度和高度(w,h)以及对应的置信度。
置信度的计算:根据原论文可以理解为预测目标和真实目标之间的交并比。


2、预测阶段(后处理):

以一个grid cell 为例,每个grid cell 包含了2组{x,y,w,h,c}和20个分类概率。
 每个grid cell 对应两个框框。

将每个bounding box的置信度与后面的20个分类概率相乘得到一列20×1的第一个bounding box对应的完整类别概率。

第二个bounding box也做同样操作,由此可知一个grid cell可以得到两列完整类别概率。

由上述知,论文中用的是7×7的网格,有49个grid cell,故得到下图49×2=98个完整的分类概率列。每一行对应一个物种类别,如图,第一行对应的是狗的类别概率。

以狗的类别概率为例,IoU设置为0.5,两两依次进行交并比,若小于0.5则概率改为0,否则不变。


最终会得到一系列的数字,以最大值为准,选出对应类别。

3、训练阶段(反向传播)
训练阶段,Ground Truth的中心点落在哪个grid cell里,那个grid cell就应该负责检测这个物体,检测这个物体的bounding box就应该由这个grid cell生成。
一个grid cell 中有两个bounding box且两个bounding box的中心点都在grid cell中的话,就选择IoU交并比大的来拟合该物体。


四、YoLov1的核心技术以及分别解决了什么问题?
1、单次回归模型:将目标检测简化为单一的回归问题,直接从图像预测目标类别和位置,解决了传统检测器中多阶段处理的复杂性,提升了检测速度。
2、全图像预测:YoLov1在整个图像上进行预测,捕捉全局上下文信息,减少了背景误检问题,并提升了模型的泛化能力。
3、固定网格划分:将图像划分为 7×7 的固定网格,每个网格负责预测目标,简化了区域提议过程,但也带来了小物体检测和边界框精度较低的问题。
4、非极大值抑制(NMS):用于去除重复预测框,保留置信度最高的框,解决了多重检测问题。
五、YoLo V1有什么优点?
1、快:可以实现实时的目标检测。
YoLov1之所以快,是因为它将目标检测简化为一个单一的回归问题,直接通过整个图像进行端到端的预测,从而大幅减少了计算量并实现了实时检测。
2、一次读取整张图片,能够捕获全图上下文信息。
3、迁移泛化能力好。
因为它在整个图像上进行全局预测,使模型能够捕捉更广泛的上下文信息,从而提升在不同数据集和场景中的泛化性能。
六、YoLov1有什么不足?
1、准确率较低。YoLov1 准确率较低的主要原因在于其固定网格划分、小物体检测不准、缺乏多尺度处理以及定位和分类的损失权衡不佳。
2、定位能力和小目标的识别性能上较差。每个grid cell只能预测出一个类别,模型空间限制了能预测的物体个数,对小的密集物体不友好。
3、分类正确但定位误差大。损失函数对大小框是同等对待的,对大框来说较小的误差还好,对小框来说就会显得误差比较大,即会导致小框一小点误差就对IoU有很大的影响。
七、与其他检测系统的比较:
1、Deformable parts models(DPM):
DPM 采用多阶段处理(特征提取、分类、边界框回归等),导致整体检测流程复杂且速度较慢,无法实现实时检测。
YoLov1通过单一的卷积神经网络同时进行特征提取、边界框预测和非极大值抑制,整体模型更快且更准确
2、R-CNN:
R-CNN 的处理速度非常慢,因为它首先生成区域提议(候选区域),然后对每个提议进行卷积特征提取和分类,整个流程冗长且计算量大,不适合实时应用。
YoLov1将这些独立的步骤整合为一个单一的神经网络,优化了速度,但牺牲了部分精度,尤其在定位小目标时表现较差。
YoLo 和 R-CNN的相似性:
YoLov1的每个网格单元也提出潜在的边界框,并基于卷积特征进行评分,但其网格设计施加了空间约束,从而减少了对同一目标的多重检测
3、Fast Detectors Fast and Faster R-CNN:
Fast R-CNN 和 Faster R-CNN 通过共享卷积计算和使用神经网络进行区域提议提高了速度,但依然未能达到实时性能。相比之下,YoLov1通过简化检测管道,实现了更高的实时性。
4、Deep MultiBox:
MultiBox 的检测方式仍依赖于后续的分类步骤,这增加了系统的复杂性,并且由于缺乏全局信息,难以精确检测复杂背景下的目标。
YoLov1则是一体化的检测系统,独立完成整个检测任务。
5、OverFeat:
OverFeat 采用滑动窗口的方式进行目标检测,这种方法虽然提升了定位精度,但计算开销大,并且由于窗口机制无法利用全局上下文信息,容易受到背景干扰。
YoLov1则在预测过程中考虑了整个图像的全局信息,减少了背景误检。
6、MultiGrasp:
MultiGrasp 主要专注于单一目标(可抓取区域)的检测,对于多类别、多目标场景难以适应,且系统的泛化能力较弱。
YoLov1的网格框架设计借鉴了 MultiGrasp 系统,但相比于仅需要预测单个可抓取区域的 MultiGrasp,YoLov1 需要同时预测多个类别和物体的边界框和类别。
八、与其他实时系统的比较:

1、速度:YoLov1由于将目标检测简化为单个神经网络回归问题,能够在全图像上一次性完成所有目标的预测,因此比使用滑动窗口或区域提议方法的检测系统(如DPM和R-CNN)快得多。YoLo v1的基本模型可以达到45 FPS,而Fast YOLO甚至可以达到155 FPS,显著超越了其他实时检测系统。
2、准确率:尽管YoLov1在速度上占据优势,但其定位精度低于R-CNN等模型,尤其是在处理小物体时表现不佳。不过,YoLov1在背景误检率(false positives)上表现更好,特别是在检测复杂背景的图像时。
3、结构简化:与R-CNN复杂的多步骤处理(区域提议、特征提取、分类、后处理等)相比,YoLo v1采用了单一的卷积神经网络架构,不需要单独训练不同的模块,这使得YoLov1更容易优化,并实现了端到端的检测系统。
模型集成:

九、知识补充:

目标检测的发展:

参考视频:YOLOV1论文精读:You only look once: Unified, real-time object detection_哔哩哔哩_bilibili
更多推荐

 25
 0
- 0


 已为社区贡献2条内容

所有评论(0)