
彩色星球图片生成5:先验条件约束与LapGAN(pytorch版)
彩色星球图片生成5:先验条件约束与LapGAN(pytorch版)
上一集:彩色星球图片生成4:转置卷积+插值缩放+卷积收缩(pytorch版)
在上一集代码的基础上,重构了代码结构,从而实验了更加多样化的生成。
与此同时,增加了更多训练集图片,也为训练集添加了一些不同的种类,比如恒星、黑洞与类星体,为每一张图片都进行了类别的人工标注。
本章大量内容为无指导情况下的个人理解,如有错误,欢迎大佬指出帮助纠正。
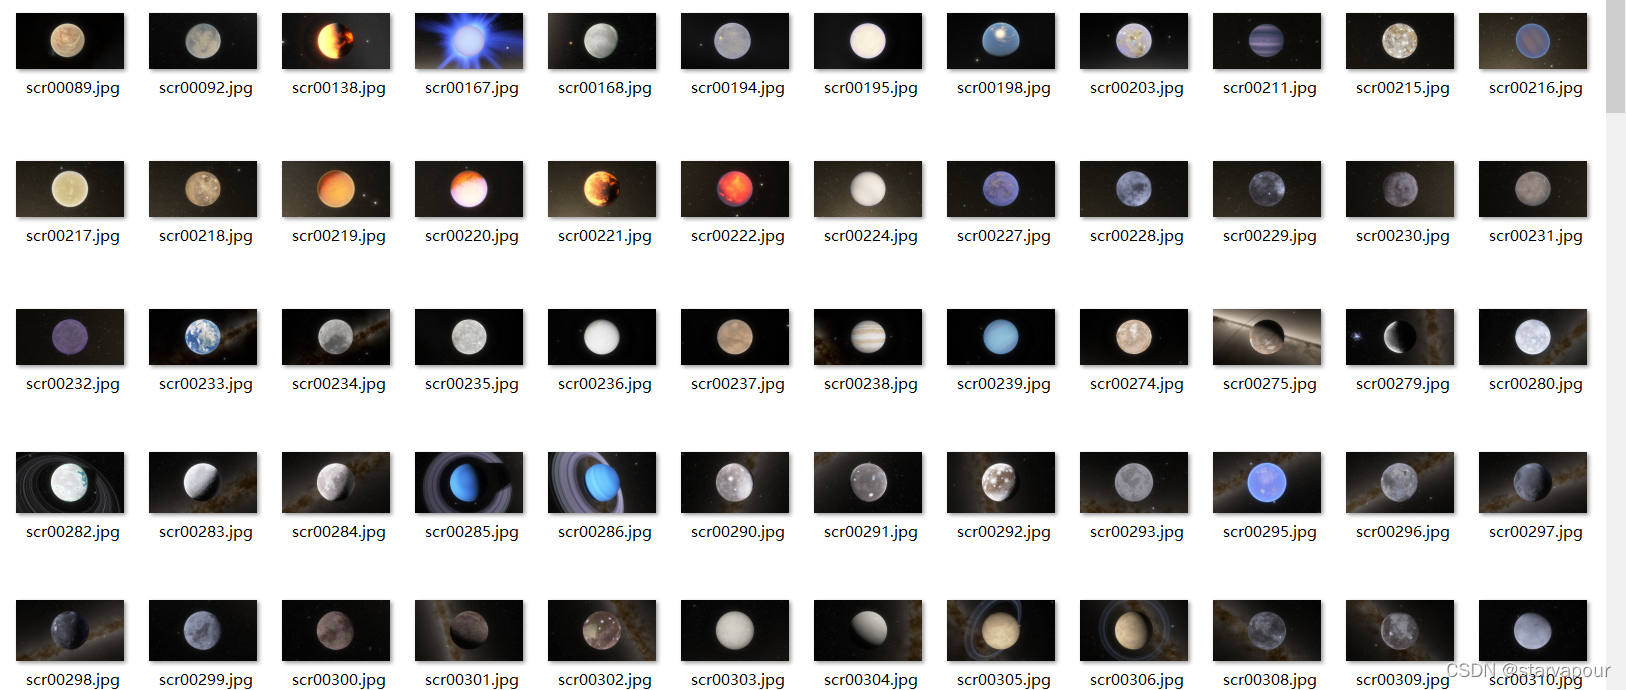
训练集图片(共328张,来自于Space Engine):
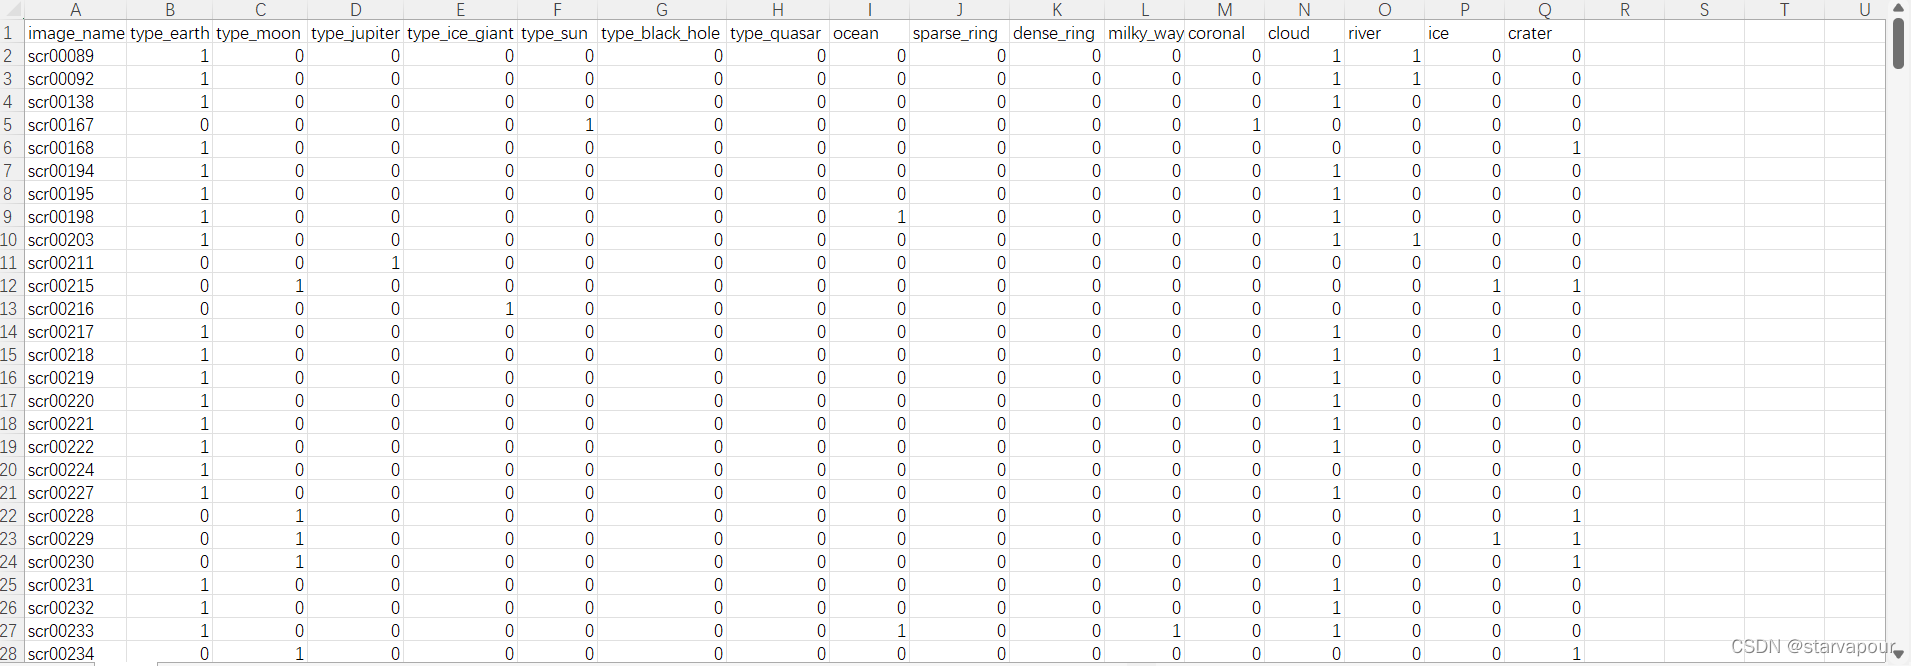
train.csv文件,人工标注的训练集图片信息:
1. 改进方面
1.1 训练集信息的人工标注
设定了一些相关的图片信息,为了便于标注,开发了一个可视化图形界面用于标注图片信息,然后自动写入CSV文件。
标注可视化工具界面如下:
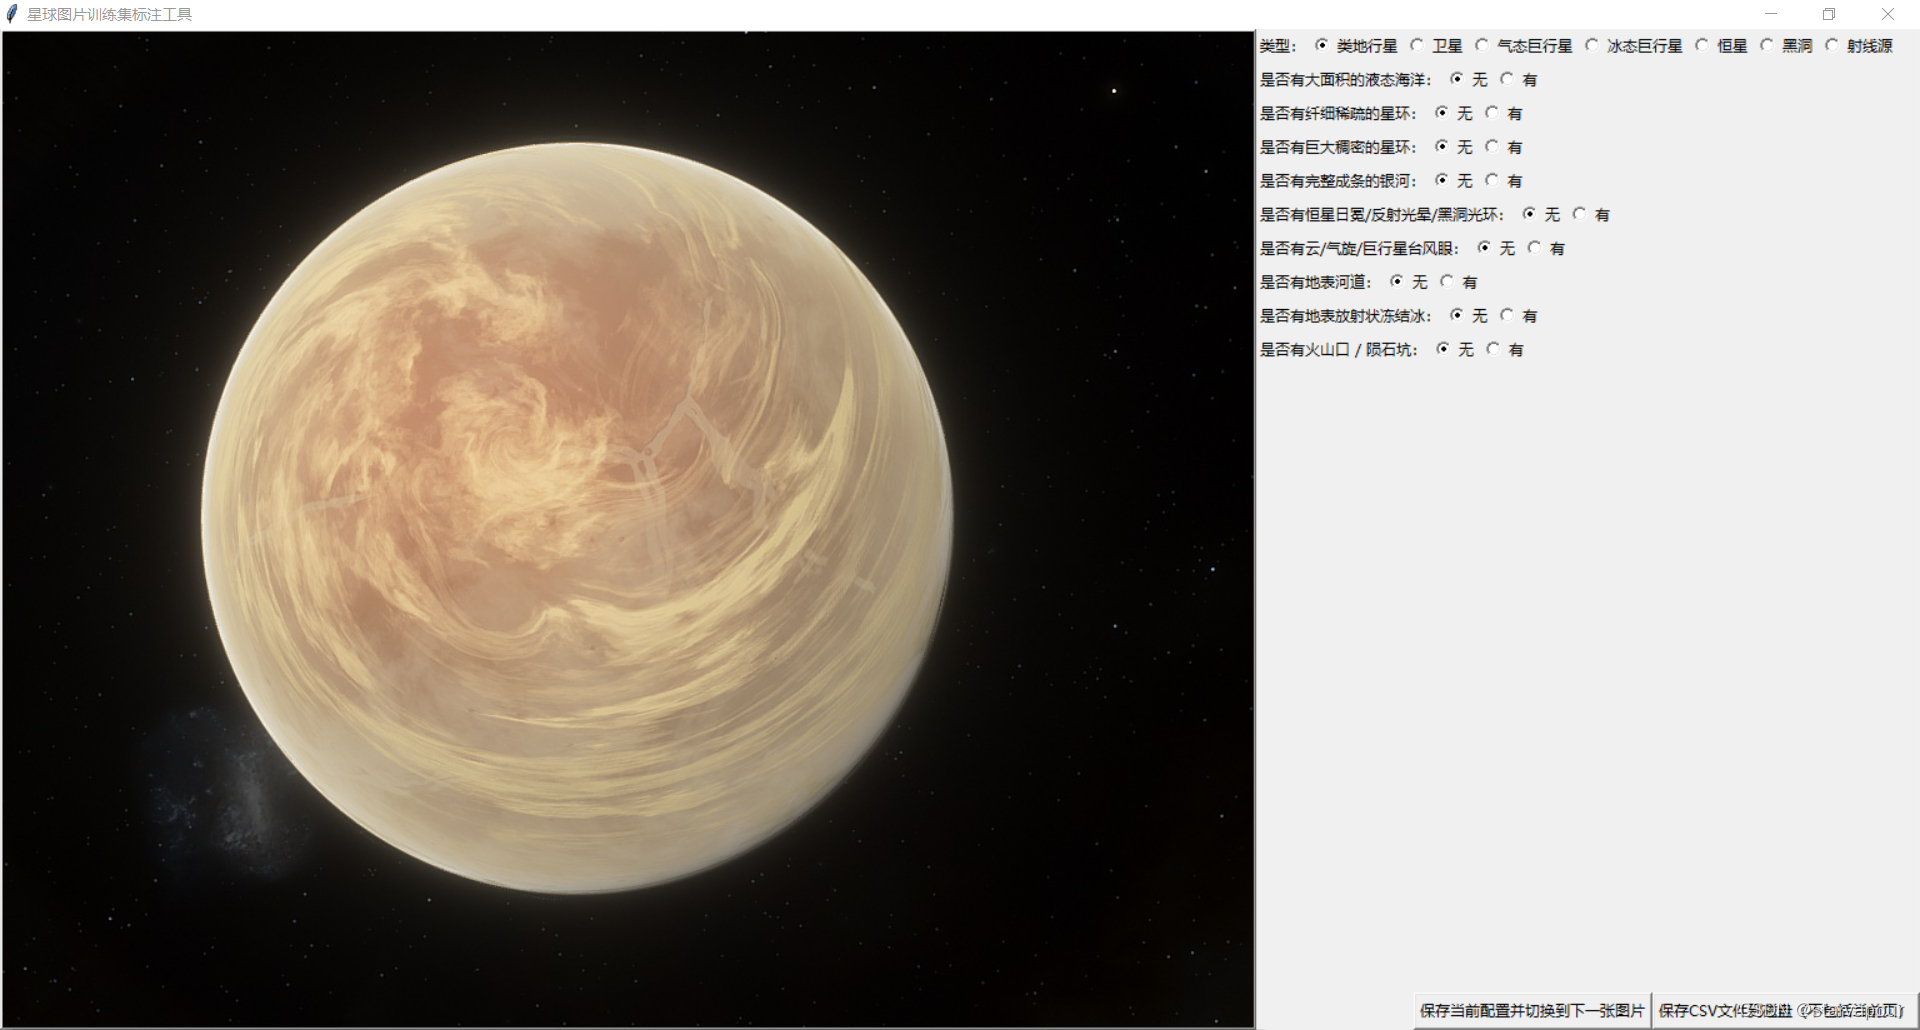
对应的属性将会被写入csv文件中对应的列:
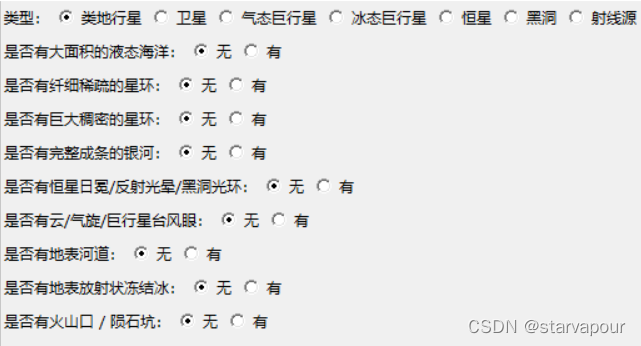
其中,类型这一项将会被转换为多个列的one-hot编码形式,而其它属性则直接用0与1表示否与是,即最终条件向量是完全由0与1的离散值构成的。
1.2 先验信息的条件约束
将条件向量转换为输入的方式很简单:
1、输入一个1维的独热编码条件向量。
2、通过一个线性层将这个向量映射到【频道长*频道宽】长度的一维向量。
3、将这个一维向量reshape成与频道长宽相同的二维矩阵。
4、将这个矩阵作为一个新的频道叠加到神经网络输入的三维矩阵中。
1.3 分类器C
为了自动化筛选输出,设置了一个分类器C作为自动化选择版本的指标。
注:此处使用分类器C的做法不具备严格的论证!也不具备严密的理论基础!仅仅是在操作简便性上比较好用!如果追求更加严密的选择方式和实际效果,网上有很多相关的学术论文与判断方式可以学习!你可以按照那些资料的方式来更好地选择你的评估参数,这里只是出于编码简便,没有用复杂的方法!
生成器G接收条件向量与噪声/前置图片作为输入,根据条件输出图片。
判别器D接收条件向量与图片作为输入,根据条件输出对图片的打分。
分类器C接收图片,输出一个分析图片得到的条件向量。
分类器C只使用真实图片进行训练,但是它会对生成器的图片进行条件输出,由于LapGAN中的高分辨率图片是基于低分辨率图片生成,此处姑且认为使用真实训练集的低分辨率图片输入时,生成器给出的高分辨率图片输出应该尽可能接近对应真实训练集的高分辨率图片。即,如果分类器C在训练集高分辨率图片上分析条件的loss接近0,那么对生成器相同低分辨率图片输入后得到的高分辨率图片,loss也应该越低越好。
这个想法没有严格的证明,只是编码简便,而且实际使用中对迭代训练版本的自动筛选最优版本效果还行。
缺点:由于分类器同样有训练过程,这个数据也会有阶段性震荡,在不同训练阶段需要人工手动重置进度,也许改成真实图片与生成图片得到的loss之差最小会更好,但还没有经过实验证实。
1.4 LapGAN的分层残差拟合
参考:LAPGAN论文解析
参考LapGAN的相关资料进行实现,采用多层分段式训练。
首先把原始训练集缩放到1024x1024的尺寸,然后将它逐层缩小,每一层长宽是上一层的一半,直到变成8x8,保存每一层的图片到磁盘作为训练数据。
注:这里的缩放不是常用的缩放算法,参考LapGAN的实现,每一层的1个像素都对应上一层的2x2像素块,此时这个像素的值其实是2x2像素块中4个像素的均值。
因此这里使用的缩放算法与常用的默认图片缩放算法不同,其实应该是一种均值池化操作。
第1层生成器完全由2-3个线性层构成,接收一个条件向量和一段正态分布的随机噪声,然后生成8x8的图像。
后续每一层的生成器都接收一个低分辨率的训练集图片作为输入,在输入图像上叠加一个条件向量转换来的通道,再叠加一个提供随机信息的高斯噪声通道,输出一个长宽翻倍的高分辨率图像,与真实数据集中的高分辨率图像一起输入判别器进行训练。
注:这个过程或许可以说就是在做超分辨率重建,重复做了很多次超分辨率重建,每一次都把长宽翻倍。
它会将输入图片通过最近邻插值的方式放大到两倍长宽,然后神经网络的输出为这个图像与真实图像之间的残差图像。
简单来说,最近邻插值将1个像素变成了一模一样的2x2像素,然后残差即为这些像素与真实图像2x2像素的差,将放大后的图像加上残差图像的2x2即得到了生成的图像。
通过残差的方式,降低了网络学习难度,保留原本图像更多的信息不失真。
与此同时,因为这个过程完全没有使用转置卷积层,因此完全不会存在转置卷积层导致的生成图像中出现网格状棋盘图像的问题!
个人看法,此处可能有两种分支:
1、串联,使用前面的生成器输出图片作为后面的生成器的输入
优点:这样会让后续生成器具备一定的纠错能力,获得更好的生成质量。
缺点:生成图像可能过拟合于原始数据集,产生更少的新图片内容。训练后续生成器必须等到前面的生成器版本固定之后再进行,没法灵活替换。
2、并行,只使用真实训练集中不同分辨率的图片作为生成器输入
优点:生成更加多样化,产生与原始数据集不同的新内容。不同生成器训练彼此无关,计算资源足够即可并行训练,同时可以任意替换其中任何一个生成器的版本。
缺点:生成器没有训练纠错能力,一旦低分辨率生成器出现错误,这些错误可能在一层层过程中被不断放大,导致一错再错,最后的图像质量受到严重影响。
本次实现中暂时使用了并行的方式。
2. 代码实现
该版本代码略。
一方面,是因为每层生成器都有相应代码,导致该版本的完整项目代码过长已经不适合放在博客文章里。
当然,可以放github,只是另一方面,这些代码的网络模型中加入了亿点点细节的修正,以至于不太想开源……喂你就这么堂而皇之说出来了?
3. 最终效果
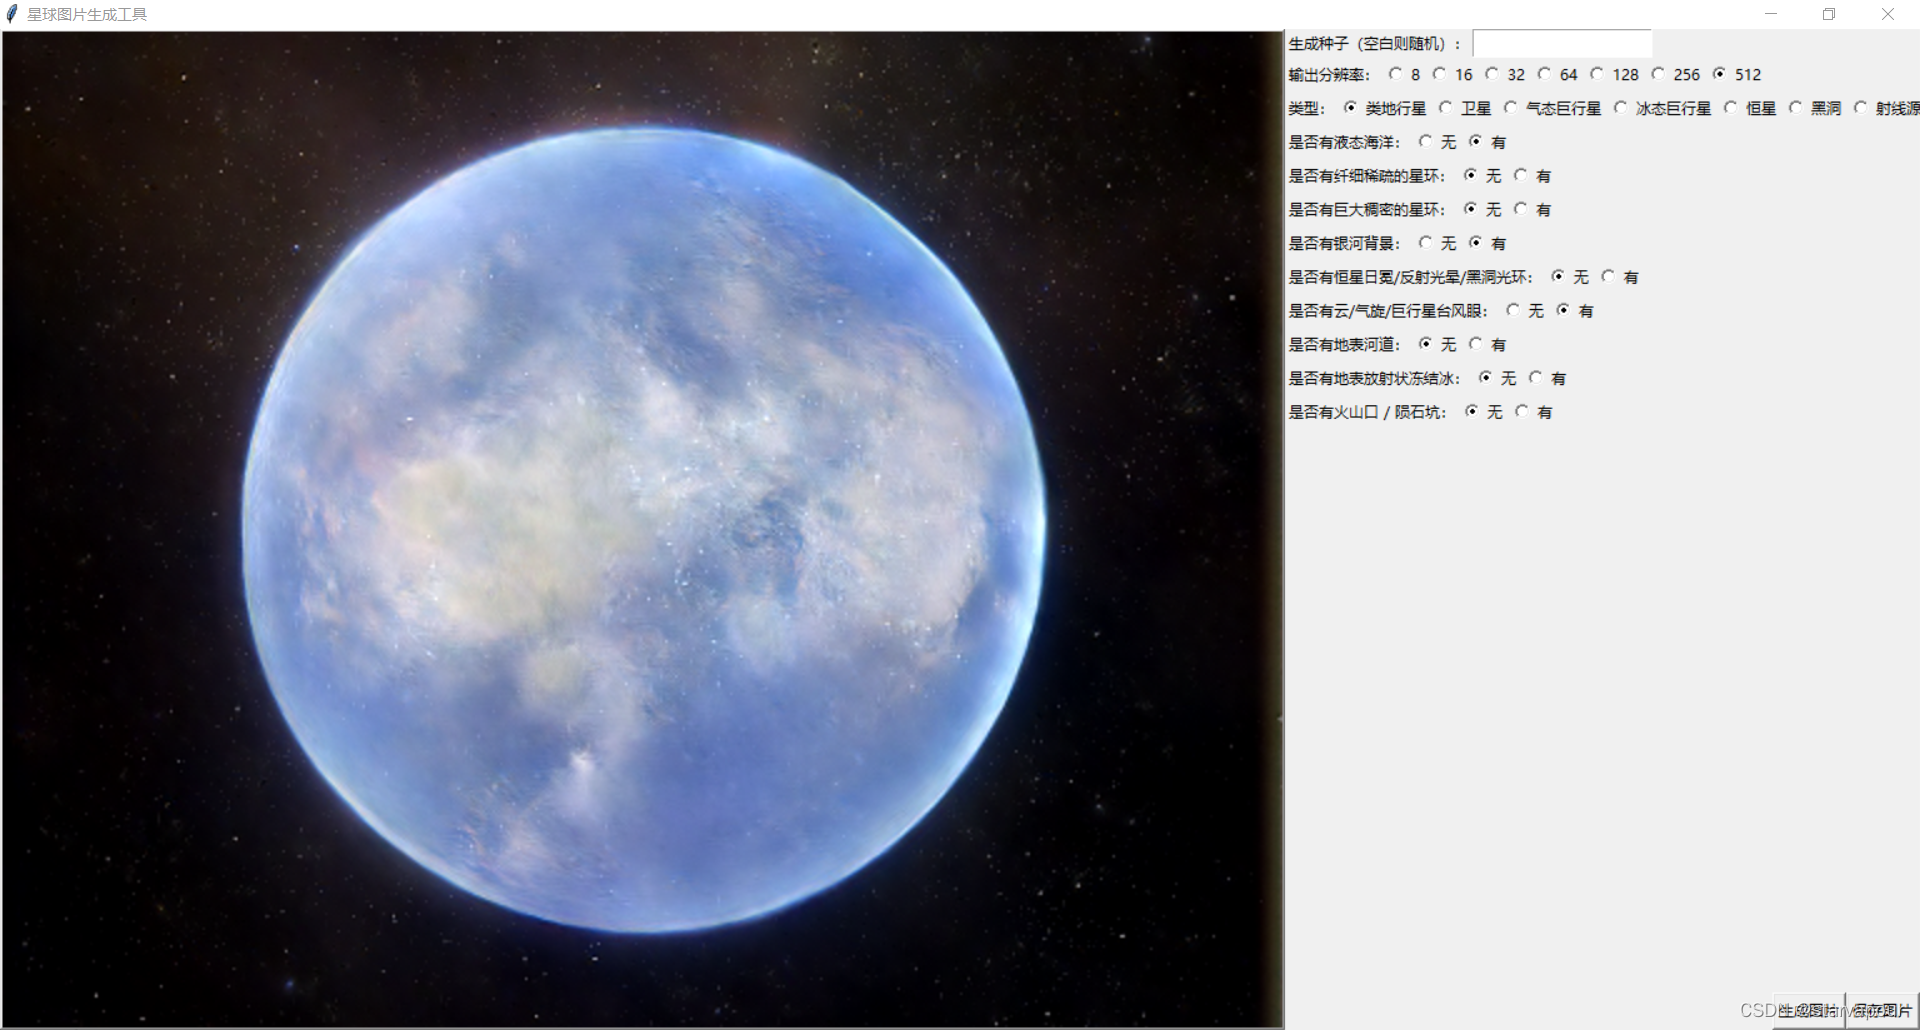
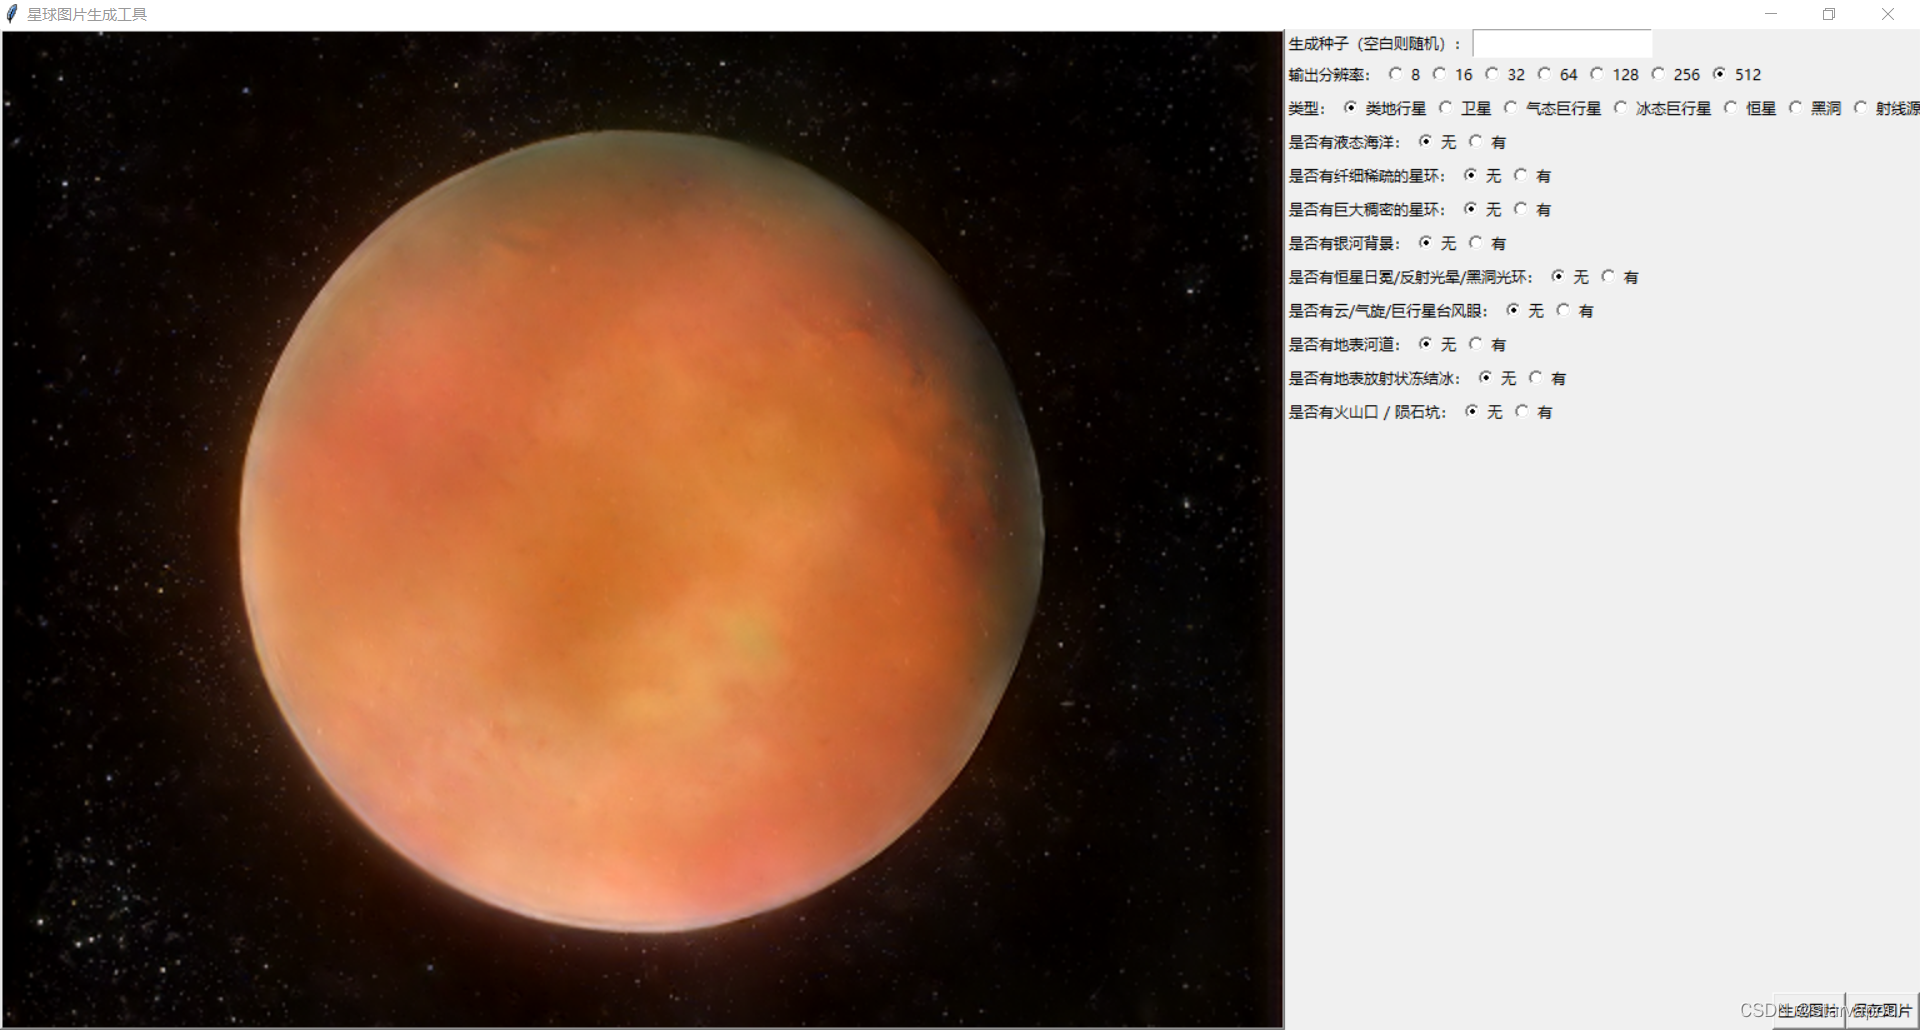
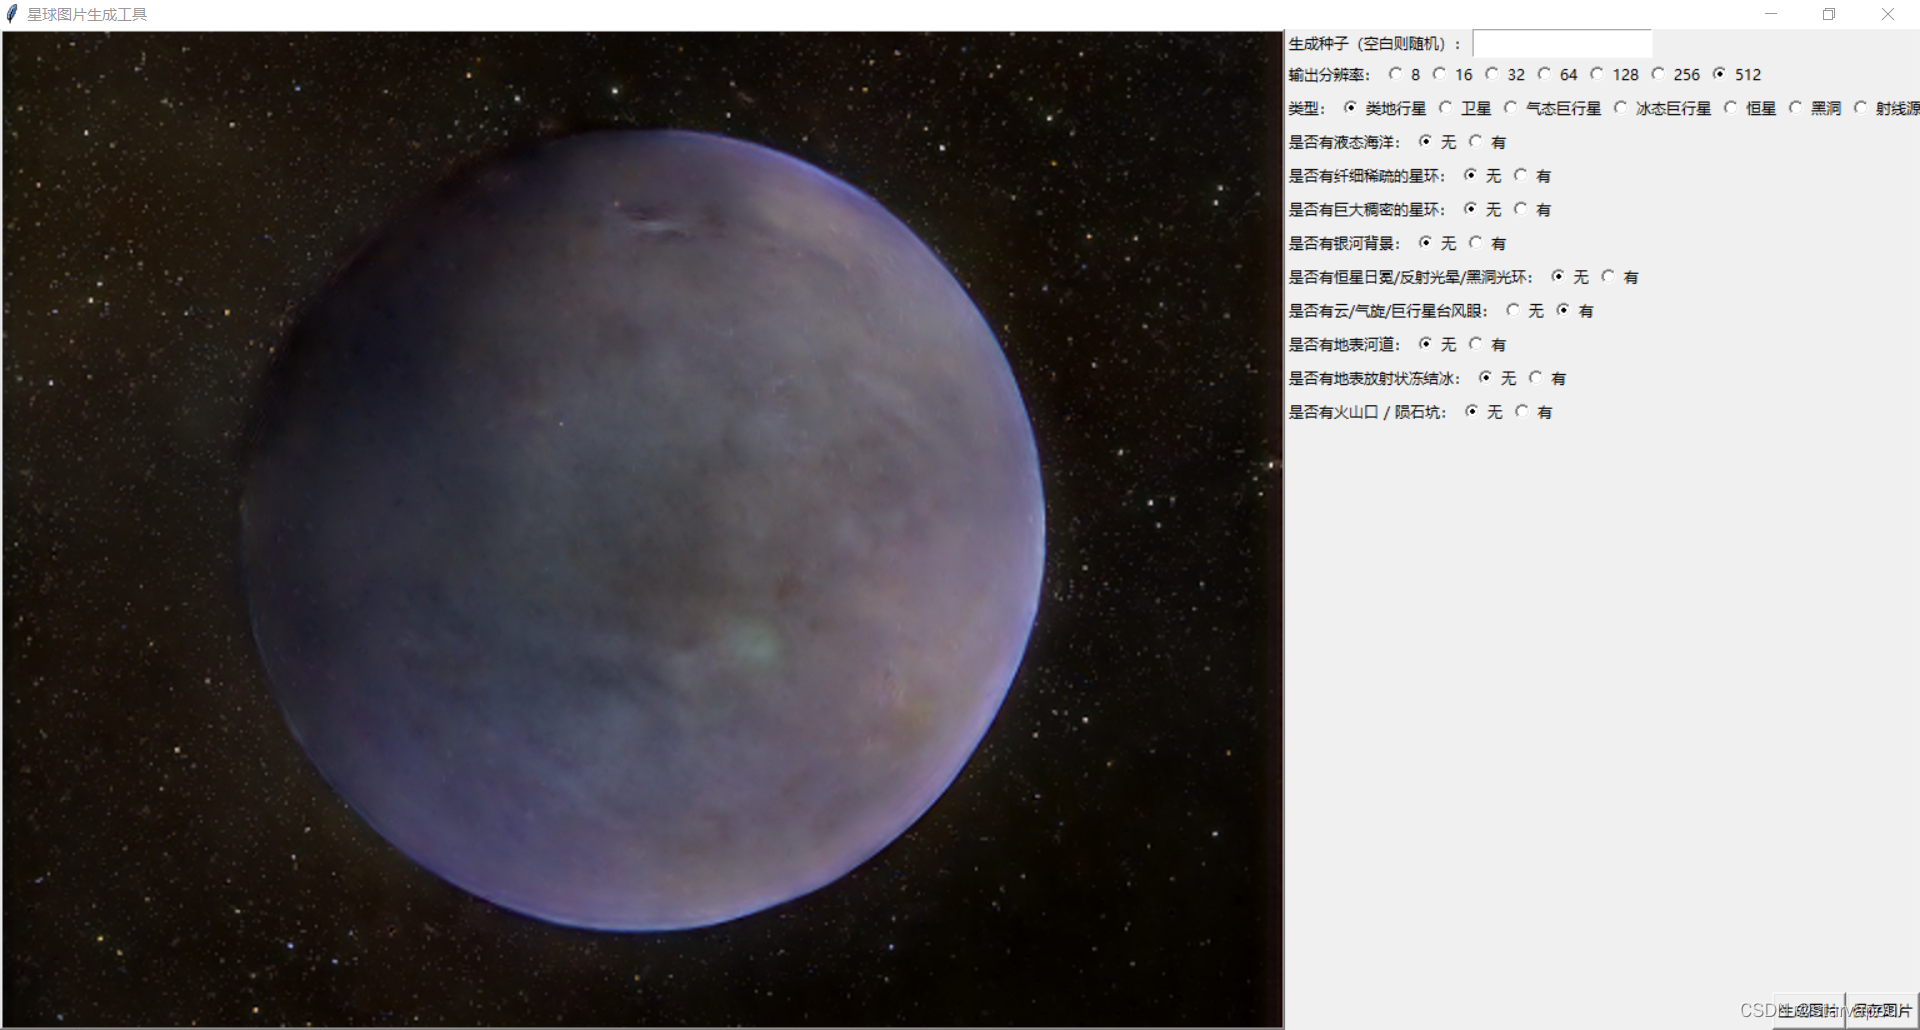
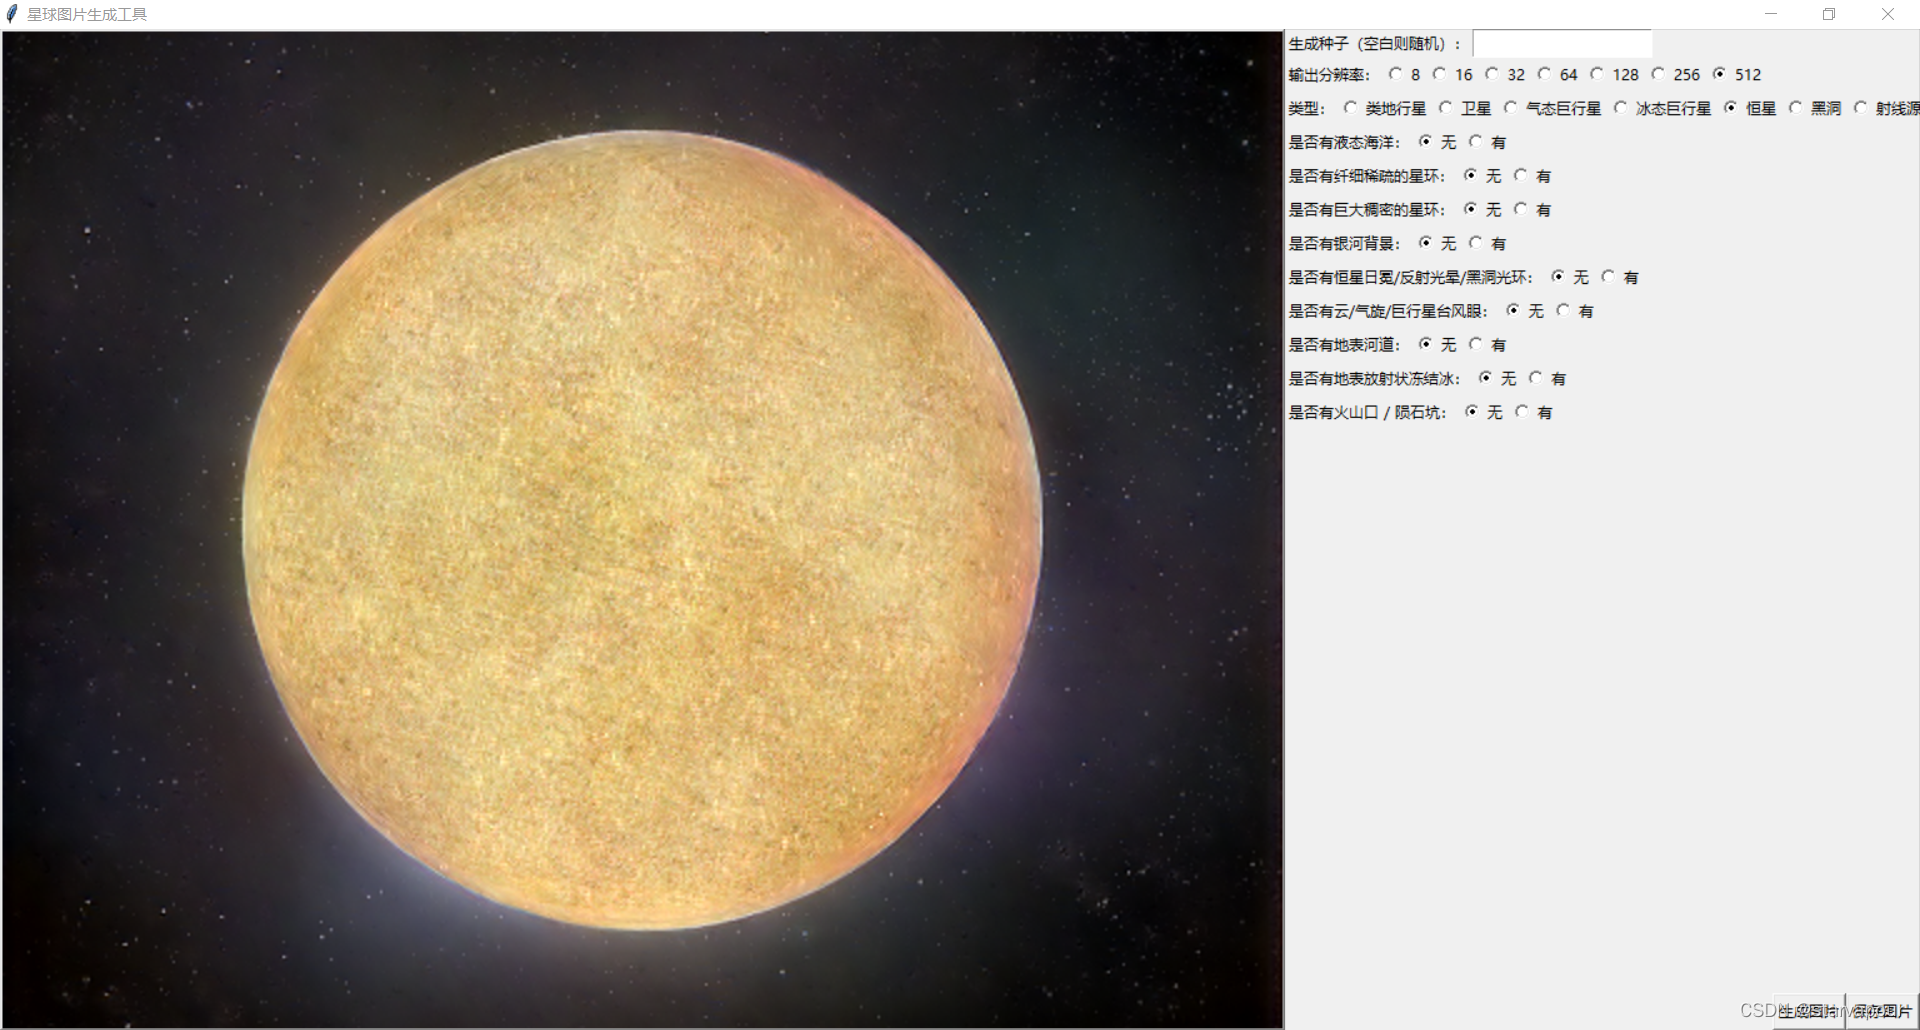
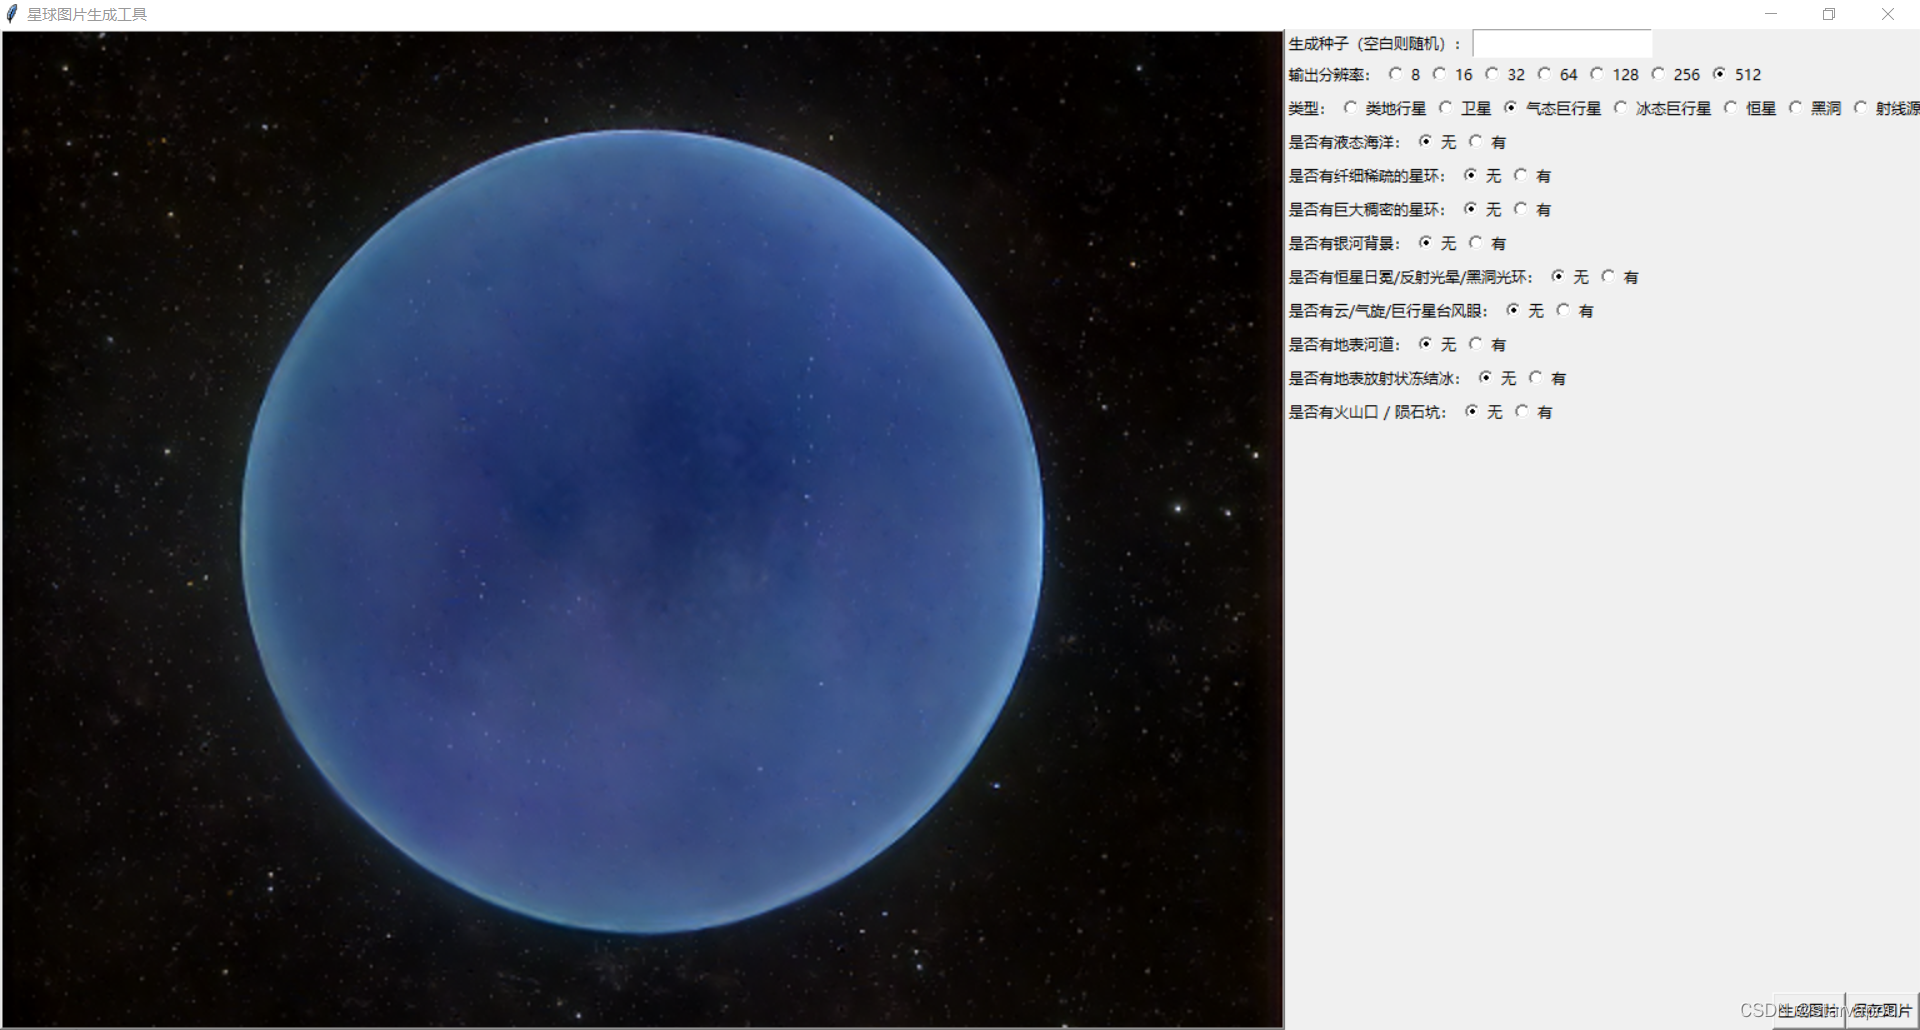
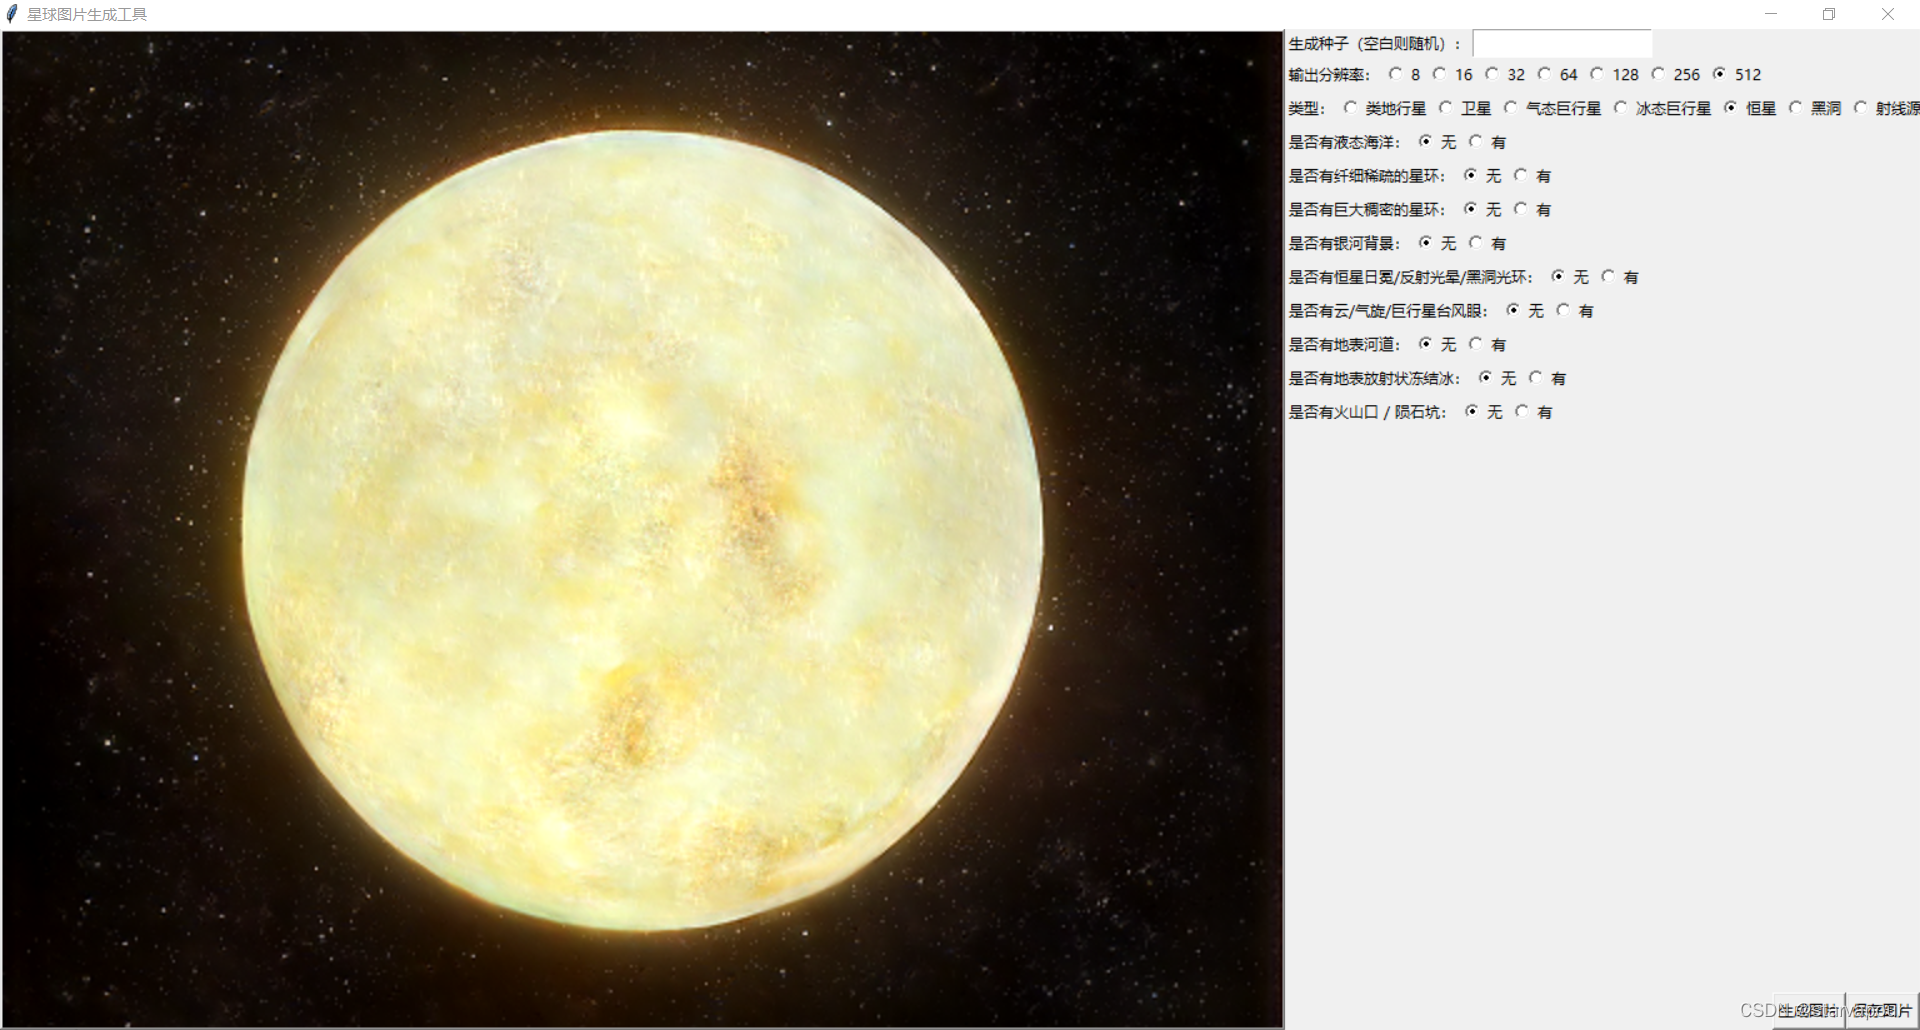
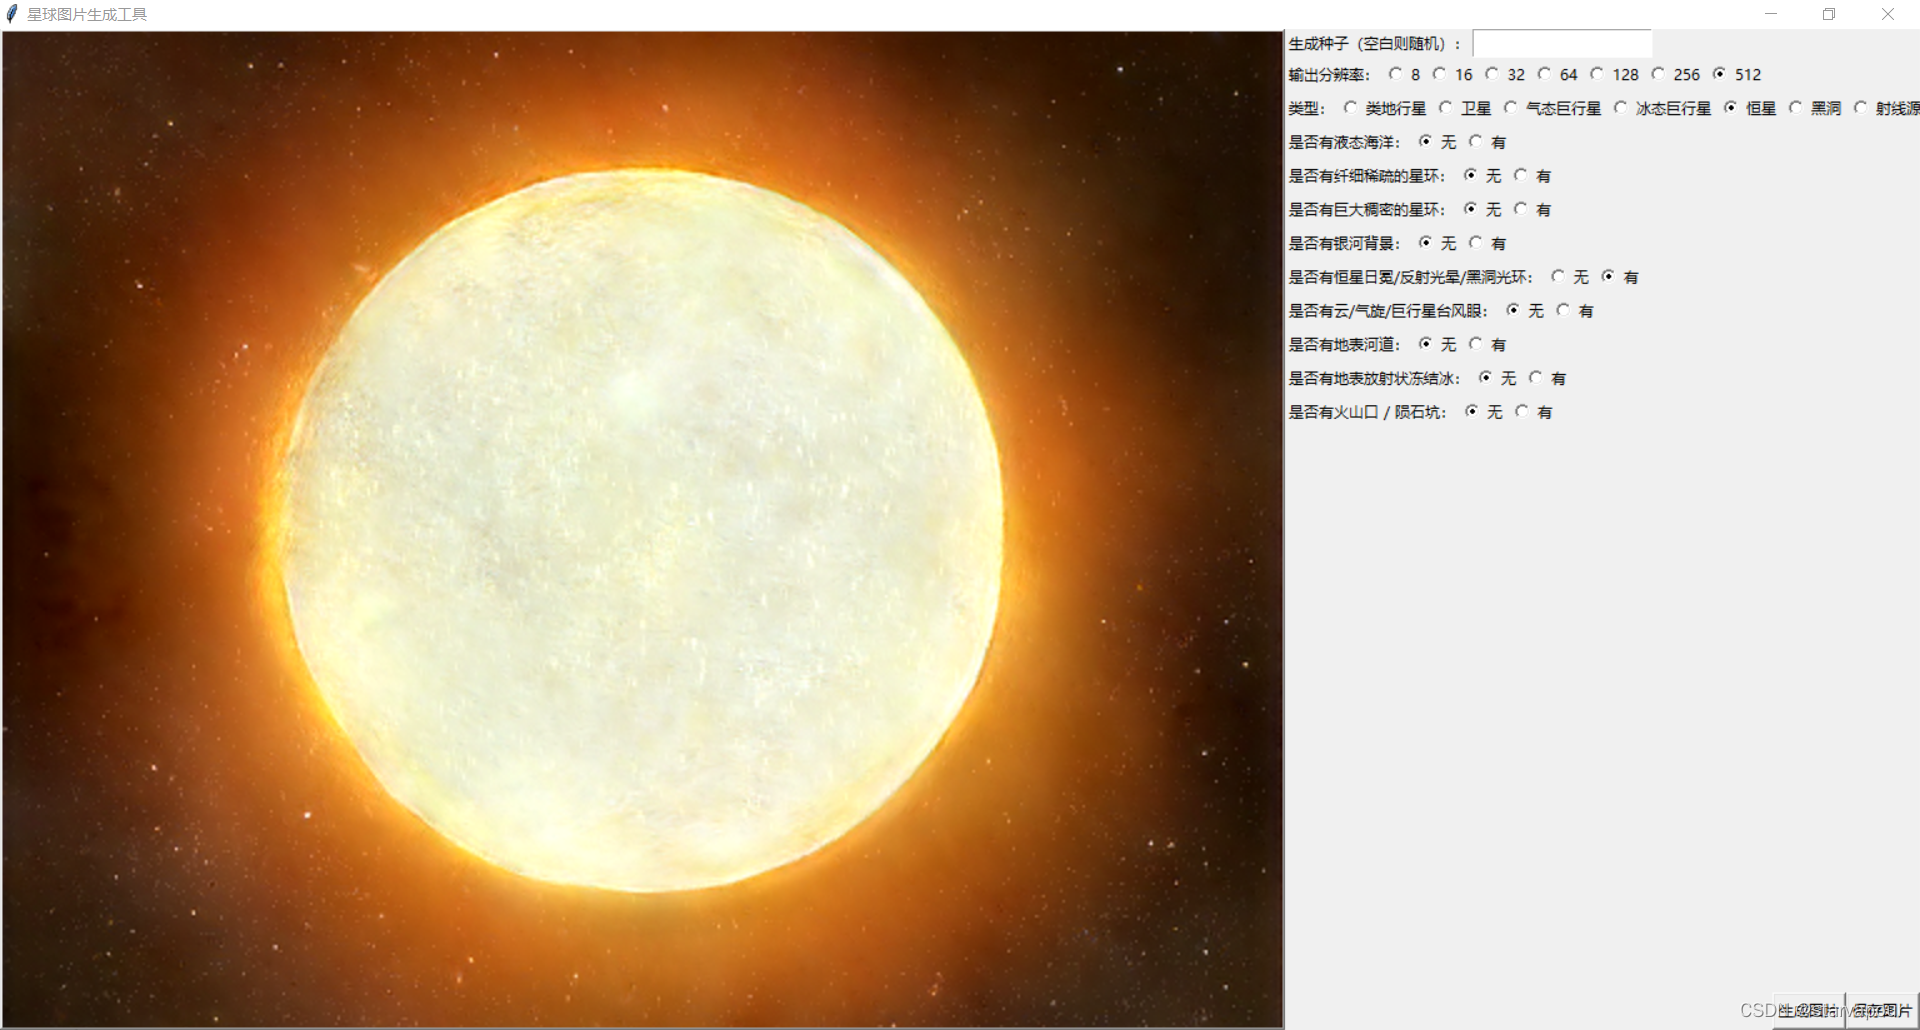
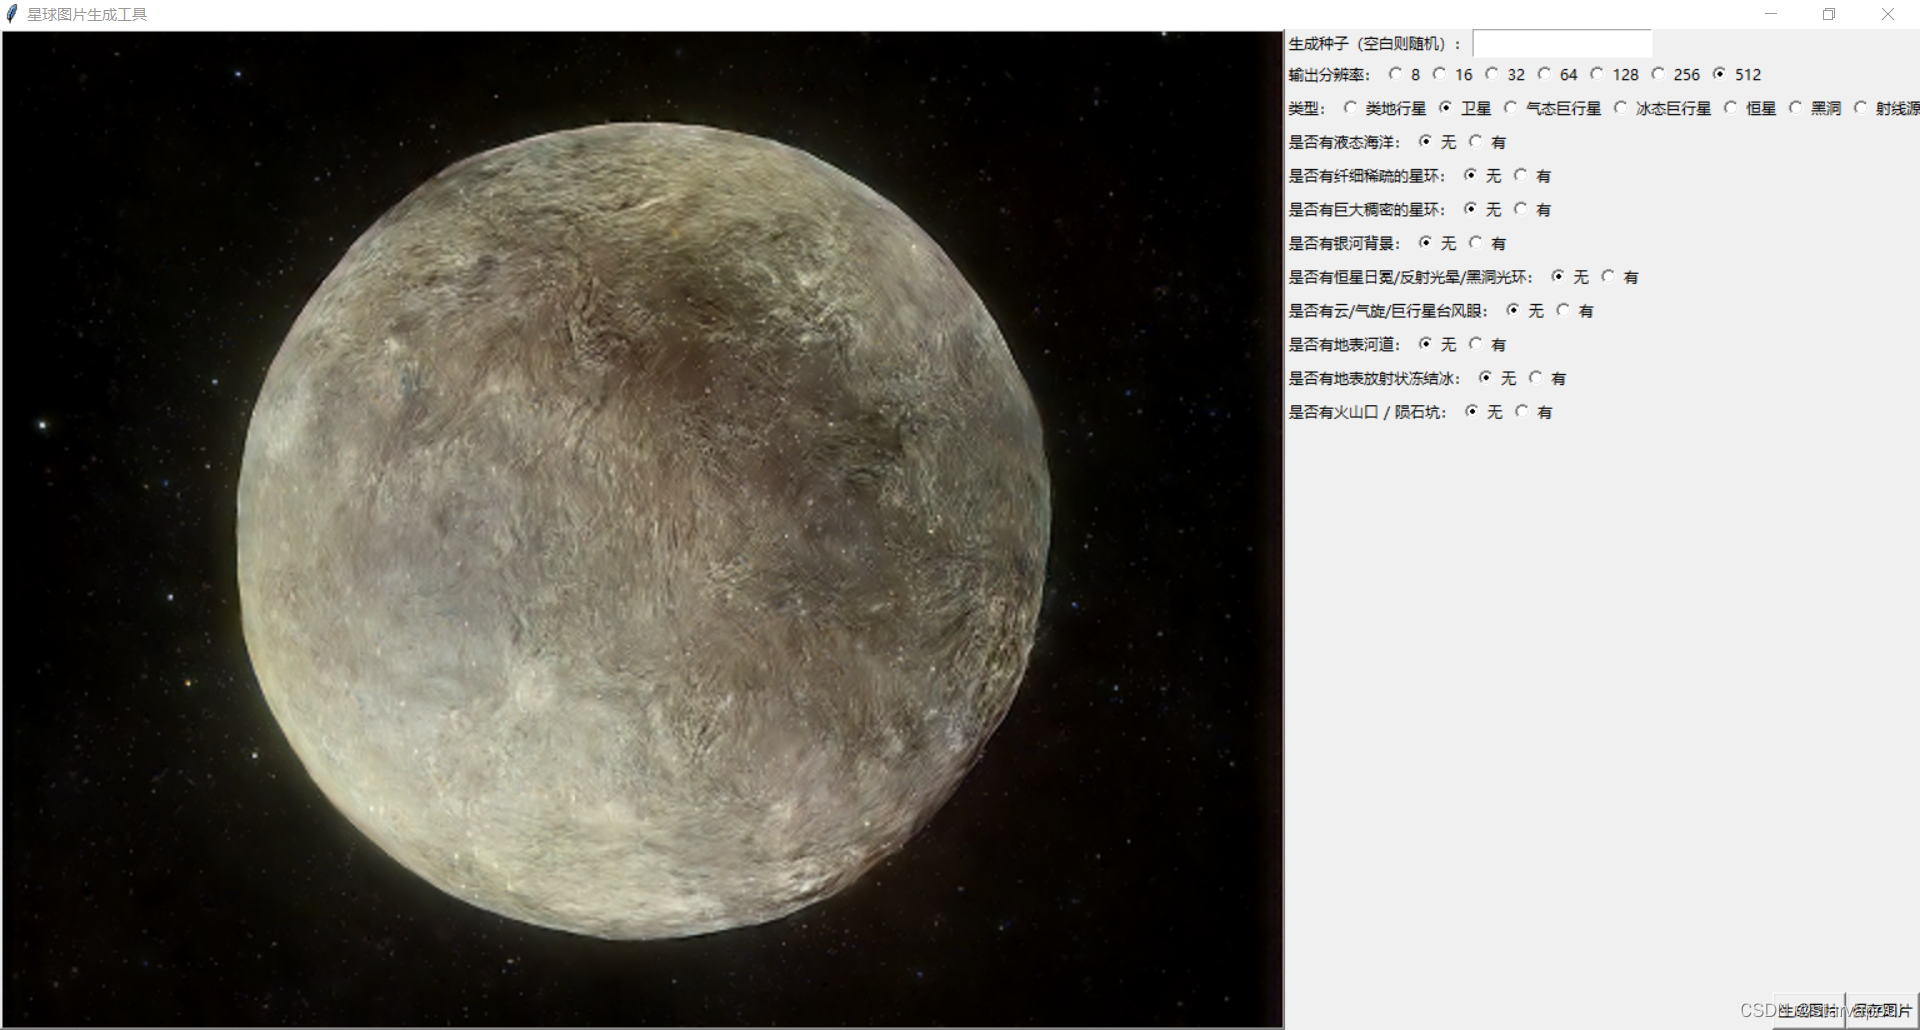
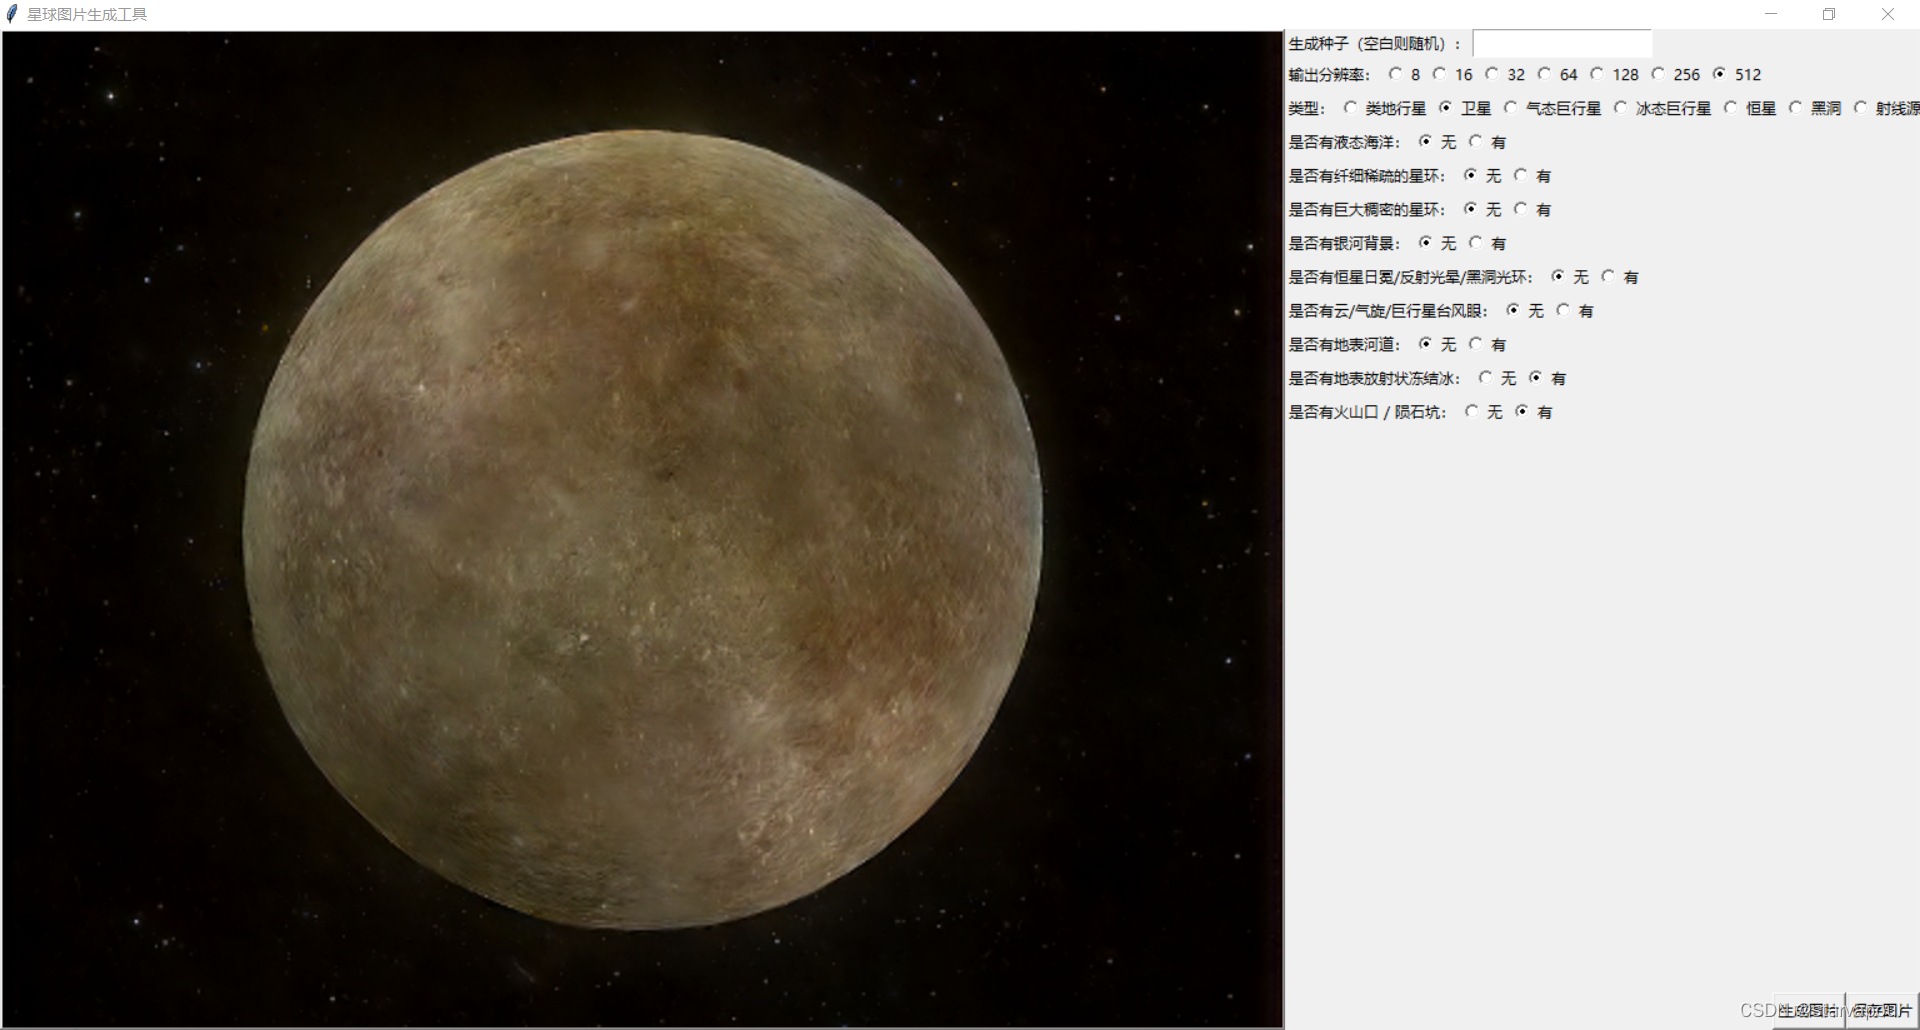
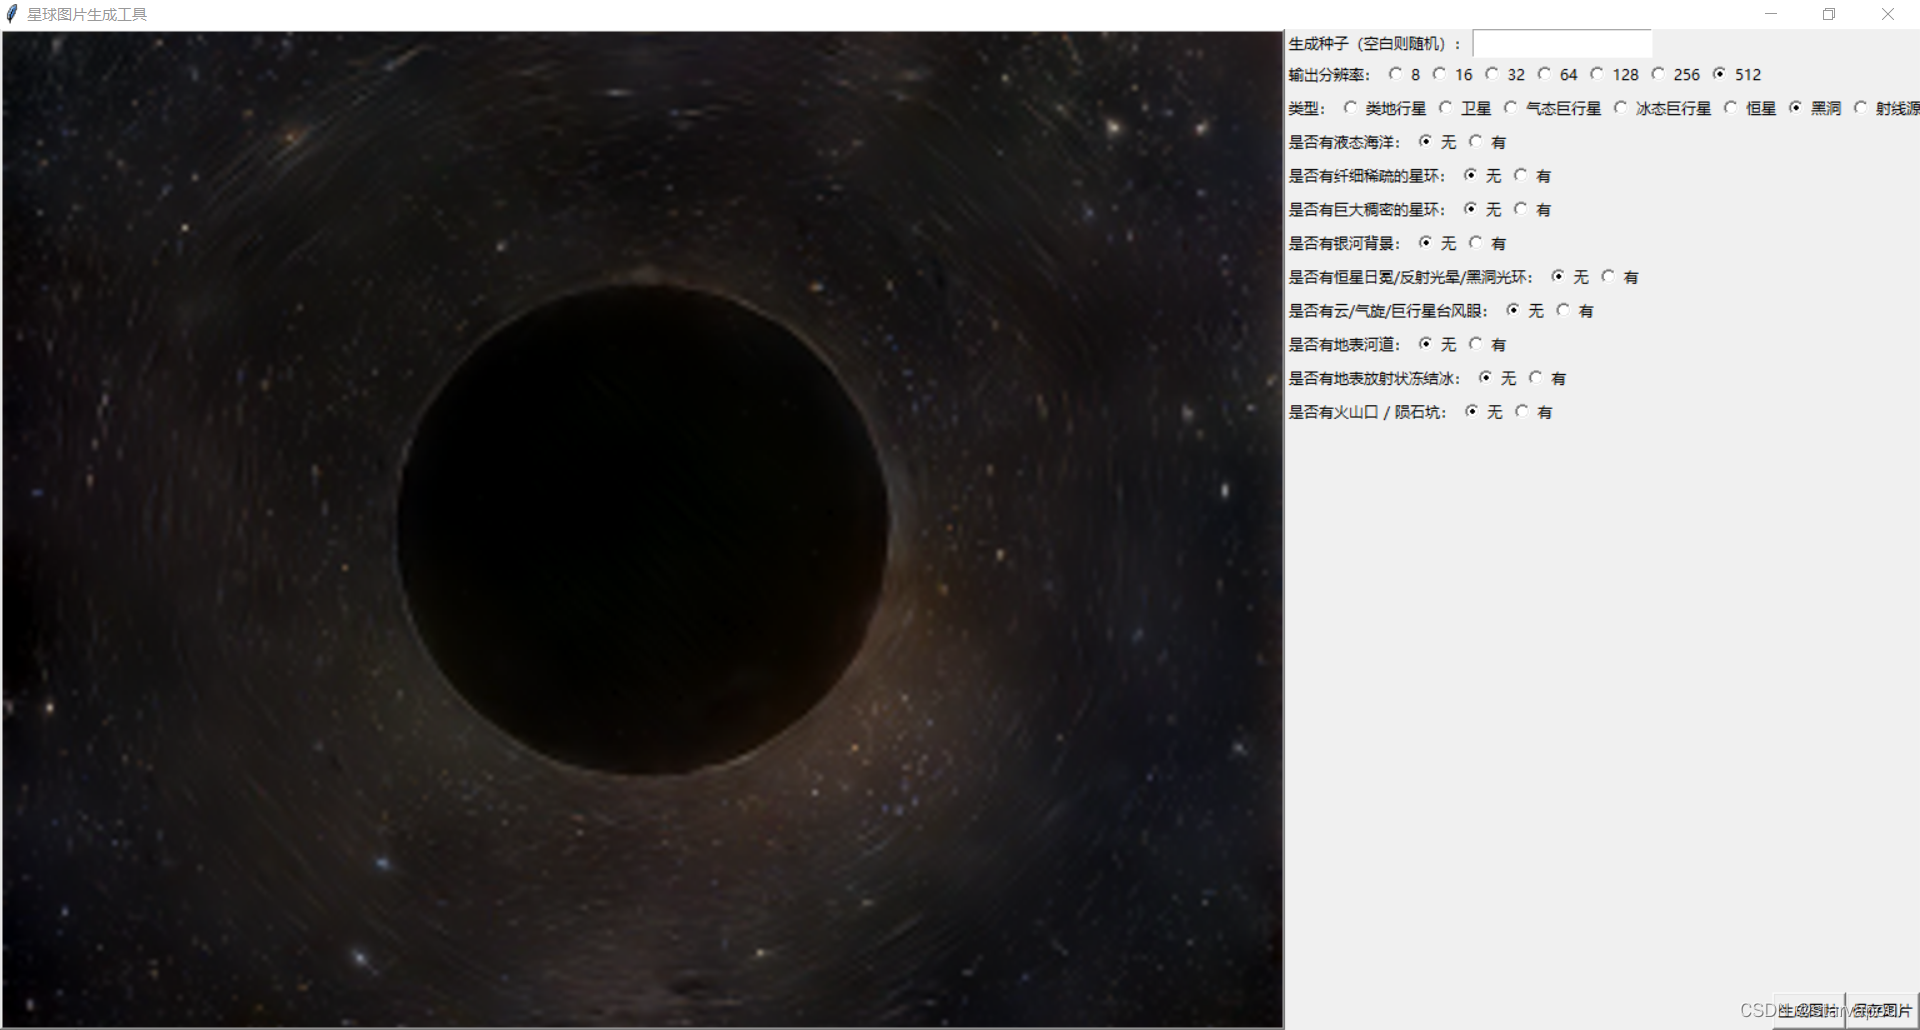
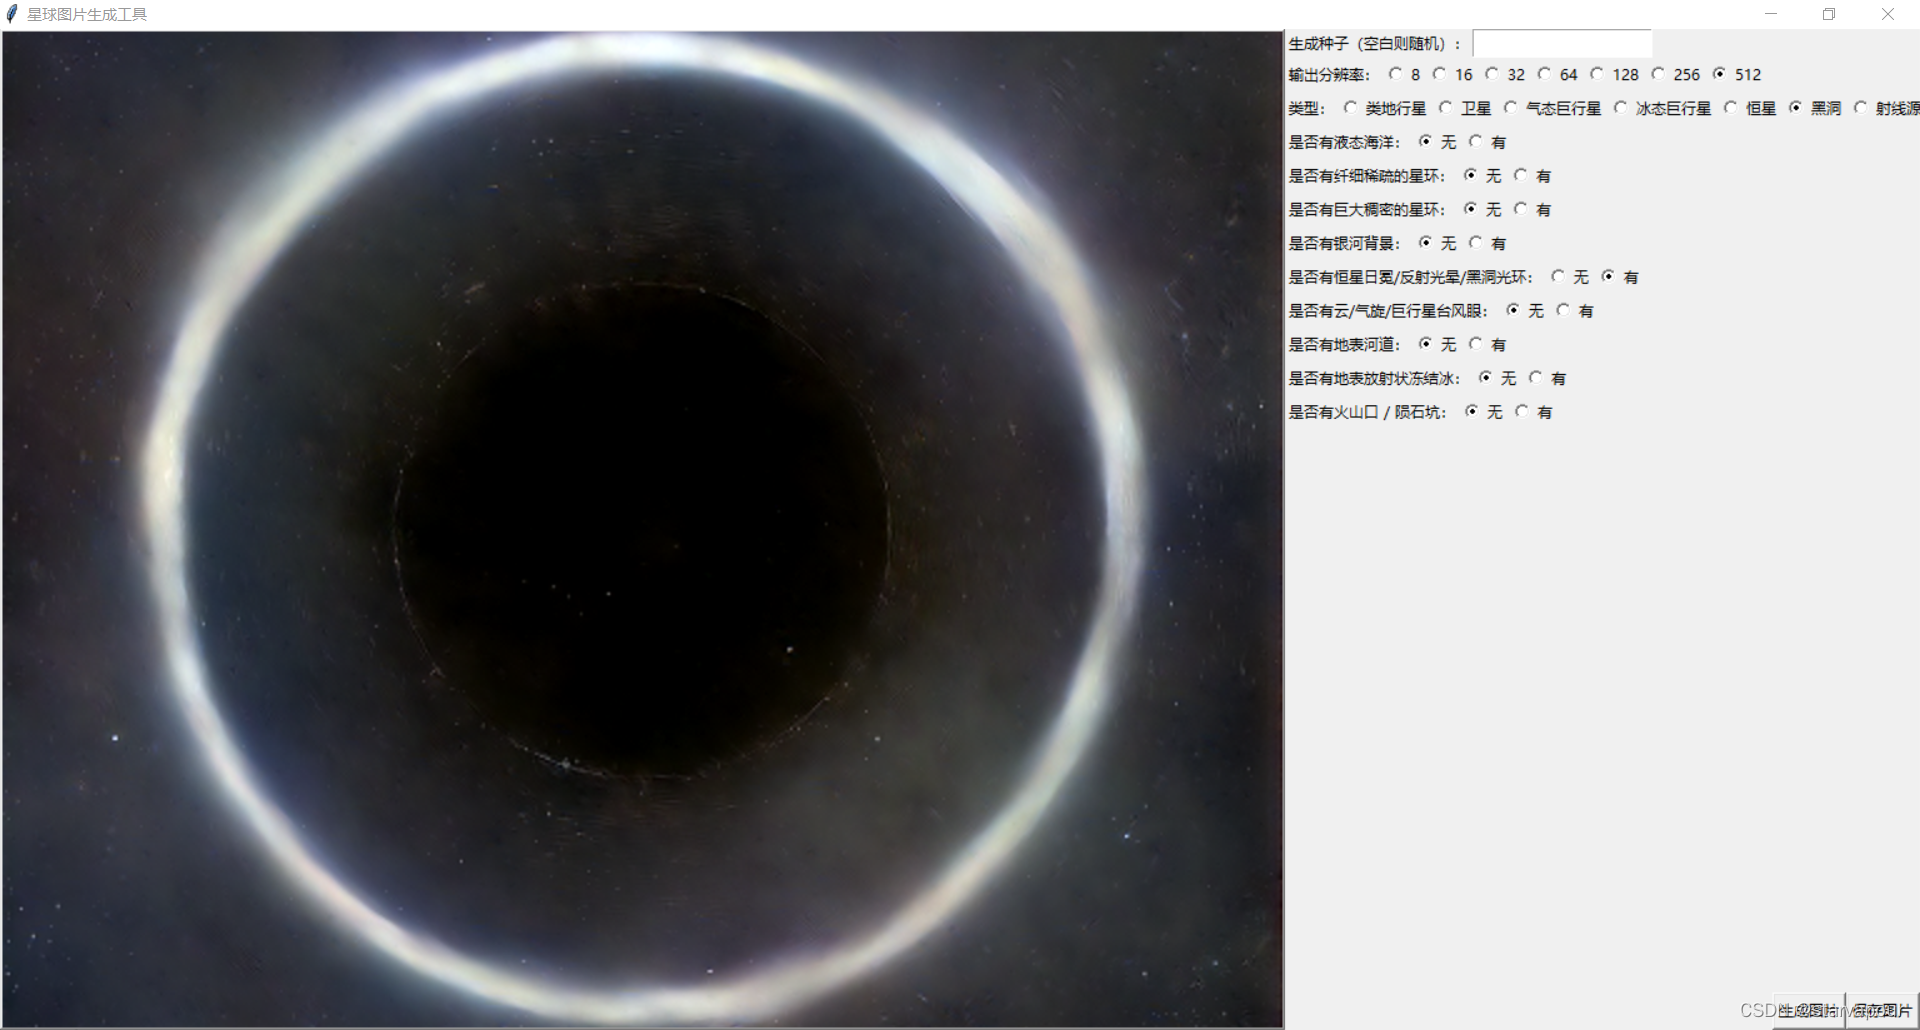
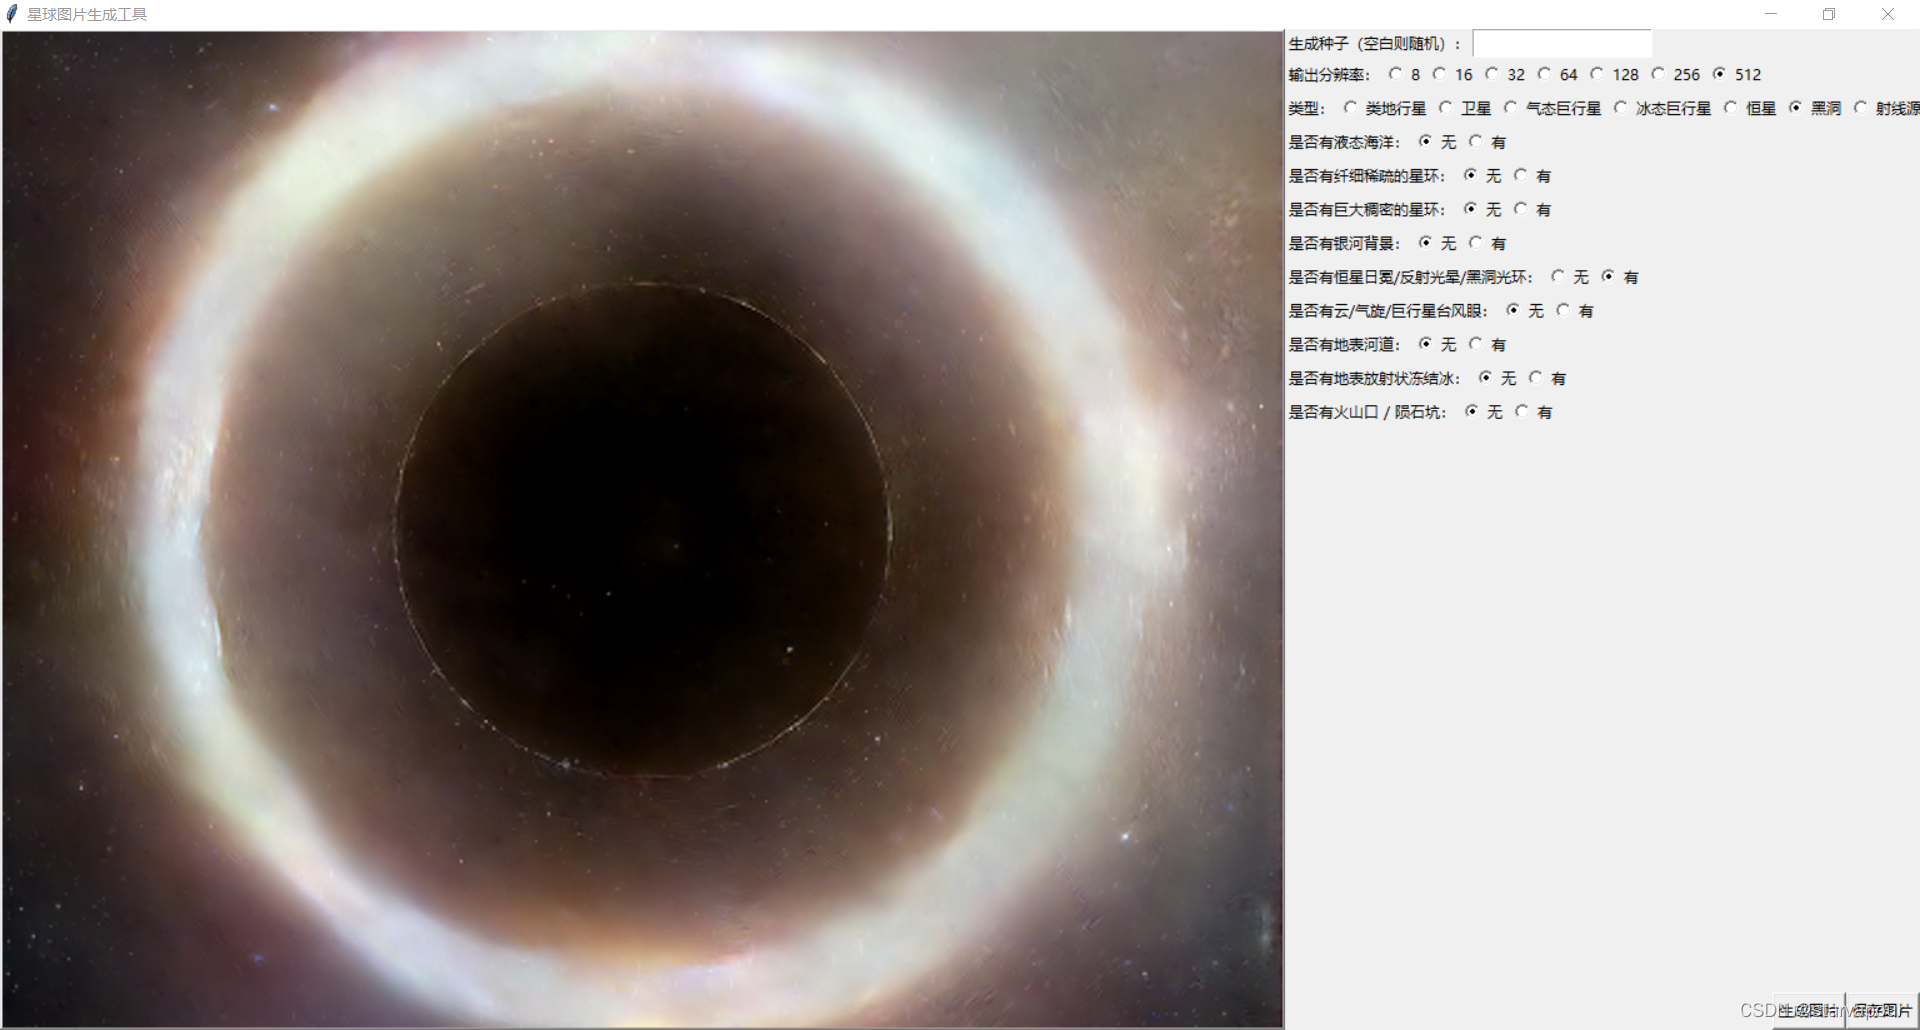
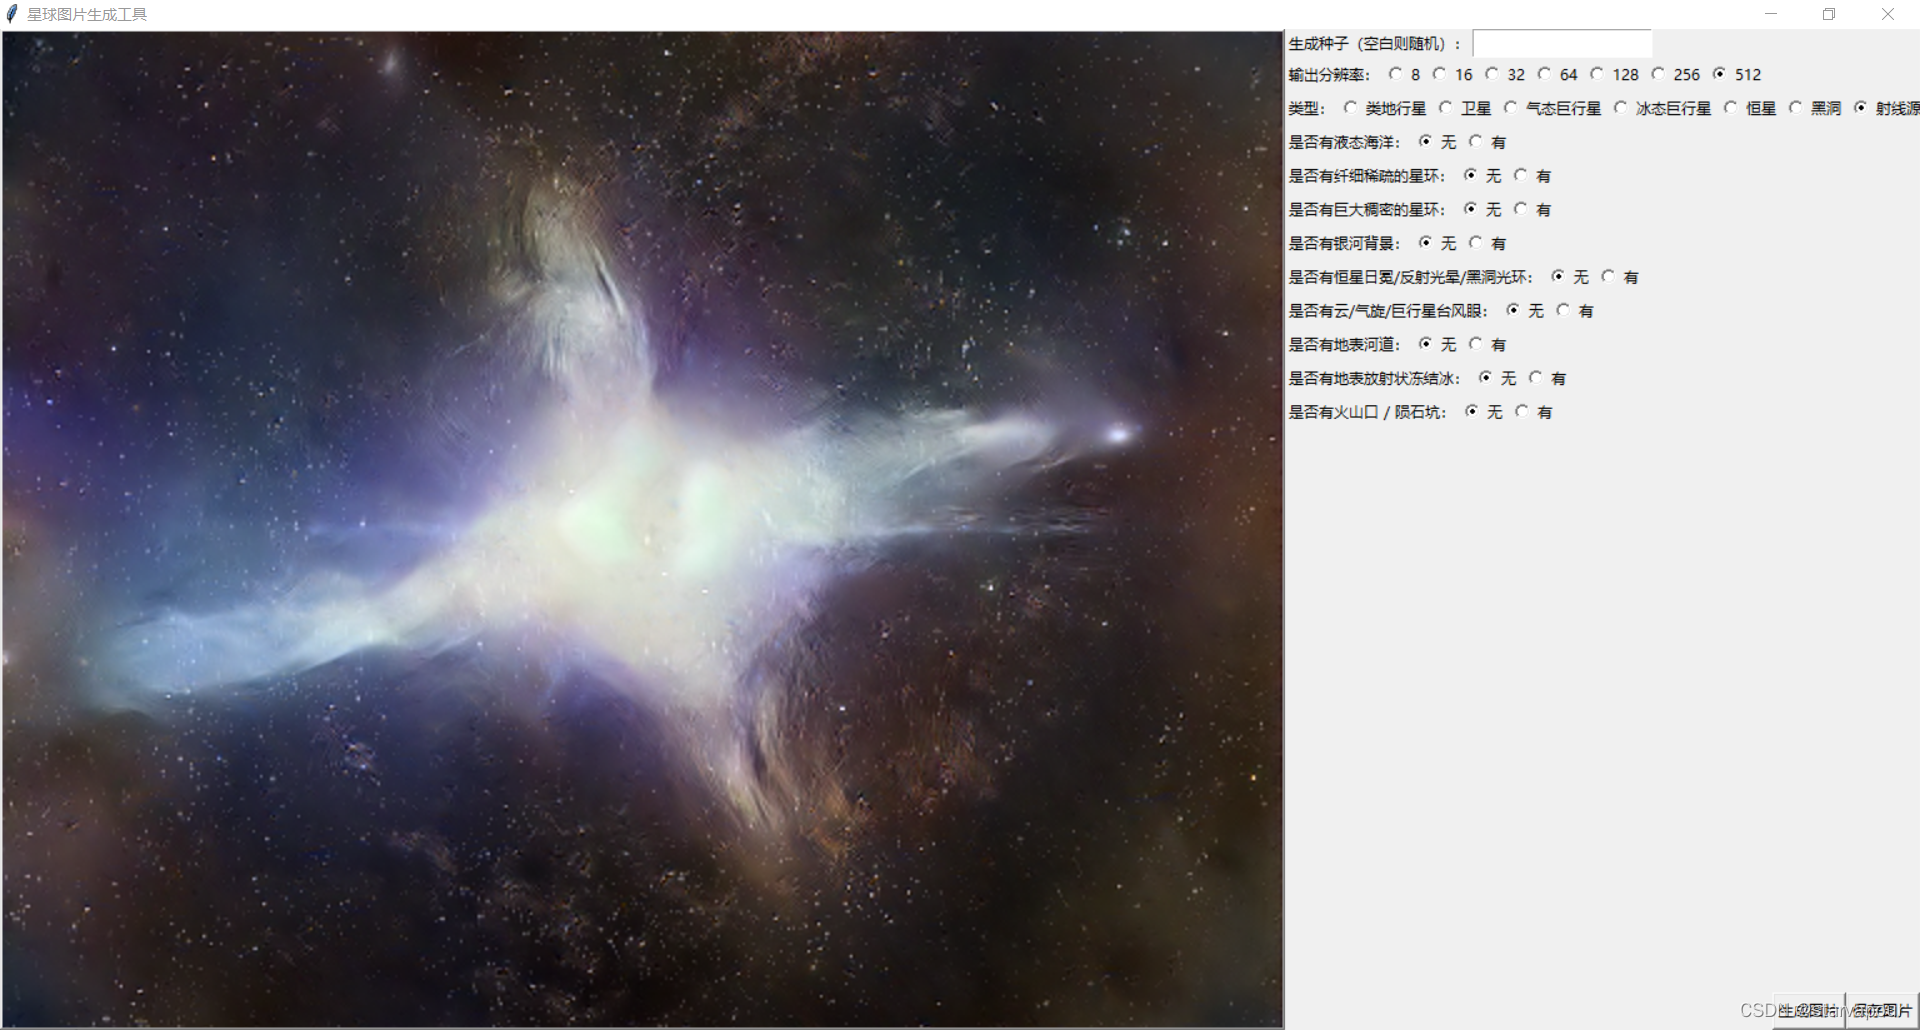
在可视化标注工具的基础上修修改改,弄了一个可视化的条件约束生成器,按钮功能一目了然。
基于硬件限制,显存的极限只能训练到512x512的分辨率【256-512分辨率的模型在设置batchsize=8的情况下大概需要19G的显存进行训练】,即使是这样,也在斥巨资购买的 RTX3090上花费了2个月的训练时间才完成训练。
3.1 层层递进的生成
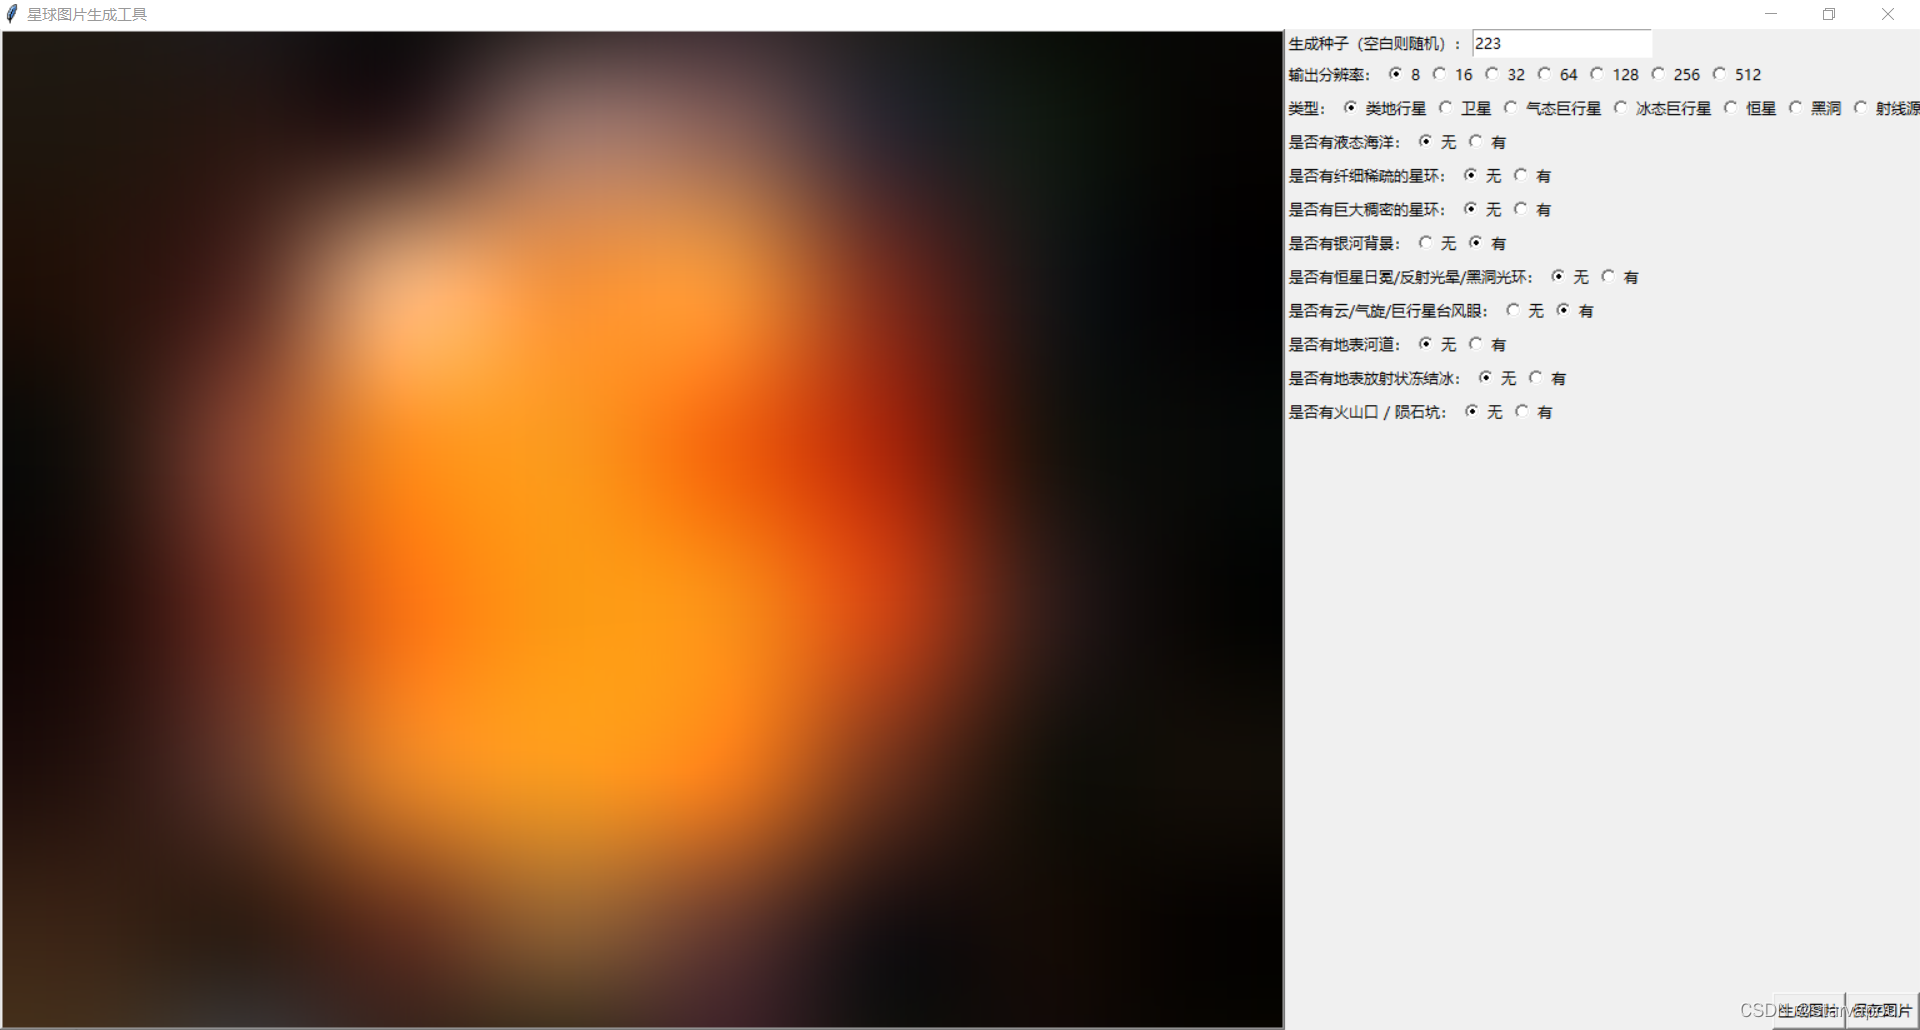
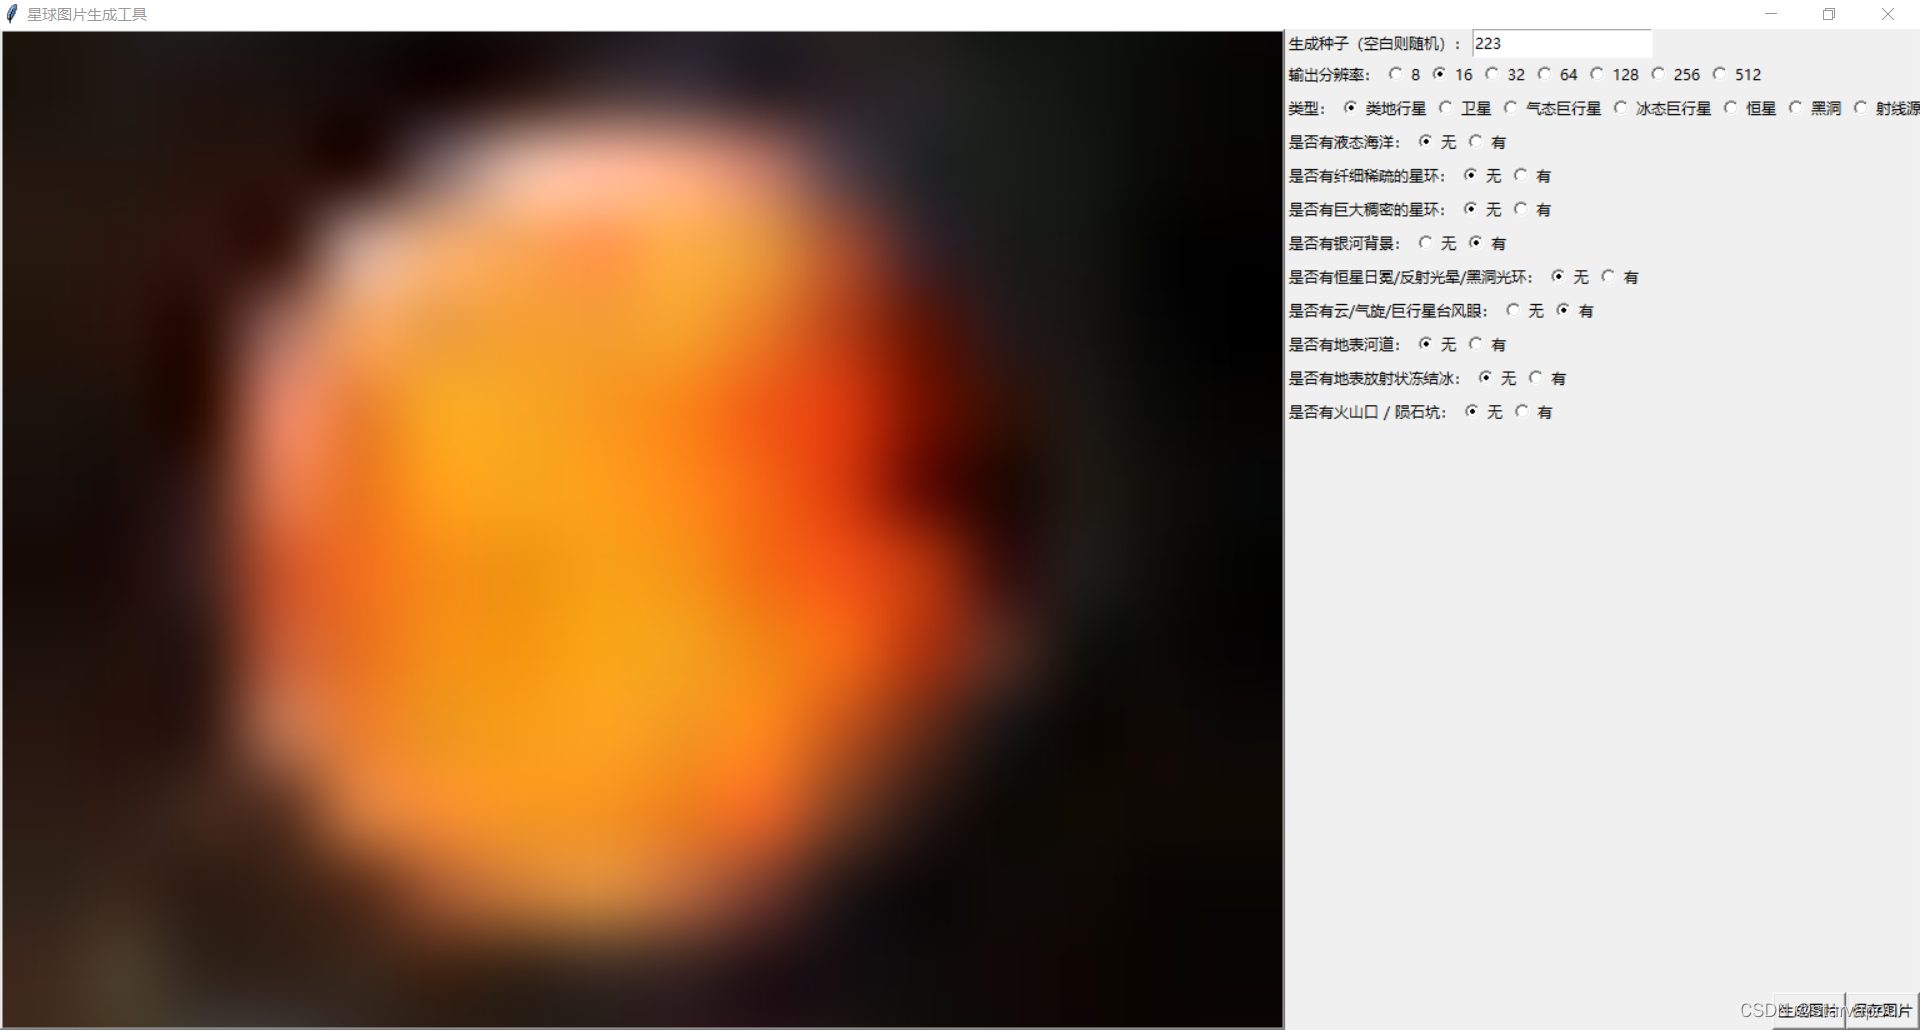
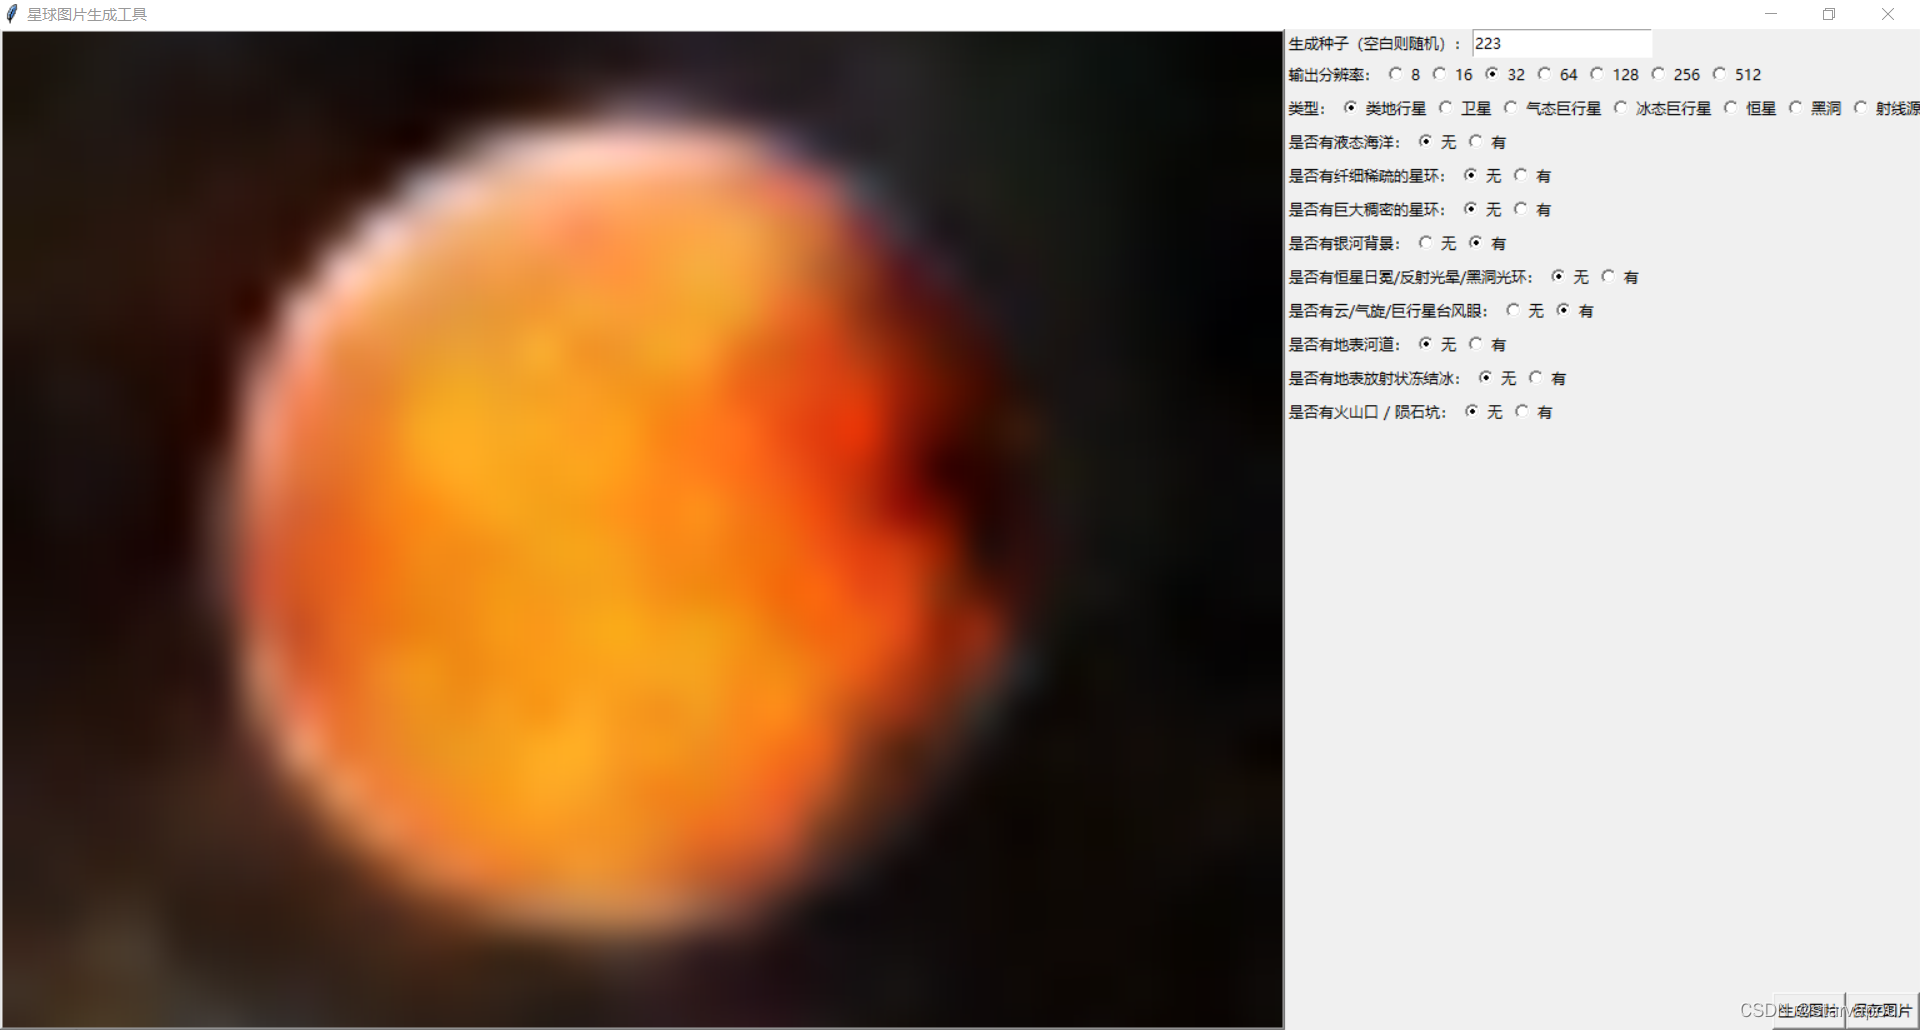
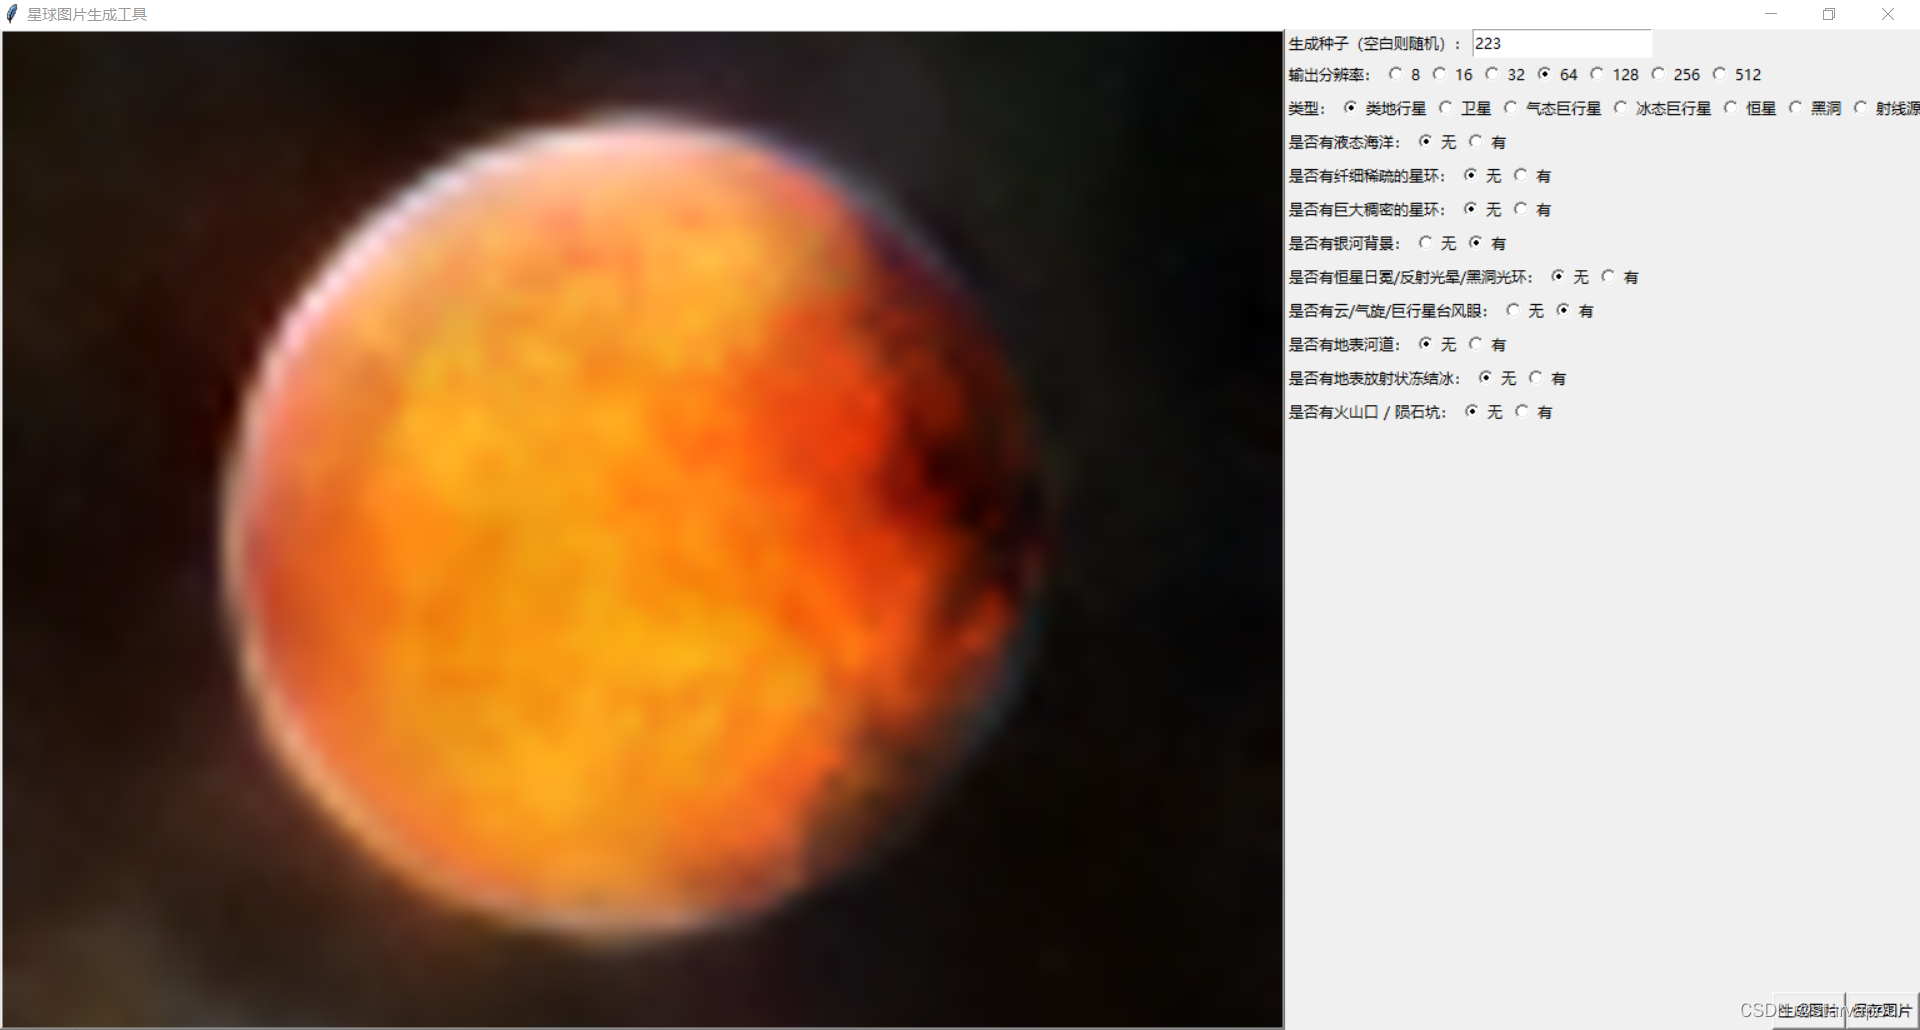
通过固定随机数种子,可以展示一个高分辨率图像被一层层生成的过程。
从8x8的图像到512x512的图像:
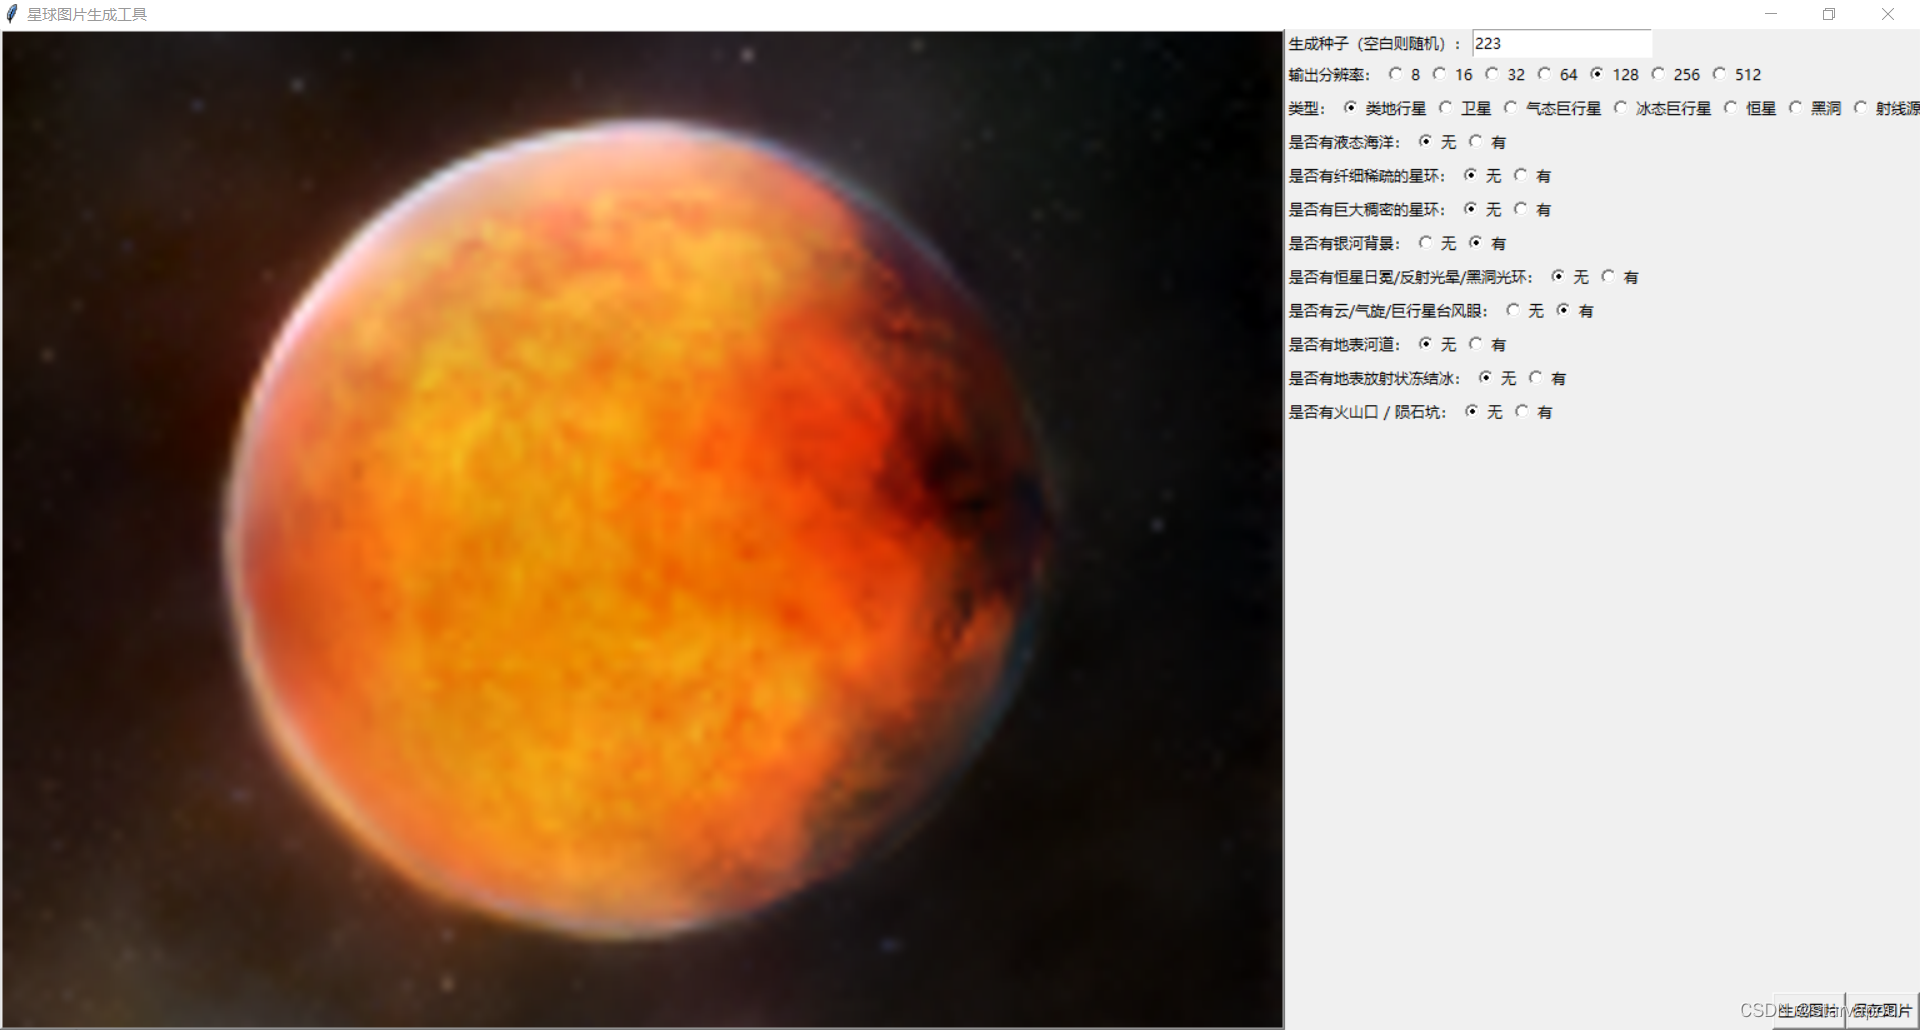
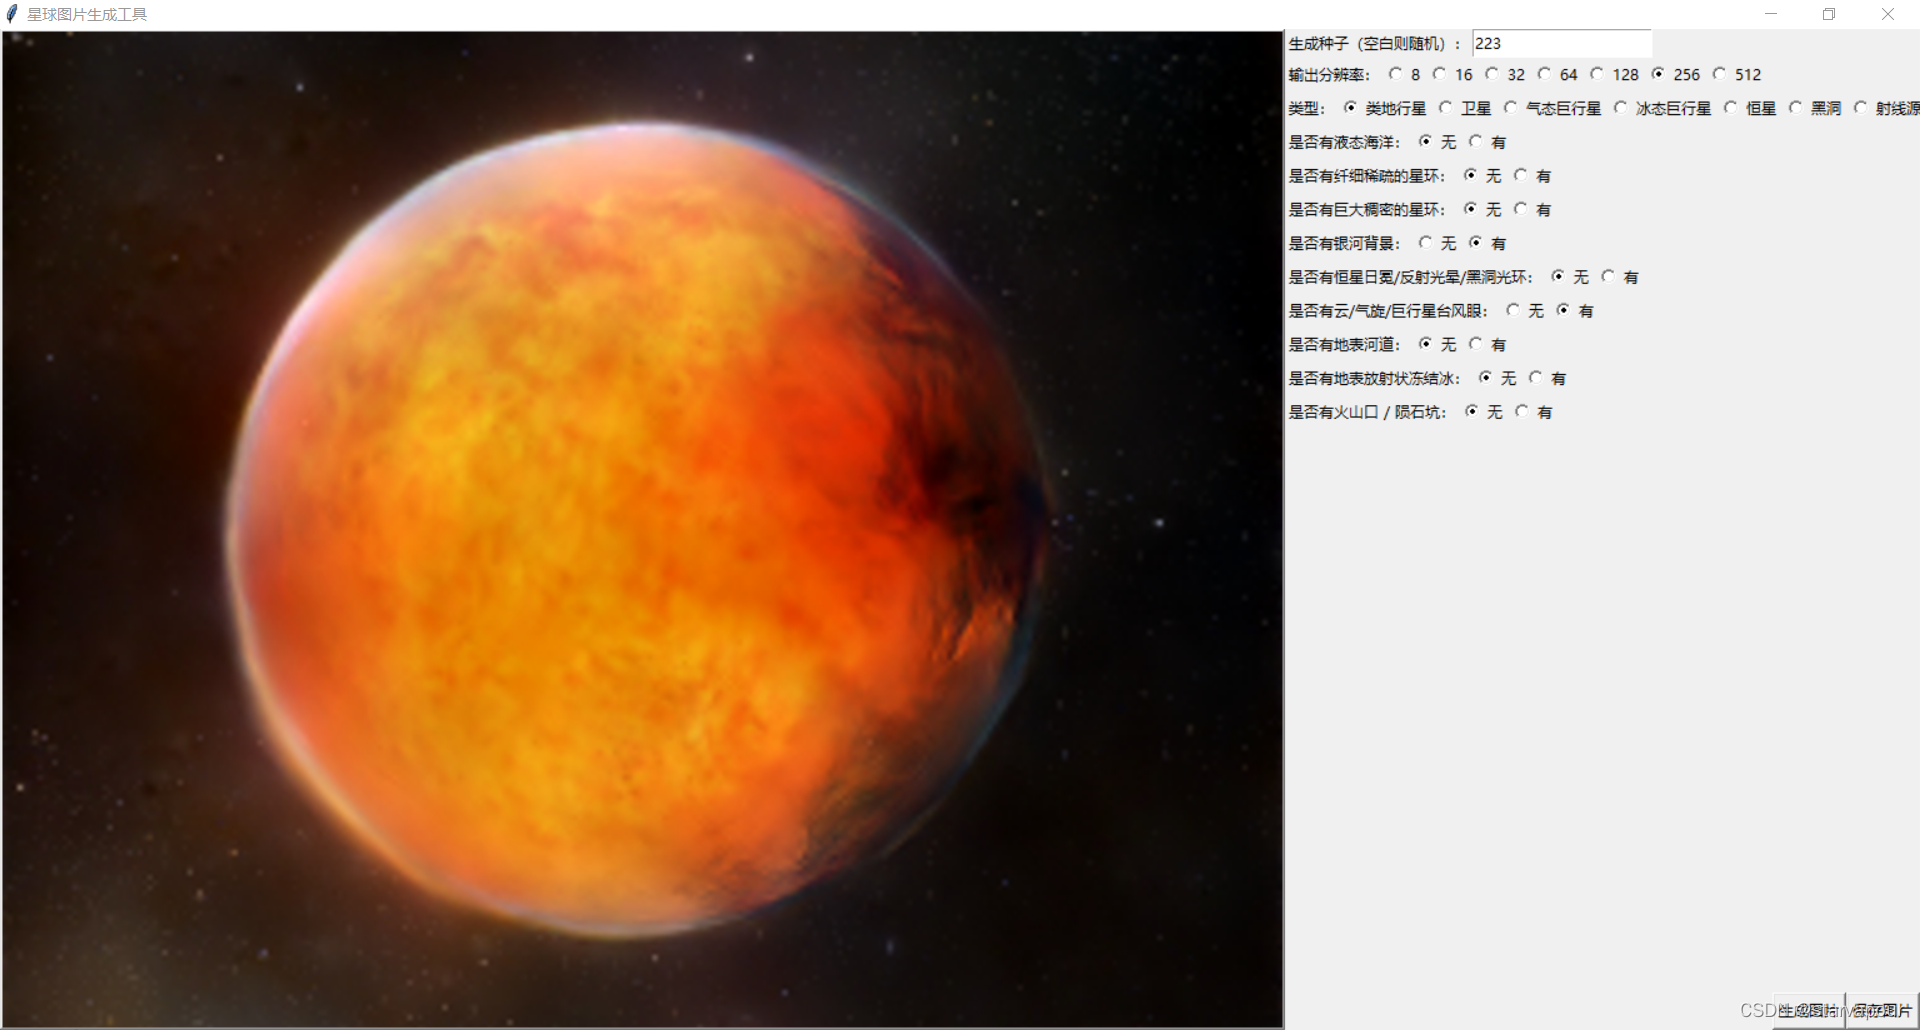
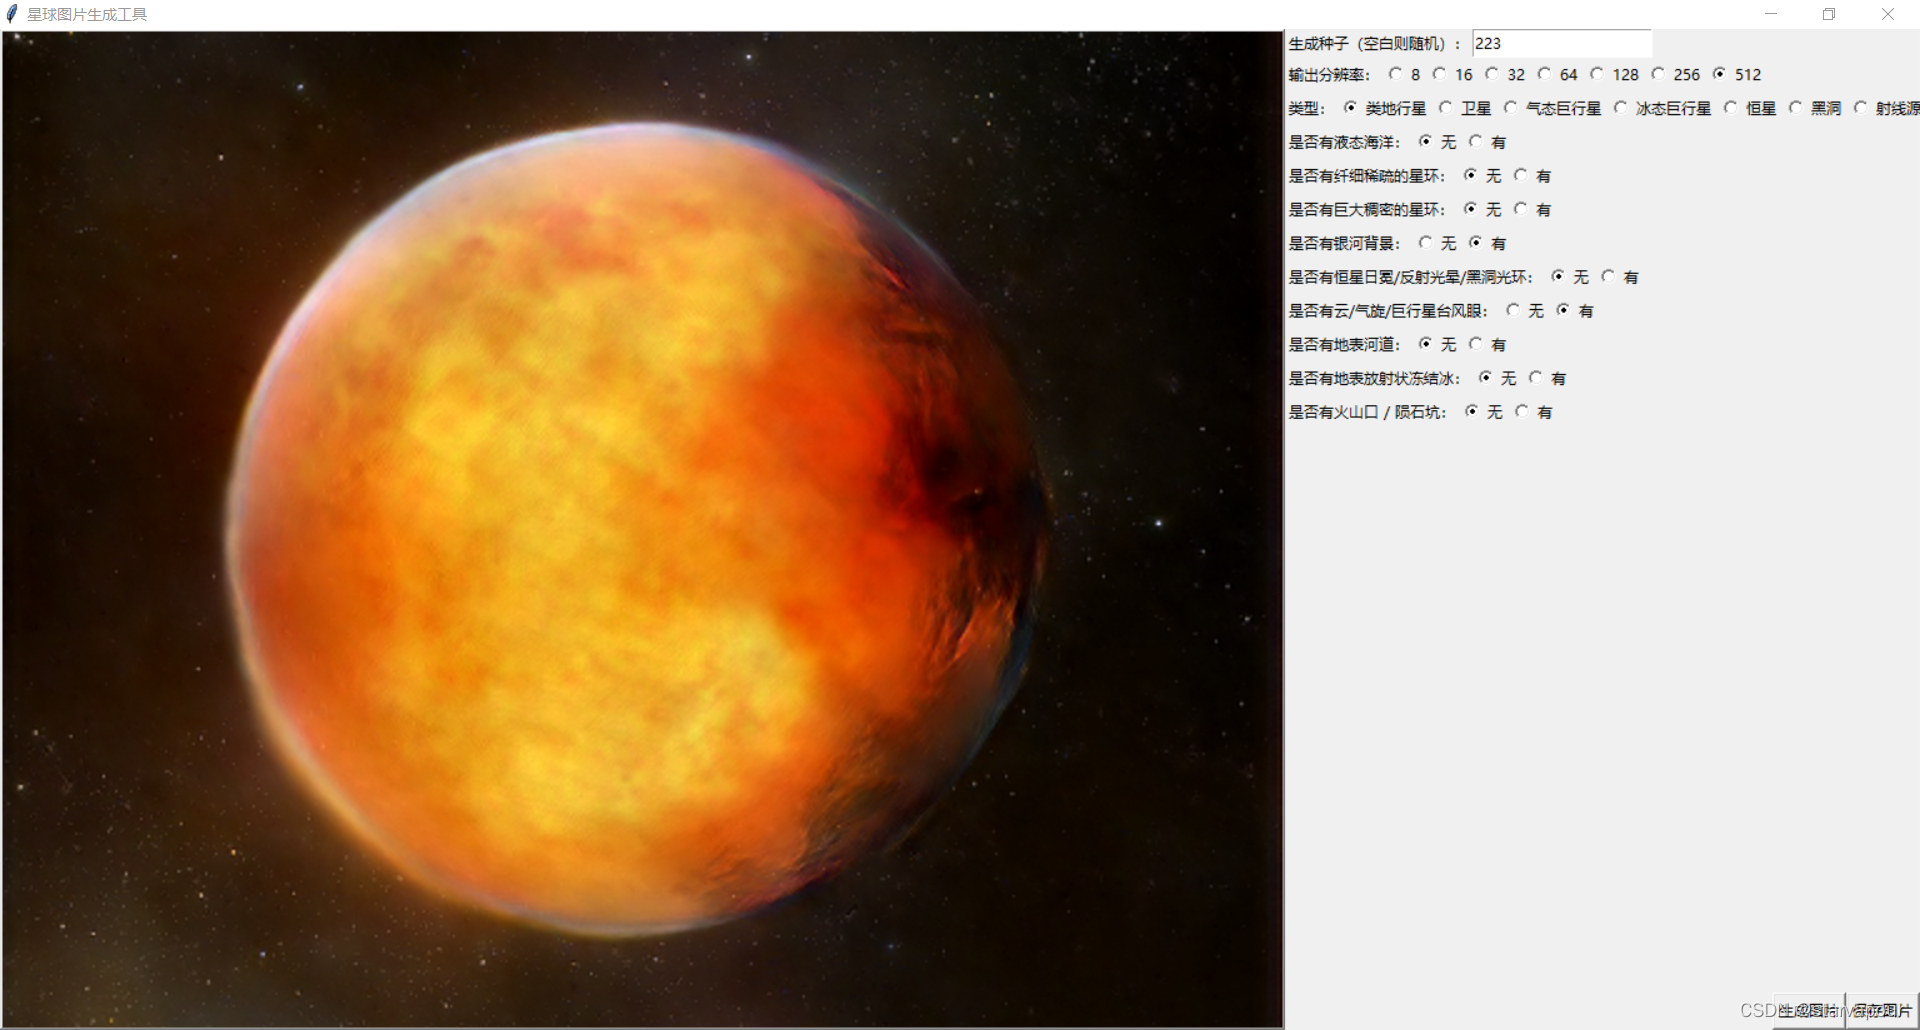
3.2 其它生成样式的展示
4. 缺陷与下一步改进
生成的多样化上虽然碾压了过去的版本,而且完全解决了生成图像中棋盘效应和网格状点的问题,但是生成质量的细节上却有些比不过上一次的版本,特别是并行训练导致的错误放大问题。
大部分条件生成成功了,但是有一些还是失败了,比如这个模型始终没有学会画出完整的星环,它充其量只能做到这个地步:
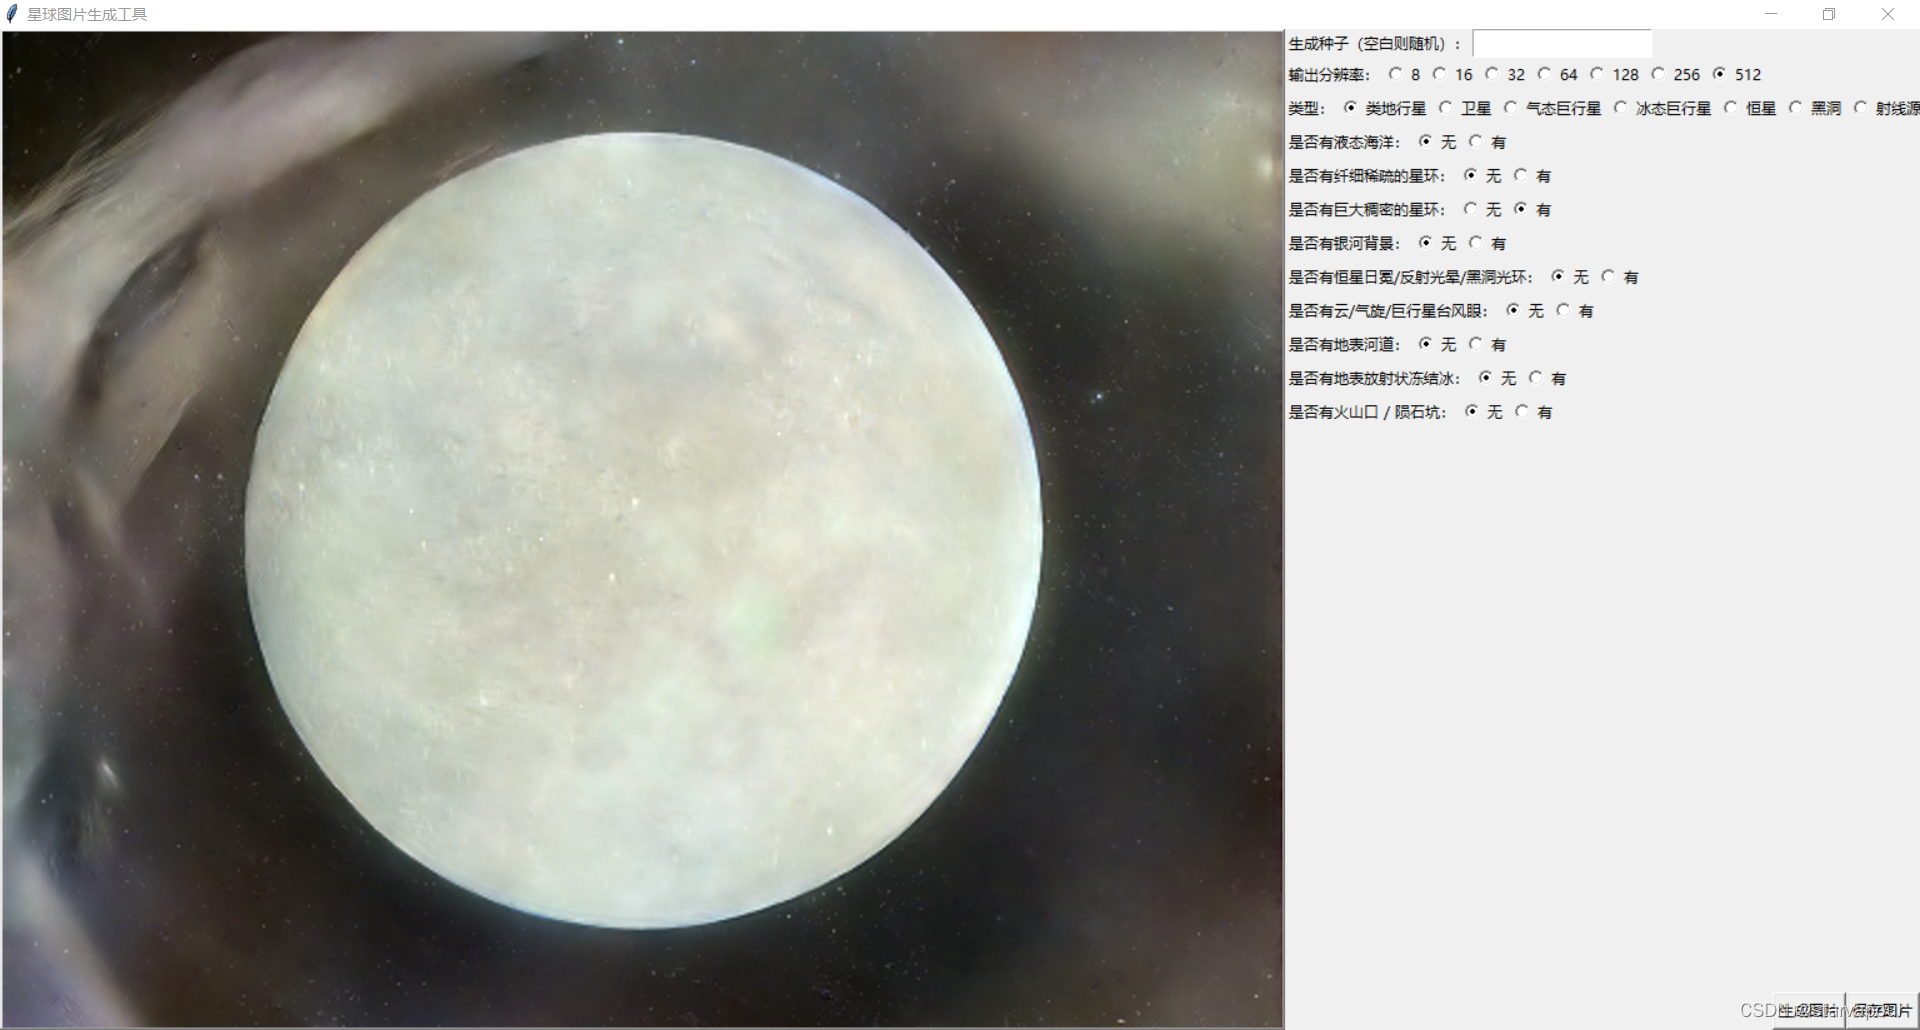
从表现上来看,疑似ai会混淆银河与星环的概念。
其次,对类星体这样非圆形,结构差异过大的物体,它还没法很好的生成。
有些遗憾,终于正式开始上班后,工作没能做ai方面的内容,不过仍然会将其作为业余的兴趣爱好继续研究下去,新版本的生成模型已经作为自己的聊天机器人的插件成功使用,用于丰富日常的群聊内容~
感谢默默支持的沙雕群友们提供试用评价~
虽然上班后空余时间不多,而且现在训练也越来越耗费时间,导致更新可能会很慢……不过还是会试着在下一个版本中使用更多的方式进行优化,敬请期待。
更多推荐

 2
 0
- 0


 已为社区贡献7条内容

所有评论(0)