
大语言模型原理通俗版:为什么 AI 突然会聊天了?
为什么 AI 突然会聊天了?拆解大语言模型背后的秘密
2023 年之前,"AI 会聊天"还只是科幻片里的桥段。但今天,一个网页、一次回车,它就能写出像样的文章、代码、方案。它不是魔法,是一套有章可循的原理。 这篇用最通俗的方式,把大语言模型从「会打字」到「会思考」的秘密讲清楚,全程无代码、配图直观,小白也能看懂。
先泼一盆冷水:AI 其实不会「思考」
先记住一个反直觉的事实:
AI 不是真的在理解你说了什么,它是在「猜下一个词」。
你看到的每一个回答,本质都是模型根据上文,一次次选择"下一个最可能的词",拼出来的。就像打字法预测,只不过它的预测范围大得惊人——几千亿次计算、几十层网络之后,看起来就像真的会思考一样。
下面我们用三张图,把这个过程彻底拆开。
一、神经网络:AI 的大脑长什么样
一切的起点,是一张图就能讲清的结构——神经网络。
你看这张图,像不像一张渔网?
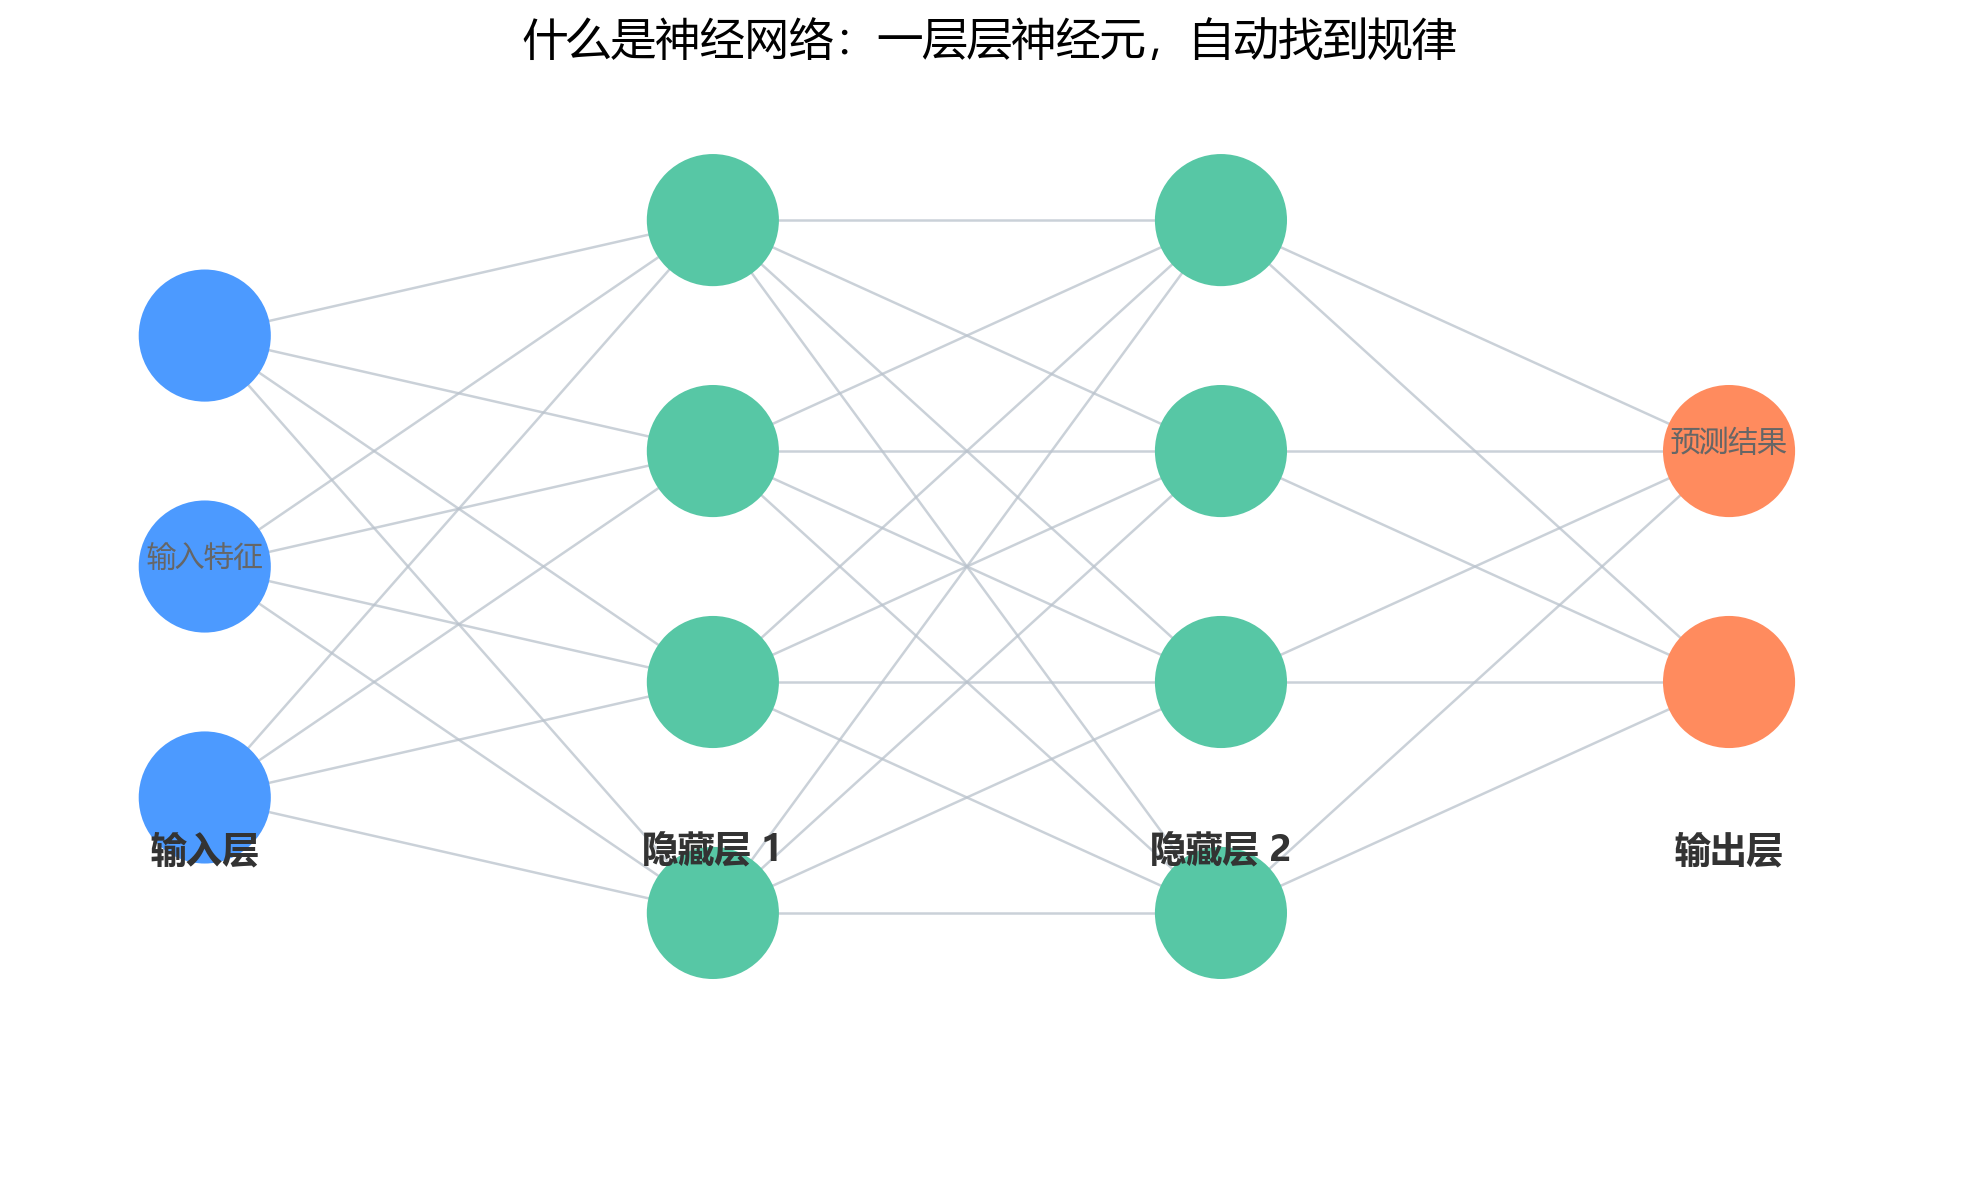
- 最左边是输入层:你问的问题(比如"什么是黑洞")会被拆解、数字化,从这里喂进去
- 中间是隐藏层:一层套一层的"加工车间",信息经过层层变换,规律被一点点提炼出来
- 最右边是输出层:把加工结果吐出来,就是 AI 的回答
关键在中间的每一根线。 每条线都带一个"权重"——相当于这个连接有多重要。训练的过程,就是不断调整这几千亿个权重的过程。权重调对了,输入"1+1"就能输出"2";调错了,就继续改,直到全对。
💡 一句话总结:神经网络 = 一张巨大的网,靠调整「权重」来学会输入到输出的映射。
二、大模型是怎么「读」你这句话的
普通神经网络处理不了长文字。于是有了大语言模型(LLM)的核心流程——把文字变成数字,再一步步加工。
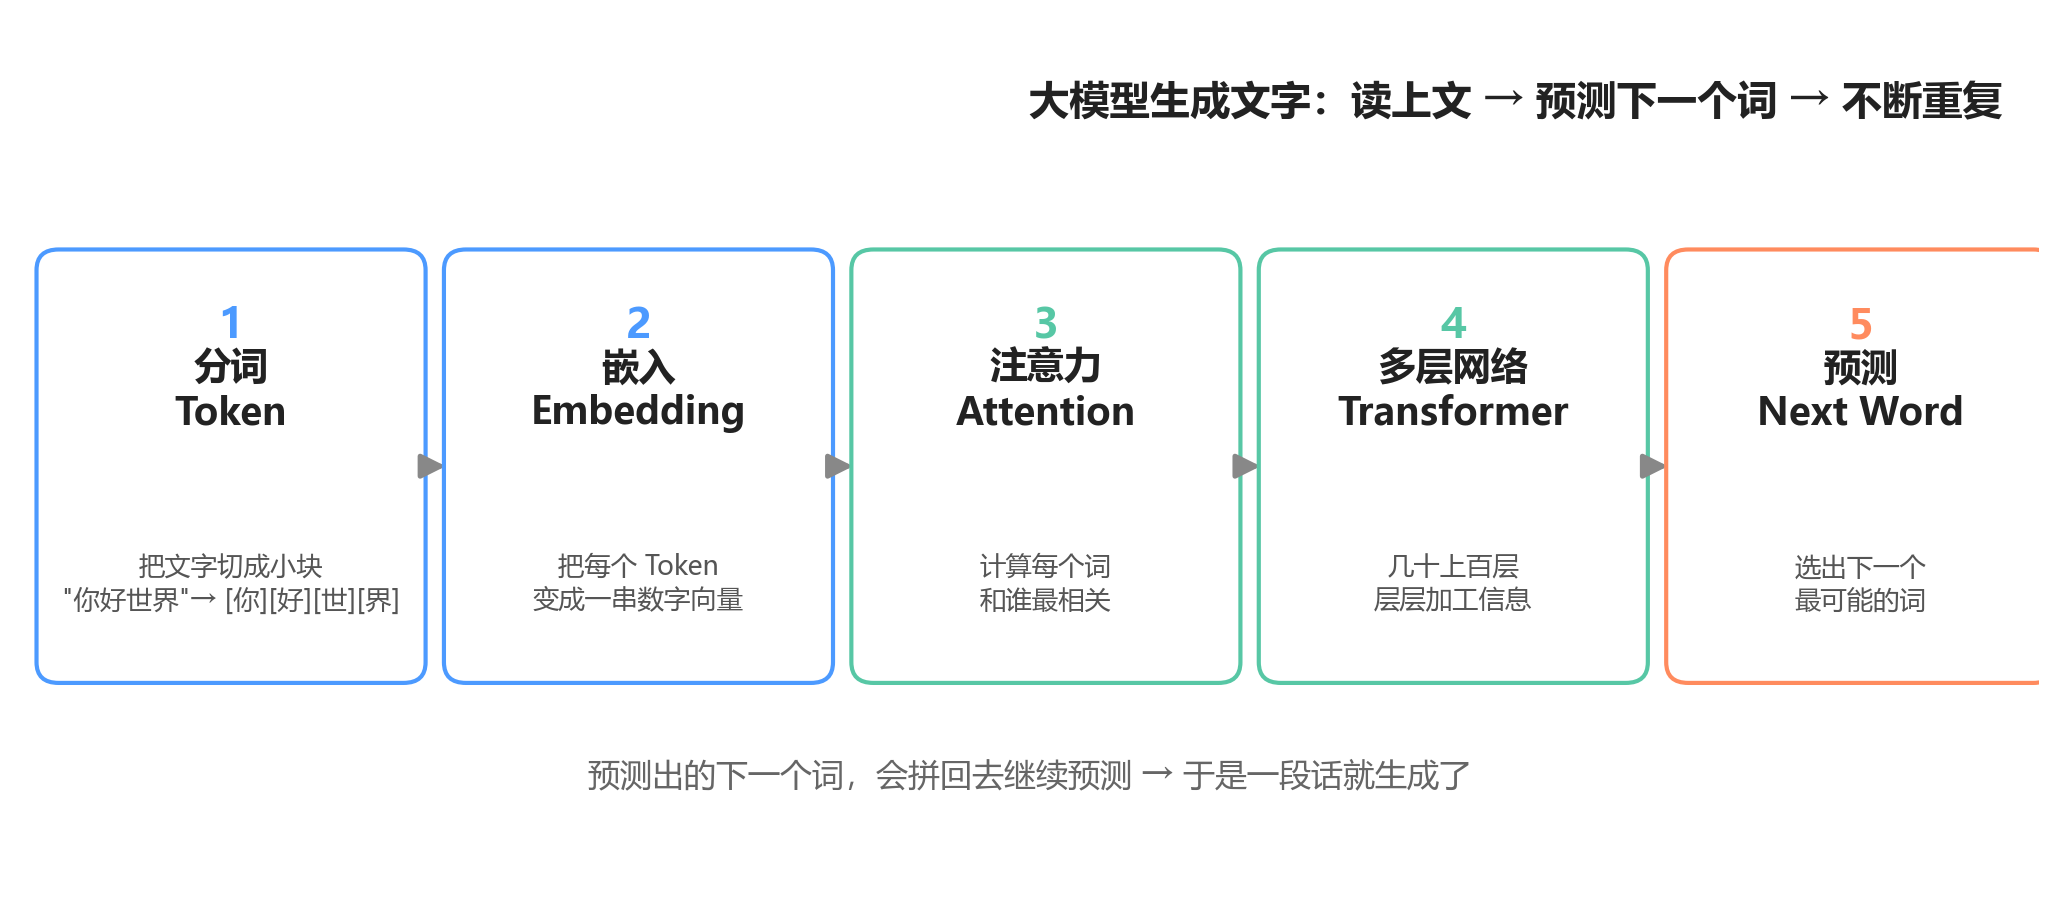
整个流程分五步,我们拆开看:
1️⃣ 分词(Token)——先把句子切碎
"你好世界"不会整句被理解,而是先被切成小块:[你][好][世][界]。这些小块就是 Token。中文一个字可能算一个,英文一个词可能算一个。
2️⃣ 嵌入(Embedding)——变成数字向量
计算机不懂文字,只懂数字。每个 Token 会被映射成一串数字(比如 4096 维的向量),这个词的含义、它和哪些词相近,都被编码在这串数字里。"猫"和"狗"的向量会很接近,"猫"和"汽车"则离得远。
3️⃣ 注意力(Attention)——找出谁和谁最相关
这是大模型最核心的发明。它让每个词动态地关注句子里最重要的其他词。
比如"他抱着猫走进了房间,然后它跳上了沙发"——“它"指的是谁?Attention 机制会通过计算,让"它"这个位置主动"看向"前面的"猫”,而不是"房间"。这一步让模型真正理解上下文和指代。
4️⃣ 多层 Transformer 网络——层层加工
有了注意力,信息进入几十上百层的 Transformer 层。每一层都对信息做一次加工提炼,前面提取的是"字面",越往后越是"语义"“逻辑”"意图"层面的理解。
5️⃣ 预测下一个词——一个字一个字地"写"
最后一层输出一个"词表概率分布"——每个候选词有多大概率是下一个。模型按概率挑一个,拼到句尾,然后拿着新句子重新走一遍流程,继续预测下一个。如此循环,一段通顺的话就这么"挤"出来了。
🔁 这就是为什么叫"大"语言模型:几十亿到几千亿的参数,几十层网络,海量的训练数据——把"猜词"这件事做到了极致,量变引起质变。
三、AI 是怎么被「训练」出来的
上面只是"推理"(用的时候),AI 之所以"聪明",靠的是前面几年烧掉天文数字电费去训练。训练分三个阶段,一步比一步"懂事"。
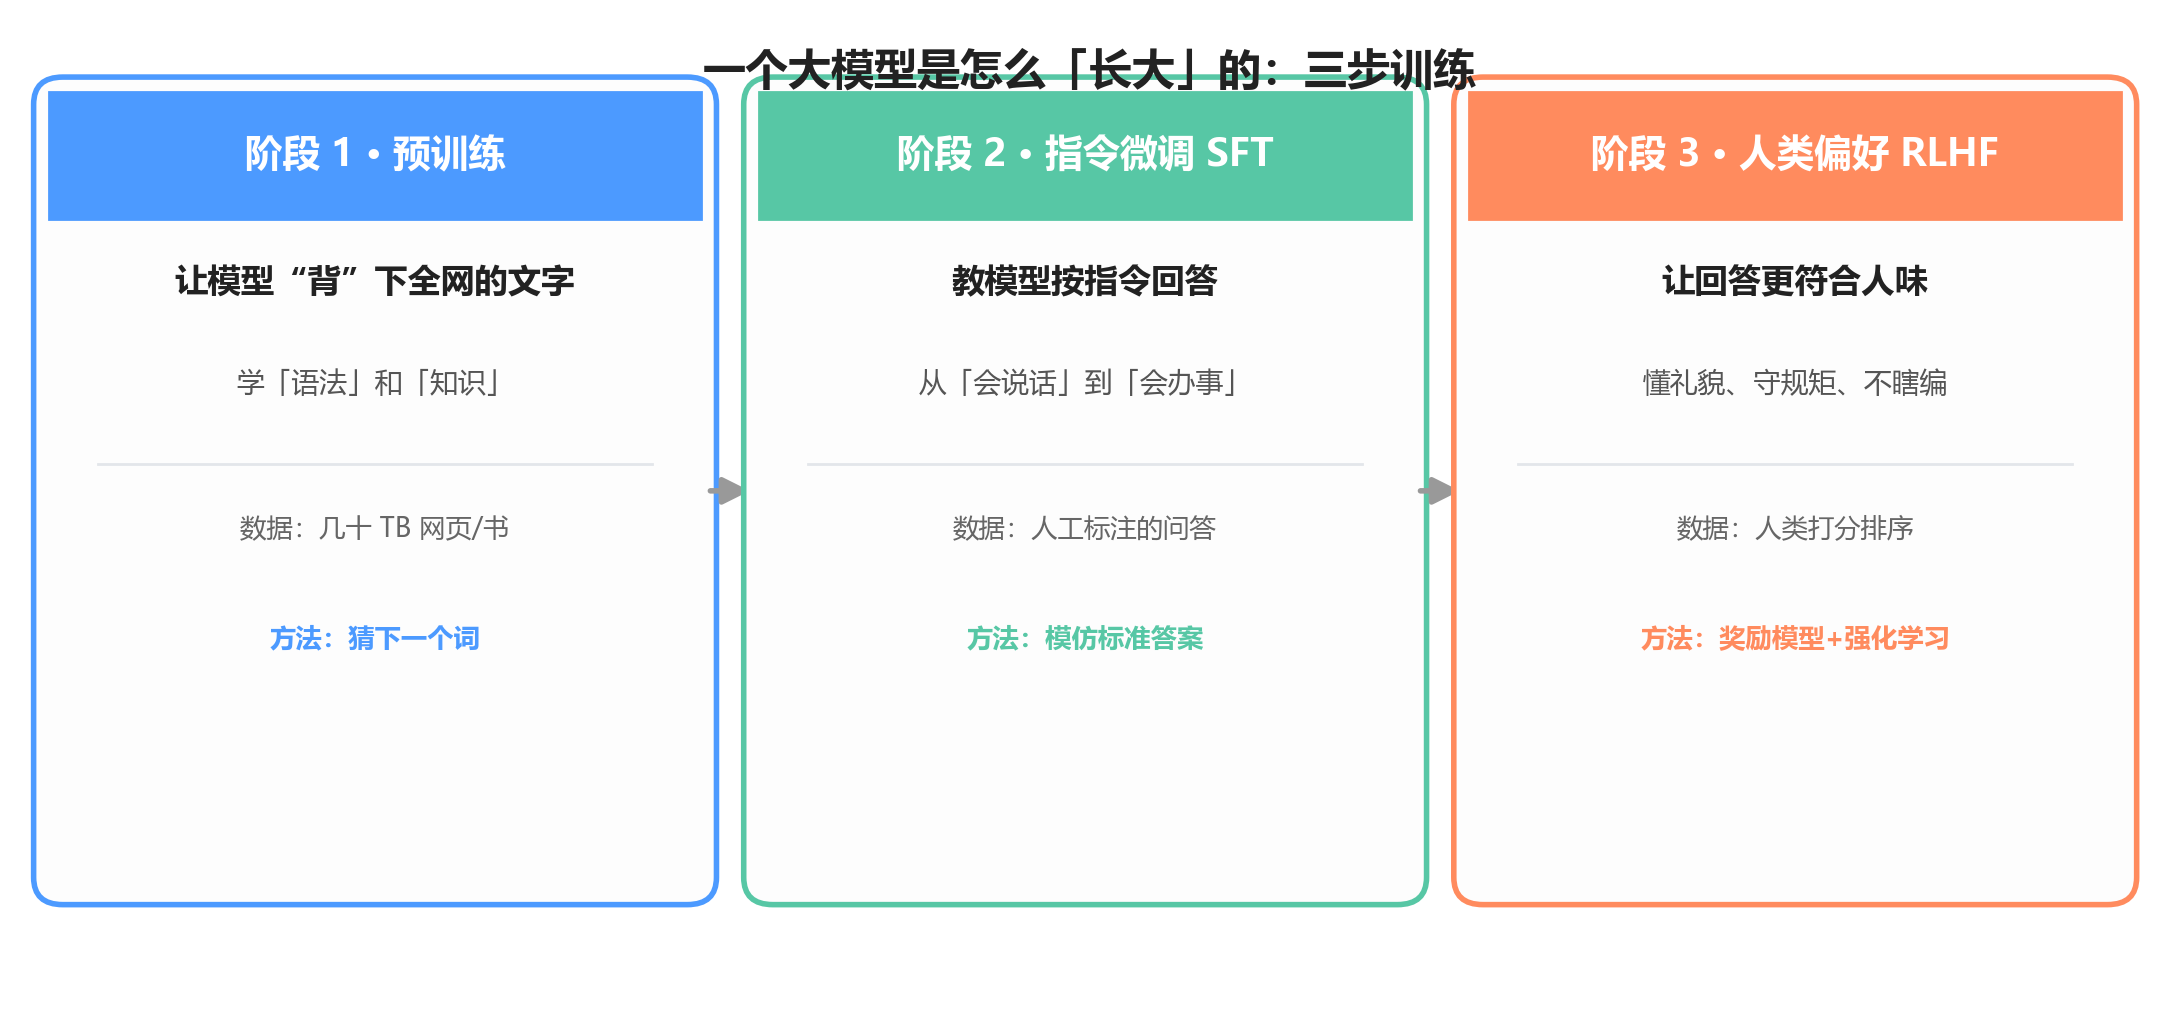
阶段 1:预训练——像海绵一样吸收全网文字
把几十 TB 的网页、书籍、论文喂给模型,任务是预测下一个词。这个阶段它"背"下了海量知识,学会了语法、逻辑、常识。你可以理解为:它读了人类几十年写下的所有公开文字。
但也因此有个毛病:它只会"续写",你问它"什么是黑洞",它可能接着写"是宇宙中最神秘的天体之一……"而不是直接回答你。
阶段 2:指令微调(SFT)——从「会说话」到「会办事」
人们拿着人工标注好的问答对(问一句、标准答案答一句)再喂给模型。它开始学会:哦,用户问"什么是黑洞",我应该直接给出答案,而不是接着造句。
这一步是"老师手把手教",让模型从"会续写"变成"会问答"。
阶段 3:人类偏好对齐(RLHF)——学懂「人味」
光会答还不够,有时答得专业但冷冰冰,有时一本正经地胡说八道。于是引入人类反馈强化学习:
- 让模型针对同一个问题生成多个答案
- 人类给这些答案打分排序
- 训练一个"奖励模型"学习人类偏好,再反向调整大模型
经过这一步,模型学会了说话像人——懂礼貌、有分寸、不知道就说不知道(至少表面上是)。ChatGPT 当年惊艳世界,靠的就是这个阶段的功劳。
四、所以,AI 到底是怎么「突然」变厉害的?
回顾整条链路,答案其实是三个变量同时爆发:
| 变量 | 变化 | 作用 |
|---|---|---|
| 算力 | GPU 大规模集群 | 让几十层、几千亿参数的训练成为可能 |
| 数据 | 全网文字 + 人工标注 | 喂饱了"知识"和"行为" |
| 算法 | Attention / Transformer / RLHF | 让模型真正理解上下文、对齐人类偏好 |
这三个没有一个是最新发明——但它们凑齐的那一刻,质变发生了。就像拼图最后一块落下:你突然发现,那个只会猜词的"打字法",居然能写诗、写代码、陪你聊天了。
五、认识它的边界:AI 的「幻觉」
理解了原理,就能理解它的最大缺陷——幻觉。
因为它本质是"猜下一个最可能的词",而不是"查证事实",所以当它不知道答案时,不会说"不知道",而是流畅地编一个看起来合理的答案。这就是为什么重要的事情,永远要自己核实。
这不是"AI 有自我意识",而是概率生成的必然副作用。
小结
回顾全文的思维链:
一句话 → 切 Token → 变成向量 → 注意力找重点 → 层层加工 → 预测下一个词 → 循环 → 一段话
                                                    ↑
                              训练:预训练学知识 → SFT学答题 → RLHF学人味
大语言模型不神秘,也不遥远。它是一台巨大的"猜词机器",靠算力、数据、算法三股力量,把猜词这件事做到了以假乱真。
下次再看到 AI 聊天,不妨想想:此刻屏幕那头,其实是一个个字在"挤"出来,而不是一个人在"想"。
觉得这篇讲清楚了大模型的原理?欢迎 点赞 + 收藏,下一篇准备讲 AI Agent 智能体(AI 是怎么从"聊天"变成"干活"的),感兴趣评论区告诉我 👇
更多推荐


 7
 0
- 0


 已为社区贡献1条内容

所有评论(0)