
map apply agg transformer 的用法及区别
文章目录
在Python做数据处理中会经常用到map 、apply、 agg、 transformer ,今天总结一下集中函数的用法。
map
map映射规则
map 只能用于 Series(单列),作用是对列中的「每个元素」做 “一对一” 映射(比如替换值、简单计算),逻辑简单、性能快。
# Series.map(映射规则):规则可以是字典、函数、Series
df['列名'].map(映射规则)
首先生成示例数据
import pandas as pd
import numpy as np

year = 2024  # 固定年份2024
start_date = f"{year}-01-01"
end_date = f"{year}-12-31"
total_users_min = 1000
total_users_max = 5000
overproduction_ratio_max = 0.8  # 调高上限(确保超产率可能>0.6)
overproduction_flag_type = "str"  # 保持输出1/0
output_type = "excel"


regions = ["北京", "上海", "广州", "深圳", "杭州", "成都", "武汉", "西安", "南京", "重庆"]
date_column = pd.date_range(start=start_date, end=end_date, freq="D")
index = pd.MultiIndex.from_product(
    [regions, date_column],
    names=["地区", "日期"]
)
base_df = pd.DataFrame(index=index).reset_index()

np.random.seed(42)
total_users_column = np.random.randint(
    low=total_users_min,
    high=total_users_max + 1,
    size=len(base_df)
).astype(int)

overproduction_ratios = np.random.uniform(0, overproduction_ratio_max, size=len(base_df))
overproduction_users_column = np.round(total_users_column * overproduction_ratios).astype(int)
overproduction_users_column = np.minimum(overproduction_users_column, total_users_column)  # 不超过总用户数
overproduction_users_column = np.maximum(overproduction_users_column, 0)  # 避免负数

total_users_column = pd.to_numeric(total_users_column, errors="coerce")
overproduction_users_column = pd.to_numeric(overproduction_users_column, errors="coerce")
total_users_column = np.where(total_users_column == 0, 1, total_users_column)  # 避免除以0

overproduction_rate_column = np.round(
    overproduction_users_column / total_users_column,
    decimals=4
)

if overproduction_flag_type == "bool":
    is_overproduction_column = overproduction_rate_column > 0.6  # 基于超产率判断
elif overproduction_flag_type == "str":
    is_overproduction_column = np.where(
        overproduction_rate_column > 0.6,  # 超产率>0.6 → 1(超产)
        1,
        0  # 否则→0(未超产)
    )
result_df = base_df.assign(
    总用户数=total_users_column.astype(int),
    超产用户数=overproduction_users_column.astype(int),
    超产率=overproduction_rate_column,
    是否超产=is_overproduction_column
)
result_df = result_df[["日期", "地区", "总用户数", "超产用户数", "超产率", "是否超产"]]
result_df

# 字典映射:1→超产,0→未超产
result_df['是否超产_文本'] = result_df['是否超产'].map({1: '超产', 0: '未超产'})
result_df
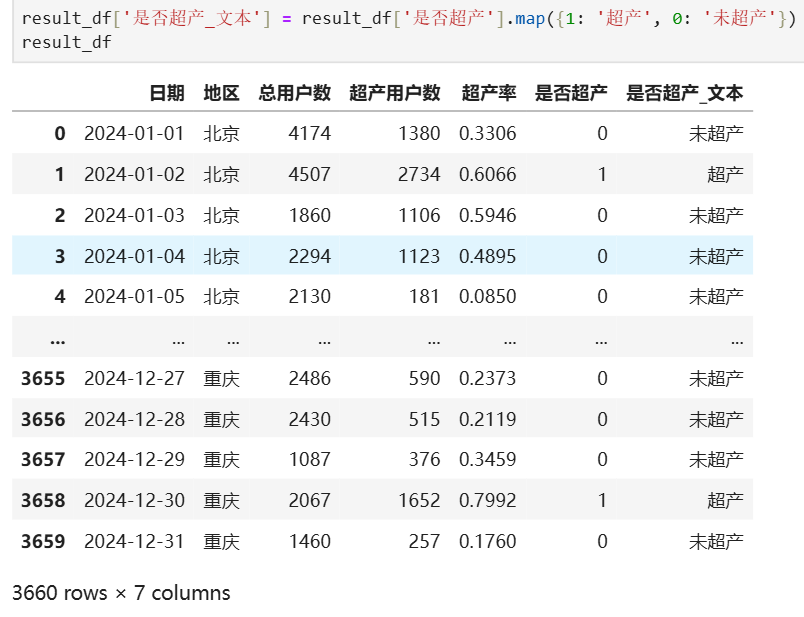
map简单计算
# 函数映射:每个元素×100 + 加百分号
result_df['超产率_百分比'] = result_df['超产率'].map(lambda x: f"{x*100:.1f}%")
result_df

map的关键特点
1.仅支持 Series(不能直接用在 DataFrame 上);
2.映射规则简单(字典、无复杂逻辑的函数);
3.性能最优(比Series.apply 快,因为无额外函数调用开销)。
apply
Series.apply(元素级复杂映射)
# 对「超产率」列分类:高/中/低超产(多条件判断)
def classify_overproduction(rate):
    if rate > 0.7:
        return '高超产'
    elif rate > 0.4:
        return '中超产'
    else:
        return '低超产'

# 用 apply 调用自定义复杂函数
result_df['超产等级'] = result_df['超产率'].apply(classify_overproduction)

result_df

DataFrame.apply(行 / 列级处理)
案例1
# 按行处理(axis=1):计算「超产用户数占总用户数的差值(千分位)」
result_df['超产用户数千分差'] = result_df.apply(
    lambda row: (row['超产用户数'] / row['总用户数']) * 1000,  # row 代表一行数据
    axis=1
)
result_df

分组后.apply(分组级复杂逻辑)
案例2:apply 后面跟自定义的函数
import pandas as pd
import numpy as np

#生成假数据
names = ["设备A", "设备B", "设备C", "传感器1", "传感器2"]
total_rows = 2000
value_min = 3.0
value_max = 135.0
value_decimals = 2
name_column = [names[i % len(names)] for i in range(total_rows)]
np.random.seed(42)
value_column = np.round(
    np.random.uniform(value_min, value_max, size=total_rows),
    decimals=value_decimals)
result_df = pd.DataFrame({
    "名称": name_column,
    "值": value_column
})
def jisuan_zscore(group):
    # 1. 取出当前分组的「值」列(核心计算对象)
    x = group["值"]

    # 2. 生成「非缺失值掩码」(处理缺失值的关键步骤)
    mask = ~x.isna()  # x.isna():判断每个位置是否是缺失值(NaN),返回布尔数组;~取反→True=非缺失值,False=缺失值

    # 3. 初始化Z-score数组:长度和当前分组一致,默认填充NaN(缺失值)
    z_scores = np.full(len(x), np.nan)  # 为什么先填NaN?→ 只对非缺失值计算,缺失值位置保持NaN,不污染结果

    # 4. 确保非缺失值数量≥2(避免计算标准差时出错)
    if mask.sum() >= 2:  # mask.sum():统计非缺失值的个数(True=1,False=0)
        # 4.1 计算该组非缺失值的「均值」
        mean = x[mask].mean()
        # 4.2 计算该组非缺失值的「总体标准差」(ddof=0是关键参数)
        std = x[mask].std(ddof=0)  # ddof=0:总体标准差(分母为n);ddof=1:样本标准差(分母为n-1)
        # 4.3 计算Z-score,并赋值到对应非缺失值位置
        z_scores[mask] = (x[mask] - mean) / std  # 核心公式:(原始值-均值)/标准差

    # 5. 用计算好的Z-score替换当前分组的「值」列
    group["值"] = z_scores

    # 6. 返回处理后的分组DataFrame
    return group

#group_keys=False:可选参数,作用是「不将分组键(名称)添加到结果的索引中」,保持原始数据的索引结构(如果设为 True,结果索引会多一层 “名称” 分组键,通常不需要)
RESULT = result_df.groupby("名称", group_keys=False).apply(jisuan_zscore) # 按「名称」分组,对每组的「值」列进行 Z-score(标准化)计算,并替换原列值
RESULT
以上代码的核心解释
- 缺失值处理逻辑
代码用 mask = ~x.isna() 筛选非缺失值,仅对非缺失值计算 Z-score;缺失值位置保持 np.nan,避免缺失值影响均值 / 标准差计算,也避免结果中出现无效值。- 为什么要判断 mask.sum() >= 2?
若某分组的非缺失值≤1:计算总体标准差时,分母为 n(1 或 0),会导致标准差 = 0(n=1 时,所有值等于均值,标准差为 0),此时除以 0 会报错;
该判断是「防错机制」,确保只有足够数据量时才计算 Z-score,否则该分组的「值」列全部保留为 NaN。- 总体标准差(ddof=0)的意义
x[mask].std(ddof=0) 中 ddof=0 表示「自由度为 0」,对应总体标准差(分母是 n,n 为非缺失值个数);
若改为 ddof=1,则是样本标准差(分母是 n-1),适用于 “用样本推断总体” 的场景;
代码注释提到 “与 zscore 一致”,是指 numpy.nanmean/numpy.nanstd(默认 ddof=0)和 scipy.stats.zscore(默认 ddof=0)的默认行为,保证计算逻辑统一。- 分组逻辑的核心
groupby(“名称”) 确保「同一名称的所有数据在同一组内计算 Z-score」,避免不同名称的数据混合计算(比如 “设备 A” 和 “设备 B” 的原始值量级可能不同,分开标准化才合理)。这里是引用

groupby 中 group_keys=True 的 用处。
RESULT = result_df.groupby("名称", group_keys=True).apply(jisuan_zscore) # 按「名称」分组,对每组的「值」列进行 Z-score(标准化)计算,并替换原列值
RESULT

apply 的关键特点
1.万能灵活,能覆盖 map、agg、transform 的部分场景;
2.性能:Series.apply ≈map(简单逻辑),DataFrame.apply/ 分组.apply 较慢(大数据量谨慎用);
3.函数参数:Series.apply是「单个元素」,DataFrame.apply 是「一行 / 一列」,分组.apply 是「子 DataFrame」。
agg
agg 是「聚合(Aggregation)」的简写,专门用于统计汇总(多行→1 个 scalar 值),支持多列、多函数同时计算,性能最优(pandas 内部优化,无 Python 循环)。
单列单函数
A0 = result_df['超产用户数'].agg('sum')
A0

多列多函数(字典指定)
## 方法一
A1 = result_df.groupby('地区').agg({
    '总用户数': ['sum', 'mean'],
    '是否超产': 'count'
})
A1

## 方法二
A2 = result_df.groupby('地区').agg(
    全年总用户数=('总用户数', 'sum'),  # 总用户数求和
    全年超产用户数均值=('超产用户数', 'mean'),  # 超产用户数均值
    超产天数=('是否超产', 'sum'),  # 超产天数(1的个数)
    最高超产率=('超产率', 'max')  # 最高超产率
).reset_index()
A2

agg的关键特点
1.仅支持「聚合逻辑」(输入多行,输出 1 个统计值); 不支持变形、过滤,但若需汇总,优先用 agg(比 apply 简洁 10 倍);
2.支持重命名结果列(如 全年总用户数=(‘总用户数’, ‘sum’))。
transform
transform 专门用于生成新列,核心约束:输出长度必须和输入长度一致(即保持原数据行数),常用于给明细数据添加「分组级统计指标」(如分组均值、标准化值)。
# 分组后对列做变形,返回同长度 Series,用于新增列
df['新列'] = df.groupby('分组列')['列名'].transform(函数)
案例1
# 按地区分组,计算每个地区的总用户数均值,广播到该地区的所有行
result_df['地区总用户数均值'] = result_df.groupby('地区')['总用户数'].transform('mean')
result_df

transform的关键特点
1.输出长度 ≡ 输入长度(核心约束,违反则报错); 用于「给原数据加新列」,且新列是分组级统计结果;
2.性能优于分组.apply(向量化操作),比手动计算后合并更简洁。
总结
整体性能排序为:map ≈ agg ≈ transform > apply(分组/行级),其中前三者属于「高性能梯队」(向量化、无 Python 循环、内部优化),而 apply 因场景不同性能波动极大,尤其是行级 / 分组级 apply 属于「低性能梯队」。

# 反例慢:逐行计算超产用户数占比(慢)
df['超产占比'] = df.apply(lambda row: row['超产用户数'] / row['总用户数'], axis=1)

# 正例快-向量化运算(毫秒级)
df['超产占比'] = df['超产用户数'] / df['总用户数']
# 反例慢:分组计算总用户数求和(可用 agg)
df.groupby('地区').apply(lambda x: x['总用户数'].sum())
# 正例快-
df.groupby('地区')['总用户数'].agg('sum')
更多推荐


 22
 0
- 0


 已为社区贡献2条内容

所有评论(0)