
从0到1——手搓【Transformer】底层代码_手搓transformer

- Transformer 作为 NLP 领域的革命性架构,重塑了序列建模范式。从机器翻译到文本生成,其身影遍布核心任务,拆解其架构是掌握深度学习的关键一步 📌点赞关注小编哦~
一、认识Transformer架构
📌1.1 Transformer 模型的作用
- 基于seq2seq架构的Transformer模型可以完成NLP领域研究的典型任务,如机器翻译、文本生成等。同时又可以构建预训练语言模型,用于不同任务的迁移学习
- 在接下来的架构分析中,我们将假设使用Transformer模型架构处理从一种语言文本到另一种语言文本的翻译工作,因此很多命名方式遵循NLP中的规则。比如:Embedding层将称作文本嵌入层,Embedding层产生的张量称为词嵌入张量,它的最后一维将称作词向量等
1.2 Transformer 总体架构图

二、位置编码器
- 源文本嵌入层及其位置编码器
- 目标文本嵌入层及其位置编码器


- 使用不同频率的正弦和余弦函数进行位置编码,其中
pos代表位置、i代表维度,每个位置编码维度对应一条正弦曲线,且波长从2π到10000·2π呈等比数列分布;选择这类函数是因假设其能让模型轻松学习相对位置(对任意固定偏移k,位置pos+k的位置编码可表示为pos处编码的线性函数)
class PositionalEncoding(nn.Module):
    def __init__(self, d_model, dropout: float=0.1, max_len=1000):
        super().__init__()
        self.dropout = nn.Dropout(p=dropout)

        position = torch.arange(max_len).unsqueeze(1)  # (length, 1)
        div_term = torch.exp(torch.arange(0, d_model, 2) * (-math.log(10000.0) / d_model))
        pe = torch.zeros(max_len, 1, d_model)          # (length, 1, d_model)
        pe[:, 0, 0::2] = torch.sin(position * div_term)
        pe[:, 0, 1::2] = torch.cos(position * div_term)
        self.register_buffer('pe', pe)

    def forward(self, x: Tensor, max_len=1000) -> Tensor:
        """
        Arguments:
            x: Tensor, shape ``[seq_len, batch_size, embedding_dim]``
        """
        x = x[:max_len, :, :] + self.pe[:x.size(0), :]
        return self.dropout(x)
-
position = torch.arange(max_len).unsqueeze(1) # (length, 1)
生成位置索引张量:torch.arange(max_len)创建0到max_len-1的序列,unsqueeze(1)在维度1扩展,最终形状(max_len, 1),代表每个位置的索引 -
div_term = torch.exp(torch.arange(0, d_model, 2) * (-math.log(10000.0) / d_model))
计算频率缩放因子:torch.arange(0, d_model, 2)取偶数维度索引;-math.log(10000.0) / d_model是公式里的对数缩放;通过exp得到各维度的频率分母项,用于生成不同频率的正、余弦曲线 -
pe = torch.zeros(max_len, 1, d_model) # (length, 1, d_model)
初始化位置编码张量pe,形状为(max_len, 1, d_model),1是为了后续与batch维度广播兼容 -
pe[:, 0, 0::2] = torch.sin(position * div_term)
对pe的偶数维度(从0开始,步长2)赋值:用正弦函数计算位置编码,position * div_term等价于公式里的pos / 10000^(2i/d_model) -
pe[:, 0, 1::2] = torch.cos(position * div_term)
对pe的奇数维度(从1开始,步长2)赋值:用余弦函数计算位置编码。 -
self.register_buffer('pe', pe)
将pe注册为模块的缓冲区:pe会随模块迁移(如到GPU),但不作为需要优化的参数 -
x = x[:max_len, :, :] + self.pe[:x.size(0), :]
输入x与位置编码相加:x[:max_len, :, :]截取前max_len个序列;self.pe[:x.size(0), :]截取与输入序列长度(x.size(0))匹配的位置编码,通过广播(batch维度)实现逐元素相加
三、多头注意力机制

- 多头注意力机制,摒弃了键、值、查询均为 d model d_{\text{model}} dmodel维的单一线性注意力模式,而是通过 h h h组不同的可学习线性投影,将查询( Q Q Q)、键( K K K)、值( V V V)分别投影至 d k d_k dk、 d k d_k dk、 d v d_v dv维度,对每次投影后的 Q Q Q、 K K K、 V V V并行执行注意力函数得到 h h h个 d v d_v dv维输出(即“注意力头”),再将这些输出拼接后通过线性投影得到最终结果,其数学表达为
head i = Attention ( Q W i Q , K W i K , V W i V ) \text{head}_i = \text{Attention}(QW_i^Q, KW_i^K, VW_i^V) headi=Attention(QWiQ,KWiK,VWiV) - ( W i Q , W i K , W i V W_i^Q, W_i^K, W_i^V WiQ,WiK,WiV为第 i i i次投影的参数矩阵)与
MultiHead ( Q , K , V ) = Concat ( head 1 , … , head h ) W O \text{MultiHead}(Q, K, V) = \text{Concat}(\text{head}_1, \dots, \text{head}_h) W^O MultiHead(Q,K,V)=Concat(head1,…,headh)WO - ( W O W^O WO为拼接后投影的参数矩阵);该机制能让模型在不同位置联合关注不同表示子空间的信息,弥补了单头注意力因信息平均化而无法实现这一能力的缺陷
import torch
import torch.nn as nn

class MultiHeadSelfAttention(nn.Module):
    def __init__(self, d_model, num_heads):
        super(MultiHeadSelfAttention, self).__init__()
        self.num_heads = num_heads
        self.d_model = d_model
        self.d_k = d_model // self.num_heads

        self.query_linear = nn.Linear(d_model, d_model)
        self.key_linear = nn.Linear(d_model, d_model)
        self.value_linear = nn.Linear(d_model, d_model)

        self.softmax = nn.Softmax(dim=-1)

    def split_heads(self, x, batch_size):
        x = x.reshape(batch_size, -1, self.num_heads, self.d_k)  # 将 d_model 维度拆分为 (num_heads, d_k)(因为 d_model = num_heads * d_k)
        return x.permute(0, 2, 1, 3)

    def forward(self, x, mask=None):
        batch_size = x.shape[0]

        query = self.query_linear(x)
        key = self.key_linear(x)
        value = self.value_linear(x)

        query = self.split_heads(query, batch_size)
        key = self.split_heads(key, batch_size)
        value = self.split_heads(value, batch_size)

        scaled_attention = torch.matmul(query, key.transpose(-2, -1)) / torch.sqrt(torch.tensor(self.d_k, dtype=torch.float32))

        if mask is not None:
            scaled_attention += (mask * -1e9)

        attention_weights = self.softmax(scaled_attention)

        output = torch.matmul(attention_weights, value)
        output = output.permute(0, 2, 1, 3).contiguous()  # (batch_size, seq_len, num_heads, d_k) contiguous确保张量在内存中连续存储
        output = output.reshape(batch_size, -1, self.d_model)

        return output
📌核心代码解释
- 多头自注意力(Multi-Head Self-Attention)是 Transformer 架构的核心模块,其作用是让模型在不同“子特征空间”中捕捉序列内部的关联信息。以下是核心步骤的解释
3.1 初始化与线性变换
- 维度定义:
d_model是输入特征的总维度(如 Transformer 中常用 512/768),num_heads是“注意力头”的数量(需满足d_model % num_heads == 0),每个头的维度为d_k = d_model // num_heads - 线性层:
query_linear、key_linear、value_linear三个线性层,将输入特征(维度d_model)分别映射为 Query(查询)、Key(键)、Value(值)(维度仍为d_model,后续拆分多头)
3.2 拆分多头
- 作用:将单头的“宽维度”(
d_model)拆分为“多头上的窄维度”(num_heads, d_k),让每个头独立计算注意力,捕捉不同子空间的特征 - 步骤:
x.reshape(batch_size, -1, self.num_heads, self.d_k):将输入形状从(batch_size, seq_len, d_model)调整为(batch_size, seq_len, num_heads, d_k)(-1自动推断为seq_len)x.permute(0, 2, 1, 3):调整维度顺序为(batch_size, num_heads, seq_len, d_k),让“头”的维度位于第二维,方便每个头独立计算注意力
3.3 缩放点积注意力(前向传播核心)
-
注意力的本质是“Query 与 Key 计算相似度,再用相似度加权聚合 Value”
-
计算注意力得分:
torch.matmul(query, key.transpose(-2, -1))计算 Query 和 Key 的点积,得到形状为(batch_size, num_heads, seq_len, seq_len)的“注意力得分矩阵”(每个位置的 Query 与所有位置的 Key 做内积) -
缩放(Scaled):
除以torch.sqrt(torch.tensor(self.d_k)),防止d_k过大时,点积结果过大导致 Softmax 后梯度消失(Softmax 在极端大值处梯度接近 0) -
掩码(Mask)处理(可选):
若传入mask(如自回归任务的“未来掩码”),则给需要屏蔽的位置的注意力得分加 -1e9(Softmax 后这些位置的权重会趋近于 0,实现“不可见”效果) -
注意力权重归一化:
self.softmax(scaled_attention)对得分做 Softmax,得到归一化的注意力权重(反映每个位置对当前位置的“重要性”) -
加权聚合 Value:
torch.matmul(attention_weights, value)用注意力权重对 Value 加权求和,得到每个头的输出(形状(batch_size, num_heads, seq_len, d_k))
3.4 合并多头与还原维度
output.permute(0, 2, 1, 3):将维度从(batch_size, num_heads, seq_len, d_k)调整为(batch_size, seq_len, num_heads, d_k),把“头”的维度放回序列维度之后contiguous():确保张量在内存中连续(因permute会改变内存布局,后续reshape需要连续张量)output.reshape(..., self.d_model):将num_heads × d_k重新合并为d_model(因d_model = num_heads × d_k),最终输出形状为(batch_size, seq_len, d_model),与输入维度一致
四、Transformer编码器层

import torch
import torch.nn as nn
import torch.nn.functional as F  # 注意:原代码使用了F.relu,需导入此模块

class FeedForwardNetwork(nn.Module):
    def __init__(self, d_model, d_ff):
        super(FeedForwardNetwork, self).__init__()
        self.linear_1 = nn.Linear(d_model, d_ff)  # 第一层线性变换:将输入从d_model维度映射到d_ff维度
        self.linear_2 = nn.Linear(d_ff, d_model)  # 第二层线性变换:将特征从d_ff维度映射回d_model维度
        self.dropout = nn.Dropout(0.1)  # Dropout层,防止过拟合,丢弃概率0.1

    def forward(self, x):
        x = F.relu(self.linear_1(x))  # 先通过第一层线性变换,再应用ReLU激活函数
        x = self.dropout(x)  # 对激活后的结果应用Dropout
        x = self.linear_2(x)  # 通过第二层线性变换映射回原维度
        x = self.dropout(x)  # 再次应用Dropout
        return x

class TransformerEncoderLayer(nn.Module):
    def __init__(self, d_model, num_heads, d_ff):
        super(TransformerEncoderLayer, self).__init__()
        self.self_attention = MultiHeadSelfAttention(d_model, num_heads)  # 多头自注意力模块
        self.layer_norm_1 = nn.LayerNorm(d_model)  # 第一个层归一化,稳定训练
        self.feed_forward = FeedForwardNetwork(d_model, d_ff)  # 前馈神经网络模块
        self.layer_norm_2 = nn.LayerNorm(d_model)  # 第二个层归一化
        self.dropout = nn.Dropout(0.1)  # 残差连接中的Dropout

    def forward(self, x, mask=None):
        # 第一步:多头自注意力 + 残差连接 + 层归一化
        x_attention = self.self_attention(x, mask)  # 计算多头自注意力输出
        x = x + self.dropout(x_attention)  # 残差连接:输入x加上注意力输出(经Dropout)
        x = self.layer_norm_1(x)  # 对残差连接后的结果做层归一化

        # 第二步:前馈网络 + 残差连接 + 层归一化
        x_ffn = self.feed_forward(x)  # 计算前馈网络输出
        x = x + self.dropout(x_ffn)  # 残差连接:当前x加上前馈网络输出(经Dropout)
        x = self.layer_norm_2(x)  # 对残差连接后的结果做层归一化

        return x
📌FeedForwardNetwork(前馈神经网络):
- 是Transformer中每个编码器/解码器层的固定组件,作用是对注意力输出进行非线性变换和特征增强
d_model:输入/输出特征维度(与注意力模块保持一致)d_ff:中间层维度(通常是d_model的4倍,如512→2048),通过扩大维度增加模型表达能力- 流程:先升维(d_model→d_ff)→ReLU激活→Dropout→降维(d_ff→d_model)→再Dropout,引入非线性并控制过拟合
📌TransformerEncoderLayer(Transformer编码器层):
- 是Transformer编码器的基本组成单元,每个编码器由N个这样的层堆叠而成
- 核心结构遵循“注意力+前馈网络”的双塔设计,配合残差连接和层归一化
- 流程解析:
- 输入先经过多头自注意力模块,捕捉序列内部的依赖关系
- 注意力输出与原始输入做残差连接(
x + x_attention),并通过Dropout和层归一化稳定训练 - 结果再送入前馈网络做非线性变换
- 前馈网络输出与上一步结果做残差连接,再次通过Dropout和层归一化
- 残差连接(
x + ...)解决深层网络梯度消失问题,层归一化(LayerNorm)使每一层输入分布更稳定,两者共同保障了Transformer能有效训练深层模型
class TransformerEncoder(nn.Module):
    def __init__(self, d_model, num_heads, d_ff, num_layers):
        super(TransformerEncoder, self).__init__()
        self.layers = nn.ModuleList()  # 用于存储多个编码器层的列表,PyTorch会自动跟踪其中的参数

        # 使用循环来添加多个具有相同结构的编码器层
        for _ in range(num_layers):
            layer = TransformerEncoderLayer(d_model, num_heads, d_ff)  # 创建单个编码器层
            self.layers.append(layer)  # 将编码器层添加到列表中

    def forward(self, x):
        # 依次通过所有编码器层,每一层对输入进行特征增强
        for layer in self.layers:
            x = layer(x)
        return x
📌TransformerEncoder(Transformer编码器):
- 是由多个
TransformerEncoderLayer堆叠而成的完整编码器,是Transformer模型的核心组件之一(用于处理源序列,如文本分类中的输入文本、机器翻译中的源语言等)。 - 核心参数:
d_model:特征维度(贯穿整个Transformer的统一维度)num_heads:多头注意力的头数d_ff:前馈网络的中间层维度num_layers:堆叠的编码器层数(如原始Transformer中使用6层)
五、TransformerModel
import torch
import torch.nn as nn
import torch.nn.functional as F
import math
from torch import Tensor

class TransformerModel(nn.Module):

    def __init__(self, ntoken: int, d_model: int, nhead: int, d_hid: int,
                 nlayers: int, dropout: float = 0.5):
        super().__init__()
        self.model_type = 'Transformer'  # 标识模型类型为Transformer
        self.pos_encoder = PositionalEncoding(d_model, dropout)  # 位置编码器,为序列添加位置信息
        # 初始化Transformer编码器(由nlayers个编码器层堆叠而成)
        self.transformer_encoder = TransformerEncoder(d_model, nhead, d_hid, nlayers)
        self.embedding = nn.Embedding(ntoken, d_model)  # 词嵌入层:将词索引映射为d_model维度的向量
        self.d_model = d_model  # 模型特征维度(贯穿整个模型的统一维度)
        self.linear = nn.Linear(d_model, 2)  # 最终分类层:将d_model维度映射为2类(pos/neg)

        self.init_weights()  # 初始化模型权重

    def init_weights(self) -> None:
        initrange = 0.1
        # 初始化词嵌入权重为[-initrange, initrange]的均匀分布
        self.embedding.weight.data.uniform_(-initrange, initrange)
        self.linear.bias.data.zero_()  # 初始化分类层偏置为0
        # 初始化分类层权重为[-initrange, initrange]的均匀分布
        self.linear.weight.data.uniform_(-initrange, initrange)

    def forward(self, src: Tensor, src_mask: Tensor = None) -> Tensor:
        """
        Arguments:
            src: Tensor, shape ``[seq_len, batch_size]`` 输入序列(序列长度×批次大小)
            src_mask: Tensor, shape ``[seq_len, seq_len]`` 可选的掩码矩阵(用于屏蔽无效位置)

        Returns:
            output Tensor of shape ``[batch_size, 2]`` 最终分类结果(批次大小×2类)
        """
        # 词嵌入:将词索引转为向量,并用sqrt(d_model)缩放(稳定嵌入层输出范围)
        # 输出形状: [seq_len, batch_size, d_model]
        src = self.embedding(src) * math.sqrt(self.d_model)
        src = self.pos_encoder(src)  # 添加位置编码,输出形状不变

        # 调整维度顺序:从[seq_len, batch_size, d_model]转为[batch_size, seq_len, d_model]
        # 以匹配TransformerEncoder的输入维度要求
        src = src.permute(1, 0, 2)

        # 通过Transformer编码器,输出形状保持[batch_size, seq_len, d_model]
        output = self.transformer_encoder(src)

        # 恢复维度顺序:从[batch_size, seq_len, d_model]转回[seq_len, batch_size, d_model]
        output = output.permute(1, 0, 2)

        # 取序列的第一个位置(index=0)的特征作为整个序列的表示
        # 输出形状: [batch_size, d_model]
        output = output[0, :, :]

        # 通过分类层得到最终的2类预测结果,形状: [batch_size, 2]
        output = self.linear(output)
        return output
📌TransformerModel 整体作用:
-
这是一个基于Transformer的完整分类模型,用于将输入序列(如文本)分类为2个类别(pos/neg),核心是通过Transformer编码器提取序列特征,再通过线性层输出分类结果。
-
该模型适用于文本分类等序列级任务,通过Transformer的强大特征提取能力,能有效捕捉输入序列的深层语义和长距离依赖关系
六、代码实战——IMDB评论数据集的情感分析
6.1 Dataloader预处理
import os
os.environ['HF_ENDPOINT'] = 'https://hf-mirror.com'  # 设置Hugging Face镜像端点,加速数据集加载

import string
import torch
import numpy as np
from torch import nn, Tensor
import torch.nn.functional as F
from torch.utils.data import Dataset, DataLoader  # 导入数据集相关工具类
import math
from datasets import load_dataset  # 用于加载IMDB数据集,需提前安装 datasets 库

# 加载IMDB训练集并构建词表
train_dataset_hf = load_dataset('imdb', split='train')  # 从Hugging Face加载IMDB训练集

# 收集训练集中所有预处理后的单词(去标点、转小写)
all_text_word = []
for i in range(len(train_dataset_hf)):
    text = train_dataset_hf[i]['text']
    for c in string.punctuation:
        text = text.replace(c, ' ').lower()  # 去除标点并转换为小写
    all_text_word.extend(text.split())

# 构建词表:唯一单词映射到索引(索引从1开始),未知词(<unk>)映射到0
unique_words = np.unique(all_text_word)
vocab = {word: index + 1 for index, word in enumerate(unique_words)}
vocab['<unk>'] = 0  # 未知单词的默认索引

# 自定义IMDB数据集类,继承自torch.utils.data.Dataset
class IMDB_Dataset(Dataset):
    def __init__(self, split):
        self.dataset = load_dataset('imdb', split=split)  # 加载指定划分(train或test)的数据集

    def __len__(self):
        return len(self.dataset)  # 返回数据集的样本总数

    def __getitem__(self, idx):
        text = self.dataset[idx]['text']
        for c in string.punctuation:
            text = text.replace(c, ' ').lower()  # 对文本进行预处理(去标点、转小写)
        label = self.dataset[idx]['label']
        return text, label  # 返回预处理后的文本和对应的标签

# 实例化训练集和测试集的Dataset
train_ds = IMDB_Dataset('train')
test_ds = IMDB_Dataset('test')

# 自动选择设备:有GPU则用GPU,否则用CPU
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')

# 自定义批次处理函数,用于DataLoader对每个批次的处理
def collate_batch(batch):
    label_list, text_list = [], []
    for (_text, _label) in batch:
        word_list = []
        for word in _text.split():
            word_list.append(vocab.get(word, 0))  # 将单词转换为词表中的索引,未知词用0
        word_list = torch.tensor(word_list, dtype=torch.int64)  # 转换为张量
        text_list.append(word_list)
        label_list.append(_label)
    label_list = torch.tensor(label_list)  # 将标签列表转换为张量
    # 对文本序列进行填充,使同批次内的序列长度一致
    text_list = torch.nn.utils.rnn.pad_sequence(text_list)
    # 将标签和文本张量移动到指定设备(GPU/CPU)
    return label_list.to(device), text_list.to(device)

# 创建训练集和测试集的DataLoader(用于按批次加载数据)
train_dataloader = DataLoader(train_ds, batch_size=128, shuffle=True, collate_fn=collate_batch)
test_dataloader = DataLoader(test_ds, batch_size=128, collate_fn=collate_batch)
-
环境与导入部分:
- 设置
HF_ENDPOINT为镜像地址,加速Hugging Face数据集的下载; - 导入字符串处理、PyTorch、数据集加载等所需模块
- 设置
-
词表构建:
- 从IMDB训练集中提取所有单词,经“去标点、转小写”预处理后,生成“单词→索引”的映射字典
vocab; - 预留索引
0给未知单词(<unk>),确保未见过的单词能被统一映射
- 从IMDB训练集中提取所有单词,经“去标点、转小写”预处理后,生成“单词→索引”的映射字典
-
自定义
IMDB_Dataset类:- 继承
Dataset类,实现__init__(加载指定划分的数据集)、__len__(返回数据集长度)、__getitem__(按索引获取并预处理单条样本)方法,使IMDB数据集能被PyTorch的DataLoader加载
- 继承
-
设备选择:
- 通过
torch.cuda.is_available()自动判断是否使用GPU,实现硬件加速的自动适配
- 通过
-
collate_batch函数:- 对
DataLoader的每个批次进行后处理:将文本转换为词表索引序列、用pad_sequence填充至同长度、把标签和文本张量移到目标设备,保证模型能批量处理数据
- 对
-
DataLoader实例化:- 生成训练/测试集的批次迭代器,训练集开启
shuffle=True以打乱数据顺序,提升训练稳定性;两者均指定collate_batch为自定义批次处理逻辑
- 生成训练/测试集的批次迭代器,训练集开启
6.2 模型训练
📌model = TransformerModel(ntokens, d_model, nhead, d_hid, nlayers, dropout).to(device)
📌使用前面搭建的TransformerModel进行训练
# 模型超参数设置
ntokens = len(vocab)  # 词汇表大小
d_model = 200  # 词嵌入维度
d_hid = 2048  # 前馈网络中间层维度
nlayers = 2  # Transformer编码器的层数
nhead = 2  # 多头注意力的头数
dropout = 0.2  # Dropout概率
model = TransformerModel(ntokens, d_model, nhead, d_hid, nlayers, dropout).to(device)  # 初始化模型并移到目标设备

# 损失函数、优化器与学习率调度器
loss_fn = nn.CrossEntropyLoss()  # 交叉熵损失(适用于分类任务)
from torch.optim import lr_scheduler
optimizer = torch.optim.Adam(model.parameters(), lr=0.0001)  # Adam优化器
exp_lr_scheduler = lr_scheduler.StepLR(optimizer, step_size=10, gamma=0.1)  # 学习率调度器:每10轮学习率乘以0.1

# 训练函数:计算一个epoch的损失和准确率
def train(dataloader):
    total_acc, total_count, total_loss = 0, 0, 0
    model.train()  # 切换模型为训练模式(启用Dropout等)
    for label, text in dataloader:
        predicted_label = model(text)  # 模型前向传播预测标签
        loss = loss_fn(predicted_label, label)  # 计算损失
        # 反向传播与参数更新
        optimizer.zero_grad()  # 清空梯度
        loss.backward()  # 反向传播计算梯度
        optimizer.step()  # 更新参数

        with torch.no_grad():  # 不计算梯度,用于统计指标
            total_acc += (predicted_label.argmax(1) == label).sum().item()  # 累加正确预测数
            total_count += label.size(0)  # 累加样本总数
            total_loss += loss.item() * label.size(0)  # 累加带权重的损失(按样本数加权)
    return total_loss / total_count, total_acc / total_count  # 返回平均损失和准确率

# 测试函数:计算数据集上的损失和准确率(无梯度更新)
def test(dataloader):
    model.eval()  # 切换模型为评估模式(禁用Dropout等)
    total_acc, total_count, total_loss = 0, 0, 0
    with torch.no_grad():  # 禁用梯度计算,节省内存且避免不必要计算
        for label, text in dataloader:
            predicted_label = model(text)  # 模型前向传播预测标签
            loss = loss_fn(predicted_label, label)  # 计算损失
            total_acc += (predicted_label.argmax(1) == label).sum().item()  # 累加正确预测数
            total_count += label.size(0)  # 累加样本总数
            total_loss += loss.item() * label.size(0)  # 累加带权重的损失
    return total_loss / total_count, total_acc / total_count  # 返回平均损失和准确率

# 训练循环函数:执行多轮训练并记录每轮的训练/测试指标
def fit(epochs, train_dl, test_dl):
    train_loss, train_acc, test_loss, test_acc = [], [], [], []  # 用于存储每轮的指标
    for epoch in range(epochs):
        epoch_loss, epoch_acc = train(train_dl)  # 训练一个epoch,获取训练损失和准确率
        epoch_test_loss, epoch_test_acc = test(test_dl)  # 在测试集上评估,获取测试损失和准确率
        # 记录每轮指标
        train_loss.append(epoch_loss)
        train_acc.append(epoch_acc)
        test_loss.append(epoch_test_loss)
        test_acc.append(epoch_test_acc)
        exp_lr_scheduler.step()  # 学习率调度器步进(更新学习率)
        # 打印当前轮的指标
        template = ("epoch:{:2d}, train_loss: {:.5f}, train_acc: {:.1f}%,"
                   " test_loss: {:.5f}, test_acc: {:.1f}%")
        print(template.format(
            epoch, epoch_loss, epoch_acc*100, epoch_test_loss, epoch_test_acc*100))
    print("Done!")
    return train_loss, test_loss, train_acc, test_acc  # 返回所有轮的指标

EPOCHS = 50  # 训练总轮数
# 执行训练,获取训练过程的损失和准确率指标
train_loss, test_loss, train_acc, test_acc = fit(EPOCHS, train_dataloader, test_dataloader)
- 训练结果如下图所示

📌从位置编码到多头注意力,Transformer 的精巧设计重塑了 NLP。掌握其架构,不仅能驾驭各类任务,更能领悟深度学习的核心智慧,为进阶之路奠定基石~
零基础如何高效学习大模型?
为了帮助大家打破壁垒,快速了解大模型核心技术原理,学习相关大模型技术。从原理出发真正入局大模型。在这里我和MoPaaS魔泊云联合梳理打造了系统大模型学习脉络,这份 LLM大模型资料 分享出来:包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码免费领取🆓**⬇️⬇️⬇️

【大模型全套视频教程】
教程从当下的市场现状和趋势出发,分析各个岗位人才需求,带你充分了解自身情况,get 到适合自己的 AI 大模型入门学习路线。
从基础的 prompt 工程入手,逐步深入到 Agents,其中更是详细介绍了 LLM 最重要的编程框架 LangChain。最后把微调与预训练进行了对比介绍与分析。
同时课程详细介绍了AI大模型技能图谱知识树,规划属于你自己的大模型学习路线,并且专门提前收集了大家对大模型常见的疑问,集中解答所有疑惑!
深耕 AI 领域技术专家带你快速入门大模型
跟着行业技术专家免费学习的机会非常难得,相信跟着学习下来能够对大模型有更加深刻的认知和理解,也能真正利用起大模型,从而“弯道超车”,实现职业跃迁!

【精选AI大模型权威PDF书籍/教程】
精心筛选的经典与前沿并重的电子书和教程合集,包含《深度学习》等一百多本书籍和讲义精要等材料。绝对是深入理解理论、夯实基础的不二之选。
【AI 大模型面试题 】
除了 AI 入门课程,我还给大家准备了非常全面的**「AI 大模型面试题」,**包括字节、腾讯等一线大厂的 AI 岗面经分享、LLMs、Transformer、RAG 面试真题等,帮你在面试大模型工作中更快一步。
【大厂 AI 岗位面经分享(92份)】
【AI 大模型面试真题(102 道)】
【LLMs 面试真题(97 道)】
【640套 AI 大模型行业研究报告】
【AI大模型完整版学习路线图(2025版)】
明确学习方向,2025年 AI 要学什么,这一张图就够了!
👇👇点击下方卡片链接免费领取全部内容👇👇
抓住AI浪潮,重塑职业未来!
科技行业正处于深刻变革之中。英特尔等巨头近期进行结构性调整,缩减部分传统岗位,同时AI相关技术岗位(尤其是大模型方向)需求激增,已成为不争的事实。具备相关技能的人才在就业市场上正变得炙手可热。
行业趋势洞察:
- 转型加速: 传统IT岗位面临转型压力,拥抱AI技术成为关键。
- 人才争夺战: 拥有3-5年经验、扎实AI技术功底和真实项目经验的工程师,在头部大厂及明星AI企业中的薪资竞争力显著提升(部分核心岗位可达较高水平)。
- 门槛提高: “具备AI项目实操经验”正迅速成为简历筛选的重要标准,预计未来1-2年将成为普遍门槛。
与其观望,不如行动!
面对变革,主动学习、提升技能才是应对之道。掌握AI大模型核心原理、主流应用技术与项目实战经验,是抓住时代机遇、实现职业跃迁的关键一步。
01 为什么分享这份学习资料?
当前,我国在AI大模型领域的高质量人才供给仍显不足,行业亟需更多有志于此的专业力量加入。
因此,我们决定将这份精心整理的AI大模型学习资料,无偿分享给每一位真心渴望进入这个领域、愿意投入学习的伙伴!
我们希望能为你的学习之路提供一份助力。如果在学习过程中遇到技术问题,也欢迎交流探讨,我们乐于分享所知。
*02 这份资料的价值在哪里?*
专业背书,系统构建:
-
本资料由我与MoPaaS魔泊云的鲁为民博士共同整理。鲁博士拥有清华大学学士和美国加州理工学院博士学位,在人工智能领域造诣深厚:
-
- 在IEEE Transactions等顶级学术期刊及国际会议发表论文超过50篇。
- 拥有多项中美发明专利。
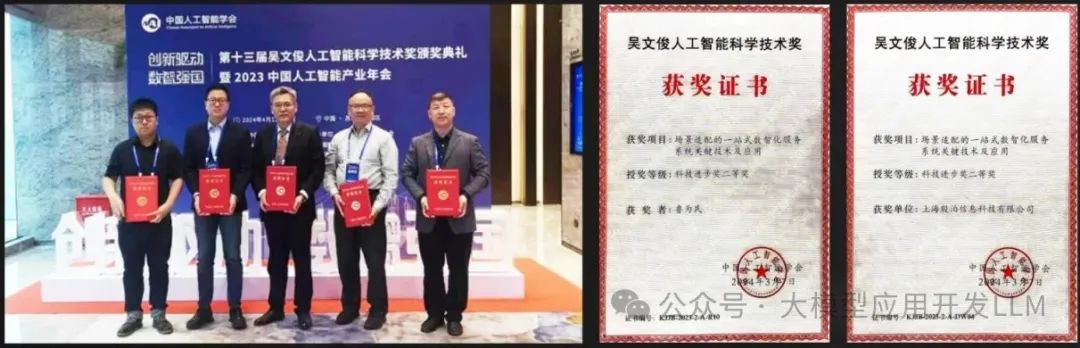
- 荣获吴文俊人工智能科学技术奖(中国人工智能领域重要奖项)。
-
目前,我有幸与鲁博士共同进行人工智能相关研究。
内容实用,循序渐进:
-
资料体系化覆盖了从基础概念入门到核心技术进阶的知识点。
-
包含丰富的视频教程与实战项目案例,强调动手实践能力。
-
无论你是初探AI领域的新手,还是已有一定技术基础希望深入大模型的学习者,这份资料都能为你提供系统性的学习路径和宝贵的实践参考,助力你提升技术能力,向大模型相关岗位转型发展。
抓住机遇,开启你的AI学习之旅!
更多推荐


 27
 0
- 0


 已为社区贡献29条内容

所有评论(0)