
如何开始学习大型语言模型(LLM)?2025最新学习路线,从零基础入门到精通,一篇全掌握!
想要学习LLM(大型语言模型),首先要对LLM有一定的了解,知道LLM的基本概念和使用。因此,对于每一位初学者,首先都需要学习一些LLM的入门课程,包括基础的 Python 语法(因为 LLM 目前基本都建立在Python生态上)、LLM 的概念、Prompt 书写技巧等,对 LLM 有一个初步而全面的了解。在LLM基础入门方面,DW 目前有这样一些开源教程供学习:
- 学习 Python 基本语法与程序编写方法的《聪明办法学 Python》:https://github.com/datawhalechina/learn-python-the-smart-way-v2
- 面向非从业人员、非高级开发者的 LLM 通识课程《GPT 从入门到应用——Prompt 使用指南》:https://linklearner.com/lesson/11eee795-2d34-a81b-afbb-00ffd44c5a68/summary
- 从 Prompt 开始,讲授 LLM 的全面入门的《LLM Cookbook 必修一——面向开发者的提示工程》:https://github.com/datawhalechina/llm-cookbook/tree/main/content/%E5%BF%85%E4%BF%AE%E4%B8%80-Prompt%20Engineering%20For%20Developers
一、细分方向
在对 LLM 有基本了解之后,需要更进一步理解 LLM 的细分方向,确定自己想要深入探索的具体方向。根据个人的学习经验,我将 LLM 这个领域分成以下四个细分方向:
- 首先是 LLM 开发,主要指基于闭源 LLM API 来去构建一些有意思的应用。这是一个更“开发”的方向,你需要在 LLM API 的基础上来做文章,包括构建 RAG 或者 Agent 框架,优化 Prompt 等来开发一个能解决用户实际需求的应用。例如主打情感聊天的个性化聊天伙伴、前段时间爆火出圈的哄哄模拟器等,都是 LLM 开发的成果;
- 其次是微调 LLM,主要指本地微调一个开源 LLM 来去解决实际业务问题。这是一个更偏向于传统“算法”的方向,你需要针对业务需求进行业务逻辑拆解,再针对性地构建、优化训练数据,对开源 LLM 进行分布式微调并不断迭代优化 Bad Case。例如我们上文所使用的案例,就是一个微调 LLM 的经典任务;
- LLM 部署是一个更底层的方向,主要指如何对训练好的 LLM 进行部署推理、加速优化。这个方向一般会涉及到 LLM 的分布式部署、量化、剪枝、蒸馏等操作,一般存在于大企业的架构部门。针对这个方向,你不仅需要熟悉 LLM 的架构和原理,还需要掌握一定 CUDA 编程等底层知识;
- 最后是门槛最高、技术空间最广阔的训练 LLM,包括 LLM 相关的、更硬核、资源要求更高的一切内容,例如 LLM 的预训练、SFT、RLHF 全流程,海量预训练数据处理,超大分布式集群训练,LLM 的架构、训练方法优化等。要深研这个方向,需要有较高的数学和代码功底,往往还需要一定的科研素养与灵感。
二、LLM 开发
对于 LLM 开发,可以先学习一些 LLM 开发的入门内容,例如什么是 RAG、什么是 Agent,如何使用 Langchain 构建 LLM Demo 等。在掌握了 LLM 开发的基本技能之后,可以深入学习例如 RAG 高级技巧或是 Agent 开发等进阶内容,来去尝试如何构建强大、可用的 LLM 应用,包括阅读一些前沿论文或经典开源项目源码,来不断深入自己对 LLM 开发的理解。在完成了上述内容的学习并掌握对应内容之后,需要投入到真正的 LLM 开发实践中去深入探索 LLM 开发,提出新的 Idea 并组队开发创新产品,或是参加一些由国内知名企业举办的 LLM 赛事,从而在实践中不断磨练真正的 LLM 开发技术。
在 LLM 开发领域,DW 有这样一些开源教程可供学习参考:
- 聚焦于如何使用ChatGPT相关API创造新的功能和应用的《Hugging LLM》:https://github.com/datawhalechina/hugging-llm
- 面向小白开发者的大模型应用开发教程《LLM Universe —— 动手学大模型应用开发》:(https://github.com/datawhalechina/llm-universe
- 基于 MetaGPT 框架的多智能体开发教程《Hugging Multi-Agent》:https://github.com/datawhalechina/hugging-multi-agent
三、LLM 微调
要学习 LLM 微调,需要学习更多的 LLM 基础内容和原理,更进一步掌握 LLM 本身,因为微调需要对 LLM 的参数做调整。你需要首先学习深度学习基础,掌握深度学习基本概念,了解深度学习任务的常见术语、经典网络。你还需要具备一定的 Pytorch 基础,因为目前 LLM 基本都搭建在 Pytorch 生态上。完成深度学习基础和 Pytorch 基础学习后,可以从理论到实践来去学习 LLM 的微调。
首先需要学习一系列理论教程,对 LLM 有全面、深入、微观的认识和理解;然后进行真正的 LLM 微调实践,一步步掌握 LLM 部署、推理、微调全流程并尝试参加一些算法比赛产出实际成果。在掌握基本的 LLM 微调技巧后,你还需要投入到真正业务实践中,去理解学界、业界真正如何使用 LLM 微调。你可以去到一些知名企业(例如互联网大厂或独角兽)实习 LLM 算法岗位,目前,LLM 微调一般有两种核心工作:一是微调 LLM 来解决实际业务问题,另一个就是微调垂域大模型,如医学大模型、法律大模型等。这两种工作中都存在大量业务实践经验和技巧,需要学习者亲身实践才能体会。
你也可以跟随有足够资源的导师或实验室去进行科研探索,例如阅读大量科研论文,找到新的 Idea 并进行实现实验,尝试产出真正的学术成果。到这一步,在 LLM 微调的细分方向上,学习者就算登堂入室了。
在 LLM 微调领域,Datawhale有这样一些开源教程可供学习参考:
- 深度学习入门经典教程《李宏毅深度学习教程》:https://github.com/datawhalechina/leedl-tutorial
- 入浅出、从理论到实践的 Pytorch 教程《深入浅出 Pytorch》:https://github.com/datawhalechina/thorough-pytorch
- 全面介绍 LLM 理论基础的《So Large LM》:https://github.com/datawhalechina/so-large-lm
- 提供LLM 的调用、部署、微调全链路手把手教学的《Self LLM——开源大模型食用指南》:https://github.com/datawhalechina/self-llm
四、LLM 部署
LLM 部署是一个比微调更底层、更硬核的方向,主要是对已训练好的模型进行部署、量化和推理加速,该方向一般是在大型企业的架构部门,在一些企业中,负责训练模型算法工程师也需要兼顾模型部署和推理。要学习 LLM 部署的方向,你首先同样需要学习深度学习基础、Pytorch 基础和 LLM 基础。
在掌握相关基础之后,我们建议通过学习一些经典的部署框架来进行部署的实践,包括常用分布式框架 Deepspeed、常用部署推理框架 vLLM 和经典量化框架 accelerate。要深入掌握 LLM 部署,不仅要学会如何使用上述框架,更要深入其原理和源码,理解 LLM 部署需要做些什么。最后,你同样需要进行深入实践。可以去到企业的架构团队进行实习,尝试上手真实业务场景下 LLM 的部署与推理加速;也可以进行 CUDA 编程的学习,从更底层掌握 LLM 的部署优化。
五、LLM 训练
LLM 训练是门槛最高、技术空间最大、学习路径最系统的一个方向。LLM 训练包括 LLM 的全流程训练、结构优化、理论研究等,需要大量资源和较高的功底,一般在知名高校、研究院或是企业的研究类部门中,是比较“稀缺”的一个方向。学习 LLM 训练,需要更长周期、更系统、更全面的基础学习。首先,你需要具备一定的数学基础。包括高等数学、线性代数与矩阵论、概率论等,都需要掌握到至少本科水平。其次,你需要学习机器学习和深度学习基础。对于机器学习基础,要掌握常见算法理论,熟悉常见算法的实现。对于深度学习基础,学习的要求可能会更高,需要深入掌握主流神经网络的结构,最好要能够自己动手实现。
在掌握机器学习与深度学习的基础之后,你还需要学习 NLP 基础。你需要阅读一系列 NLP 经典论文,如 Word2Vec、ELMo、Transformer、GPT、BERT 等,理解 NLP 任务的特点、核心思路和发展历程。具备足够的 NLP 基础,我们才推荐学习 LLM 基础,因为对于 LLM 训练这个方向,掌握扎实的基础至关重要。你同样需要学习 LLM 理论基础,同时阅读一系列 LLM 经典论文,例如 Instruct-GPT、LoRA 等,从而对 LLM 有一个更深入、透彻的掌握。同样,需要掌握开源 LLM 的部署、微调实践,这也是学习 LLM 训练的必备基础技能。最后,在具备较深厚的基础后,可以投身到有足够资源的科研团队中,紧跟研究热点,产出学术成果;还可以到知名 LLM 团队实习(如讯飞星火、百度文心一言、阿里通义千问等),亲身参与 LLM 训练,体验 LLM 训练中的核心难点和问题所在。
到这个阶段,就算 LLM 训练方向上完成入门了。
六、AI大模型从0到精通全套学习大礼包
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
只要你是真心想学AI大模型,我这份资料就可以无偿共享给你学习。大模型行业确实也需要更多的有志之士加入进来,我也真心希望帮助大家学好这门技术,如果日后有什么学习上的问题,欢迎找我交流,有技术上面的问题,我是很愿意去帮助大家的!
如果你也想通过学大模型技术去帮助就业和转行,可以扫描下方链接👇👇
大模型重磅福利:入门进阶全套104G学习资源包免费分享!
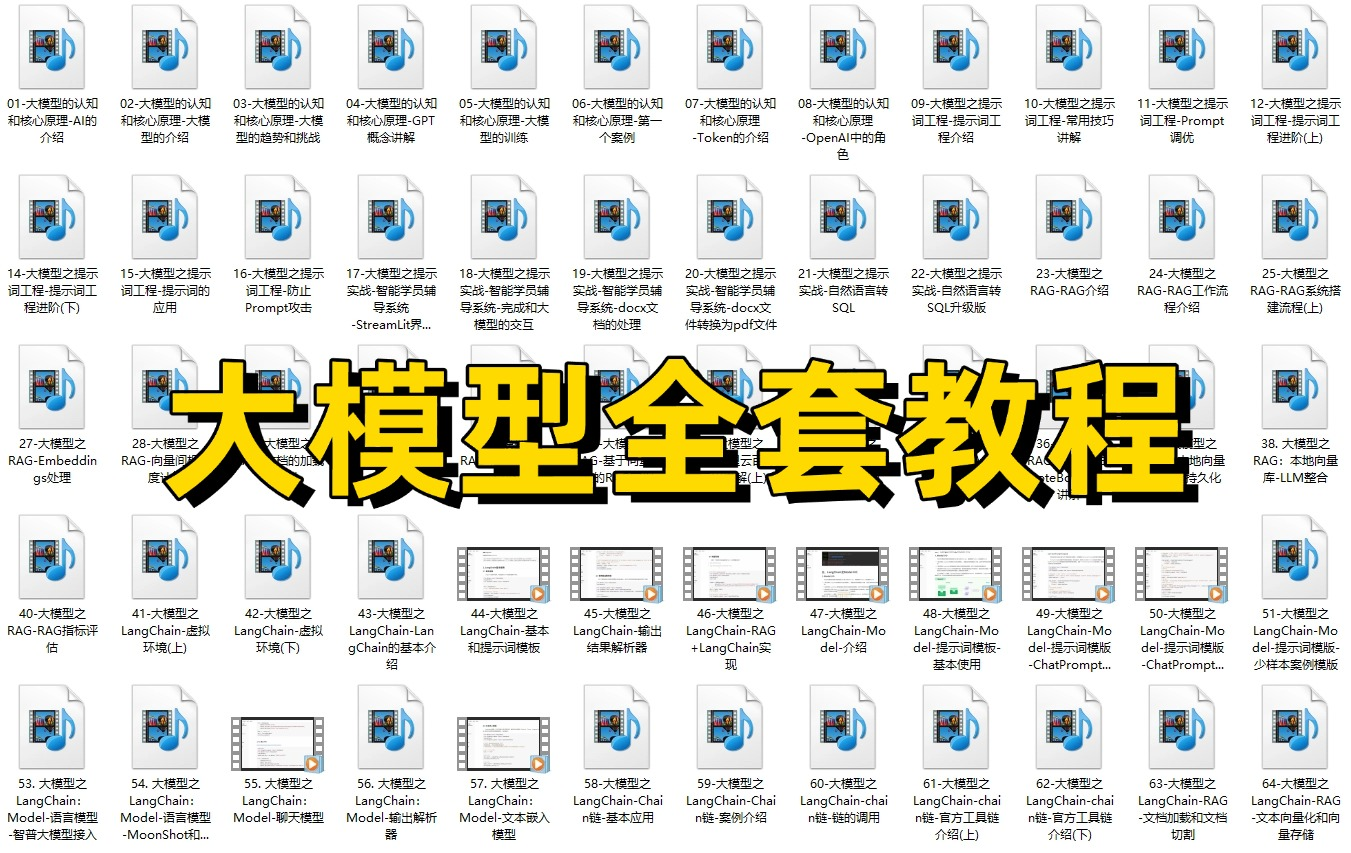
01.从入门到精通的全套视频教程
包含提示词工程、RAG、Agent等技术点
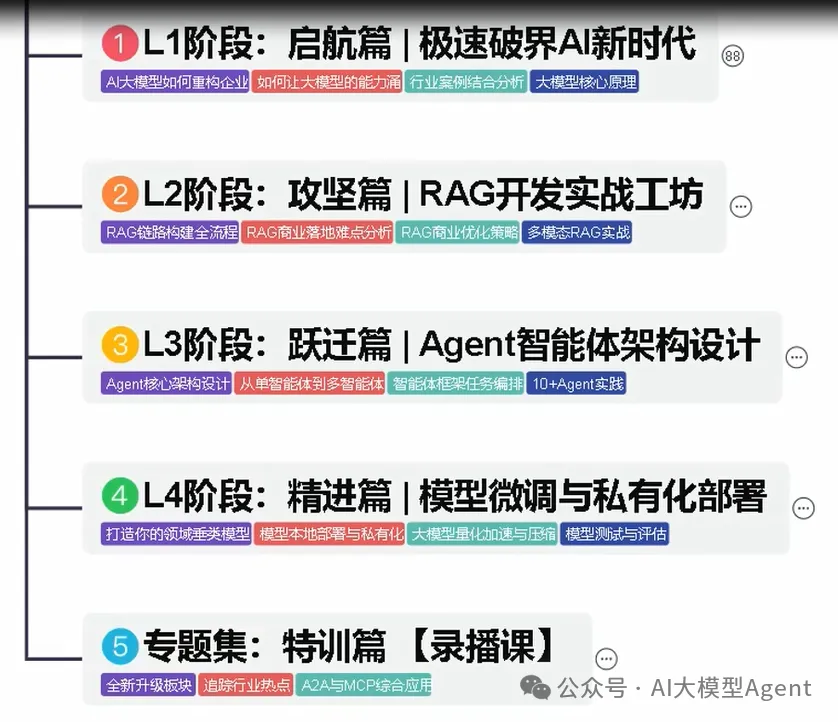
02.AI大模型学习路线图(还有视频解说)
全过程AI大模型学习路线
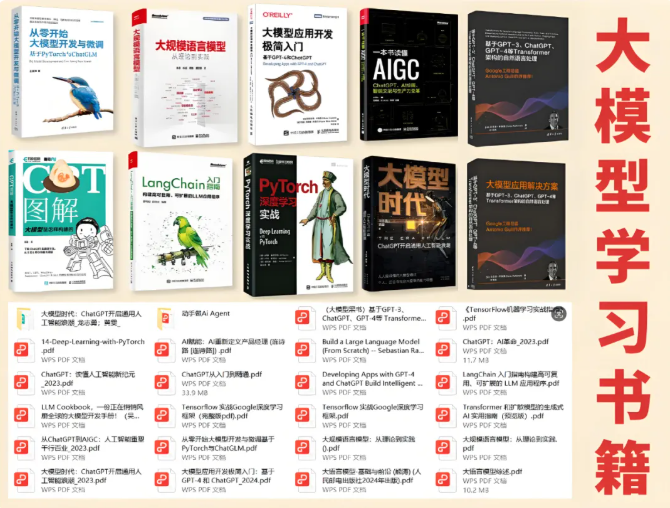
03.学习电子书籍和技术文档
市面上的大模型书籍确实太多了,这些是我精选出来的
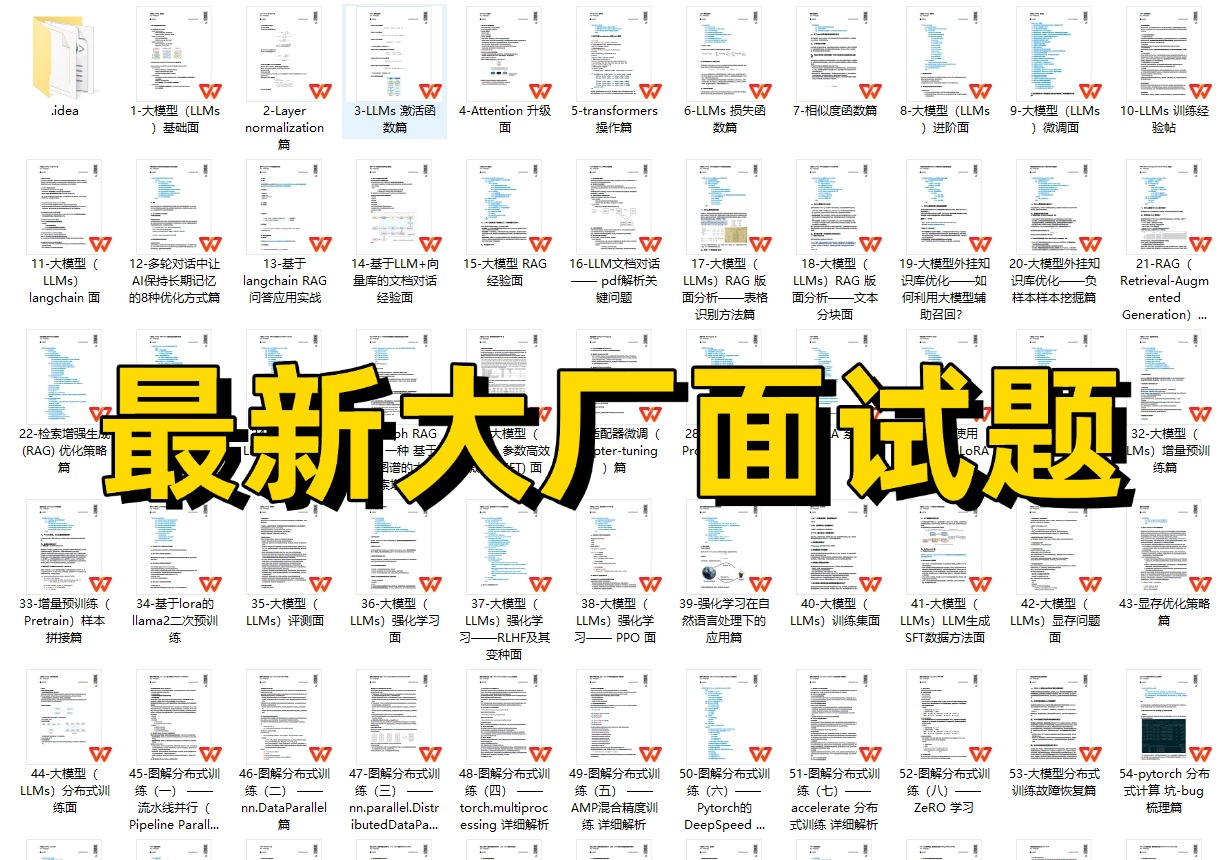
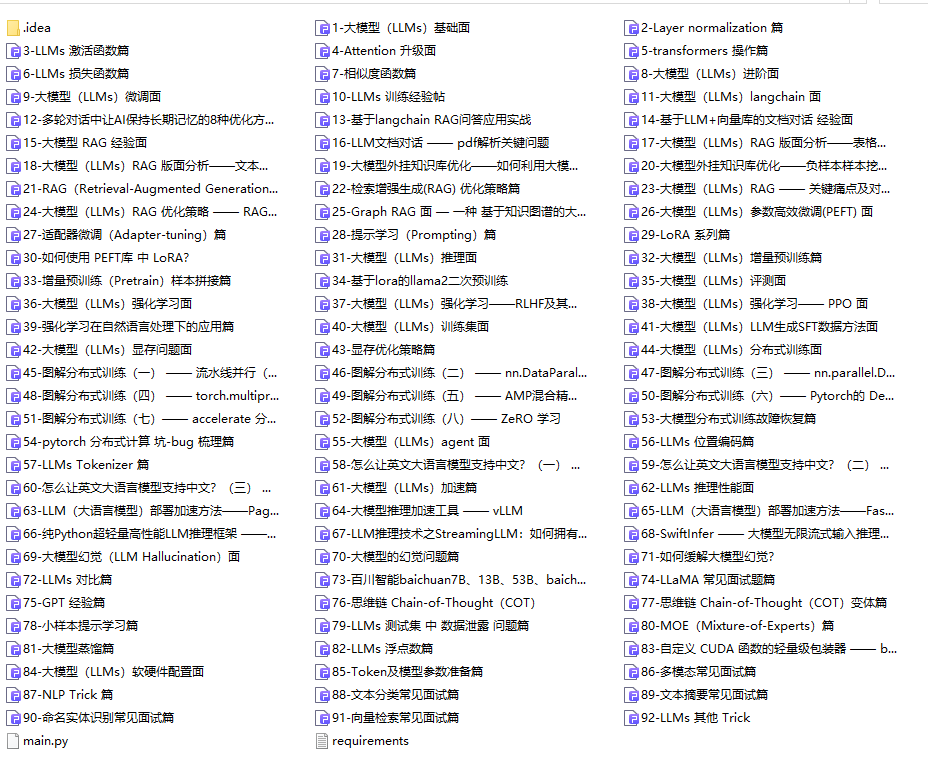
04.大模型面试题目详解
05.这些资料真的有用吗?
这份资料由我和鲁为民博士共同整理,鲁为民博士先后获得了北京清华大学学士和美国加州理工学院博士学位,在包括IEEE Transactions等学术期刊和诸多国际会议上发表了超过50篇学术论文、取得了多项美国和中国发明专利,同时还斩获了吴文俊人工智能科学技术奖。目前我正在和鲁博士共同进行人工智能的研究。
所有的视频由智泊AI老师录制,且资料与智泊AI共享,相互补充。这份学习大礼包应该算是现在最全面的大模型学习资料了。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
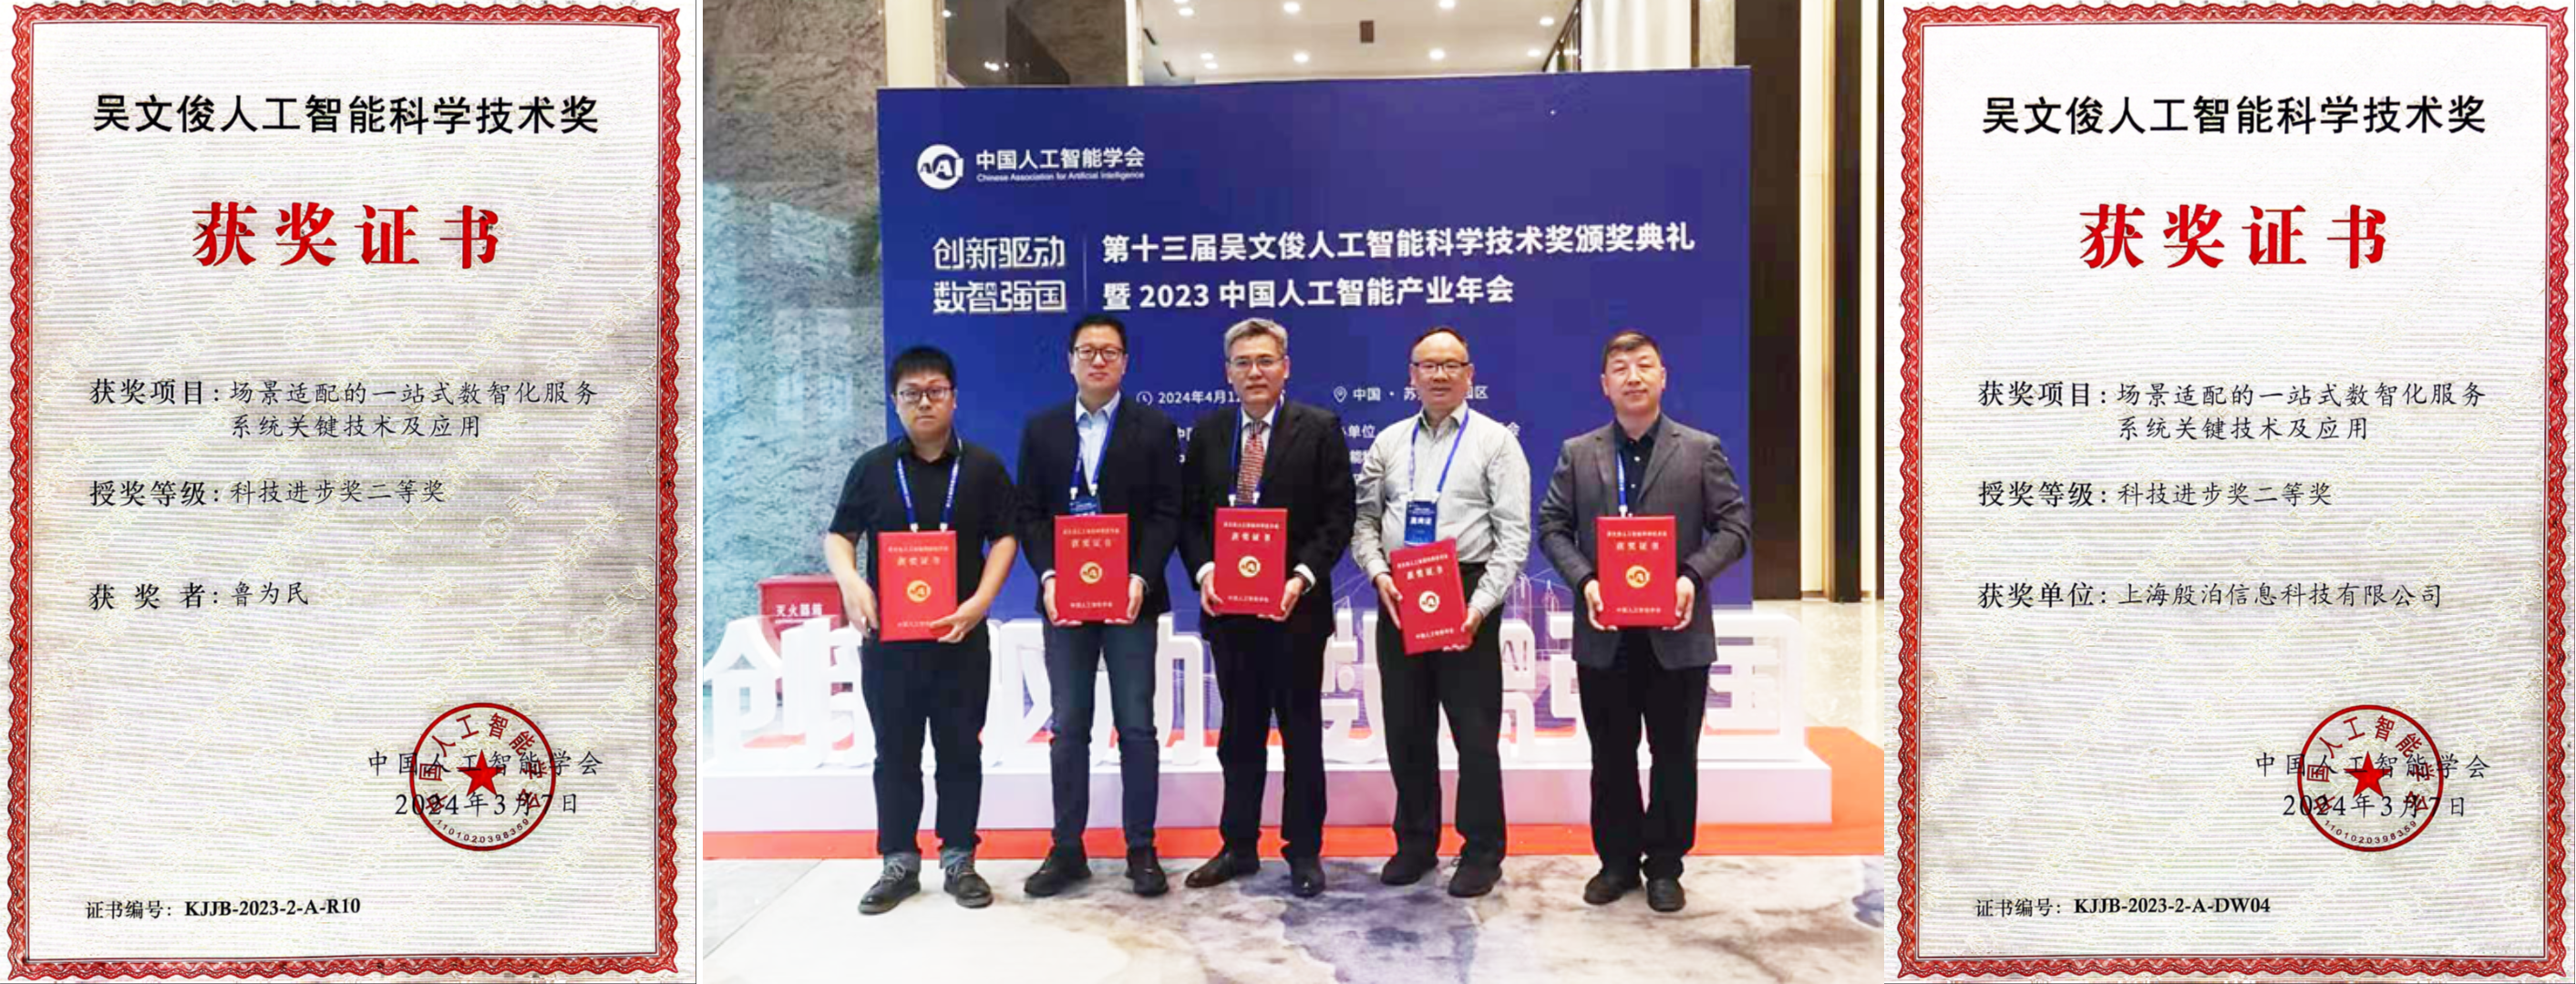
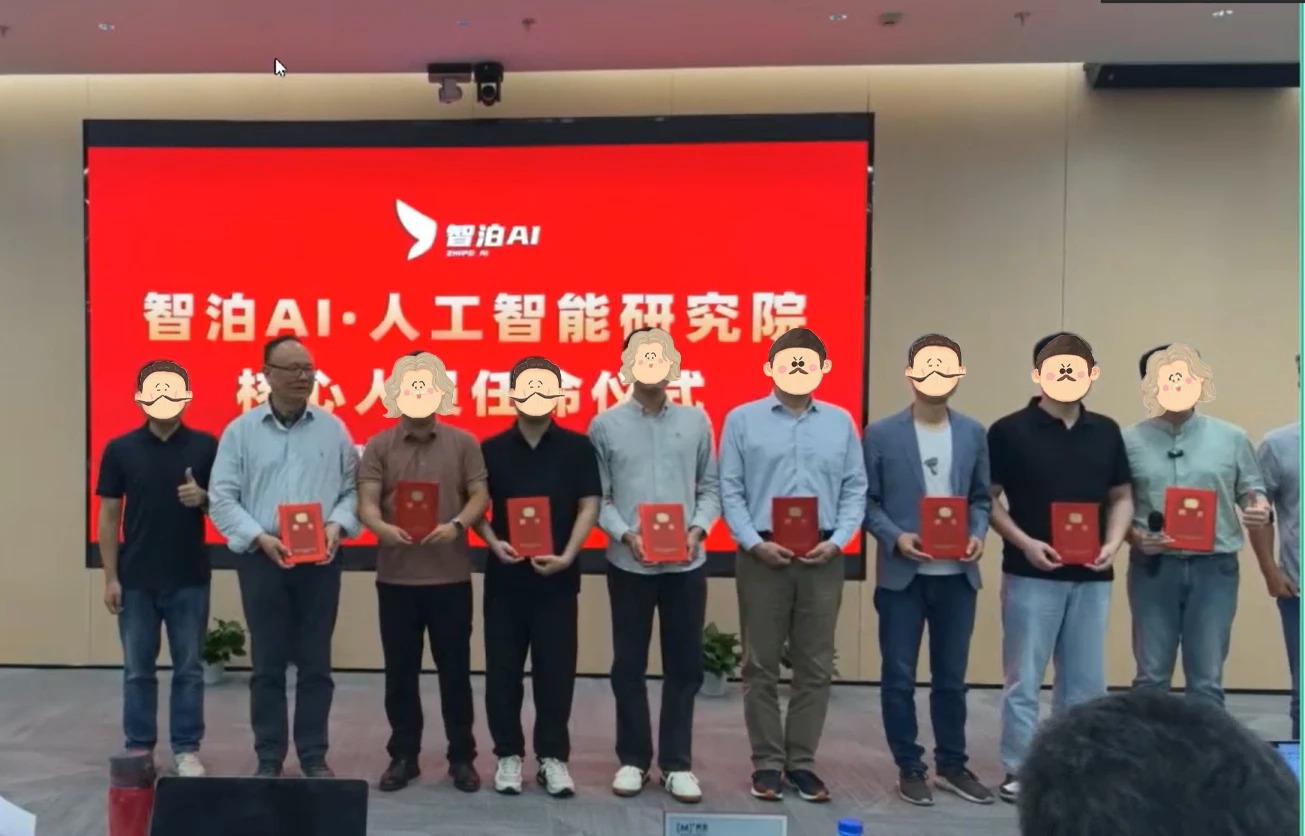
智泊AI始终秉持着“让每个人平等享受到优质教育资源”的育人理念,通过动态追踪大模型开发、数据标注伦理等前沿技术趋势,构建起"前沿课程+智能实训+精准就业"的高效培养体系。
课堂上不光教理论,还带着学员做了十多个真实项目。学员要亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事!
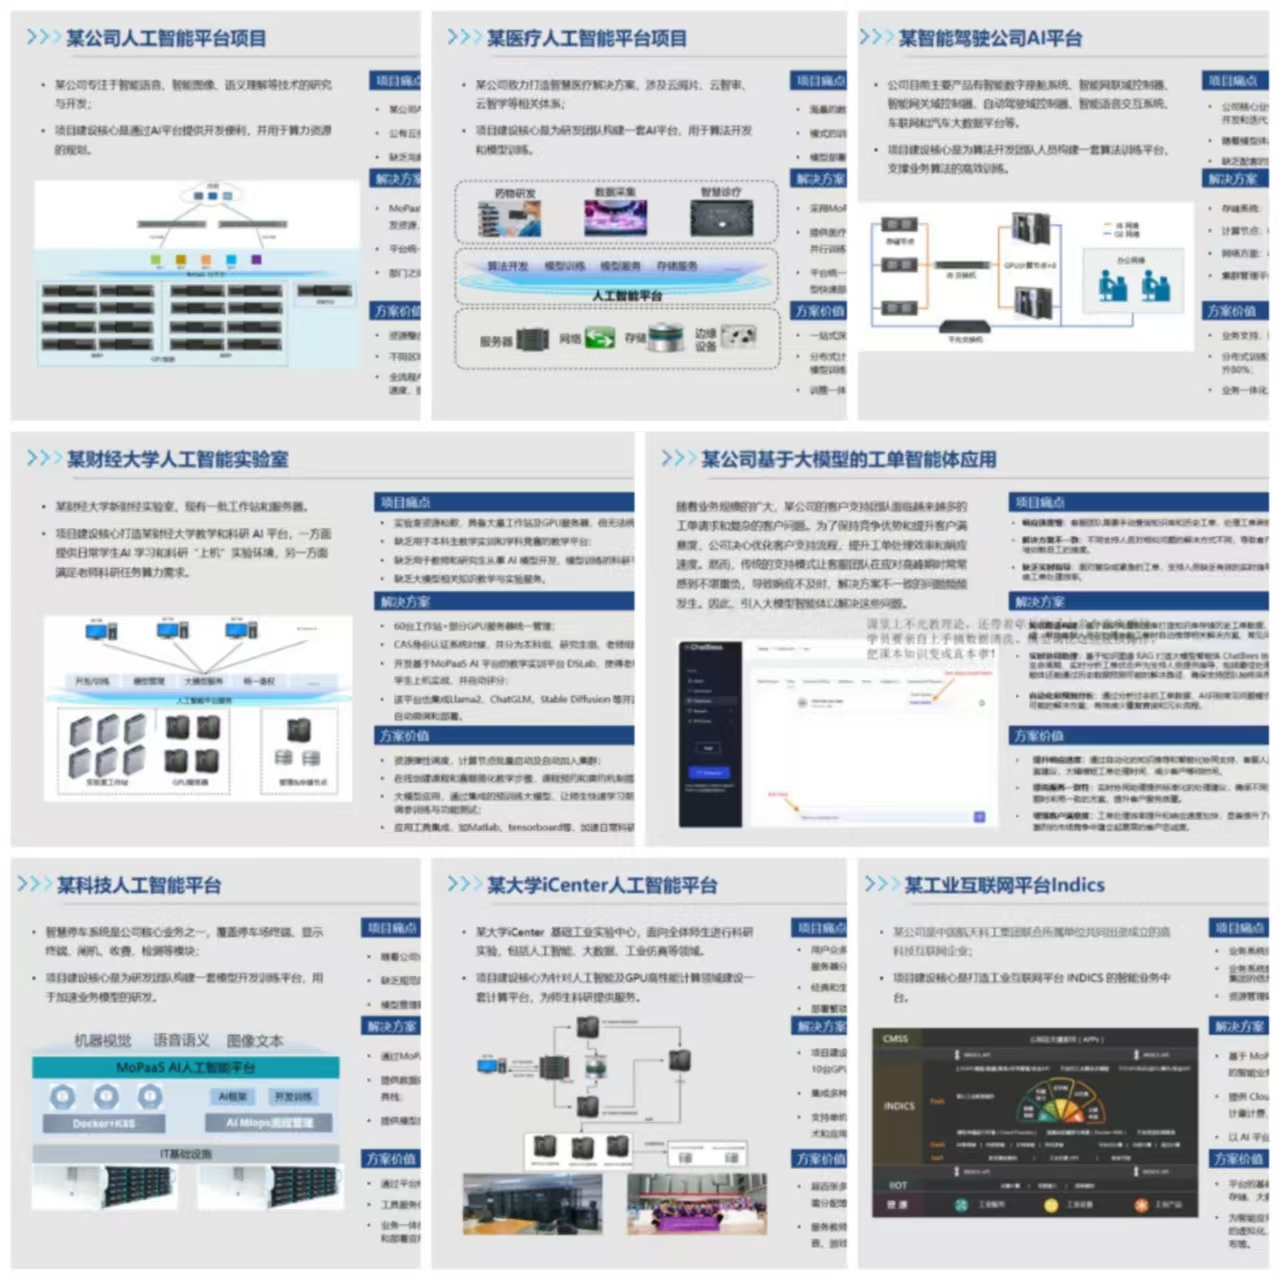
如果说你是以下人群中的其中一类,都可以来智泊AI学习人工智能,找到高薪工作,一次小小的“投资”换来的是终身受益!
应届毕业生:无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。
零基础转型:非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界。
业务赋能 突破瓶颈:传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型。
👉获取方式:
😝有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓
更多推荐

 15
 0
- 0


 已为社区贡献8条内容

所有评论(0)