
SASRec(2018):Self-Attentive Sequential Recommendation及其pytorch代码实现
·
0.前言
在个性化推荐系统的研究中,用户兴趣建模始终是核心挑战之一。随着深度学习的发展,研究者提出了多种模型以挖掘用户的动态偏好。其中,DIN(Deep Interest Network) 和 SASRec(Self-Attentive Sequential Recommendation) 分别代表了推荐系统中两种截然不同的建模路径。
- DIN 所代表的路线,以阿里巴巴提出的一系列兴趣建模网络(如 DIN、DIEN)为代表,聚焦于特征交叉与行为序列的兴趣提取,主要应用于 CTR 预估等精排任务。这条路线强调用户与目标 item 之间的兴趣匹配关系,通过注意力机制对用户历史行为进行加权建模,是工业界 CTR 精排模型的重要发展方向。
- SASRec 所代表的路线主要是针对的是召回的工作,预测用户在未来可能感兴趣的 item。这一类模型更接近 NLP 中的序列建模范式,着重挖掘用户行为序列中的时序依赖关系。SASRec 开创性地将自注意力机制引入推荐系统,催生了后续一系列基于 BERT、GPT 等预训练架构的序列推荐模型(如 BERT4Rec、GPT4Rec)。
虽然这两类模型都以用户行为序列为核心输入,但它们在目标函数、模型结构、应用场景等方面呈现出明显的分化趋势,也分别引领了推荐系统研究中 “匹配建模” 与 “序列建模” 两大范式的演化路径。
论文地址:https://arxiv.org/abs/1808.09781
pytorch实现:GitHub - pmixer/SASRec.pytorch: PyTorch(1.6+) implementation of https://github.com/kang205/SASRec
1. 数据
很多人可能第一次接触序列建模不太清楚输入数据需要如何整理,这里简单讲一下。以ml-1m.txt数据为例,其每一行代表一个用户的行为,第一列为user_id,第二列行为id。
SASRec 是一个 自回归序列推荐模型(autoregressive sequential recommender),训练数据是一个user_id的行为id序列,label是行为id序列的平移。这和其他的时序建模不太一样,其他的时序建模一般是通过滑窗实现。另外,sasrec还需要负样本序列,随机采样不在该用户历史序列中的 item。
class WarpSampler(object):
    def __init__(self, user_train, usernum, itemnum, batch_size=64, maxlen=10, SEED=42):
        self.user_train = user_train
        self.usernum = usernum
        self.itemnum = itemnum
        self.batch_size = batch_size
        self.maxlen = maxlen
        self.SEED = SEED
        self.uids = np.arange(1, usernum + 1, dtype=np.int32)
        np.random.seed(SEED)
        self.counter = 0

    def sample(self, uid):
        while len(self.user_train[uid]) <= 1:
            uid = np.random.randint(1, self.usernum + 1)
        seq = np.zeros([self.maxlen], dtype=np.int32)
        pos = np.zeros([self.maxlen], dtype=np.int32)
        neg = np.zeros([self.maxlen], dtype=np.int32)
        nxt = self.user_train[uid][-1]
        idx = self.maxlen - 1
        ts = set(self.user_train[uid])
        for i in reversed(self.user_train[uid][:-1]):
            seq[idx] = i
            pos[idx] = nxt
            if nxt != 0:
                neg[idx] = random_neq(1, self.itemnum + 1, ts)
            nxt = i
            idx -= 1
            if idx == -1:
                break
        return (uid, seq, pos, neg)

    def __iter__(self):
        while True:
            if self.counter % self.usernum == 0:
                np.random.shuffle(self.uids)
            one_batch = []
            for _ in range(self.batch_size):
                one_batch.append(self.sample(self.uids[self.counter % self.usernum]))
                self.counter += 1
            yield zip(*one_batch)

    def next_batch(self):
        # 保持接口兼容,调用时可以用 next_batch 获取一批数据
        return next(iter(self))
2. 评价指标
2.1. Hit Ratio@K (简称 HT@K)
推荐列表的前 K 个中,是否命中了(包含)用户真实的点击/购买行为(即 test item)。
2.2. NDCG@K(归一化折损累积增益)
如果命中真实 item,越靠前排名越好。考虑了排名位置的推荐评价指标,比 Hit 更细腻。
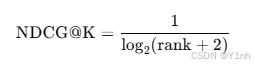
3. 模型结构
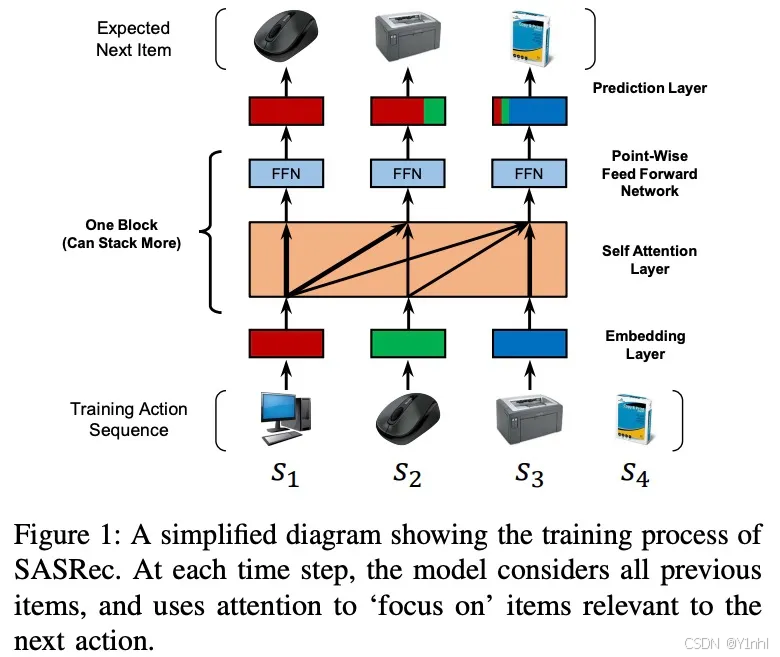
3.1. learnable positional embedding
position embedding(位置嵌入) 是为了解决Transformer架构中的时序顺序信息缺失问题
self.pos_emb = torch.nn.Embedding(args.maxlen+1, args.hidden_units, padding_idx=0)
poss = np.tile(np.arange(1, log_seqs.shape[1] + 1), [log_seqs.shape[0], 1])
poss *= (log_seqs != 0)
seqs += self.pos_emb(torch.LongTensor(poss).to(self.dev))
seqs = self.emb_dropout(seqs)   # [B,T,H]

3.3. FFN
尽管self-attention能将之前item的emebdding使用自适应的权重进行集成,但仍然是一个线性模型,为了加入非线性能力,使用两层的一维卷积
class PointWiseFeedForward(torch.nn.Module):
    def __init__(self, hidden_units, dropout_rate):
        super(PointWiseFeedForward, self).__init__()
        self.conv1 = torch.nn.Conv1d(hidden_units, hidden_units, kernel_size=1)
        self.dropout1 = torch.nn.Dropout(p=dropout_rate)
        self.relu = torch.nn.ReLU()
        self.conv2 = torch.nn.Conv1d(hidden_units, hidden_units, kernel_size=1)
        self.dropout2 = torch.nn.Dropout(p=dropout_rate)

    def forward(self, inputs):
        outputs = self.dropout2(self.conv2(self.relu(self.dropout1(self.conv1(inputs.transpose(-1, -2))))))
        outputs = outputs.transpose(-1, -2) # as Conv1D requires (N, C, Length)
        return outputs
四、完整代码
import sys
import copy
import torch
import random
import numpy as np
from collections import defaultdict
from multiprocessing import Process, Queue

def build_index(dataset_name):
    ui_mat = np.loadtxt('data/%s.txt' % dataset_name, dtype=np.int32)
    n_users = ui_mat[:, 0].max()
    n_items = ui_mat[:, 1].max()

    u2i_index = [[] for _ in range(n_users + 1)]
    i2u_index = [[] for _ in range(n_items + 1)]

    for ui_pair in ui_mat:
        u2i_index[ui_pair[0]].append(ui_pair[1])
        i2u_index[ui_pair[1]].append(ui_pair[0])

    return u2i_index, i2u_index

# sampler for batch generation
def random_neq(l, r, s):
    t = np.random.randint(l, r)
    while t in s:
        t = np.random.randint(l, r)
    return t

class WarpSampler(object):
    def __init__(self, user_train, usernum, itemnum, batch_size=64, maxlen=10, SEED=42):
        self.user_train = user_train
        self.usernum = usernum
        self.itemnum = itemnum
        self.batch_size = batch_size
        self.maxlen = maxlen
        self.SEED = SEED
        self.uids = np.arange(1, usernum + 1, dtype=np.int32)
        np.random.seed(SEED)
        self.counter = 0

    def sample(self, uid):
        while len(self.user_train[uid]) <= 1:
            uid = np.random.randint(1, self.usernum + 1)
        seq = np.zeros([self.maxlen], dtype=np.int32)
        pos = np.zeros([self.maxlen], dtype=np.int32)
        neg = np.zeros([self.maxlen], dtype=np.int32)
        nxt = self.user_train[uid][-1]
        idx = self.maxlen - 1
        ts = set(self.user_train[uid])
        for i in reversed(self.user_train[uid][:-1]):
            seq[idx] = i
            pos[idx] = nxt
            if nxt != 0:
                neg[idx] = random_neq(1, self.itemnum + 1, ts)
            nxt = i
            idx -= 1
            if idx == -1:
                break
        return (uid, seq, pos, neg)

    def __iter__(self):
        while True:
            if self.counter % self.usernum == 0:
                np.random.shuffle(self.uids)
            one_batch = []
            for _ in range(self.batch_size):
                one_batch.append(self.sample(self.uids[self.counter % self.usernum]))
                self.counter += 1
            yield zip(*one_batch)

    def next_batch(self):
        # 保持接口兼容,调用时可以用 next_batch 获取一批数据
        return next(iter(self))

    def close(self):
        # 单线程不需要关闭什么,空实现即可
        pass

# train/val/test data generation
def data_partition(fname):
    usernum = 0
    itemnum = 0
    User = defaultdict(list)
    user_train = {}
    user_valid = {}
    user_test = {}
    # assume user/item index starting from 1
    f = open('data/%s.txt' % fname, 'r')
    for line in f:
        u, i = line.rstrip().split(' ')
        u = int(u)
        i = int(i)
        usernum = max(u, usernum)
        itemnum = max(i, itemnum)
        User[u].append(i)

    for user in User:
        nfeedback = len(User[user])
        if nfeedback < 3:
            user_train[user] = User[user]
            user_valid[user] = []
            user_test[user] = []
        else:
            user_train[user] = User[user][:-2]
            user_valid[user] = []
            user_valid[user].append(User[user][-2])
            user_test[user] = []
            user_test[user].append(User[user][-1])
    return [user_train, user_valid, user_test, usernum, itemnum]

# TODO: merge evaluate functions for test and val set
# evaluate on test set
def evaluate(model, dataset, args):
    [train, valid, test, usernum, itemnum] = copy.deepcopy(dataset)

    NDCG = 0.0
    HT = 0.0
    valid_user = 0.0

    if usernum>10000:
        users = random.sample(range(1, usernum + 1), 10000)
    else:
        users = range(1, usernum + 1)
    for u in users:

        if len(train[u]) < 1 or len(test[u]) < 1: continue

        seq = np.zeros([args.maxlen], dtype=np.int32)
        idx = args.maxlen - 1
        seq[idx] = valid[u][0]
        idx -= 1
        for i in reversed(train[u]):
            seq[idx] = i
            idx -= 1
            if idx == -1: break
        rated = set(train[u])
        rated.add(0)
        item_idx = [test[u][0]]
        for _ in range(100):
            t = np.random.randint(1, itemnum + 1)
            while t in rated: t = np.random.randint(1, itemnum + 1)
            item_idx.append(t)

        predictions = -model.predict(*[np.array(l) for l in [[u], [seq], item_idx]])
        predictions = predictions[0] # - for 1st argsort DESC

        rank = predictions.argsort().argsort()[0].item()

        valid_user += 1

        if rank < 10:
            NDCG += 1 / np.log2(rank + 2)
            HT += 1
        if valid_user % 100 == 0:
            print('.', end="")
            sys.stdout.flush()

    return NDCG / valid_user, HT / valid_user


# evaluate on val set
def evaluate_valid(model, dataset, args):
    [train, valid, test, usernum, itemnum] = copy.deepcopy(dataset)
    NDCG = 0.0
    valid_user = 0.0
    HT = 0.0
    if usernum>10000:
        users = random.sample(range(1, usernum + 1), 10000)
    else:
        users = range(1, usernum + 1)
    for u in users:
        if len(train[u]) < 1 or len(valid[u]) < 1:
            continue
        seq = np.zeros([args.maxlen], dtype=np.int32)
        idx = args.maxlen - 1
        for i in reversed(train[u]):
            seq[idx] = i
            idx -= 1
            if idx == -1:
                break

        rated = set(train[u])
        rated.add(0)
        item_idx = [valid[u][0]]  # validation 的真实点击放进第一个位置
        for _ in range(100):
            t = np.random.randint(1, itemnum + 1)
            while t in rated:
                t = np.random.randint(1, itemnum + 1)
            item_idx.append(t)

        predictions = -model.predict(*[np.array(l) for l in [[u], [seq], item_idx]])
        predictions = predictions[0]

        rank = predictions.argsort().argsort()[0].item()

        valid_user += 1

        if rank < 10:
            NDCG += 1 / np.log2(rank + 2)
            HT += 1
        if valid_user % 100 == 0:
            print('.', end="")
            sys.stdout.flush()
    return NDCG / valid_user, HT / valid_user


import numpy as np
import torch

class PointWiseFeedForward(torch.nn.Module):
    def __init__(self, hidden_units, dropout_rate):
        super(PointWiseFeedForward, self).__init__()
        self.conv1 = torch.nn.Conv1d(hidden_units, hidden_units, kernel_size=1)
        self.dropout1 = torch.nn.Dropout(p=dropout_rate)
        self.relu = torch.nn.ReLU()
        self.conv2 = torch.nn.Conv1d(hidden_units, hidden_units, kernel_size=1)
        self.dropout2 = torch.nn.Dropout(p=dropout_rate)

    def forward(self, inputs):
        outputs = self.dropout2(self.conv2(self.relu(self.dropout1(self.conv1(inputs.transpose(-1, -2))))))
        outputs = outputs.transpose(-1, -2) # as Conv1D requires (N, C, Length)
        return outputs

# pls use the following self-made multihead attention layer
# in case your pytorch version is below 1.16 or for other reasons
# https://github.com/pmixer/TiSASRec.pytorch/blob/master/model.py
class SASRec(torch.nn.Module):
    def __init__(self, user_num, item_num, args):
        super(SASRec, self).__init__()
        self.user_num = user_num
        self.item_num = item_num
        self.dev = args.device
        self.norm_first = args.norm_first

        # TODO: loss += args.l2_emb for regularizing embedding vectors during training
        # https://stackoverflow.com/questions/42704283/adding-l1-l2-regularization-in-pytorch
        self.item_emb = torch.nn.Embedding(self.item_num+1, args.hidden_units, padding_idx=0)
        self.pos_emb = torch.nn.Embedding(args.maxlen+1, args.hidden_units, padding_idx=0)
        self.emb_dropout = torch.nn.Dropout(p=args.dropout_rate)

        self.attention_layernorms = torch.nn.ModuleList() # to be Q for self-attention
        self.attention_layers = torch.nn.ModuleList()
        self.forward_layernorms = torch.nn.ModuleList()
        self.forward_layers = torch.nn.ModuleList()

        self.last_layernorm = torch.nn.LayerNorm(args.hidden_units, eps=1e-8)

        for _ in range(args.num_blocks):
            new_attn_layernorm = torch.nn.LayerNorm(args.hidden_units, eps=1e-8)
            self.attention_layernorms.append(new_attn_layernorm)

            new_attn_layer =  torch.nn.MultiheadAttention(args.hidden_units,
                                                            args.num_heads,
                                                            args.dropout_rate)
            self.attention_layers.append(new_attn_layer)

            new_fwd_layernorm = torch.nn.LayerNorm(args.hidden_units, eps=1e-8)
            self.forward_layernorms.append(new_fwd_layernorm)

            new_fwd_layer = PointWiseFeedForward(args.hidden_units, args.dropout_rate)
            self.forward_layers.append(new_fwd_layer)

            # self.pos_sigmoid = torch.nn.Sigmoid()
            # self.neg_sigmoid = torch.nn.Sigmoid()

    def log2feats(self, log_seqs): # TODO: fp64 and int64 as default in python, trim?
        seqs = self.item_emb(torch.LongTensor(log_seqs).to(self.dev))   # [B,T,H]
        seqs *= self.item_emb.embedding_dim ** 0.5                      # 缩放
        poss = np.tile(np.arange(1, log_seqs.shape[1] + 1), [log_seqs.shape[0], 1])
        # TODO: directly do tensor = torch.arange(1, xxx, device='cuda') to save extra overheads
        poss *= (log_seqs != 0)
        seqs += self.pos_emb(torch.LongTensor(poss).to(self.dev))
        seqs = self.emb_dropout(seqs)   # [B,T,H]

        tl = seqs.shape[1] # time dim len for enforce causality
        attention_mask = ~torch.tril(torch.ones((tl, tl), dtype=torch.bool, device=self.dev))

        for i in range(len(self.attention_layers)):
            seqs = torch.transpose(seqs, 0, 1)
            if self.norm_first:
                x = self.attention_layernorms[i](seqs)
                mha_outputs, _ = self.attention_layers[i](x, x, x,
                                                          attn_mask=attention_mask)
                seqs = seqs + mha_outputs
                seqs = torch.transpose(seqs, 0, 1)
                seqs = seqs + self.forward_layers[i](self.forward_layernorms[i](seqs))
            else:
                mha_outputs, _ = self.attention_layers[i](seqs, seqs, seqs,
                                                          attn_mask=attention_mask)
                seqs = self.attention_layernorms[i](seqs + mha_outputs)
                seqs = torch.transpose(seqs, 0, 1)
                seqs = self.forward_layernorms[i](seqs + self.forward_layers[i](seqs))

        log_feats = self.last_layernorm(seqs) # (U, T, C) -> (U, -1, C)

        return log_feats

    def forward(self, user_ids, log_seqs, pos_seqs, neg_seqs): # for training
        log_feats = self.log2feats(log_seqs) # [B, T]   user_ids hasn't been used yet
        pos_embs = self.item_emb(torch.LongTensor(pos_seqs).to(self.dev))  # [B, T, H]
        neg_embs = self.item_emb(torch.LongTensor(neg_seqs).to(self.dev))

        pos_logits = (log_feats * pos_embs).sum(dim=-1)
        neg_logits = (log_feats * neg_embs).sum(dim=-1)  # [B, T]

        # pos_pred = self.pos_sigmoid(pos_logits)
        # neg_pred = self.neg_sigmoid(neg_logits)
        return pos_logits, neg_logits # pos_pred, neg_pred

    def predict(self, user_ids, log_seqs, item_indices): # for inference
        log_feats = self.log2feats(log_seqs) # user_ids hasn't been used yet

        final_feat = log_feats[:, -1, :] # only use last QKV classifier, a waste

        item_embs = self.item_emb(torch.LongTensor(item_indices).to(self.dev)) # (U, I, C)

        logits = item_embs.matmul(final_feat.unsqueeze(-1)).squeeze(-1)

        # preds = self.pos_sigmoid(logits) # rank same item list for different users
        return logits # preds # (U, I)

import os
import time
import torch
import argparse
# from model import SASRec
# from utils import *

def str2bool(s):
    if s not in {'false', 'true'}:
        raise ValueError('Not a valid boolean string')
    return s == 'true'

parser = argparse.ArgumentParser()
parser.add_argument('--dataset', default="ml-1m")
parser.add_argument('--train_dir', default="test")
parser.add_argument('--batch_size', default=128, type=int)
parser.add_argument('--lr', default=0.001, type=float)
parser.add_argument('--maxlen', default=200, type=int)
parser.add_argument('--hidden_units', default=50, type=int)
parser.add_argument('--num_blocks', default=2, type=int)
parser.add_argument('--num_epochs', default=1000, type=int)
parser.add_argument('--num_heads', default=1, type=int)
parser.add_argument('--dropout_rate', default=0.2, type=float)
parser.add_argument('--l2_emb', default=0.0, type=float)
parser.add_argument('--device', default='cuda', type=str)
parser.add_argument('--inference_only', default=False, type=str2bool)
parser.add_argument('--state_dict_path', default=None, type=str)
parser.add_argument('--norm_first', action='store_true', default=False)
args = parser.parse_args([])

if not os.path.isdir(args.dataset + '_' + args.train_dir):
    os.makedirs(args.dataset + '_' + args.train_dir)
with open(os.path.join(args.dataset + '_' + args.train_dir, 'args.txt'), 'w') as f:
    f.write('\n'.join([str(k) + ',' + str(v) for k, v in sorted(vars(args).items(), key=lambda x: x[0])]))
f.close()

u2i_index, i2u_index = build_index(args.dataset)
dataset = data_partition(args.dataset)

[user_train, user_valid, user_test, usernum, itemnum] = dataset
# num_batch = len(user_train) // args.batch_size # tail? + ((len(user_train) % args.batch_size) != 0)
num_batch = (len(user_train) - 1) // args.batch_size + 1
cc = 0.0
for u in user_train:
    cc += len(user_train[u])
print('average sequence length: %.2f' % (cc / len(user_train)))

f = open(os.path.join(args.dataset + '_' + args.train_dir, 'log.txt'), 'w')
f.write('epoch (val_ndcg, val_hr) (test_ndcg, test_hr)\n')
print("get_1")

sampler = WarpSampler(user_train, usernum, itemnum, batch_size=args.batch_size, maxlen=args.maxlen)
model = SASRec(usernum, itemnum, args).to(args.device) # no ReLU activation in original SASRec implementation?

for name, param in model.named_parameters():
    try:
        torch.nn.init.xavier_normal_(param.data)
    except:
        pass # just ignore those failed init layers
print("get_2")

model.pos_emb.weight.data[0, :] = 0
model.item_emb.weight.data[0, :] = 0

# this fails embedding init 'Embedding' object has no attribute 'dim'
# model.apply(torch.nn.init.xavier_uniform_)
model.train() # enable model training
epoch_start_idx = 1
if args.state_dict_path is not None:
    try:
        model.load_state_dict(torch.load(args.state_dict_path, map_location=torch.device(args.device)))
        tail = args.state_dict_path[args.state_dict_path.find('epoch=') + 6:]
        epoch_start_idx = int(tail[:tail.find('.')]) + 1
    except: # in case your pytorch version is not 1.6 etc., pls debug by pdb if load weights failed
        print('failed loading state_dicts, pls check file path: ', end="")
        print(args.state_dict_path)
        print('pdb enabled for your quick check, pls type exit() if you do not need it')
        import pdb; pdb.set_trace()

if args.inference_only:
    model.eval()
    t_test = evaluate(model, dataset, args)
    print('test (NDCG@10: %.4f, HR@10: %.4f)' % (t_test[0], t_test[1]))

# ce_criterion = torch.nn.CrossEntropyLoss()
# https://github.com/NVIDIA/pix2pixHD/issues/9 how could an old bug appear again...
bce_criterion = torch.nn.BCEWithLogitsLoss() # torch.nn.BCELoss()
adam_optimizer = torch.optim.Adam(model.parameters(), lr=args.lr, betas=(0.9, 0.98))
best_val_ndcg, best_val_hr = 0.0, 0.0
best_test_ndcg, best_test_hr = 0.0, 0.0
T = 0.0
t0 = time.time()
for epoch in range(epoch_start_idx, args.num_epochs + 1):
    if args.inference_only: break # just to decrease identition
    for step in range(num_batch): # tqdm(range(num_batch), total=num_batch, ncols=70, leave=False, unit='b'):
        u, seq, pos, neg = sampler.next_batch() # tuples to ndarray
        u, seq, pos, neg = np.array(u), np.array(seq), np.array(pos), np.array(neg)
        pos_logits, neg_logits = model(u, seq, pos, neg)
        pos_labels, neg_labels = torch.ones(pos_logits.shape, device=args.device),torch.zeros(neg_logits.shape, device=args.device)
        # print("\neye ball check raw_logits:"); print(pos_logits); print(neg_logits) # check pos_logits > 0, neg_logits < 0
        adam_optimizer.zero_grad()

        indices = np.where(pos != 0)
        loss = bce_criterion(pos_logits[indices], pos_labels[indices])
        loss += bce_criterion(neg_logits[indices], neg_labels[indices])

        # valid_count = indices[0].shape[0]  # 有效位置数量
        # loss = bce_criterion(pos_logits[indices], pos_labels[indices])
        # loss += bce_criterion(neg_logits[indices], neg_labels[indices])
        # loss = loss / valid_count  # 加这一行做归一化

        for param in model.item_emb.parameters():
            loss += args.l2_emb * torch.norm(param)
        loss.backward()
        adam_optimizer.step()
        print("loss in epoch {} iteration {}: {}".format(epoch, step, loss.item())) # expected 0.4~0.6 after init few epochs

    if epoch % 20 == 0:
        model.eval()
        t1 = time.time() - t0
        T += t1
        print('Evaluating', end='')
        t_test = evaluate(model, dataset, args)
        t_valid = evaluate_valid(model, dataset, args)
        print('epoch:%d, time: %f(s), valid (NDCG@10: %.4f, HR@10: %.4f), test (NDCG@10: %.4f, HR@10: %.4f)'
                % (epoch, T, t_valid[0], t_valid[1], t_test[0], t_test[1]))

        if t_valid[0] > best_val_ndcg or t_valid[1] > best_val_hr or t_test[0] > best_test_ndcg or t_test[1] > best_test_hr:
            best_val_ndcg = max(t_valid[0], best_val_ndcg)
            best_val_hr = max(t_valid[1], best_val_hr)
            best_test_ndcg = max(t_test[0], best_test_ndcg)
            best_test_hr = max(t_test[1], best_test_hr)
            folder = args.dataset + '_' + args.train_dir
            fname = 'SASRec.epoch={}.lr={}.layer={}.head={}.hidden={}.maxlen={}.pth'
            fname = fname.format(epoch, args.lr, args.num_blocks, args.num_heads, args.hidden_units, args.maxlen)
            torch.save(model.state_dict(), os.path.join(folder, fname))

        f.write(str(epoch) + ' ' + str(t_valid) + ' ' + str(t_test) + '\n')
        f.flush()
        t0 = time.time()
        model.train()

    if epoch == args.num_epochs:
        folder = args.dataset + '_' + args.train_dir
        fname = 'SASRec.epoch={}.lr={}.layer={}.head={}.hidden={}.maxlen={}.pth'
        fname = fname.format(args.num_epochs, args.lr, args.num_blocks, args.num_heads, args.hidden_units, args.maxlen)
        torch.save(model.state_dict(), os.path.join(folder, fname))

f.close()
sampler.close()
print("Done")
更多推荐


 34
 0
- 0


 已为社区贡献14条内容

所有评论(0)