
完整的pytorch模型代码
·
以上是原文,以下是笔记
本文内容涉及完整的模型训练流程,包括:数据集的加载,模型的创建与训练,tensorboard面板可视化损失变化/精确度变化,是否使用cpu训练,记录开始结束时间等(包含注释,如果有不理解的可以看前几篇文章,注释更丰富)
先介绍下argmax():
若outpus=[[0.1,0.3],
[0.7,0.1],
[0.5,0.8]]
则outputs.argmax(0)=[1,2] outputs.argmax(1)=[1,0,1]
可以看出一个是纵向的,一个是横向的
import time

import torch
import torchvision
from torch import nn
from torch.nn import Conv2d, MaxPool2d, Flatten, Linear, ReLU, Sequential
from torch.utils.data import DataLoader
from torch.utils.tensorboard import SummaryWriter

# 说明需要对数据做出哪些转换
dataset_transform=torchvision.transforms.Compose(
    [torchvision.transforms.ToTensor()]
)

# 加载数据集
batch_size=64
train_set=torchvision.datasets.CIFAR10(root="./dataset",train=True,transform=dataset_transform,download=True)
train_loader=DataLoader(dataset=train_set,batch_size=64,shuffle=True,num_workers=0,drop_last=True)
test_set=torchvision.datasets.CIFAR10(root="./dataset",train=False,transform=dataset_transform,download=True)
test_loader=DataLoader(dataset=test_set,batch_size=64,shuffle=True,num_workers=0,drop_last=False)
# download=True 这一项永远设置成True就行,因为如果没下载的话会自动下载,下载过的话不会重复下载

class MyModule(nn.Module):
    def __init__(self):
        super(MyModule,self).__init__()
        self.model1=Sequential(
            Conv2d(in_channels=3, out_channels=6, kernel_size=3, stride=1, padding=0),
            MaxPool2d(kernel_size=3, ceil_mode=False),
            Flatten(),
            Linear(600, 64),
            ReLU(),
            Linear(64, 10)
        )

    def forward(self,x):
        x=self.model1(x)
        return x

mymodule=MyModule()
# 如果想使用GPU训练的话,要把model loss data 都放在GPU上
# 有两种方式
# 方式一:
device=torch.device("cuda" if torch.cuda.is_available() else "cpu")
mymodule.to(device)
# 方式二:
# if torch.cuda.is_available():
#     mymodule.cuda()
writer=SummaryWriter("logs")
loss=nn.CrossEntropyLoss() #交叉熵损失
# 方式一:
loss.to(device)
# 方式二:
# if torch.cuda.is_available():
#     loss.cuda()
optim=torch.optim.SGD(mymodule.parameters(),lr=0.01)
# 前一个参数指明需要更新的参数是那些 后一参数是指学习率learning rate
# 记录开始时间
start_time=time.time()
for epoch in range(4):
    print("------------epoch={}-----------".format(epoch))
    total_loss=0
    # 某些东西在训练和验证的时候不一样 比如说dropout,训练的时候有,验证的时候没有
    # 写模型的时候都加上这句话,不会出错
    mymodule.train()
    for idx,(imgs,targets) in enumerate(train_loader):
        # 方式一:
        imgs,targets=imgs.to(device),targets.to(device)
        # 方式二:
        # if torch.cuda.is_available():
        #     imgs, targets = imgs.cuda(),targets.cuda()
        outputs = mymodule(imgs) #output:64*10
        result_loss=loss(outputs,targets)
        optim.zero_grad() # 把梯度清零
        result_loss.backward() # 反向传播计算梯度
        optim.step() # 根据反向传播计算出的梯度对参数进行更新
        # 在同一epoch下,每经过100次更新,打印一次损失变化
        if idx%100==0:
            print("idx={},result_loss={}".format(idx, result_loss))
            # 可视化损失变化
            writer.add_scalar("epoch{}_loss".format(epoch),result_loss,idx)
        total_loss+=result_loss
    # 每epoch,打印一次损失变化
    print("epoch{}_train_loss={}".format(epoch, total_loss))
    writer.add_scalar("train_loss_epoch",total_loss,epoch)
    # 进入验证阶段(由于没有验证集,所以使用测试集代替验证集)
    test_loss=0
    accuracy=0
    mymodule.eval()
    # 验证阶段不进行梯度更新
    with torch.no_grad():
        for imgs,targets in test_loader:
            imgs, targets = imgs.to(device), targets.to(device)
            outputs = mymodule(imgs)  # output:64*10
            accuracy+=(outputs.argmax(1)==targets).sum()
            test_loss += loss(outputs, targets)
            # 每epoch,打印一次在测试集上的损失变化
        print("epoch{}_test_loss={}".format(epoch, test_loss))
        print("epoch{}_accuracy={}".format(epoch, accuracy/len(test_set)))
        writer.add_scalar("test_accuracy_epoch", accuracy, epoch)
# 记录结束时间
end_time=time.time()
print("time={}".format(end_time-start_time))
writer.close()
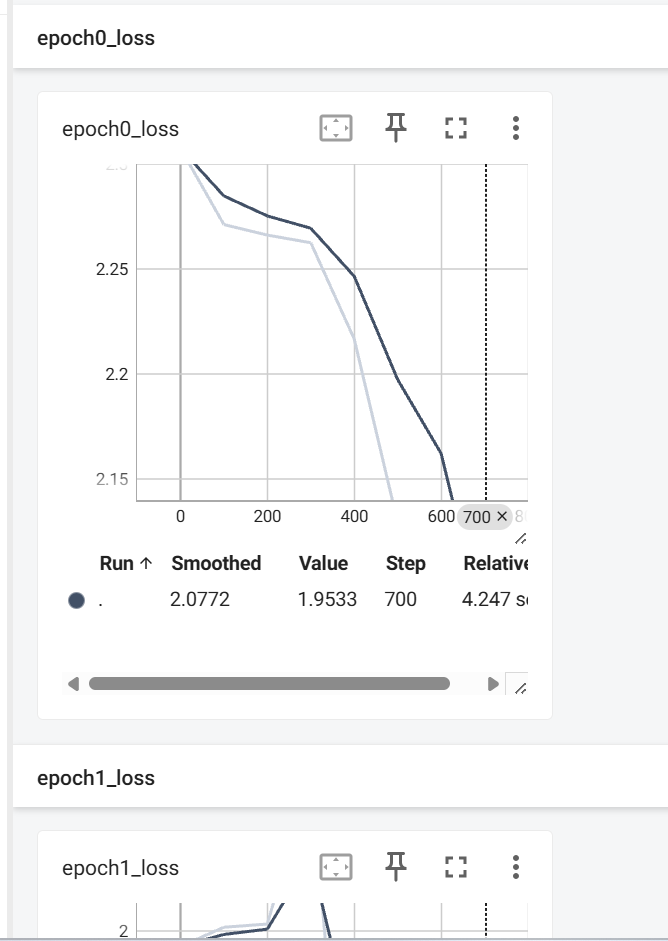
结果:


 也可以把模型和其它部分分开写:
model.py:
from torch import nn
from torch.nn import Sequential, Conv2d, MaxPool2d, Flatten, Linear, ReLU


class MyModule(nn.Module):
    def __init__(self):
        super(MyModule,self).__init__()
        self.model1=Sequential(
            Conv2d(in_channels=3, out_channels=6, kernel_size=3, stride=1, padding=0),
            MaxPool2d(kernel_size=3, ceil_mode=False),
            Flatten(),
            Linear(600, 64),
            ReLU(),
            Linear(64, 10)
        )

    def forward(self,x):
        x=self.model1(x)
        return x
mymodule=MyModule()
train_val.py:
import time
import torch
import torchvision
from torch.utils.data import DataLoader
from torch.utils.tensorboard import SummaryWriter

#注意一定要有这一步
from model import *
# 说明需要对数据做出哪些转换
dataset_transform=torchvision.transforms.Compose(
    [torchvision.transforms.ToTensor()]
)

# 加载数据集
batch_size=64
train_set=torchvision.datasets.CIFAR10(root="./dataset",train=True,transform=dataset_transform,download=True)
train_loader=DataLoader(dataset=train_set,batch_size=64,shuffle=True,num_workers=0,drop_last=True)
test_set=torchvision.datasets.CIFAR10(root="./dataset",train=False,transform=dataset_transform,download=True)
test_loader=DataLoader(dataset=test_set,batch_size=64,shuffle=True,num_workers=0,drop_last=False)
# download=True 这一项永远设置成True就行,因为如果没下载的话会自动下载,下载过的话不会重复下载


# 如果想使用GPU训练的话,要把model loss data 都放在GPU上
# 有两种方式
# 方式一:
device=torch.device("cuda" if torch.cuda.is_available() else "cpu")
mymodule.to(device)
# 方式二:
# if torch.cuda.is_available():
#     mymodule.cuda()
writer=SummaryWriter("logs")
loss=nn.CrossEntropyLoss() #交叉熵损失
# 方式一:
loss.to(device)
# 方式二:
# if torch.cuda.is_available():
#     loss.cuda()
optim=torch.optim.SGD(mymodule.parameters(),lr=0.01)
# 前一个参数指明需要更新的参数是那些 后一参数是指学习率learning rate
# 记录开始时间
start_time=time.time()
for epoch in range(4):
    print("------------epoch={}-----------".format(epoch))
    total_loss=0
    # 某些东西在训练和验证的时候不一样 比如说dropout,训练的时候有,验证的时候没有
    # 写模型的时候都加上这句话,不会出错
    mymodule.train()
    for idx,(imgs,targets) in enumerate(train_loader):
        # 方式一:
        imgs,targets=imgs.to(device),targets.to(device)
        # 方式二:
        # if torch.cuda.is_available():
        #     imgs, targets = imgs.cuda(),targets.cuda()
        outputs = mymodule(imgs) #output:64*10
        result_loss=loss(outputs,targets)
        optim.zero_grad() # 把梯度清零
        result_loss.backward() # 反向传播计算梯度
        optim.step() # 根据反向传播计算出的梯度对参数进行更新
        # 在同一epoch下,每经过100次更新,打印一次损失变化
        if idx%100==0:
            print("idx={},result_loss={}".format(idx, result_loss))
            # 可视化损失变化
            writer.add_scalar("epoch{}_loss".format(epoch),result_loss,idx)
        total_loss+=result_loss
    # 每epoch,打印一次损失变化
    print("epoch{}_train_loss={}".format(epoch, total_loss))
    writer.add_scalar("train_loss_epoch",total_loss,epoch)
    # 进入验证阶段(由于没有验证集,所以使用测试集代替验证集)
    test_loss=0
    accuracy=0
    mymodule.eval()
    # 验证阶段不进行梯度更新
    with torch.no_grad():
        for imgs,targets in test_loader:
            imgs, targets = imgs.to(device), targets.to(device)
            outputs = mymodule(imgs)  # output:64*10
            accuracy+=(outputs.argmax(1)==targets).sum()
            test_loss += loss(outputs, targets)
            # 每epoch,打印一次在测试集上的损失变化
        print("epoch{}_test_loss={}".format(epoch, test_loss))
        print("epoch{}_accuracy={}".format(epoch, accuracy/len(test_set)))
        writer.add_scalar("test_accuracy_epoch", accuracy, epoch)
# 记录结束时间
end_time=time.time()
print("time={}".format(end_time-start_time))
writer.close()
更多推荐

 8
 0
- 0


 已为社区贡献2条内容

所有评论(0)