
适用于嵌入式设备的TensorFlow:TensorFlow修剪
概述
深度学习以其在图像识别、自然语言处理等任务中的卓越表现给各个领域带来了革命。然而,随着深度学习模型的复杂性和规模的增长,它们的计算成本变得昂贵且内存密集,使得它们在资源受限的设备上的部署变得具有挑战性。TensorFlow 剪枝是一种有效的优化技术,可以在不影响性能的情况下减小模型大小。在这篇博客中,我们将探讨 TensorFlow 剪枝的概念、其底层技术、剪枝感知训练、TensorFlow 剪枝工具、TensorFlow Lite 的部署、模型大小和准确性之间的权衡、评估量化模型,以及 TensorFlow Lite 的局限性和未来发展。修剪。
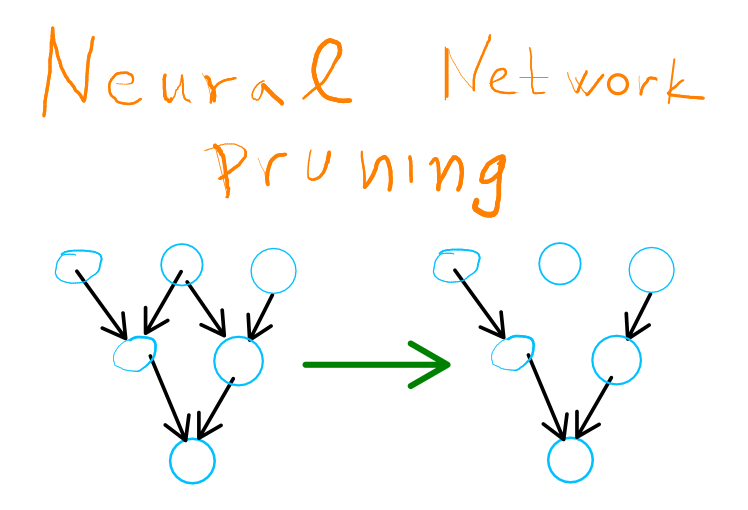
什么是修剪?
剪枝是深度学习和神经网络背景下使用的一种优化技术。它涉及有选择地从神经网络中删除某些被认为对模型性能不太重要或影响较小的组件。剪枝的目标是减少神经网络的大小和复杂性,使其计算效率更高、内存友好且推理速度更快。
在神经网络中,权重、连接或神经元等参数负责捕获输入数据中的模式和关系。然而,并非所有参数对模型的输出或预测精度都有同等的贡献。某些参数可能对模型的整体性能影响不大,删除它们可以产生更紧凑、更高效的模型,而不会显着牺牲准确性。这正是剪枝的可能。

修剪技术
采用各种剪枝技术来有效减小模型大小:
1. 权重修剪:
该技术涉及去除幅度较小或接近于零的个体权重。这些权重被认为对模型的性能不太重要,可以安全地修剪。
# Define the pruning schedule
pruning_params = {'pruning_schedule': sparsity.PolynomialDecay(initial_sparsity=0.50,
                                                             final_sparsity=0.90,
                                                             begin_step=1000,
                                                             end_step=3000)}

# Create the pruned model
pruned_model = sparsity.prune_low_magnitude(model, **pruning_params)
在上面,我们使用 PolynomialDecay 函数定义剪枝计划,从 50% 稀疏度开始,在训练步骤 1000 到 3000 之间逐渐增加到 90%。然后,我们使用prune_low_magnitude创建剪枝模型,它将权重剪枝应用于基于修剪时间表。
2. 过滤器修剪:
整个过滤器(包括卷积层中的神经元集)根据某些标准被删除。激活值低或对准确性贡献最小的过滤器将被修剪。
# pruning schedule for filter pruning
pruning_params = {
    'pruning_schedule': sparsity.PolynomialDecay(initial_sparsity=0.50,
                                                 final_sparsity=0.90,
                                                 begin_step=1000,
                                                 end_step=3000,
                                                 frequency=100)
上面的代码中应用了频率,并通过删除整个过滤器及其内核,删除过滤器意味着该过滤器生成的整个特征图将在推理过程中被丢弃。过滤器剪枝会导致更加结构化的稀疏模式,因为整个过滤器都被删除,从而产生更多的零值权重。
3.神经元修剪:
神经元修剪需要去除密集(完全连接)层中的整个神经元。对模型输出影响很小的神经元被修剪。
# Perform neuron pruning
# Assume we want to prune the entire second layer (64 neurons)
# We can set the weights of the second layer to zero to effectively remove the neurons
pruned_model = tf.keras.Sequential([
    layers.Input(shape=(784,)),
    layers.Dense(128, activation='relu'),
    layers.Dense(64, activation='relu'),
    layers.Dense(10, activation='softmax')
])

# Copy the trained weights from the original model to the pruned model
for i in range(len(model.layers)):
    pruned_model.layers[i].set_weights(model.layers[i].get_weights())

# Set the weights of the second layer to zero for pruning
pruned_model.layers[2].set_weights([np.zeros_like(pruned_model.layers[2].get_weights()[0]),
                                    np.zeros_like(pruned_model.layers[2].get_weights()[1])])
- 步骤1:
在上面的代码中,在这段代码中,我们首先创建一个简单的三层全连接神经网络模型:两个隐藏层分别有128个和64个神经元,以及一个有10个神经元的输出层。我们创建一个新的剪枝模型, pruned_model,具有相同的架构。 - 步骤2:
为了执行神经元修剪,我们将第二层(64 个神经元)的权重设置为零。这有效地从第二层中删除了神经元以及它们与后续层的相应连接。 - 步骤3:
然后,我们将训练后的权重从原始模型复制到剪枝后的模型中,以保留剩余神经元的训练后的权重。将第二层的权重设置为零后,我们编译剪枝模型并评估其在测试集上的准确性。
剪枝可以在神经网络训练期间或之后进行。在训练过程中,可以采用剪枝感知技术来使模型适应剪枝后的结构并保持性能。或者,修剪可以作为单独的步骤在训练后应用。
让我们通过简单的代码来了解后加权剪枝
import tensorflow as tf
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import Dense
from tensorflow.keras.optimizers import Adam
from tensorflow.keras.datasets import mnist
import numpy as np

# Load the MNIST dataset
(x_train, y_train), (x_test, y_test) = mnist.load_data()
x_train, x_test = x_train / 255.0, x_test / 255.0

# Create a simple fully connected neural network model
model = Sequential([
    Dense(128, activation='relu', input_shape=(784,)),
    Dense(64, activation='relu'),
    Dense(10, activation='softmax')
])

# Compile the model
model.compile(optimizer=Adam(learning_rate=0.001),
              loss='sparse_categorical_crossentropy',
              metrics=['accuracy'])

# Train the model
model.fit(x_train.reshape(-1, 784), y_train, epochs=5, batch_size=32)

# Evaluate the model's accuracy before pruning
_, accuracy = model.evaluate(x_test.reshape(-1, 784), y_test)
print("Accuracy before pruning:", accuracy)
# ... (Previous code)

# Function to apply weight pruning to a model
def apply_weight_pruning(model, pruning_percentage):
    # Get all the trainable layers of the model
    layers_to_prune = [layer for layer in model.layers if isinstance(layer, tf.keras.layers.Dense)]

    # Calculate the number of weights to prune for each layer
    total_params = sum(np.prod(layer.get_weights()[0].shape) + np.prod(layer.get_weights()[1].shape) for layer in layers_to_prune)
    num_params_to_prune = int(total_params * pruning_percentage)

    # Flatten and sort the weights and biases across all layers
    all_weights_biases = [np.concatenate([layer.get_weights()[0].flatten(), layer.get_weights()[1].flatten()]) for layer in layers_to_prune]
    all_weights_biases = np.concatenate(all_weights_biases)
    sorted_weights_biases = np.sort(np.abs(all_weights_biases))

    # Find the threshold weight value for pruning
    threshold_weight_bias = sorted_weights_biases[num_params_to_prune]

    # Apply pruning by setting low magnitude weights to zero
    for layer in layers_to_prune:
        weights = layer.get_weights()[0]
        biases = layer.get_weights()[1]
        pruned_weights = np.where(np.abs(weights) < threshold_weight_bias, 0.0, weights)
        pruned_biases = np.where(np.abs(biases) < threshold_weight_bias, 0.0, biases)
        layer.set_weights([pruned_weights, pruned_biases])

# ... (The rest of the code)


# Apply weight pruning with a given pruning percentage
pruning_percentage = 0.5
apply_weight_pruning(model, pruning_percentage)

# Evaluate the model's accuracy after pruning
_, accuracy = model.evaluate(x_test.reshape(-1, 784), y_test)
print("Accuracy after pruning:", accuracy)
在上面的代码中,我们引入了两个新函数,calculate_importance_scores和apply_weighted_pruning。calculate_importance_scores函数用于计算权重的重要性分数(您可以在此处选择您想要使用的方法)。apply_weighted_pruning 函数在执行剪枝时会考虑这些重要性分数。
请注意,实施适当的加权剪枝技术可能会更加复杂,并且需要仔细考虑重要性指标、剪枝率和迭代再训练,以实现更好的模型性能。

上面是剪枝前代码的输出

上面是代码修剪后的输出
修剪的主要好处包括:
- 减小模型大小:
修剪消除了非必要的组件,从而形成需要更少内存和存储的更小的模型。 - 更快的推理:
较小的模型导致更快的推理时间,使它们更适合实时应用程序和资源受限的设备。 - 正则化:
剪枝可以作为正则化的一种形式,防止过度拟合并提高对未见数据的泛化能力。
然而,在修剪程度和保持模型精度之间取得平衡至关重要。如果没有适当的技术(例如修剪感知训练),激进的修剪可能会导致严重的准确性损失。如果应用得当,剪枝可以为优化深度学习模型并使其在实际应用中更加高效提供宝贵的工具。所以 Pruning-Aware 训练对于模型 Pruning 很重要。
修剪意识培训
剪枝感知训练涉及训练神经网络模型,使其能够适应剪枝过程并从权重、过滤器或神经元剪枝引起的任何性能下降中恢复。修剪感知训练有不同的方法,一些常见的类型包括:
1、剪枝后微调:
在这种方法中,对预训练的模型进行修剪,然后使用原始数据集或训练数据的子集上的较小学习率对修剪后的模型进行微调。微调允许模型调整其剩余权重,以补偿删除的权重并适应修剪引入的稀疏性。
# Perform pruning-aware fine-tuning
# Lower the learning rate for fine-tuning
optimizer = tf.keras.optimizers.Adam(learning_rate=0.0001)
在上面的代码中,剪枝后,我们通过使用较小的学习率(0.0001)再次在数据集上训练剪枝模型来执行剪枝感知微调,以使模型适应剪枝变化。此微调步骤可帮助模型从修剪引起的任何性能下降中恢复。
2.迭代剪枝:
迭代剪枝涉及以迭代方式多次应用剪枝和重新训练。该过程包括剪枝、重新训练剪枝后的模型、再次剪枝,并重复该循环,直到达到所需的稀疏度或性能稳定。
pruning_schedule = sparsity.PolynomialDecay(initial_sparsity=0.50,
                                       final_sparsity=0.90,
                                       begin_step=1000,
                                       end_step=3000,
                                       frequency=100)

for i in range(3):
# Prune the model
pruned_model = sparsity.prune_low_magnitude(model, pruning_schedule)

# Retain the original weights and compile the pruned model
for j in range(len(model.layers)):
    pruned_model.layers[j].set_weights(model.layers[j].get_weights())
pruned_model.compile(optimizer='adam', loss='sparse_categorical_crossentropy', metrics=['accuracy'])

# Train the pruned model
pruned_model.fit(x_train, y_train, epochs=5, batch_size=32, validation_split=0.1)

# Update the model with pruned weights
for k in range(len(model.layers)):
    model.layers[k].set_weights(pruned_model.layers[k].get_weights())
迭代剪枝过程由 3 次迭代组成(对于 range(3) 中的 i)。在每次迭代中,我们使用 sparsity.prune_low_magnitude 函数和修剪计划来执行权重修剪。剪枝后,我们将剪枝后的模型中的剪枝权重复制到原始模型中并再次编译。
然后,我们在每次迭代中在数据集上再训练五个时期的修剪模型。每次迭代后,模型都会适应修剪变化并从性能下降中恢复。
3. 逐步修剪:
逐步剪枝涉及在训练过程中逐渐增加稀疏度,而不是从一开始就应用固定的稀疏度。这种方法使模型能够适应逐渐增加的稀疏度,从而获得更稳定的性能。
for step in range(5000):
if step % 100 == 0:
    pruned_model = sparsity.prune_low_magnitude(model, pruning_schedule)

    # Retain the original weights and compile the pruned model
    for i in range(len(model.layers)):
        pruned_model.layers[i].set_weights(model.layers[i].get_weights())
    pruned_model.compile(optimizer='adam', loss='sparse_categorical_crossentropy', metrics=['accuracy'])

    # Train the pruned model for a few steps (optional)
    pruned_model.fit(x_train, y_train, epochs=1, batch_size=32, validation_split=0.1)

    # Update the model with pruned weights
    for i in range(len(model.layers)):
        model.layers[i].set_weights(pruned_model.layers[i].get_weights())
逐步修剪过程涉及在训练期间逐渐增加稀疏程度。在循环中,我们检查当前步骤,如果它是 100 的倍数(由步骤 % 100 == 0 指定),我们使用剪枝计划中的当前稀疏级别对模型应用权重剪枝。在训练期间定期重复修剪过程。
在每个修剪步骤之后,我们将修剪后的权重从修剪后的模型复制到原始模型并再次编译。我们可以选择对剪枝模型进行几个步骤的训练,以使其适应剪枝更改,然后再使用剪枝权重更新原始模型。
循环继续,直到达到所需的步数(本例中为 5000),从而允许稀疏级别在训练期间逐渐增加。
TensorFlow 剪枝工具
TensorFlow 修剪工具可供新手和高级开发人员使用,用于优化机器学习模型的部署和执行。重要的工具之一是模型优化工具包。
TensorFlow 的模型优化工具包 (MOT)已广泛用于将 TensorFlow 模型转换/优化为 TensorFlow Lite 模型,该模型具有更小的尺寸、更好的性能和可接受的精度,可以在移动和 IoT 设备上运行。目前,他们还致力于将 MOT 技术和工具扩展到 TensorFlow Lite 之外,以支持 TensorFlow SavedModel。该工具包提供了一系列用于优化和修剪深度学习模型的功能。让我们深入研究它提供的一些关键工具和功能:
-
权重修剪:
Tfmot 可以修剪模型中的各个权重。权重修剪涉及识别和删除小量级的权重,通常对模型的性能不太重要。这样做可以减小模型的大小,而不会显着降低准确性。 -
结构化剪枝:
结构化剪枝超越了个体权重剪枝,通过从模型中删除整个神经元、通道或其他结构化组件。这可以带来更高的模型效率。tfmot 中的 tfmot.sparsity.keras 模块有助于结构化修剪,并允许用户定义跨不同层的稀疏模式。 -
剪枝回调:
Tfmot 支持将剪枝集成到训练过程中。这是通过自定义回调来实现的,该回调可以在训练期间将修剪掩码应用于模型的权重。这种动态方法确保模型随着时间的推移适应修剪过程。 -
微调:
剪枝后,通常会进行微调以恢复剪枝过程中丢失的一些精度。微调涉及再次在数据上训练修剪后的模型,使其能够重新学习重要的连接并适应变化。 -
量化:
虽然严格来说不是一种修剪技术,但 tfmot 还提供了量化工具,通过使用较低的权重和激活精度来减少内存和计算需求。
模型修剪工具的好处
TensorFlow 模型剪枝工具为深度学习从业者和研究人员带来了几个好处:
-
效率:
修剪后的模型在内存使用和推理速度方面更加高效,使其适合部署在边缘设备、移动应用程序和实时系统上。 -
节省资源:
较小的模型需要较少的计算资源来进行训练和部署,这可以节省成本和更环保的人工智能应用。 -
**部署灵活性
修剪后的模型更适合在计算资源有限的环境中部署,从而支持更广泛的应用程序。
使用 TFLite 修剪模型
TensorFlow Lite (TFLite) 是 TensorFlow 的优化版本,专为移动和边缘设备设计。TFLite 支持部署修剪模型以在资源受限的平台上进行推理,使其成为现实应用程序的合适选择。修剪并选择性地重新训练模型后,将修剪后的模型转换为 TensorFlow Lite 格式,以便在移动或边缘设备上部署。TensorFlow Lite 提供了一个转换器工具来促进这种转换。
# Convert the pruned model to TensorFlow Lite format
converter = tf.lite.TFLiteConverter.from_keras_model(pruned_model)
tflite_model = converter.convert()

# Save the TensorFlow Lite model to a file
with open('pruned_model.tflite', 'wb') as f:
    f.write(tflite_model)

## Trade-offs between model size and accuracy

修剪可以减小模型大小并提高效率,但也需要权衡。积极的剪枝可能会导致模型精度大幅降低,尤其是在没有剪枝感知训练的情况下。使用剪枝时,在模型大小和准确性之间取得适当的平衡至关重要。
模型大小和准确性之间的权衡
在机器学习领域,模型大小和准确性之间微妙的相互作用是一个关键的考虑因素,它影响在各种应用程序中部署模型的可行性和有效性。随着在资源有限的环境中嵌入人工智能的需求激增,在这两个因素之间取得适当的平衡变得至关重要。
1. 模型大小:
模型大小是指神经网络内的参数、权重和连接的数量。较大的模型通常更具表现力,能够捕获数据中复杂的模式,从而在训练过程中提高准确性。然而,这种扩展性是以增加内存和计算需求为代价的。
2. 准确性:
准确性是模型正确预测结果的能力。更高的准确度是可取的,因为它可以确保模型的预测与地面真实标签紧密结合。然而,实现高精度通常需要训练复杂且大规模的模型。
影响权衡的因素
-
资源约束:
在资源有限的设备(例如手机和边缘设备)上部署模型,需要最小化模型大小以确保高效运行。 -
推理速度:
较小的模型通常在推理过程中需要较少的计算,从而导致更快的预测。这对于实时应用程序至关重要。 -
通信开销:
通过网络传输模型会消耗带宽。较小的模型发送速度更快,因此更适合远程推理。 -
精度要求:
应用程序的精度需求决定了模型压缩导致的精度下降的可接受水平。
实现平衡的最佳方法是修剪和量化,它们在减小模型大小和保持准确性之间提供了和谐的协同作用。修剪有选择地修剪掉冗余连接,从而形成线性模型架构。同时,量化降低了权重的精度,进一步压缩了模型的内存占用。这些技术共同提供了一种全面的方法来优化神经网络,以便在资源受限的设备上进行高效部署,同时最大限度地减少对预测性能的影响。但是,您还可以考虑其他技术,例如知识蒸馏、架构设计、集成方法。
评估量化模型
量化通过降低模型权重的精度来补充剪枝,进一步减小模型大小。TensorFlow Lite 提供对量化的支持,使得可以在资源受限的设备上部署量化模型。
以下是如何在 TensorFlow Lite 中评估量化模型的说明:
-
步骤 1:将剪枝模型转换为量化 TensorFlow Lite 格式
在评估之前,您需要将剪枝模型转换为量化 TensorFlow Lite 格式。您可以通过在 TFLite 转换器中指定量化模式来完成此操作。# Assuming you have already created the pruned model as 'pruned_model' (as shown in the previous code example) # Create a TFLite converter with quantization converter = tf.lite.TFLiteConverter.from_keras_model(pruned_model) converter.optimizations = [tf.lite.Optimize.DEFAULT] converter.target_spec.supported_types = [tf.int8] tflite_quantized_model = converter.convert()在上面,使用 tf.lite.TFLiteConverter 将修剪后的模型转换为量化的 TensorFlow Lite 模型。converter.optimizations 选项指定应应用默认的量化优化。Converter.target_spec.supported_types 选项将模型设置为使用 8 位整数 (int8) 进行量化。
-
步骤 2:保存量化的 TensorFlow Lite 模型
将量化的 TensorFlow Lite 模型保存到文件中,类似于前面的代码示例。with open('pruned_model_quantized.tflite', 'wb') as f: f.write(tflite_quantized_model)在上面,量化的 TensorFlow Lite 模型保存到名为“pruned_model_quantized.tflite”的文件中。
-
步骤 3:加载量化的 TensorFlow Lite 模型并评估
加载量化的 TensorFlow Lite 模型并使用 TensorFlow Lite 解释器评估其在测试数据集上的性能。# Load the quantized TensorFlow Lite model interpreter = tf.lite.Interpreter(model_path='pruned_model_quantized.tflite') interpreter.allocate_tensors() # Get the input and output details input_details = interpreter.get_input_details() output_details = interpreter.get_output_details() # Assuming you have already loaded the test dataset as 'x_test' and 'y_test' (similar to the previous code examples) # Perform inference on the test dataset predictions = [] for i in range(len(x_test)): input_data = np.expand_dims(x_test[i], axis=0).astype(np.float32) interpreter.set_tensor(input_details[0]['index'], input_data) interpreter.invoke() output_data = interpreter.get_tensor(output_details[0]['index']) predictions.append(output_data[0]) # Calculate accuracy y_pred = np.argmax(predictions, axis=1) accuracy = np.mean(y_pred == y_test) print(f"Quantized Model Accuracy: {accuracy}")在上面,使用 tf.lite.Interpreter 加载量化的 TensorFlow Lite 模型。分别使用get_input_details()和get_output_details()检索模型的输入和输出详细信息。然后使用加载的模型对测试数据集执行推理(假设加载为“x_test”和“y_test”)。对于每个测试样本,设置输入张量,调用模型,并检索输出张量。预测收集在“预测”列表中。
最后,通过将预测标签与测试数据集中的真实标签进行比较来计算量化模型的准确性。
然而,量化可能会影响模型的准确性,评估量化和剪枝之间的权衡至关重要。
部署与集成
修剪后的模型以及量化(如果应用)可以部署在边缘设备、移动电话和其他资源有限的平台上。借助 TensorFlow Lite 等框架,可以实现与现有应用程序和系统的集成。
-
模型服务:
为了在服务器环境或基于云的应用程序中部署,您可以使用模型服务器将机器学习模型作为 RESTful API 提供服务。TensorFlow Serving 或 Flask 等框架可用于设置模型服务器。 -
移动应用集成:
为了与移动应用集成,TensorFlow Lite 为 Android 和 iOS 等流行移动平台提供了移动友好的 API 和 SDK。这使得机器学习模型能够无缝集成到移动应用程序中。 -
边缘设备集成:
对于具有硬件加速器的边缘设备(例如Edge TPU、Coral TPU),TensorFlow Lite支持硬件加速,以进一步提高推理性能。可以使用专用库和 API 将模型部署到边缘设备。 -
安全和隐私注意事项:
在部署过程中,必须考虑安全和隐私注意事项。如果模型涉及敏感数据或操作,则必须实施适当的安全措施,例如加密。 -
监控和维护:
部署后,监控模型的性能并确保它们是最新的至关重要。应监控模型漂移和概念漂移,并且可能需要定期重新训练模型以保持准确性。 -
持续集成和部署 (CI/CD):
使用 CI/CD 实践可确保模型更新的无缝部署和集成。自动化测试和部署管道有助于保持一致性和可靠性。
局限性和未来发展
修剪的局限性
- 性能下降:
激进的剪枝可能会导致性能显着下降,特别是如果不与剪枝感知训练或微调等技术相结合的话。 - 对初始化的敏感性:
剪枝模型可能对权重初始化敏感,不同的初始化可能会导致不同的剪枝结构和性能。 - 表达能力降低:
过度修剪可能会导致模型表达能力丧失,从而限制其捕获数据中复杂模式的能力。 - 细粒度剪枝挑战:
个体权重级别的细粒度剪枝可能需要专门的硬件支持才能实现高效推理。
未来发展
- 自动修剪算法:
开发更复杂的自动修剪算法,可以自适应地识别模型中的冗余权重和结构,而无需手动调整。 - 高级量化技术:
探索先进的量化技术,以减轻量化噪声的影响并提高较低位精度下的模型性能。 - 混合剪枝和量化:
研究剪枝和量化技术之间的协同作用,以实现更紧凑、更高效的部署模型。 - 动态修剪:
实现动态修剪技术,可以根据输入数据分布在运行时修剪和增长模型结构。 - 压缩算法:
研究和开发新颖的模型压缩算法,结合多种技术以实现模型大小和准确性之间的更好权衡。
结论
- 剪枝和量化是强大的模型压缩技术,可以减少深度学习模型的内存占用和计算要求。
- 修剪消除了冗余连接和权重,从而在不牺牲准确性的情况下产生更稀疏的模型,使它们适合部署在资源受限的设备上。
- 量化降低了模型参数的精度,从而缩小了模型尺寸并加快了推理速度,使其成为边缘设备和移动应用程序的理想选择。
- 剪枝感知训练有助于减轻剪枝引起的性能下降,确保剪枝后的模型保持其准确性。
- 修剪和量化的结合使得能够在从移动设备到物联网设备和边缘计算的各种实际应用中部署高效、准确的机器学习模型,通过智能和资源友好型解决方案解决现实世界的挑战。
更多推荐


 43
 0
- 0


 已为社区贡献6条内容

所有评论(0)