
为什么大多数LLM只使用Decoder-Only结构?
我在网上冲浪时遇到了这个问题,但却无法给出一个足以说服自己的答案。于是我做了一些调查,结果发现这是一个令人着迷的问题。它融合了对Transformer、架构、数学和工程优化的理解。在此,我将与大家分享我一路走来的心得体会。
01.语言模型结构概述
首先让我们先来熟悉一下关于模型结构的术语。
-
Encoder and Decoder
-
Encoder: 处理输入数据并将其转换为压缩后的特征表示形式,用以捕捉基本信息。在翻译任务中,编码器将一个英语句子转换为代表其语言特点和含义的特征编码向量。
-
Decoder: 接收编码后的特征表示并生成输出,通常是不同的形式。在上述翻译任务中,解码器接收英语句子的编码表示,并生成其法语等效句子。

-
Encoder-Only Models
-
举例: 基于Bert的模型
-
预训练方法:基于mask掩码的语言建模模型 (MLM)
-
应用:需要深入理解输入数据的任务。这些模型对分类、情感分析和信息提取非常有效。
-
Decoder-Only Models
-
举例: 基于GPT/XLNet的模型
-
预训练方法:下一个Token预测(NTP)
-
应用:生成任务。通常以自回归的方式,根据提供的上下文预测后续文本。它们的主要功能是生成输出,无需单独的编码阶段。
-
Encoder-Decoder Models
-
举例: 例如T5/BART/Google Gemini
-
预训练方法: Task-dependent
-
应用:同时涉及理解和生成数据的任务。它们首先将输入序列编码为内部特征表示,然后将该特征表示解码为输出序列。
针对上述翻译任务,我们首先可以轻松地排除encoder-only模型:这些模型通常使用 MLM 进行预训练,不一定有助于生成输出。
另一方面,Decoder-Only则非常合理:它们用于生成输出,并根据下一个Token预测任务进行预训练,而这正是大多数 LLM 的任务。
这个问题实际上可以归结为Decoder-only架构与Encoder-Decoder架构的对比:
有了Decoder组件,就有了生成能力,多了Encoder组件是不是更有帮助了呢?
02.Causal-Decoder VS Encoder-Decoder
针对Encoder-Decoder模型和Decoder-Only纯解码器(也称Causal-Decoder)性能研究由来已久。较早的研究之一是 Wang 等人在 ICML 2022 上发表的论文<>在这项研究中,研究人员比较了各种架构和预训练方法的组合。他们发现:
我们的实验表明,在纯粹的自监督预训练后,根据自回归语言建模目标训练的纯因果解码器模型表现出最强的零样本泛化能力。
然而,在我们的实验中,对具有非因果可见性的输入来说,先使用基于掩码语言建模目标训练,然后进行多任务微调的模型性能最好。
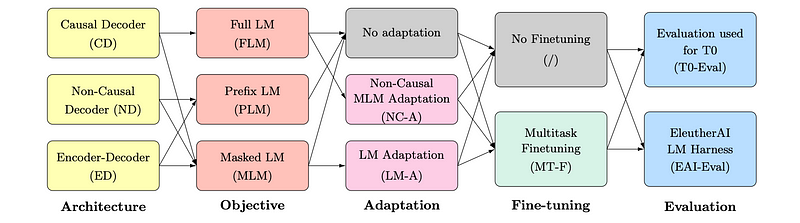
好极了,那么Encoder-Decoder > Decoder-Only > Encoder-Only,对吗?
事实证明,尽管上述论文揭示了开发大型模型的一些有价值的见解。在选择架构时,还需要考虑其他一些因素。
03.训练成本
要实现 Encoder-Decoder结构的最大潜力,我们需要对标注数据进行多任务微调(基本上就是指令微调),这可能会非常昂贵,尤其是对于大型模型而言。
另一方面,Causal Decoder 模型因其强大的零样本泛化能力而表现出色,这与当前的惯例–在大规模语料库上进行自我监督学习十分契合。
04.涌现能力
论文中比较的模型有大约 5B 个参数,并经过 170B 个Token的训练。这还不足以解释LLM 的涌现能力。
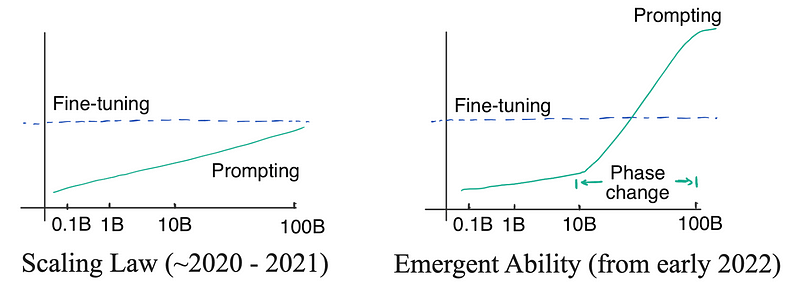
大型语言模型(LLM)中的涌现能力指的是一种现象,即模型在训练过程中显示出新的、复杂的能力,而这些能力在训练过程中并没有明确地传授给模型,而是随着模型规模和复杂程度的增加而自然产生的。
从本质上讲,涌现能力使 LLM 能够进行一定程度的复杂推理。例如,从非结构化文本中提取结构化知识。这种能力使 LLM 能够理解一些 NLP 任务,而这些任务自然地潜藏在它所训练的文本语料库中。对于较为简单的任务,我们可以认为 LLM 具有在训练过程中已经微调过的涌现能力,而对于较为复杂的任务,它可以将其分解为更简单的任务。新出现的能力并不一定会使Decoder-Only模型比 Encoder-Decoder 模型更有优势,但它们会缩小 Encoder-Decoder模型与经过多任务微调的Decoder-Only模型之间的性能差距。
05.从提示词中进行上下文学习
另一个需要考虑的问题是提示词。在使用 LLM 时,我们可以采用提示词工程方法,例如提供少量实例来帮助 LLM 理解上下文或任务。在 Dai 等人的这篇论文中,研究人员用数学方法证明,这种上下文信息可以被视为具有与梯度下降类似的效果,可以更新零样本的注意力权重。
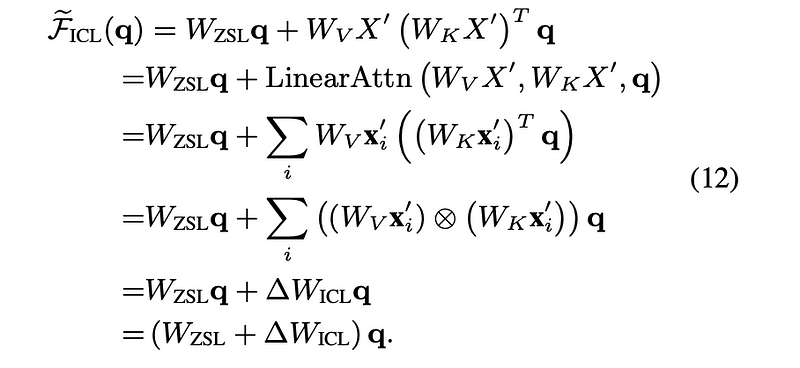
如果我们把提示词看作是给注意力权重引入梯度,那么我们或许可以期待它对Decoder-Only模型产生更直接的效果,因为它在用于生成任务之前不需要先转化为中间语境的特征表示。从逻辑上讲,它应该仍然适用于Encoder-Decoder架构,但这需要对编码器进行仔细调整,使其达到最佳性能,而这可能比较困难。
06.效率优化
在纯解码器模型(Decoder-Only)中,先前Token的键(K)和值(V)矩阵可以在解码过程中重复用于后面的标记Token。由于每个位置只关注之前的Token(由于因果注意力机制),因此这些标记Token的 K 和 V 矩阵保持不变。这种缓存机制避免了为已经处理过的标记Token重新计算 K 和 V 矩阵,从而提高了效率,有利于在自回归模型(如 GPT)的推理过程中加快生成速度并降低计算成本。
07.自回归VS 双向注意力
还有另一个有趣的问题,那就是底层注意机制的不同,即仅解码器(因果解码器)的自回归注意机制和编码器-解码器的双向注意力机制。下面我们可以直观地看到它们是如何关注不同位置的:
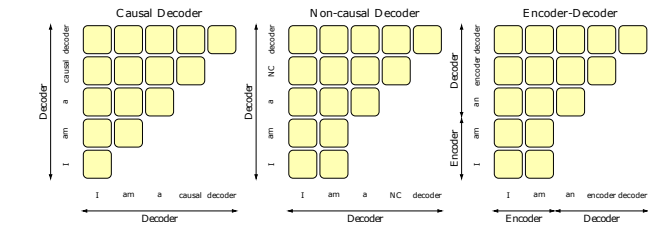
在Transformer架构中,计算注意力矩阵的方法是将两个低维矩阵(Q 和 K^T)相乘,然后进行Softmax运算。在纯解码器Decoder-Only架构中,由于因果掩码(防止模型看到未来的标记Token),注意力矩阵被限制为下三角形式,理论上可以保持其全秩状态:对角线上的每个元素(代表自注意力)都有助于使行列式为正(只有 Softmax 才能得到正结果)。全秩意味着理论上更强的表达能力。
另外两种生成式架构都引入了双向注意力,因此无法保证其注意力矩阵的全秩状态。作者认为这将限制模型的性能。为了验证这一假设,他设置了一个实验,将双向注意力矩阵拆分为单向,一半注意力向前注意,另一半向后注意。然后,他将这种前向-后向注意力的表现与全双向注意力模型进行了比较。前向-后向注意力的表现确实更好,这在某种程度上验证了这一理论,但这种改进非常有限,似乎并不表明存在显著差异,尤其是在模型经过充分训练的情况下。
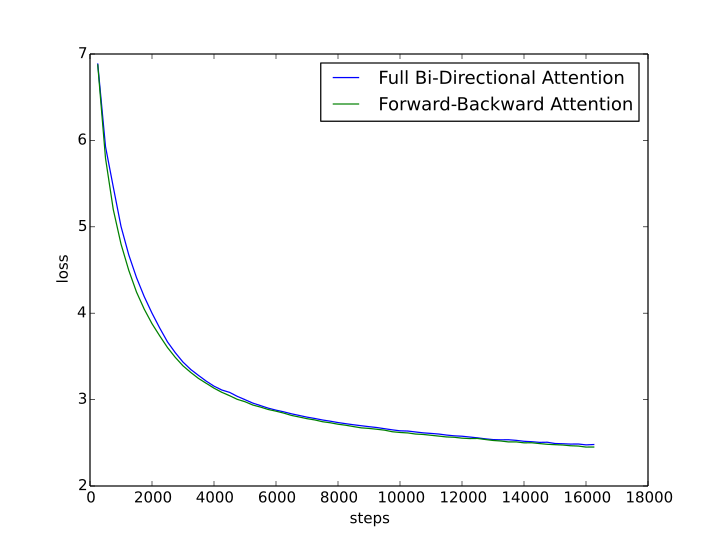
直觉上这是有道理的。双向注意力是一把双刃剑:它能加快学习过程,但也会破坏模型学习生成所必需的更深层预测模式。你可以把它想象成学习如何写作:填空比逐字逐句地写出整篇文章更容易,但这是一种不太有效的练习方式。不过,经过大量训练后,这两种方法都能达到学习如何写作的目的。
结论
纯解码器架构之所以受欢迎,是因为它简单易用,具有良好的零样本泛化能力,而且训练成本较低,可以达到合理的性能。许多研究都对纯解码器架构和编码器-解码器架构的性能进行了研究,但在有足够的训练和模型规模的情况下,确实没有确凿证据证明一种架构在最终性能上优于另一种架构。
事实上,谷歌Gemini 模型展示了编码器-解码器模型如何在某些任务中发挥同样出色的作用,甚至超越了纯解码器架构。编码器组件支持 “内置多模态”,可以从非文本输入中提取信息,这对未来的 LLM 至关重要。我们最初的问题确实应该是–为什么大多数 LLM 都是解码器–这表明在那个时代,每个人都主要致力于推进解码器架构。尽管如此,我认为它仍然揭示了了解 LLM 如何工作的内在机制。令人兴奋的是,在探索 AGI 的过程中,我们无法知道下一步将会发生什么。
如何学习大模型 AI ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。
如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

更多推荐

 18
 0
- 0


 已为社区贡献11条内容

所有评论(0)