
本地部署大模型:Ollama 还是 vLLM?7 个维度一次讲透
同一张显卡上跑同一个模型,Ollama 单用户秒吐,一上并发就被 vLLM 甩开几条街。差距怎么来的?看完 7 个对比你心里就有数了。
你有没有过这种时刻——想本地跑个大模型玩玩,网上一搜,名字冒出来两个:Ollama、vLLM。
公众号教程清一色说「装 Ollama 就行,一行命令搞定」。你真跑起来了,单聊挺顺。但并发一上来,响应慢到让你想砸键盘。这时候有人说「换 vLLM」,你一看部署文档就头大:CUDA 版本、Linux 环境、参数调优…
这两个到底什么时候用谁?
一句话先讲清楚:Ollama 是「给一个人用的」,vLLM 是「给一群人用的」。下面 8 个维度,让你一次看明白。
一、定位:一个人的玩具 vs 一群人的底座
先说定位,因为后面所有差异都从这里长出来。
Ollama 本质上就是「给 llama.cpp 包了一层友好的壳」。llama.cpp 是 Georgi Gerganov 写的那套 C++ 推理引擎,本来就是跑模型用的;Ollama 在外面套了命令行、模型库管理、API 服务这些贴心操作。
它的目标人群:个人开发者、学生、想本地玩玩开源模型的人。说人话:一个人用,自得其乐。
vLLM 不一样。它是 UC Berkeley Sky Computing Lab 出的,研究方向一开始就是「怎么让一张 GPU 同时服务尽可能多的请求」。所以它从第一天起就是为生产、为高并发、为多用户设计的。
打个比方:Ollama 像你家里那台胶囊咖啡机,自己做一杯香;vLLM 像星巴克的咖啡师,一早上要做出 300 杯,还得稳。

二、部署方式:容器化部署
Ollama:官方镜像 ollama/ollama,挂载本地 GGUF,用 Modelfile 注册。
# docker-compose.yamlservices:  ollama:    image: ollama/ollama    container_name: ollama    ports:      - "11434:11434"    volumes:      - ollama:/root/.ollama      - ./models:/models          # 放本地下载好的 GGUF    deploy:      resources:        reservations:          devices:            - driver: nvidia              count: 1              capabilities: [gpu]    restart: unless-stoppedvolumes:  ollama:
``````plaintext
# 假设已把 Llama-3-8B-Instruct-Q4_K_M.gguf 放到 ./models/docker compose up -d# 写一份 Modelfile,FROM 指向本地 GGUF 路径cat > ./models/Modelfile <<'EOF'FROM /models/Llama-3-8B-Instruct-Q4_K_M.ggufEOF# 进容器注册并运行(也可以直接 ollama run /models/xxx.gguf)docker compose exec ollama ollama create mymodel -f /models/Modelfiledocker compose exec ollama ollama run mymodel
背后的 llama.cpp 不变,但模型文件、API 服务、11434 端口都随容器起好。想纯 CPU 跑,删掉 deploy 那块就行。
一个小提醒:Mac(Apple Silicon)上 Docker Desktop 不支持把 GPU 透传给容器,Mac 用户要么直接装原生 Ollama 应用,要么就只能纯 CPU 跑。
vLLM:官方镜像 vllm/vllm-openai,–model 直接指本地路径。
# docker-compose.yamlservices:  vllm:    image: vllm/vllm-openai:latest    container_name: vllm    ports:      - "8000:8000"    volumes:      - ./models:/models          # 放本地下载好的 HF 格式模型目录    ipc: host    deploy:      resources:        reservations:          devices:            - driver: nvidia              count: 1              capabilities: [gpu]    command:      - "--model"      - "/models/Llama-3-8B-Instruct"   # 本地路径      - "--tensor-parallel-size"      - "1"      - "--max-model-len"      - "8192"      - "--gpu-memory-utilization"      - "0.90"    restart: unless-stopped
``````plaintext
docker compose up -d
前提还是那几样:一张 NVIDIA 显卡、Linux 服务器、装好 NVIDIA Container Toolkit。
记忆口诀:Docker 抹掉了「配环境」的痛苦,但硬件要求和调参成本仍在——Ollama 这份 yaml 你基本能直接抄,vLLM 那份你得明白每个 command 参数是干嘛的。
三、并发吞吐:差距怎么被拉开十倍的
这一节是重头戏,也是两者最核心的差异。
Ollama 用的是 llama.cpp 的串行调度,本质上同一个时刻能并发的请求数是受限的。默认 OLLAMA_NUM_PARALLEL=4,多了就在队列里排队等。
它的设计目标不是「让一张 GPU 干最多的活」,而是「让一个请求跑得尽量快」。所以单用户场景下,Ollama 反而比 vLLM 还略快一点(少了调度开销)。
vLLM 干了两个杀手锏:
-
- 连续批处理(Continuous Batching):每个 token 步骤后,调度器扫描一遍,发现哪个请求跑完了立刻腾出位置塞新请求。GPU 几乎从不空转。
-
- PagedAttention:KV Cache 按固定大小分页,用 block table 索引,避开碎片化(这个下一节讲)。
实测差距(来自 Red Hat 2025 / 2026 多份基准):
- • 单用户:两者差不多,Ollama 还偶尔略快(45 vs 38 tok/s 量级)
- • 8 并发:vLLM 已经 2-3 倍领先
- • 128 并发:差距拉到约 19 倍(vLLM 793 tok/s vs Ollama 41 tok/s)
记住一句话:并发上来后,Ollama 的请求在排队;vLLM 的请求在被并发跑。这个差距不是一点点,是数量级。
四、显存 / KV Cache:碎片化 vs 按页分配
这一节接上一节,把「为什么并发能拉开」讲透。
每跑一个大模型推理,都需要存一份「KV Cache」——这是推理过程中的中间状态,每个活跃请求占一份。显存里除了模型权重,剩下的就是被一堆 KV Cache 切得七零八落。
传统做法(包括 Ollama):每个请求上来,先给它预留一块连续显存,按最大上下文长度算。问题是:
- • 请求 A 跑了 200 token 就停了,预留的 8000 token 位空着浪费
- • 请求 B 想跑 4000 token,但找不到一段连续的 4000 token 空位
- • 显存碎片化越积越严重,能并发的请求数根本上不去
vLLM 的 PagedAttention:
- • 把 KV Cache 切成固定大小的「页」(一般 16 token 一页)
- • 用一张 block table 索引每一页的物理位置(虚拟内存那套思路)
- • 碎片率从 60-80% 降到 4% 以下
- • 一张卡能并发的请求数直接翻倍到 4 倍

打个比方:Ollama 像你手动给每本书留一格固定抽屉;vLLM 像你按需用小格子装,同样大小的书柜,能塞下 3-4 倍的书。
五、量化 / 低配置运行:CPU 也能跑 vs 必须 NVIDIA
这一条决定能不能在你家电脑上跑起来。
Ollama = llama.cpp,对硬件几乎没门槛:
- • macOS(Apple Silicon,Metal 加速)
- • Windows(CPU 推理或 NVIDIA)
- • Linux(CPU 推理或 NVIDIA)
- • 纯 CPU 也能跑,只是慢一点
它支持的 GGUF 量化格式覆盖 q2 到 q8,主流模型基本都能找到 4-bit 量化版。一台 M2 MacBook 跑 7B 模型,再平常不过。
vLLM 这边基本是 NVIDIA CUDA 绑定:
- • AMD ROCm 支持还不成熟
- • Apple Silicon 完全不支持
- • CPU 推理理论可行,但实际没人这么部署
它主要支持 AWQ、GPTQ、FP8 等量化格式,需要你跑在 NVIDIA 显卡上。Mac 用户就不用考虑了。
一句话:Ollama 是给「我家电脑能不能跑」这种场景准备的;vLLM 是给「数据中心那台 8 卡 A100」这种场景准备的。
六、多 GPU 扩展:简单 vs 灵活
Ollama 支持单机多 GPU。当模型能放入单卡时,通常优先单卡运行;当单卡显存不足时,可以自动将模型分布到多张 GPU 上。
vLLM 从一开始就是为多卡设计的:
- • Tensor Parallel(模型层切成几片,每卡一片)
- • Pipeline Parallel(模型层按段切,卡之间接力)
- • 两种方式自由组合
跑 70B、405B 这种单卡塞不下的模型,vLLM 是为数不多的现实选择。生产环境上 H100 集群做 LLM 服务,vLLM 是默认答案。
如果你机器只有一张 4090(24G),两边都在这张卡上跑,没差;上了多卡、要服务大模型,vLLM 才能上场。
七、适用场景:什么时候选谁
最后给个干脆的结论。
选 Ollama:
- • 你一个人用,最多三五个人一起聊
- • 想在 MacBook、笔记本、家里台式机上跑模型
- • 模型小,7B / 14B 量级,量化到 4-bit 能塞进显存
- • 不想折腾环境,一行命令搞定
- • 单次对话体验要快,首字延迟尽量低
选 vLLM:
- • 多用户在线服务、有 API 接口对外
- • 高并发(哪怕只是十几二十个并发)
- • 长上下文(16K、32K 那种)
- • 大模型(30B、70B、405B)
- • 你有 NVIDIA GPU,想要把硬件性能跑满
- • 需要 Prometheus 监控、Kubernetes 部署这些工程化能力

最后说一句:
Ollama 是 90% 个人开发者的玩具 + 5% 小团队的工具;vLLM 是企业级 API 服务的标配。错配哪个都不舒服。把框架当工具用,选型跟着场景走,比讨论谁更强更有用。
如果你正在本地大模型选型,这7个维度对照一遍,五分钟心里就有数了。这张表也可以先收藏,以后扩量时直接拿出来再比对一次。
附:7 维度速查对比表
| 维度 | Ollama | vLLM |
|---|---|---|
| 定位 | 个人 / 单用户的轻量推理壳子(基于 llama.cpp) | 高并发生产级推理服务(UC Berkeley 出品) |
| 模型格式 | GGUF(llama.cpp 量化格式) | HuggingFace safetensors + AWQ / GPTQ / FP8 |
| 并发吞吐 | 单用户略快;高并发被排队机制卡住 | 8 并发起跑赢 2-3 倍,128 并发领先约 19 倍 |
| 显存 / KV Cache | 连续分配,碎片率 60-80% | PagedAttention 按页分配,碎片率 < 4% |
| 量化 / 低配运行 | q2-q8 全量化,纯 CPU 也能跑 | 主要 AWQ / GPTQ / FP8,需 NVIDIA 显卡 |
| 多 GPU / 扩展 | 支持多卡,但策略是单卡先默认用满 | 支持 Tensor / Pipeline / Data 并行 |
| 适用场景 | 个人玩、MacBook、7B-14B 模型、零搭建 | 企业 API、长上下文、30B+ 大模型、多卡集群 |
学AI大模型的正确顺序,千万不要搞错了
🤔2026年AI风口已来!各行各业的AI渗透肉眼可见,超多公司要么转型做AI相关产品,要么高薪挖AI技术人才,机遇直接摆在眼前!
有往AI方向发展,或者本身有后端编程基础的朋友,直接冲AI大模型应用开发转岗超合适!
就算暂时不打算转岗,了解大模型、RAG、Prompt、Agent这些热门概念,能上手做简单项目,也绝对是求职加分王🔋
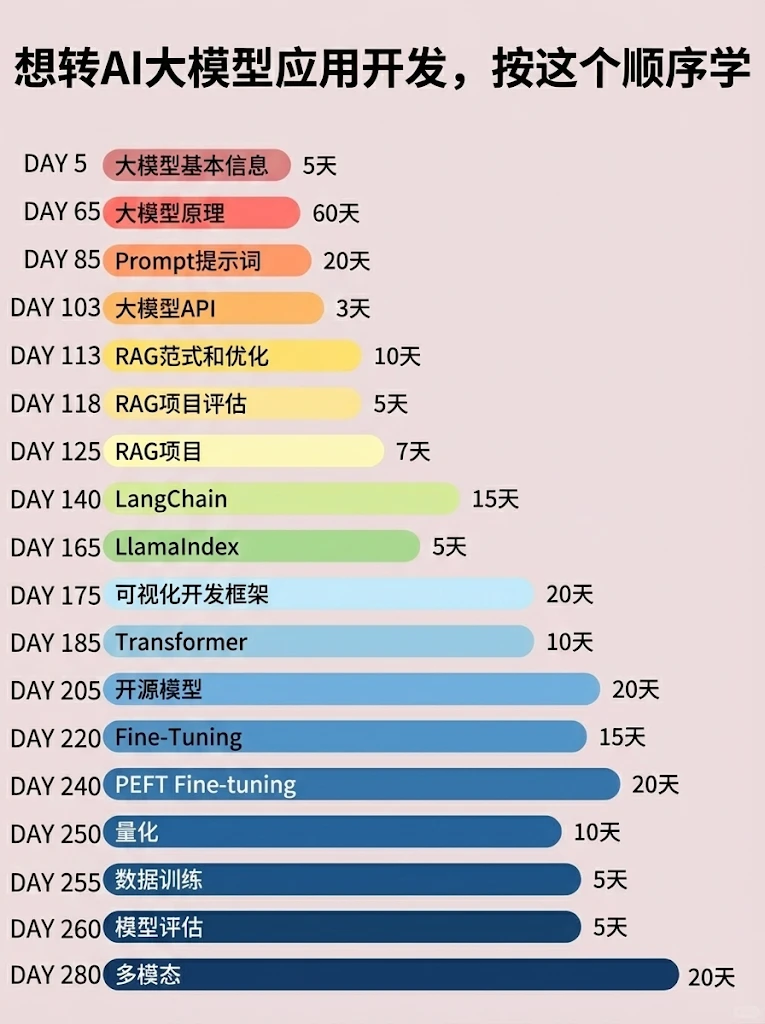
📝给大家整理了超全最新的AI大模型应用开发学习清单和资料,手把手帮你快速入门!👇👇
学习路线:
✅大模型基础认知—大模型核心原理、发展历程、主流模型(GPT、文心一言等)特点解析
✅核心技术模块—RAG检索增强生成、Prompt工程实战、Agent智能体开发逻辑
✅开发基础能力—Python进阶、API接口调用、大模型开发框架(LangChain等)实操
✅应用场景开发—智能问答系统、企业知识库、AIGC内容生成工具、行业定制化大模型应用
✅项目落地流程—需求拆解、技术选型、模型调优、测试上线、运维迭代
✅面试求职冲刺—岗位JD解析、简历AI项目包装、高频面试题汇总、模拟面经
以上6大模块,看似清晰好上手,实则每个部分都有扎实的核心内容需要吃透!
我把大模型的学习全流程已经整理📚好了!抓住AI时代风口,轻松解锁职业新可能,希望大家都能把握机遇,实现薪资/职业跃迁~
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

更多推荐

 1
 0
- 0


 已为社区贡献12条内容

所有评论(0)