
小白必看!LLM 及相关术语(Transformer、预训练、微调)通俗解析,带您轻松入门大语言模型
大语言模型(LLM)无疑是当前人工智能领域的 “顶流明星”,频繁出现在技术讨论、产业应用甚至日常场景中。尽管 “大语言模型” 这个名字听起来带着技术距离感,但剥去复杂的术语外壳,它的本质其实很易懂 —— 就是一套能 “读懂人类语言、生成人类语言” 的智能系统。
简单来说,它像一个经过海量语言训练的 “智能语言助手”:既能理解我们用自然语言表达的需求(比如问问题、提要求),又能按照人类习惯的语言逻辑,输出通顺、贴合需求的内容(比如回答问题、写文案、编代码),核心就是围绕 “人类语言” 实现双向的智能交互。下面用通俗的方式,从几个方面详细介绍:
一、基本概念与核心术语
先把关键术语“翻译”成大白话,后面会反复用到:
- 大语言模型(LLM,Large Language Model):字面意思,就是“规模很大的语言模型”。它能像人一样理解文字、生成文字,甚至做简单推理(比如“因为下雨,所以出门要带伞”)。
- 深度学习(Deep Learning):LLM的“底层技术”,模仿人脑神经元的工作方式,用多层“神经网络”处理信息。就像多层滤网,一层一层提炼数据里的规律。
- Transformer:LLM的“核心骨架”(2017年谷歌提出)。它的关键是“自注意力机制”——能像人一样,在一句话里“关注”重要的词。比如“小明给小红买了花,她很开心”,模型能知道“她”指小红。
- GPT(Generative Pre-trained Transformer):“生成式预训练Transformer”,是LLM的一种。特点是擅长“生成内容”(写文章、编故事等),代表产品是ChatGPT。
- BERT(Bidirectional Encoder Representations from Transformers):另一种LLM,擅长“理解文本”(比如分析句子情感、找关键词),但生成能力弱。
- 预训练(Pre-training):LLM的“基础教育阶段”。模型先在海量文本(比如全网书籍、网页、论文)里学习,掌握语言规律(比如“太阳从东边升起”是常识)。这个阶段就像人在上学,什么都学。
- 微调(Fine-tuning):LLM的“职业培训阶段”。预训练后的模型再用特定领域数据(比如医疗病历、法律条文)训练,让它更擅长某类任务(比如写病历)。
- Token:文本的“最小单位”。模型处理文字时,会把句子拆成Token(可能是单词、字、甚至字母片段)。比如“我爱中国”可能拆成3个Token(“我”“爱”“中国”);英文“apple”可能是1个Token,“unhappiness”可能拆成“un”“happiness”2个。
二、基本模型原理
LLM的工作原理可以简化为“三步曲”:
1. 拆分成Token:把输入的文字(比如“帮我写一封请假条”)拆成Token,转换成模型能理解的数字(向量)。
2. 用Transformer处理:通过“自注意力机制”分析Token之间的关系(比如“请假条”需要包含“请假时间”“原因”),结合预训练学到的知识,计算出“该说什么”。
3. 生成回答:把计算结果转回文字,输出回答(比如“好的,这是一封请假条模板:尊敬的领导……”)。
简单说,就像一个“超级大脑”:先通过海量学习记住语言规律,再根据输入的内容“联想”出合理的回应。
三、核心能力
LLM的核心能力可以概括为“理解”和“生成”两大块,具体包括:
- 文本理解:能看懂文章、句子、关键词,比如总结一篇新闻的大意,分析用户评论是好评还是差评。
- 内容生成:能写文章、编故事、生成代码、创作诗歌,甚至模仿特定风格(比如模仿鲁迅的语气)。
- 问答互动:像“智能顾问”一样回答问题,从常识(“地球自转一圈多久”)到专业知识(“糖尿病患者饮食注意什么”)。
- 逻辑推理:能做简单的推理,比如“小明比小红大3岁,小红10岁,小明几岁?”(答案13岁)。
- 多语言处理:能翻译、跨语言对话(比如用中文问,模型用英文回答)。
四、发展历程
LLM的发展是“从简单到复杂”的过程,关键节点:
- 2013年:词向量模型(如Word2Vec)出现,第一次让计算机“理解”单词的含义(比如“国王-男人+女人=女王”),但只能处理单个词。
- 2017年:Transformer架构诞生,解决了“长文本处理”问题,为LLM奠定基础。
- 2018年:谷歌发布BERT(擅长理解),OpenAI发布GPT-1(擅长生成),LLM开始走向实用。
- 2020年:GPT-3发布,参数量达到1750亿(相当于模型的“脑细胞”数量),生成能力大幅提升,能写邮件、编剧本。
- 2022年:ChatGPT(基于GPT-3.5)爆火,支持自然对话,让普通人第一次感受到LLM的强大。
- 2023年至今:GPT-4、Gemini等模型加入“多模态”能力(能处理图片、语音),LLM从“只懂文字”变成“能看能听”。
五、应用场景
LLM已经渗透到各行各业,举几个常见例子:
- 日常助手:写邮件、改简历、查天气、订机票(比如问Siri“帮我写一封感谢客户的邮件”)。
- 内容创作:自媒体写文案、短视频脚本、广告标语(比如用LLM生成“奶茶店促销文案”)。
- 教育培训:作业辅导(比如问“这道数学题怎么解”)、外语翻译(比如“把中文翻译成法语”)。
- 客服服务:替代人工客服回答常见问题(比如“我的快递什么时候到”)。
- 专业领域:医生用它分析病历、律师用它审查合同、程序员用它写代码(比如“帮我写一段Python爬虫代码”)。
六、业界TOP10产品及特点(按影响力排序)
目前没有绝对权威的排名,以下是公认的主流产品,各有侧重:
1. GPT-4(OpenAI)
- 特点:能力最全面,支持文本+图片输入(多模态),推理、生成、逻辑能力强,适合复杂任务(比如写论文、做数据分析)。
- 缺点:部分功能收费,对中文语境的理解略逊于本土模型。
2. Claude(Anthropic)
- 特点:擅长处理“超长文本”(比如一次分析10万字文档),安全性高(不容易生成违规内容),适合法律、学术等专业场景。
3. 文心一言(百度)
- 特点:本土化强,对中文梗、成语、国内热点理解更准(比如“躺平”“内卷”的含义),支持生成短视频脚本、PPT等。
4. 讯飞星火(科大讯飞)
- 特点:语音交互能力突出(毕竟是做语音起家),适合教育(作业批改)、医疗(语音转病历)场景。
5. 通义千问(阿里)
- 特点:电商场景适配好(比如生成商品描述、分析用户评价),和阿里生态(淘宝、钉钉)结合紧密。
6. Llama 3(Meta)
- 特点:开源免费(企业可自己修改),适合开发者二次定制(比如训练一个公司内部的客服模型),能力接近GPT-4。
7. Gemini(谷歌)
- 特点:多模态能力强(文本+图片+视频),和谷歌搜索、地图等工具结合紧密,适合日常信息查询。
8. CodeLlama(Meta)
- 特点:专门为“写代码”优化,支持Python、Java等几十种语言,程序员最爱之一。
9. Qwen(通义千问的升级版,阿里)
- 特点:小模型版本(比如Qwen-7B)运行速度快,能在手机、电脑本地使用(不用联网),适合隐私敏感场景。
10. Mistral(Mistral AI)
- 特点:欧洲代表模型,开源且效率高(用更少的计算资源达到接近GPT的效果),适合中小企业使用。
七、具体应用示例
- 场景1:写周报
输入:“帮我写一份电商运营周报,上周销售额10万,比前一周增长20%,主要来自直播带货,下周计划增加短视频推广。”
LLM(比如文心一言)会生成结构化的周报,包含“本周成果”“增长原因”“下周计划”等板块。
- 场景2:分析合同
上传一份租房合同给Claude,输入:“帮我找出合同里对租客不利的条款。” 模型会标出“提前退租不退押金”“物业费由租客承担”等潜在问题。
- 场景3:辅导作业
学生问讯飞星火:“‘忽如一夜春风来,千树万树梨花开’用了什么修辞手法?” 模型会解释是“比喻”,把雪花比作梨花。
八、发展趋势
- 多模态融合:未来的LLM不仅能处理文字,还能像人一样“看图片、听声音、甚至理解视频”(比如看到一张车祸现场图,能分析可能的原因)。
- 更“小而精”:现在的LLM需要超级计算机运行,未来会出现“轻量级模型”,在手机、手表上就能用(比如离线翻译)。
- 更懂“逻辑”:目前LLM偶尔会“一本正经地胡说八道”(比如算错简单数学题),未来会更擅长推理、减少错误。
- 行业定制化:每个行业会有自己的专属LLM(比如医院的“病历分析模型”、学校的“个性化辅导模型”)。
总结
大语言模型本质上是“用海量数据训练出来的语言专家”,它的核心是通过Transformer理解文字关系,经过预训练和微调后,能在各种场景帮人干活。虽然听起来复杂,但对普通人来说,不用懂原理,会用它提高效率(写东西、查信息)就够了~ 随着技术发展,它会变得越来越“聪明”,像手机一样成为日常工具。
读者福利大放送:如果你对大模型感兴趣,想更加深入的学习大模型,那么这份精心整理的大模型学习资料,绝对能帮你少走弯路、快速入门
如果你是零基础小白,别担心——大模型入门真的没那么难,你完全可以学得会!
👉 不用你懂任何算法和数学知识,公式推导、复杂原理这些都不用操心; 👉 也不挑电脑配置,普通家用电脑完全能 hold 住,不用额外花钱升级设备; 👉 更不用你提前学 Python 之类的编程语言,零基础照样能上手。
你要做的特别简单:跟着我的讲解走,照着教程里的步骤一步步操作就行。
包括:大模型学习线路汇总、学习阶段,大模型实战案例,大模型学习视频,人工智能、机器学习、大模型书籍PDF。带你从零基础系统性的学好大模型!
现在这份资料免费分享给大家,有需要的小伙伴,直接VX扫描下方二维码就能领取啦😝↓↓↓ 
为什么要学习大模型?
数据显示,2023 年我国大模型相关人才缺口已突破百万,这一数字直接暴露了人才培养体系的严重滞后与供给不足。而随着人工智能技术的飞速迭代,产业对专业人才的需求将呈爆发式增长,据预测,到 2025 年这一缺口将急剧扩大至 400 万!! 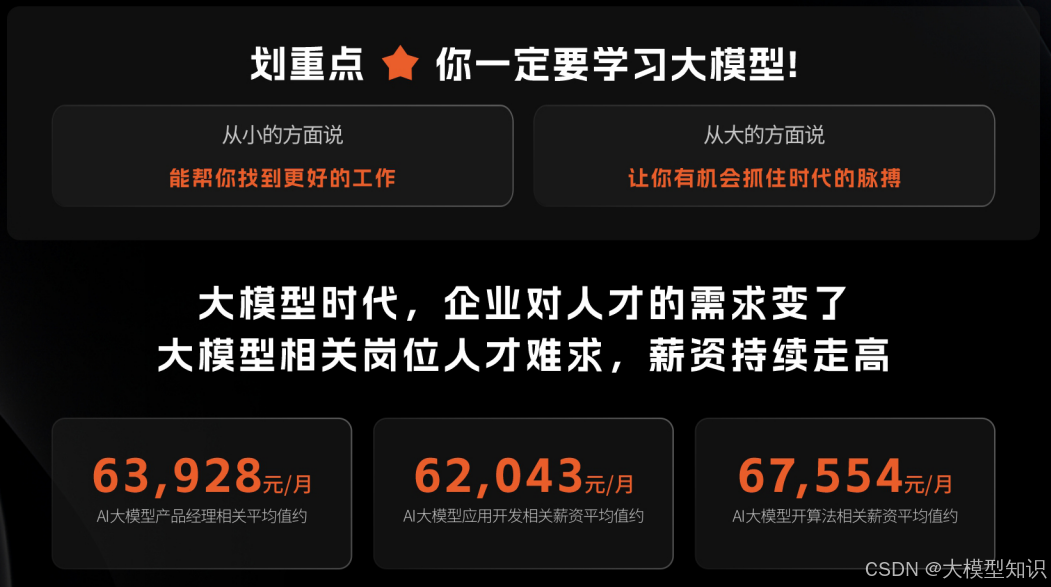
大模型学习路线汇总
整体的学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战,跟着学习路线一步步打卡,小白也能轻松学会! 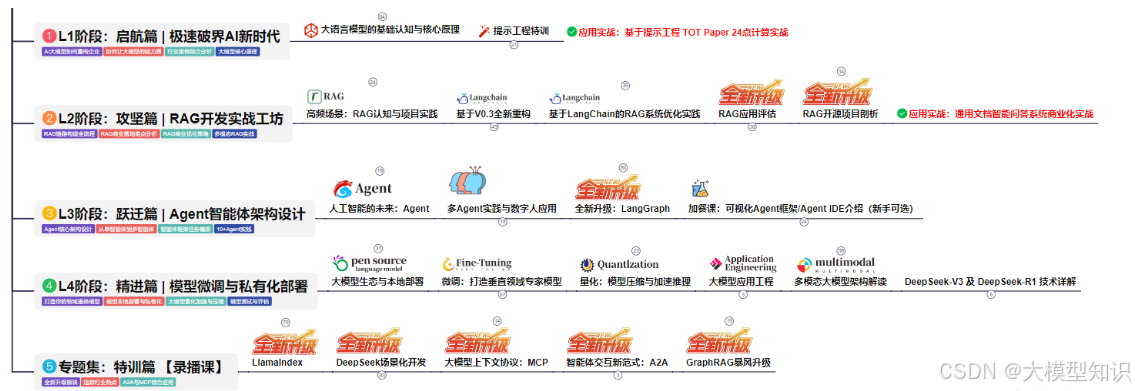
大模型实战项目&配套源码
光学理论可不够,这套学习资料还包含了丰富的实战案例,让你在实战中检验成果巩固所学知识 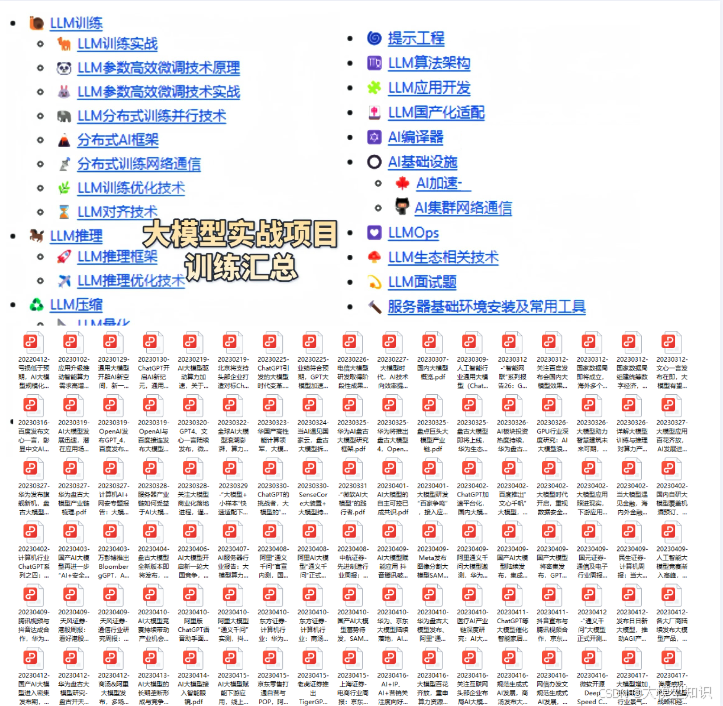
大模型学习必看书籍PDF
我精选了一系列大模型技术的书籍和学习文档(电子版),它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。 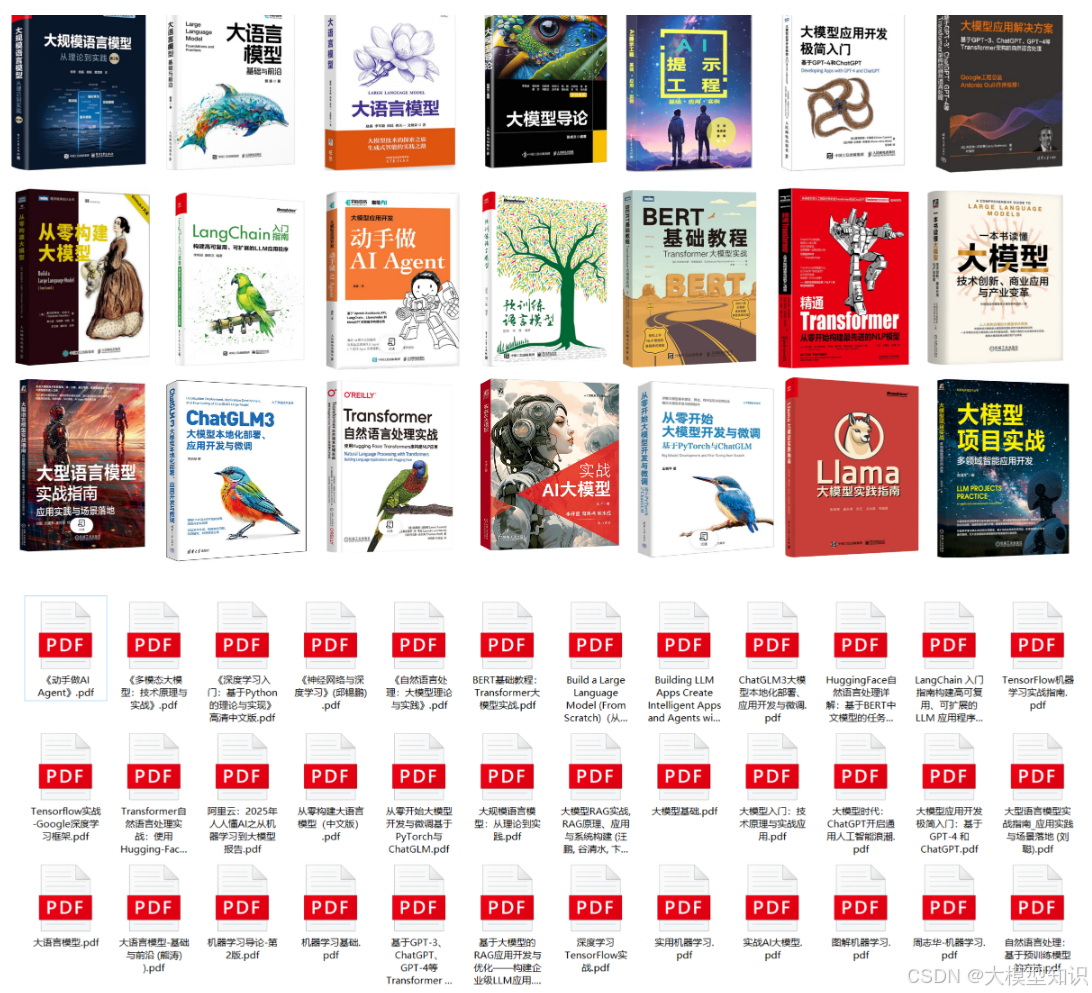
大模型超全面试题汇总
在面试过程中可能遇到的问题,我都给大家汇总好了,能让你们在面试中游刃有余 
这些资料真的有用吗?
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。  👉获取方式:
😝有需要的小伙伴,可以保存图片到VX扫描下方二维码免费领取【保证100%免费】  相信我,这套大模型系统教程将会是全网最齐全 最适合零基础的!!
更多推荐


 21
 0
- 0


 已为社区贡献17条内容

所有评论(0)