
基于知识图谱的智能问答系统教程实战七----Python+Django+Echarts封装【neo4j数据库在web可视化】
·
前言
本教程一共分为7个小教程专为零基础小白设计,从概念到实战,带你轻松入门!
📁 资源福利:教程代码+数据集+工具安装包,私信领取!
【解决毕设的最后一公里】基于知识图谱的智能问答系统教程实战一----项目整体介绍【Django+neo4j+大模型】
先看此视频:20分钟快速用django+mysql+pycharm搭建一个自己的web网站
修改Django管理员后端教程:手把手教你配置Django SimpleUI打造美丽后台
6.1 settings.py设置
- 添加两个子用户:
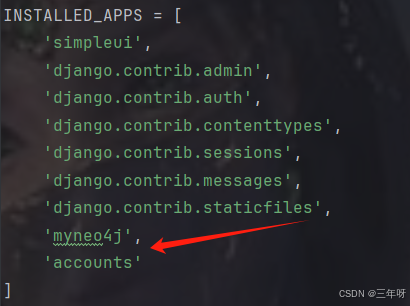
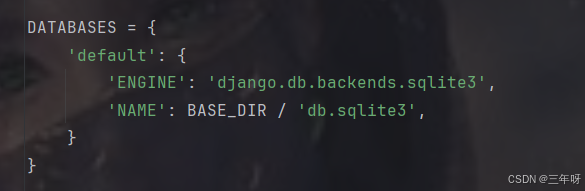
- 采用django框架自带的sqlite数据库
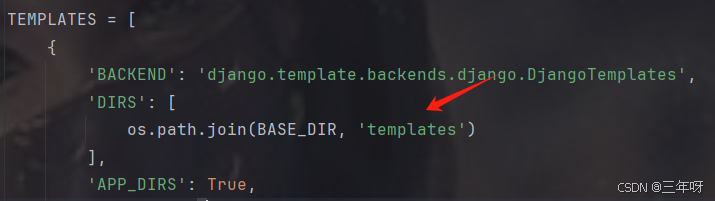
- 前端配置
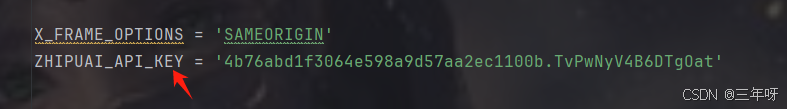
- 大模型api配置
此处api_key到智谱开放平台自行获取,新用户赠送现时一个月500万tokens,地址:https://open.bigmodel.cn/,进行登录注册,然后进入个人中心创建API key

最后修改settings.py中的api借口
6.2 pyneo_utils.py neo4j知识图谱可视化详解
主要实现以下功能:
- 动态构建Cypher查询,根据输入参数(起始节点、关系类型、结束节点)查询图数据
- 格式化图数据,转换为前端可视化(如ECharts关系图)所需的JSON结构
- 节点分类染色,为不同节点类型(CLASS/TIME/LOC等)分配对应颜色
1. 颜色定义
color = {
    "CLASS": "#5470c6",
    "TIME": "#e474c6",
    "LOC": "#147fc6",
    "RES": "#947dc6",
    "EVE": "#847986",
    "EVC": "#8374c6",
    "other": "#111111"
}
- 定义节点类型与颜色的映射关系
- 未匹配类型默认使用
other的黑色
2. 辅助函数 get_node_by_name
- 功能:根据节点标签(如"Person")和名称精确查找节点
def get_node_by_name(g, node_type, name):
    matcher = NodeMatcher(g)
    endnode = matcher.match(node_type,  name=name).first()
    return endnode if endnode else None
3. 属性格式化 get_str_by_dict
- 功能:将字典转换为HTML格式字符串(用于前端展示节点属性)例
{"age": 20} → "age:20<br>"
def get_str_by_dict(mydict):
    last = ""
    for key in mydict:
        last = str(key) + ":" + str(mydict[key]) + "<br>" + last
    return last
4. 核心函数 get_all_relation
def get_all_relation(start, relation, end):
    # 初始化数据结构
    datas = []  # 节点数据
    links = []  # 关系数据
    cache = []  # 去重缓存
    categories = []  # 分类列表
    legend_data = []  # 图例数据

    # 连接数据库
    g = Graph('http://localhost:7474', user='neo4j', password='123456')

    # 动态构建Cypher查询
    sql = "MATCH (n)-[%s]-(b) %s RETURN n,r,b LIMIT 100"
    ...
关键逻辑解析
-
动态Cypher构建
- 根据输入参数动态生成WHERE子句
- 示例:
start="Alice", relation="KNOWS"→MATCH (n)-[r:KNOWS]-(b) WHERE n.name='Alice' RETURN n,r,b
-
结果处理
for nodes_relations in nodes_data_all: # 提取节点标签和属性 start_label = str(nodes_relations['n'].labels).replace(":", "") end_label = str(nodes_relations['b'].labels).replace(":", "") ... -
节点去重与染色
if start_name not in cache: datas.append({ "name": start_name, "attr": start, "color": color.get(start_label, color["other"]), "des": get_str_by_dict(start), "category": start_label }) cache.append(start_name)- 使用
cache列表避免重复添加节点 - 根据节点标签匹配颜色配置
- 使用
-
关系处理
links.append({ "source": start_name, "target": end_name, "name": relation })- 记录关系的起点、终点和类型
输出数据结构示例
{
  "datas": [
    {
      "name": "NodeA",
      "color": "#5470c6",
      "des": "prop1:value1<br>prop2:value2",
      "category": "CLASS"
    }
  ],
  "links": [
    {"source": "NodeA", "target": "NodeB", "name": "REL_TYPE"}
  ],
  "legend_data": ["CLASS", "TIME"],
  "categories": [{"name": "CLASS"}, {"name": "TIME"}]
}
更多推荐

 24
 0
- 0


 已为社区贡献4条内容

所有评论(0)