
LLM大模型:大模型训练中优化策略(数据并行、模型并行、ZeRO等)
GPU 显存分析
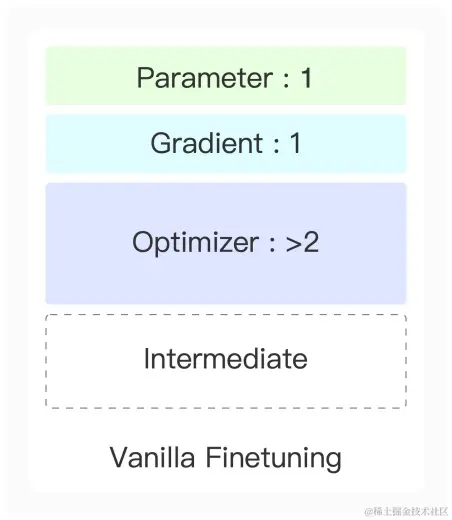
在微调时,模型显存占用主要包括模型参数、参数梯度、优化器和中间结果四个部分。
对于一个 6B 参数量的模型,它的模型参数占用为:
6×109×4(FP32)10243≈22GB\frac{6 \times 10^9 \times 4(FP32)}{1024^3} \approx 22GB102436×109×4(FP32)≈22GB
将模型参数视为基准,模型梯度占用量与模型参数相同。
优化器主采用 Adam Optimizer ,它核心计算公式如下:
mt=β1mt−1+(1−β1)gtvt=β2vt−1+(1−β2)gt2m_t = \beta_1 m_{t-1} + (1- \beta_1) g_t \\ v_t = \beta_2 v_{t-1} + (1 - \beta_2) g_t^2mt=β1mt−1+(1−β1)gtvt=β2vt−1+(1−β2)gt2
由于需要保存 m 和 v,而 m 和 v 规模与参数梯度相同,因此优化器需要两倍显存容量。
同时,在计算中得到的中间结果需要保存在显存中,以便反向传播时计算梯度。 对于每一个中间结果,其数据形状为 [Batch, SeqLen, Dim]。
Collective Operations
为了节省显存,可以将模型或者数据分配到不同的显卡上,显卡之间有如下几种 [Collective Operations]。
Broadcast
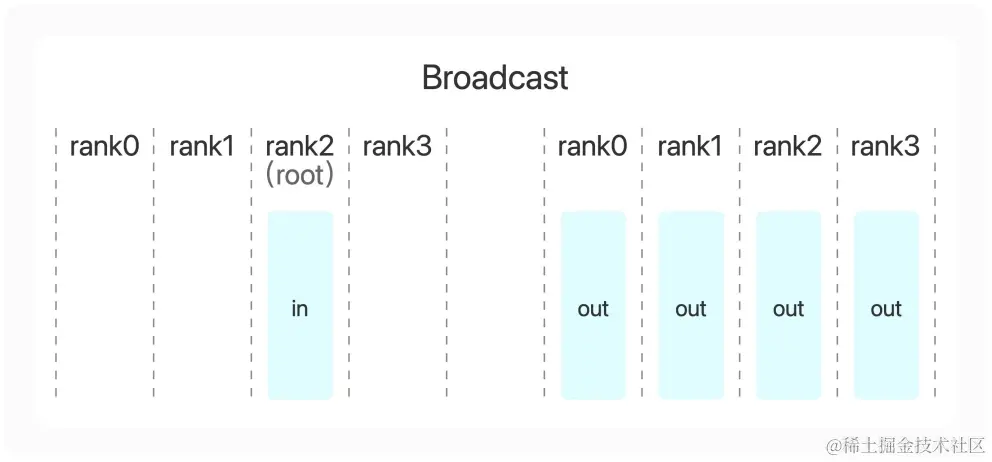
The Broadcast operation copies an N-element buffer on the root rank to all ranks.
广播操作将一张显卡上数据广播到所有显卡。
AllReduce、Reduce、ReduceScatter
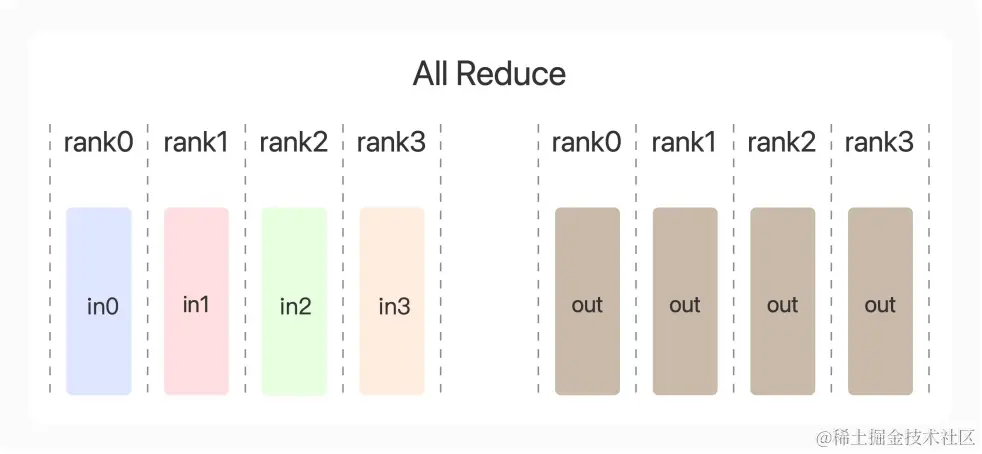
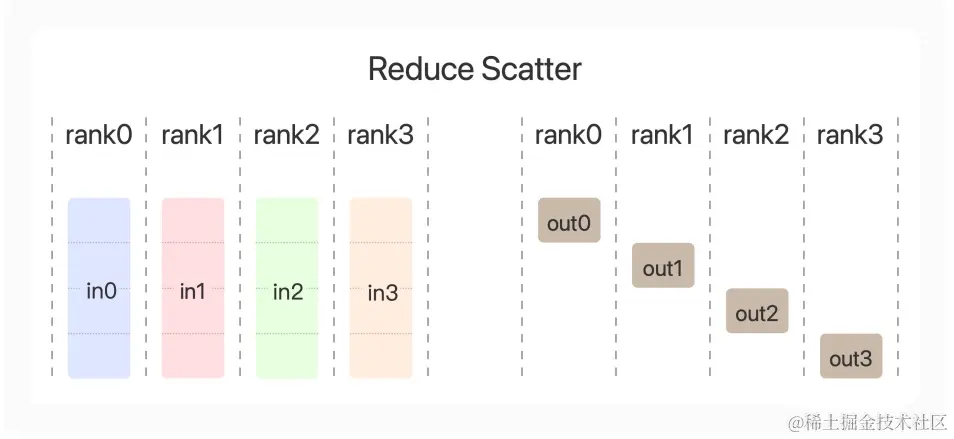
The AllReduce operation is performing reductions on data (for example, sum, min, max) across devices and writing the result in the receive buffers of every rank.
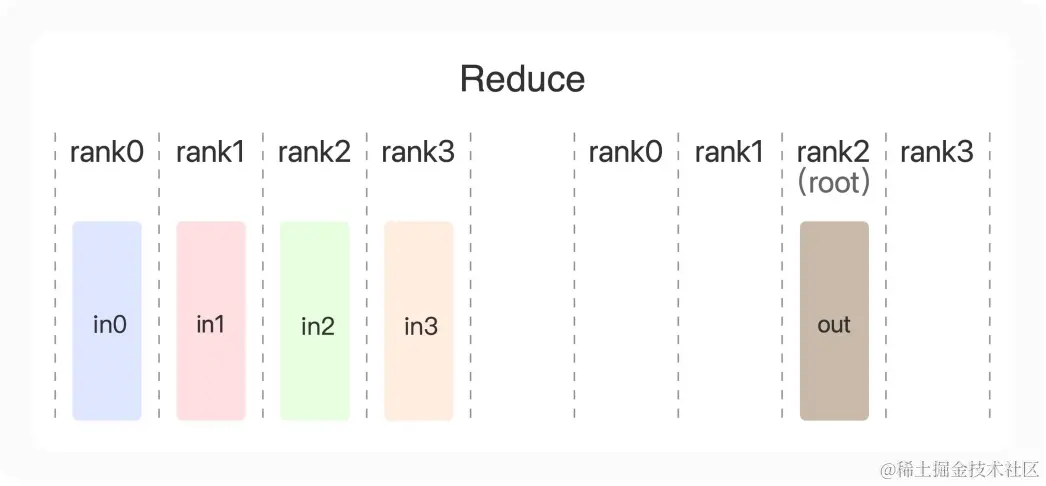
The Reduce operation is performing the same operation as AllReduce, but writes the result only in the receive buffers of a specified root rank.
The ReduceScatter operation performs the same operation as the Reduce operation, except the result is scattered in equal blocks between ranks, each rank getting a chunk of data based on its rank index.
AllReduce 操作将所有显卡上数据进行聚合如求和、取最大值或取最小值,并将结果写入所有显卡。
Reduce 只会将结果写入一张显卡。
ReduceScatter 则将结果分散在所有显卡中。
AllGather
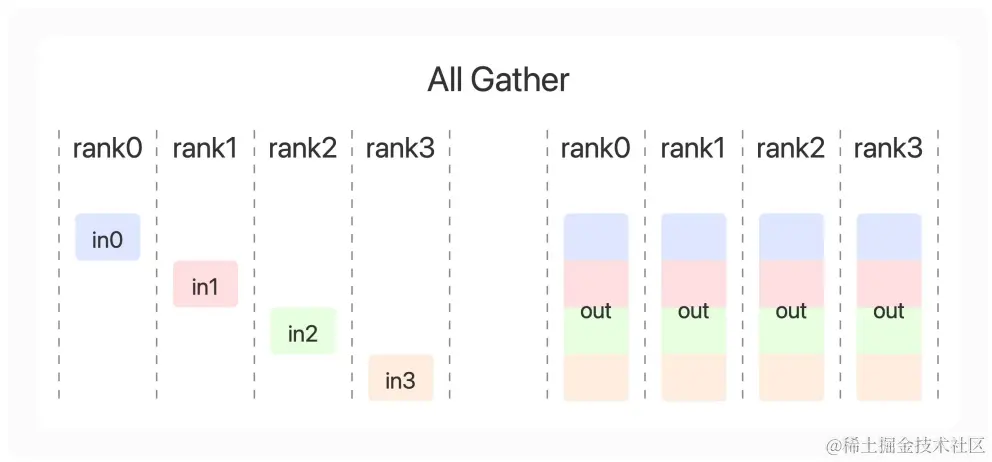
The AllGather operation gathers N values from k ranks into an output of size k*N, and distributes that result to all ranks.
AllGather 操作会收集所有显卡数据,并写入所有显卡中。
数据并行
数据并行是将数据分成若干份,装载到不同节点上进行计算。
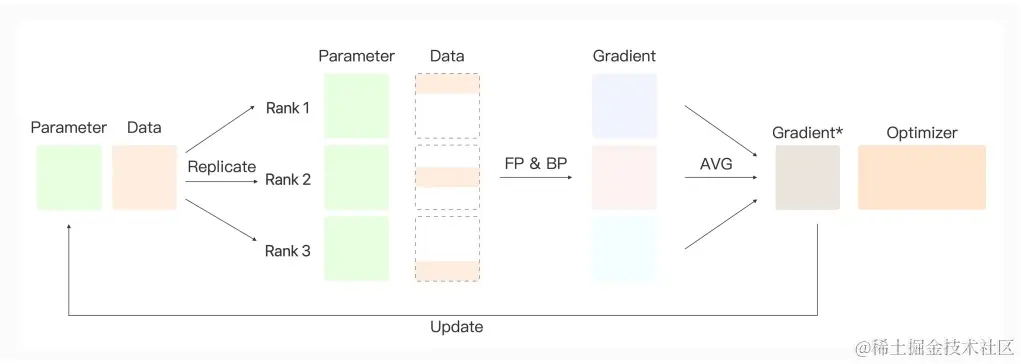
数据并行计算流程如下:
- 有个参数服务器保存模型参数。
- 参数被复制到不同的设备中,构成若干 replicas。每个 replica 处理一部分数据,进行前向传播和反向传播。
- 每个设备得到梯度进行 Reduce 操作,得到最终梯度,并按照这个梯度更新参数服务器中的模型参数。
- 在后向传播时,每计算完一层的梯度,就可以进行 Reduce 操作,提高并行性。
分布式数据并行
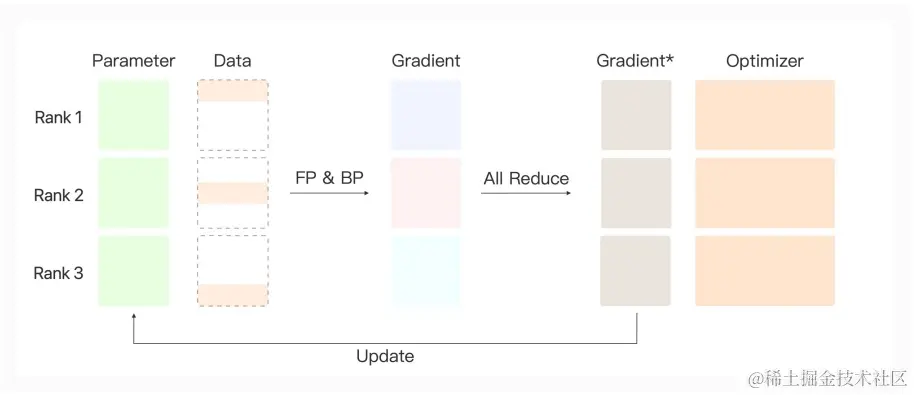
分布式数据并行中不存在参数服务器,其计算流程如下:
- 每个 replica 都保存模型参数,但是分别计算部分数据,进行前向传播和反向传播。
- 每个设备都得到梯度后进行 AllReduce 操作,将梯度写入所有设备,每个设备根据自己的优化器和梯度更新参数。
分布式数据并行中,每个设备显存占用情况如图:
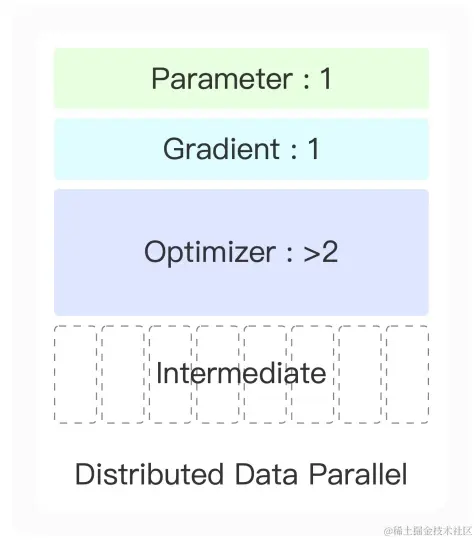
其中每个设备仍需要保存模型参数、梯度和优化器参数。
模型并行
由于模型越来越大,单个设备保存模型参数、梯度和优化器越来越难。因为深度学习主要是矩阵计算,而矩阵计算可以分块计算,因此可以将模型参数拆成若干份,每份单独计算,以减少显存占用。
yA=WA×BXB=[WAn×B(1);WAn×B(2);WAn×B(3)]XB=[WAn×B(1)XB;WAn×B(2)XB;WAn×B(3)XB]y_A=W_{A \times B} X_B \\ =[W^{(1)}_{\frac{A}{n} \times B};W^{(2)}_{\frac{A}{n} \times B};W^{(3)}_{\frac{A}{n} \times B}] X_B \\ =[W^{(1)}_{\frac{A}{n} \times B} X_B;W^{(2)}_{\frac{A}{n} \times B} X_B;W^{(3)}_{\frac{A}{n} \times B} X_B]yA=WA×BXB=[WnA×B(1);WnA×B(2);WnA×B(3)]XB=[WnA×B(1)XB;WnA×B(2)XB;WnA×B(3)XB]
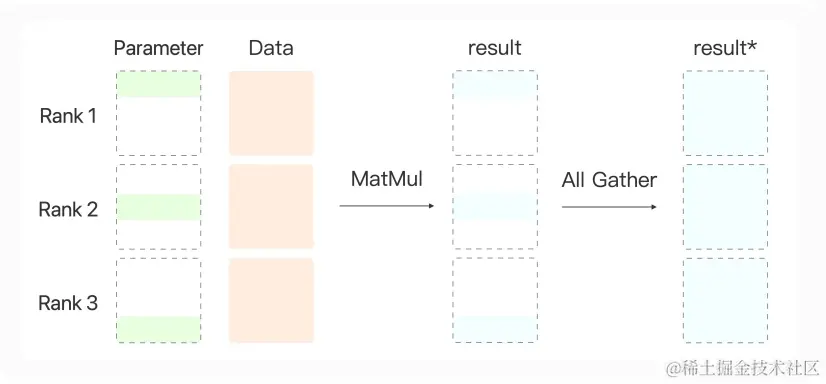
其计算流程如下:
- 将参数矩阵分成若干子矩阵,分发到不同设备中。
- 每个设备计算不同矩阵,然后将结果收集起来。
模型并行后,显存占用如下:
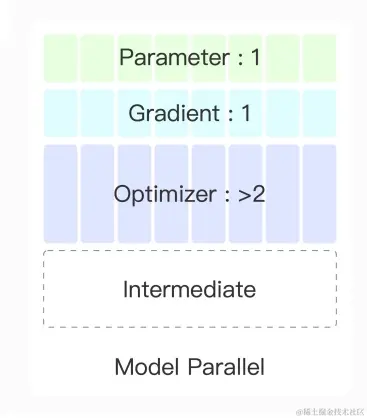
由于每个设备处理所有数据,因此中间结果都会保存在所有设备中。
ZeRO
在分布式数据并行中,最后梯度更新在不同设备进行的操作相同,多个设备中参数相同,梯度相同,优化器状态相同,存在大量冗余。
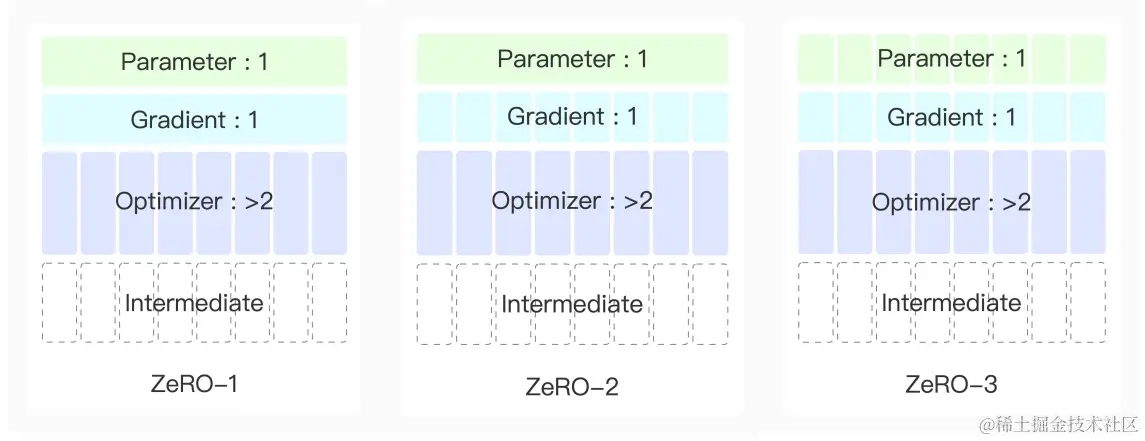
ZeRO-1 对优化器状态进行分片。
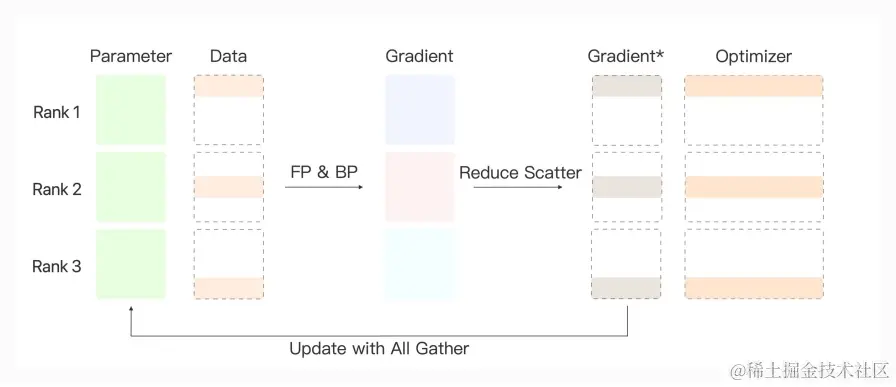
ZeRO-1 计算流程如下:
- 每个 replica 处理一部分数据输入。
- 独立进行前向传播。
- 独立进行反向传播。
- 得到完整梯度后进行 ReduceScatter,每个 replica 得到对应梯度。
- 每个 replica 更新梯度对应的部分参数。
- 使用 AllGather 同步更新所有参数。
ZeRO-2 计算流程与1基本相同,ZeRO-2在后向传播时,每计算一层梯度,就可以使用 ReduceScatter 进行同步,提高并行度。同时由于不需要完整计算梯度之后进行 ReduceScatter,每个 replica 只需要保存部分梯度即可。
ZeRO-3 在 2 的基础上,将模型参数进行分片。
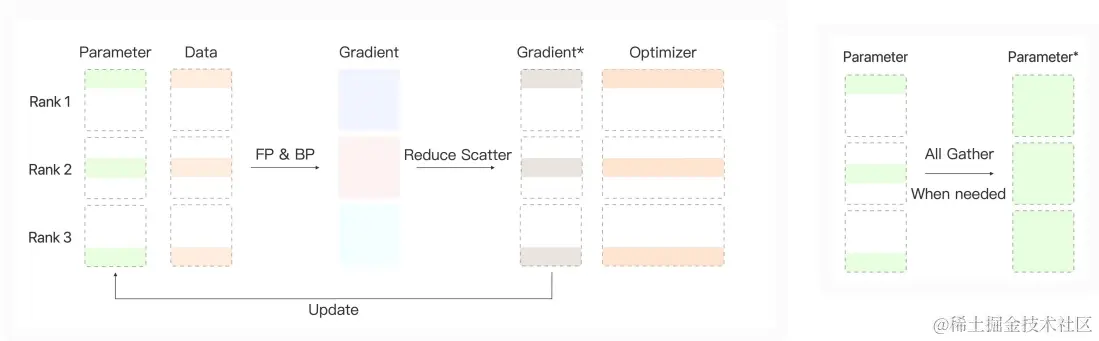
ZeRO-3 计算流程如下:
- 每个 replica 处理一部分输入。
- 前向传播时,当需要别的层参数,使用 AllGather 获取。
- 反向传播时,当需要别的层参数时,使用 AllGather 获取,同时计算出每一层梯度时,使用 ReduceScatter 分发到对应 replica。
- 每个 replica 用于部分优化器参数和梯度,进行对应参数更新。
不同 ZeRO 对应的显存占用情况:
流水线并行
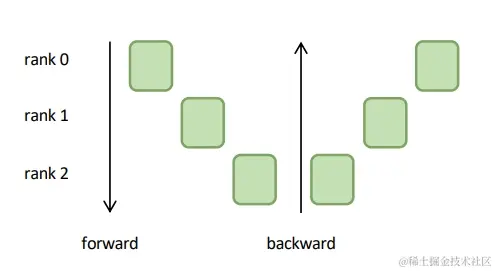
将模型一层一层分开,不同层放入不同 GPU 进行计算。个人理解与模型并行不同的是,模型并行保留从头到尾每一层的部分参数,输入可以计算出结果。流水线并行需要等前一层计算完毕才能进行计算。
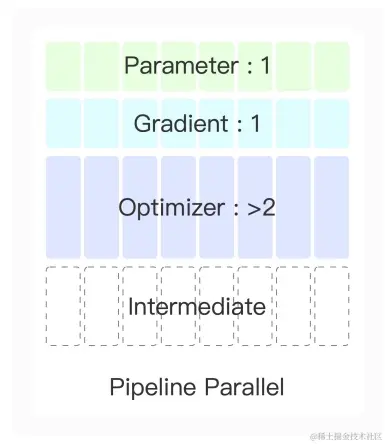
流水线并行显存分析:
混合精度
FP16 相较于 FP32 计算更快,同时占用更少的显存。但同时 FP16 表示的范围小,可能产生溢出错误。
特别的,在权重更新时 gradient * lr 导致下溢出。
混合精度训练的思路在优化器中保留一份 FP32 格式的参数副本,而模型权重、梯度等数据在训练中都是用 FP16 来存储。
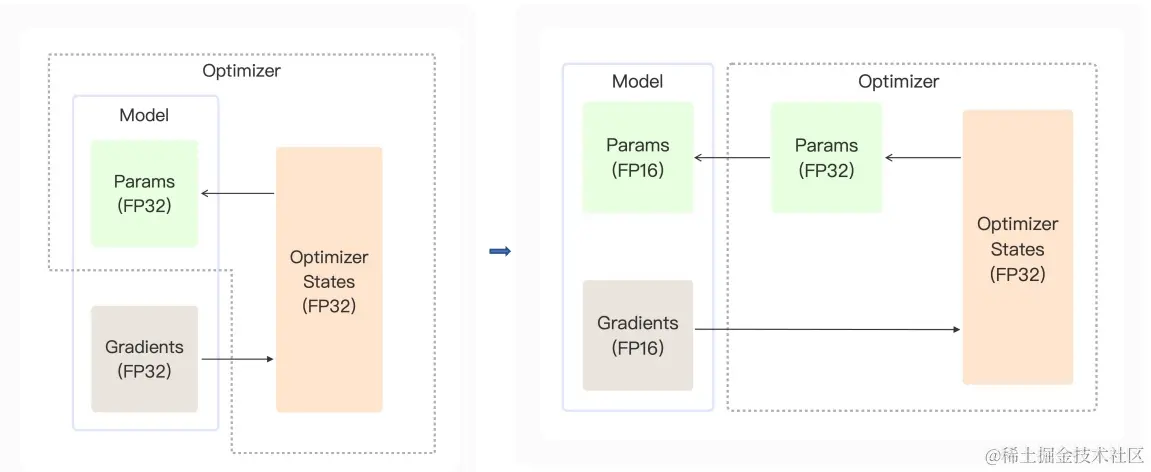
优化器中参数更新在 FP32 格式下保证精度,之后转换为 FP16 格式。
Checkpointing
由于模型反向传播需要中间结果计算梯度,大量中间结果占用大量显存。
Checkpointing 思路是保存部分隐藏层的结果(作为检查点),其余的中间结果直接释放。当反向传播需要计算梯度时,从检查点开始重新前向传播计算中间结果,得到梯度后再次释放。

如何学习AI大模型?
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
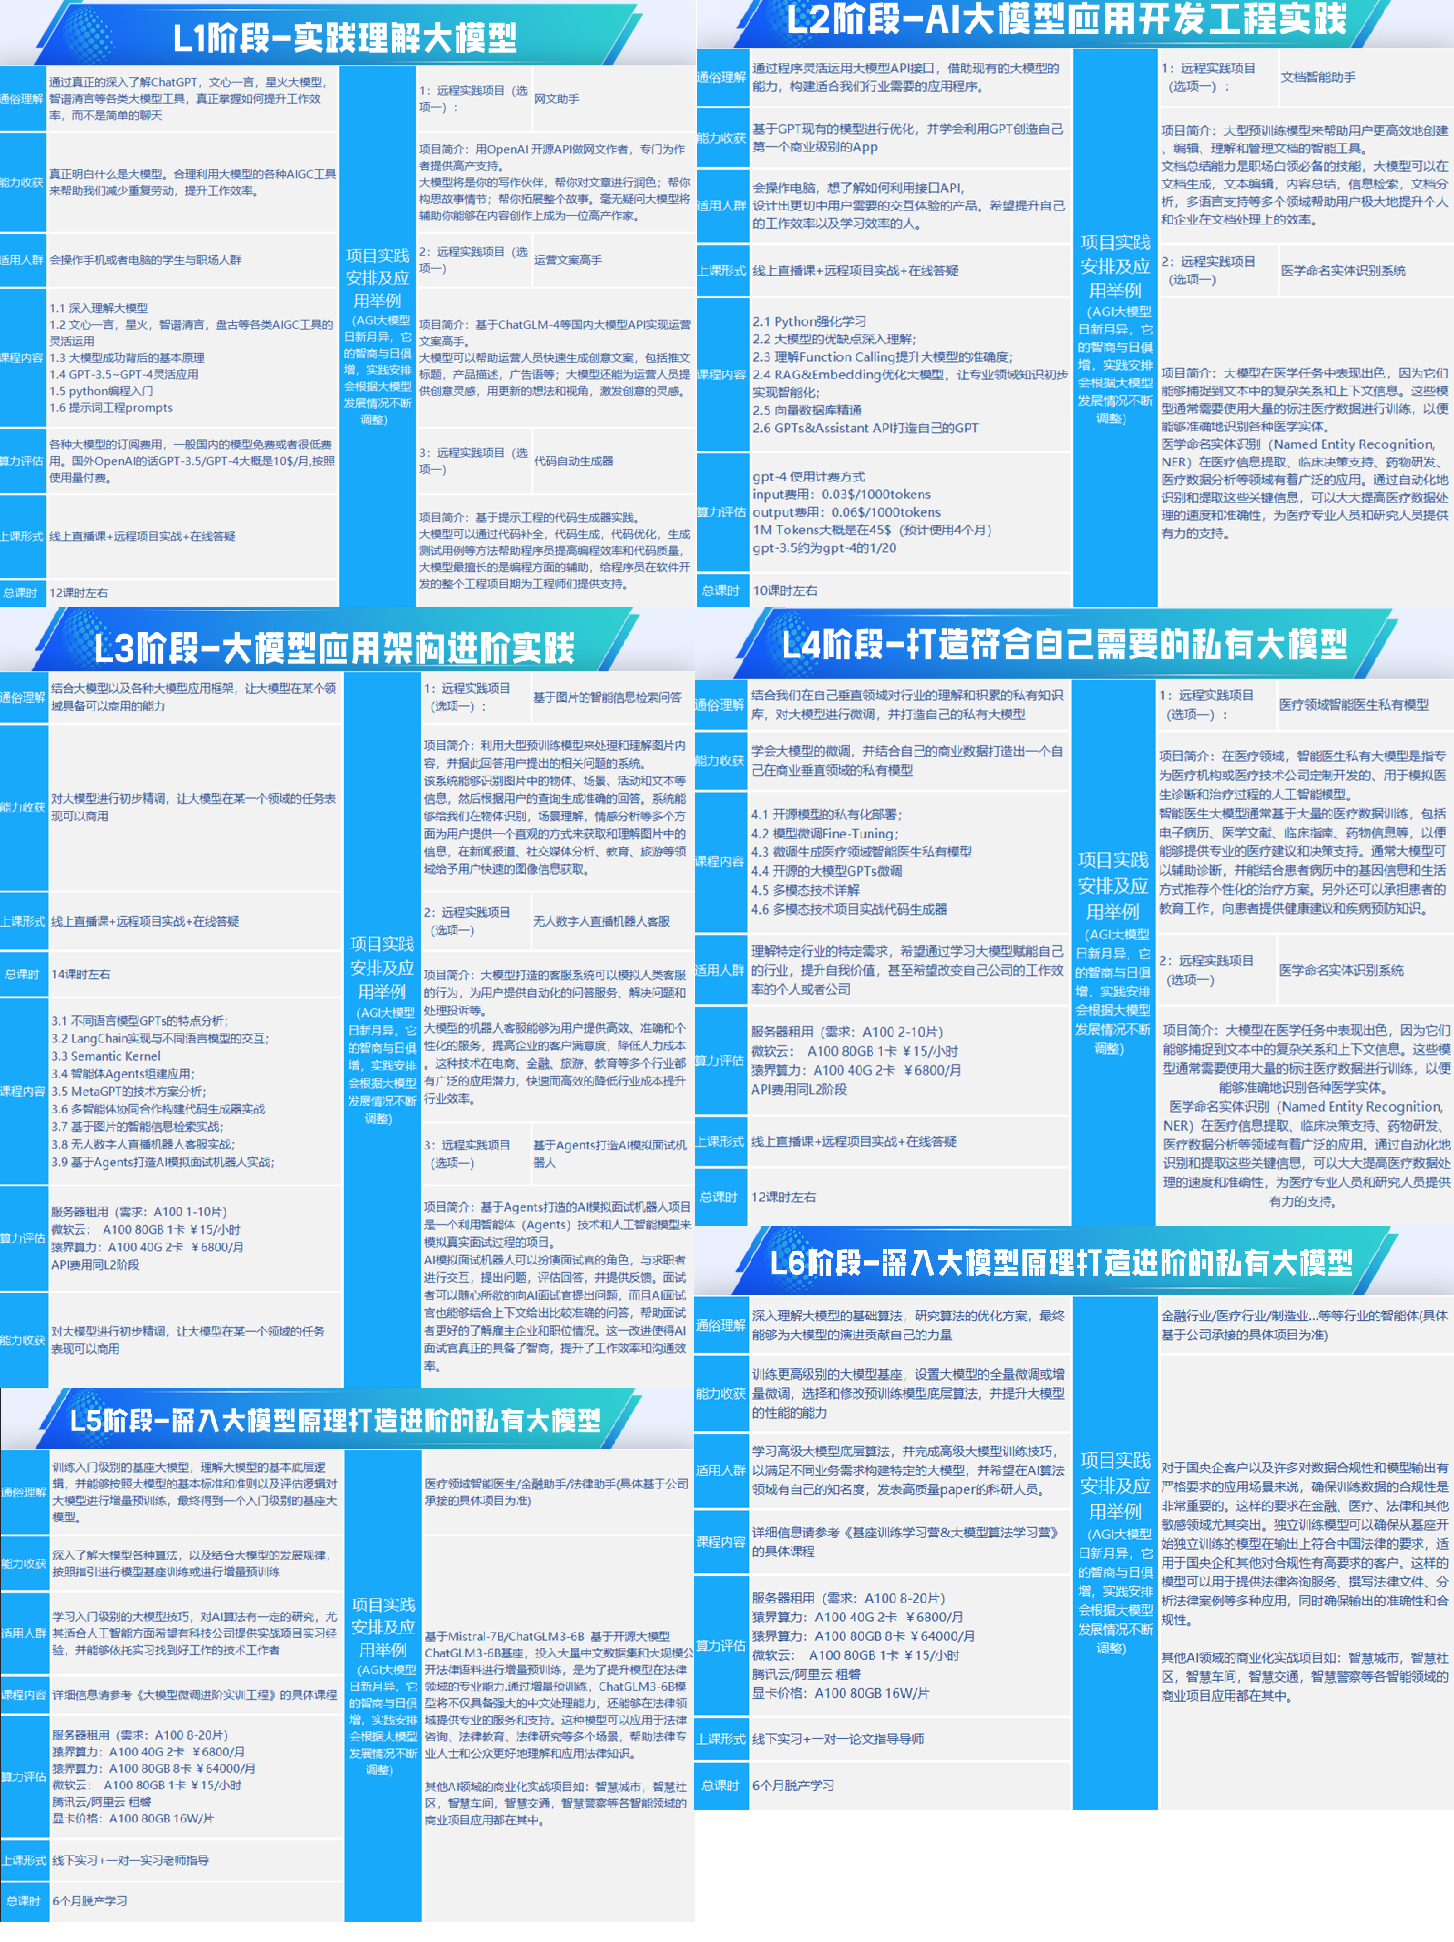
第一阶段: 从大模型系统设计入手,讲解大模型的主要方法;
第二阶段: 在通过大模型提示词工程从Prompts角度入手更好发挥模型的作用;
第三阶段: 大模型平台应用开发借助阿里云PAI平台构建电商领域虚拟试衣系统;
第四阶段: 大模型知识库应用开发以LangChain框架为例,构建物流行业咨询智能问答系统;
第五阶段: 大模型微调开发借助以大健康、新零售、新媒体领域构建适合当前领域大模型;
第六阶段: 以SD多模态大模型为主,搭建了文生图小程序案例;
第七阶段: 以大模型平台应用与开发为主,通过星火大模型,文心大模型等成熟大模型构建大模型行业应用。
👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;
• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;
• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;
• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。
1.AI大模型学习路线图
2.100套AI大模型商业化落地方案
3.100集大模型视频教程
4.200本大模型PDF书籍
5.LLM面试题合集
6.AI产品经理资源合集
👉获取方式:
😝有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓
更多推荐

 28
 0
- 0


 已为社区贡献8条内容

所有评论(0)