
【实操实录】从 0 到 1 搭一个能跑起来的 RAG 问答系统:从模型API调用配置、文档解析、文本处理、向量化存储到将复杂查询分解为子问题、查询意图识别、多跳问题处理等关键环节进行了详细说明
大家好,笔主是一名大一人工智能NLP邻域的自学小白,现在在学习基于RAG检索技术的问答系统,学习之初,在大量浏览博客与文章后却苦恼于具体细节无法直接下手实践,每个流程具有应该实现,实践后发现有特别多细节与思考解决的问题,接下来我将从我的实践中遇到的细节进行总结归纳,文笔可能不够好,有什么建议欢迎在评论区给出,谢谢大家
一、申请调用模型的api
📌1:构建大模型调用能力
配置 大模型API Key, 以DeepSeek大模型为例
🟣API Key 申请页面:https://platform.deepseek.com/api_keys
api_base_c = "https://api.deepseek.com/v1/chat/completions"
api_key_c = "替换为自己的api_key"
model_c = "deepseek-chat"
llm = DeepSeek(
    model=model_c,
    api_key=api_key_c);

result = llm.chat(
    messages=[ChatMessage(role="user", content="你好")]
)

print(result)
📌2..构建向量模型调用能力
配置 嵌入模型API Key, 以硅谷激流为例
🟣.访问官网:https://cloud.siliconflow.cn/zh-cn
🔵.登录后,在控制台左侧导航栏点击 【API 密钥】 → 【新建 API 密钥】,生成 sk-开头的密钥
🟡.API 端点:https://api.siliconflow.cn/v1/embeddings
api_base_e = "https://api.siliconflow.cn/v1/#embeddings"
api_key_e = "替换为自己的api_key"
mode_e = "BAAI/bge-m3"
二.定义和Llamaindex接口适配的类
os.environ["OPENAI_API_KEY"] = api_key_e;
client = OpenAI(base_url=api_base_e)  # 硅基流动的 API 端点
class SiliconFlowEmbedding(BaseEmbedding):
    def __init__(self, **kwargs):
        super().__init__(**kwargs)

    def _get_query_embedding(self, query: str):
        response = client.embeddings.create(
            input=query,
            model=mode_e  # 替换为硅基流动实际支持的嵌入模型名称
        )
        return response.data[0].embedding

    def _get_text_embedding(self, text: str):
        return self._get_query_embedding(text)

    def _get_text_embeddings(self, texts: list[str]):
        response = client.embeddings.create(
            input=texts,
            model=mode_e  # 替换为硅基流动实际支持的嵌入模型名称
        )
        return  [data.embedding for data in response.data]
    # 异步获取查询嵌入
    async def _aget_query_embedding(self, query: str):
        return self._get_query_embedding(query)
# 创建嵌入实例
embed_model = SiliconFlowEmbedding()
三、加载知识文档
📌1.文档解析
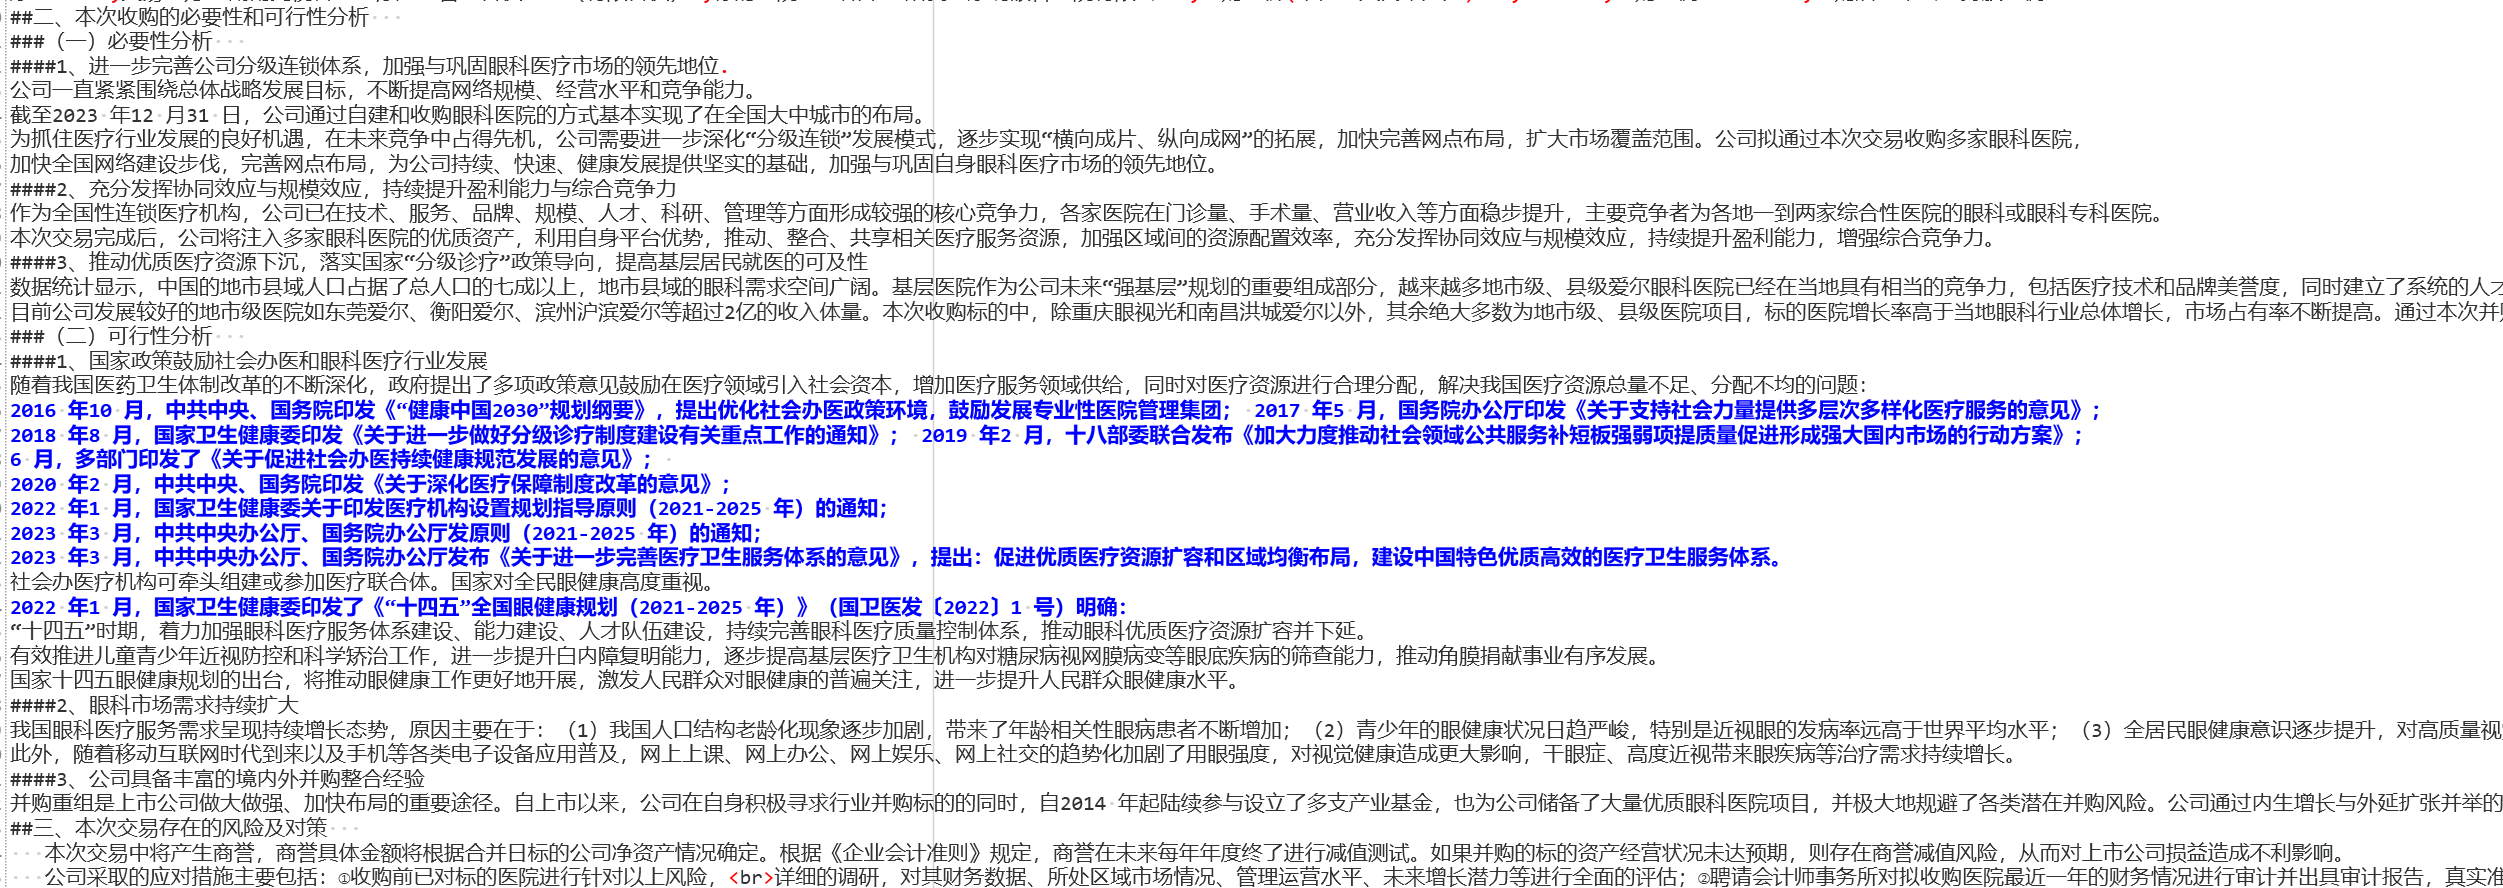
📌2、为什么要做文档解析
📌3.加载知识文档
在项目根目录下创建data文件夹,将格式化后的文本放到文件夹下
documents = SimpleDirectoryReader("放入知识文档的绝对路径").load_data()
📌4.切割文本
对加载的格式化文本内容进行切割处理,有不同的切割粒度,通过chunk_size的阈值控制切割出来的节点大小,需要设置滑动窗口设置来避免语义的缺失
def split_into_categories(self, text: str) -> Dict[str, str]:
        categories = {}
        for cat, pattern in self.category_patterns.items():
            matches = re.finditer(pattern, text, re.IGNORECASE)
            for match in matches:
                start = match.end()
                end = len(text)
                for next_cat, next_pat in self.category_patterns.items():
                    next_match = re.search(next_pat, text[start:], re.IGNORECASE)
                    if next_match:
                        end = min(end, start + next_match.start())
                categories[cat] = text[start:end].strip()
        return categories
四、创建向量库
向量化的本质是语义的相似度的抽象表达方式,不管是embedding,还是bm25,都是检索文本内容与问题语义的匹配度
class SiliconFlowEmbedding(BaseEmbedding):
    sync_client: OpenAI = Field(default_factory=lambda: OpenAI(
        api_key=api_key_e,
        base_url=api_base_e
    ))
    async_client: AsyncOpenAI = Field(default_factory=lambda: AsyncOpenAI(
        api_key=api_key_e,
        base_url=api_base_e
    ))

    def __init__(self, model: str, **kwargs):
        super().__init__(model_name=model, **kwargs)

    def _get_query_embedding(self, query: str) -> List[float]:
        response = self.sync_client.embeddings.create(
            input=query,
            model=embed_model_name
        )
        return response.data[0].embedding

    def _get_text_embedding(self, text: str) -> List[float]:
        return self._get_query_embedding(text)

    def _get_text_embeddings(self, texts: List[str]) -> List[List[float]]:
        response = self.sync_client.embeddings.create(
            input=texts,
            model=embed_model_name
        )
        return [data.embedding for data in response.data]

    async def _aget_query_embedding(self, query: str) -> List[float]:
        response = await self.async_client.embeddings.create(
            input=query,
            model=embed_model_name
        )
        return response.data[0].embedding

    async def _aget_text_embedding(self, text: str) -> List[float]:
        return await self._aget_query_embedding(text)

embed_model = SiliconFlowEmbedding(model=embed_model_name)
五、查询分解
结合我们日常查询,不难想到,查询问题有简单也有复杂,可以思考一下,如果让自己对问题做分类,可以怎么分类?
从我的角度,我将从深度和广度、对象和属性这三个角度作为切入
📌1.简单问题
单个对象的单个属性,比如:小明的哥哥是谁,对象不具有多个定语修饰,也只有一 个谓语
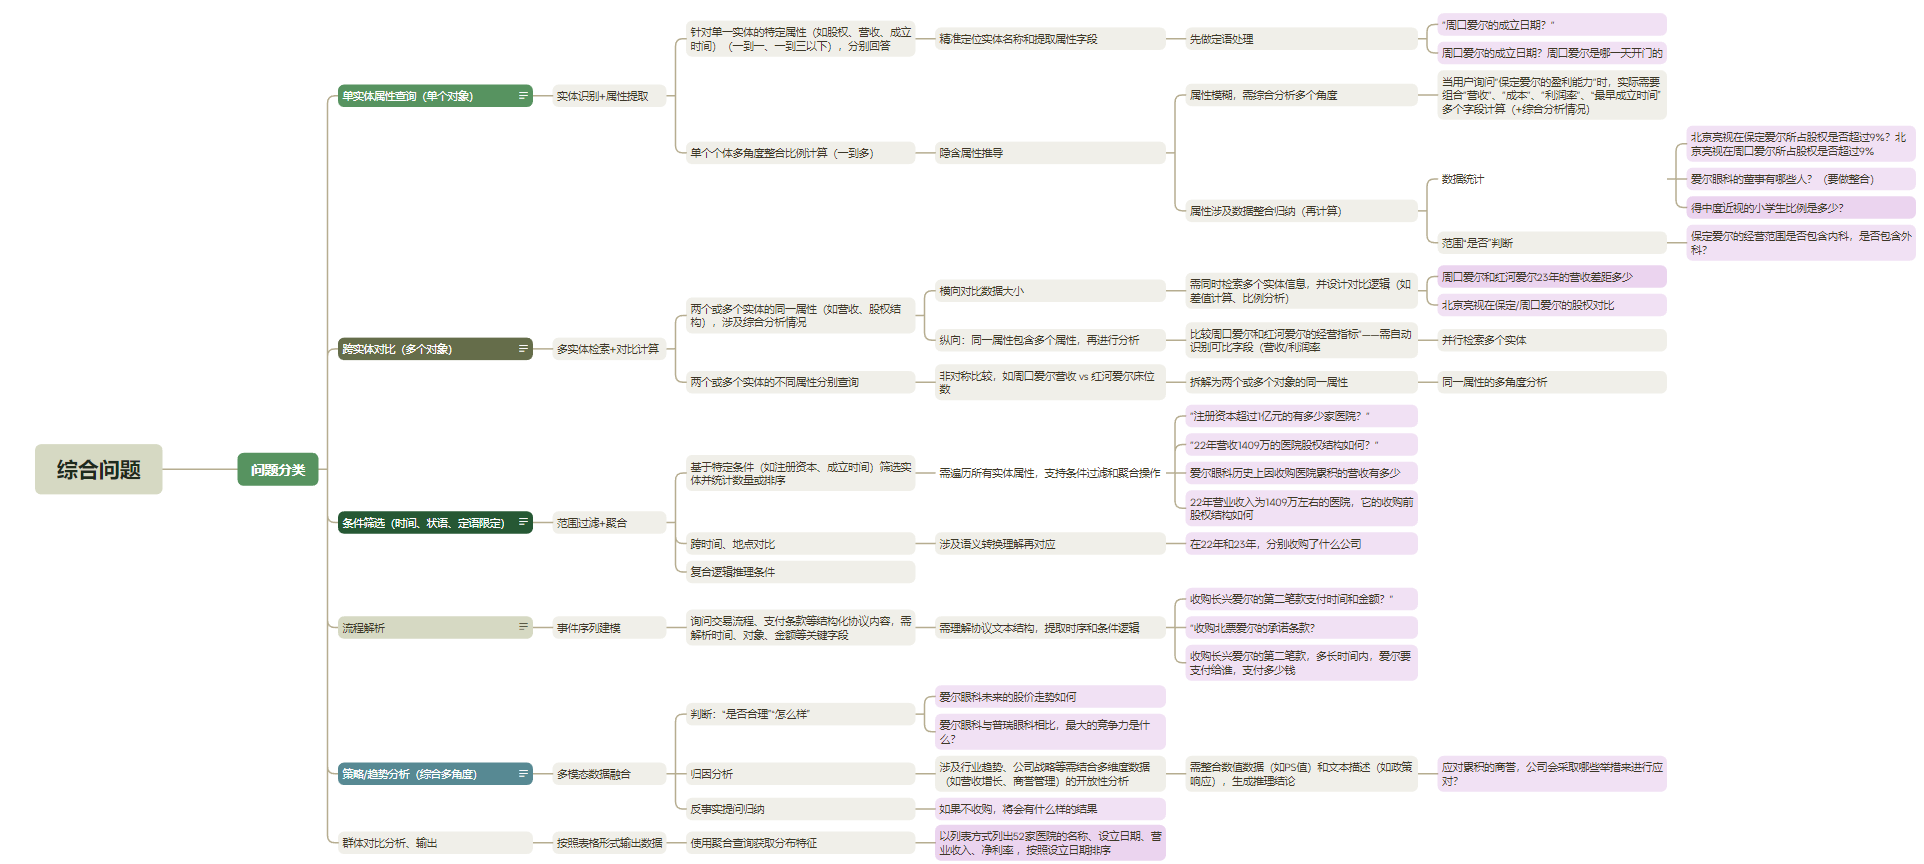
📌2.综合问题
综合问题是指需要结合多源信息、多维度推理或跨领域知识才能回答的问题属于广度角度,属于并列角度,比如:
马斯克和德普的共同好友有谁?
2023 年 9 月尼日尔政变后,法国对尼日尔电力供应实施了哪一项“精确制裁”?
截至 2024 年 7 月,全球仍在运行的“海上浮动核电站”共有多少座?
下面是我对综合问题的分类角度:
📌3.多跳问题
多跳问题(Multi-hop Question)是指需要模型通过多次推理或信息关联才能回答的问题,前后有前提依赖推理的查询,属于深度角度,需要一步步深挖依赖,比如:
🟣.本月迟到次数最多的员工所在部门预算
子问题拆解:"本月迟到次数最多的员工是谁?", "该员工所在部门是哪个?", "该部门预算是多 少?"
🔵.国家自然科学基金间接促进了哪些科学研究仪器设备的销售?
子问题拆解:"国家自然科学基金资助了哪些科学研究项目?", "这些项目采购了哪些科学研究仪 器设备?"
🟡.论文A间接引用了哪些19世纪的经典研究?作者分别是谁?
子问题拆解:"论文A引用了哪些论文", "这些被引用的论文引用了哪些19世纪的经典研究?", "这 些19世纪的经典研究的作者分别是谁?"
📌4.意图识别
意图识别是指在用户输入查询(Query)时,系统自动分析其潜在目标或操作意图,从而指导后续的检索(Retrieval)和生成(Generation)过程。其核心是理解用户“想做什么”,而非仅解析字面含义,比如:
用户输入:
“为什么OpenAI的Sora模型生成的视频比Runway更流畅?”
接下来大模型会意图识别:
-
分类为分析型意图(需对比技术细节)。
-
检索策略:
-
优先抓取Sora和Runway的技术报告、评测文章。
-
过滤无关内容(如公司新闻)。
-
-
生成策略:
-
总结关键差异(如帧率、物理模拟算法)。
-
引用权威来源增强可信度
-
:
以上这些分类,我们都需要通过提示词的方式,告诉大模型具体怎么识别与拆解子问题;
class QuestionDecomposer:
    def __init__(self, llm):
        self.llm = llm

    def decompose(self, question: str) -> List[str]:
        """优化后的分解方法,严格基于原问题语义"""
        prompt = f"""
        请将以下问题分解为2-3个最相关的子问题,要求:
        1. 每个子问题必须直接服务于解决原问题
        2. 保持原问题中的关键实体和属性不变
        3. 不要引入原问题未提及的新概念

        示例:
        原问题:注册资本超过1亿元的医院有多少家?
        子问题:
        1. 注册过资本有哪些医院?
        2. 这些医院的注册资本分别是多少?
        3. 注册资本超过1亿元的医院有哪些?

        现在请分解以下问题:
        原问题:{question}
        子问题:
        """
        response = self.llm.complete(prompt)
        return self._parse_subquestions(response.text)

    def _parse_subquestions(self, response_text: str) -> List[str]:
        """解析LLM返回的子问题"""
        sub_questions = []
        for line in response_text.split("\n"):
            line = line.strip()
            if line and re.match(r"^\d+\.", line):
                sub_questions.append(re.sub(r"^\d+\.\s*", "", line))
        return sub_questions

    def solve_subproblems(self, sub_questions: List[str], context: List[str] = []) -> List[str]:
        context = context or []
        solutions = []
        for sub_q in sub_questions:
            prompt = f"已知信息:{';'.join(context)}\n问题:{sub_q}\n回答:"
            response = self.llm.complete(prompt)
            solution = response.text.strip()
            solutions.append(solution)
            context.append(f"问题:{sub_q};回答:{solution}")
        return solutions
六、检索召回
📌 1 入口:原始问题 = 第一重召回闸口
用户提问进入系统后,先做意图分类 + 消歧。
-
如果单轮即可回答(简单事实、时间地点类),直接走“单跳 RAG”——打包召回→抽取→生成答案,流程结束。
-
如果需要拆解(复杂因果、跨实体、模糊统计),则把原问题语义保留为永久闸口,进入下面的“子问题并发迭代”模式。
📌 2 子问题拆分:并发探路,但随时拉回闸口
-
生成子问题
意图识别 + 消歧模块输出 N 个子问题,每条子问题只负责补全原问题的一个缺失侧面。 -
按批次并发
每批 2 条子问题同时丢给各自的iterative_search代理(独立的 embedding、混合召回、重排)。-
各自内部仍然遵循我们之前说的“每探一步就拉回闸口”:
– 用原问题的核心语义做相关性过滤(score≥0.6)。
– 用连续 5 次抽取失败或已足够回答作为本链路的停止信号。
-
-
事件流合并
所有子代理的事件流通过_merge_agent_run实时合并到前端,用户能看到“知识块”逐步浮现。
📌 3 事实抽取:把碎片拼成“实体-属性-值”三元组
-
每批子问题的检索结果先拼接成
content,再统一调用fact_extractor代理。 -
实时反馈:
reasoningLogDelta把刚抽到的三元组推送给前端,实现“边搜边展示”。 -
累积池:所有子问题的三元组进入
sub_query_facts,后续每轮迭代只用新增事实与闸口做交叉验证,避免重复计算。
📌 4 结果整合:再次过闸口,决定“是否再转一圈”
-
答案充分性检查器(search_results_checker)把当前全部事实与原问题语义做匹配:
– 若is_sufficient=True,螺旋终止,进入最终答案生成。
– 若仍缺关键信息,把缺口反向翻译成新的子问题,回到第 2 步继续并发迭代 -
长文本重排(可选):如果单次召回结果过长,再做一次 rerank,保证闸口过滤效率。
📌 5 最终答案:一次性输出,但仍保留可追溯性
-
AnswerQuestionAgentTemplate把原问题 + 全部累积事实 + 会话历史一次性喂给 LLM。 -
结果通过
answerStart→answerDelta→answerEnd事件流输出,同时把最终答案写入enterprise_content持久化。 -
前端用户能看到完整引用链,实现“可审计的 RAG”。
七、致谢
谢谢大家的阅读,本篇文章是笔者的第一篇文章,还有很多不足支出,欢迎大家在评论区指出,如果我的内容对你有帮助,可以点赞 , 收藏 ,大家的支持就是我坚持下去的动力!
”请赐予我平静,去接受我无法改变的 :赐予我勇气,去改变我能改变的。”
更多推荐
 32
 0
- 0


 已为社区贡献2条内容

所有评论(0)