
基于 Rokid AIUI:从掏手机到一句「开跑」,我做了《悦跑教练》
我跑步跑了六七年,配速这事一直别扭。跑到一半想看眼配速,得停下,掏手机,解锁,点开跑步 APP,等它转完那一圈。冬天手指头冻得伸不直,摘手套那几秒是真难受。智能手表能显示数据,可要切歌、换个播客,还是得回到手机。有了 Rokid Glasses 之后我就想,能不能换个做法。戴上眼镜,说一句「开跑」,它自己记、自己报,手不用离开摆动节奏。于是就有了《悦跑教练》,一个跑在 Rokid Glasses 上的 AIUI 跑步智能体。
接下来讲讲它是怎么搭起来的,中间踩过的坑我一并写清楚。
一、项目简介
《悦跑教练》解决的是一个很小的麻烦,跑步的时候不想掏手机。目标用户是每周跑三到五次的城市跑者。这类人不需要专业训练系统,也不想看复杂图表,要的就是一个不用掏手机就能报数、能顺手记下来的东西。眼镜在这个场景里挺合适。它一直戴在头上,抬眼就能看,开口就能用,手还在摆臂。这一点手机做不到,手表只做到一半。
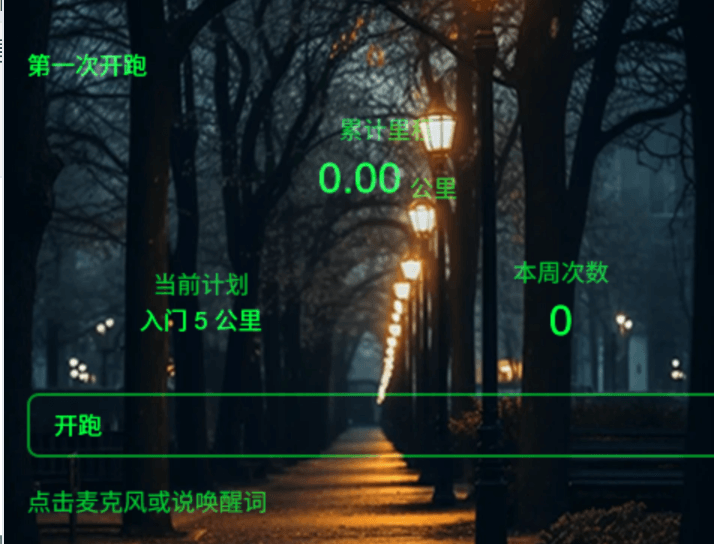
功能上有四块。累计数据看主页,实时数据在跑步页,训练计划分三档,历史记录存最近二十次。就这些。我没往里塞社交,也没做训练指导,做多了反而用不上。
二、场景与用户意图
跑步这个场景有几个特点,直接决定了智能体该怎么设计。
唤醒的时机分两种。 一种是出门前站在楼下,说完「开始跑步」就要走,没耐心等页面转圈。另一种是跑到一半喘着气,只想说一两个字把事情办了。
用户嘴里说的不会标准。 「开始跑步」「开跑」「跑起来」是一个意思,「暂停」「停一下」「歇会儿」也是一个意思。更麻烦的是跑起来呼吸重,识别结果经常吞字或者串音。我实测过十几条含混的语音输入,「开跑」被正确识别的概率不到一半,倒是「开炮」出现过两次,还有一次识别成了「开跑吧」。
所以意图识别不能做精确匹配。我在 parseCommand 里按关键词分组,一共分了十一组,每组共享一个动作。挑几组主要的说。
-
开始组用「开始、开跑、出发、跑起来、开练」
-
暂停组用「暂停、歇一下、停一下、等一等」
-
继续组用「继续、接着跑、恢复」
-
结束组用「结束、跑完、不跑了、停跑、收工」
-
查询拆成两组,问当前状态用「播报、报一下、多少公里、现在配速」,问历史用「记录、历史、上次、成绩、跑过」
「开始跑步」「暂停一下」这类完整口令写在 AGENTS.md 的意图声明里,把宿主和页面的职责分开。
/* ---------------- 指令解析 ---------------- */

// 顺序很重要:先匹配语义更明确的指令,避免"结束跑步"被"跑步"误判为开始
const RULES = [
  { command: 'finish', keywords: ['结束', '跑完', '不跑了', '停跑', '收工'] },
  { command: 'pause', keywords: ['暂停', '歇一下', '停一下', '等一等'] },
  { command: 'resume', keywords: ['继续', '接着跑', '恢复'] },
  { command: 'back', keywords: ['返回', '回去', '回首页', '上一页', '退回'] },
  { command: 'start', keywords: ['开始', '开跑', '出发', '跑起来', '开练'] },
  { command: 'report', keywords: ['播报', '报一下', '多少公里', '现在配速', '什么情况'] },
  { command: 'plan', keywords: ['计划', '训练', '课程', '方案'] },
  { command: 'history', keywords: ['记录', '历史', '上次', '成绩', '跑过'] },
  { command: 'confirm', keywords: ['就这个', '用这个', '确认', '选定', '选它'] },
  { command: 'next', keywords: ['下一个', '换一个', '切换', '后面'] },
  { command: 'prev', keywords: ['上一个', '前一个', '前面'] },
];

export function parseCommand(text) {
  if (!text) return 'unknown';
  const content = String(text);
  for (const rule of RULES) {
    for (const keyword of rule.keywords) {
      if (content.includes(keyword)) return rule.command;
    }
  }
  return 'unknown';
}
三、方案设计
智能体定义
名字叫「悦跑教练」,定位是随身的配速播报器加简易记录本。不做训练指导,不做社交,不做排行榜。
页面与结构
四个页面都在 .ink 单文件里写。
- 主页 累计里程、本周次数、当前训练计划入口
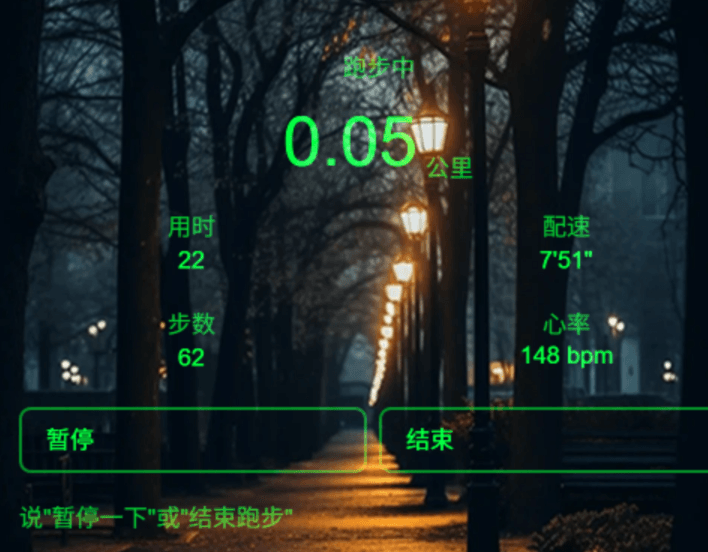
- 跑步中 实时距离、配速、步频、心率估算、卡路里
- 训练计划 5km 入门、10km 进阶、减脂燃脂三档
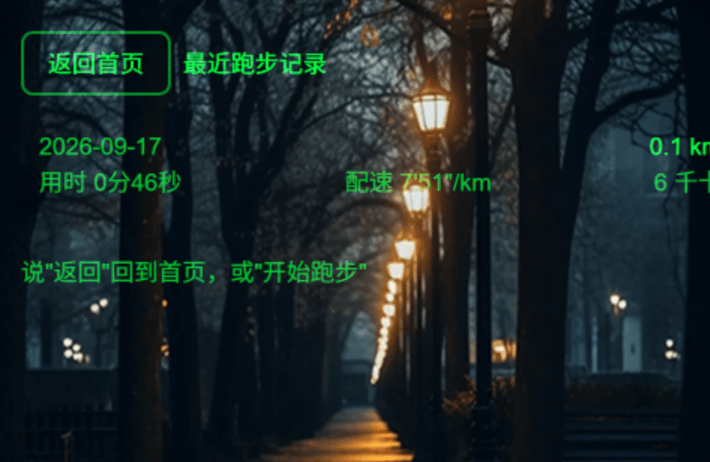
- 历史记录 最近 20 次
状态流转
待机 → 主页面
  ↓ 说「开始跑步」/ 点「开跑」
跑步中 → 计时器启动,TTS 进入每 5 分钟播报节奏
  ↓ 说「暂停」/ 摸镜腿
已暂停 → 计时器挂起,数据冻结
  ↓ 说「继续」/ 再摸镜腿
跑步中(恢复)
  ↓ 说「结束跑步」/ 按返回键 / 点「结束」按钮
保存对话框 → 写入本地存储 → 回到主页面
能力调用关系
| 能力 | 用途 |
|---|---|
| 语音识别(ASR) | 听懂开始、暂停、继续、结束、查询 |
| 语音合成(TTS) | 开跑提示、每 5 分钟播报、结束播报成绩 |
| 本地存储 | 存最近 20 次跑步记录 |
| 页面事件 | 接管唤醒、镜腿按键 |
| 屏幕渲染 | 实时数据展示与按钮点击 |
四、AIUI 实现
项目结构
├── lib/
│   └── voice.js           # TTS 播报 + ASR 识别 + 指令解析
├── pages/
│   ├── index/index.ink    # 主页
│   ├── running/index.ink  # 跑步中
│   ├── plan/index.ink     # 训练计划
│   └── history/index.ink  # 历史记录
├── AGENTS.md              # 智能体说明文档
├── app.js                 # 应用入口脚本
└── app.json               # 应用配置(路由 + 权限声明)
voice.js 里的三个方法
speak(text) 负责播报,用的是 SpeechSynthesisUtterance 配 speechSynthesis.speak(utterance, 'enqueue')。
第二个参数是关键。我第一版没传,结果播报和用户语音掐在一起。跑到一半它正在播「当前配速」,我说「暂停」,两个声音叠着出来。加上 'enqueue' 之后播报进队列,一条播完才播下一条。
createListener(onResult) 负责识别。AIUI 里 SpeechRecognition 有两种模式。简单模式的 start / stop / abort 由页面自己控制,会话模式走 SpeechRecognitionSession,结束点交给系统判断,适合长对话。跑步这种两个字就说完的场景,用简单模式就够。
parseCommand\(text, commands) 负责匹配。按上面说的关键词分组,命中哪组就返回哪个动作。
页面事件接管
这块是 AIUI 跟普通页面框架差别最大的地方。宿主会把语音唤醒和硬件按键事件分发给当前页面,接不接、怎么接,由页面自己决定。
每个页面都要写这三段。
// 语音唤醒,必须 preventDefault 接管,否则宿主自己处理掉了
onVoiceWakeup(event) {
  event.preventDefault()
  this.startListening()
}

// 镜腿按键
onKeyUp(event) {
  if (event.code === 'GlobalHook') {
    // 镜腿触摸,跑步页里做暂停切换
  } else if (event.code === 'Enter') {
    // 确认
  } else if (event.code === 'ArrowUp' || event.code === 'ArrowDown') {
    // 计划页切换焦点
  }
}
键码对应关系是这样的。镜腿触摸是 GlobalHook,确认是 Enter,上下导航是 ArrowUp 和 ArrowDown。
app.json 权限声明
"permissions": ["RECORD_AUDIO"]
这条漏了就是静默失败。页面不报错,麦克风也没反应,排查起来最费时间。
AGENTS.md
按官方格式写,一级标题是 # Agent: 悦跑教练,下面分 ## System Prompts、## Capabilities、## Configuration、## Dependencies。语音意图写在 System Prompts 里,把「开始跑步」「暂停一下」「结束跑步」这类完整口令声明清楚,让宿主和页面的职责边界明确。
# 悦跑教练 · Rokid AIUI 跑步智能体

一款运行在 Rokid Glasses 上的 AR 跑步助手智能体,按 AIUI 官方规范(`.ink` 单文件组件 + 页面级事件)编写,可直接导入使用。

## v1.1 更新:修复"点麦克风/镜腿无反应"

**原因**:v1.0 只实现了页面渲染,没有实现页面级事件回调,宿主不知道把语音/按键事件分发给谁。

**修复内容**:

| 修复项 | 说明 |
|--------|------|
| `onVoiceWakeup` 事件 | 每个页面都实现了该回调,唤醒后会 `event.preventDefault()` 接管交互并启动 ASR 识别 |
| ASR 语音识别 | 新增 `lib/voice.js` 封装 `SpeechRecognition`,唤醒后可说「开始跑步」「暂停一下」等指令 |
| TTS 语音播报 | 用 `speechSynthesis.speak()` 接入播报,含开跑提示、每 5 分钟数据播报、结束成绩播报 |
| `RECORD_AUDIO` 权限 | `app.json` 补充录音权限声明,否则识别无法启动 |
| 镜腿按键 | `onKeyUp` 处理 `GlobalHook`(镜腿触摸)/ `Enter` / `Backspace` / 方向键 |
| 点击交互 | 主按钮、卡片、麦克风条都支持 `bindtap`,Craft 调试面板可直接点 |

## 功能一览

| 模块 | 说明 |
|------|------|
| 🏠 主页 | 累计里程、本周次数、当前计划,开跑入口 |
| 🏃 跑步页 | 实时距离/用时/配速/步数/心率/卡路里,TTS 每 5 分钟播报 |
| 📋 训练计划 | 入门 5km / 进阶 10km / 减脂燃脂,语音或镜腿方向键切换选择 |
| 📊 历史记录 | 本地保存最近 20 次记录,语音查询最近成绩 |

## 语音指令(唤醒后说出)

- 「开始跑步」→ 跳转跑步页并开始
- 「暂停一下」/「继续」→ 暂停 / 恢复
- 「结束跑步」→ 保存并播报成绩
- 「播报一下」→ 立即播报当前距离配速心率
- 「看看计划」→ 计划页;「下一个」「就这个」→ 切换/选定
- 「跑步记录」→ 历史页并播报最近成绩

## 镜腿按键映射

| 按键 | 主页 | 跑步页 | 计划页 | 历史页 |
|------|------|--------|--------|--------|
| 触摸(GlobalHook) | 语音唤醒 | 暂停/继续 | 确认选定 | 语音播报 |
| Enter | 开跑 | 语音唤醒 | — | — |
| 方向键上/下 | — | — | 切换焦点 | 滚动 |
| Backspace | 重置状态 | 结束并保存 | 返回 | 返回 |

## 项目结构

run-coach/
├── AGENTS.md                  # 智能体描述(官方规范格式)
├── app.json                   # 页面路由 + RECORD_AUDIO 权限
├── app.js                     # 应用入口:存储初始化 + 数据读写
├── lib/
│   └── voice.js               # TTS 播报 + ASR 识别 + 指令解析(共享模块)
└── pages/
    ├── index/index.ink        # 主页
    ├── running/index.ink      # 跑步实时数据页
    ├── plan/index.ink         # 训练计划页
    └── history/index.ink      # 历史记录页

## 导入使用

### Craft Web IDE(推荐)

1. 打开 Craft AIUI Web IDE:https://js.rokid.com/craft?lang=zh-CN 并登录
2. 「导入本地文件夹」→ 选中 `run-coach` 文件夹
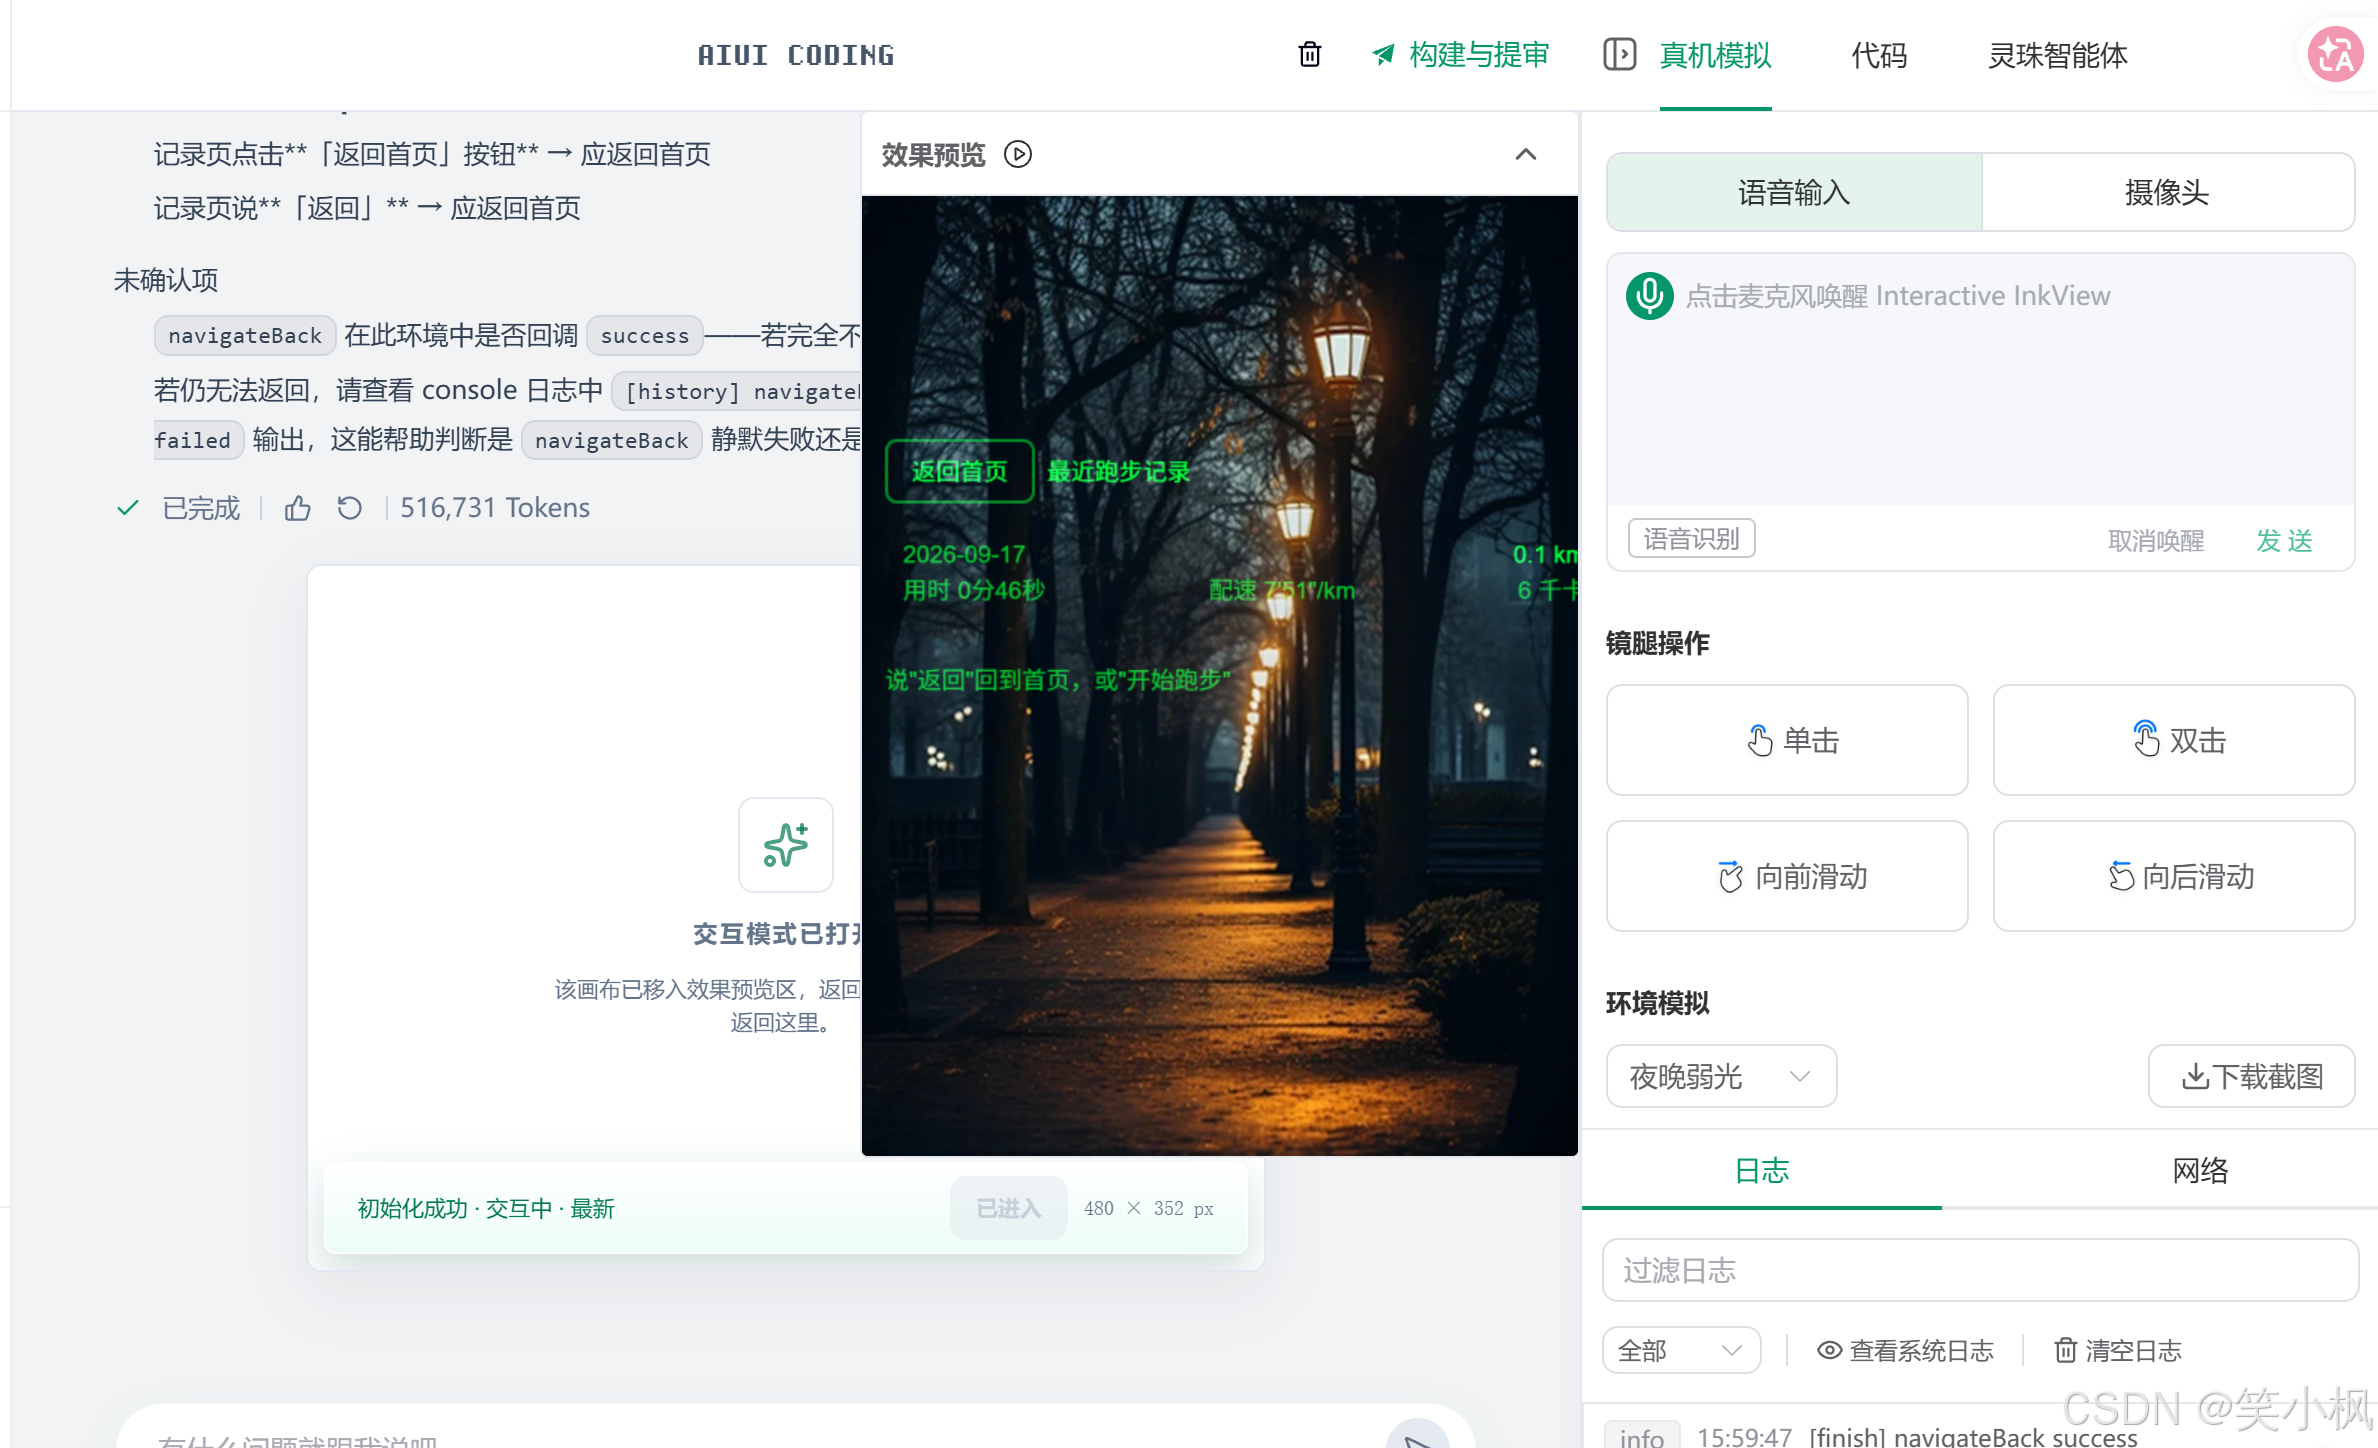
3. 点「运行智能体」→ 进入 Interactive InkView 预览
4. ****测试语音****:右侧面板点麦克风图标(或「语音识别」按钮)→ 说出指令 → 观察页面底部状态条和日志面板
5. ****测试镜腿****:右侧面板点「单击 / 双击 / 向前滑动 / 向后滑动」按钮

### AIUI Studio

1. 浏览器打开 https://aiui.rokid.com/ 并登录
2. 新建智能体,把本项目文件上传/粘贴到工作区
3. 真机验证 → 生成版本 → 提交上架

## 技术说明

- ****语音交互架构****:`onVoiceWakeup`(接管唤醒)→ `SpeechRecognition`(识别指令)→ `parseCommand`(关键词解析)→ 业务动作 → `speechSynthesis.speak`(TTS 反馈)
- ****页面规范****:`.ink` 单文件组件,`export default {}` 注册,`this.setData()` 更新状态
- ****权限****:`app.json` 中声明 `"permissions": ["RECORD_AUDIO"]`
- ****视觉规范****:单色绿设计系统,官方设计令牌 + 弹性布局
- ****数据模拟****:距离/步数/心率来自固定步频 170 步/分 × 步幅 0.75m 的模拟(`pages/running/index.ink` 顶部 `SIM_*` 常量),接入真实传感器时替换为传感器回调即可

## 常见问题排查

| 现象 | 原因与解决 |
|------|-----------|
| 点麦克风没反应 | 确认导入的是 v1.1 代码(页面里有 `onVoiceWakeup`);在 Craft 中重新运行智能体 |
| 说了指令没反应 | 打开右侧「日志」面板看 ASR 是否返回文本;确认说的内容命中指令关键词 |
| 无语音播报 | TTS 依赖运行时语音服务,Web 调试环境可能受限,以真机为准 |
| 想改指令词 | 编辑 `lib/voice.js` 里的 `RULES` 关键词表即可 |
{
  "pages": [
    "pages/index/index",
    "pages/running/index",
    "pages/plan/index",
    "pages/history/index"
  ],
  "window": {
    "navigationBarTitleText": "悦跑教练",
    "navigationBarTextStyle": "white"
  },
  "permissions": ["RECORD_AUDIO"]
}
五、交互与体验
整体思路是三路冗余,语音、镜腿,同一件事两条路都能到。
语音 适合场景固定的动作。站定了说「开始跑步」,或者跑着说「暂停」,不用看屏幕。
镜腿 在手上没空的时候最好使。摸一下就是暂停和继续的切换,比说两个字还快。这个是跑步场景里我实际用得最多的。
四个页面各说一句。
主页 进来看累计里程和本周次数,底部一个「开跑」大按钮。不用说话也能开始。
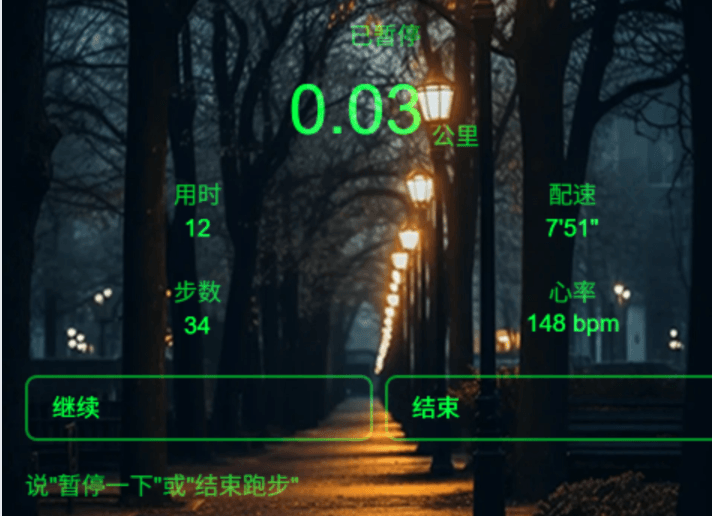
跑步中 是核心。中间三行数字,距离、配速、步频。不用碰它,每 5 分钟自己播报一次,「当前配速 5 分 12 秒每公里,已跑 2.3 公里,继续保持」。喘气的时候听到这句,比低头看表方便。
训练计划 用方向键上下切,Enter 确认。每个计划标了推荐配速区间,选完回主页,下次开跑按这个目标算。
历史记录 存最近 20 次。说「上次跑了多少」,播报最近一次的距离和配速。
六、调试与验证
AIUI 预览
开发全程都在 AIUI 里做。改完 .ink 直接点「运行智能体」,右侧面板有麦克风图标和镜腿操作按钮那一排,语音和按键都能在浏览器里模拟。跑步页的 5 分钟播报周期太长,调试时我临时把间隔改成 10 秒,验证逻辑对了再改回去。
v1.0 到 v1.1 的排查
第一版做完,页面渲染正常,四个页面都能翻,麦克风没反应,按镜腿也没反应。
翻官方文档 page-events.md 才发现问题,我没实现任何页面级事件。宿主把语音唤醒事件分发出去,没有页面接,信号就丢了。我原来以为平台内置了语音功能,接上就能用,其实整条链路得页面自己搭。
第二版补了三件事,onVoiceWakeup 接管唤醒再启动识别、onKeyUp 处理镜腿按键、app.json 加 RECORD_AUDIO 权限。这三点凑齐,麦克风才真正活过来。
真机验证
戴上眼镜到小区门口那次,我说「开始跑步」,它回了「好的,开始跑步。当前是减脂燃脂计划,预计 25 分钟」。镜腿摸一下,播报「已暂停」。跑起来之后每 5 分钟自动报一次配速,声音从眼镜两侧出来,路过的大爷都多看我一眼。
真机上跟模拟器有几处不一样。
-
户外风噪对识别影响明显。同一句「暂停」,室内成功率我体感八成以上,有风的时候明显掉下来。所以兜底按键不是可选项。
-
跑超过 40 分钟,播报节奏得控住。太频繁会烦,5 分钟一次比较舒服。
-
眼镜扬声器在户外音量偏小,播报内容要短。我后来把「当前配速 X 分 Y 秒每公里」简化成了「配速 X 分 Y 秒」。
七、成果与复盘
成果
四个页面全部跑通,语音、镜腿、点屏三条路径都能走完整个跑步流程。关键词容错实测能覆盖大部分含混输入。历史上限 20 条,存本地,不依赖网络。
遇到的问题
| 问题 | 原因 | 解决 |
|---|---|---|
| 点麦克风无反应 | 页面未实现 onVoiceWakeup | 补页面事件接管 |
| 镜腿按了没反应 | 未监听 onKeyUp 与键码 | 加 GlobalHook / Enter 分支 |
| 识别起不来 | app.json 缺 RECORD_AUDIO | 补权限声明 |
| 播报和语音打架 | speak 未传队列参数 | 改 speak(utterance, 'enqueue') |
| 提审被卡 | 预览素材用了 AI 生成图,与实际不符 | 换成模拟器真实截图和录屏 |
最后一条我想多说一句。预览素材这块我一开始想省事,让 AI 画了几张眼镜界面的效果图,自己看两眼就删了。风格跟实际跑出来的界面完全不是一回事,提审的时候这种图文不符最容易被卡。后来老老实实跑项目,用模拟器截了真实界面才过的。
后续迭代
接下来想做三件事。
1. 接真实传感器。 现在距离是步频乘步幅模拟出来的,接上 IMU 和 GPS 之后配速才准。
2. 加心率区间提醒。 现在心率是估算值,接上真实数据后可以在超区间时播报提示。
3. 训练计划自定义。 现在三档是写死的,想做成能自己填目标距离和配速区间。
一点感受
我用下来的感觉是,AIUI 更像一套让硬件开口的机制,页面只是它的外壳。把「功能」想成「页面」,就没了交互。把「交互」想成「页面加事件回调」,它才活过来。
你写了 onVoiceWakeup,它就接住麦克风,写了 onKeyUp,它就接住镜腿。没写,眼镜里就是一张冷着的图。
平台把「硬件信号分发到页面」这条管道铺好了,接不接是开发者的事。这件事我卡了整整一版才想明白。写给同样卡着的朋友,去翻 page-events 那一节,别只读 quickstart。
更多推荐

 0
 0
- 0


 已为社区贡献4条内容

所有评论(0)