
手上全是油,我怎么让rokid眼镜在厨房里教我炒菜
炒菜最烦的其实不是不会做,是做到第三步要翻手机——手上全是油,屏幕一摸一个指纹,滑一下还容易翻过头。
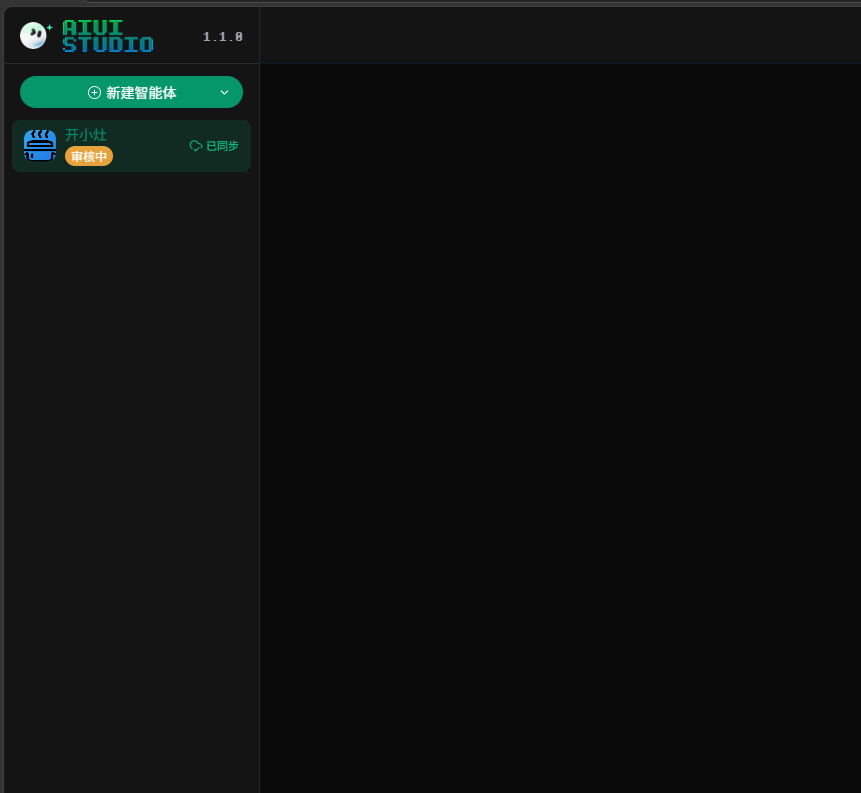
我做了个跑在 Rokid AR 眼镜上的小应用叫「开小灶」:戴上眼镜,对着冰箱说一声"鸡蛋番茄",它直接给你弹出菜谱,一屏只显示一步,镜腿一滑就翻到下一步,该炒多久自己倒计时,到点了念给你听。手上不用碰任何东西。
这篇文章不堆功能列表,就讲我做这东西时踩出来的两件实事:一是为什么断网了也能教你炒菜(我一开始只接了大模型,拔网线直接白屏);二是为什么说"辣椒炒肉拌面"它真听得懂(不是让你念标准菜名)。
一、项目简介——为什么要做「开小灶」
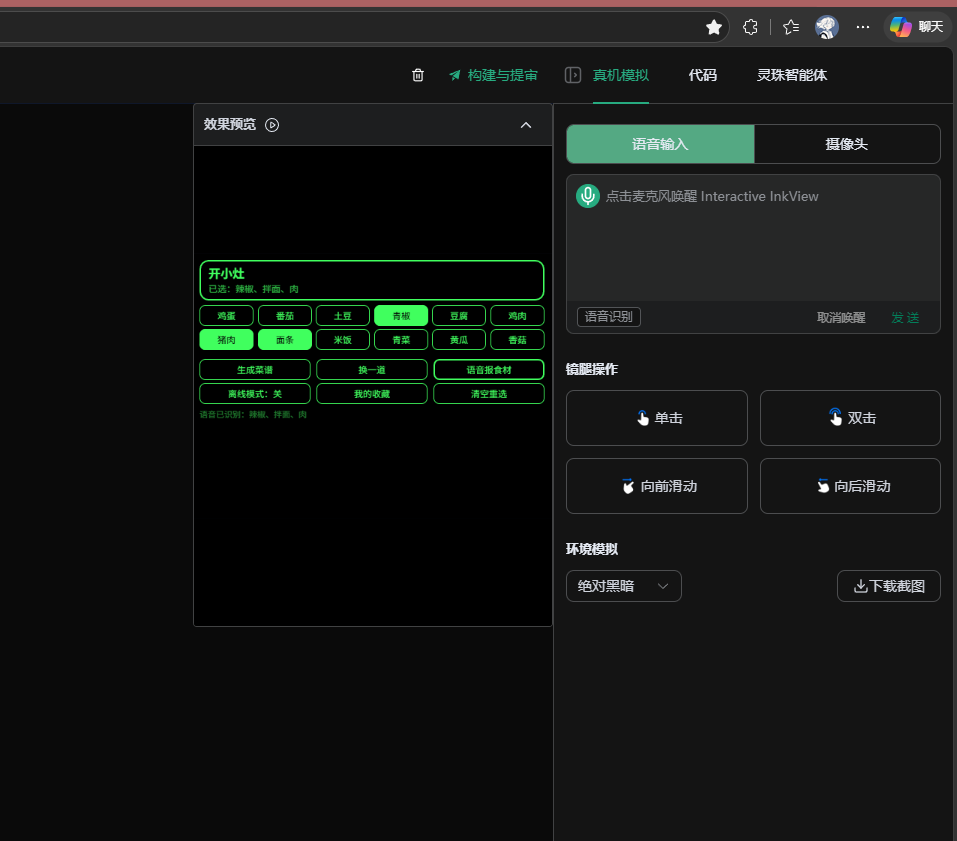
打开应用就是食材页。屏幕上摆了 12 个常用芯片:鸡蛋、番茄、土豆、青椒、豆腐、鸡肉、猪肉、面条、米饭、青菜、黄瓜、香菇,滑到哪个点一下就选上了。也可以直接说话——在 Craft 调试时点右边麦克风唤醒,输入框打"辣椒炒肉拌面"发出去,它能自己拆出食材。
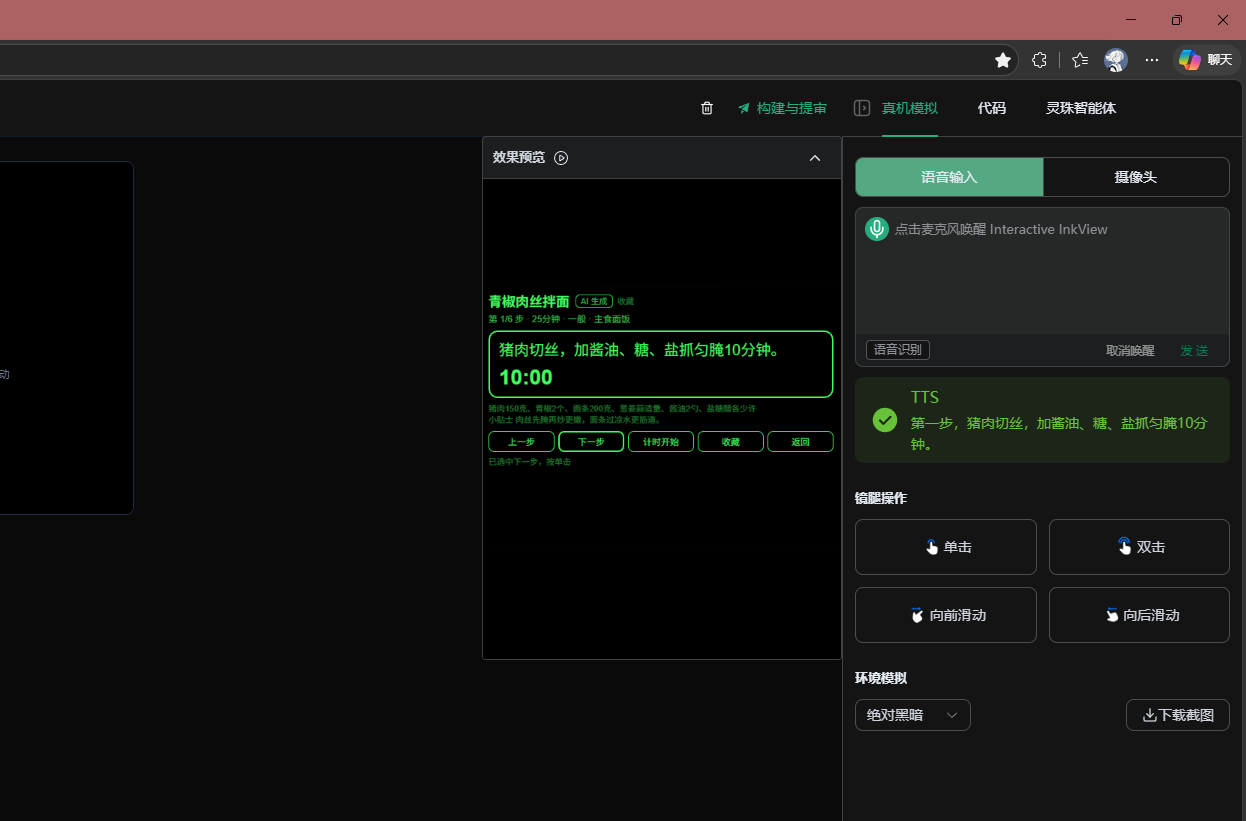
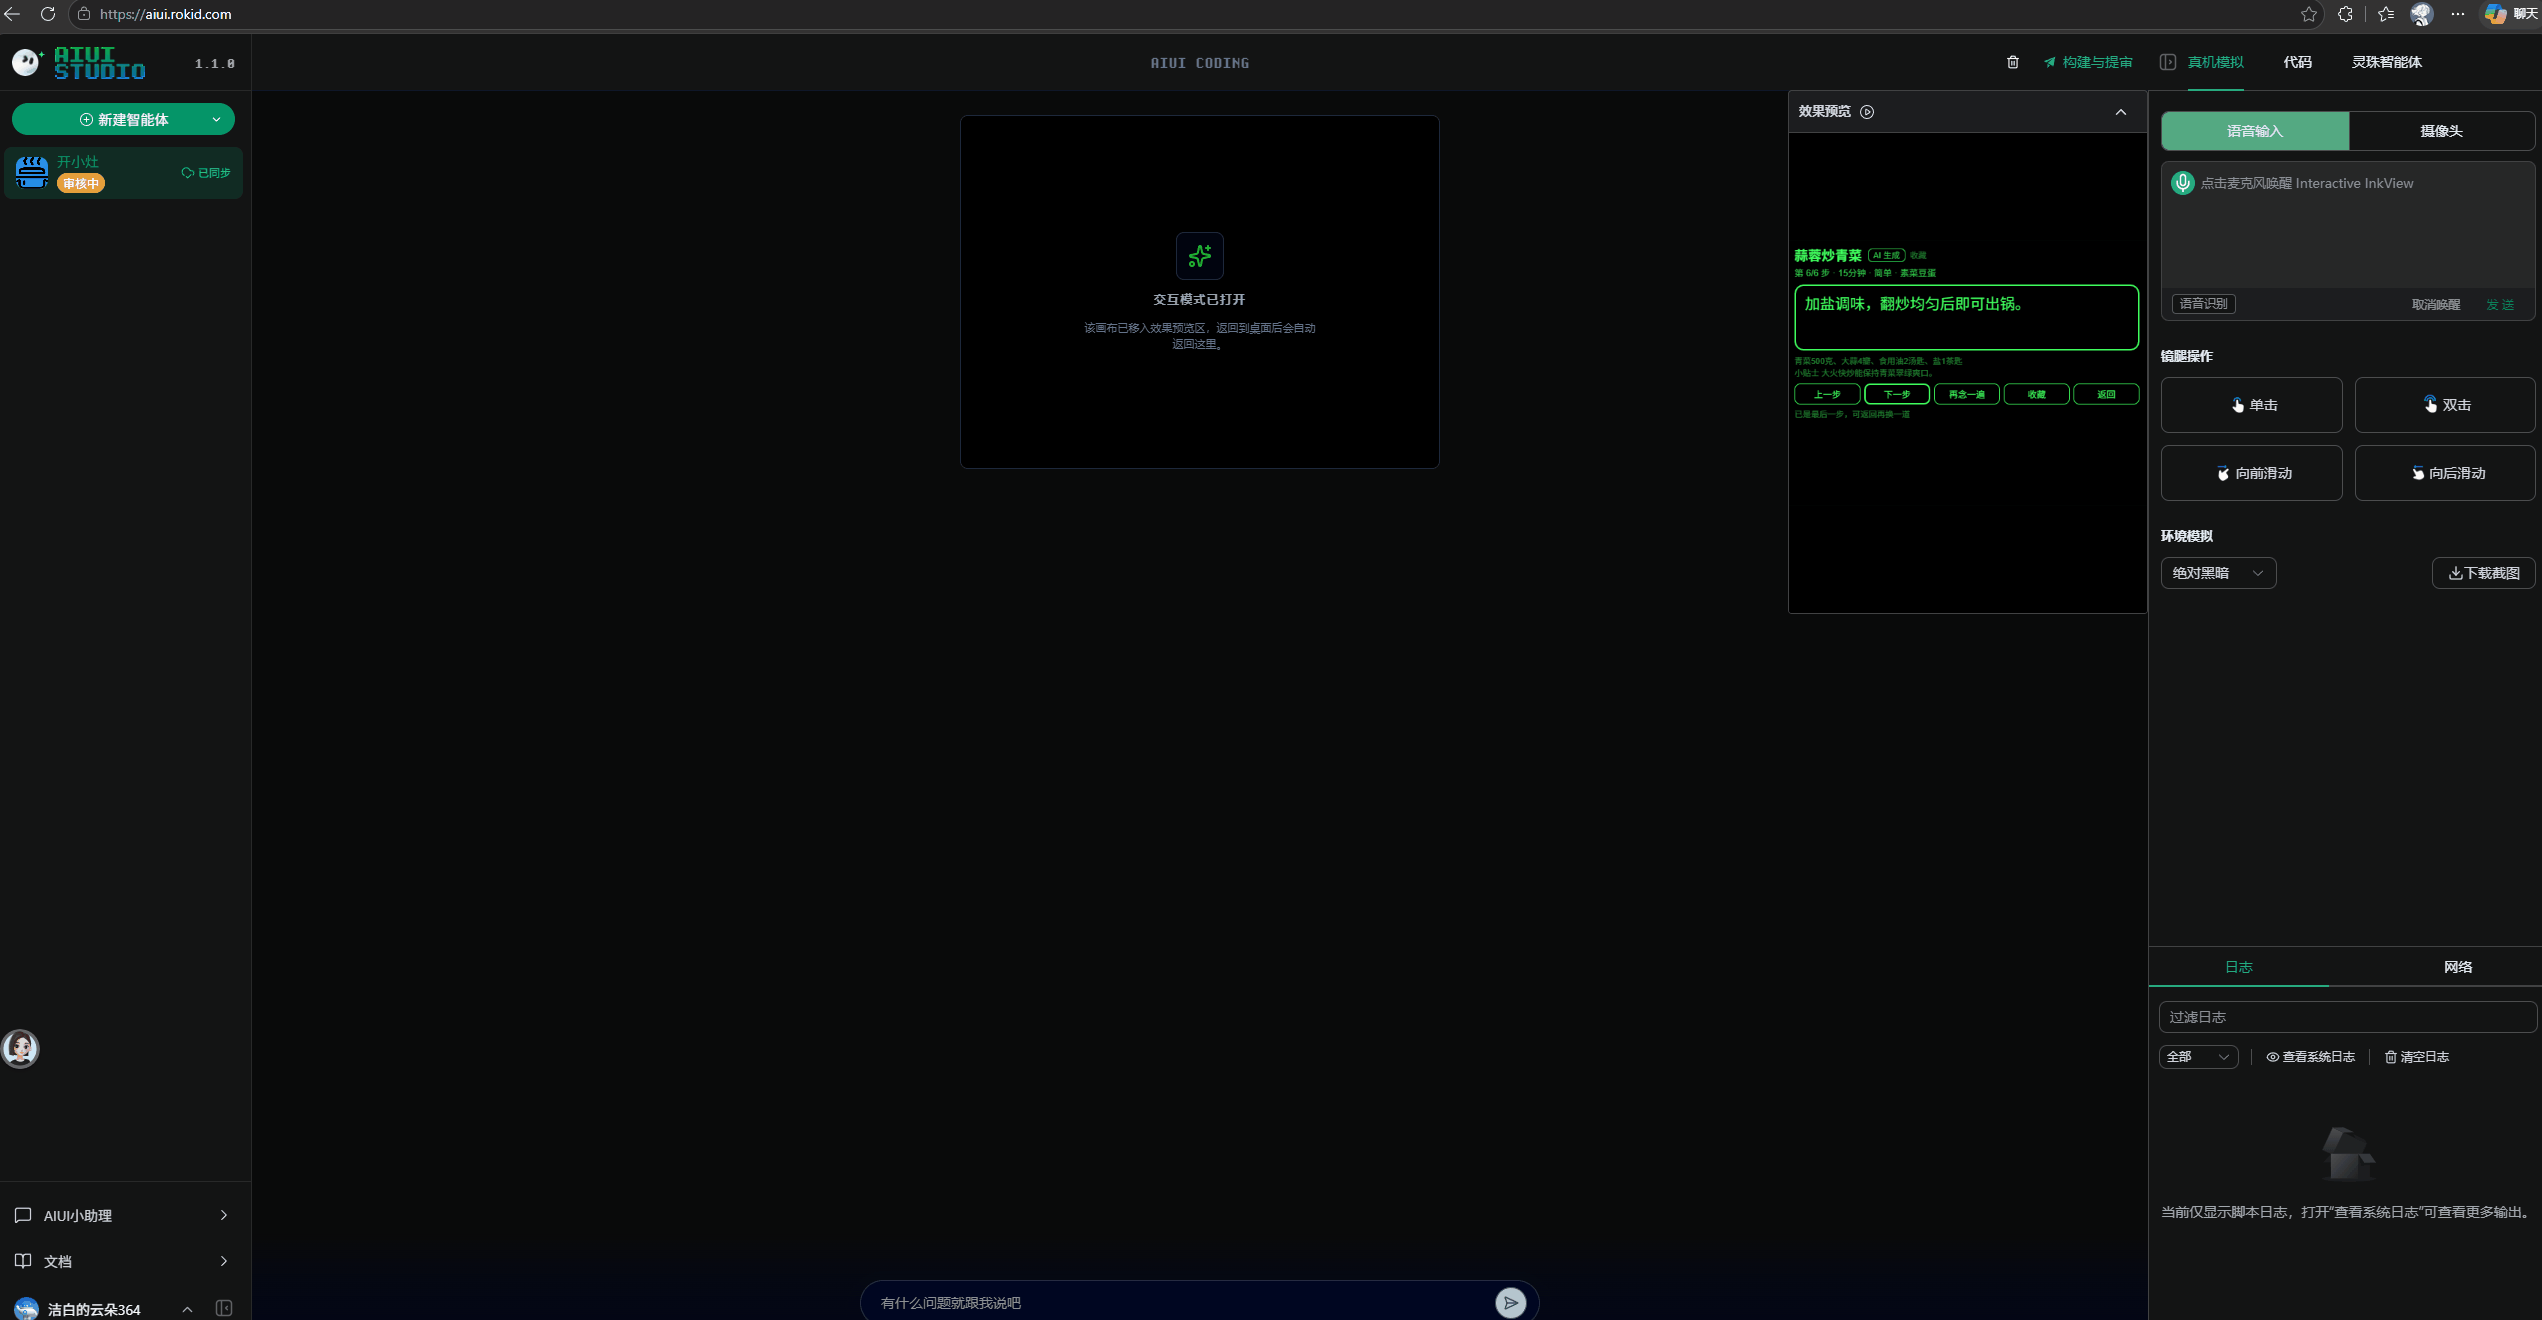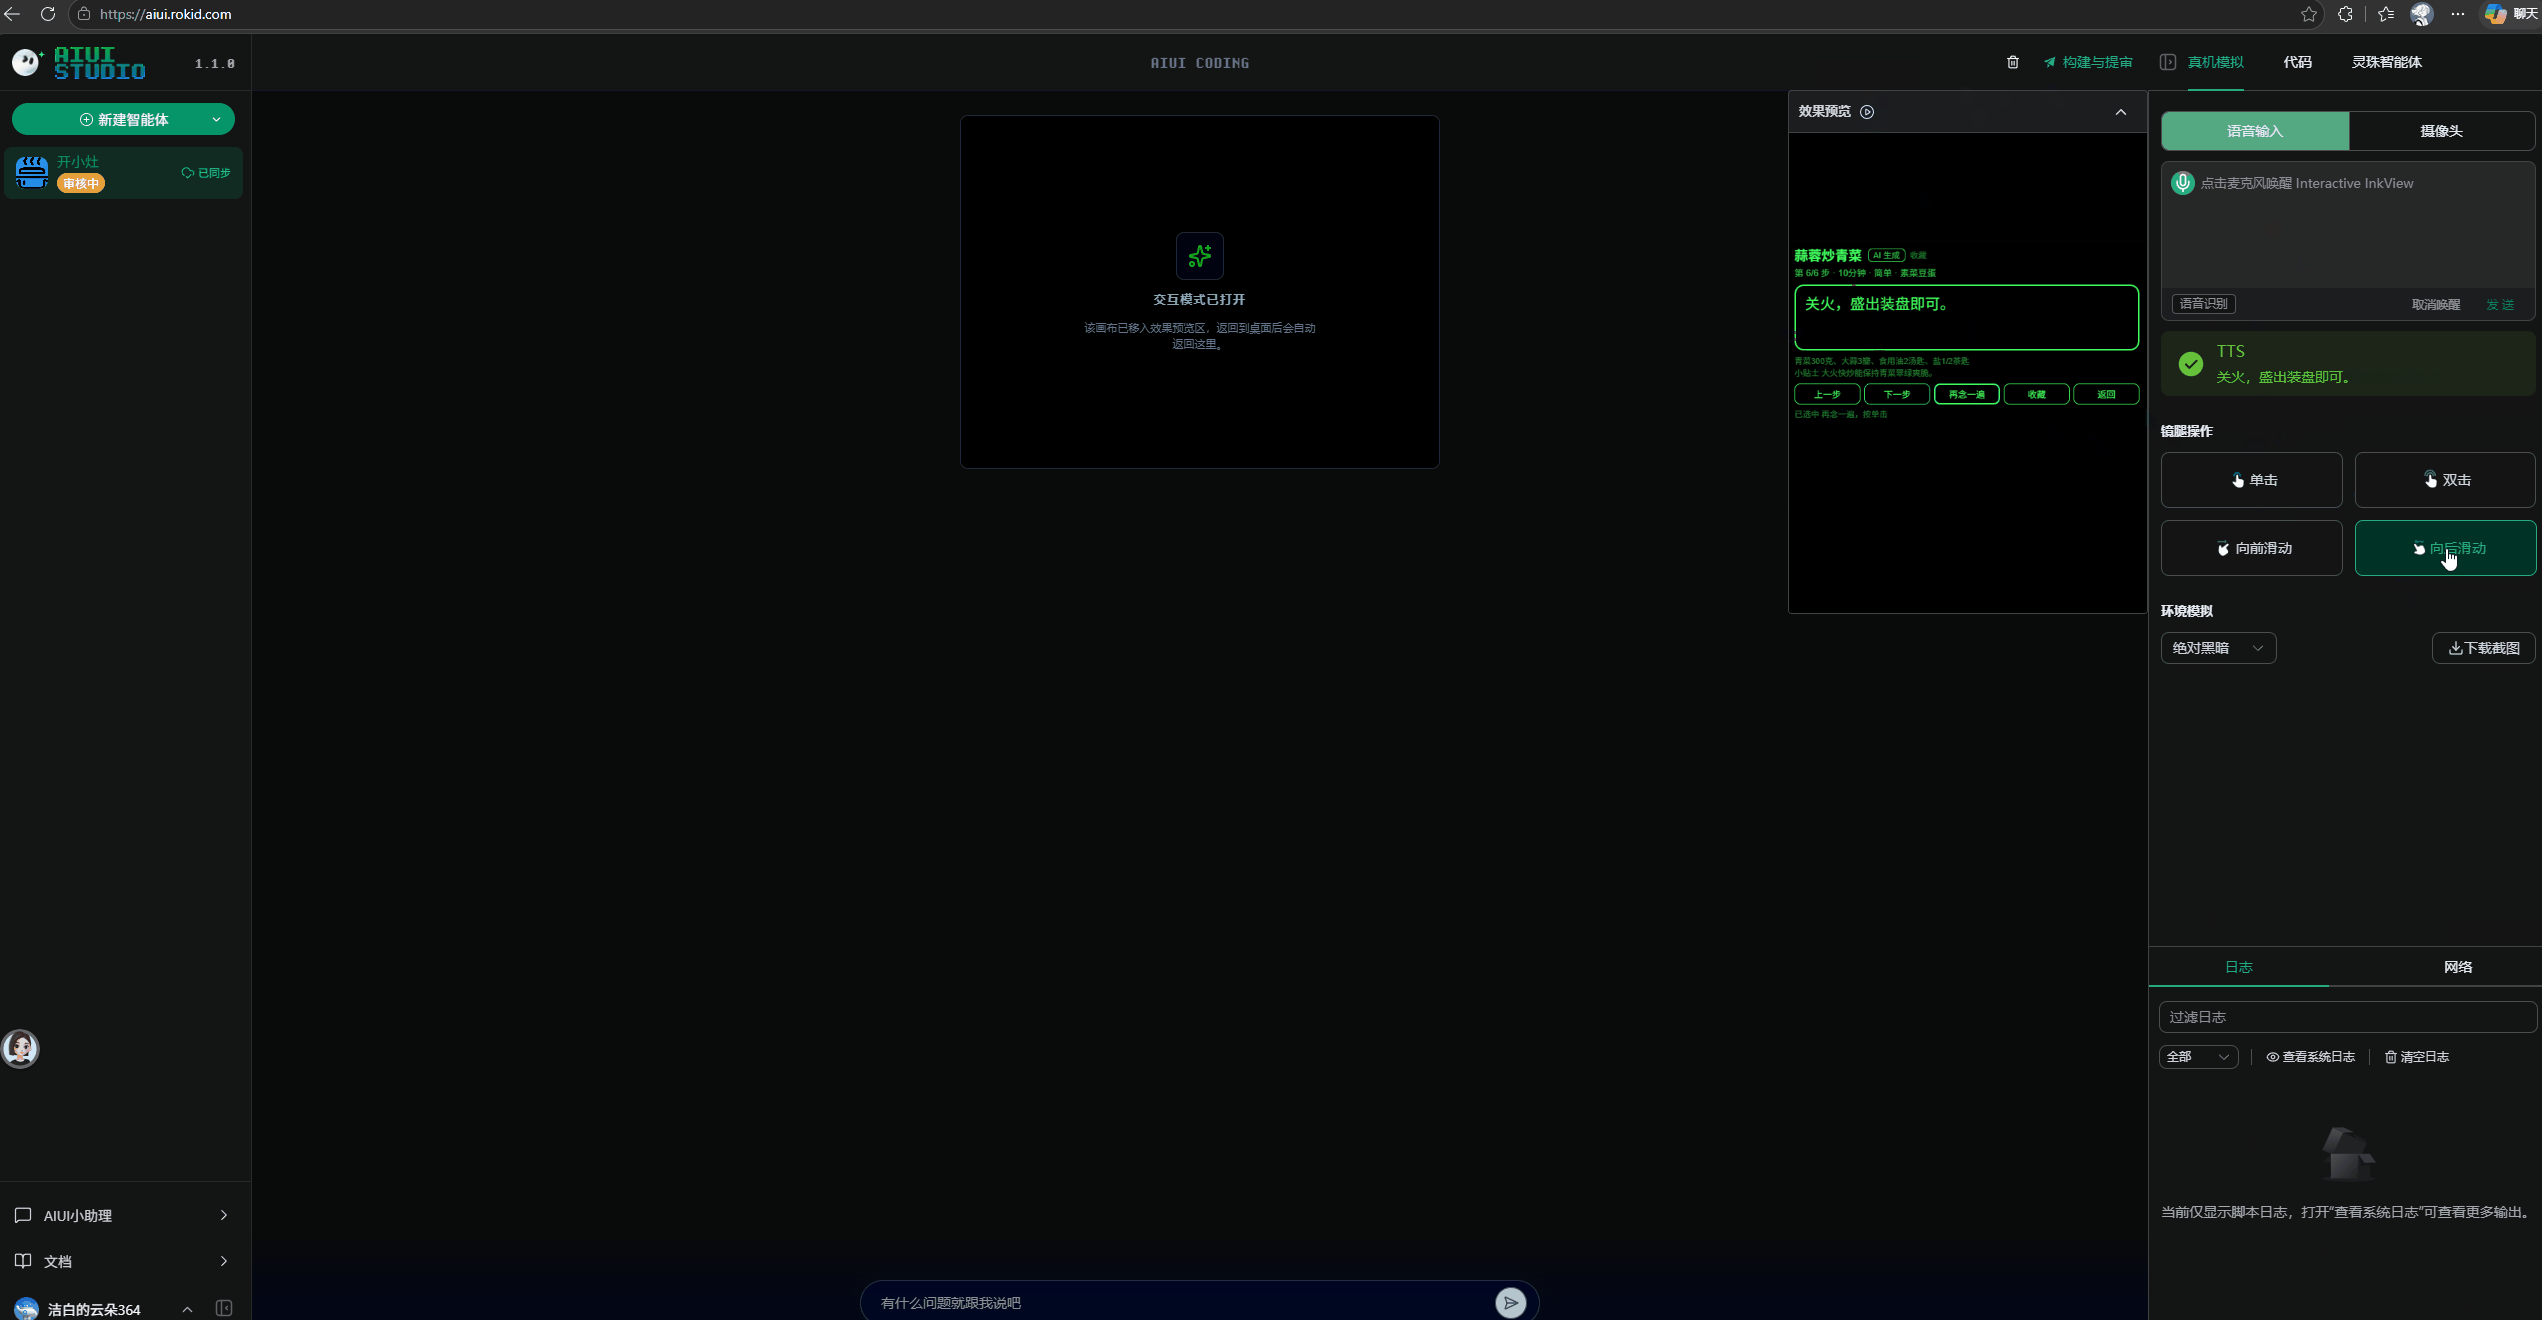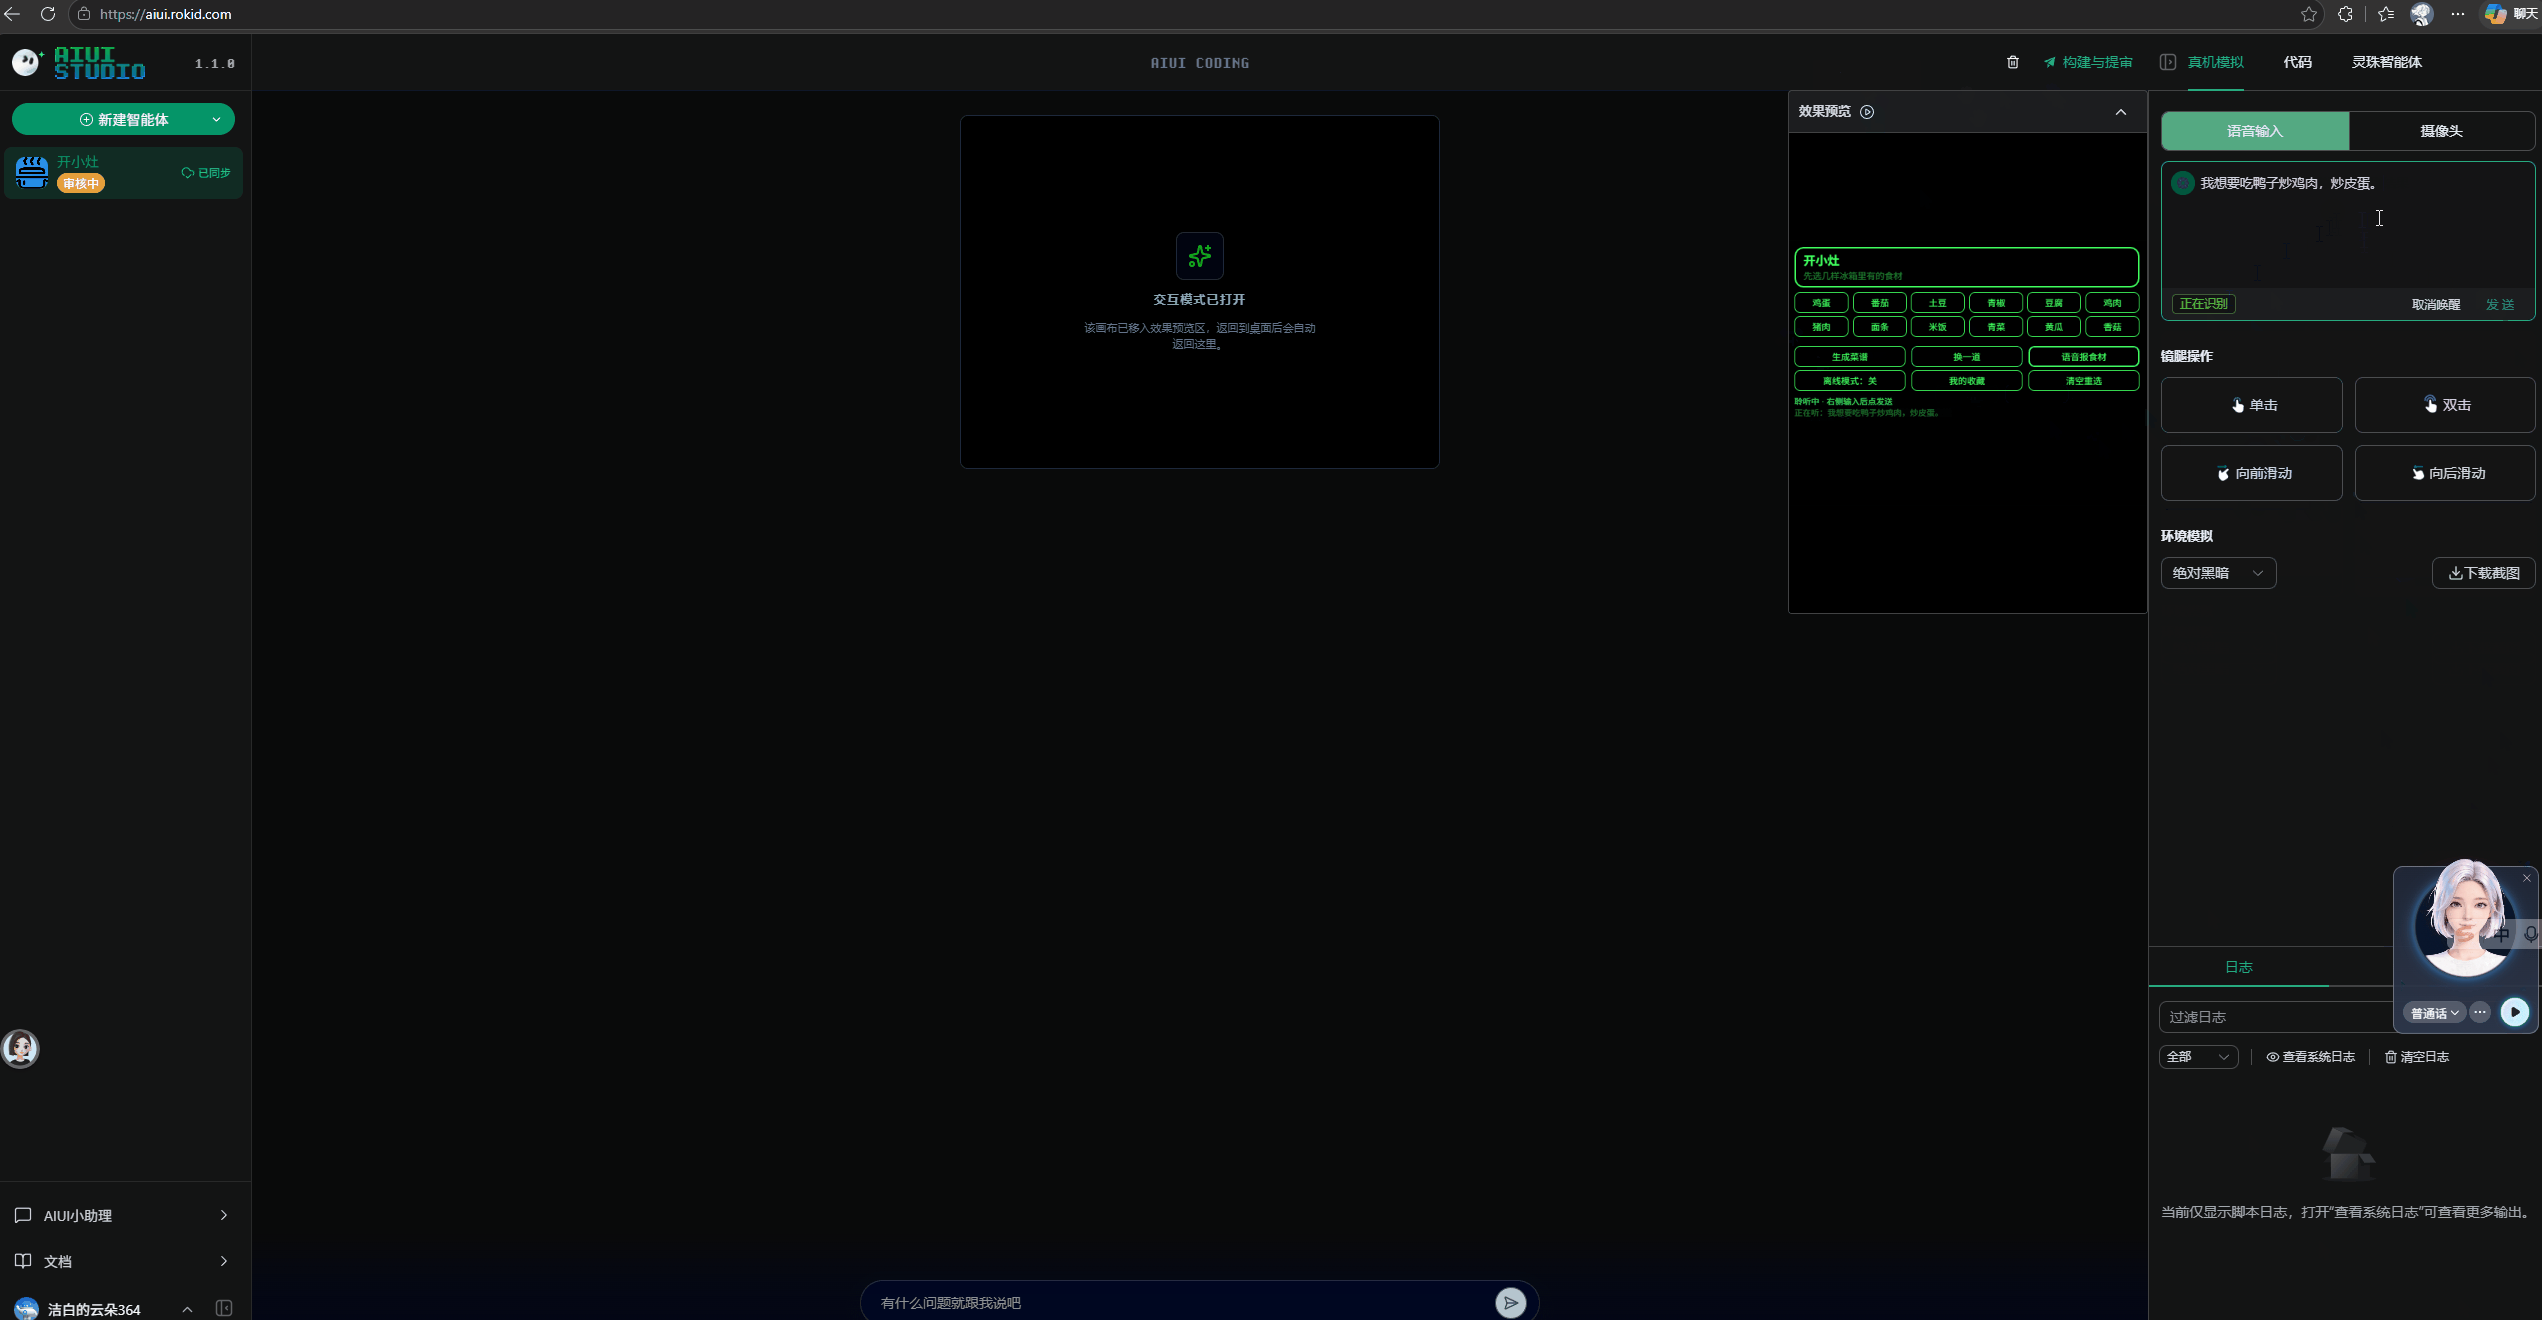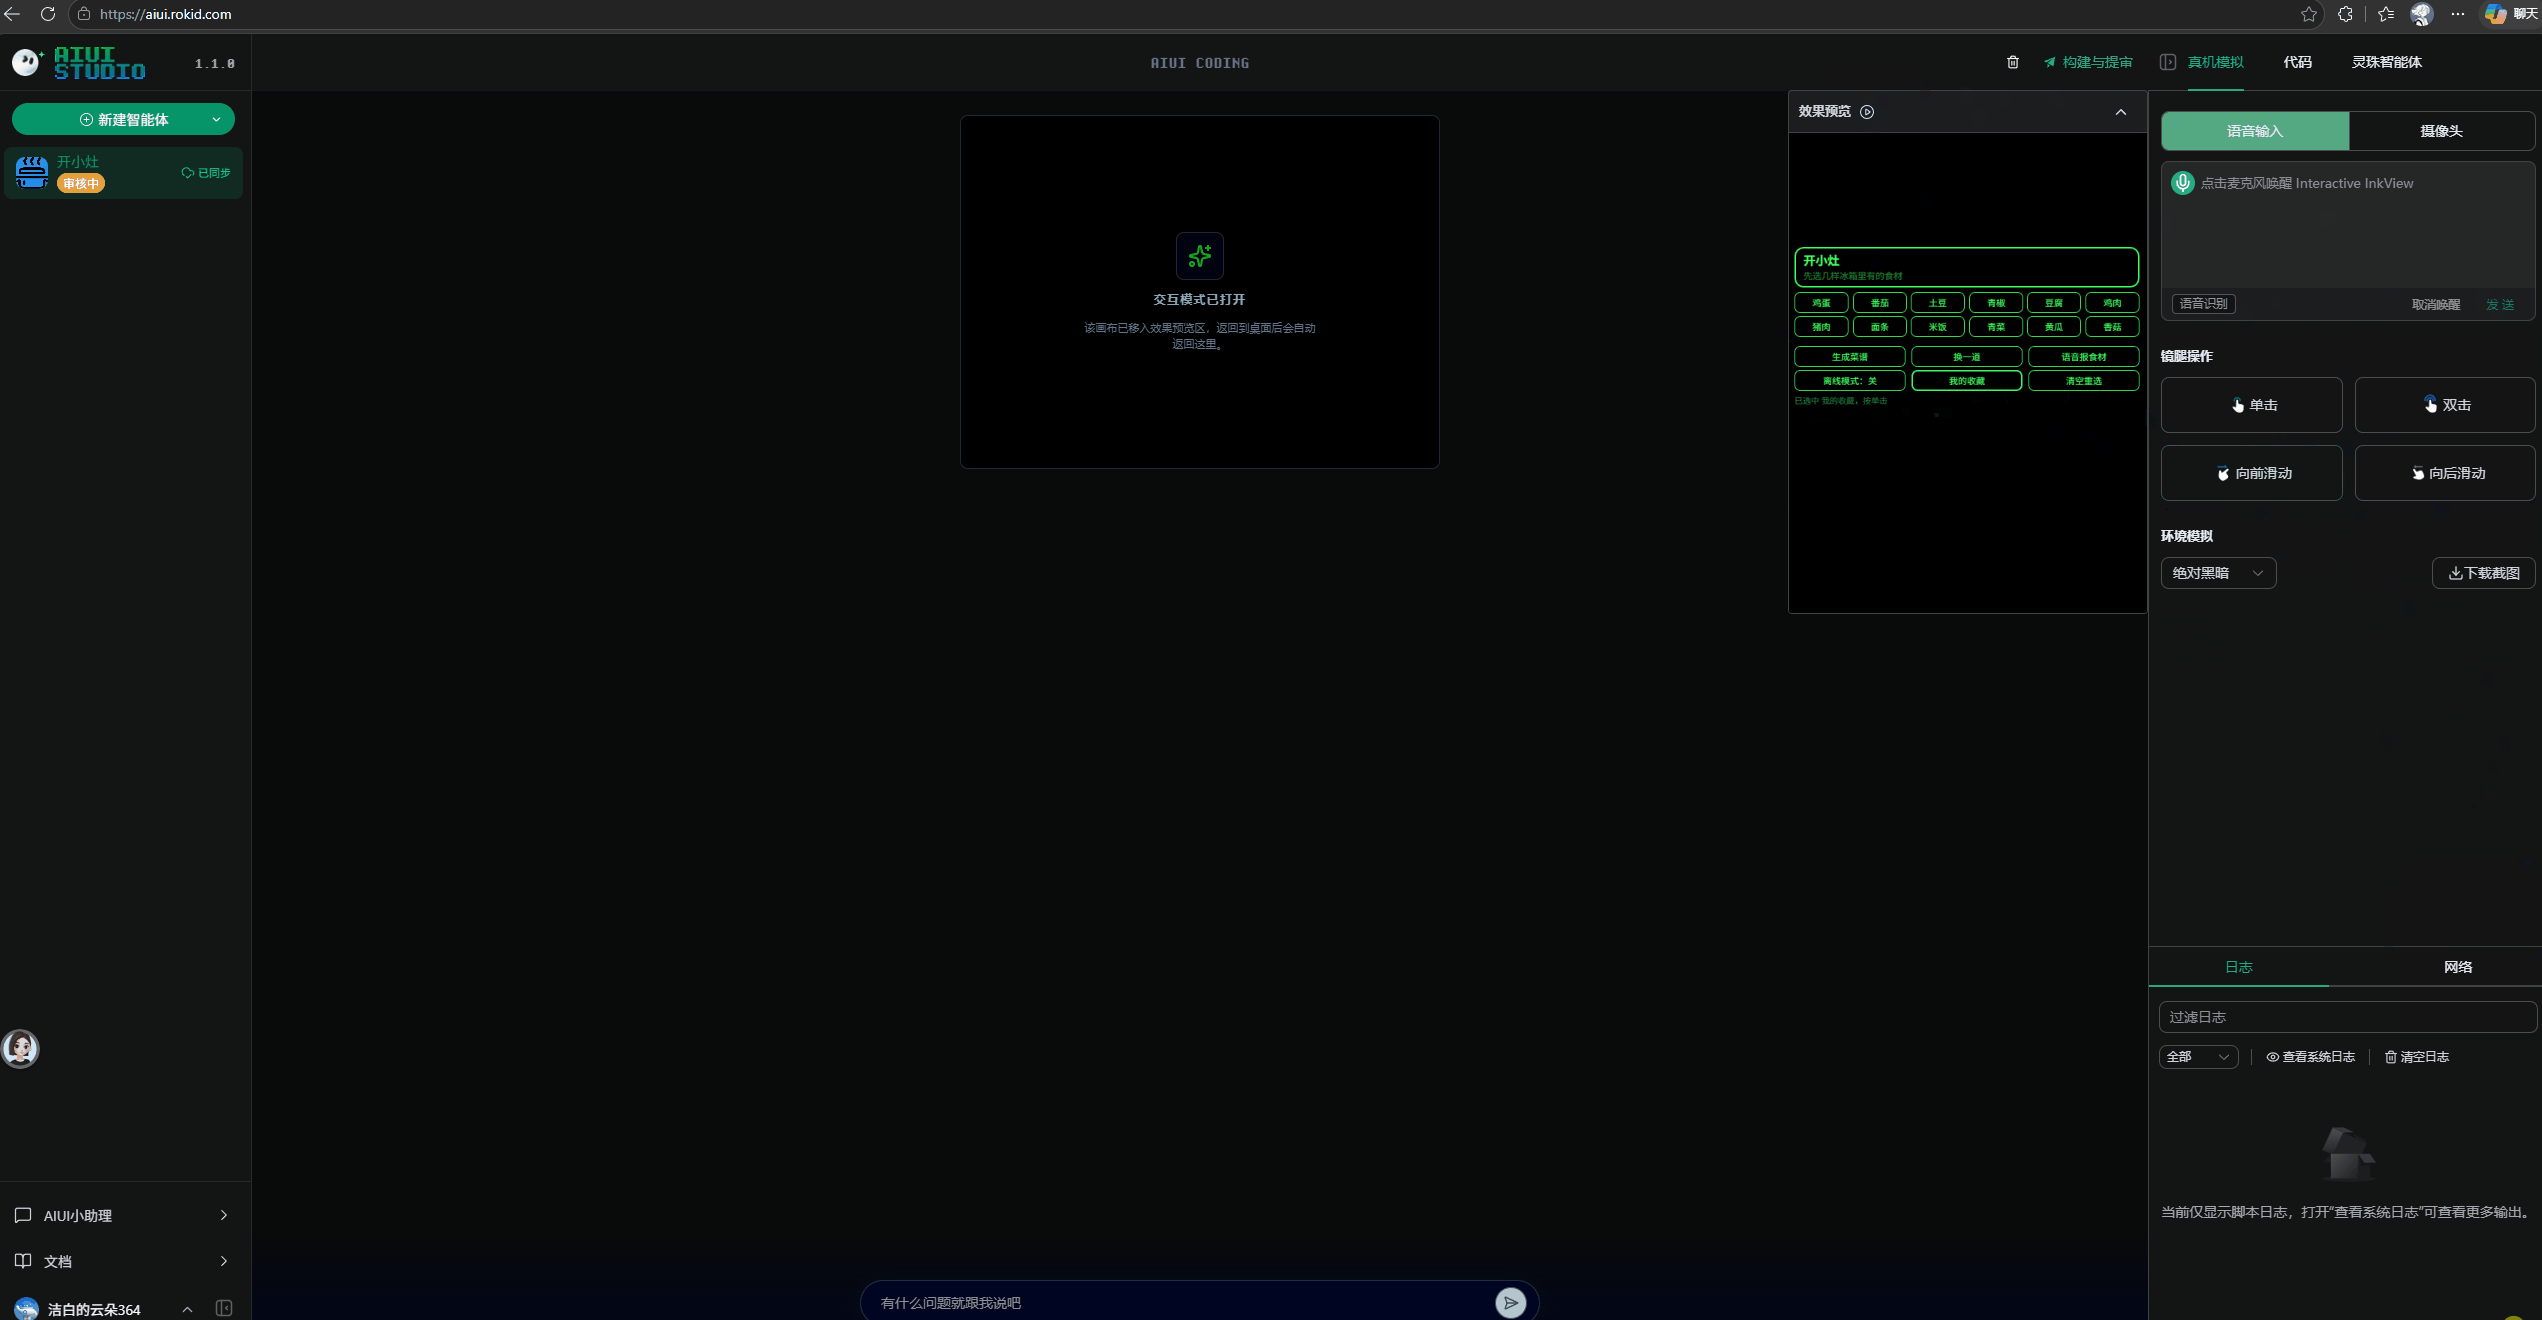
选好食材点生成,应用会给你一道菜,点进去是分步教学:一屏一步,大字显示当前在干嘛,上一步下一步靠镜腿滑动,需要等的步骤(比如"小火煮 3 分钟")自带倒计时,到点自动语音念"第 n 步时间到"。喜欢的菜可以收藏,下次直接从收藏里进。
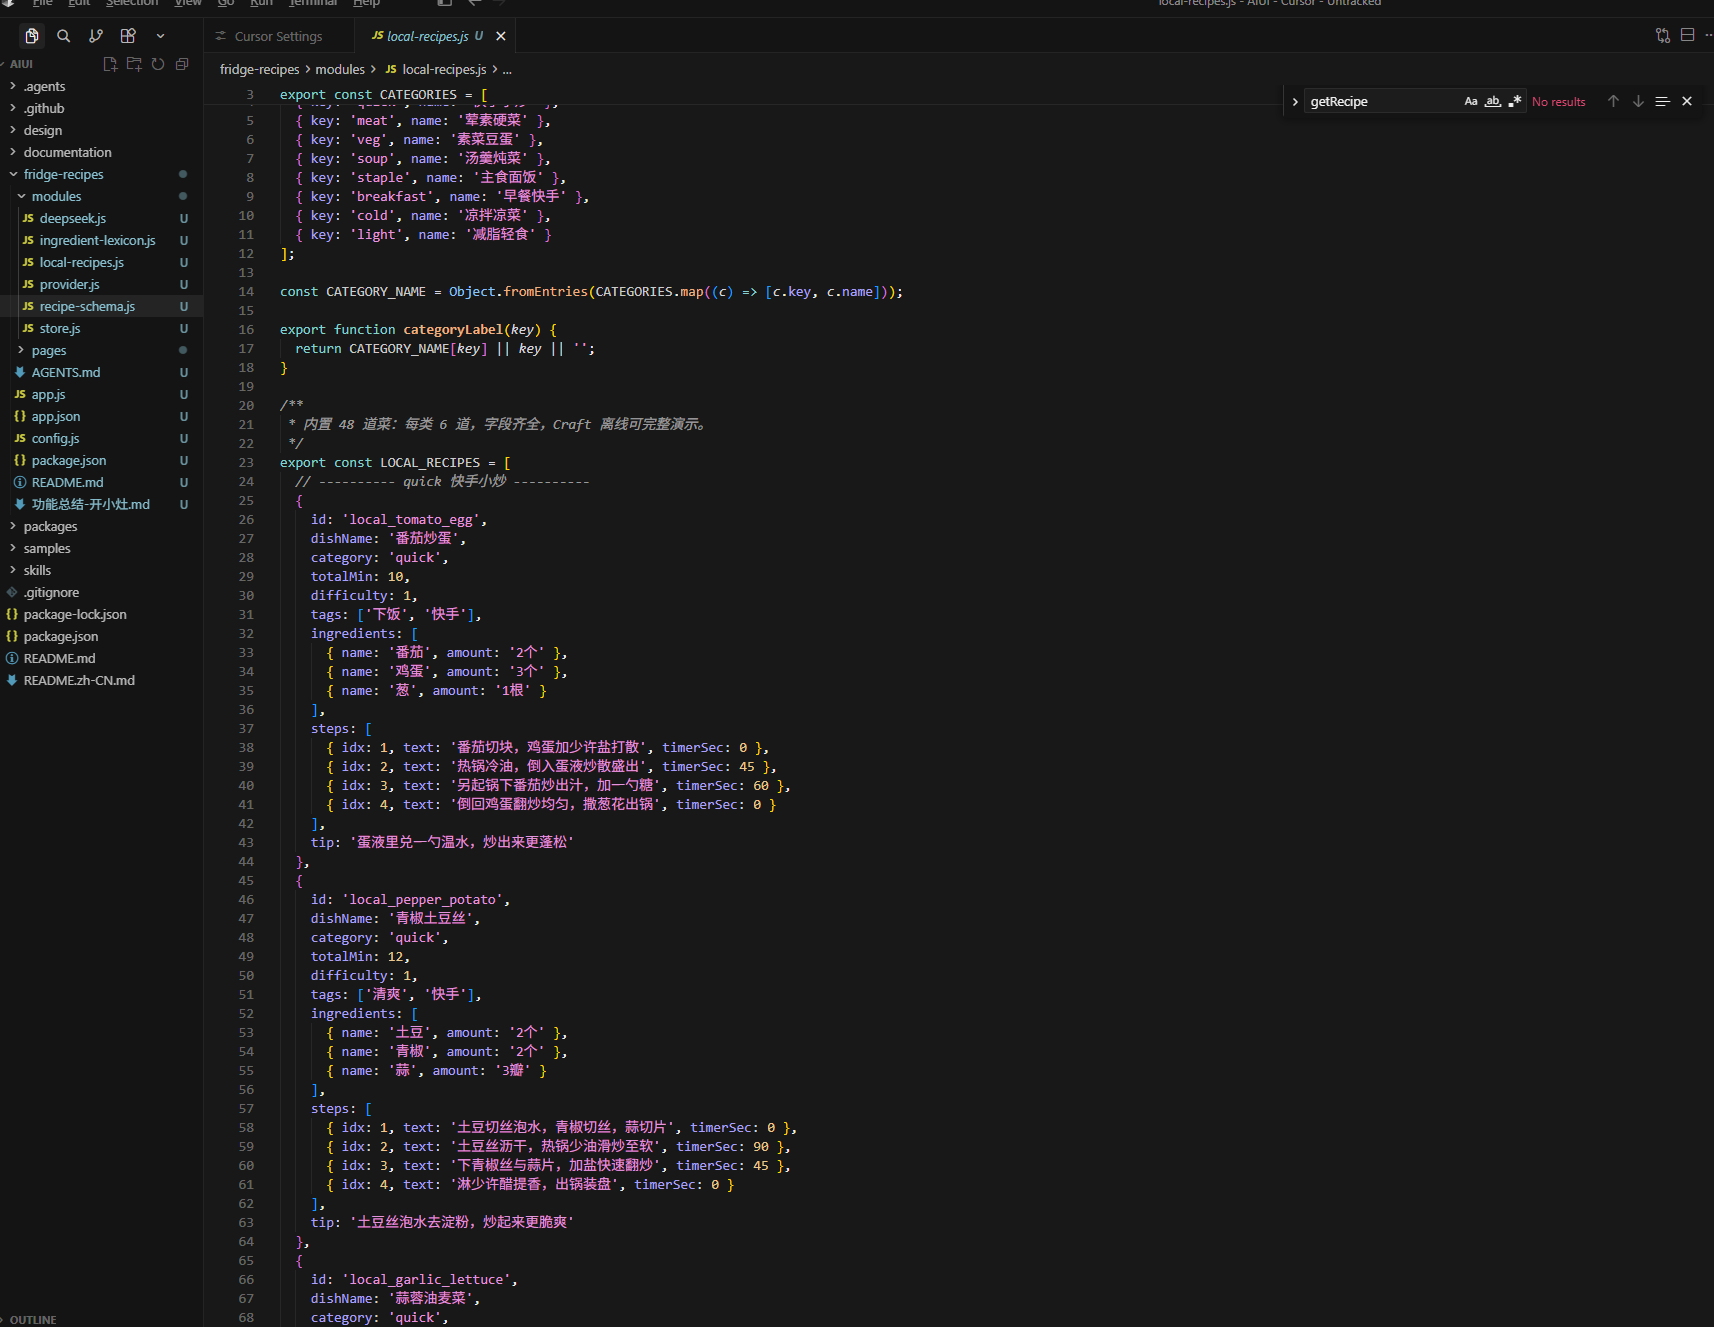
整应用没有引入任何第三方 npm 包,纯原生 AIUI 写的;在线出菜靠 DeepSeek,离线有 48 道本地菜谱兜底。
二、双通道菜谱生成
第一版我图省事,生成菜谱这件事整个甩给了 DeepSeek:前端把食材一拼,POST 过去,拿回 JSON 就渲染。本地跑着挺顺,直到有天我在厨房演示,眼镜一连家里 WiFi 不稳,请求超时——屏幕直接一个"加载失败",一行菜谱都没有。
厨房这个场景很尴尬:你已经站在锅前了,让你掏手机查菜谱,那戴眼镜干嘛?所以我定下一条死规矩:不管在线接口成不成,页面永远必须有菜出,绝不白屏。
1、在线优先与静默降级
核心是 provider.js 里的 getRecipe,逻辑不复杂:先看有没有填 Key、有没有手动开离线;能走在线就调 DeepSeek,任何一步失败都不抛错,静默掉到本地库:
export async function  (ingredients, options = {}) {
  const normalized = normalizeIngredientList(ingredients);
  const forceOffline = options.offline === true || getOffline();
  const key = (CONFIG.DEEPSEEK_API_KEY || '').trim();
  const canOnline = !forceOffline && !!key;

  if (canOnline) {
    try {
      const recipe = await tryDeepSeek(normalized, {
        excludeNames: options.excludeNames || sessionExcludeNames
      });
      pushRecent(recipe);
      return { recipe, source: 'deepseek', failReason: '' };
    } catch (err) {
      failReason = err && err.message ? String(err.message) : 'DS_FAIL';
      // 不抛,静默落本地
    }
  }

  // 走到这:没 Key / 离线 / 超时 / 接口挂 / JSON 不合格
  const recipe = pickLocal(normalized, options.excludeIds || sessionServedIds);
  recipe.source = 'local';
  pushRecent(recipe);
  return { recipe, source: 'local', failReason };
}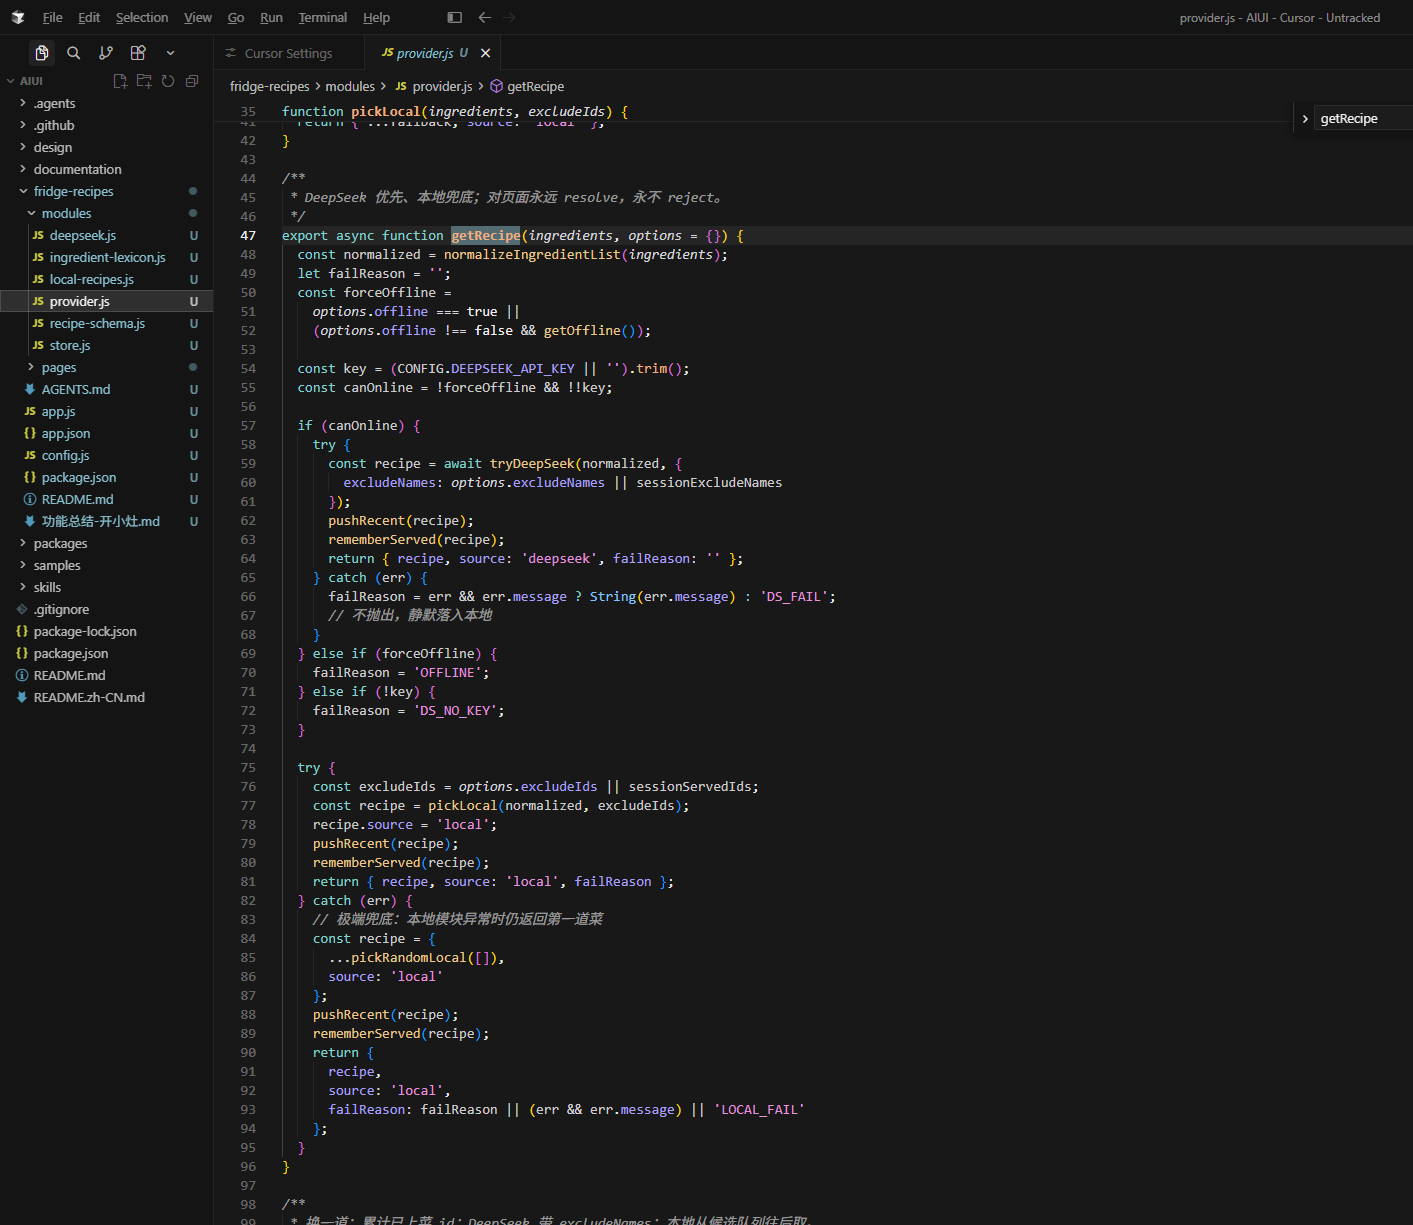
注意那个 catch 块里我没 throw。这不是偷懒,是故意的——在线这条路的所有异常(超时、HTTP 错误、返回了脏 JSON、模型抽风少给了字段)都统一在这里被吞掉,然后走本地。页面这一层根本不需要知道"这次是 AI 出的还是本地出的",它只认一个 recipe 对象,顶多在角落标一下来源是"AI 生成"还是"本地菜谱"。
2、返回 JSON 的校验与修复
光降级还不够,因为在线时大模型返回的 JSON 结构可能乱来:步骤写了 10 步、每步一句话 60 个字、或者干脆少了菜名。所以我在提示词里就把格式钉死,回来再做一遍 schema 校验和修复。
发给 DeepSeek 的系统提示词大概是这个意思(deepseek.js):
const SYSTEM_PROMPT = [
  '你是一名家常菜厨师,根据用户手头食材设计一道普通家庭能完成的菜。',
  '严格输出一个 JSON 对象,字段如下:',
  'dishName、category、totalMin、difficulty、tags、',
  'ingredients(数组,至少2项)、steps(必须4到6步,每项{idx,text,timerSec})、tip。',
  '步骤必须是真实可执行的烹饪顺序,一屏只看一步,每步不超过30个汉字。',
  '不要输出 JSON 以外的任何字符。'
].join('\n');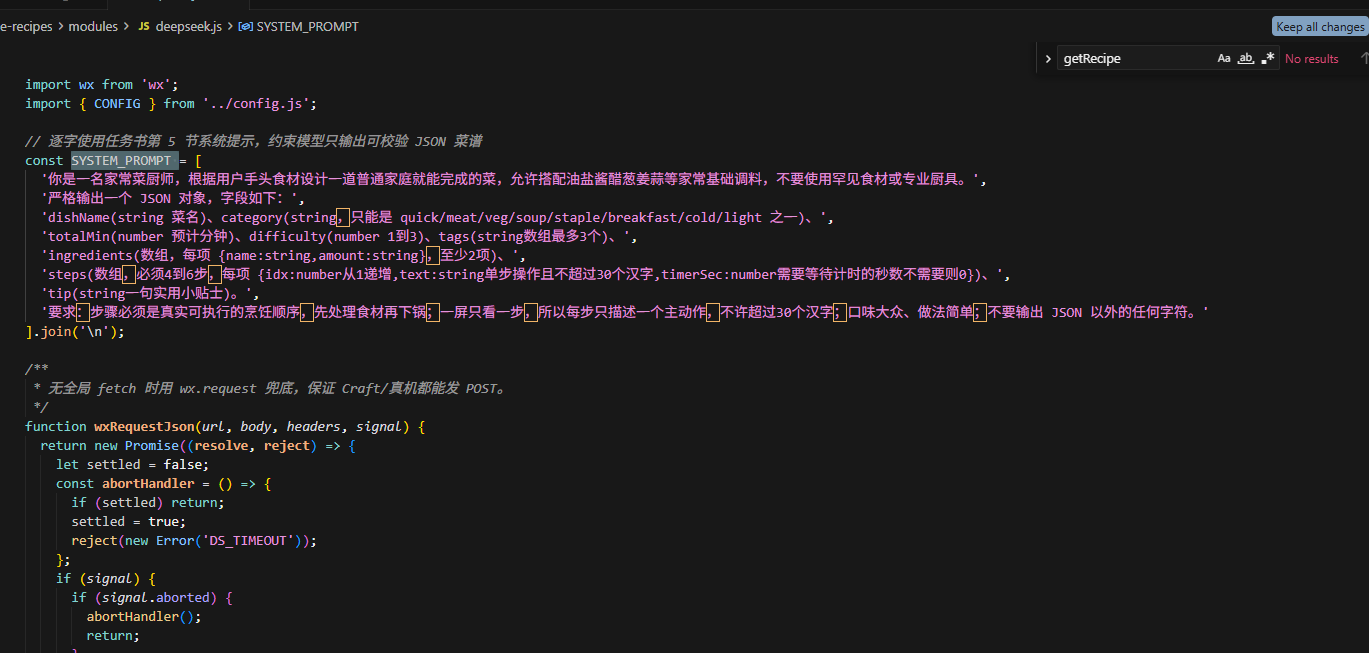
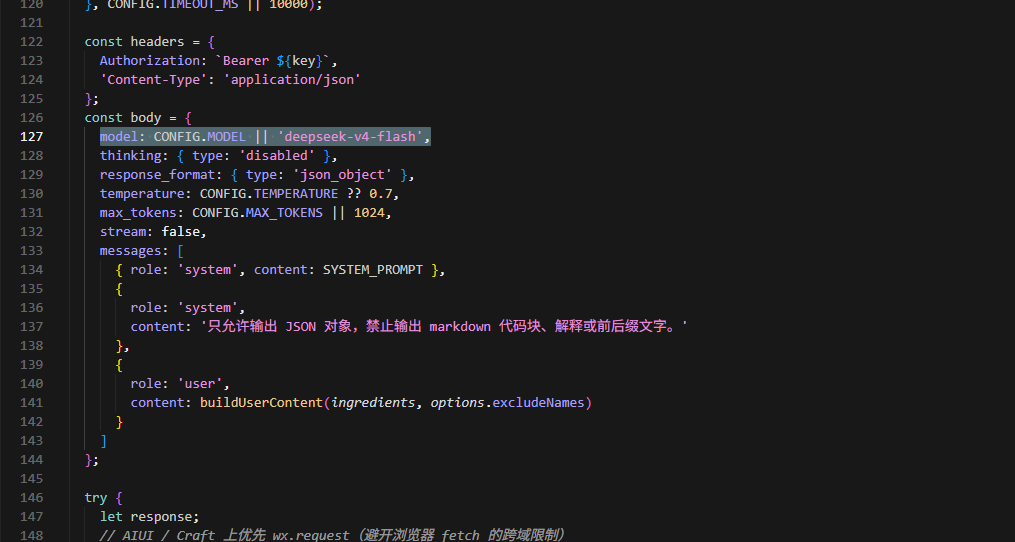
.请求体里我还专门关了思考、开了 response_format: json_object,超时卡 10 秒——厨房场景等不起,宁可掉本地也不能让用户盯着转圈:
const controller = new AbortController();
const timer = setTimeout(() => controller.abort(), CONFIG.TIMEOUT_MS || 10000);

const body = {
  model: CONFIG.MODEL || 'deepseek-v4-flash',
  thinking: { type: 'disabled' },
  response_format: { type: 'json_object' },
  messages: [
    { role: 'system', content: SYSTEM_PROMPT },
    { role: 'user', content: buildUserContent(ingredients, options.excludeNames) }
  ]
};
回来的 JSON 再过一遍 validateRecipe:步骤多于 6 步就砍到 6 步,每步文字超过 30 字就从最近的标点处硬切,缺菜名直接判失败走本地。就算大模型偶尔抽风,渲染到眼镜上的也一定是个结构完整、能一步步看的菜谱。
小坑:AIUI 上直接用浏览器 fetch 发请求会被跨域卡住,所以我优先走 wx.request,fetch 只当兜底。这个换了真机才暴露出来,在 Chrome 模拟器里测不出来。
三、口语食材识别
食材页最初我只放了 12 个芯片,觉得点选就够了。结果自己一用就傻了:我站在冰箱前不可能跟眼镜说"请给我青椒和猪肉",我张嘴是"辣椒炒肉再来个面"。"辣椒"不是芯片上写的"青椒","肉"不知道是猪肉还是牛肉,"面"到底是米饭还是面条?
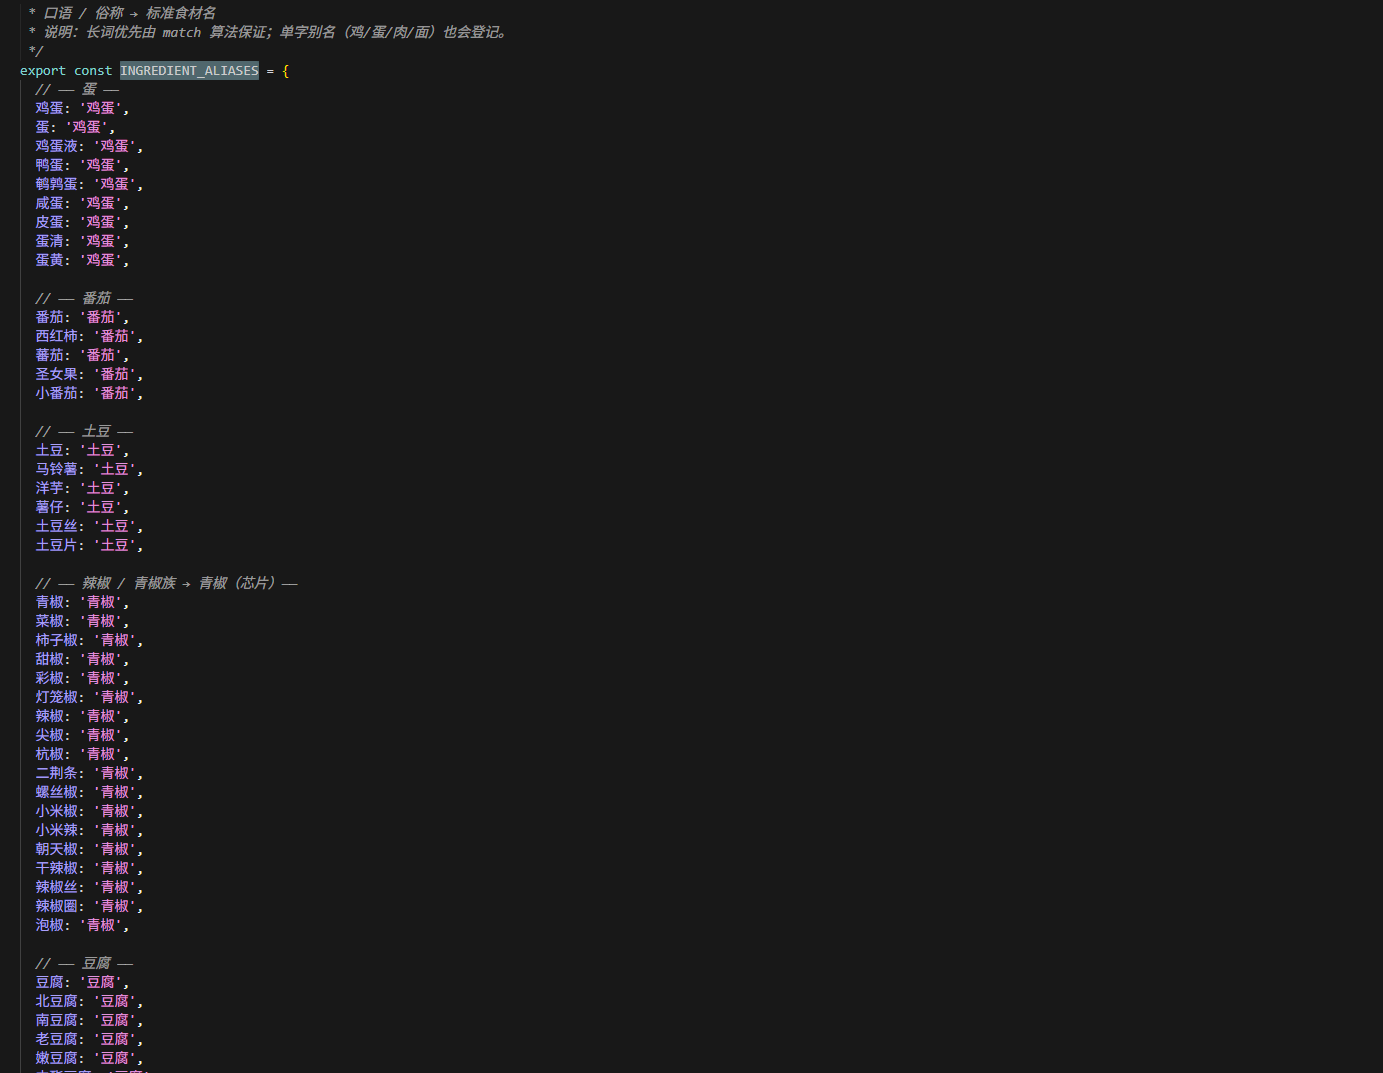
所以我写了个独立词库 ingredient-lexicon.js,把口语别名往标准名上映。现在大概 330 多个别名,举几段感受下:
1、别名词库
export const INGREDIENT_ALIASES = {
  // 辣椒族全归到"青椒"芯片
  辣椒: '青椒', 尖椒: '青椒', 杭椒: '青椒', 小米辣: '青椒',
  二荆条: '青椒', 螺丝椒: '青椒', 朝天椒: '青椒', 干辣椒: '青椒',
  // 猪肉的各种说法
  肉: '猪肉', 五花肉: '猪肉', 里脊: '猪肉', 肉丝: '猪肉', 肉末: '猪肉',
  // 面的各种说法
  面: '面条', 拌面: '面条', 拉面: '面条', 刀削面: '面条',
  米线: '面条', 河粉: '面条', 乌冬: '面条', 粉丝: '面条',
  // 番茄
  西红柿: '番茄', 圣女果: '番茄'
  // ……牛肉、鱼、虾、白菜、菌菇等共 330+ 条
};
2、长词优先匹配
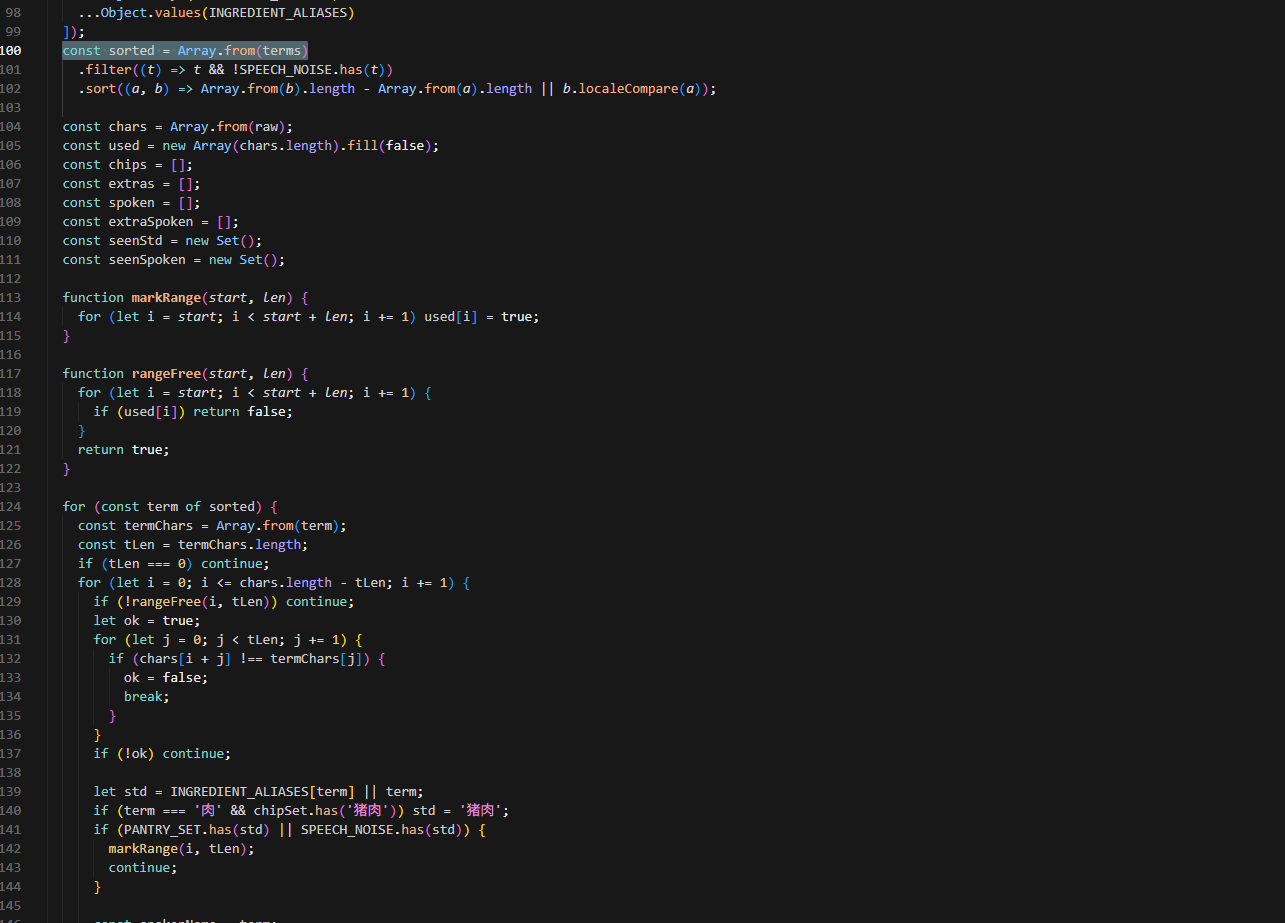
光有映射表不够。"辣椒炒肉拌面"这句话直接按单字扫,"鸡蛋"会被拆成"鸡"和"蛋","拌面"会被拆成"拌"和"面"。所以匹配算法我做了两件事:把所有词按字数从长到短排,扫到一个词就把这段位置标记成"已用",后面的词不能再踩到这块。核心就这几行:
// 所有词按字数降序排,长的先抢位置
const sorted = Array.from(terms)
  .filter(t => t && !SPEECH_NOISE.has(t))
  .sort((a, b) => Array.from(b).length - Array.from(a).length);

for (const term of sorted) {
  // 在原句里逐位找这个词,找到就占用这几个字,不许重叠
  for (let i = 0; i <= chars.length - termLen; i++) {
    if (!rangeFree(i, termLen)) continue;     // 这块已被更长的词占用
    // ……匹配成功,记录标准名,markRange(i, termLen)
  }
}
另外我还列了一个噪声词表:"炒、拌、跟、和、冰箱、里、剩下、来个"这些,扫到直接丢掉不参与匹配。不然"炒肉"会被当成一个食材。
3、说什么显示什么
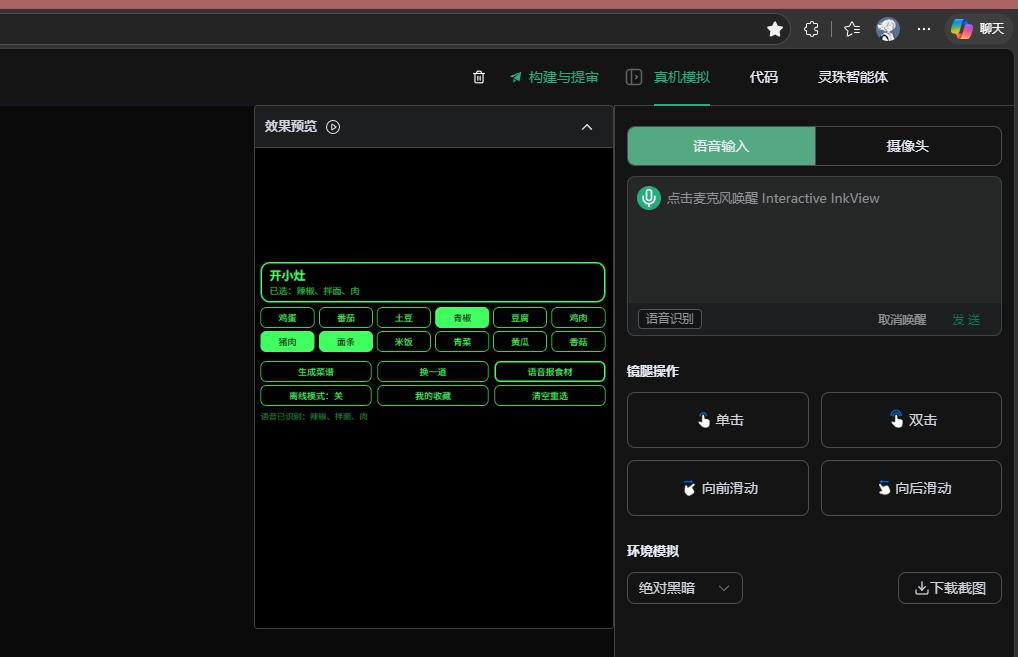
这是我最在意的一个细节。早期版本识别完只显示标准名——用户说了"辣椒炒肉拌面",屏幕上孤零零三个词"青椒、猪肉、面条",看着就不像我刚说的话,很没有安全感。
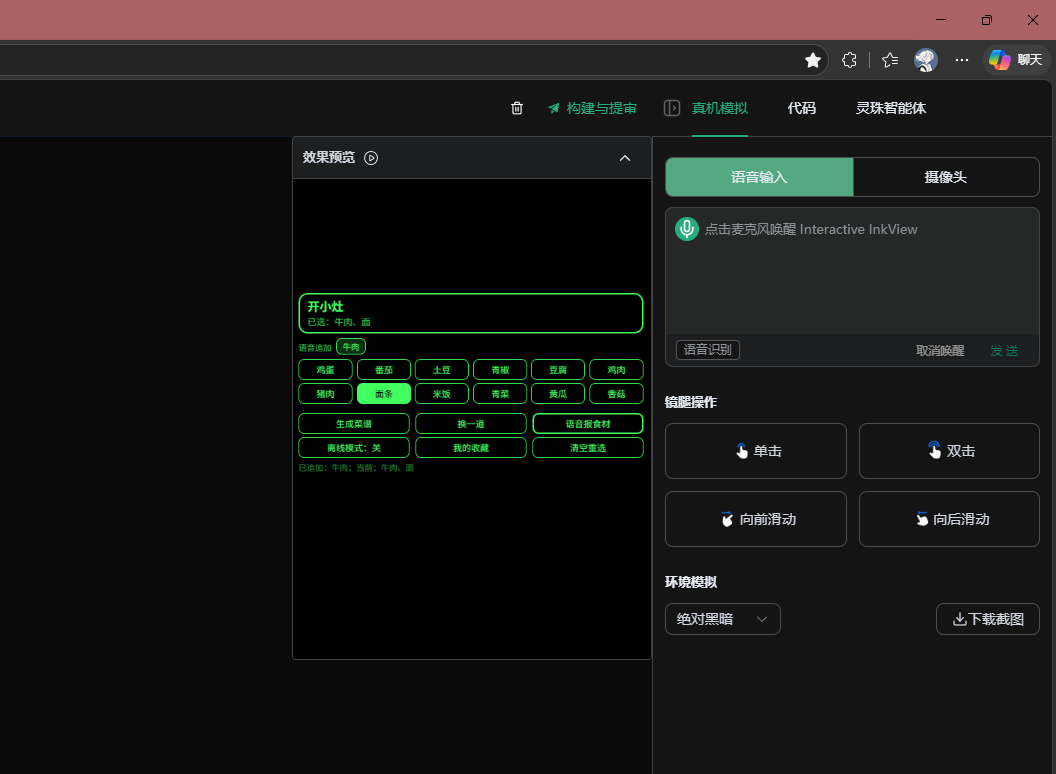
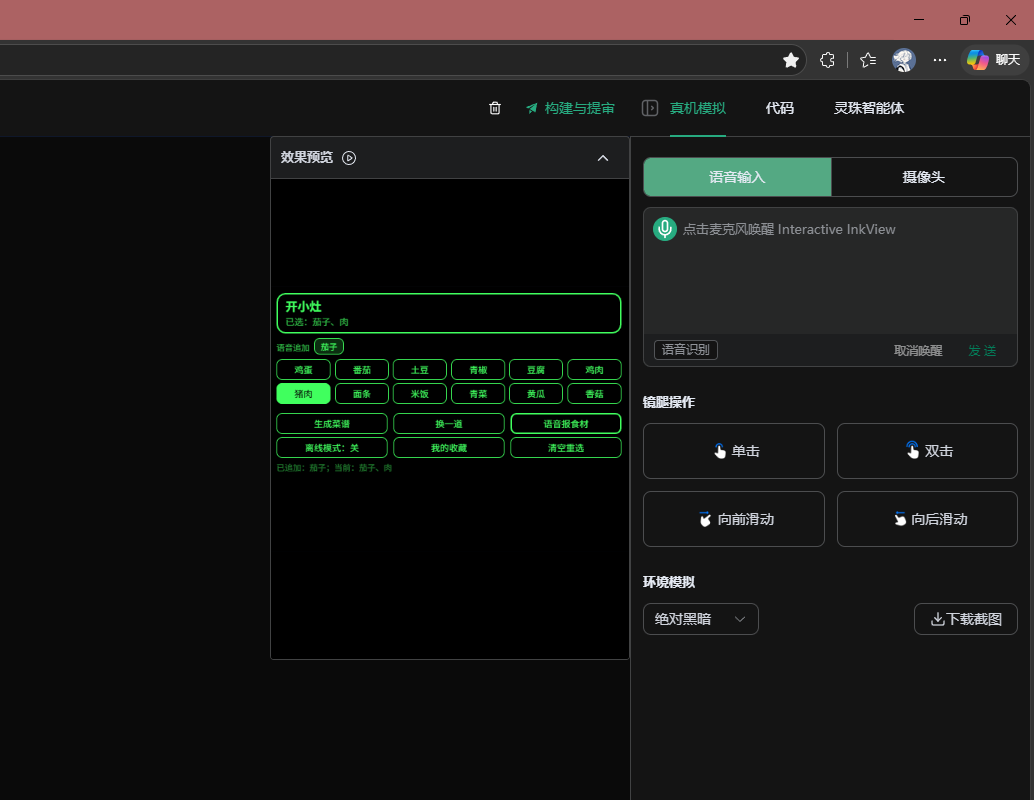
现在改成:顶部"已选"优先显示用户原话("辣椒、拌面、肉"),同时把能映射到芯片的对应点亮(青椒、猪肉、面条);要是说了芯片上没有的,比如"牛肉面","牛肉"会单独出现在一行"语音追加"标签里——它没被丢掉,照样参与出菜,只是屏幕上多了个小标签告诉你我听懂了。
| 你说的 | 屏幕显示原话 | 点亮芯片 | 追加标签 |
| 辣椒炒肉拌面 | 辣椒、拌面、肉 | 青椒、猪肉、面条 | — |
| 牛肉面 | 牛肉、面 | 面条 | 牛肉 |
| 茄子烧肉 | 茄子、肉 | 猪肉 | 茄子 |
四、分步教学页
进了菜谱页,界面就四块:当前步骤大字、一个进度、底部五个操作(上一步 / 下一步 / 计时或朗读 / 收藏 / 返回)。这页没什么花哨的,关键是那个"计时/朗读"按钮,根据当前步骤有没有 timerSec 自动变身:
toggleTimerOrReplay() {
  const step = this._recipe.steps[this.data.stepIndex];
  const needTimer = step && Number(step.timerSec) > 0;

  // 这步不用等 → 按钮变成"再念一遍"
  if (!needTimer) {
    playTtsSafe(step.text);
    return;
  }

  // 正在跑 → 暂停
  if (this.data.timerRunning) { this.clearTimer(); return; }

  // 开始倒计时
  this._timer = setInterval(() => {
    const next = this.data.remainSec - 1;
    if (next <= 0) {
      this.clearTimer();
      playTtsSafe(`第 ${this.data.stepNo} 步时间到`);
      return;
    }
    this.setData({ remainSec: next, timerText: formatMmSs(next) });
  }, 1000);
}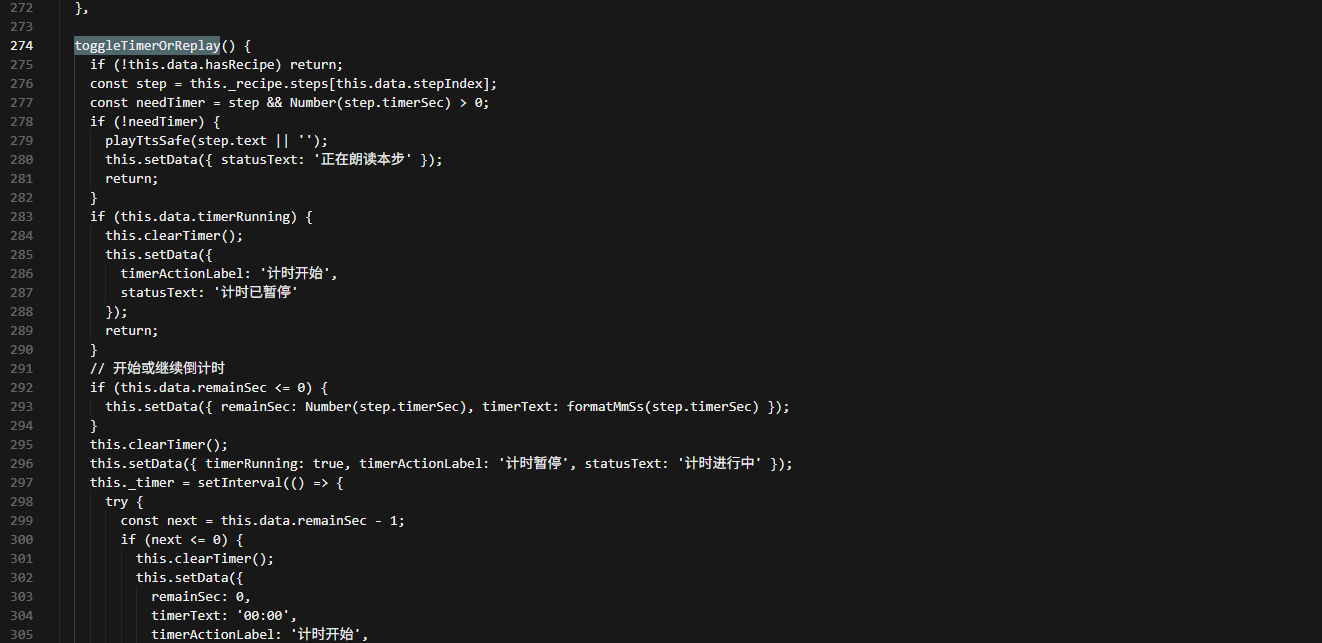
这样设计的原因很直接:炒菜时一只手在锅里,另一只手要拍蒜,眼睛能看、耳朵能听,但手没空碰屏幕。需要炖的步骤就让它自己倒数,到点念一声;不需要等的步骤(比如"加盐"),你转头问一下,它再念一遍当前步骤就行。
五、按键映射与焦点系统
镜腿手势这块我改了两版。第一版我图省事,把所有输入(滑动、单击)都当成"确认"事件处理——结果真机上一滑镜腿,应用直接就进下一步了,因为镜腿触摸信号在滑动时也会上报 GlobalHook。炒菜本来就忙,这一下等于误触。
改完之后规则变得很明确:前后滑动只移动焦点,真正确认只有 Enter 键;而且滑完之后 200 毫秒内忽略确认,防止手势尾巴带出来一次误触发:
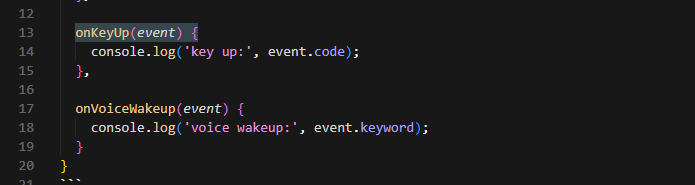
onKeyUp(event) {
  event.preventDefault();
  const code = event.code;

  if (code === 'Backspace') { this.goBack(); return; }

  // 滑动 → 只挪焦点,不执行
  if (code === 'ArrowUp' || code === 'ArrowLeft') {
    this.armNavGuard();           // 200ms 内忽略确认
    this.moveFocus(-1);
    return;
  }
  if (code === 'ArrowDown' || code === 'ArrowRight') {
    this.armNavGuard();
    this.moveFocus(1);
    return;
  }

  // 单击确认只用 Enter,GlobalHook 是触摸总信号,滑动也会报,不能用
  if (code === 'Enter' && Date.now() >= this._navGuardUntil) {
    this.activateFocus();
  }
}
这改完之后体验才对味:滑一下高亮按钮,再滑换一个,看准了单击才执行。
六、项目创建与打包上线
1、在 AIUI Studio 创建智能体
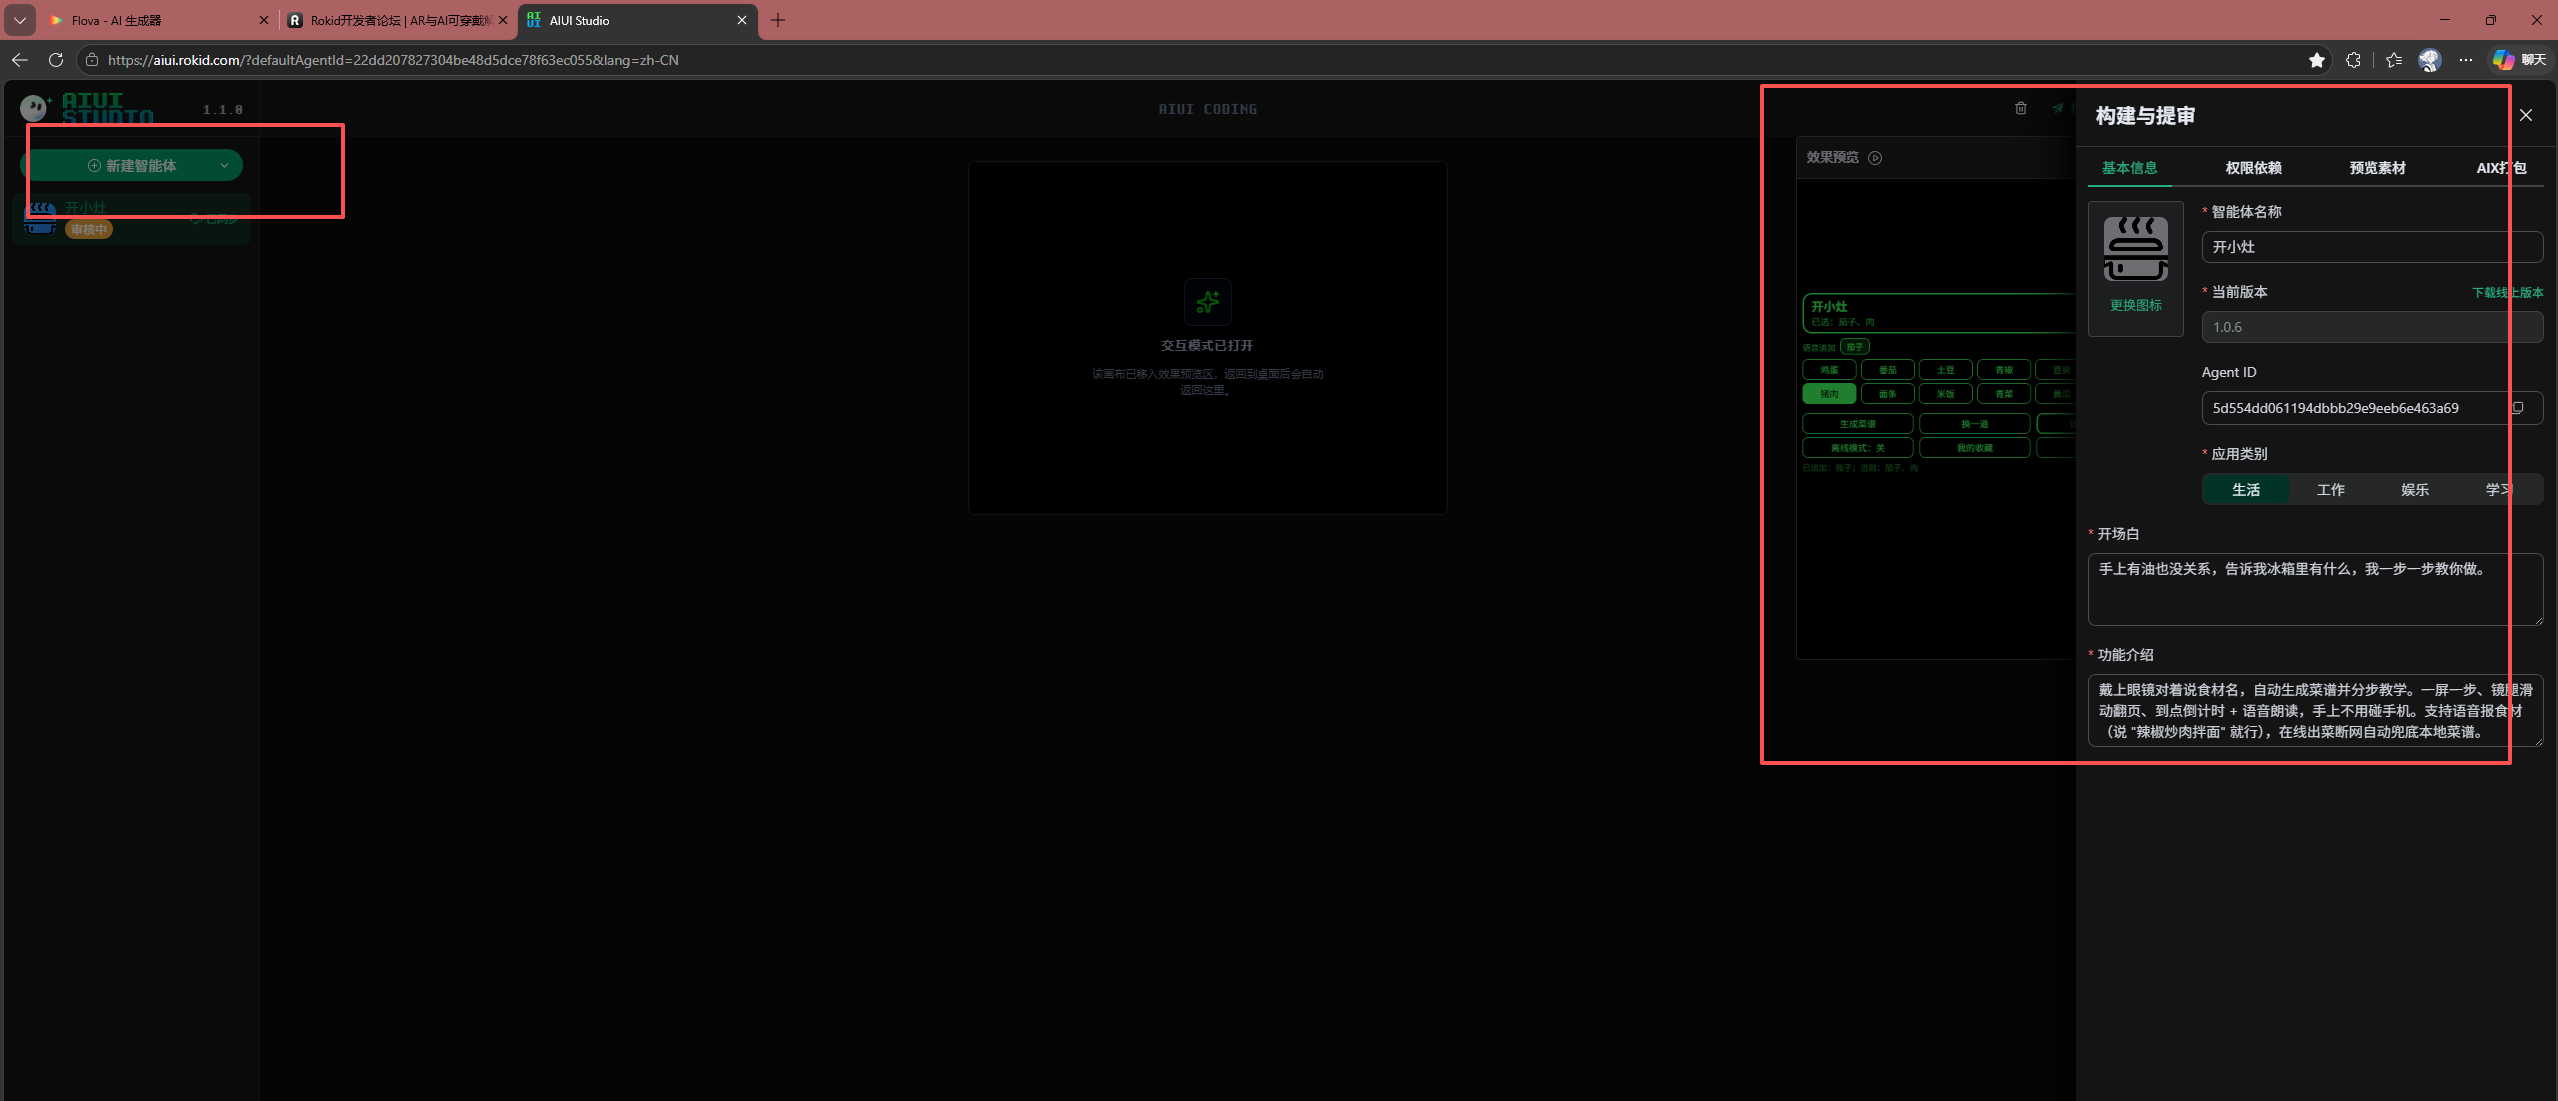
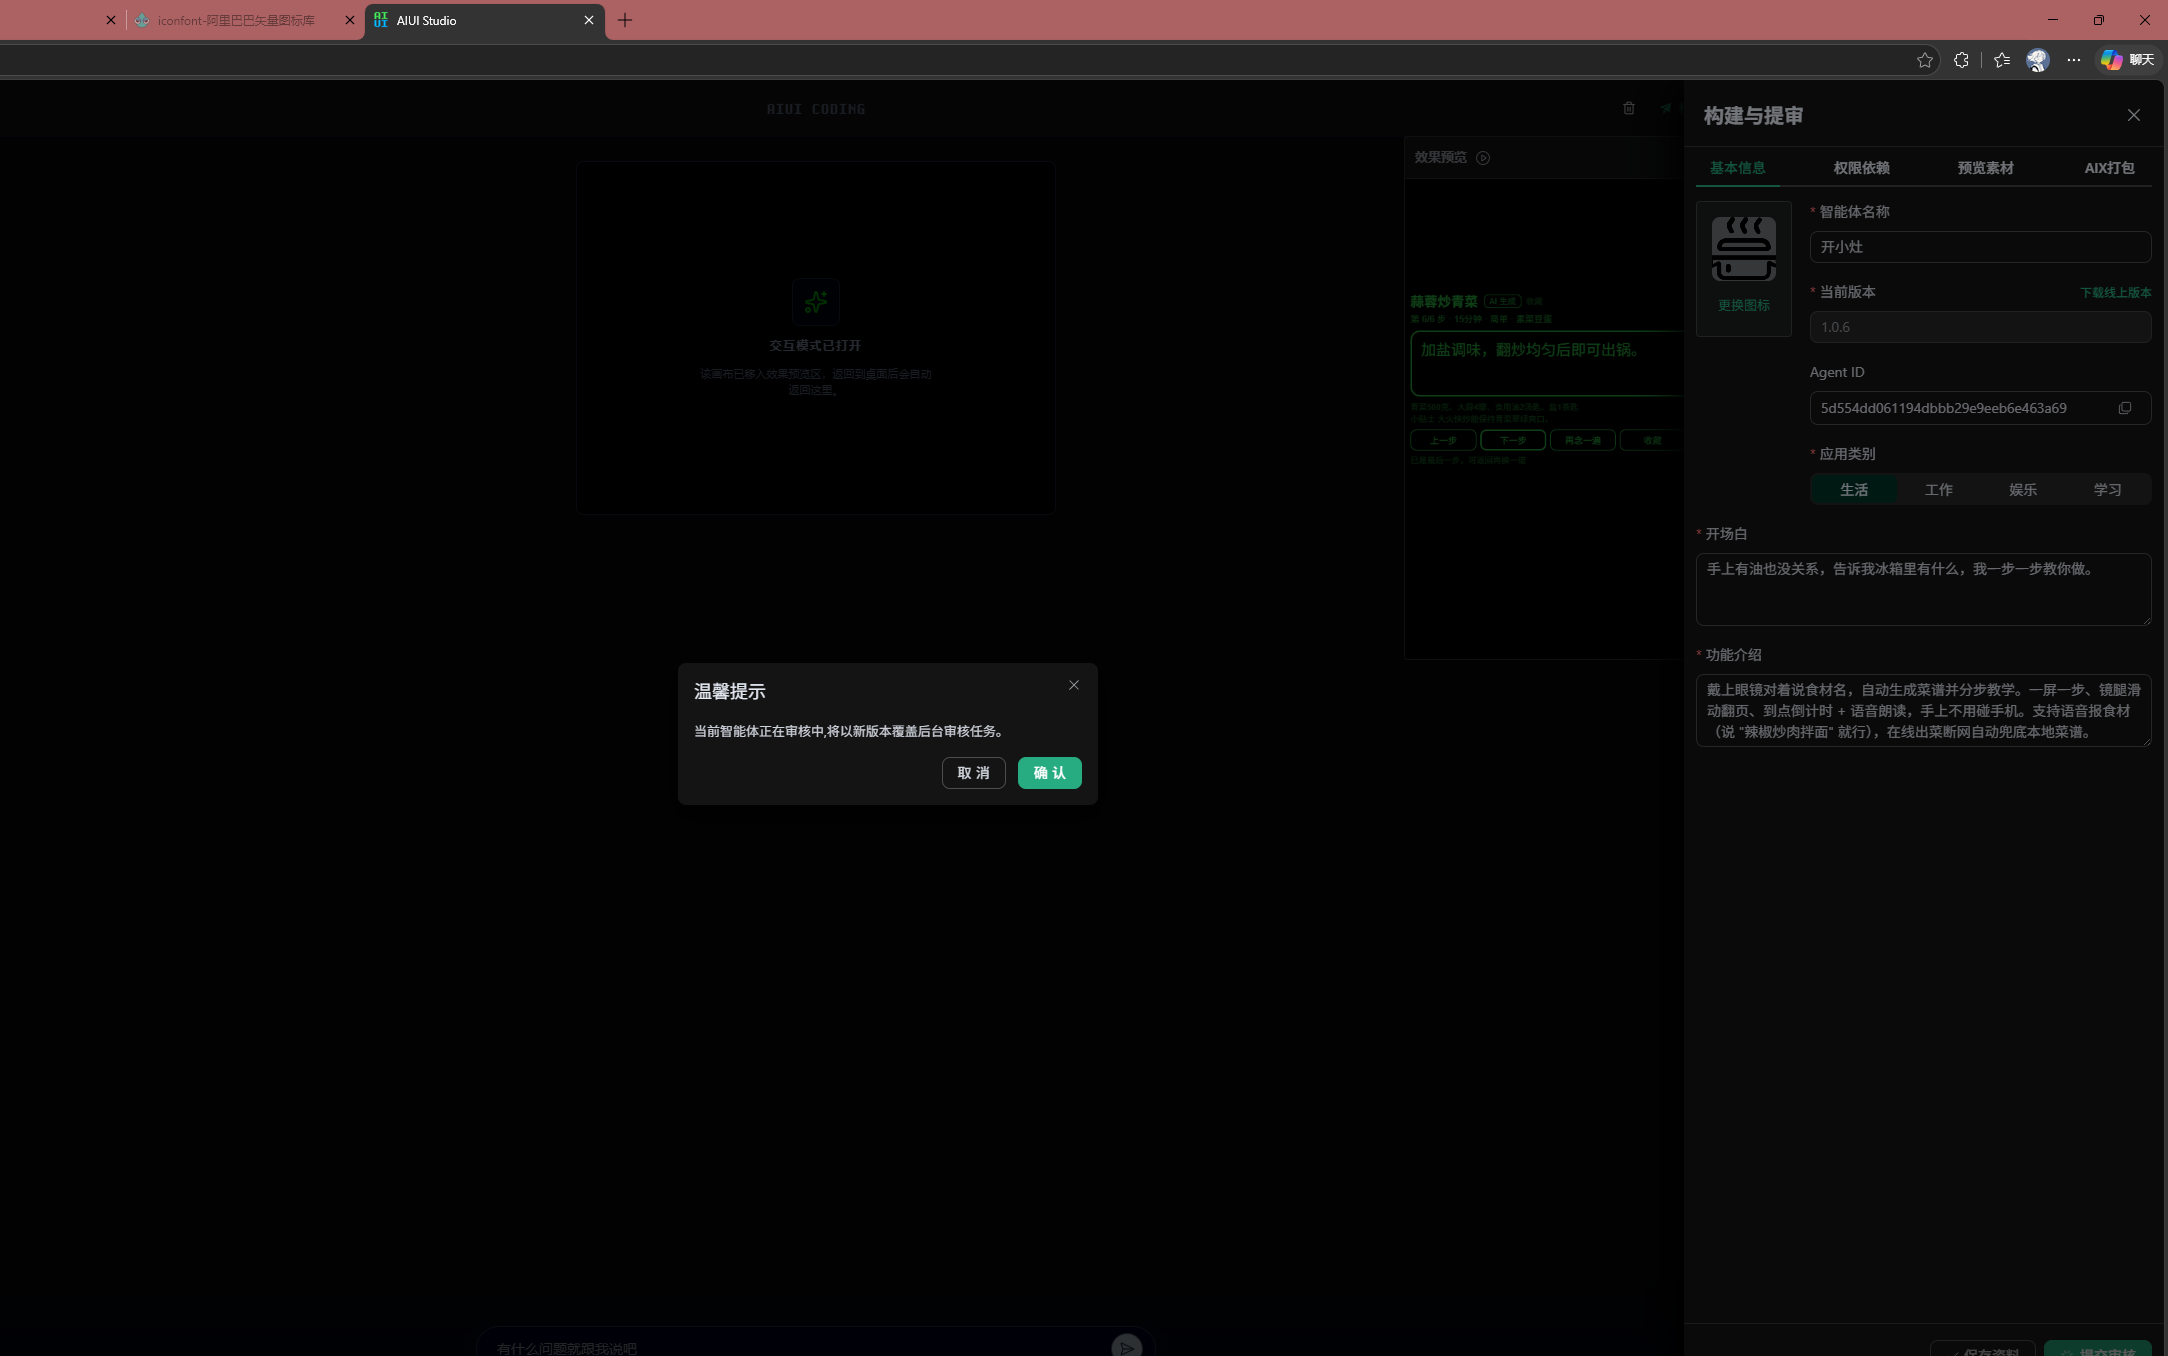
打开 AIUI Studio,登录后点"新建智能体",名字随便起(比如"开小灶"),分类选生活工具。创建完会得到一个 Agent ID,后面代码里要用。
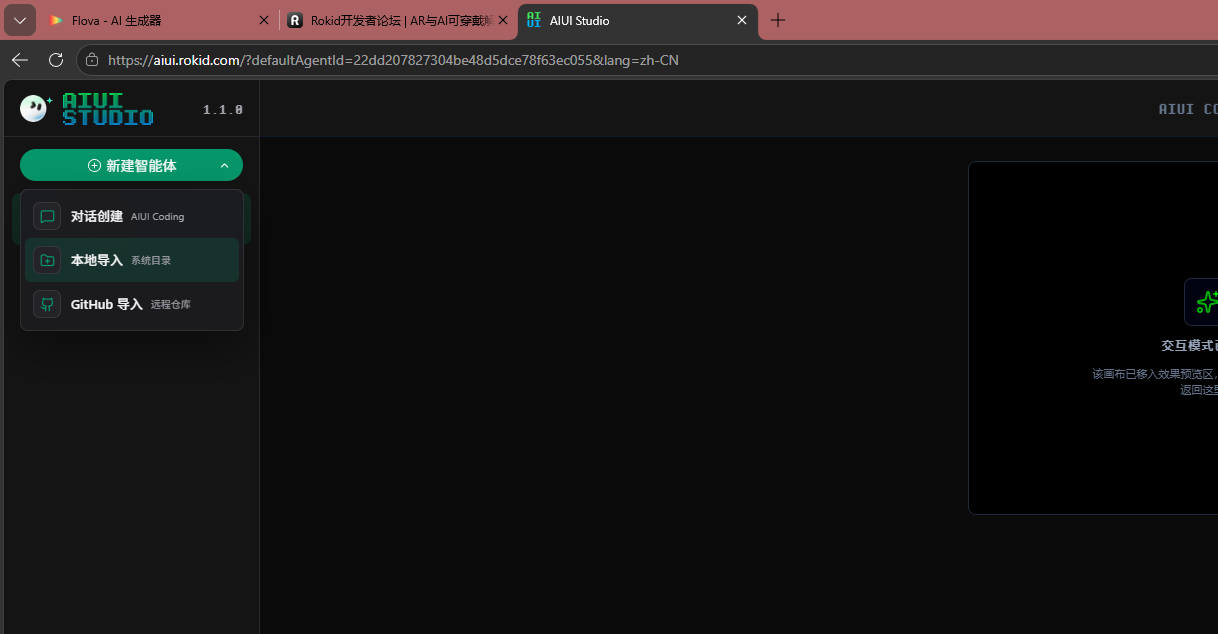
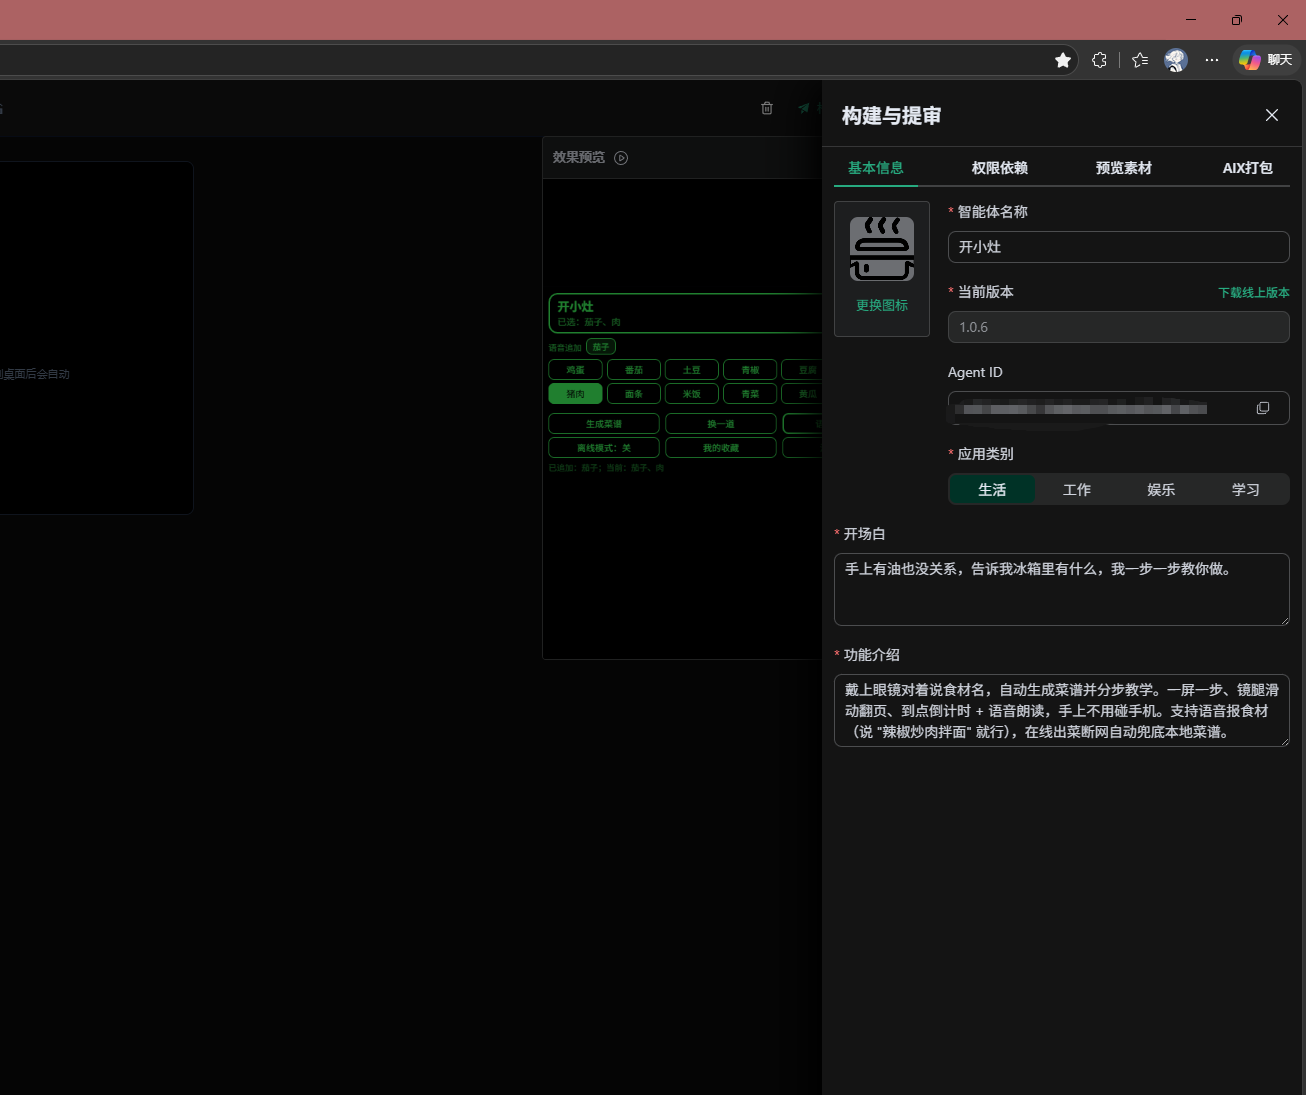
创建时还要填两个东西:开场白和功能介绍。开场白是用户第一次打开智能体时眼镜自动念的那句,别写太长,一句人话就行:
开场白:手上有油也没关系,告诉我冰箱里有什么,我一步一步教你做。
功能介绍填在后台,给审核和商店列表看的,说清楚能干什么、给谁用:
功能介绍:戴上眼镜对着说食材名,自动生成菜谱并分步教学。一屏一步、镜腿滑动翻页、到点倒计时+语音朗读,手上不用碰手机。支持语音报食材(说"辣椒炒肉拌面"就行),在线出菜断网自动兜底本地菜谱。
2、拉开发包与目录结构
从 Gitee 克隆一份官方开发包,把我这个 fridge-recipes/ 文件夹整个拷进去。工程目录大概长这样:
fridge-recipes/
├── AGENTS.md              # 给 AI 看的工程说明
├── app.json               # 智能体配置(入口页、权限)
├── config.js              # DEEPSEEK_API_KEY、超时等配置
├── modules/
│   ├── provider.js        # 在线/离线双通道切换
│   ├── deepseek.js        # 调 DeepSeek、超时、校验 JSON
│   ├── ingredient-lexicon.js  # 330+ 口语别名词库
│   ├── recipe-schema.js   # 食材识别、长词匹配、菜谱校验
│   └── local-recipes.js   # 48 道本地兜底菜谱
└── pages/
    ├── home/              # 食材选择页
    └── recipe/            # 分步教学页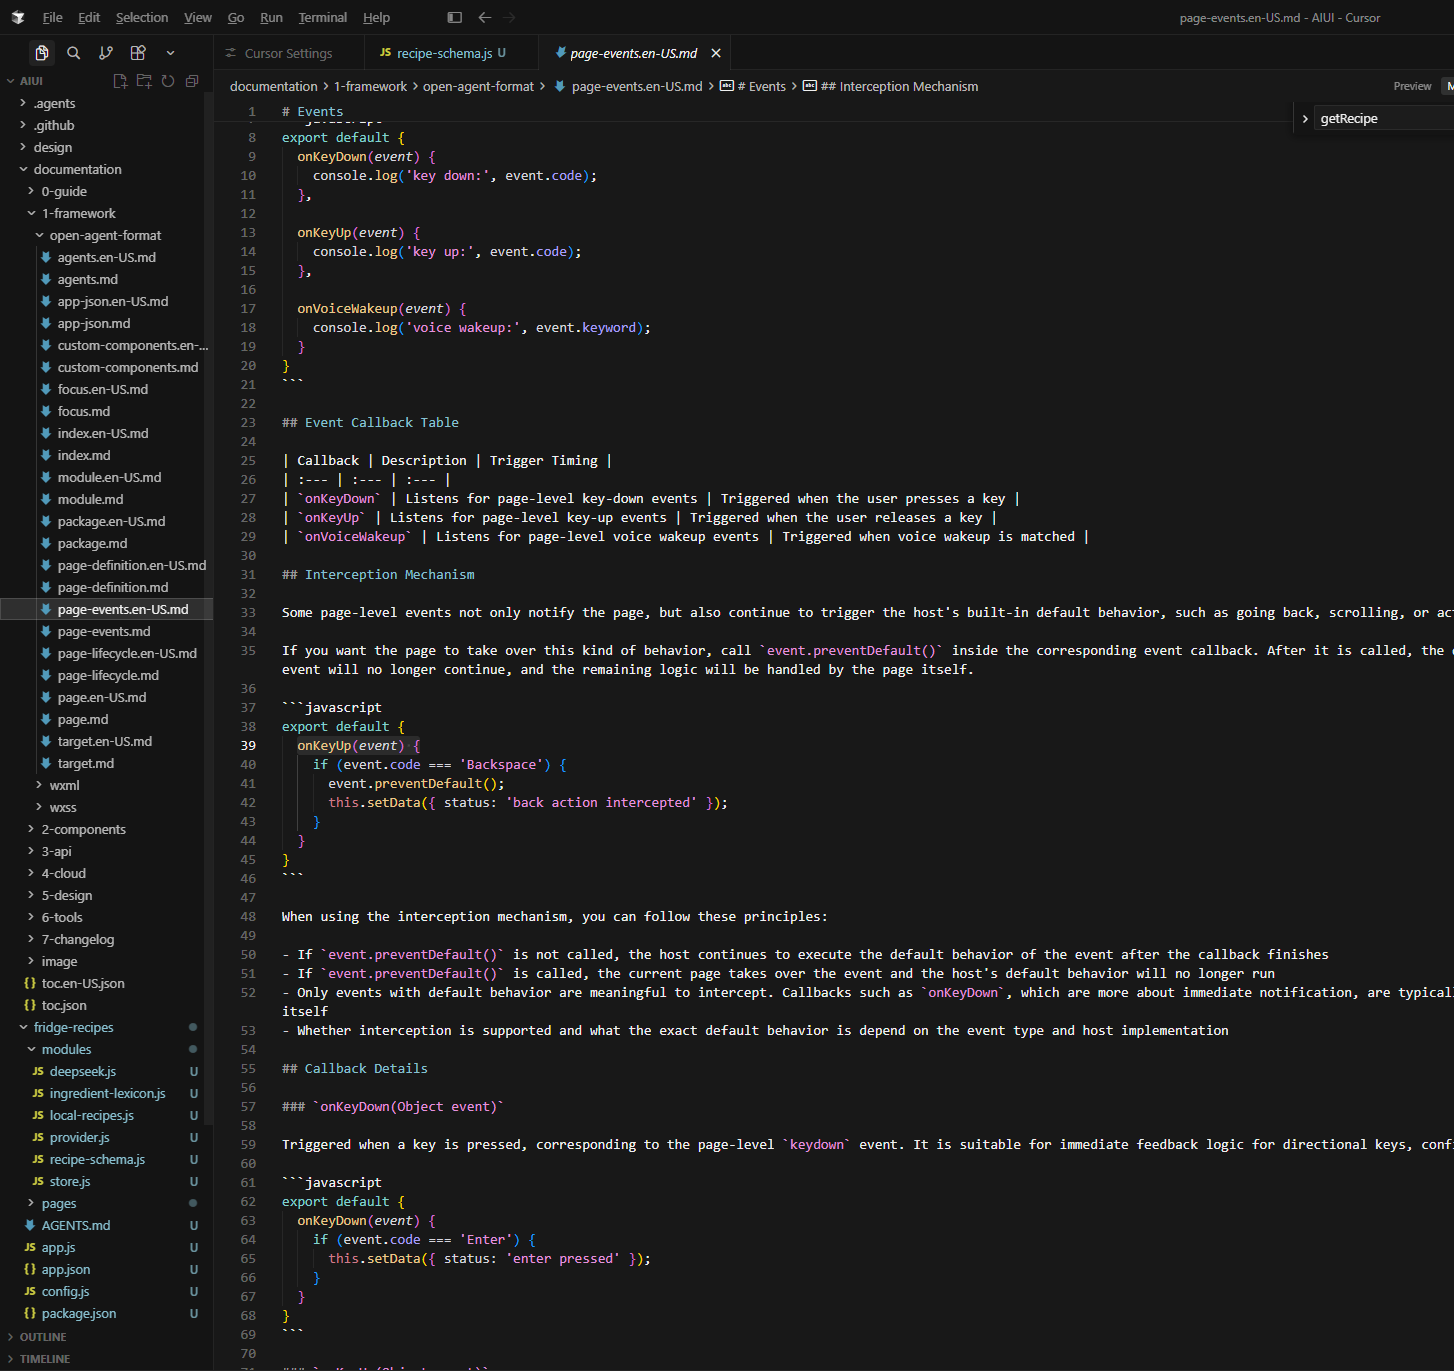
3、在 Craft 中导入并运行
打开 Craft 工作台,把整个 fridge-recipes/ 文件夹拖进去,等依赖装完点"运行"。右侧预览窗口会直接渲染出食材页,不用连真机就能滑着测。
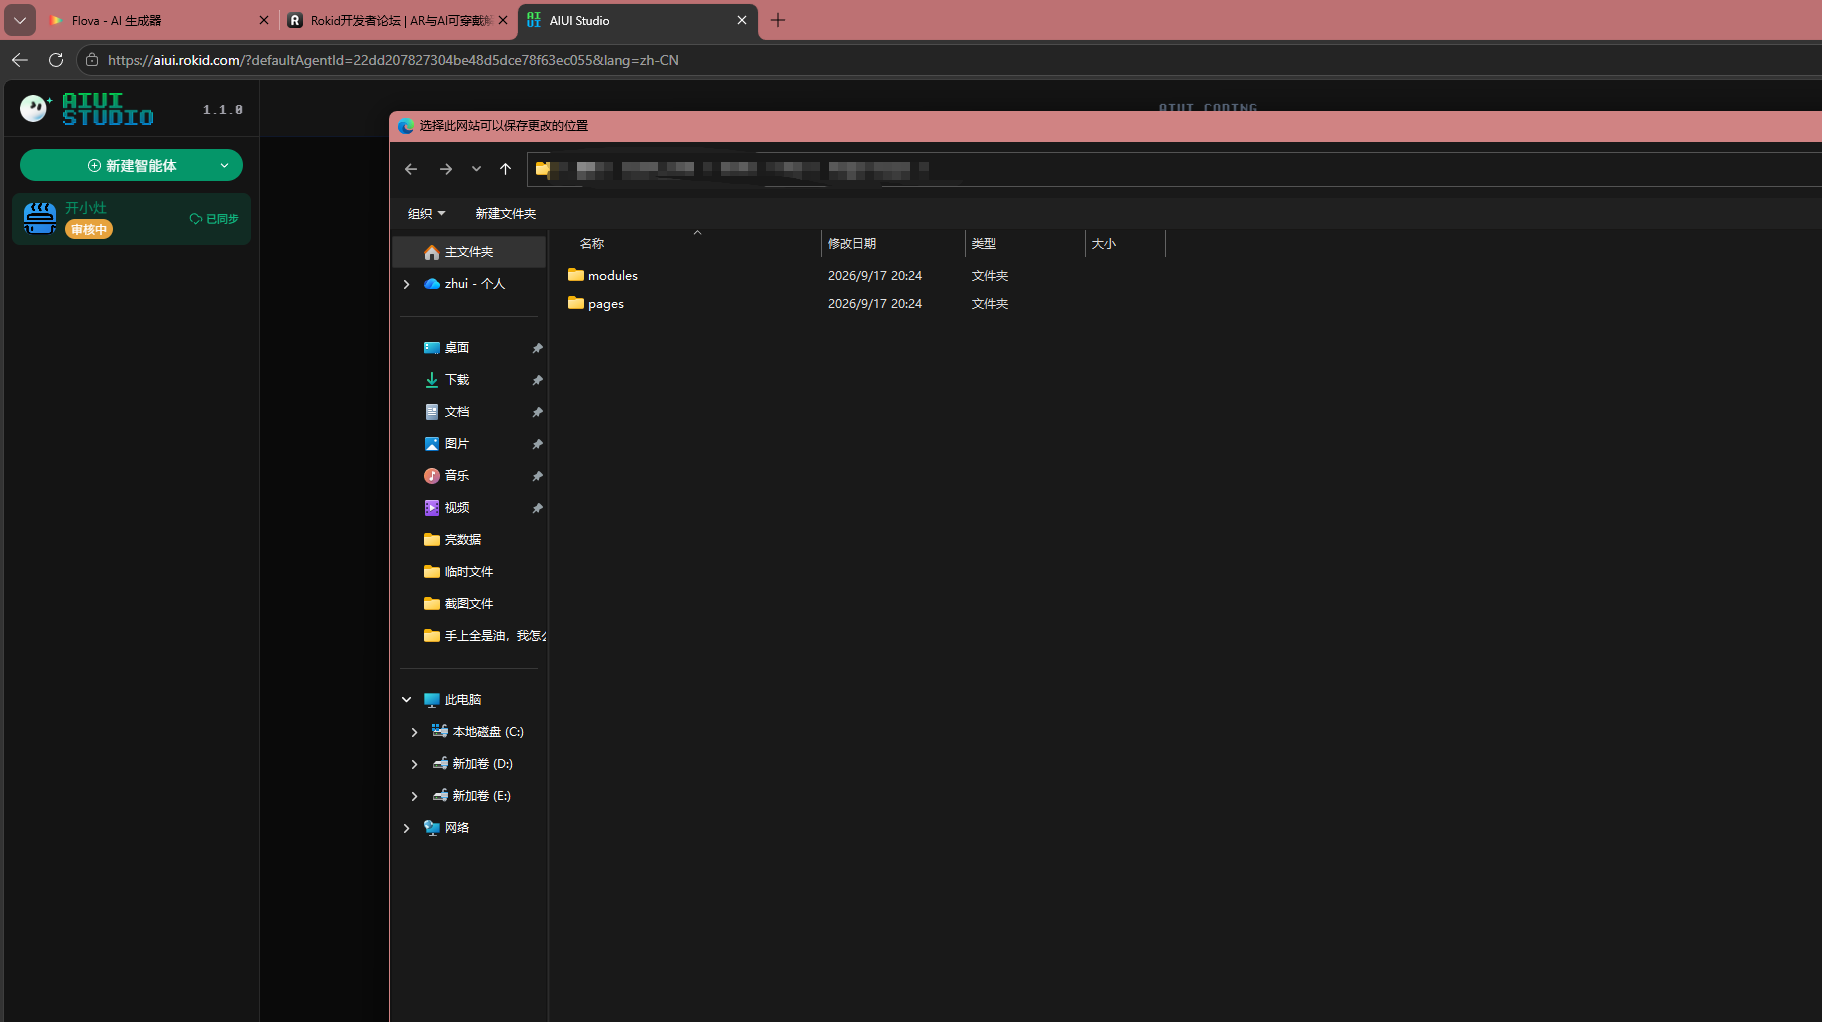
想试在线出菜,把 config.js 里的 DEEPSEEK_API_KEY 填上;不想联网或者没 Key,直接打开页面上的"离线模式"开关,走本地 48 道菜,功能一模一样。
4、打包上线
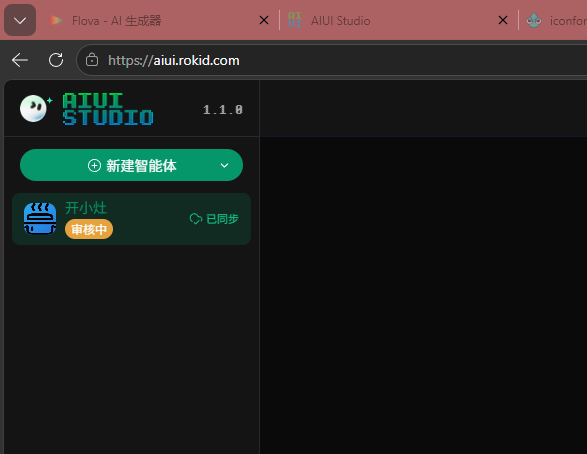
Craft 里测没问题后,点右上角"打包",选"发布到智能体"。第一次发布需要填一句简介和图标,审核过了就能在眼镜上的智能体列表里搜到。以后改完代码重新打包上传,眼镜上自动更新,不用重装。
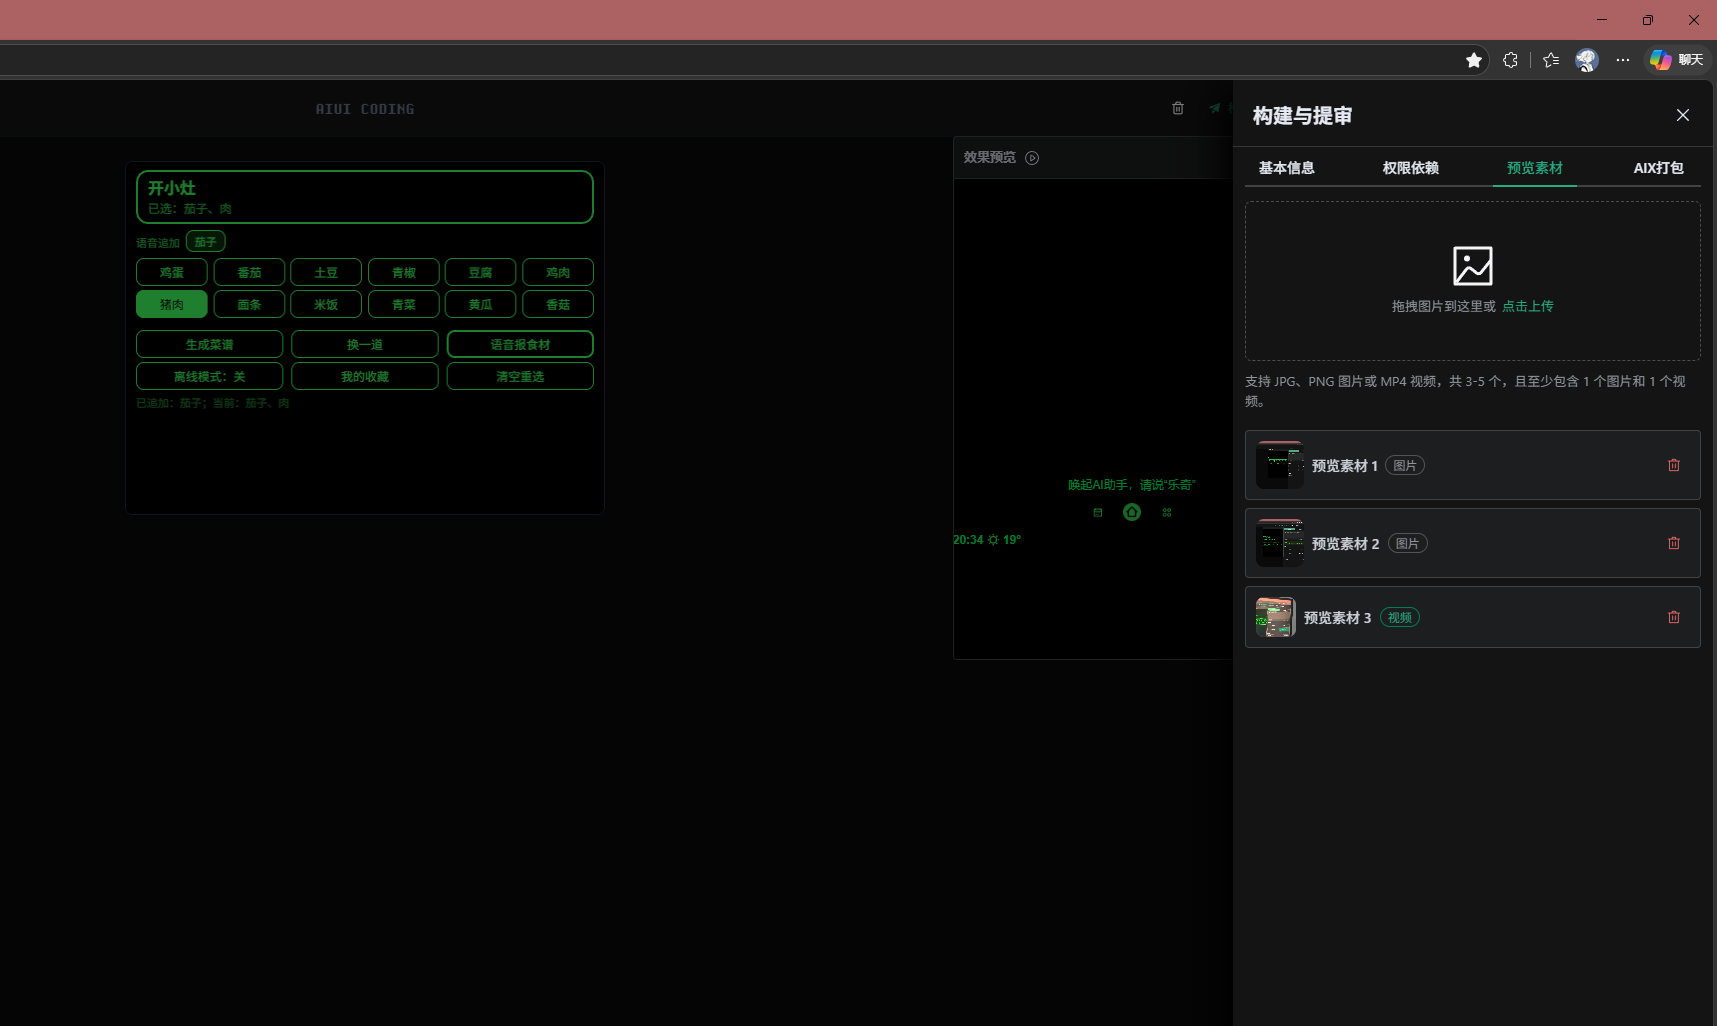
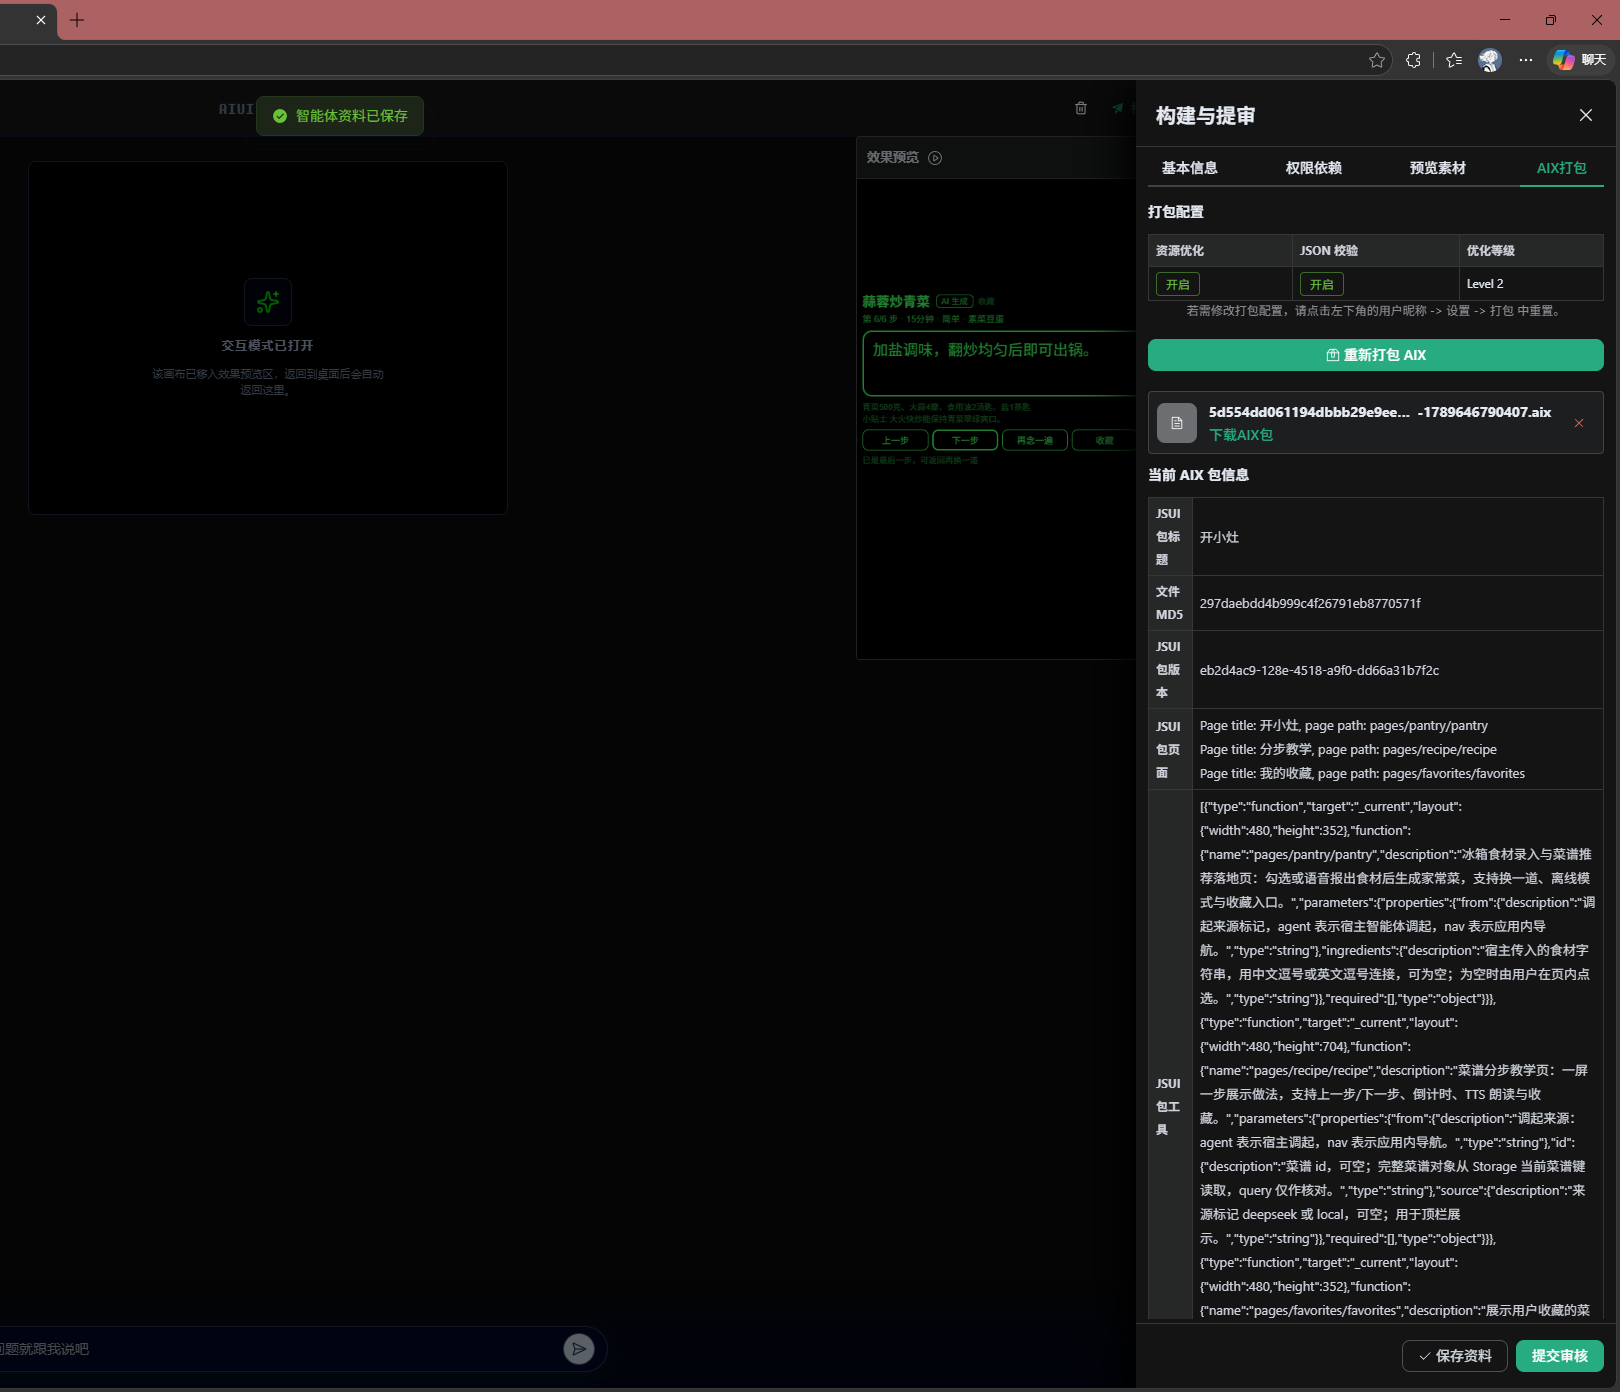
提审时预览素材至少要传 3-5 个文件(JPG/PNG 图片或 MP4 视频),而且必须至少包含 1 张图片和 1 个视频。我第一次只传了几张截图就提交,直接被打回来。建议录一段实际操作视频(语音报食材→出菜→分步教学),再配 2-3 张关键界面截图就够了。
素材传完后切到"AIX 打包"标签页,点"重新打包 AIX"。打包配置默认开着资源优化、JSON 校验、优化等级 Level 2,不用动。打包完会生成一个 .aix 文件(文件名带 Agent ID 和时间戳),确认包标、包版、包页面(食材页/分步教学/收藏)都对,再点"提交审核"。
七、运行效果
本地跑起来之后,实际长这样:
八、总结
1、开发中踩过的坑
不凑数,几个真坑:
- 镜腿单击键搞错了。一开始把
GlobalHook当确认,结果一滑就进下一步,改成只认Enter才正常。 - 接口必须走
wx.request,别用fetch。Craft 浏览器里跨域,fetch直接报错,换成wx.request才通。 - 大模型返回的 JSON 不能信。哪怕开了
response_format,也得自己再解析一遍首尾花括号、修字段、切长句,不然偶尔一次抽风整个页面就崩了。 - 长词必须先匹配。"鸡蛋"先于"鸡"匹配,"拌面"先于"面"匹配,不然食材全拆碎。
- 模板里别写三元表达式。AIUI 的 Ink 模板对
a ? b : c支持不好,我把样式判断全预先算好塞进data里了。
2、后续计划
厨房这个场景其实还能往下挖:识别冰箱里的保质期、根据人数自动改菜量、接本地语音唤醒不走点麦克风。先把这版跑顺,后面再加。
九、写在最后
做这个小应用最大的感受是:在眼镜上做东西,不能照搬手机 App 那套。手机上你可以点、可以滑、可以双指缩放,眼镜上你的手是在锅里、面上、水里,真正能用的只有"眼睛看 + 耳朵听 + 镜腿那点手势"。把这个想明白,一屏一步、断网兜底、说人话食材这些设计就都是自然推出来的。
项目代码我已经开源了,有兴趣可以拿去改。厨房这个场景其实还能往下做——比如识别冰箱里的保质期、根据人数自动改菜量,都挺值得挖。
相关资源:
- AIUI 官网:js.rokid.com/AIUI
- AIUI Studio:aiui.rokid.com
- Craft 工作台:js.rokid.com/craft
- 开源地址:https://gitcode.com/gcw_5HydrCBG/kaixiaozhao
更多推荐

 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)