
点击率预估(CTR)与 FuxiCTR 实战指南
在推荐系统、广告投放与搜索排序等工业化场景中,点击率预估(Click-Through Rate Prediction, CTR) 是衡量分发效率的核心指标。其任务是构建一个概率模型 P ( click = 1 ∣ user , item , context ) P(\text{click}=1 | \text{user}, \text{item}, \text{context}) P(click=1∣user,item,context)。
本文将结合华为诺亚方舟实验室开源的 FuxiCTR 框架,深入解析其底层机制、庞大的模型库支持,以及在实战中应对"AUC 50%"失效案例的排障经验。
开源地址:
https://github.com/reczoo/FuxiCTR
tutorials
一、 FuxiCTR:工业级 CTR 预估库的深度解构
1. 为什么选择 FuxiCTR?
在 CTR 场景下,数据通常表现为高维、稀疏、且具有复杂的非线性交互。相比传统树模型(如 XGBoost),FuxiCTR 通过深度学习机制展现了以下核心优势:
- 可配置性(Configurable):数据预处理与模型组件均实现了高度模块化,通过 YAML 文件即可控制整个实验流程。
- 可调优性(Tunable):内置自动调参工具,支持快速的超参数网格搜索。
- 可复现性(Reproducible):提供了完整的 Benchmark 设置,确保学术研究与工业实验的可比性。
- 丰富的模型支持(Model Zoo):FuxiCTR 涵盖了从传统的线性模型到最前沿的深度学习模型,支持 PyTorch 与 TensorFlow 双引擎。
2. 庞大的模型家族 (Model Zoo)
FuxiCTR 提供了超过 50 个经典及前沿模型的实现,按技术演进分为:
- 特征交互模型 (Feature Interaction):如 FM, DeepFM (Huawei), DCN (Google), xDeepFM (Microsoft), FinalMLP (Huawei) 等。
- 行为序列建模 (Behavior Sequence):如 DIN, DIEN, BST (Alibaba), TransAct (Pinterest) 等。
- 长序列建模 (Long Sequence):如 SIM, ETA (Alibaba), SDIM (Meituan) 等。
- 动态权重与多任务建模:如 APG (Alibaba), PEPNet (Kuaishou), MMoE (Google), PLE (Tencent) 等。
二、 核心工作流:从配置到生产
FuxiCTR 的建模流程严格遵循工业级的标准化链路。从原始数据到最终的预测输出,可以抽象为以下流程图和伪代码逻辑:
1. 建模全链路流程图 (Mermaid)
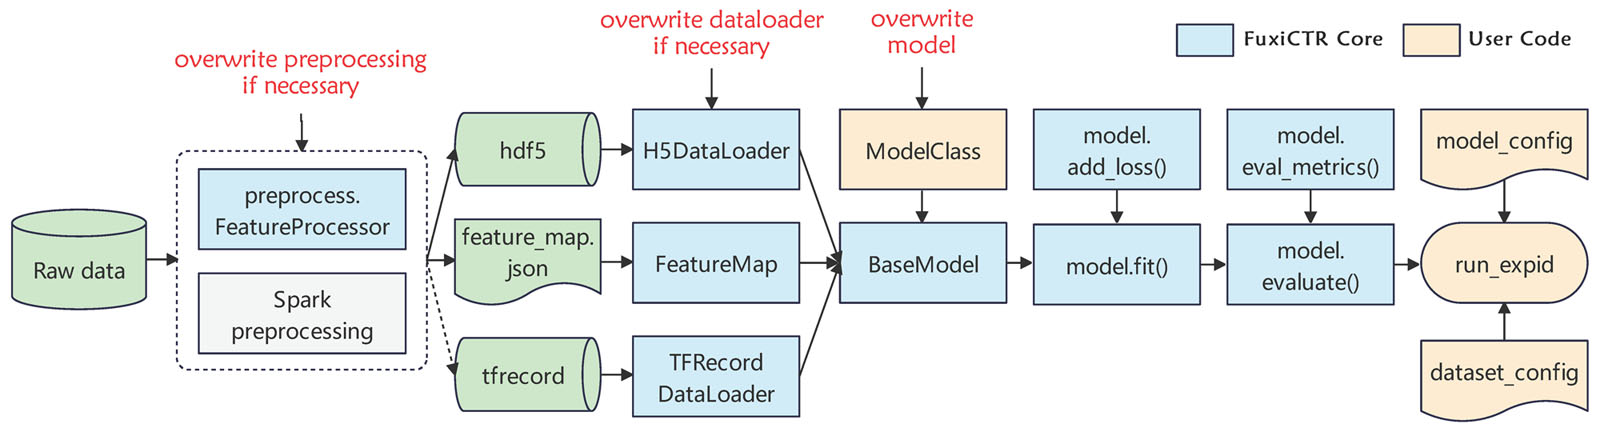
2. 建模伪代码逻辑 (Pseudo-code)
# --- STEP 1: 数据清洗 (Data Cleaning) ---
# 处理原始业务日志,确保 Label 准确且特征无明显脏数据
raw_data = load_csv("raw_data.csv")
clean_data = raw_data.dropna(subset=["label"]).filter_outliers()

# --- STEP 2: 特征工程 (Feature Engineering) ---
# 在 dataset_config.yaml 中显式定义特征类型(灵魂步骤)
# 确保 ID 类列设为 Categorical,连续值设为 Numeric

# --- STEP 3: 训练前准备 (Pre-training Prep) ---
config = load_config(dataset_yaml, model_yaml)
processor = FeatureProcessor(config)
# 将 CSV 转换为二进制格式,并生成 feature_map.json (存储词典与统计量)
train_file, valid_file = build_dataset(processor, clean_data)
feature_map = FeatureMap().load("feature_map.json")

# --- STEP 4: 训练模型 (Model Training) ---
# 初始化模型(会自动根据 feature_map 构建 Embedding 层和交叉层)
model = DeepFM(feature_map, **config)
train_gen = RankDataLoader(train_file, batch_size=params['batch_size'])
model.fit(train_gen, validation_data=valid_gen, epochs=10)

# --- STEP 5: 训练模型评估 (Evaluation) ---
# 计算验证集指标,观察 AUC 与 LogLoss 是否符合预期
val_metrics = model.evaluate(valid_gen)
print(f"Validation AUC: {val_metrics['AUC']}")

# --- STEP 6: 模型验证与预测 (Validation & Prediction) ---
# 加载测试集进行推理,输出预测概率
test_gen = RankDataLoader(test_file, stage='test')
predictions = model.predict(test_gen)
save_to_csv(predictions, "predict_output.csv")
3. 配置驱动的实验管理:YAML 的奥秘
FuxiCTR 的核心竞争力在于其完全通过 YAML 配置文件 来解耦数据与模型。实验通常由两份关键文件驱动,它们共同构成了实验的"说明书"。
(1) dataset_config.yaml:定义"数据长什么样"
这份文件是 FuxiCTR 理解原始数据的"说明书",它规定了特征的来源、类型及处理方式。
更完整的配置示例:
dataset_202603_2:
  dataset_id: dataset_202603_2 # 数据集唯一标识
  data_root: ./data           # 预处理产物(如 feature_map)的存储根目录
  data_format: csv            # 原始数据格式
  train_data: ./raw_data/train.csv
  valid_data: ./raw_data/valid.csv
  test_data: ./raw_data/predict.csv
  feature_cols:
    # 1. 数值特征 (Numeric)
    - {name: item_sales_r365d, active: true, dtype: float, type: numeric}
    - {name: member_dim_age_value, active: true, dtype: float, type: numeric}

    # 2. 序列特征 (Sequence)
    - name: sequential_order_item_encoded_list
      active: true
      dtype: str
      type: sequence
      splitter: ','           # 序列分隔符
      max_len: 11             # 最大截断长度
      padding: post           # 填充方式(后填充)

    # 3. 类别特征 (Categorical)
    - {name: member_id, active: true, dtype: float, type: categorical}
  label_col:
    {name: label, dtype: int} # 标签列定义
字段深度解读:
dataset_id:逻辑标识符,用于在模型配置中通过此 ID 引用该数据集配置。active:特征开关。设为false则该特征不会进入模型,非常适合做特征消融实验(Ablation Study)。type:numeric:连续值,默认执行标准化处理。categorical:离散值,框架自动建立 Vocab 并映射为 Embedding。sequence:变长序列(如历史行为),需配合splitter和max_len使用。
max_len&padding:处理序列时的标准操作,确保 batch 内张量对齐。
(2) model_config.yaml:定义"模型怎么练"
这份文件控制了算法的架构细节、优化策略以及训练环境。
更完整的配置示例:
DeepFM_202603_2:
  model: DeepFM               # 指定模型类名
  dataset_id: dataset_202603_2 # 必须对应 dataset_config.yaml 中的 ID
  task: binary_classification # 任务类型
  loss: binary_crossentropy   # 损失函数
  metrics: ['AUC', 'logloss'] # 监控指标
  optimizer: adam             # 优化器类型
  learning_rate: 0.001        # 学习率
  embedding_dim: 8            # Embedding 向量维度
  hidden_units: [64, 32]      # MLP 层架构(两层,神经元数为 64 和 32)
  batch_size: 128             # 批大小
  epochs: 10                  # 训练轮数
  shuffle: true               # 是否打乱数据
  seed: 2026                  # 随机种子,保证实验可复现
  monitor: AUC                # 模型保存/早停的参考指标
  save_best_only: true        # 仅保存 monitor 指标最优的模型文件
字段深度解读:
dataset_id:核心纽带。通过这个 ID,模型知道去哪里读取feature_map.json以及处理后的数据文件。embedding_dim:这是 CTR 模型中最重要的超参数之一。它定义了离散特征映射到低维稠密空间的厚度,直接影响模型的表达能力与过拟合风险。hidden_units:定义了 DeepFM 中 “Deep” 部分的深度与宽度。FuxiCTR 支持灵活的列表定义。monitor&save_best_only:自动化模型管理。框架会自动根据验证集的 AUC 表现,实时保存最优权重,避免过拟合。seed:在学术论文复现和工业界 Baseline 对齐中,固定种子是排查波动的首要手段。
2. 特征加工机制与 Parquet 格式选择
FeatureProcessor 负责将原始数据转换为模型可读的张量。在工业界,FuxiCTR 强烈建议使用 Parquet 格式作为中间存储,而非传统的 CSV。
为什么使用 Parquet?
- 列式存储 (Columnar Storage):CTR 特征往往多达数百个,但在某些实验中我们可能只取其中一部分。Parquet 允许只读取需要的列,极大降低了 IO 开销。
- 强类型约束:CSV 容易出现数值读取为字符串的歧义,而 Parquet 自带 Schema,确保了
float和int的物理存储一致性。 - 高压缩比:Parquet 采用 Snappy 或 Gzip 压缩,存储空间通常仅为 CSV 的 1/5 到 1/10,提升了集群分发的效率。
3. 中间产物深度解析:数据的"数字孪生"
在执行 build_dataset 后,FuxiCTR 会在输出目录下生成几个关键文件。这些文件是模型理解数据的"翻译官",其含义如下:
(1) feature_map.json:神经网络的蓝图
这是最核心的文件,定义了模型底层的 Embedding 层和输入层的结构。
num_fields/input_length:模型输入向量的总长度。total_features:模型需要学习的独立特征总数。features列表:type: numeric:代表该列走线性变换或归一化层。type: categorical:代表该列会映射到一个 Embedding 矩阵。type: sequence:如sequential_order_sales_list,它会包含max_len(截断长度)和feature_encoder(如MaskedAveragePooling,即将序列聚合为一个向量的方式)。
(2) feature_vocab.json:特征的字典
它记录了所有离散特征从"原始字符串"到"整数 ID"的映射关系。
__PAD__(0):填充位,用于对齐长度(如序列特征)。__OOV__(Out of Vocabulary):处理在训练集中未出现过的新特征(冷启动)。- 映射示例:在
sequential_order_sales_list中,字符串"10"被映射为数字11,模型训练时实际上看到的是 ID 11。
(3) feature_processor.pkl:预处理的"记忆"
这是一个序列化的 Python 对象,存储了 FeatureProcessor 的运行状态。
- 关键内容:它记录了数值特征(Numeric)的均值(Mean)和标准差(Std)。
- 作用:在推断(Inference)阶段,必须加载此文件,以确保在线预测的特征缩放标准与训练时完全一致,防止"训练推断偏差"。
4 四类特征加工模式以及自定义校验格式
对于实际业务中的 CTR 模型来说,挖掘更多更有效的特征往往比模型结构更有效。特征通常包括类别特征、连续值特征、序列特征和时间类特征等。为了适配这些业务数据,FuxiCTR 提供了标准化的加工协议:
-
Categorical (类别型):
- 处理逻辑:根据基数大小分为两类处理:
- 稠密特征 (Dense):如性别(男/女/其他),类别数目较少,一般通过 One-hot 编码 处理。
- 稀疏特征 (Sparse):如广告 ID、用户 ID,类别数目极大(可达百万级)。直接 One-hot 会导致维度灾难,常用的做法是通过 Embedding 技术 将高维稀疏向量转化成低维稠密向量。
- 示例:
user_id,item_id,gender。
- 处理逻辑:根据基数大小分为两类处理:
-
Numeric (数值型):
- 处理逻辑:通常执行标准化(如
StandardScaler)或归一化。此外,在 CTR 领域,另一种常见的处理办法是进行 分桶 (Bucketing) 操作,将连续值离散化以捕捉非线性关系。 - 模型表现:直接作为连续值输入,或离散化后走 Embedding。
- 示例:
price,user_age。
- 处理逻辑:通常执行标准化(如
-
Sequence (序列型):
- 处理逻辑:处理用户历史行为(如
click_sequence)。通常在进行 Embedding 映射后,通过 Sum/Avg Pooling (池化) 操作或注意力机制(如DIN)将其聚合成固定长度的向量。 - 示例:
last_5_bought_items,clicked_ads_history。
- 处理逻辑:处理用户历史行为(如
-
Time (时间类):
- 处理逻辑:时间戳通常无法直接使用,需要通过特征提取抽取出 周几、当年的第几天、当月的第几天、当季度的第几天、时分秒 等周期性特征。这些特征提取后通常作为类别型特征处理。
-
Pre-trained (预训练型):
- 处理逻辑:加载外部生成的向量(如 Word2Vec, Graph Embedding),支持在训练过程中“锁定”或“微调”。
- 示例:
item_image_embedding。
在进入具体的特征加工模式之前,为了提高实验效率,我在使用过程中会使用自动化辅助函数来完成特征的初步归类与配置生成。
这主要涉及以下两个核心工具函数:
infer_feature_cols(自动化特征推断):- 职责:扫描原始 CSV 采样数据(如前 200 行),根据数据的物理形态(如是否包含逗号、是否以
_list结尾)和 Pandas 数据类型,自动将特征划分为numeric、categorical或sequence等初步类型。 - 意义:极大地减少了手动编写数百行 YAML 配置的工作量,并能初步识别出需要特殊处理的序列行为特征。
- 职责:扫描原始 CSV 采样数据(如前 200 行),根据数据的物理形态(如是否包含逗号、是否以
write_config_files(配置文件自动生成):- 职责:将推断出的特征定义(
feature_cols)与项目路径、模型超参数整合,一键生成 FuxiCTR 运行所需的dataset_config.yaml和model_config.yaml。 - 意义:实现了“代码即配置”,确保了训练脚本中的逻辑变更能实时同步到配置文件中,规避了手动维护 YAML 的低级失误。
- 职责:将推断出的特征定义(
def infer_feature_cols(train_csv, label_name="label"):
    '''
    函数根据数据的物理形态,将特征分为四类:
    - 序列特征 (Sequence Features)

    '''
    sample_df = pd.read_csv(train_csv, nrows=200)
    feature_cols = []
    for col in sample_df.columns:
        # 特征过滤:排除标签列
        if col.lower() == label_name.lower(): continue

        # 1 序列特征 (Sequence Features)
        # 如果列名以 _list 结尾,或者数据中包含逗号(如 "1,5,23"),则判定为用户行为序列。
        # 配置参数:
            # type: "sequence":告知 FuxiCTR 需要进行 Embedding + Pooling(池化)处理。
            # splitter: ",":指定用逗号切分字符串。
            # max_len: 11:预设最大长度(这通常是根据业务经验设置的默认值)。
        series_sample = sample_df[col].dropna().astype(str)
        has_comma = series_sample.str.contains(",", regex=False).any() if len(series_sample) > 0 else False
        if col.endswith("_list") or has_comma:
            feature_cols.append({"name": col, "active": True, "dtype": "str", "type": "sequence", "splitter": ",", "max_len": 11, "padding": "post"})

        # 2 连续数值特征 (Numeric Features)
            # 推断依据:如果 Pandas 识别该列为浮点数(float),说明它是连续变化的数值(如价格、点击率、分数值)。
            # 配置参数:type: "numeric", dtype: "float"。
        elif pd.api.types.is_float_dtype(sample_df[col]):
            feature_cols.append({"name": col, "active": True, "dtype": "float", "type": "numeric"})

        # 3 整数型特征的二分处理 (Integer Heuristics)
            # 如果是低基数(Unique < 100):比如“省份ID”、“性别代码(0/1)”。虽然是数字,但它们代表的是类别,应该走 Embedding。
            # 如果是高基数(Unique >= 100):比如“用户年龄”、“商品累计销量”。这些数字通常具有大小意义,直接作为 连续数值 输入模型效果更好。
        elif pd.api.types.is_integer_dtype(sample_df[col]):
            if sample_df[col].nunique() < 100:
                # 如果某一列数值类型小于100,则认为是分类变量
                # 情况 1:配置为 categorical (类别型)
                feature_cols.append({"name": col, "active": True, "dtype": "int", "type": "categorical"})
            else:
                # # 情况 2:配置为 numeric (数值型)
                feature_cols.append({"name": col, "active": True, "dtype": "float", "type": "numeric"})
        else:
        # 4 字符型/对象特征 (Categorical Features)
            # 推断依据:如果不满足上述所有条件(通常是字符串,如 "CITY_SHANGHAI"),则统一视为类别型。
            # 配置参数:type: "categorical", dtype: "str"。FuxiCTR 会自动对这些字符串建立词表并进行 Embedding。
            feature_cols.append({"name": col, "active": True, "dtype": "str", "type": "categorical"})
    return feature_cols

def write_config_files(paths, dataset_id, experiment_id, feature_cols):
    # 检查一下,生成新的:`dataset_config.yaml` 和 `model_config.yaml`
    os.makedirs(paths["config_dir"], exist_ok=True)
    dataset_config = {dataset_id: {"dataset_id": dataset_id, "data_root": paths["data_root"], "data_format": "csv", "train_data": paths["train_csv"], "valid_data": paths["valid_csv"], "test_data": paths["predict_csv"], "feature_cols": feature_cols, "label_col": {"name": "label", "dtype": "int"}}}
    model_config = {experiment_id: {"model": "DeepFM", "model_id": experiment_id, "dataset_id": dataset_id, "task": "binary_classification", "loss": "binary_crossentropy", "metrics": ["AUC", "logloss"], "optimizer": "adam", "learning_rate": 1e-3, "embedding_dim": 8, "hidden_units": [64, 32], "batch_size": 128, "epochs": 2, "shuffle": True, "seed": 2026, "gpu": -1, "verbose": 1, "num_workers": 0, "model_root": paths["model_root"], "save_best_only": True, "monitor": "AUC"}}
    with open(os.path.join(paths["config_dir"], "dataset_config.yaml"), "w", encoding="utf-8") as f:
        yaml.safe_dump(dataset_config, f, allow_unicode=True, sort_keys=False)
    with open(os.path.join(paths["config_dir"], "model_config.yaml"), "w", encoding="utf-8") as f:
        yaml.safe_dump(model_config, f, allow_unicode=True, sort_keys=False)


# 1. 基础推断
feature_cols = infer_feature_cols(paths['train_csv'])

# 2.自己微调一下,修改中的业务逻辑循环
for f in feature_cols:
    # 1. 核心 ID 类特征:强制设为类别型 (Categorical)
    # 商品 ID 即使是数字,也必须走 Embedding 以捕捉其独特的个性化特征
    if f['name'] == "item_encoded":
        f['type'] = 'categorical'
        f['dtype'] = 'int' # 原始数据为整数索引

    # 2. 字符串类 ID:如 member_code
    if f['name'] == "member_code":
        f['type'] = 'categorical'
        f['dtype'] = 'str' # 明确告诉框架按字符串处理,自动建立 Vocab

    # 3. 时间维度与池化 ID:pool_ds 或日期 ID
    # 建议:如果不需要模型去拟合时间趋势,设为类别型(Categorical)效果更稳健
    if f['name'] in ["pool_ds", "member_id"]:
        f['type'] = 'categorical'

    # 4. 连续数值特征:自动注入归一化器
    # 工业界 CTR 模型对数值极其敏感,未归一化的特征会导致模型无法收敛
    if f['type'] == 'numeric':
        f['normalizer'] = 'StandardScaler' # 注入均值方差归一化

# 3. 生成配置
write_config_files(paths, dataset_id=dataset_id, experiment_id=experiment_id, feature_cols=feature_cols)

# 4.加载配置参数
params = load_config(paths["config_dir"], experiment_id)
params["epochs"] = 10
params["batch_size"] = 512


# 调整更多的参数
# params.update({
#     "epochs": 10,               # 训练 10 轮
#     "batch_size": 512,          # 每批处理 512 条
#     "learning_rate": 0.0005,    # 稍微降低学习率,让训练更平稳
#     "embedding_dim": 16,        # 增加 Embedding 维度捕捉更多信息
#     "hidden_units": [128, 64],  # 加深神经网络
#     "net_dropout": 0.2,         # 增加抗过拟合能力
#     "save_best_only": True      # 只留效果最好的模型
# })
当你完成上述配置并执行 build_dataset 后,框架会生成 feature_map.json。确认格式是否正确的最快方法就是打开这个 JSON 文件:
- 如果看到
member_id的type是categorical且vocab_size很大,说明 Embedding 层已正确就绪。 - 如果
numeric特征下出现了mean和std统计量,说明归一化协议已生效。
三、 代码实战:在 FuxiCTR 中使用 DeepFM
为了让开发者能够快速上手,FuxiCTR 在 demo 目录下提供了多个实战案例。以下我们将以 example4_DeepFM_with_csv_input.py 为例,详细解读如何从零开始训练一个 DeepFM 模型。
1. 完整代码示例
import os
import logging
from fuxictr.utils import load_config, set_logger, print_to_json
from fuxictr.features import FeatureMap
from fuxictr.pytorch.torch_utils import seed_everything
from fuxictr.pytorch.dataloaders import RankDataLoader
from fuxictr.preprocess import FeatureProcessor, build_dataset
from model_zoo import DeepFM

if __name__ == '__main__':
    # 1. 加载配置参数
    # config_dir 指向存放 dataset_config.yaml 和 model_config.yaml 的目录
    config_dir = './config/example4_config'
    experiment_id = 'DeepFM_test_csv'
    params = load_config(config_dir, experiment_id)

    # 2. 设置日志与随机种子,确保实验可复现
    set_logger(params)
    seed_everything(seed=params['seed'])

    # 3. 初始化特征处理器 (FeatureProcessor)
    # 它会读取配置中的 feature_cols 定义,确定每一列的预处理方式
    feature_encoder = FeatureProcessor(feature_cols=params["feature_cols"],
                                       label_col=params["label_col"],
                                       dataset_id=params["dataset_id"],
                                       data_root=params["data_root"])

    # 4. 构建数据集 (build_dataset)
    # 将原始 CSV 文件转换为高效的 .npz 格式,并返回处理后的文件路径
    params["train_data"], params["valid_data"], params["test_data"] = \
        build_dataset(feature_encoder,
                      train_data=params["train_data"],
                      valid_data=params["valid_data"],
                      test_data=params["test_data"])

    # 5. 加载 FeatureMap
    # FeatureMap 存储了特征词典大小、维度、预处理统计值等核心元数据
    data_dir = os.path.join(params['data_root'], params['dataset_id'])
    feature_map = FeatureMap(params['dataset_id'], data_dir)
    feature_map.load(os.path.join(data_dir, "feature_map.json"), params)

    # 6. 构造数据生成器 (RankDataLoader)
    # 使用迭代器模式加载数据,支持大规模数据下的内存优化
    train_gen, valid_gen = RankDataLoader(feature_map,
                                          stage='train',
                                          train_data=params['train_data'],
                                          valid_data=params['valid_data'],
                                          batch_size=params['batch_size'],
                                          data_format=params["data_format"],
                                          shuffle=params['shuffle']).make_iterator()

    # 7. 模型初始化、训练与评估
    model = DeepFM(feature_map, **params)
    model.fit(train_gen, validation_data=valid_gen, epochs=params['epochs'])

    # 验证集与测试集评估
    model.evaluate(valid_gen)
    test_gen = RankDataLoader(feature_map, stage='test', ...).make_iterator() # 省略部分参数
    model.evaluate(test_gen)
2. 针对超大规模数据集:Parquet 离线预处理模式
当数据集规模达到 TB 级别时,在训练脚本中实时进行 build_dataset 会导致严重的显存/内存波动,甚至导致 CPU 瓶颈。此时,**“预处理与训练分离”**是工业界的标准做法:先将数据转换为 Parquet 格式并持久化,后续训练时直接读取。
第一步:离线生成 Parquet 数据集
参考 demo/example1_build_dataset_to_parquet.py,其核心目标是生成 feature_map.json 和对应的 .parquet 文件。
from fuxictr.preprocess import FeatureProcessor, build_dataset
from fuxictr.utils import load_dataset_config

# 1. 加载数据集配置
config_dir = './config/large_scale_config'
dataset_id = 'user_behavior_60d'
params = load_dataset_config(config_dir, dataset_id)

# 2. 初始化 FeatureProcessor
feature_encoder = FeatureProcessor(feature_cols=params["feature_cols"],
                                   label_col=params["label_col"],
                                   dataset_id=dataset_id,
                                   data_root=params["data_root"])

# 3. 执行持久化转换
# 这将生成 parquet 文件,极大降低后续训练的 IO 压力
build_dataset(feature_encoder,
              train_data=params["train_data"],
              valid_data=params["valid_data"],
              test_data=params["test_data"])
第二步:基于 Parquet 进行高效训练
参考 demo/example2_DeepFM_with_parquet_input.py,此时无需再定义 FeatureProcessor,直接加载预处理产物。
from fuxictr.features import FeatureMap
from fuxictr.pytorch.dataloaders import RankDataLoader
from model_zoo import DeepFM

# 1. 直接加载已经生成的 FeatureMap
data_dir = os.path.join(params['data_root'], params['dataset_id'])
feature_map = FeatureMap(params['dataset_id'], data_dir)
feature_map.load(os.path.join(data_dir, "feature_map.json"), params)

# 2. 构造支持 Parquet 格式的 DataLoader
# 注意:data_format 需设为 'parquet'
train_gen, valid_gen = RankDataLoader(feature_map,
                                      stage='train',
                                      train_data=params['train_data'],
                                      valid_data=params['valid_data'],
                                      batch_size=params['batch_size'],
                                      data_format='parquet',
                                      shuffle=True).make_iterator()

# 3. 极速启动训练
model = DeepFM(feature_map, **params)
model.fit(train_gen, validation_data=valid_gen, epochs=params['epochs'])
为什么这种模式更高效?
- 避免重复计算:特征映射、Vocab 统计、标准化参数计算只需执行一次。
- 随机读取优化:Parquet 格式配合 FuxiCTR 的
RankDataLoader支持真正的列式切片读取,内存占用极低。 - 实验并行化:同一份预处理好的 Parquet 数据可以同时供给多个不同的模型实验(如 DeepFM vs DIN),极大提升了炼丹效率。
3. 关键环节深度解读
-
load_config与experiment_id:
FuxiCTR 采用配置驱动。experiment_id对应 YAML 文件中的一个特定实验项。通过这种方式,你可以在同一个配置文件中管理数十组不同参数的对照实验,而无需修改 Python 代码。 -
FeatureProcessor的角色:
它是 FuxiCTR 的"大脑"。它不仅仅是做类型转换,更重要的是它会根据categorical类型的列自动构建全局词典(Vocabulary),并根据numeric类型的列计算标准化参数(均值、方差)。这些统计信息会被持久化,确保推断(Inference)阶段使用相同的基准。 -
从 CSV 到
build_dataset:
在深度学习中,频繁读取 CSV 的 IO 开销非常大。build_dataset会将数据重写为压缩的二进制格式(如.npz或.parquet),极大地提升了训练时的 IO 吞吐量。 -
FeatureMap与标准化特征加工的一致性:
feature_map.json不仅仅是一份元数据,它本质上是一个标准的特征加工协议。在工业级场景中,这一步至关重要:- "记忆"功能:一旦在训练阶段通过
FeatureProcessor建立了特征映射标准,所有的词典(Vocab)、归一化参数(Numeric Mean/Std)都会被锁定。 - 推断一致性:后续在执行
model.predict或在线推断时,系统会直接加载该文件。即使面对全新的原始数据,系统也会强制按照训练集建立的"标准模式"进行加工。 - 规避偏差:这彻底规避了"同样的 ID 在训练和推测时映射不一致"或"数值缩放标准不统一"导致的训练推断偏差(Training-Serving Skew),确保了模型在生产环境下的预测结果与实验表现高度一致。
- "记忆"功能:一旦在训练阶段通过
-
RankDataLoader的流式加载:
对于 TB 级的数据,无法一次性读入内存。RankDataLoader配合make_iterator()实现了分批次(Batch)读取,结合 Python 的多进程数据预取(Prefetch),保证了 GPU 的利用率。
四、 深度排障
4.1 为何"用户ID"字段误设为数值型会导致 AUC 0.5?
在笔者实战中,遇到一个问题,
最令人困惑的异常是模型能够正常运行,但是 Loss 非常高,而且 验证集 AUC 死死卡在 0.5。
1. 诊断路径:三步排查法
- 标签校验:检查 Label 是否存在数据偏差或泄露。
- 梯度与数值稳定性:检查 Loss 是否变为
NaN,确认是否存在梯度爆炸。 - 基准对照(Baseline):运行简单的线性模型(如 LR)。若 LR 有效而 DeepFM 0.5,则指向特征工程或配置错误。笔者在这个步骤里面看到LR模型在笔者的数据集中,AUC正常保持在70%多,那说明trainset数据集没有啥问题,大概定位是特征加工的时候出现了问题
2. 根因剖析:ID 类特征的类型塌陷(Type Collapse)
笔者实战中有一个用户ID,member_id字段,该字段是一串随机数字,例如 1001, 1002, 1003…。
在我们的案例中,高基数的 member_id 被错误识别为 numeric 类型,这不仅是一个配置失误,更是对底层数学逻辑的严重违背。以下是深度解析原因:
(1) 物理意义的完全错位
- 类别型(正确方式):模型认为
member_id是一个**“标签(Label)”**。每个 ID(如 1001, 1002)都是独立的个体。通过 Embedding,模型会为每个用户学习一个专属的“特征向量”,从而精准捕捉该用户的偏好(例如:用户 A 偏好电子产品,用户 B 偏好运动鞋)。 - 数值型(错误方式):模型认为
member_id是一个**“连续的度量值”**(类似身高、体重或价格)。- 模型会尝试学习: 预测概率 = 权重 w ⋅ member_id + 偏置 b \text{预测概率} = \text{权重 } w \cdot \text{member\_id} + \text{偏置 } b 预测概率=权重 w⋅member_id+偏置 b。
- 荒谬之处:这意味着模型会认为 ID 为 2000 的用户在某种属性上是 ID 为 1000 的用户的 2 倍。实际上,ID 的大小仅是数据库生成的随机数字,并不代表任何倍数关系或程度。
(2) 模型无法学习“个性”
- 数值型的局限:当 ID 设为数值型时,无论你有 100 万个用户还是 1000 万个用户,模型只给这个特征分配了 1 个参数(权重 w w w)。这 1 个参数根本无法承载数百万用户各不相同的兴趣特征。
- 类别型的优势:设为类别型后,模型通过 Embedding 层分配了
用户总数 × Embedding 维度个参数。这让模型拥有了足够的“记忆容量”来刻画每一个用户的特定行为模式。
(3) 数据噪声与梯度爆炸
- 数值规模问题:
member_id通常是极大的整数(如89273641)。如果直接作为数值输入,这个巨大的值与模型权重相乘会产生海量的激活值,直接导致梯度爆炸,使模型参数更新陷入紊乱。 - 无效的归一化:即使执行了标准化(StandardScaler),由于 ID 本身是无序的随机分布,归一化后的数值对模型而言依然是毫无规律的**“纯噪声”**。模型在噪声中反复横跳,最终只能退化为随机猜测,导致 AUC 锁定在 0.5。
3. 防御性代码实现
在 infer_feature_cols 函数中,应加入显式的特征保护逻辑:
def infer_feature_cols(train_csv):
    # 扫描数据列名,对潜在的 ID 类列执行强制转换
    for col in feature_cols:
        if any(kw in col['name'].lower() for kw in ['id', 'code', 'uuid']):
            col['type'] = 'categorical'
            col['dtype'] = 'str' # 强制转字符串,确保进入词表处理
4.2 FuxiCTR 开源库的“瑕疵”
FuxiCTR 虽然功能强大,但在代码健壮性上仍带有较为明显的“实验室产品”特征。笔者在实战中发现了一个极其隐蔽的坑:Parquet 转换的无声失败。
1. 现象:转换失败却不报错
在调用 build_dataset 时,如果你设置了 data_block_size > 0(开启多进程分块转换),FuxiCTR 内部会使用 multiprocessing.Pool.apply_async 来执行转换任务。
问题在于:如果子进程在执行 to_parquet 时因为磁盘空间不足、权限问题或路径不存在而崩溃,主进程由于没有对异步结果进行 get() 校验,往往会“无视”这些错误,继续向下运行并打印 Transform csv data to parquet done.。
2. 产生的后果
- 训练空跑:返回的
train_data路径可能根本没有生成文件,导致后续DataLoader读取时抛出异常,或者更糟糕的是—— - 训练了旧数据:如果你多次运行实验,框架可能会默认加载上一次残留在目录里的旧 Parquet 文件,导致你的参数调整完全没有生效,而你却浑然不知。
3. 避坑指南:如何绕过这个陷阱?
为了确保实验的严谨性,建议采取以下防御性措施:
- 手动核验文件:在
build_dataset调用后,增加一行显式的检查逻辑,确认目标目录下确实存在.parquet文件且文件大小非零。 - 关闭分块(小规模数据):如果数据量不是千万级,建议将
data_block_size设为0。这样转换逻辑会在主进程中同步执行,一旦报错会立即中断程序,方便快速定位问题。 - 清理脏数据:在每次重新生成数据集前,手动执行
shutil.rmtree(data_dir),确保不会读取到历史残留的错误数据。 - 关注日志细节:虽然程序不会崩溃,但子进程的错误信息有时会混在控制台日志中,养成扫一眼日志输出(是否有
写入 parquet 失败的字样)的好习惯。
五、 总结:通往高精度 CTR 预估之路
CTR 预估不仅是算法的博弈,更是对数据物理意义的精准还原。FuxiCTR 凭借其可配置、可调优、可复现的特性,以及支持全球顶尖大厂(华为、谷歌、阿里、腾讯等)数十种经典模型的 Model Zoo,为从业者提供了极其强大的工业级武器。
在实践中,请务必记住:特征类型是模型的"灵魂"。只有正确地将离散 ID 映射为 Embedding 空间,才能让 AI 真正"读懂"用户的个性化偏好。
更多推荐



 13
 0
- 0


 已为社区贡献11条内容

所有评论(0)