
SNN(TTFS)论文阅读——High-performance deep spiking neural networks with 0.3 spikes per neuron(上)
High-performance deep spiking neural networks with 0.3 spikes per neuron
TTFS编码的SNN与ReLU转换
-
编码公式
tj(0)=tmax(0)−τcxj(0) t_{j}^{(0)} = t_{\text{max}}^{(0)} - \tau_{c} x_{j}^{(0)} tj(0)=tmax(0)−τcxj(0)- xj(0)∈[0,1]x_j^{(0)} \in [0,1]xj(0)∈[0,1]:归一化的像素强度(0最暗,1最亮)
- tmax(0)t_{\text{max}}^{(0)}tmax(0):输入层允许的最晚发放时间
- τc\tau_cτc:时间转换参数(将无量纲输入转换为时间单位)
- tj(0)t_j^{(0)}tj(0):第j个输入神经元的脉冲时间
- 当 xj(0)=1x_j^{(0)} = 1xj(0)=1(最亮像素):tj(0)=tmax(0)−τct_j^{(0)} = t_{\text{max}}^{(0)} - \tau_ctj(0)=tmax(0)−τc → 最早发放
- 当 xj(0)=0x_j^{(0)} = 0xj(0)=0(最暗像素):tj(0)=tmax(0)t_j^{(0)} = t_{\text{max}}^{(0)}tj(0)=tmax(0) → 最晚发放(或按论文说明:不发放)
-
双区段神经元模型
-
微分方程(公式1)
τcdVi(n)dt={Ai(n)+∑jWij(n)H(t−tj(n−1))for t<tmin(n)Bi(n)for tmin(n)≤t≤tmax(n) \tau_{c} \frac{\mathrm{d} V_{i}^{(n)}}{\mathrm{d} t} = \begin{cases} A_{i}^{(n)} + \sum_{j} W_{ij}^{(n)} H(t-t_j^{(n-1)}) & \text{for } t < t_{\min}^{(n)} \\ B_{i}^{(n)} & \text{for } t_{\min}^{(n)} \leq t \leq t_{\max}^{(n)} \end{cases} τcdtdVi(n)={Ai(n)+∑jWij(n)H(t−tj(n−1))Bi(n)for t<tmin(n)for tmin(n)≤t≤tmax(n)
分阶段详细推导阶段一:异步累积期 (t<tmin(n)t < t_{\min}^{(n)}t<tmin(n))
方程:
τcdVi(n)dt=Ai(n)+∑jWij(n)H(t−tj(n−1)) \tau_c \frac{dV_i^{(n)}}{dt} = A_i^{(n)} + \sum_j W_{ij}^{(n)} H(t-t_j^{(n-1)}) τcdtdVi(n)=Ai(n)+j∑Wij(n)H(t−tj(n−1))
Heaviside函数的作用:
H(t−tj)={0if t<tj1if t≥tj H(t-t_j) = \begin{cases} 0 & \text{if } t < t_j \\ 1 & \text{if } t \geq t_j \end{cases} H(t−tj)={01if t<tjif t≥tj
物理过程:- 初始状态:膜电位变化率 = Ai(n)/τcA_i^{(n)}/\tau_cAi(n)/τc
- 脉冲到达时:当输入脉冲在 tjt_jtj 时刻到达,变化率瞬间增加 Wij(n)/τcW_{ij}^{(n)}/\tau_cWij(n)/τc
- 累积效应:膜电位变化率随时间不断调整,反映输入脉冲的异步到达
数学推导:
对时间积分可得膜电位:
Vi(n)(t)=1τc[Ai(n)t+∑jWij(n)(t−tj(n−1))H(t−tj(n−1))] V_i^{(n)}(t) = \frac{1}{\tau_c} \left[ A_i^{(n)}t + \sum_j W_{ij}^{(n)} (t - t_j^{(n-1)}) H(t-t_j^{(n-1)}) \right] Vi(n)(t)=τc1[Ai(n)t+j∑Wij(n)(t−tj(n−1))H(t−tj(n−1))]
阶段二:线性冲刺期 (tmin(n)≤t≤tmax(n)t_{\min}^{(n)} \leq t \leq t_{\max}^{(n)}tmin(n)≤t≤tmax(n))方程:
τcdVi(n)dt=Bi(n) \tau_c \frac{dV_i^{(n)}}{dt} = B_i^{(n)} τcdtdVi(n)=Bi(n)
物理意义:
在 t=tmin(n)t = t_{\min}^{(n)}t=tmin(n) 时刻,无论当前膜电位是多少,变化率强制切换为固定值 Bi(n)/τcB_i^{(n)}/\tau_cBi(n)/τc数学推导:
Vi(n)(t)=Vi(n)(tmin(n))+Bi(n)τc(t−tmin(n)) V_i^{(n)}(t) = V_i^{(n)}(t_{\min}^{(n)}) + \frac{B_i^{(n)}}{\tau_c} (t - t_{\min}^{(n)}) Vi(n)(t)=Vi(n)(tmin(n))+τcBi(n)(t−tmin(n))
这是一个纯线性增长过程。 -
时间边界的设计
递归定义
tmin(n)=deftmax(n−1) t_{\min}^{(n)} \stackrel{\text{def}}{=} t_{\max}^{(n-1)} tmin(n)=deftmax(n−1)- 第n层只能在第n-1层处理完成后开始计算
-
阈值定义
ϑi(n)=ϑ~i(n)−Di(n) \vartheta_i^{(n)} = \widetilde{\vartheta}_i^{(n)} - D_i^{(n)} ϑi(n)=ϑi(n)−Di(n)
其中 Di(n)D_i^{(n)}Di(n) 是可训练参数,提供灵活性。 -
发放时间计算
发放时间 ti(n)t_i^{(n)}ti(n) 是满足以下条件的解:
Vi(n)(t)=ϑi(n)且tmin(n)≤t≤tmax(n) V_i^{(n)}(t) = \vartheta_i^{(n)} \quad \text{且} \quad t_{\min}^{(n)} \leq t \leq t_{\max}^{(n)} Vi(n)(t)=ϑi(n)且tmin(n)≤t≤tmax(n)
由于第二阶段是线性的,可以解析求解:
ti(n)=tmin(n)+τcBi(n)[ϑi(n)−Vi(n)(tmin(n))] t_i^{(n)} = t_{\min}^{(n)} + \frac{\tau_c}{B_i^{(n)}} \left[ \vartheta_i^{(n)} - V_i^{(n)}(t_{\min}^{(n)}) \right] ti(n)=tmin(n)+Bi(n)τc[ϑi(n)−Vi(n)(tmin(n))]
-
-
建立SNN与ReLU的映射关系
-
简化:
- 设 Ai(n)=0A_i^{(n)} = 0Ai(n)=0(简化第一阶段动力学)
- 但保持 Bi(n)B_i^{(n)}Bi(n) 为任意值(保持模型通用性)
这样第一阶段方程变为:
τcdVi(n)dt=∑jWij(n)H(t−tj(n−1))for t<tmin(n) \tau_c \frac{dV_i^{(n)}}{dt} = \sum_j W_{ij}^{(n)} H(t-t_j^{(n-1)}) \quad \text{for } t < t_{\min}^{(n)} τcdtdVi(n)=j∑Wij(n)H(t−tj(n−1))for t<tmin(n) -
定义变量:
xi(n)=tmax(n)−ti(n)τc x_i^{(n)} = \frac{t_{\max}^{(n)} - t_i^{(n)}}{\tau_c} xi(n)=τctmax(n)−ti(n)- ti(n)t_i^{(n)}ti(n):第n层神经元i的脉冲时间
- tmax(n)−ti(n)t_{\max}^{(n)} - t_i^{(n)}tmax(n)−ti(n):距离截止时间的剩余时间
- 除以其时c:将时间转换为无量纲的"激活值"
重要性质:
- 脉冲时间越早 (ti(n)t_i^{(n)}ti(n) 越小) → xi(n)x_i^{(n)}xi(n) 越大
- 不发放脉冲 (ti(n)t_i^{(n)}ti(n) 不存在) → xi(n)=0x_i^{(n)} = 0xi(n)=0
-
阶段二膜电位动态(关键阶段)
在 t∈[tmin(n),tmax(n)]t \in [t_{\min}^{(n)}, t_{\max}^{(n)}]t∈[tmin(n),tmax(n)] 期间:
τcdVi(n)dt=Bi(n) \tau_c \frac{dV_i^{(n)}}{dt} = B_i^{(n)} τcdtdVi(n)=Bi(n)
积分得:
Vi(n)(t)=Vi(n)(tmin(n))+Bi(n)τc(t−tmin(n))(3) V_i^{(n)}(t) = V_i^{(n)}(t_{\min}^{(n)}) + \frac{B_i^{(n)}}{\tau_c} (t - t_{\min}^{(n)}) \tag{3} Vi(n)(t)=Vi(n)(tmin(n))+τcBi(n)(t−tmin(n))(3)
发放时刻条件在 t=ti(n)t = t_i^{(n)}t=ti(n) 时,膜电位达到阈值:
Vi(n)(ti(n))=ϑi(n) V_i^{(n)}(t_i^{(n)}) = \vartheta_i^{(n)} Vi(n)(ti(n))=ϑi(n)
代入公式(3):
ϑi(n)=Vi(n)(tmin(n))+Bi(n)τc(ti(n)−tmin(n))(4) \vartheta_i^{(n)} = V_i^{(n)}(t_{\min}^{(n)}) + \frac{B_i^{(n)}}{\tau_c} (t_i^{(n)} - t_{\min}^{(n)}) \tag{4} ϑi(n)=Vi(n)(tmin(n))+τcBi(n)(ti(n)−tmin(n))(4) -
第一阶段膜电位计算
在 tmin(n)t_{\min}^{(n)}tmin(n) 时刻,膜电位来自第一阶段的累积:
Vi(n)(tmin(n))=1τc∑jWij(n)(tmin(n)−tj(n−1))H(tmin(n)−tj(n−1)) V_i^{(n)}(t_{\min}^{(n)}) = \frac{1}{\tau_c} \sum_j W_{ij}^{(n)} (t_{\min}^{(n)} - t_j^{(n-1)}) H(t_{\min}^{(n)} - t_j^{(n-1)}) Vi(n)(tmin(n))=τc1j∑Wij(n)(tmin(n)−tj(n−1))H(tmin(n)−tj(n−1))
由于 tmin(n)=tmax(n−1)t_{\min}^{(n)} = t_{\max}^{(n-1)}tmin(n)=tmax(n−1),且对于所有有效输入都有 tj(n−1)<tmin(n)t_j^{(n-1)} < t_{\min}^{(n)}tj(n−1)<tmin(n),所以Heaviside函数都为1:
Vi(n)(tmin(n))=1τc∑jWij(n)(tmin(n)−tj(n−1))(5) V_i^{(n)}(t_{\min}^{(n)}) = \frac{1}{\tau_c} \sum_j W_{ij}^{(n)} (t_{\min}^{(n)} - t_j^{(n-1)}) \tag{5} Vi(n)(tmin(n))=τc1j∑Wij(n)(tmin(n)−tj(n−1))(5) -
将公式(5)代入公式(4):
ϑi(n)=1τc∑jWij(n)(tmin(n)−tj(n−1))+Bi(n)τc(ti(n)−tmin(n)) \vartheta_i^{(n)} = \frac{1}{\tau_c} \sum_j W_{ij}^{(n)} (t_{\min}^{(n)} - t_j^{(n-1)}) + \frac{B_i^{(n)}}{\tau_c} (t_i^{(n)} - t_{\min}^{(n)}) ϑi(n)=τc1j∑Wij(n)(tmin(n)−tj(n−1))+τcBi(n)(ti(n)−tmin(n))
两边乘以 τc\tau_cτc:
τcϑi(n)=∑jWij(n)(tmin(n)−tj(n−1))+Bi(n)(ti(n)−tmin(n))(6) \tau_c \vartheta_i^{(n)} = \sum_j W_{ij}^{(n)} (t_{\min}^{(n)} - t_j^{(n-1)}) + B_i^{(n)} (t_i^{(n)} - t_{\min}^{(n)}) \tag{6} τcϑi(n)=j∑Wij(n)(tmin(n)−tj(n−1))+Bi(n)(ti(n)−tmin(n))(6)
引入ReLU激活变量:回忆定义:
- xj(n−1)=tmax(n−1)−tj(n−1)τc=tmin(n)−tj(n−1)τcx_j^{(n-1)} = \frac{t_{\max}^{(n-1)} - t_j^{(n-1)}}{\tau_c} = \frac{t_{\min}^{(n)} - t_j^{(n-1)}}{\tau_c}xj(n−1)=τctmax(n−1)−tj(n−1)=τctmin(n)−tj(n−1)
- xi(n)=tmax(n)−ti(n)τcx_i^{(n)} = \frac{t_{\max}^{(n)} - t_i^{(n)}}{\tau_c}xi(n)=τctmax(n)−ti(n)
代入公式(6):
τcϑi(n)=∑jWij(n)(τcxj(n−1))+Bi(n)[(tmax(n)−τcxi(n))−tmin(n)] \tau_c \vartheta_i^{(n)} = \sum_j W_{ij}^{(n)} (\tau_c x_j^{(n-1)}) + B_i^{(n)} [ (t_{\max}^{(n)} - \tau_c x_i^{(n)}) - t_{\min}^{(n)} ] τcϑi(n)=j∑Wij(n)(τcxj(n−1))+Bi(n)[(tmax(n)−τcxi(n))−tmin(n)]
整理:
τcϑi(n)=τc∑jWij(n)xj(n−1)+Bi(n)(tmax(n)−tmin(n))−Bi(n)τcxi(n) \tau_c \vartheta_i^{(n)} = \tau_c \sum_j W_{ij}^{(n)} x_j^{(n-1)} + B_i^{(n)} (t_{\max}^{(n)} - t_{\min}^{(n)}) - B_i^{(n)} \tau_c x_i^{(n)} τcϑi(n)=τcj∑Wij(n)xj(n−1)+Bi(n)(tmax(n)−tmin(n))−Bi(n)τcxi(n)
得到ReLU形式的方程:重新排列项:
Bi(n)τcxi(n)=τc∑jWij(n)xj(n−1)+Bi(n)(tmax(n)−tmin(n))−τcϑi(n) B_i^{(n)} \tau_c x_i^{(n)} = \tau_c \sum_j W_{ij}^{(n)} x_j^{(n-1)} + B_i^{(n)} (t_{\max}^{(n)} - t_{\min}^{(n)}) - \tau_c \vartheta_i^{(n)} Bi(n)τcxi(n)=τcj∑Wij(n)xj(n−1)+Bi(n)(tmax(n)−tmin(n))−τcϑi(n)
两边除以 Bi(n)τcB_i^{(n)} \tau_cBi(n)τc:
xi(n)=∑jWij(n)Bi(n)xj(n−1)+tmax(n)−tmin(n)τc−ϑi(n)Bi(n)(7) x_i^{(n)} = \sum_j \frac{W_{ij}^{(n)}}{B_i^{(n)}} x_j^{(n-1)} + \frac{t_{\max}^{(n)} - t_{\min}^{(n)}}{\tau_c} - \frac{\vartheta_i^{(n)}}{B_i^{(n)}} \tag{7} xi(n)=j∑Bi(n)Wij(n)xj(n−1)+τctmax(n)−tmin(n)−Bi(n)ϑi(n)(7) -
映射公式的最终形式
公式(7)正好是ReLU网络的前向传播公式:
xi(n)=∑jwij(n)xj(n−1)+bi(n) x_i^{(n)} = \sum_j w_{ij}^{(n)} x_j^{(n-1)} + b_i^{(n)} xi(n)=j∑wij(n)xj(n−1)+bi(n)
其中:- ReLU权重: wij(n)=Wij(n)Bi(n)w_{ij}^{(n)} = \frac{W_{ij}^{(n)}}{B_i^{(n)}}wij(n)=Bi(n)Wij(n)
- ReLU偏置: bi(n)=tmax(n)−tmin(n)τc−ϑi(n)Bi(n)b_i^{(n)} = \frac{t_{\max}^{(n)} - t_{\min}^{(n)}}{\tau_c} - \frac{\vartheta_i^{(n)}}{B_i^{(n)}}bi(n)=τctmax(n)−tmin(n)−Bi(n)ϑi(n)
这正是论文中的公式(2)
-
输出层的特殊处理
对于输出层 N+1N+1N+1(不发放脉冲):
- 允许 Ai(N+1)≠0A_i^{(N+1)} \neq 0Ai(N+1)=0
- 映射公式简化为: wij(N+1)=Wij(N+1)w_{ij}^{(N+1)} = W_{ij}^{(N+1)}wij(N+1)=Wij(N+1)
- 偏置: bi(N+1)=(tmax(N)−tmin(N))Ai(N+1)b_i^{(N+1)} = (t_{\max}^{(N)} - t_{\min}^{(N)}) A_i^{(N+1)}bi(N+1)=(tmax(N)−tmin(N))Ai(N+1)
-
-
梯度消失/爆炸问题
-
链式法则分解(公式3)
dLdW(n)=dLdV(N+1)⋅dV(N+1)dt(N)⋅dt(N)dt(N−1)⋯dt(n+1)dt(n)⋅dt(n)dW(n) \frac{\mathrm{d} \mathcal{L}}{\mathrm{d} W^{(n)}} = \frac{\mathrm{d} \mathcal{L}}{\mathrm{d} V^{(N+1)}} \cdot \frac{\mathrm{d} V^{(N+1)}}{\mathrm{d} t^{(N)}} \cdot \frac{\mathrm{d} t^{(N)}}{\mathrm{d} t^{(N-1)}} \cdots \frac{\mathrm{d} t^{(n+1)}}{\mathrm{d} t^{(n)}} \cdot \frac{\mathrm{d} t^{(n)}}{\mathrm{d} W^{(n)}} dW(n)dL=dV(N+1)dL⋅dt(N)dV(N+1)⋅dt(N−1)dt(N)⋯dt(n)dt(n+1)⋅dW(n)dt(n)
梯度可以看作多个雅可比矩阵的连乘:
梯度∝J(N)⋅J(N−1)⋯J(n+1)⋅J(n) \text{梯度} \propto J^{(N)} \cdot J^{(N-1)} \cdots J^{(n+1)} \cdot J^{(n)} 梯度∝J(N)⋅J(N−1)⋯J(n+1)⋅J(n)
其中 J(k)=dt(k)dt(k−1)J^{(k)} = \frac{\mathrm{d} t^{(k)}}{\mathrm{d} t^{(k-1)}}J(k)=dt(k−1)dt(k) 是层间脉冲时间的雅可比矩阵。 -
雅可比矩阵的解析推导(公式4)
核心结果:
dt(n)dt(n−1)=M(n−1)⋅1B(n)⋅W(n)=M(n−1)w(n) \frac{\mathrm{d} t^{(n)}}{\mathrm{d} t^{(n-1)}} = M^{(n-1)} \cdot \frac{1}{B^{(n)}} \cdot W^{(n)} = M^{(n-1)} w^{(n)} dt(n−1)dt(n)=M(n−1)⋅B(n)1⋅W(n)=M(n−1)w(n)
详细推导过程:步骤1:回顾脉冲时间关系
从之前的推导我们知道,对于发放的神经元:
ti(n)=tmin(n)+τcBi(n)[ϑi(n)−Vi(n)(tmin(n))] t_i^{(n)} = t_{\min}^{(n)} + \frac{\tau_c}{B_i^{(n)}} \left[ \vartheta_i^{(n)} - V_i^{(n)}(t_{\min}^{(n)}) \right] ti(n)=tmin(n)+Bi(n)τc[ϑi(n)−Vi(n)(tmin(n))]
而 Vi(n)(tmin(n))=1τc∑jWij(n)(tmin(n)−tj(n−1))V_i^{(n)}(t_{\min}^{(n)}) = \frac{1}{\tau_c} \sum_j W_{ij}^{(n)} (t_{\min}^{(n)} - t_j^{(n-1)})Vi(n)(tmin(n))=τc1∑jWij(n)(tmin(n)−tj(n−1))步骤2:计算偏导数
对 tk(n−1)t_k^{(n-1)}tk(n−1) 求偏导:
∂ti(n)∂tk(n−1)=−τcBi(n)⋅∂Vi(n)(tmin(n))∂tk(n−1)⋅1τc \frac{\partial t_i^{(n)}}{\partial t_k^{(n-1)}} = -\frac{\tau_c}{B_i^{(n)}} \cdot \frac{\partial V_i^{(n)}(t_{\min}^{(n)})}{\partial t_k^{(n-1)}} \cdot \frac{1}{\tau_c} ∂tk(n−1)∂ti(n)=−Bi(n)τc⋅∂tk(n−1)∂Vi(n)(tmin(n))⋅τc1
由于 ∂Vi(n)(tmin(n))∂tk(n−1)=−Wik(n)\frac{\partial V_i^{(n)}(t_{\min}^{(n)})}{\partial t_k^{(n-1)}} = -W_{ik}^{(n)}∂tk(n−1)∂Vi(n)(tmin(n))=−Wik(n)(当 tk(n−1)<tmin(n)t_k^{(n-1)} < t_{\min}^{(n)}tk(n−1)<tmin(n) 时)所以:
∂ti(n)∂tk(n−1)=Wik(n)Bi(n) \frac{\partial t_i^{(n)}}{\partial t_k^{(n-1)}} = \frac{W_{ik}^{(n)}}{B_i^{(n)}} ∂tk(n−1)∂ti(n)=Bi(n)Wik(n)
步骤3:引入掩码矩阵 M(n−1)M^{(n-1)}M(n−1)定义对角掩码矩阵:
Mij(n−1)=δijH(tmax(n−1)−ti(n−1)) M_{ij}^{(n-1)} = \delta_{ij} H(t_{\max}^{(n-1)} - t_i^{(n-1)}) Mij(n−1)=δijH(tmax(n−1)−ti(n−1))
意义:- 如果神经元 jjj 在 tmax(n−1)t_{\max}^{(n-1)}tmax(n−1) 之前发放 → Mjj(n−1)=1M_{jj}^{(n-1)} = 1Mjj(n−1)=1
- 如果神经元 jjj 不发放 → Mjj(n−1)=0M_{jj}^{(n-1)} = 0Mjj(n−1)=0
步骤4:完整的雅可比矩阵
dt(n)dt(n−1)=M(n−1)⋅1B(n)⋅W(n) \frac{\mathrm{d} t^{(n)}}{\mathrm{d} t^{(n-1)}} = M^{(n-1)} \cdot \frac{1}{B^{(n)}} \cdot W^{(n)} dt(n−1)dt(n)=M(n−1)⋅B(n)1⋅W(n)
其中 1B(n)\frac{1}{B^{(n)}}B(n)1 是对角矩阵,元素为 1/Bi(n)1/B_i^{(n)}1/Bi(n)。 -
与ReLU网络的类比
-
在ReLU网络中,前向传播为:
x(n)=ReLU(W(n)x(n−1)+b(n)) x^{(n)} = \text{ReLU}(W^{(n)} x^{(n-1)} + b^{(n)}) x(n)=ReLU(W(n)x(n−1)+b(n))
雅可比矩阵为:
dx(n)dx(n−1)=D(n)W(n) \frac{\mathrm{d} x^{(n)}}{\mathrm{d} x^{(n-1)}} = D^{(n)} W^{(n)} dx(n−1)dx(n)=D(n)W(n)
其中 D(n)D^{(n)}D(n) 是对角矩阵,元素为ReLU的导数(0或1)。 -
在TTFS网络中:
- M(n−1)M^{(n-1)}M(n−1) 对应 D(n)D^{(n)}D(n)(活性掩码)
- 1B(n)W(n)\frac{1}{B^{(n)}} W^{(n)}B(n)1W(n) 对应 W(n)W^{(n)}W(n)(权重矩阵)
-
特征值分析
梯度的大小取决于雅可比矩阵连乘的谱半径(最大特征值的模):
梯度幅度∝∏k=nNρ(J(k)) \text{梯度幅度} \propto \prod_{k=n}^N \rho(J^{(k)}) 梯度幅度∝k=n∏Nρ(J(k))
其中 ρ(J(k))\rho(J^{(k)})ρ(J(k)) 是第k层雅可比矩阵的谱半径。 -
在标准ReLU网络中,主要关注权重矩阵 W(n)W^{(n)}W(n) 的特征值。
但在TTFS网络中,雅可比矩阵为:
J(n)=M(n−1)⋅1B(n)⋅W(n) J^{(n)} = M^{(n-1)} \cdot \frac{1}{B^{(n)}} \cdot W^{(n)} J(n)=M(n−1)⋅B(n)1⋅W(n)
关键问题:特征值受到 1B(n)\frac{1}{B^{(n)}}B(n)1 的强烈影响!假设 W(n)W^{(n)}W(n) 的特征值为 λW\lambda_WλW,那么 J(n)J^{(n)}J(n) 的特征值大约为:
λJ≈λWβ \lambda_J \approx \frac{\lambda_W}{\beta} λJ≈βλW
其中 β\betaβ 是 B(n)B^{(n)}B(n) 的典型值。 -
梯度问题的具体表现
梯度爆炸条件
如果 ∣λW∣>∣β∣|\lambda_W| > |\beta|∣λW∣>∣β∣(即权重特征值大于B参数),则:
∣λJ∣>1⇒∏k∣λJ(k)∣→∞(梯度爆炸) |\lambda_J| > 1 \Rightarrow \prod_{k} |\lambda_J^{(k)}| \to \infty \quad \text{(梯度爆炸)} ∣λJ∣>1⇒k∏∣λJ(k)∣→∞(梯度爆炸)
梯度消失条件如果 ∣λW∣<∣β∣|\lambda_W| < |\beta|∣λW∣<∣β∣(即权重特征值小于B参数),则:
∣λJ∣<1⇒∏k∣λJ(k)∣→0(梯度消失) |\lambda_J| < 1 \Rightarrow \prod_{k} |\lambda_J^{(k)}| \to 0 \quad \text{(梯度消失)} ∣λJ∣<1⇒k∏∣λJ(k)∣→0(梯度消失) -
ReLU网络的标准解决方案
通过精心设计权重初始化(如He初始化、Xavier初始化),确保 ρ(W(n))≈1\rho(W^{(n)}) \approx 1ρ(W(n))≈1。
-
TTFS网络的额外挑战
即使精心初始化 W(n)W^{(n)}W(n),还需要同时控制 B(n)B^{(n)}B(n) 使得:
ρ(W(n)B(n))≈1 \rho\left( \frac{W^{(n)}}{B^{(n)}} \right) \approx 1 ρ(B(n)W(n))≈1
这引入了额外的自由度和复杂性。
-
-
-
方案二:B1-模型 + 恒等映射(Identity Mapping)
-
核心思想:
设置 Bi(n)=1B_i^{(n)} = 1Bi(n)=1,则:
w(n)=W(n) w^{(n)} = W^{(n)} w(n)=W(n) -
对于B1-模型:
J(n)=M(n−1)⋅11⋅W(n)=M(n−1)W(n) J^{(n)} = M^{(n-1)} \cdot \frac{1}{1} \cdot W^{(n)} = M^{(n-1)} W^{(n)} J(n)=M(n−1)⋅11⋅W(n)=M(n−1)W(n)
这与标准ReLU网络的雅可比矩阵:
JReLU(n)=D(n)W(n) J_{\text{ReLU}}^{(n)} = D^{(n)} W^{(n)} JReLU(n)=D(n)W(n)
(其中 D(n)D^{(n)}D(n) 是ReLU导数掩码)具有相同的特征值分布。
-
-
如何设置时间边界和基础阈值(初始化阶段)
-
在深度TTFS网络中,需要为每一层设置合理的时间窗口 [tmin(n),tmax(n)][t_{\min}^{(n)}, t_{\max}^{(n)}][tmin(n),tmax(n)],确保:
- 所有活性神经元都能在窗口内发放
- 窗口不能太大,否则会增加不必要的延迟
- 需要自动适应不同层、不同数据分布的特性
-
基本递归关系
tmin(n)=tmax(n−1) t_{\min}^{(n)} = t_{\max}^{(n-1)} tmin(n)=tmax(n−1)
这确保了层间顺序处理。 -
步骤1:评估最大膜电位(公式16)
在 t=tmin(n)t = t_{\min}^{(n)}t=tmin(n) 时刻,计算所有神经元在所有训练样本上的最大膜电位:
V~0(n)=(1+ζ)maxμ,iVi(n)(tmin(n)) \tilde{V}_0^{(n)} = (1+\zeta) \max_{\mu, i} V_i^{(n)}(t_{\min}^{(n)}) V~0(n)=(1+ζ)μ,imaxVi(n)(tmin(n))
数学原理:- 遍历所有样本(μ)和所有神经元(i):确保覆盖最坏情况
- 安全裕量ζ:通常取0.5(50%的余量)
- 物理意义:估计在 tmin(n)t_{\min}^{(n)}tmin(n) 时刻可能出现的最大膜电位
-
步骤2:计算时间窗口长度(公式17)
tmax(n)=deftmin(n)+τc⋅V~0(n)B0 t_{\max}^{(n)} \stackrel{\text{def}}{=} t_{\min}^{(n)} + \tau_c \cdot \frac{\tilde{V}_0^{(n)}}{B_0} tmax(n)=deftmin(n)+τc⋅B0V~0(n)
参数说明:- B0=1B_0 = 1B0=1:参考斜率因子
- τc\tau_cτc:时间转换参数
- 物理意义:基于最大膜电位和固定斜率,估计所需的时间长度
- 逻辑是:
- 我们观测到在 tmin(n)t_{\min}^{(n)}tmin(n) 时刻,最大膜电位是 V~0(n)\tilde{V}_0^{(n)}V~0(n)
- 假设有一个"最迟钝的神经元",它在 tmin(n)t_{\min}^{(n)}tmin(n) 时刻膜电位为0
- 这个神经元要以斜率 B0B_0B0 充电,需要多长时间才能达到某个阈值?
- 我们设置 tmax(n)t_{\max}^{(n)}tmax(n) 来容纳这种最坏情况
-
步骤3:设置基础阈值(公式18)
ϑ~i(n)=defBi(n)(tmax(n)−tmin(n)τc) \tilde{\vartheta}_i^{(n)} \stackrel{\text{def}}{=} B_i^{(n)} \left( \frac{t_{\max}^{(n)} - t_{\min}^{(n)}}{\tau_c} \right) ϑ~i(n)=defBi(n)(τctmax(n)−tmin(n))这不就是V~0(n)\tilde{V}_0^{(n)}V~0(n)?又推回来了
数学推导:
从膜电位方程(阶段二):
Vi(n)(t)=Vi(n)(tmin(n))+Bi(n)τc(t−tmin(n)) V_i^{(n)}(t) = V_i^{(n)}(t_{\min}^{(n)}) + \frac{B_i^{(n)}}{\tau_c} (t - t_{\min}^{(n)}) Vi(n)(t)=Vi(n)(tmin(n))+τcBi(n)(t−tmin(n))
设 Vi(n)(t)=ϑ~i(n)V_i^{(n)}(t) = \tilde{\vartheta}_i^{(n)}Vi(n)(t)=ϑ~i(n) 时发放,且希望在 t=tmax(n)t = t_{\max}^{(n)}t=tmax(n) 时刻,即使是最弱的输入也能达到阈值:
ϑ~i(n)=Vi(n)(tmin(n))+Bi(n)τc(tmax(n)−tmin(n)) \tilde{\vartheta}_i^{(n)} = V_i^{(n)}(t_{\min}^{(n)}) + \frac{B_i^{(n)}}{\tau_c} (t_{\max}^{(n)} - t_{\min}^{(n)}) ϑ~i(n)=Vi(n)(tmin(n))+τcBi(n)(tmax(n)−tmin(n))
但为了保守起见,假设 Vi(n)(tmin(n))=0V_i^{(n)}(t_{\min}^{(n)}) = 0Vi(n)(tmin(n))=0(最坏情况),得到:
ϑ~i(n)=Bi(n)τc(tmax(n)−tmin(n)) \tilde{\vartheta}_i^{(n)} = \frac{B_i^{(n)}}{\tau_c} (t_{\max}^{(n)} - t_{\min}^{(n)}) ϑ~i(n)=τcBi(n)(tmax(n)−tmin(n))
-
-
训练过程中的时间窗口迭代策略与训练过程比较
-
初始化阶段:由最大膜电位决定
在训练开始之前,网络需要一个初始的 tmax(n)t_{max}^{(n)}tmax(n) 值。这个值是通过一种递归的方式设置的:- 首先,对于第 nnn 层,模型会使用一部分训练数据来计算所有神经元在 tmin(n)t_{min}^{(n)}tmin(n) 时刻所能达到的最大膜电位 max(Vi(n)(tmin(n)))max(V_i^{(n)}(t_{min}^{(n)}))max(Vi(n)(tmin(n)))。
- 然后,基于这个最大的膜电位,并加上一个小的安全余量 ζζζ,来计算出一个合适的 tmax(n)t_{max}^{(n)}tmax(n)。
- 这个过程保证了在训练开始时,时间窗口 [tmin(n),tmax(n))[t_{min}^{(n)}, t_{max}^{(n)})[tmin(n),tmax(n)) 足够大,能够容纳所有可能产生的发放脉冲。
这个过程在补充材料的 Supplementary Note 2 中有详细描述 (第 63-93 行)。
-
训练阶段:通过迭代规则动态更新
在训练过程中,网络的权重 WWW 和其他参数会不断更新,这会导致神经元的脉冲发放时间 ti(n)t_i^{(n)}ti(n) 发生变化。如果 tmax(n)t_{max}^{(n)}tmax(n) 固定不变,可能会出现某些脉冲时间“跑出”了预设窗口的情况。-
为了解决这个问题,论文提出了一种自适应的更新规则(主论文中的公式(8),第 290-294 行)。
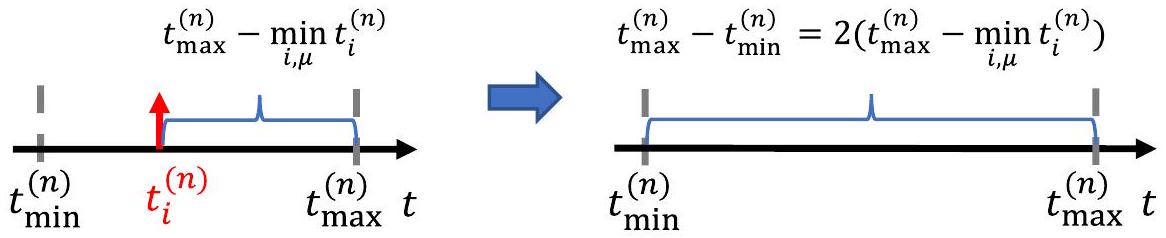
Δtmax(n)={γ(tmax(n)−mini,μti(n))−(tmax(n)−tmin(n)), if tmax(n)−tmin(n)<γ(tmax(n)−mini,μti(n))0, otherwise (8) \Delta t_{\max }^{(n)}=\left\{\begin{array}{cc} \gamma\left(t_{\max }^{(n)}-\min _{i, \mu} t_{i}^{(n)}\right)-\left(t_{\max }^{(n)}-t_{\min }^{(n)}\right), & \text { if } t_{\max }^{(n)}-t_{\min }^{(n)}<\gamma\left(t_{\max }^{(n)}-\min _{i, \mu} t_{i}^{(n)}\right) \tag{8}\\ 0, & \text { otherwise } \end{array}\right. Δtmax(n)={γ(tmax(n)−mini,μti(n))−(tmax(n)−tmin(n)),0, if tmax(n)−tmin(n)<γ(tmax(n)−mini,μti(n)) otherwise (8)
-
这个规则会在每个训练批次中检查:对于所有神经元和所有样本,最早的脉冲发放时间 min(ti(n))min(t_i^{(n)})min(ti(n)) 是否离 tmax(n)t_{max}^{(n)}tmax(n) 太近了。
-
如果发现脉冲时间过于集中在窗口的后半部分(即离 tmax(n)t_{max}^{(n)}tmax(n) 太近),规则就会自动扩大 tmax(n)t_{max}^{(n)}tmax(n),以保证有足够的空间,避免脉冲被截断。
这个更新过程在主论文的 “Methods” -> “Adaptive t_max^(n) parameters” 部分和补充材料的 “Iterative updates during training” 部分有详细说明。
-
总结一下:
这两种方法是一个串联的过程。先用第一种方法(基于最大膜电位)来获得一个合理的初始 tmaxt_{max}tmax 值,然后在训练过程中,再用第二种方法(迭代更新)来动态地、自适应地调整 tmaxt_{max}tmax,以适应网络参数的变化。 -
手推一下论文中具体的前向计算公式
设第 nnn 层神统元 iii 的发放时间为 ti(n)t_i^{(n)}ti(n) ,根据模型定义公式我们可以得到:
vi(n)τc=∑jWij(n)(tmin(n)−tj(n−1))+Bi(n)(ti(n)−tmin(n)) \frac{v_i^{(n)}}{\tau_c}=\sum_j W_{i j}^{(n)}\left(t_{\min }^{(n)}-t_j^{(n-1)}\right)+B_i^{(n)}\left(t_i^{(n)}-t_{\min }^{(n)}\right) τcvi(n)=j∑Wij(n)(tmin(n)−tj(n−1))+Bi(n)(ti(n)−tmin(n))
解得:ti(n)=τcVi(n)Bi(n)+tmin (n)+∑jWij(n)Bi(n)(tj(n−1)−tmin (n))t_i^{(n)}=\tau_c \frac{V_i^{(n)}}{B_i^{(n)}}+t_{\text {min }}^{(n)}+\sum_j \frac{W_{i j}^{(n)}}{B_i^{(n)}}\left(t_j^{(n-1)}-t_{\text {min }}^{(n)}\right)ti(n)=τcBi(n)Vi(n)+tmin (n)+∑jBi(n)Wij(n)(tj(n−1)−tmin (n))
两边同减 tmax (n)t_{\text {max }}^{(n)}tmax (n) 并将 tmin (n)t_{\text {min }}^{(n)}tmin (n) 替换为 tmax (n−1)t_{\text {max }}^{(n-1)}tmax (n−1) 得:
ti(n)−tmax (n)=τcVi(n)Bi(n)+tmin (n)−tmax (n)+∑jWij(n)Bi(n)(tj(n−1)−tmax (n−1))
t_i^{(n)}-t_{\text {max }}^{(n)}=\tau_c \frac{V_i^{(n)}}{B_i^{(n)}}+t_{\text {min }}^{(n)}-t_{\text {max }}^{(n)}+\sum_j \frac{W_{i j}^{(n)}}{B_i^{(n)}}\left(t_j^{(n-1)}-t_{\text {max }}^{(n-1)}\right)
ti(n)−tmax (n)=τcBi(n)Vi(n)+tmin (n)−tmax (n)+j∑Bi(n)Wij(n)(tj(n−1)−tmax (n−1))
对比形式 Xi(n)=∑jWijXj(n−1)+bi⇒输入对应关系X_i^{(n)}=\sum_j W_{i j} X_j^{(n-1)}+b_i \Rightarrow \text{输入对应关系}Xi(n)=∑jWijXj(n−1)+bi⇒输入对应关系
现在将两边同消 tmax (n)t_{\text {max }}^{(n)}tmax (n) ,将 τc=1, Bi(n)=1\tau_c=1, ~ B_i^{(n)}=1τc=1, Bi(n)=1 代入, tmax (n−1)t_{\text {max }}^{(n-1)}tmax (n−1) 替回 tmin (n)t_{\text {min }}^{(n)}tmin (n) ,有:
ti(n)=vi(n)+tmin (n)+∑Wij(n)(tj(n−1)−tmin (n))
t_i^{(n)}=v_i^{(n)}+t_{\text {min }}^{(n)}+\sum W_{i j}^{(n)}\left(t_j^{(n-1)}-t_{\text {min }}^{(n)}\right)
ti(n)=vi(n)+tmin (n)+∑Wij(n)(tj(n−1)−tmin (n))
由于 V~i(n)=Bi(n)(tmax (n)−tmin (n)τc)(18)\tilde{V}_i^{(n)}=B_i^{(n)}\left(\frac{t_{\text {max }}^{(n)}-t_{\text {min }}^{(n)}}{\tau_c}\right) (18)V~i(n)=Bi(n)(τctmax (n)−tmin (n))(18) ,且 Bi(n)=1,τc=1,Vi(n)=V~i(n)−Di(n)B_i^{(n)}=1, \tau_c=1, V_i^{(n)}=\tilde{V}_i^{(n)}-D_i^{(n)}Bi(n)=1,τc=1,Vi(n)=V~i(n)−Di(n) ,
∴Vi(n)=tmax (n)−tmin (n)−Di(n)\therefore V_i^{(n)}=t_{\text {max }}^{(n)}-t_{\text {min }}^{(n)}-D_i^{(n)}∴Vi(n)=tmax (n)−tmin (n)−Di(n) ,代入上式,有:
ti(n)=∑Wij(n)(tj(n−1)−tmin (n))+(tmax (n)−tmin (n)−Di(n))+tmin (n)
t_i^{(n)}=\sum W_{i j}^{(n)}\left(t_j^{(n-1)}-t_{\text {min }}^{(n)}\right)+\left(t_{\text {max }}^{(n)}-t_{\text {min }}^{(n)}-D_i^{(n)}\right)+t_{\text {min }}^{(n)}
ti(n)=∑Wij(n)(tj(n−1)−tmin (n))+(tmax (n)−tmin (n)−Di(n))+tmin (n)
消除上标得到当前层的前向:
ti=W(tj−tmin )+(tmax −tmin −Di)+tmin . t_i=W\left(t_j-t_{\text {min }}\right)+\left(t_{\text {max }}-t_{\text {min }}-D_i\right)+t_{\text {min }} . ti=W(tj−tmin )+(tmax −tmin −Di)+tmin .
更多推荐

 9
 0
- 0


 已为社区贡献1条内容

所有评论(0)