
推荐系统推理论文(两篇)
SIGIR25
1 动机
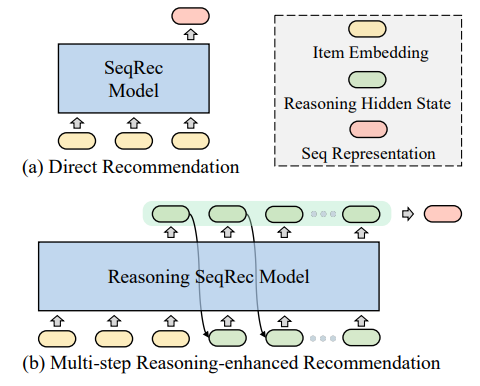
序列推荐(SeqRec)旨在预测用户的下一次交互 ,然而:现有模型(如SASRec)大多采用直接前向计算范式 。这种有限的计算深度,使其难以建模用户复杂且动态演变的兴趣 ,并且在处理长尾物品和交互稀疏的用户时表现不佳 。 受到自然语言处理领域思维链(CoT)的启发 ,研究者发现,通过在推理时允许多步思考(即增加计算深度),可以显著提升模型解决复杂任务的能力。
2 贡献
提出了 ReaRec,这是首个系统性地在序列推荐中探索推理时计算能力的框架 。它通过自回归机制和推理位置嵌入(RPE)来执行隐式的多步推理 。并设计两种学习策略: 提出了 ERL(集成推理学习)和 PRL(渐进推理学习)两种轻量级策略 。分别借鉴集成学习 和课程学习的思想,来解决隐式推理中缺乏中间监督和可能出现的推理退化问题 。
3 模型概述
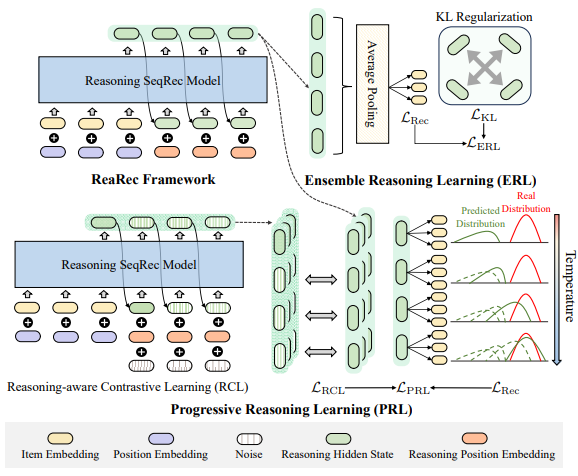
使用Transformer处理用户的历史物品序列,并得到最后一个位置的输出作为第0步推理状态 。接着,模型进入一个 K 步的自回归推理循环 :在第 k 步,将上一步的输出与一个可学习的第 k 步推理位置嵌入(RPE)相加 ,然后将这个新组合的向量再次送入同一个Transformer编码器中进行计算,得到新的推理状态 ,产生一系列推理状态 。最后,根据所选策略(ERL或PRL),模型将这些推理状态聚合成最终的用户表征 ,并与物品嵌入进行内积以生成预测。
ERL(集成推理学习):借鉴了集成学习的思想 ,它将所有K步的推理隐藏状态视为对用户兴趣的多视角表征 ,并通过平均池化将它们全部聚合起来,形成最终的用户表示 。为了防止多步推理的输出变得同质化,引入了KL散度,以强制不同步骤的输出分布保持多样性 。
PRL(渐进推理学习):借鉴了课程学习的思想 ,它旨在引导模型渐进式地逼近用户的真实偏好分布 。它通过PTA机制来实现:在早期推理步骤中使用高温度使分布平滑,在后期步骤中降低温度使分布尖锐(精炼)。同时还使用推理感知对比学习(RCL)来模拟错误纠正,以增强推理过程的鲁棒性 。
论文的实验分析研究了模型在不同活跃度用户和不同流行度物品子群上的鲁棒性,以验证其对长尾问题的改善效果 ;探究不同推理步数对模型性能 和推理延迟 的具体影响;通过消融实验 和嵌入可视化分析 来证明ERL的KL散度 和PRL的RCL对比学习 这两个关键组件的必要性和有效性;进行超参数敏感性分析 ;并最后提供了两个案例研究 ,直观地展示了模型是如何通过多步推理逐步修正并锁定正确推荐结果的 。
思维链(Chain-of-Thought, CoT)是一种专门用于“激发”和“引导”大型语言模型进行复杂推理“提示(Prompting)技术 ,它引导模型在给出最终答案之前,先生成一系列中间的、连贯的推理步骤 。
基于提示的生成:在推理时起作用,不涉及模型训练。
小样本思维链:依赖于上下文学习,在向模型提问之前,先在提示中手动提供几个完整的示例每一个示例都完整地包含“问题”、“推理步骤(思维链)”和“最终答案” 。
零样本思维链:不需要提供任何示例,加一句提示。
规划-解决提示:Zero-Shot CoT的增强版,使用一个更结构化的提示,明确要求模型先“制定计划”,再“执行计划” 。
自动思维链:解决了Few-Shot CoT需要手动编写高质量示例的痛点 。首先对一批问题使用Zero-Shot CoT("Let's think step by step")来自动生成推理路径 。从这些自动生成的(问题, 思维链)对中,采样出一组具有多样性的示例,然后用它们来构建一个Few-Shot CoT提示 。
基于训练的生成:通过微调来“教会”模型如何生成思维链。例如知识蒸馏,使用一个强大的“教师模型”(如GPT-4),配合Zero-Shot或Few-Shot CoT,为大量的训练问题生成推理路径 。将这些(问题, 思维链答案)对 作为一个新的数据集,去微调一个更小的模型 。微调后的“学生模型”就学会了生成CoT推理的能力 。
在得到COT后,可以直接使用,也可以多路径聚合,也可以结构化搜索与规划(思维树,图)
TKDE 24 (这篇实验分析部分写的真不戳啊)
1 动机
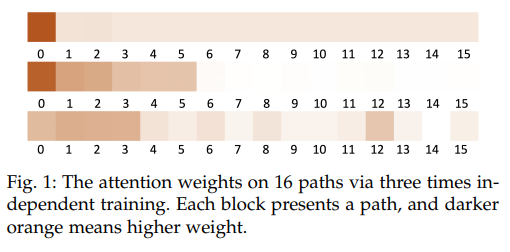
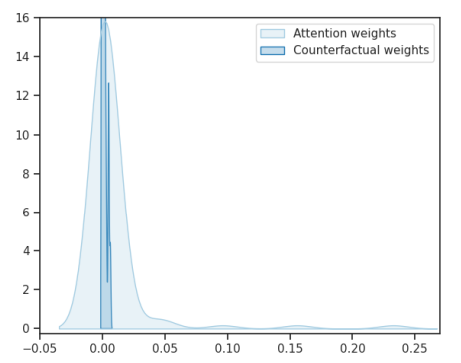
序列推荐旨在预测用户的下一次交互 ,然而:现有模型(如SASRec)大多采用直接现有的图路径推荐模型高度依赖注意力机制来生成解释 。然而,注意力权重并非为可解释性而设计,其主要目标是提升模型精度 。如下图所示,即使是相同的模型和数据,多次独立运行得到的注意力权重分布也不一致,这使得解释结果难以令人信服 。注意力机制倾向于为那些频繁出现的“通用”路径(例如非常宽泛的类别)分配高权重,但这些路径信息量低(低不确定性),解释价值有限 。
2 贡献
反事实推理提供了一种更优的思路 。它通过判断“对一个路径的轻微扰动能在多大程度上改变推荐结果”来衡量该路径的重要性 。这种方法天然更擅长捕获那些信息量大、高不确定性的“特定”路径,因为通用路径很难被轻微扰动所影响 。提出了新型可解释框架 。该框架用基于反事实推理学习到的“可解释权重”来替代传统的注意力权重 。该框架设计了两种反事实算法:
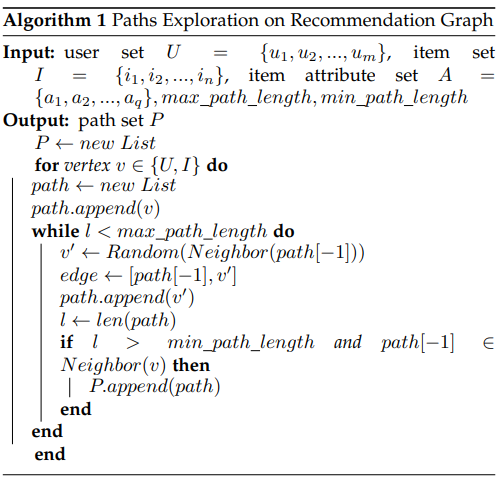
基于路径表示: 通过优化一个目标函数来学习一个最优的、轻微的“扰动因子”来生成反事实数据。
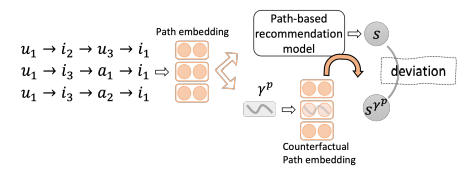
基于路径拓扑结构: 创新性地将此问题建模为马尔可夫决策过程,并使用强化学习来学习一个路径操纵策略,即智能体学会如何替换路径上的节点以产生反事实效果 。
此外,提出系统的评估方案: 针对路径解释缺乏公认评估标准的问题(大多依赖案例分析),论文提出了一套完整的可解释性评估方案,包括:
定性评估: 评估解释的稳定性(多次运行结果是否一致)和有效性(能否识别无关路径) 。
定量评估: 评估解释的置信度(Confidence,用信息熵衡量)、信息量和保真度 。
3 模型概述
首先呢,Path-Based Recommendation使用了推荐图,不同于传统的二部图和KG,包含用户 (U)、物品 (I) 和 物品属性 (A)。基于用户的购买历史和物品及属性信息构图,之后采用随机游走收集所有符合特定条件的路径。
模型大致的流程就是从“推荐图”中探索出连接用户和物品的路径,例如,然后,通过平均池化等方式,将路径上的节点嵌入聚合成路径嵌入。然后使用这些路径嵌入来增强物品的嵌入(物品自身的初始嵌入和所有指向它的路径嵌入的聚合),然后将用户购买过的、经过路径增强的物品嵌入按时间顺序组织起来,并输入到一个序列模型中进行预测。
基于路径表示的扰动:
模型将原始的路径嵌入 x送入推荐后端,得到一个原始的推荐分数 s。模型的目标是学习到一个“轻微的扰动向量” (损失函数)。将这个扰动添加到原始嵌入上,得到一个“反事实路径嵌入x'。再将x'送入推荐后端,得到一个新的(期望它更低的)推荐分数 s'。
基于路径拓扑结构的扰动
这种方法不是扰动向量,而是直接修改路径的结构,即替换路径上的节点 。原将原始的路径嵌入 x送入推荐后端,得到一个原始的推荐分数 s。并采用强化学习,其中Agent是一个策略网络,目标是最大化累积奖励W,当推荐分数下降时,给予正奖励,用最少的替换次数,来换取最大的推荐分数下降;Action是在路径中选择一个节点,并将其替换为一个同类型的“候选节点”(例如该节点的2跳邻居);State 是当前的路径集合和当前的推荐分数。
反事实权重是上述两种策略执行完毕后,计算得出的一个结果,被明确定义为:由扰动所引起的推荐分数下降值。原因是一条路径之所以“可解释”,是因为它对最终的推荐结果至关重要。当分数下降很多时,如果对路径 A 进行轻微扰动,导致推荐分数大幅下降,这证明模型高度依赖路径 A 来做出推荐 。因此,路径 A 是一个关键原因,具有高可解释性。
注意力机制倾向于给高频、通用的路径,因为它们很常见 。但这种路径信息量很低(低不确定性),不具解释价值 。反事实权重恰好相反。扰动一条“通用路径”对结果影响很小(权重低),因为模型可以从其他千万条路径中获得同样的“通用信息” 。
4 可解释性分析
定性评估:直观地、非数值地判断解释结果是否可靠和合理。
稳定性
解释方法在多次独立重复实验中,其结果是否保持一致。一个可靠的、值得信赖的解释框架,不应该在相同的输入下(或轻微扰动下)产生截然不同的解释结果。如果一个解释模型每次运行都给出不同的“重要路径”,那么这个解释本身就是不稳定的,用户无法信赖 。这正是论文在图1中指出的注意力机制的核心缺陷 。因此,选取了100条路径,并独立运行模型10次来获取这些路径的解释权重(包括注意力和反事实权重)并绘制这些权重值的KDE(核密度估计)图 。
有效性
考察解释方法能否有效地区分“相关路径”和“无关路径”,个好的解释方法应该只关注那些真正对推荐决策产生影响的路径。如果它为一个明显无关的路径赋予了很高的重要性权重,那么这个方法就是无效的,它没有真正理解模型的逻辑 。因此在原始的路径集中,人为地添加一个“恶作剧路径”(Pranking Path) 。这个路径是随机选取的、与当前推荐毫无关系的路径(例如来自一个毫不相干的用户) 。运行解释模型(10次),并观察这个“恶作剧路径”(在图中被标记为#16)获得的解释权重 。
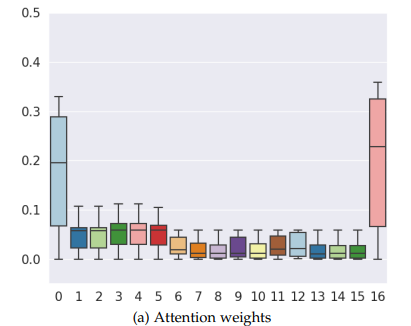
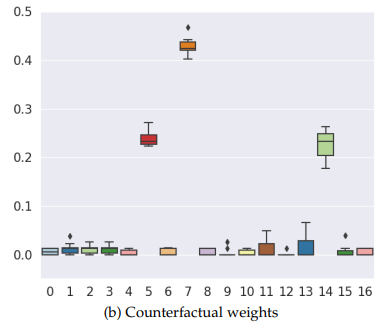
理想情况下,这个“恶作剧路径”的解释权重应该接近于0 。实验结果显示,注意力机制(a)错误地给了这个无关路径(#16)非常高且不稳定的权重;而CPER(b)则成功地将其权重压在接近0的水平,证明了其有效性 。
案例研究
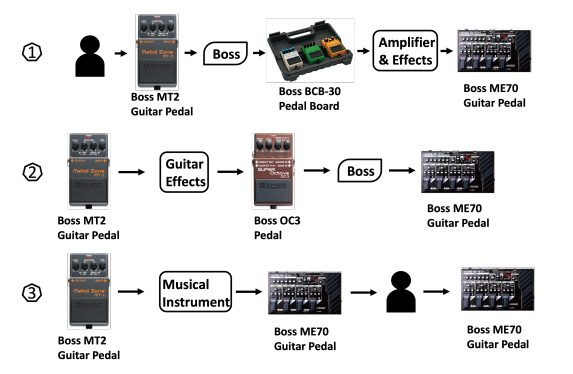
通过可视化具体路径来展示CPER的解释更符合人类常识 ,例如“具体品牌”路径比“通用类别”路径更重要 ,而注意力机制则相反 。
定量评估:使用具体的数值指标来衡量解释的质量。
置信度
考察解释模型对其给出的路径权重分布有多“自信”。受到了信息论的启发 。如果一个解释模型是“自信”的,它应该倾向于只把高权重分配给少数几条关键路径,而不是把权重“平摊”给大量路径。一个“平摊”的分布意味着高度的不确定性,即模型自己也不确定到底哪条路径更重要。使用信息熵来量化路径权重分布的不确定性 。
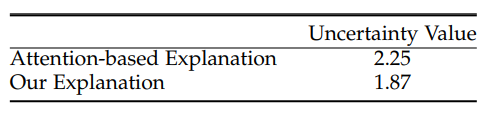
熵值越低,代表不确定性越低,即模型的置信度越高 。实验结果显示,CPER的熵明显低于注意力机制的熵,证明其解释更“自信” 。
信息量
考察被选出的“可解释路径”是否承载了推荐决策所需的大部分关键信息,如果一组路径真的具有高度可解释性,那么只使用这些路径来输入推荐模型,其产生的推荐分数应该与使用全部路径时的原始分数非常接近 。如果分数相差很大,说明这些被选中的路径丢失了大量重要信息,即它们的信息量不足。
首先,记录使用所有路径时的原始推荐分数。然后,只将被选中的“可解释路径”(送入推荐后端,得到一个“新分数” 。计算“新分数”与“原始分数”之间的均方误差,MSE越低,说明(仅由可解释路径)预测的分数越接近原始分数,即这些路径承载的“信息量”越足 。
保真度
评估解释权重与模型预测结果的相关性 ,这是评估反事实解释的一个经典指标。如果一个解释方法是“忠实”的,并且它赋予路径的权重是准确的,那么移除那些被评为“最重要”的路径,应该会导致推荐分数大幅下降 。

按照解释权重从高到低对路径进行排序,逐步从输入中移除最重要的路径,测量在移除不同比例路径后,推荐分数的下降幅度(Fidelity值)。
那么这篇论文涉及到了多个领域的可解释性验证方法,统计学领域还有:
特征归因值:计算一个特征在所有可能的特征组合中对最终预测所做的平均边际贡献。这个“贡献值”本身就是一个高度规范的统计量,用于衡量单一特征的重要性。
排列重要性:通过随机打乱数据集中某一列特征的顺序,然后观察模型性能(如准确率或MSE)下降了多少来衡量该特征的重要性。性能下降得越多,说明该特征越重要。
偏依赖图:展示了一个(或两个)特征对模型预测结果的边际效应。简单来说,它通过固定其他所有特征,只改变这一个特征的值,来绘制“当这个特征变化时,模型的平均预测会如何变化”的曲线。
敏感性分析:在输入数据发生轻微、不重要的扰动时,其给出的解释(例如特征重要性排序)不应该发生剧烈变化。
信息论领域:
互信息:在知道了某个特征(例如一条路径)的信息后,关于模型预测结果的不确定性降低了多少。与统计学中的“相关系数”不同,互信息可以捕捉非线性关系。一个特征可能与结果呈U型关系(相关系数为0),但互信息会很高。
KL散度:衡量两个概率分布之间的差异。
更多推荐

 29
 0
- 0


 已为社区贡献1条内容

所有评论(0)