
告别传统,拥抱高效:Playwright + Midscene.js 开启 UI 自动化测试新纪元
最近,我深入体验了字节发布的 Midscene.js,并尝试将其与 Playwright 结合,调用豆包或通义千问的 LLM 视觉模型开展 UI 自动化测试。一番实践下来,发现这种组合带来的效果远超传统 Selenium 方案。在深入研究前,不妨先了解下收费标准,做到心中有数。
Playwright + Midscene vs Selenium:优势大比拼
速度制胜:响应迅捷如闪电
传统 Selenium 在运行前,需先安装各类浏览器的驱动,等待驱动启动,这一过程耗时较长。而 Midscene 巧妙地跳过了这一繁琐步骤,直接调用内置浏览器运行,还能选择不展示浏览器及运行过程,真正实现了“快人一步”,大大缩短了测试周期,提升了整体效率。
兼容无忧:主流浏览器全适配
当下主流的 Google、Edge 等浏览器,Midscene 都能完美兼容。无需像 Selenium 那样,为不同浏览器下载对应的驱动,省去了诸多麻烦,让测试工作更加轻松便捷。
语法简易:小白也能快速上手
Midscene 内置了丰富实用的函数,使用时直接调用即可,几乎无需编写复杂的逻辑校验代码。即使是刚入门的小白,最多只需半天时间,就能熟练掌握并投入实际测试工作,极大地降低了学习成本。
另一面:不可忽视的缺点
收费门槛:免费有限,长期使用需付费
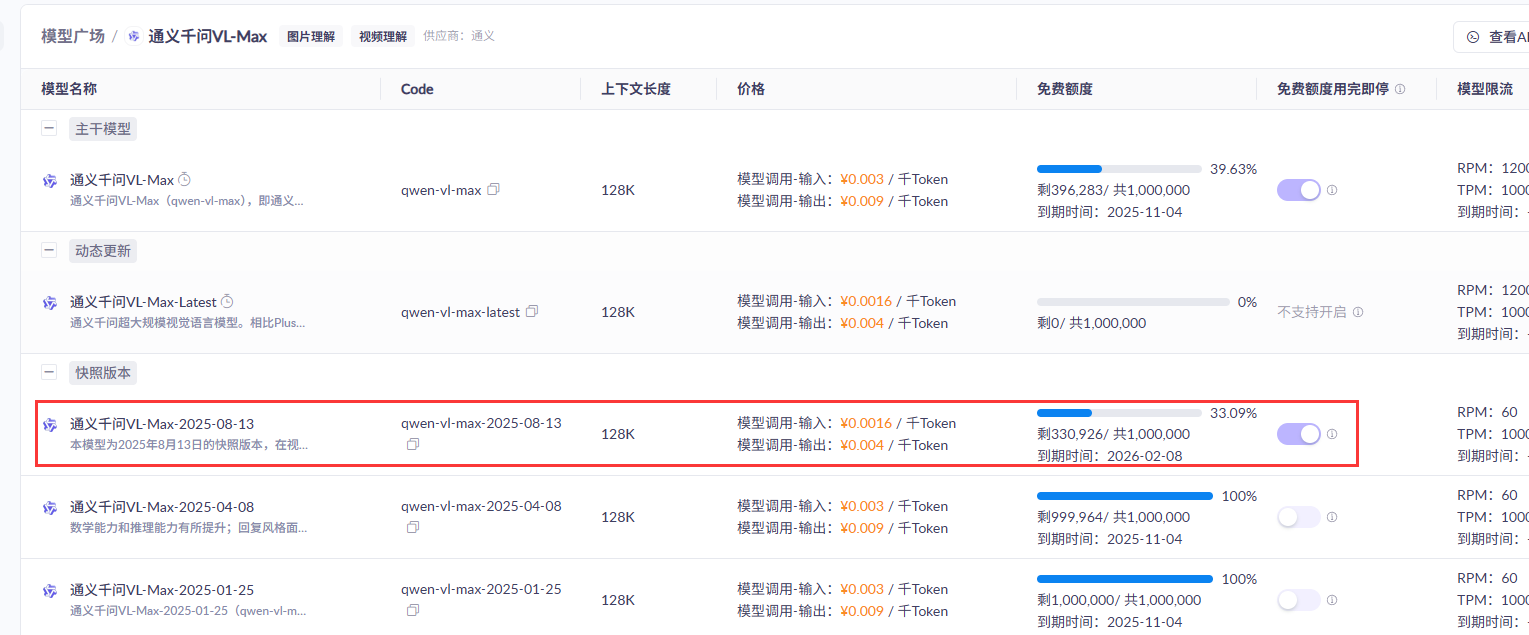
尽管豆包单个模型提供了 50W 的免费 Token,千问单个模型更是慷慨地给出了 100W 免费 Token,但单个注册账号的免费使用期限仅为 6 个月。超过这个时间,若想继续使用,就需要支付相应费用了。当然,也有“曲线救国”的办法,比如不断注册新账号,但这无疑会增加管理成本和操作复杂度。
模型兼容:切换有风险,用例或“失灵”
当我们将模型从豆包切换到千问,或者在同一个供应商下,某个视觉模型的免费 Token 用完后,换用其他模型时,之前编写的能够正常识别页面元素的测试用例,有极小的概率会出现执行失败的情况。这就要求我们在模型切换时,需要进行充分的测试和验证,以确保测试的稳定性和准确性。
收费情况实探:以阿里通义千问为例
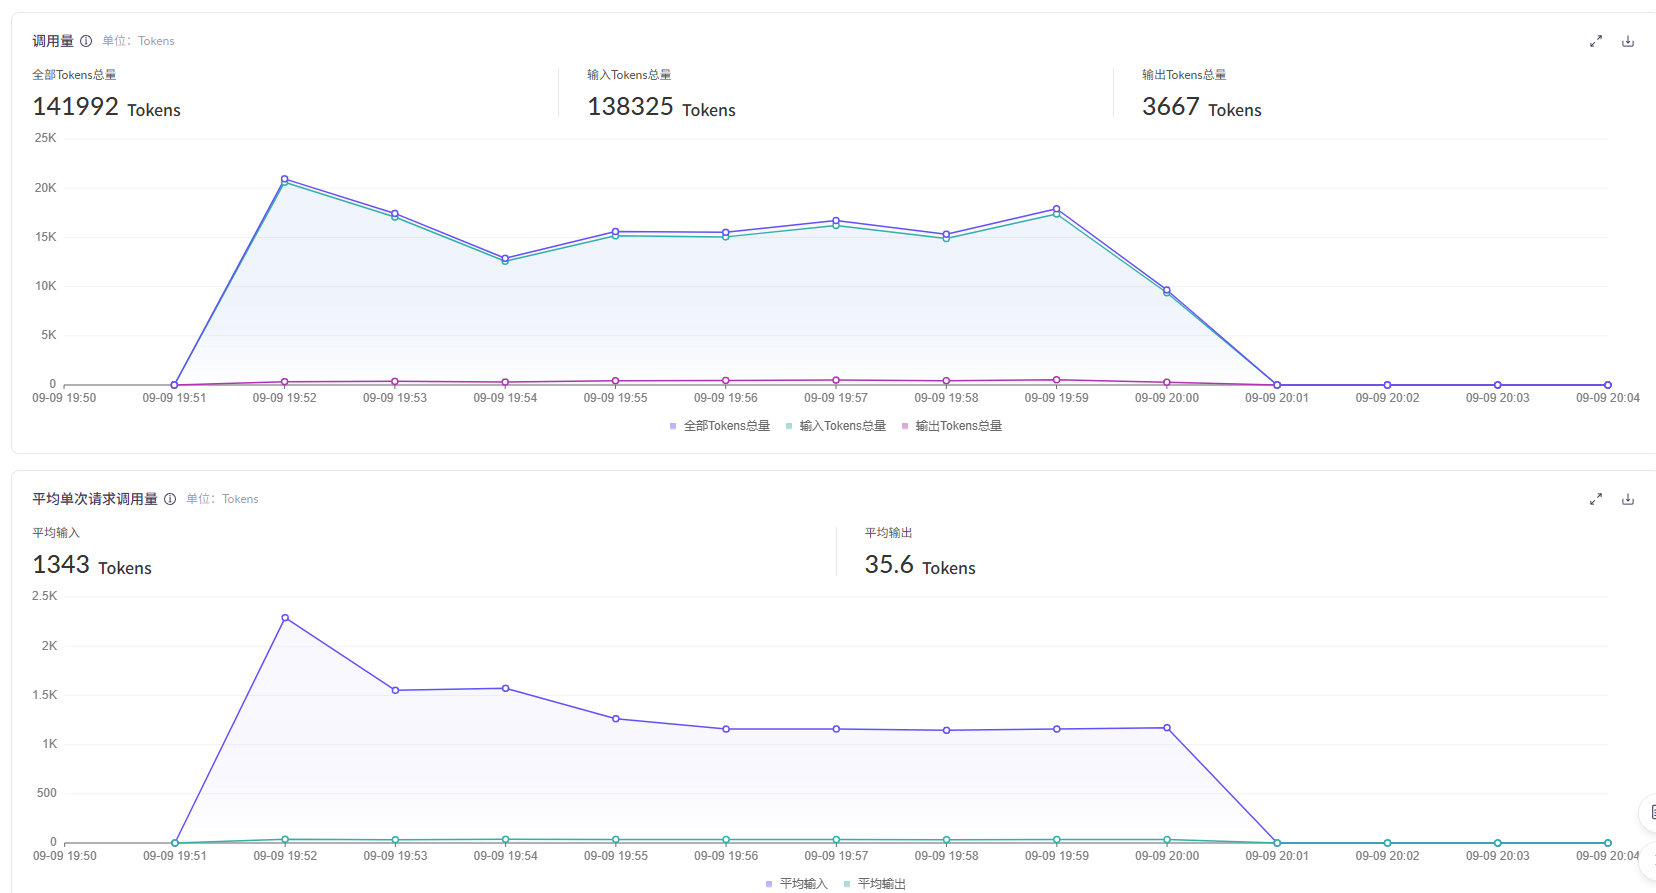
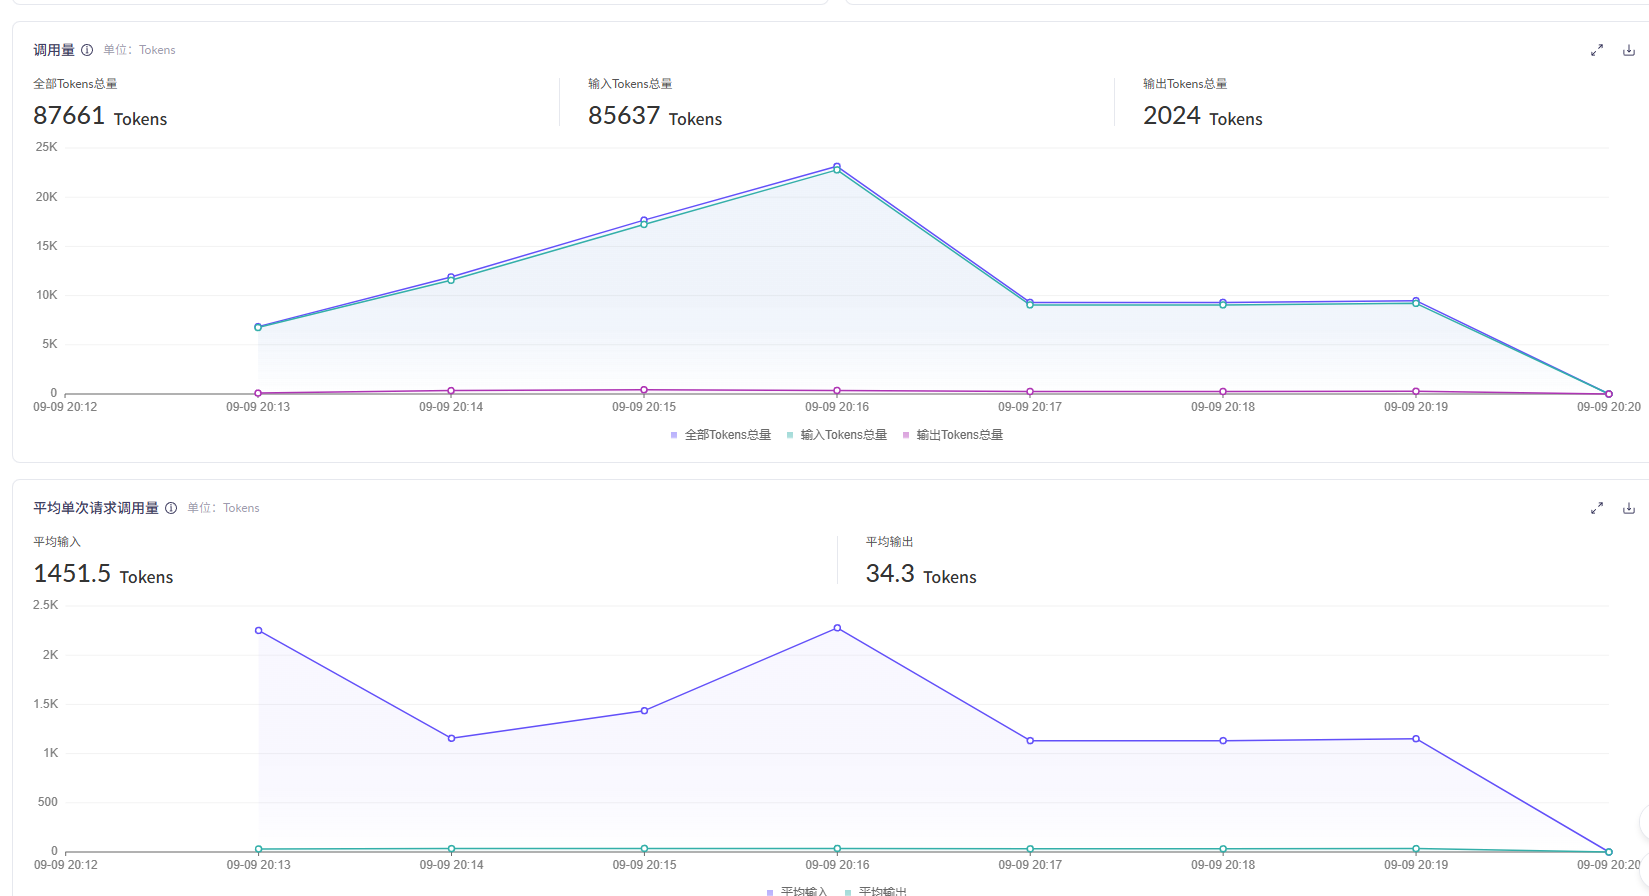
为了更直观地了解收费情况,我以阿里的通义千问为例进行了一番测试。在批量运行 10 条 UI 自动化测试用例后,我查看了后台调用的 Token 统计图。从图中可以清晰地看到 Token 的消耗情况,大家可以根据自己的测试需求和频率,合理规划 Token 的使用,避免不必要的浪费。
- 模型及价格列表:
- 第一次运行统计:
- 第二次运行统计:
- 结果统计:
|
批量运行10个用例 | ||||||||
|
运行统计 |
输入 |
输出 |
合计 | |||||
|
用时(S) |
成功率 |
数量(Tokens) |
价格(¥) |
数量(Tokens) |
价格(¥) |
总Token |
总价 | |
|
第一次 |
483 |
80% |
138325 |
0.0016/千Token |
3667 |
0.004/千Token |
141992 |
0.235 |
|
第二次 |
367 |
90% |
85637 |
2024 |
87661 |
0.145 | ||
如果你正在为 UI 自动化测试的效率和效果而烦恼,不妨尝试一下 Playwright + Midscene.js 的组合方案。虽然它存在一定的收费和兼容性问题,但其显著的优势无疑能为你的测试工作带来质的飞跃。在开启这场测试革新之旅前,务必充分了解收费标准,做好规划,让新技术更好地服务于你的工作。
更多推荐


 35
 0
- 0


 已为社区贡献1条内容

所有评论(0)