
SpringCloud 微服务 Day10 - 高效缓存与分布式锁管理:利用 Redis 提升系统性能与稳定性
经过前几天的学习,大家已经掌握了微服务相关技术的实际应用,能够应对企业开发的要求了。不过大家都知道在IT领域往往都是面试造火箭,实际工作拧螺丝。
为了更好的应对面试,让大家能拿到更高的offer,我们接下来就讲讲“造火箭”的事情。
接下来的内容主要包括以下几方面:
Redis高级:
-
Redis主从
-
Redis哨兵
-
Redis分片集群
-
Redis数据结构
-
Redis内存回收
-
Redis缓存一致性
微服务高级:
-
Eureka和Nacos对比
-
Ribbon和SpringCloudLoadBalancer
-
Hystix和Sentinel
-
限流算法
1.Redis主从
单节点Redis的并发能力是有上限的,要进一步提高Redis的并发能力,就需要搭建主从集群,实现读写分离。
1.1.主从集群结构
下图就是一个简单的Redis主从集群结构:
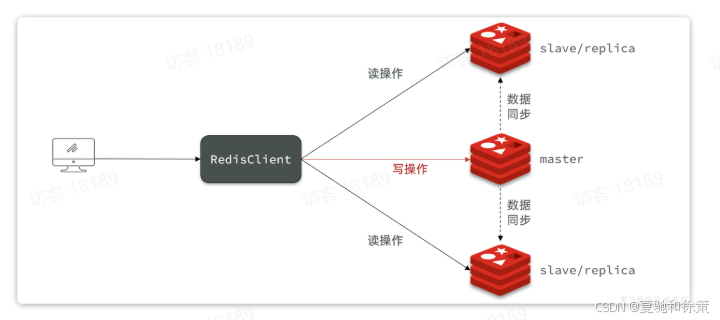
如图所示,集群中有一个master节点、两个slave节点(现在叫replica)。当我们通过Redis的Java客户端访问主从集群时,应该做好路由:
-
如果是写操作,应该访问master节点,master会自动将数据同步给两个slave节点
-
如果是读操作,建议访问各个slave节点,从而分担并发压力
1.2.搭建主从集群
我们会在同一个虚拟机中利用3个Docker容器来搭建主从集群,容器信息如下:
容器名 |
角色 |
IP |
映射端口 |
|---|---|---|---|
|
r1 |
master |
192.168.150.101 |
7001 |
|
r2 |
slave |
192.168.150.101 |
7002 |
|
r3 |
slave |
192.168.150.101 |
7003 |
1.2.1.启动多个Redis实例
我们利用课前资料提供的docker-compose文件来构建主从集群:
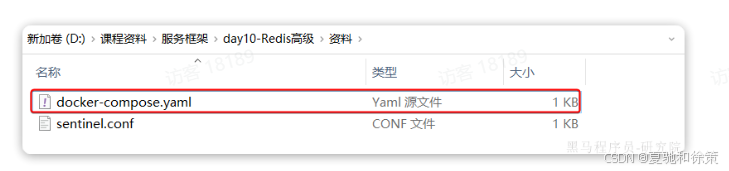
文件内容如下:
version: "3.2"

services:
  r1:
    image: redis
    container_name: r1
    network_mode: "host"
    entrypoint: ["redis-server", "--port", "7001"]
  r2:
    image: redis
    container_name: r2
    network_mode: "host"
    entrypoint: ["redis-server", "--port", "7002"]
  r3:
    image: redis
    container_name: r3
    network_mode: "host"
    entrypoint: ["redis-server", "--port", "7003"]
将其上传至虚拟机的/root/redis目录下:
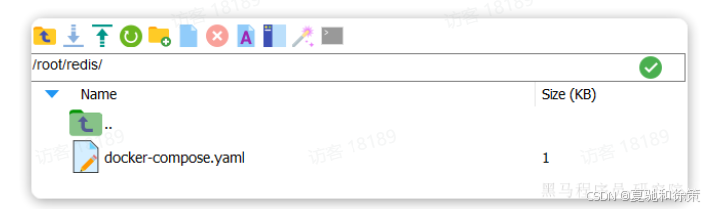
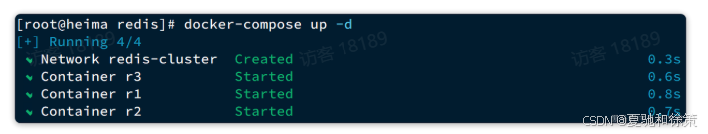
执行命令,运行集群:
docker compose up -d
结果:
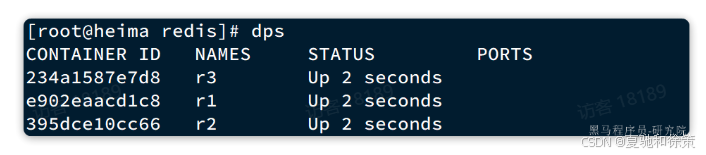
查看docker容器,发现都正常启动了:
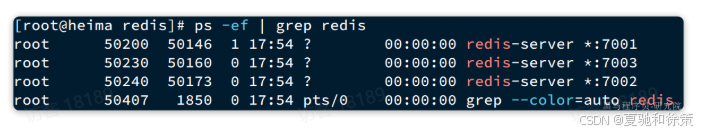
由于采用的是host模式,我们看不到端口映射。不过能直接在宿主机通过ps命令查看到Redis进程:
1.2.2.建立集群
虽然我们启动了3个Redis实例,但是它们并没有形成主从关系。我们需要通过命令来配置主从关系:
# Redis5.0以前 slaveof <masterip> <masterport> # Redis5.0以后 replicaof <masterip> <masterport>
有临时和永久两种模式:
-
永久生效:在redis.conf文件中利用
slaveof命令指定master节点 -
临时生效:直接利用redis-cli控制台输入
slaveof命令,指定master节点
我们测试临时模式,首先连接r2,让其以r1为master
# 连接r2
docker exec -it r2 redis-cli -p 7002
# 认r1主,也就是7001
slaveof 192.168.150.101 7001
然后连接r3,让其以r1为master
# 连接r3
docker exec -it r3 redis-cli -p 7003
# 认r1主,也就是7001
slaveof 192.168.150.101 7001
然后连接r1,查看集群状态:
# 连接r1
docker exec -it r1 redis-cli -p 7001
# 查看集群状态
info replication
# 连接r1 docker exec -it r1 redis-cli -p 7001 # 查看集群状态 info replication
结果如下:
127.0.0.1:7001> info replication
# Replication
role:master
connected_slaves:2
slave0:ip=192.168.150.101,port=7002,state=online,offset=140,lag=1
slave1:ip=192.168.150.101,port=7003,state=online,offset=140,lag=1
master_failover_state:no-failover
master_replid:16d90568498908b322178ca12078114e6c518b86
master_replid2:0000000000000000000000000000000000000000
master_repl_offset:140
second_repl_offset:-1
repl_backlog_active:1
repl_backlog_size:1048576
repl_backlog_first_byte_offset:1
repl_backlog_histlen:140
可以看到,当前节点r1:7001的角色是master,有两个slave与其连接:
-
slave0:port是7002,也就是r2节点 -
slave1:port是7003,也就是r3节点
1.2.3.测试
依次在r1、r2、r3节点上执行下面命令:
set num 123

get num
你会发现,只有在r1这个节点上可以执行set命令(写操作),其它两个节点只能执行get命令(读操作)。也就是说读写操作已经分离了。
1.3.主从同步原理
在刚才的主从测试中,我们发现r1上写入Redis的数据,在r2和r3上也能看到,这说明主从之间确实完成了数据同步。
那么这个同步是如何完成的呢?
1.3.1.全量同步
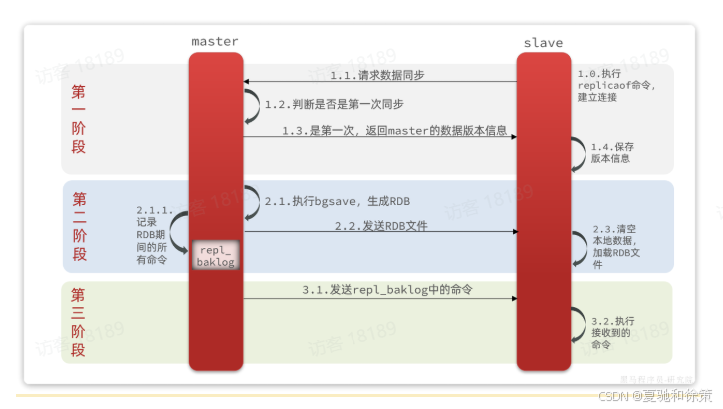
主从第一次建立连接时,会执行全量同步,将master节点的所有数据都拷贝给slave节点,流程:
这里有一个问题,master如何得知salve是否是第一次来同步呢??
有几个概念,可以作为判断依据:
-
Replication Id:简称replid,是数据集的标记,replid一致则是同一数据集。每个master都有唯一的replid,slave则会继承master节点的replid -
offset:偏移量,随着记录在repl_baklog中的数据增多而逐渐增大。slave完成同步时也会记录当前同步的offset。如果slave的offset小于master的offset,说明slave数据落后于master,需要更新。
因此slave做数据同步,必须向master声明自己的replication id 和offset,master才可以判断到底需要同步哪些数据。
由于我们在执行slaveof命令之前,所有redis节点都是master,有自己的replid和offset。
当我们第一次执行slaveof命令,与master建立主从关系时,发送的replid和offset是自己的,与master肯定不一致。
master判断发现slave发送来的replid与自己的不一致,说明这是一个全新的slave,就知道要做全量同步了。
master会将自己的replid和offset都发送给这个slave,slave保存这些信息到本地。自此以后slave的replid就与master一致了。
因此,master判断一个节点是否是第一次同步的依据,就是看replid是否一致。流程如图:
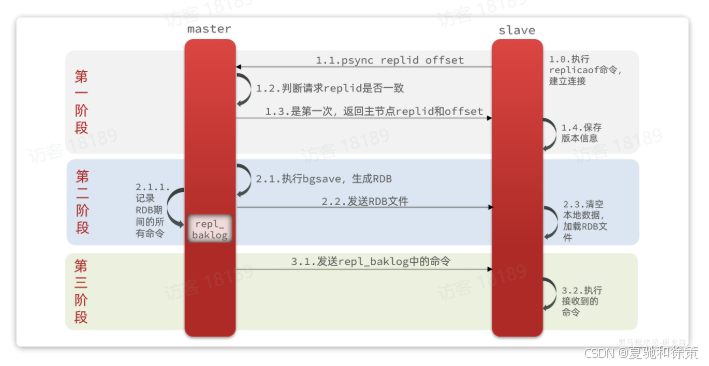
完整流程描述:
-
slave节点请求增量同步 -
master节点判断replid,发现不一致,拒绝增量同步 -
master将完整内存数据生成RDB,发送RDB到slave -
slave清空本地数据,加载master的RDB -
master将RDB期间的命令记录在repl_baklog,并持续将log中的命令发送给slave -
slave执行接收到的命令,保持与master之间的同步
来看下r1节点的运行日志:
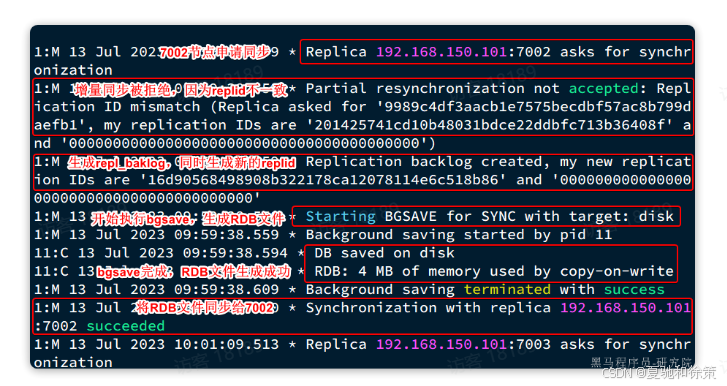
再看下r2节点执行replicaof命令时的日志:
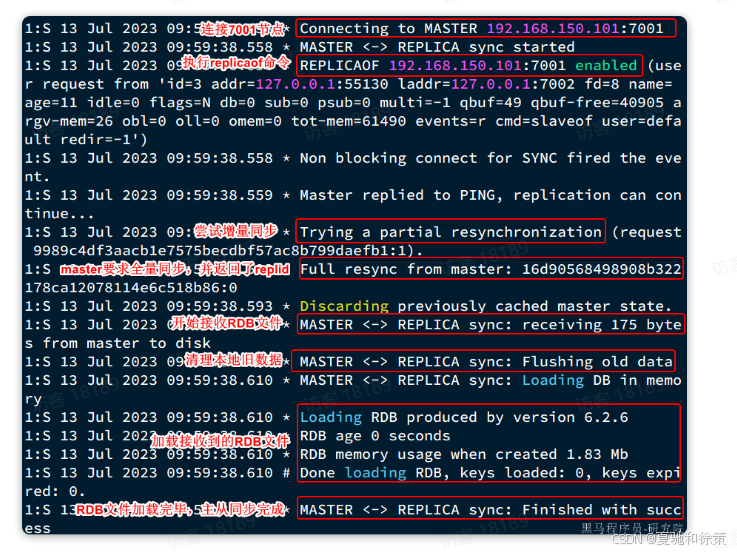
与我们描述的完全一致。
1.3.2.增量同步
全量同步需要先做RDB,然后将RDB文件通过网络传输个slave,成本太高了。因此除了第一次做全量同步,其它大多数时候slave与master都是做增量同步。
什么是增量同步?就是只更新slave与master存在差异的部分数据。如图:
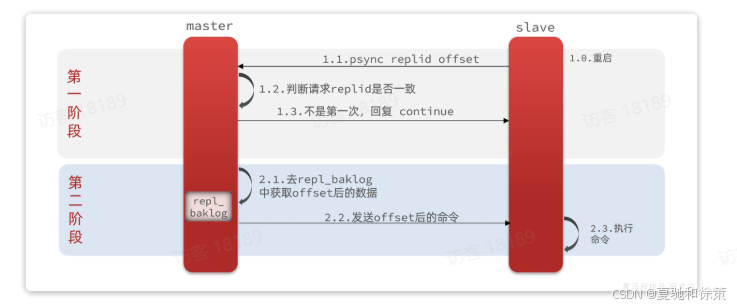
那么master怎么知道slave与自己的数据差异在哪里呢?
1.3.3.repl_baklog原理
master怎么知道slave与自己的数据差异在哪里呢?
这就要说到全量同步时的repl_baklog文件了。这个文件是一个固定大小的数组,只不过数组是环形,也就是说角标到达数组末尾后,会再次从0开始读写,这样数组头部的数据就会被覆盖。
repl_baklog中会记录Redis处理过的命令及offset,包括master当前的offset,和slave已经拷贝到的offset:
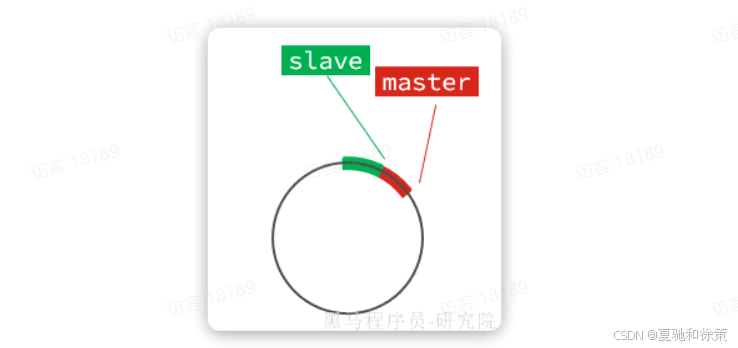
slave与master的offset之间的差异,就是salve需要增量拷贝的数据了。
随着不断有数据写入,master的offset逐渐变大,slave也不断的拷贝,追赶master的offset:
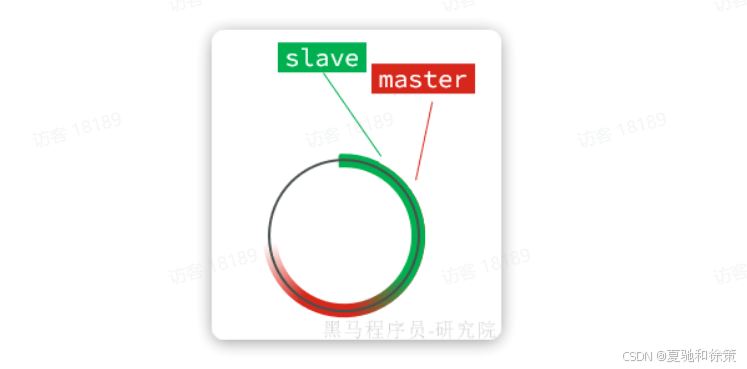
直到数组被填满:
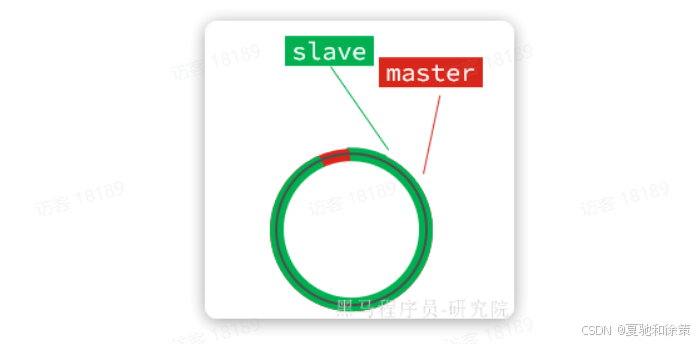
此时,如果有新的数据写入,就会覆盖数组中的旧数据。不过,旧的数据只要是绿色的,说明是已经被同步到slave的数据,即便被覆盖了也没什么影响。因为未同步的仅仅是红色部分:
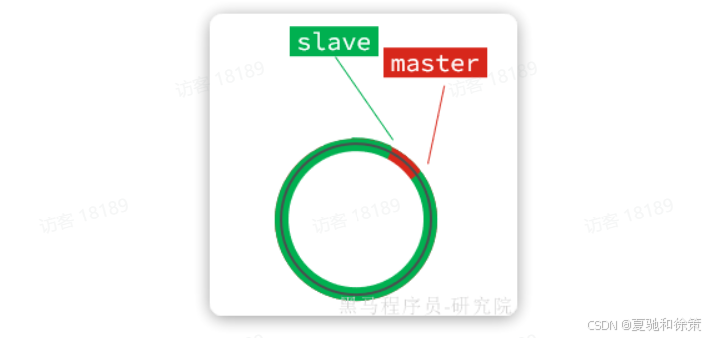
但是,如果slave出现网络阻塞,导致master的offset远远超过了slave的offset:
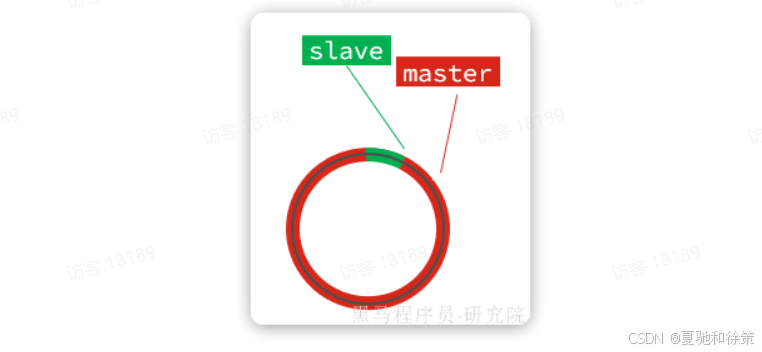
如果master继续写入新数据,master的offset就会覆盖repl_baklog中旧的数据,直到将slave现在的offset也覆盖:
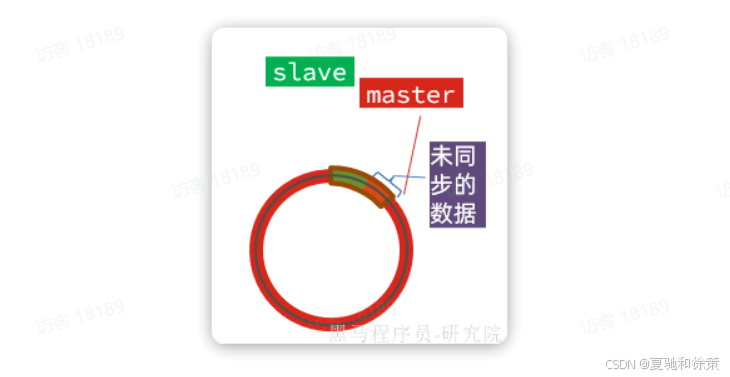
棕色框中的红色部分,就是尚未同步,但是却已经被覆盖的数据。此时如果slave恢复,需要同步,却发现自己的offset都没有了,无法完成增量同步了。只能做全量同步。
repl_baklog大小有上限,写满后会覆盖最早的数据。如果slave断开时间过久,导致尚未备份的数据被覆盖,则无法基于repl_baklog做增量同步,只能再次全量同步。
1.4.主从同步优化
主从同步可以保证主从数据的一致性,非常重要。
可以从以下几个方面来优化Redis主从就集群:
-
在master中配置
repl-diskless-sync yes启用无磁盘复制,避免全量同步时的磁盘IO。 -
Redis单节点上的内存占用不要太大,减少RDB导致的过多磁盘IO
-
适当提高
repl_baklog的大小,发现slave宕机时尽快实现故障恢复,尽可能避免全量同步 -
限制一个master上的slave节点数量,如果实在是太多slave,则可以采用
主-从-从链式结构,减少master压力
主-从-从架构图:
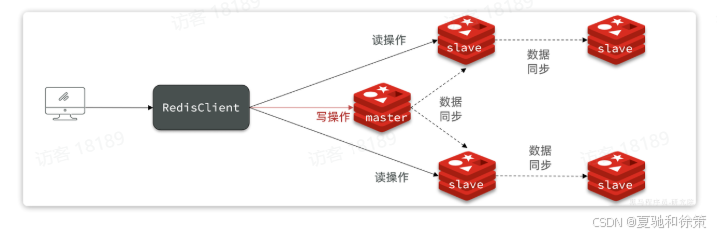
简述全量同步和增量同步区别?
-
全量同步:master将完整内存数据生成RDB,发送RDB到slave。后续命令则记录在repl_baklog,逐个发送给slave。
-
增量同步:slave提交自己的offset到master,master获取repl_baklog中从offset之后的命令给slave
什么时候执行全量同步?
-
slave节点第一次连接master节点时
-
slave节点断开时间太久,repl_baklog中的offset已经被覆盖时
什么时候执行增量同步?
-
slave节点断开又恢复,并且在
repl_baklog中能找到offset时
2.Redis哨兵
主从结构中master节点的作用非常重要,一旦故障就会导致集群不可用。那么有什么办法能保证主从集群的高可用性呢?
2.1.哨兵工作原理
Redis提供了哨兵(Sentinel)机制来监控主从集群监控状态,确保集群的高可用性。
2.1.1.哨兵作用
哨兵集群作用原理图:
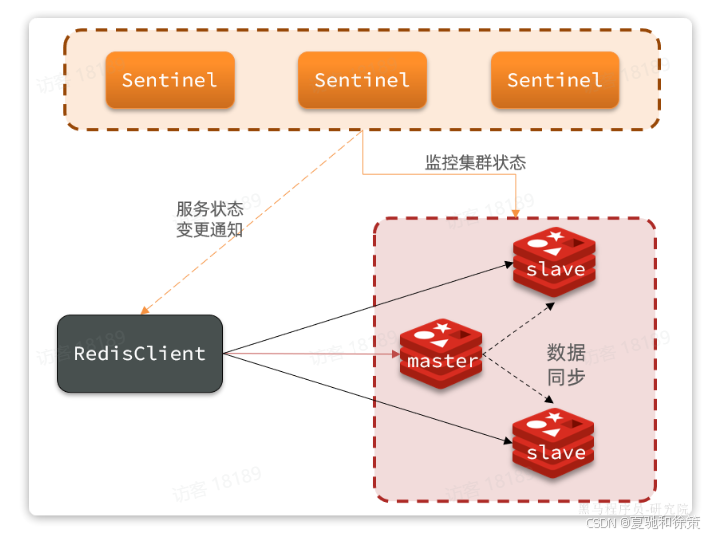
哨兵的作用如下:
-
状态监控:
Sentinel会不断检查您的master和slave是否按预期工作 -
故障恢复(failover):如果
master故障,Sentinel会将一个slave提升为master。当故障实例恢复后会成为slave -
状态通知:
Sentinel充当Redis客户端的服务发现来源,当集群发生failover时,会将最新集群信息推送给Redis的客户端
那么问题来了,Sentinel怎么知道一个Redis节点是否宕机呢?
2.1.2.状态监控
Sentinel基于心跳机制监测服务状态,每隔1秒向集群的每个节点发送ping命令,并通过实例的响应结果来做出判断:
-
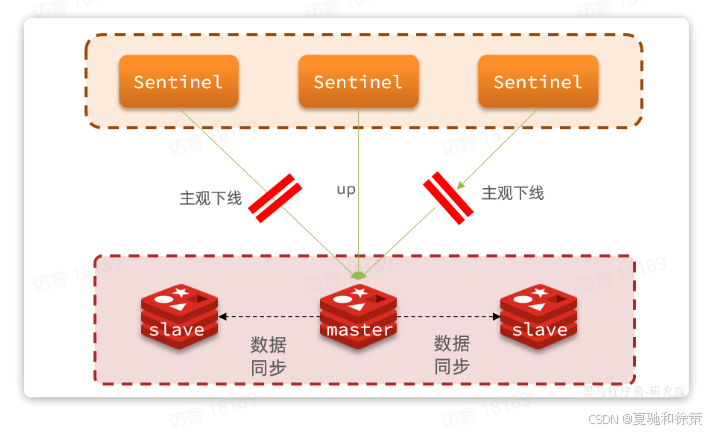
主观下线(sdown):如果某sentinel节点发现某Redis节点未在规定时间响应,则认为该节点主观下线。
-
客观下线(odown):若超过指定数量(通过
quorum设置)的sentinel都认为该节点主观下线,则该节点客观下线。quorum值最好超过Sentinel节点数量的一半,Sentinel节点数量至少3台。
如图:
一旦发现master故障,sentinel需要在salve中选择一个作为新的master,选择依据是这样的:
-
首先会判断slave节点与master节点断开时间长短,如果超过
down-after-milliseconds * 10则会排除该slave节点 -
然后判断slave节点的
slave-priority值,越小优先级越高,如果是0则永不参与选举(默认都是1)。 -
如果
slave-prority一样,则判断slave节点的offset值,越大说明数据越新,优先级越高 -
最后是判断slave节点的
run_id大小,越小优先级越高(通过info server可以查看run_id)。
对应的官方文档如下:
https://redis.io/docs/management/sentinel/#replica-selection-and-priority
问题来了,当选出一个新的master后,该如何实现身份切换呢?
大概分为两步:
-
在多个
sentinel中选举一个leader -
由
leader执行failover
2.1.3.选举leader
首先,Sentinel集群要选出一个执行failover的Sentinel节点,可以成为leader。要成为leader要满足两个条件:
-
最先获得超过半数的投票
-
获得的投票数不小于
quorum值
而sentinel投票的原则有两条:
-
优先投票给目前得票最多的
-
如果目前没有任何节点的票,就投给自己
比如有3个sentinel节点,s1、s2、s3,假如s2先投票:
-
此时发现没有任何人在投票,那就投给自己。
s2得1票 -
接着
s1和s3开始投票,发现目前s2票最多,于是也投给s2,s2得3票 -
s2称为leader,开始故障转移
不难看出,谁先投票,谁就会称为leader,那什么时候会触发投票呢?
答案是第一个确认master客观下线的人会立刻发起投票,一定会成为leader。
OK,sentinel找到leader以后,该如何完成failover呢?
2.1.4.failover
我们举个例子,有一个集群,初始状态下7001为master,7002和7003为slave:
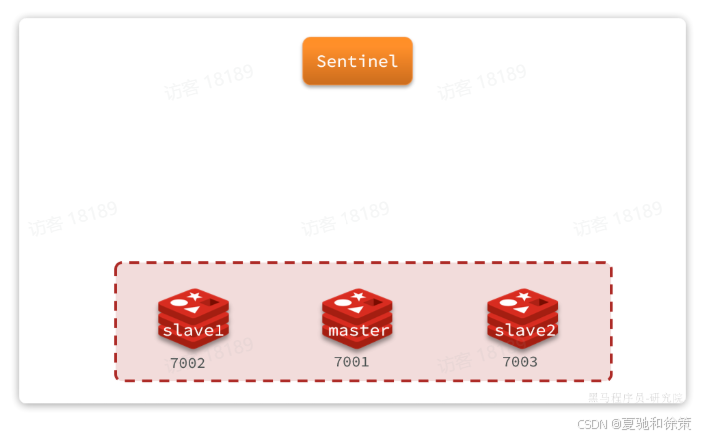
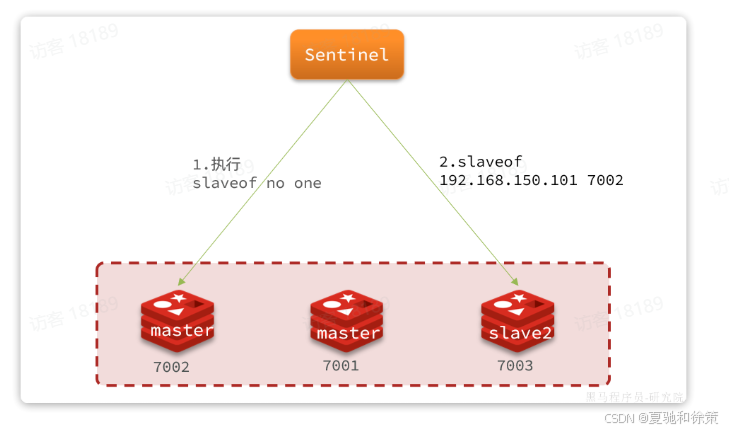
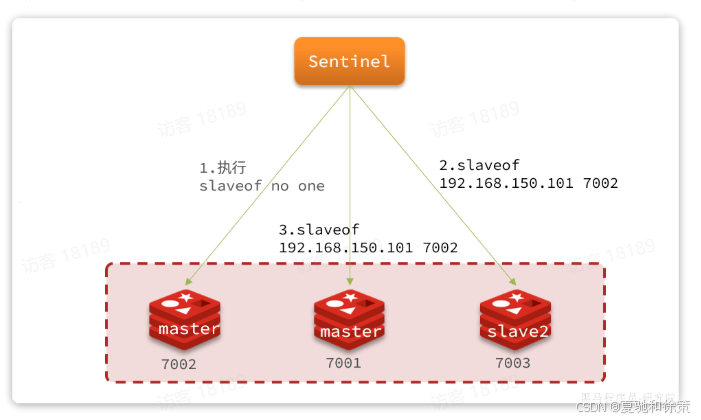
假如master发生故障,slave1当选。则故障转移的流程如下:
1)sentinel给备选的slave1节点发送slaveof no one命令,让该节点成为master
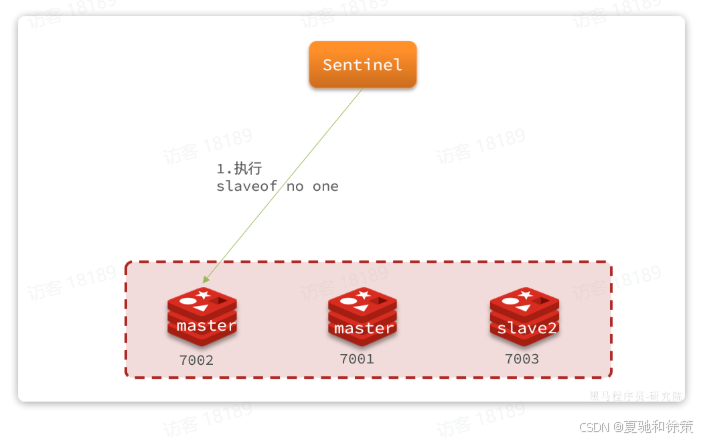
2)sentinel给所有其它slave发送slaveof 192.168.150.101 7002 命令,让这些节点成为新master,也就是7002的slave节点,开始从新的master上同步数据。
3)最后,当故障节点恢复后会接收到哨兵信号,执行slaveof 192.168.150.101 7002命令,成为slave:
2.2.搭建哨兵集群
首先,我们停掉之前的redis集群:
# 老版本DockerCompose
docker-compose down

# 新版本Docker
docker compose down
然后,我们找到课前资料提供的sentinel.conf文件:
其内容如下:
sentinel announce-ip "192.168.150.101" sentinel monitor hmaster 192.168.150.101 7001 2 sentinel down-after-milliseconds hmaster 5000 sentinel failover-timeout hmaster 60000
说明:
-
sentinel announce-ip "192.168.150.101":声明当前sentinel的ip -
sentinel monitor hmaster 192.168.150.101 7001 2:指定集群的主节点信息-
hmaster:主节点名称,自定义,任意写 -
192.168.150.101 7001:主节点的ip和端口 -
2:认定master下线时的quorum值
-
-
sentinel down-after-milliseconds hmaster 5000:声明master节点超时多久后被标记下线 -
sentinel failover-timeout hmaster 60000:在第一次故障转移失败后多久再次重试
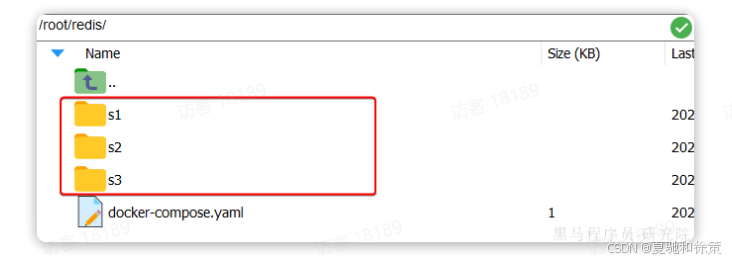
我们在虚拟机的/root/redis目录下新建3个文件夹:s1、s2、s3:
将课前资料提供的sentinel.conf文件分别拷贝一份到3个文件夹中。
接着修改docker-compose.yaml文件,内容如下:
version: "3.2"

services:
  r1:
    image: redis
    container_name: r1
    network_mode: "host"
    entrypoint: ["redis-server", "--port", "7001"]
  r2:
    image: redis
    container_name: r2
    network_mode: "host"
    entrypoint: ["redis-server", "--port", "7002", "--slaveof", "192.168.150.101", "7001"]
  r3:
    image: redis
    container_name: r3
    network_mode: "host"
    entrypoint: ["redis-server", "--port", "7003", "--slaveof", "192.168.150.101", "7001"]
  s1:
    image: redis
    container_name: s1
    volumes:
      - /root/redis/s1:/etc/redis
    network_mode: "host"
    entrypoint: ["redis-sentinel", "/etc/redis/sentinel.conf", "--port", "27001"]
  s2:
    image: redis
    container_name: s2
    volumes:
      - /root/redis/s2:/etc/redis
    network_mode: "host"
    entrypoint: ["redis-sentinel", "/etc/redis/sentinel.conf", "--port", "27002"]
  s3:
    image: redis
    container_name: s3
    volumes:
      - /root/redis/s3:/etc/redis
    network_mode: "host"
    entrypoint: ["redis-sentinel", "/etc/redis/sentinel.conf", "--port", "27003"]
直接运行命令,启动集群:
运行结果:
docker-compose up -d
我们以s1节点为例,查看其运行日志:
# Sentinel ID is 8e91bd24ea8e5eb2aee38f1cf796dcb26bb88acf
# +monitor master hmaster 192.168.150.101 7001 quorum 2
* +slave slave 192.168.150.101:7003 192.168.150.101 7003 @ hmaster 192.168.150.101 7001
* +sentinel sentinel 5bafeb97fc16a82b431c339f67b015a51dad5e4f 192.168.150.101 27002 @ hmaster 192.168.150.101 7001
* +sentinel sentinel 56546568a2f7977da36abd3d2d7324c6c3f06b8d 192.168.150.101 27003 @ hmaster 192.168.150.101 7001
* +slave slave 192.168.150.101:7002 192.168.150.101 7002 @ hmaster 192.168.150.101 7001
可以看到sentinel已经联系到了7001这个节点,并且与其它几个哨兵也建立了链接。哨兵信息如下:
-
27001:Sentinel ID是8e91bd24ea8e5eb2aee38f1cf796dcb26bb88acf -
27002:Sentinel ID是5bafeb97fc16a82b431c339f67b015a51dad5e4f -
27003:Sentinel ID是56546568a2f7977da36abd3d2d7324c6c3f06b8d
2.3.演示failover
接下来,我们演示一下当主节点故障时,哨兵是如何完成集群故障恢复(failover)的。
我们连接7001这个master节点,然后通过命令让其休眠60秒,模拟宕机:
# 连接7001这个master节点,通过sleep模拟服务宕机,60秒后自动恢复
docker exec -it r1 redis-cli -p 7001 DEBUG sleep 60
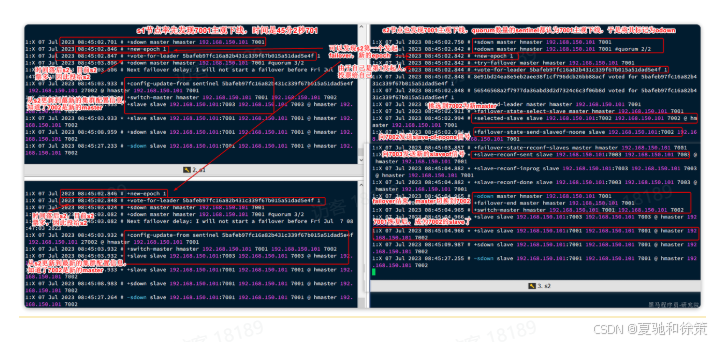
稍微等待一段时间后,会发现sentinel节点触发了failover:
2.4.总结
Sentinel的三个作用是什么?
-
集群监控
-
故障恢复
-
状态通知
Sentinel如何判断一个redis实例是否健康?
-
每隔1秒发送一次ping命令,如果超过一定时间没有相向则认为是主观下线(
sdown) -
如果大多数sentinel都认为实例主观下线,则判定服务客观下线(
odown)
故障转移步骤有哪些?
-
首先要在
sentinel中选出一个leader,由leader执行failover -
选定一个
slave作为新的master,执行slaveof noone,切换到master模式 -
然后让所有节点都执行
slaveof新master -
修改故障节点配置,添加
slaveof新master
sentinel选举leader的依据是什么?
-
票数超过sentinel节点数量1半
-
票数超过quorum数量
-
一般情况下最先发起failover的节点会当选
sentinel从slave中选取master的依据是什么?
-
首先会判断slave节点与master节点断开时间长短,如果超过
down-after-milliseconds* 10则会排除该slave节点 -
然后判断slave节点的
slave-priority值,越小优先级越高,如果是0则永不参与选举(默认都是1)。 -
如果
slave-prority一样,则判断slave节点的offset值,越大说明数据越新,优先级越高 -
最后是判断slave节点的
run_id大小,越小优先级越高(通过info server可以查看run_id)。
2.5.RedisTemplate连接哨兵集群(自学)
分为三步:
-
1)引入依赖
-
2)配置哨兵地址
-
3)配置读写分离
2.5.1.引入依赖
就是SpringDataRedis的依赖:
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-data-redis</artifactId>
</dependency>
2.5.2.配置哨兵地址
连接哨兵集群与传统单点模式不同,不再需要设置每一个redis的地址,而是直接指定哨兵地址:
spring:
  redis:
    sentinel:
      master: hmaster # 集群名
      nodes: # 哨兵地址列表
        - 192.168.150.101:27001
        - 192.168.150.101:27002
        - 192.168.150.101:27003
2.5.3.配置读写分离
最后,还要配置读写分离,让java客户端将写请求发送到master节点,读请求发送到slave节点。定义一个bean即可:
@Bean
public LettuceClientConfigurationBuilderCustomizer clientConfigurationBuilderCustomizer(){
    return clientConfigurationBuilder -> clientConfigurationBuilder.readFrom(ReadFrom.REPLICA_PREFERRED);
}
这个bean中配置的就是读写策略,包括四种:
-
MASTER:从主节点读取 -
MASTER_PREFERRED:优先从master节点读取,master不可用才读取slave -
REPLICA:从slave节点读取 -
REPLICA_PREFERRED:优先从slave节点读取,所有的slave都不可用才读取master
3.Redis分片集群
主从模式可以解决高可用、高并发读的问题。但依然有两个问题没有解决:
-
海量数据存储
-
高并发写
要解决这两个问题就需要用到分片集群了。分片的意思,就是把数据拆分存储到不同节点,这样整个集群的存储数据量就更大了。
Redis分片集群的结构如图:
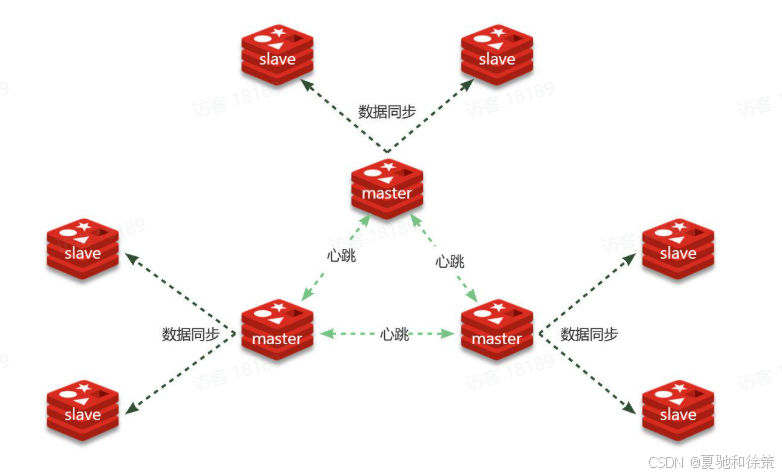
分片集群特征:
-
集群中有多个master,每个master保存不同分片数据 ,解决海量数据存储问题
-
每个master都可以有多个slave节点 ,确保高可用
-
master之间通过ping监测彼此健康状态 ,类似哨兵作用
-
客户端请求可以访问集群任意节点,最终都会被转发到数据所在节点
3.1.搭建分片集群
Redis分片集群最少也需要3个master节点,由于我们的机器性能有限,我们只给每个master配置1个slave,形成最小的分片集群:
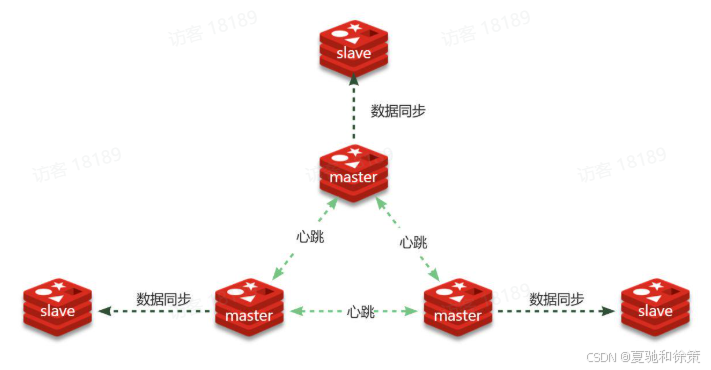
计划部署的节点信息如下:
| 容器名 | 角色 | IP | 映射端口 |
| r1 | master | 192.168.150.101 | 7001 |
| r2 | master | 192.168.150.101 | 7002 |
| r3 | master | 192.168.150.101 | 7003 |
| r4 | slave | 192.168.150.101 | 7004 |
| r5 | slave | 192.168.150.101 | 7005 |
| r6 | slave | 192.168.150.101 | 7006 |
3.1.1.集群配置
分片集群中的Redis节点必须开启集群模式,一般在配置文件中添加下面参数:
port 7000
cluster-enabled yes
cluster-config-file nodes.conf
cluster-node-timeout 5000
appendonly yes
其中有3个我们没见过的参数:
-
cluster-enabled:是否开启集群模式 -
cluster-config-file:集群模式的配置文件名称,无需手动创建,由集群自动维护 -
cluster-node-timeout:集群中节点之间心跳超时时间
一般搭建部署集群肯定是给每个节点都配置上述参数,不过考虑到我们计划用docker-compose部署,因此可以直接在启动命令中指定参数,偷个懒。
在虚拟机的/root目录下新建一个redis-cluster目录,然后在其中新建一个docker-compose.yaml文件,内容如下:
version: "3.2"

services:
  r1:
    image: redis
    container_name: r1
    network_mode: "host"
    entrypoint: ["redis-server", "--port", "7001", "--cluster-enabled", "yes", "--cluster-config-file", "node.conf"]
  r2:
    image: redis
    container_name: r2
    network_mode: "host"
    entrypoint: ["redis-server", "--port", "7002", "--cluster-enabled", "yes", "--cluster-config-file", "node.conf"]
  r3:
    image: redis
    container_name: r3
    network_mode: "host"
    entrypoint: ["redis-server", "--port", "7003", "--cluster-enabled", "yes", "--cluster-config-file", "node.conf"]
  r4:
    image: redis
    container_name: r4
    network_mode: "host"
    entrypoint: ["redis-server", "--port", "7004", "--cluster-enabled", "yes", "--cluster-config-file", "node.conf"]
  r5:
    image: redis
    container_name: r5
    network_mode: "host"
    entrypoint: ["redis-server", "--port", "7005", "--cluster-enabled", "yes", "--cluster-config-file", "node.conf"]
  r6:
    image: redis
    container_name: r6
    network_mode: "host"
    entrypoint: ["redis-server", "--port", "7006", "--cluster-enabled", "yes", "--cluster-config-file", "node.conf"]
注意:使用Docker部署Redis集群,network模式必须采用host
3.1.2.启动集群
进入/root/redis-cluster目录,使用命令启动redis:
docker-compose up -d
启动成功,可以通过命令查看启动进程:
ps -ef | grep redis
# 结果:
root       4822   4743  0 14:29 ?        00:00:02 redis-server *:7002 [cluster]
root       4827   4745  0 14:29 ?        00:00:01 redis-server *:7005 [cluster]
root       4897   4778  0 14:29 ?        00:00:01 redis-server *:7004 [cluster]
root       4903   4759  0 14:29 ?        00:00:01 redis-server *:7006 [cluster]
root       4905   4775  0 14:29 ?        00:00:02 redis-server *:7001 [cluster]
root       4912   4732  0 14:29 ?        00:00:01 redis-server *:7003 [cluster]
可以发现每个redis节点都以cluster模式运行。不过节点与节点之间并未建立连接。
接下来,我们使用命令创建集群:
# 进入任意节点容器
docker exec -it r1 bash
# 然后,执行命令
redis-cli --cluster create --cluster-replicas 1 \
192.168.150.101:7001 192.168.150.101:7002 192.168.150.101:7003 \
192.168.150.101:7004 192.168.150.101:7005 192.168.150.101:7006
命令说明:
-
redis-cli --cluster:代表集群操作命令 -
create:代表是创建集群 -
--cluster-replicas 1:指定集群中每个master的副本个数为1-
此时
节点总数 ÷ (replicas + 1)得到的就是master的数量n。因此节点列表中的前n个节点就是master,其它节点都是slave节点,随机分配到不同master
-
输入命令后控制台会弹出下面的信息:
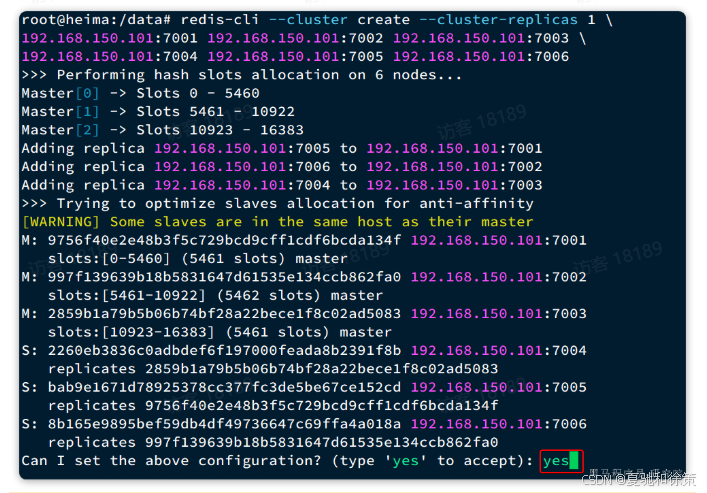
这里展示了集群中master与slave节点分配情况,并询问你是否同意。节点信息如下:
-
7001是master,节点id后6位是da134f -
7002是master,节点id后6位是862fa0 -
7003是master,节点id后6位是ad5083 -
7004是slave,节点id后6位是391f8b,认ad5083(7003)为master -
7005是slave,节点id后6位是e152cd,认da134f(7001)为master -
7006是slave,节点id后6位是4a018a,认862fa0(7002)为master
输入yes然后回车。会发现集群开始创建,并输出下列信息:
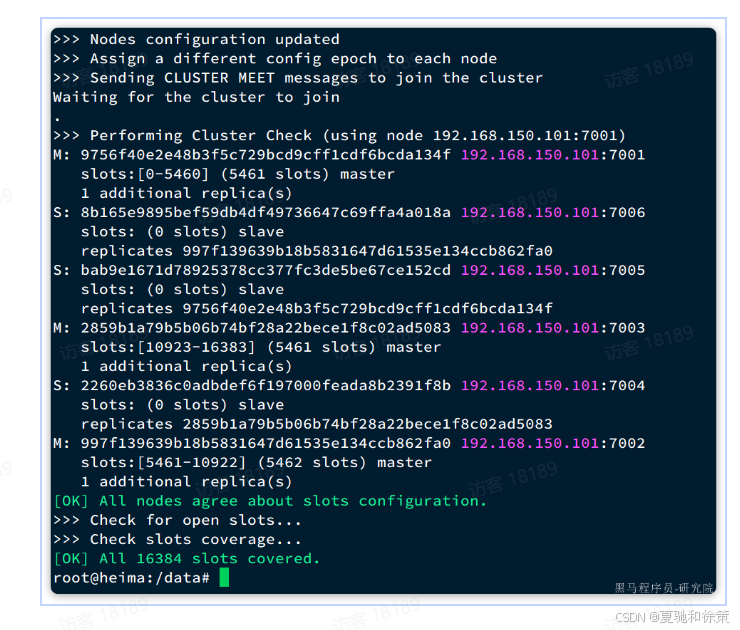
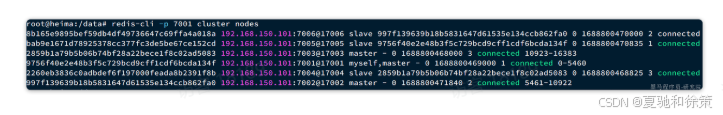
接着,我们可以通过命令查看集群状态:
redis-cli -p 7001 cluster nodes
结果:
3.2.散列插槽
数据要分片存储到不同的Redis节点,肯定需要有分片的依据,这样下次查询的时候才能知道去哪个节点查询。很多数据分片都会采用一致性hash算法。而Redis则是利用散列插槽(hash slot)的方式实现数据分片。
详见官方文档:
https://redis.io/docs/management/scaling/#redis-cluster-101
在Redis集群中,共有16384个hash slots,集群中的每一个master节点都会分配一定数量的hash slots。具体的分配在集群创建时就已经指定了:
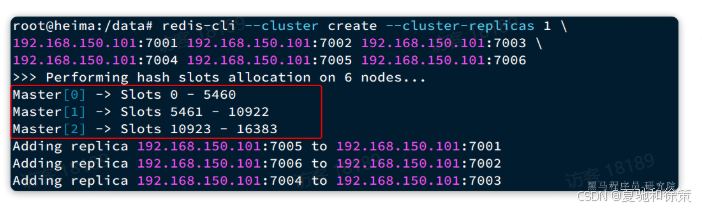
如图中所示:
-
Master[0],本例中就是7001节点,分配到的插槽是0~5460
-
Master[1],本例中就是7002节点,分配到的插槽是5461~10922
-
Master[2],本例中就是7003节点,分配到的插槽是10923~16383
当我们读写数据时,Redis基于CRC16 算法对key做hash运算,得到的结果与16384取余,就计算出了这个key的slot值。然后到slot所在的Redis节点执行读写操作。
不过hash slot的计算也分两种情况:
-
当
key中包含{}时,根据{}之间的字符串计算hash slot -
当
key中不包含{}时,则根据整个key字符串计算hash slot
例如:
-
key是
user,则根据user来计算hash slot -
key是
user:{age},则根据age来计算hash slot
我们来测试一下,先于7001建立连接:
# 进入容器
docker exec -it r1 bash
# 进入redis-cli
redis-cli -p 7001
# 测试
set user jack
会发现报错了:
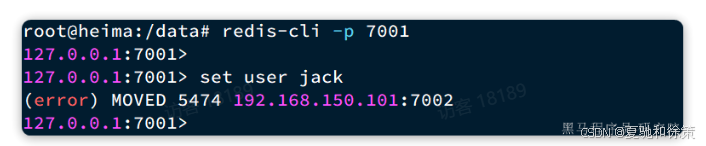
提示我们MOVED 5474,其实就是经过计算,得出user这个key的hash slot 是5474,而5474是在7002节点,不能在7001上写入!!
说好的任意节点都可以读写呢?
这是因为我们连接的方式有问题,连接集群时,要加-c参数:
# 通过7001连接集群
redis-cli -c -p 7001
# 存入数据
set user jack
结果如下:
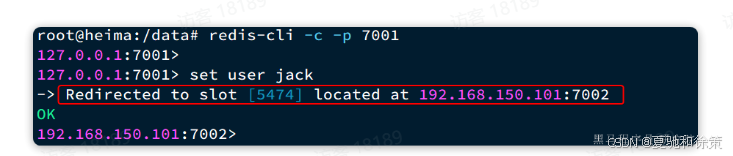
可以看到,客户端自动跳转到了5474这个slot所在的7002节点。
现在,我们添加一个新的key,这次加上{}:
# 试一下key中带{}
set user:{age} 21

# 再试一下key中不带{}
set age 20
结果如下:
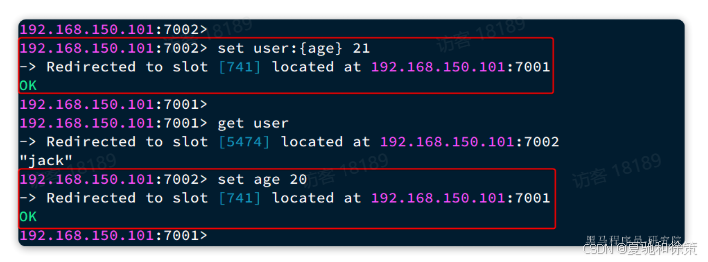
可以看到user:{age}和age计算出的slot都是741。
3.3.故障转移
分片集群的节点之间会互相通过ping的方式做心跳检测,超时未回应的节点会被标记为下线状态。当发现master下线时,会将这个master的某个slave提升为master。
我们先打开一个控制台窗口,利用命令监测集群状态:
watch docker exec -it r1 redis-cli -p 7001 cluster nodes
命令前面的watch可以每隔一段时间刷新执行结果,方便我们实时监控集群状态变化。
接着,我们故技重施,利用命令让某个master节点休眠。比如这里我们让7002节点休眠,打开一个新的ssh控制台,输入下面命令:
docker exec -it r2 redis-cli -p 7002 DEBUG sleep 30
可以观察到,集群发现7002宕机,标记为下线:
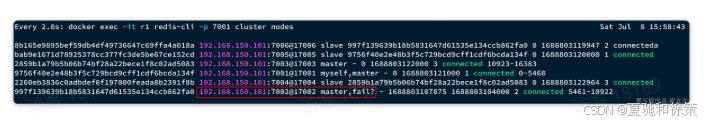
过了一段时间后,7002原本的小弟7006变成了master:
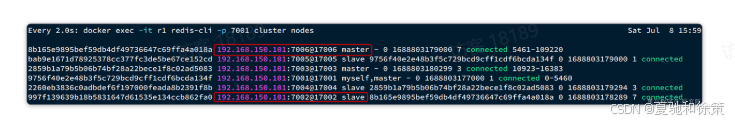
而7002被标记为slave,而且其master正好是7006,主从地位互换。
3.4.总结
Redis分片集群如何判断某个key应该在哪个实例?
-
将16384个插槽分配到不同的实例
-
根据key计算哈希值,对16384取余
-
余数作为插槽,寻找插槽所在实例即可
如何将同一类数据固定的保存在同一个Redis实例?
-
Redis计算key的插槽值时会判断key中是否包含
{},如果有则基于{}内的字符计算插槽 -
数据的key中可以加入
{类型},例如key都以{typeId}为前缀,这样同类型数据计算的插槽一定相同
3.5.Java客户端连接分片集群(选学)
RedisTemplate底层同样基于lettuce实现了分片集群的支持,而使用的步骤与哨兵模式基本一致,参考2.5节:
1)引入redis的starter依赖
2)配置分片集群地址
3)配置读写分离
与哨兵模式相比,其中只有分片集群的配置方式略有差异,如下:
spring:
  redis:
    cluster:
      nodes:
        - 192.168.150.101:7001
        - 192.168.150.101:7002
        - 192.168.150.101:7003
        - 192.168.150.101:8001
        - 192.168.150.101:8002
        - 192.168.150.101:8003
4.Redis数据结构
我们常用的Redis数据类型有5种,分别是:
-
String
-
List
-
Set
-
SortedSet
-
Hash
还有一些高级数据类型,比如Bitmap、HyperLogLog、GEO等,其底层都是基于上述5种基本数据类型。因此在Redis的源码中,其实只有5种数据类型。
4.1.RedisObject
不管是任何一种数据类型,最终都会封装为RedisObject格式,它是一种结构体,C语言中的一种结构,可以理解为Java中的类。
结构大概是这样的:
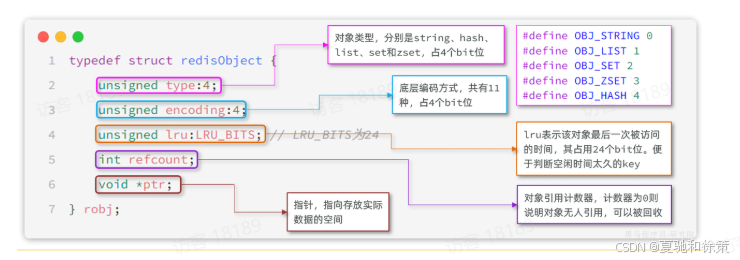
可以看到整个结构体中并不包含真实的数据,仅仅是对象头信息,内存占用的大小为4+4+24+32+64 = 128bit
也就是16字节,然后指针ptr指针指向的才是真实数据存储的内存地址。所以RedisObject的内存开销是很大的。
属性中的encoding就是当前对象底层采用的数据结构或编码方式,可选的有11种之多:
编号 |
编码方式 |
说明 |
|---|---|---|
|
0 |
OBJ_ENCODING_RAW |
raw编码动态字符串 |
|
1 |
OBJ_ENCODING_INT |
long类型的整数的字符串 |
|
2 |
OBJ_ENCODING_HT |
hash表(也叫dict) |
|
3 |
OBJ_ENCODING_ZIPMAP |
已废弃 |
|
4 |
OBJ_ENCODING_LINKEDLIST |
双端链表 |
|
5 |
OBJ_ENCODING_ZIPLIST |
压缩列表 |
|
6 |
OBJ_ENCODING_INTSET |
整数集合 |
|
7 |
OBJ_ENCODING_SKIPLIST |
跳表 |
|
8 |
OBJ_ENCODING_EMBSTR |
embstr编码的动态字符串 |
|
9 |
OBJ_ENCODING_QUICKLIST |
快速列表 |
|
10 |
OBJ_ENCODING_STREAM |
Stream流 |
|
11 |
OBJ_ENCODING_LISTPACK |
紧凑列表 |
Redis中的5种不同的数据类型采用的底层数据结构和编码方式如下:
数据类型 |
编码方式 |
|---|---|
|
STRING |
|
|
LIST |
|
|
SET |
|
|
ZSET |
|
|
HASH |
|
4.2.SkipList
SkipList(跳表)首先是链表,但与传统链表相比有几点差异:
-
元素按照升序排列存储
-
节点可能包含多个指针,指针跨度不同。
传统链表只有指向前后元素的指针,因此只能顺序依次访问。如果查找的元素在链表中间,查询的效率会比较低。而SkipList则不同,它内部包含跨度不同的多级指针,可以让我们跳跃查找链表中间的元素,效率非常高。
其结构如图:
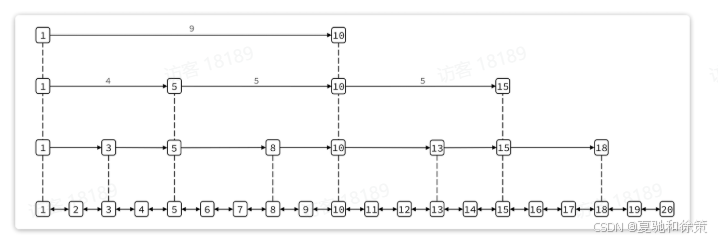
我们可以看到1号元素就有指向3、5、10的多个指针,查询时就可以跳跃查找。例如我们要找大小为14的元素,查找的流程是这样的:
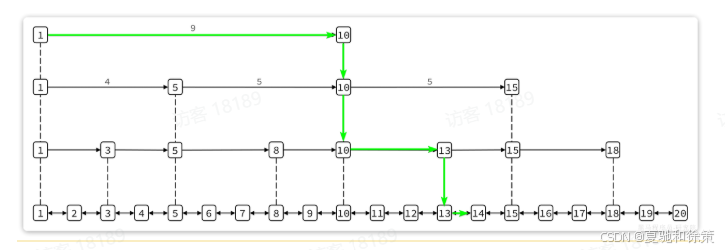
-
首先找元素1节点最高级指针,也就是4级指针,起始元素大小为1,指针跨度为9,可以判断出目标元素大小为10。由于14比10大,肯定要从10这个元素向下接着找。
-
找到10这个元素,发现10这个元素的最高级指针跨度为5,判断出目标元素大小为15,大于14,需要判断下级指针
-
10这个元素的2级指针跨度为3,判断出目标元素为13,小于14,因此要基于元素13接着找
-
13这个元素最高级级指针跨度为2,判断出目标元素为15,比14大,需要判断下级指针。
-
13的下级指针跨度为1,因此目标元素是14,刚好于目标一致,找到。
这种多级指针的查询方式就避免了传统链表的逐个遍历导致的查询效率下降问题。在对有序数据做随机查询和排序时效率非常高。
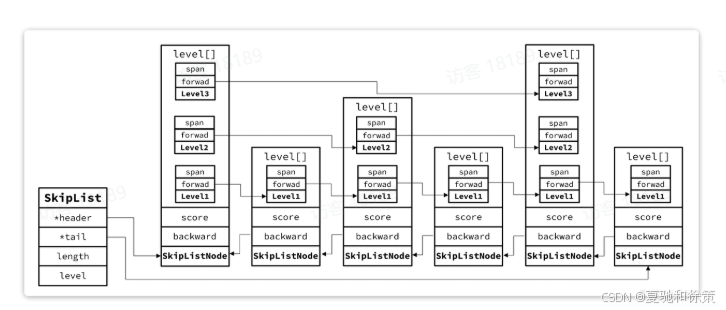
跳表的结构体如下:
typedef struct zskiplist {
    // 头尾节点指针
    struct zskiplistNode *header, *tail;
    // 节点数量
    unsigned long length;
    // 最大的索引层级
    int level;
} zskiplist;
可以看到SkipList主要属性是header和tail,也就是头尾指针,因此它是支持双向遍历的。
跳表中节点的结构体如下:
typedef struct zskiplistNode {
    sds ele; // 节点存储的字符串
    double score;// 节点分数,排序、查找用
    struct zskiplistNode *backward; // 前一个节点指针
    struct zskiplistLevel {
        struct zskiplistNode *forward; // 下一个节点指针
        unsigned long span; // 索引跨度
    } level[]; // 多级索引数组
} zskiplistNode;
每个节点中都包含ele和score两个属性,其中score是得分,也就是节点排序的依据。ele则是节点存储的字符串数据指针。
其内存结构如下:
4.3.SortedSet
面试题:Redis的SortedSet底层的数据结构是怎样的?
答:SortedSet是有序集合,底层的存储的每个数据都包含element和score两个值。score是得分,element则是字符串值。SortedSet会根据每个element的score值排序,形成有序集合。
它支持的操作很多,比如:
-
根据element查询score值
-
按照score值升序或降序查询element
要实现根据element查询对应的score值,就必须实现element与score之间的键值映射。SortedSet底层是基于HashTable来实现的。
要实现对score值排序,并且查询效率还高,就需要有一种高效的有序数据结构,SortedSet是基于跳表实现的。
加分项:因为SortedSet底层需要用到两种数据结构,对内存占用比较高。因此Redis底层会对SortedSet中的元素大小做判断。如果元素大小小于128且每个元素都小于64字节,SortedSet底层会采用ZipList,也就是压缩列表来代替HashTable和SkipList
不过,ZipList存在连锁更新问题,因此而在Redis7.0版本以后,ZipList又被替换为Listpack(紧凑列表)。
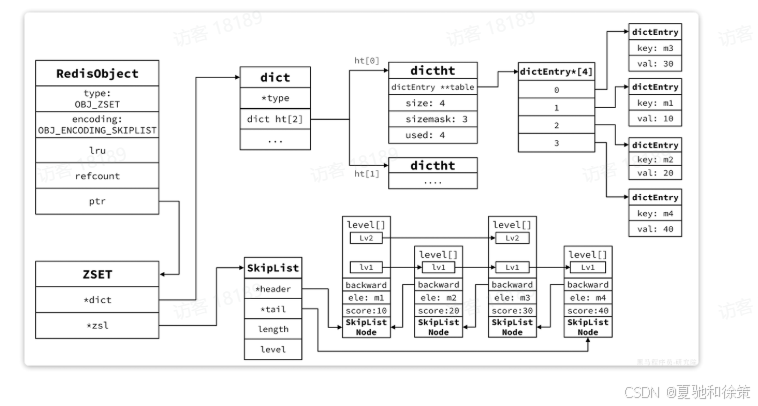
Redis源码中zset,也就是SortedSet的结构体如下:
typedef struct zset {
    dict *dict; // dict,底层就是HashTable
    zskiplist *zsl; // 跳表
} zset;
其内存结构如图:
5.Redis内存回收
Redis之所以性能强,最主要的原因就是基于内存存储。然而单节点的Redis其内存大小不宜过大,会影响持久化或主从同步性能。
我们可以通过修改redis.conf文件,添加下面的配置来配置Redis的最大内存:
maxmemory 1gb
当内存达到上限,就无法存储更多数据了。因此,Redis内部会有两套内存回收的策略:
-
内存过期策略
-
内存淘汰策略
5.1.内存过期处理
存入Redis中的数据可以配置过期时间,到期后再次访问会发现这些数据都不存在了,也就是被过期清理了。
5.1.1.过期命令
Redis中通过expire命令可以给KEY设置TTL(过期时间),例如:
# 写入一条数据 set num 123 # 设置20秒过期时间 expire num 20
不过set命令本身也可以支持过期时间的设置:
# 写入一条数据并设置20s过期时间 set num EX 20
当过期时间到了以后,再去查询数据,会发现数据已经不存在。
5.1.2.过期策略
那么问题来了:
-
Redis如何判断一个KEY是否过期呢?
-
Redis又是何时删除过期KEY的呢?
Redis不管有多少种数据类型,本质是一个KEY-VALUE的键值型数据库,而这种键值映射底层正式基于HashTable来实现的,在Redis中叫做Dict.
来看下RedisDB的底层源码:
typedef struct redisDb {
    dict dict;                 / The keyspace for this DB , 也就是存放KEY和VALUE的哈希表*/
    dict *expires;              /* 同样是哈希表,但保存的是设置了TTL的KEY,及其到期时间*/
    dict *blocking_keys;        /* Keys with clients waiting for data (BLPOP)*/
    dict *ready_keys;           /* Blocked keys that received a PUSH */
    dict *watched_keys;         /* WATCHED keys for MULTI/EXEC CAS /
    int id;                     / Database ID, 0 ~ 15 /
    long long avg_ttl;          / Average TTL, just for stats /
    unsigned long expires_cursor; / Cursor of the active expire cycle. */
    list *defrag_later;         /* List of key names to attempt to defrag one by one, gradually. */
} redisDb;
现在回答第一个问题:
面试题:Redis如何判断KEY是否过期呢?
答:在Redis中会有两个Dict,也就是HashTable,其中一个记录KEY-VALUE键值对,另一个记录KEY和过期时间。要判断一个KEY是否过期,只需要到记录过期时间的Dict中根据KEY查询即可。
Redis是何时删除过期KEY的呢?
Redis并不会在KEY过期时立刻删除KEY,因为要实现这样的效果就必须给每一个过期的KEY设置时钟,并监控这些KEY的过期状态。无论对CPU还是内存都会带来极大的负担。
Redis的过期KEY删除策略有两种:
-
惰性删除
-
周期删除
惰性删除,顾明思议就是过期后不会立刻删除。那在什么时候删除呢?
Redis会在每次访问KEY的时候判断当前KEY有没有设置过期时间,如果有,过期时间是否已经到期。对应的源码如下:
// db.c
// 寻找要执行写操作的key
robj *lookupKeyWriteWithFlags(redisDb *db, robj *key, int flags) {
    // 检查key是否过期,如果过期则删除
    expireIfNeeded(db,key);
    return lookupKey(db,key,flags);
}

// 寻找要执行读操作的key
robj *lookupKeyReadWithFlags(redisDb *db, robj *key, int flags) {
    robj *val;
    // 检查key是否过期,如果过期则删除
    if (expireIfNeeded(db,key) == 1) {
        // 略 ...
    }
    val = lookupKey(db,key,flags);
    if (val == NULL)
        goto keymiss;
    server.stat_keyspace_hits++;
    return val;
}
周期删除:顾明思议是通过一个定时任务,周期性的抽样部分过期的key,然后执行删除。
执行周期有两种:
-
SLOW模式:Redis会设置一个定时任务
serverCron(),按照server.hz的频率来执行过期key清理 -
FAST模式:Redis的每个事件循环前执行过期key清理(事件循环就是NIO事件处理的循环)。
SLOW模式规则:
-
① 执行频率受
server.hz影响,默认为10,即每秒执行10次,每个执行周期100ms。 -
② 执行清理耗时不超过一次执行周期的25%,即25ms.
-
③ 逐个遍历db,逐个遍历db中的bucket,抽取20个key判断是否过期
-
④ 如果没达到时间上限(25ms)并且过期key比例大于10%,再进行一次抽样,否则结束
FAST模式规则(过期key比例小于10%不执行):
-
① 执行频率受
beforeSleep()调用频率影响,但两次FAST模式间隔不低于2ms -
② 执行清理耗时不超过1ms
-
③ 逐个遍历db,逐个遍历db中的bucket,抽取20个key判断是否过期
-
④ 如果没达到时间上限(1ms)并且过期key比例大于10%,再进行一次抽样,否则结束
// server.c中处理命令的部分源码
int processCommand(client *c) {
    // ... 略
    if (server.maxmemory && !server.lua_timedout) {
        // 调用performEvictions()方法尝试进行内存淘汰
        int out_of_memory = (performEvictions() == EVICT_FAIL);
        // ... 略
        if (out_of_memory && reject_cmd_on_oom) {
            // 如果内存依然不足,直接拒绝命令
            rejectCommand(c, shared.oomerr);
            return C_OK;
        }
    }
}
5.2.内存淘汰策略
对于某些特别依赖于Redis的项目而言,仅仅依靠过期KEY清理是不够的,内存可能很快就达到上限。因此Redis允许设置内存告警阈值,当内存使用达到阈值时就会主动挑选部分KEY删除以释放更多内存。这叫做内存淘汰机制。
5.2.1.内存淘汰时机
那么问题来了,当内存达到阈值时执行内存淘汰,但问题是Redis什么时候会执去判断内存是否达到预警呢?
Redis每次执行任何命令时,都会判断内存是否达到阈值:
5.2.2.淘汰策略
好了,知道什么时候尝试淘汰了,那具体Redis是如何判断该淘汰哪些Key的呢?
Redis支持8种不同的内存淘汰策略:
-
noeviction: 不淘汰任何key,但是内存满时不允许写入新数据,默认就是这种策略。 -
volatile-ttl: 对设置了TTL的key,比较key的剩余TTL值,TTL越小越先被淘汰 -
allkeys-random:对全体key ,随机进行淘汰。也就是直接从db->dict中随机挑选 -
volatile-random:对设置了TTL的key ,随机进行淘汰。也就是从db->expires中随机挑选。 -
allkeys-lru: 对全体key,基于LRU算法进行淘汰 -
volatile-lru: 对设置了TTL的key,基于LRU算法进行淘汰 -
allkeys-lfu: 对全体key,基于LFU算法进行淘汰 -
volatile-lfu: 对设置了TTL的key,基于LFI算法进行淘汰
比较容易混淆的有两个算法:
-
LRU(
LeastRecentlyUsed),最近最久未使用。用当前时间减去最后一次访问时间,这个值越大则淘汰优先级越高。 -
LFU(
LeastFrequentlyUsed),最少频率使用。会统计每个key的访问频率,值越小淘汰优先级越高。
Redis怎么知道某个KEY的最近一次访问时间或者是访问频率呢?
还记不记得之前讲过的RedisObject的结构?
回忆一下:
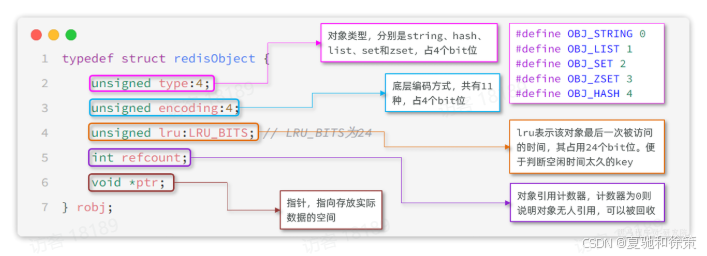
其中的lru就是记录最近一次访问时间和访问频率的。当然,你选择LRU和LFU时的记录方式不同:
-
LRU:以秒为单位记录最近一次访问时间,长度24bit
-
LFU:高16位以分钟为单位记录最近一次访问时间,低8位记录逻辑访问次数
时间就不说了,那么逻辑访问次数又是怎么回事呢?8位无符号数字最大才255,访问次数超过255怎么办?
这就要聊起Redis的逻辑访问次数算法了,LFU的访问次数之所以叫做逻辑访问次数,是因为并不是每次key被访问都计数,而是通过运算:
-
① 生成
[0,1)之间的随机数R -
② 计算
1/(旧次数* lfu_log_factor + 1),记录为P,lfu_log_factor默认为10 -
③ 如果
R<P,则计数器+1,且最大不超过255 -
④ 访问次数会随时间衰减,距离上一次访问时间每隔
lfu_decay_time分钟(默认1) ,计数器-1
显然LFU的基于访问频率的统计更符合我们的淘汰目标,因此官方推荐使用LFU算法。
算法我们弄明白了,不过这里大家要注意一下:Redis中的KEY可能有数百万甚至更多,每个KEY都有自己访问时间或者逻辑访问次数。我们要找出时间最早的或者访问次数最小的,难道要把Redis中所有数据排序?
要知道Redis的内存淘汰是在每次执行命令时处理的。如果每次执行命令都先对全量数据做内存排序,那命令的执行时长肯定会非常长,这是不现实的。
所以Redis采取的是抽样法,即每次抽样一定数量(maxmemory_smples)的key,然后基于内存策略做排序,找出淘汰优先级最高的,删除这个key。这就导致Redis的算法并不是真正的LRU,而是一种基于抽样的近似LRU算法。
不过,在Redis3.0以后改进了这个算法,引入了一个淘汰候选池,抽样的key要与候选池中的key比较淘汰优先级,优先级更高的才会被放入候选池。然后在候选池中找出优先级最高的淘汰掉,这就使算法的结果更接近与真正的LRU算法了。特别是在抽样值较高的情况下(例如10),可以达到与真正的LRU接近的效果。
这也是官方给出的真正LRU与近似LRU的结果对比:
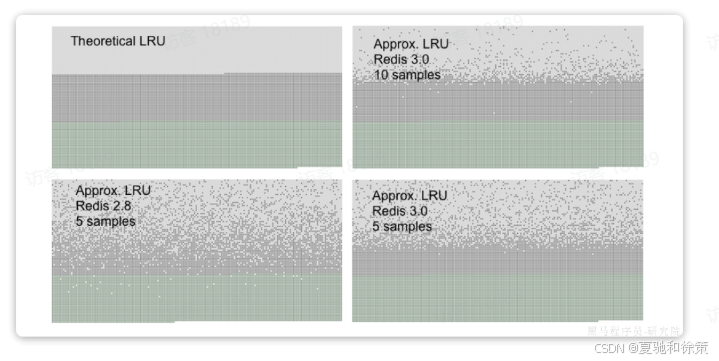
你可以在图表中看到三种颜色的点形成三个不同的带,每个点就是一个加入的KEY。
-
浅灰色带是被驱逐的对象
-
灰色带是没有被驱逐的对象
-
绿色带是被添加的对象
5.3.总结
面试题:Redis如何判断KEY是否过期呢?
答:在Redis中会有两个Dict,也就是HashTable,其中一个记录KEY-VALUE键值对,另一个记录KEY和过期时间。要判断一个KEY是否过期,只需要到记录过期时间的Dict中根据KEY查询即可。
面试题:Redis何时删除过期KEY?如何删除?
答:Redis的过期KEY处理有两种策略,分别是惰性删除和周期删除。
惰性删除是指在每次用户访问某个KEY时,判断KEY的过期时间:如果过期则删除;如果未过期则忽略。
周期删除有两种模式:
-
SLOW模式:通过一个定时任务,定期的抽样部分带有TTL的KEY,判断其是否过期。默认情况下定时任务的执行频率是每秒10次,但每次执行不能超过25毫秒。如果执行抽样后发现时间还有剩余,并且过期KEY的比例较高,则会多次抽样。
-
FAST模式:在Redis每次处理NIO事件之前,都会抽样部分带有TTL的KEY,判断是否过期,因此执行频率较高。但是每次执行时长不能超过1ms,如果时间充足并且过期KEY比例过高,也会多次抽样
面试题:当Redis内存不足时会怎么做?
答:这取决于配置的内存淘汰策略,Redis支持很多种内存淘汰策略,例如LRU、LFU、Random. 但默认的策略是直接拒绝新的写入请求。而如果设置了其它策略,则会在每次执行命令后判断占用内存是否达到阈值。如果达到阈值则会基于配置的淘汰策略尝试进行内存淘汰,直到占用内存小于阈值为止。
面试题:那你能聊聊LRU和LFU吗?
答:LRU是最近最久未使用。Redis的Key都是RedisObject,当启用LRU算法后,Redis会在Key的头信息中使用24个bit记录每个key的最近一次使用的时间lru。每次需要内存淘汰时,就会抽样一部分KEY,找出其中空闲时间最长的,也就是now - lru结果最大的,然后将其删除。如果内存依然不足,就重复这个过程。
由于采用了抽样来计算,这种算法只能说是一种近似LRU算法。因此在Redis4.0以后又引入了LFU算法,这种算法是统计最近最少使用,也就是按key的访问频率来统计。当启用LFU算法后,Redis会在key的头信息中使用24bit记录最近一次使用时间和逻辑访问频率。其中高16位是以分钟为单位的最近访问时间,后8位是逻辑访问次数。与LFU类似,每次需要内存淘汰时,就会抽样一部分KEY,找出其中逻辑访问次数最小的,将其淘汰。
面试题:逻辑访问次数是如何计算的?
答:由于记录访问次数的只有8bit,即便是无符号数,最大值只有255,不可能记录真实的访问次数。因此Redis统计的其实是逻辑访问次数。这其中有一个计算公式,会根据当前的访问次数做计算,结果要么是次数+1,要么是次数不变。但随着当前访问次数越大,+1的概率也会越低,并且最大值不超过255.
除此以外,逻辑访问次数还有一个衰减周期,默认为1分钟,即每隔1分钟逻辑访问次数会-1。这样逻辑访问次数就能基本反映出一个key的访问热度了。
6.缓存问题
Redis经常被用作缓存,而缓存在使用的过程中存在很多问题需要解决。例如:
-
缓存的数据一致性问题
-
缓存击穿
-
缓存穿透
-
缓存雪崩
6.1.缓存一致性
我们先看下目前企业用的最多的缓存模型。缓存的通用模型有三种:
-
Cache Aside:有缓存调用者自己维护数据库与缓存的一致性。即:-
查询时:命中则直接返回,未命中则查询数据库并写入缓存
-
更新时:更新数据库并删除缓存,查询时自然会更新缓存
-
-
Read/Write Through:数据库自己维护一份缓存,底层实现对调用者透明。底层实现:-
查询时:命中则直接返回,未命中则查询数据库并写入缓存
-
更新时:判断缓存是否存在,不存在直接更新数据库。存在则更新缓存,同步更新数据库
-
-
Write Behind Cahing:读写操作都直接操作缓存,由线程异步的将缓存数据同步到数据库
目前企业中使用最多的就是Cache Aside模式,因为实现起来非常简单。但缺点也很明显,就是无法保证数据库与缓存的强一致性。为什么呢?我们一起来分析一下。
Cache Aside的写操作是要在更新数据库的同时删除缓存,那为什么不选择更新数据库的同时更新缓存,而是删除呢?
原因很简单,假如一段时间内无人查询,但是有多次更新,那这些更新都属于无效更新。采用删除方案也就是延迟更新,什么时候有人查询了,什么时候更新。
那到底是先更新数据库再删除缓存,还是先删除缓存再更新数据库呢?
现在假设有两个线程,一个来更新数据,一个来查询数据。我们分别分析两种策略的表现。
我们先分析策略1,先更新数据库再删除缓存:
正常情况
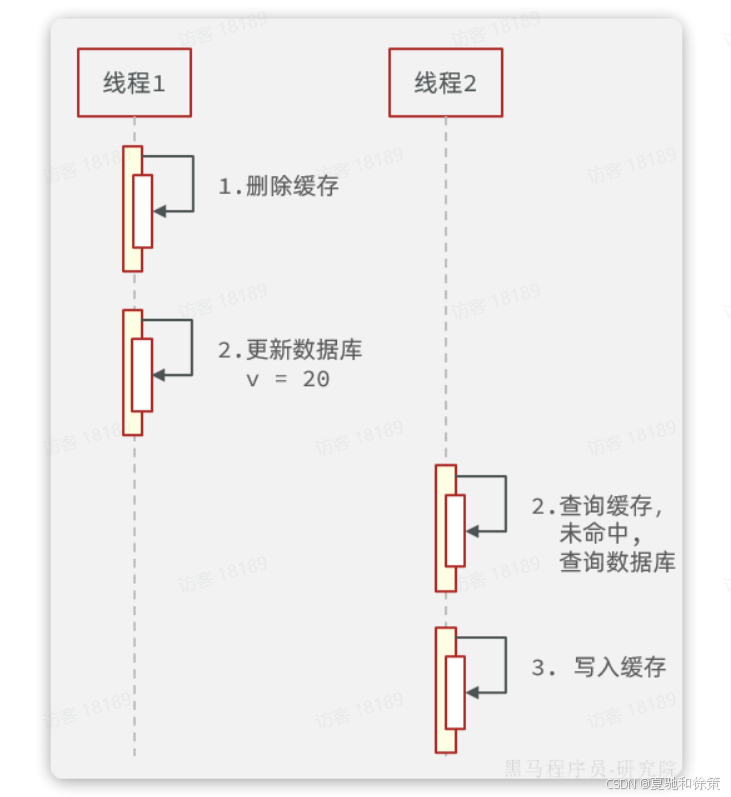
异常情况
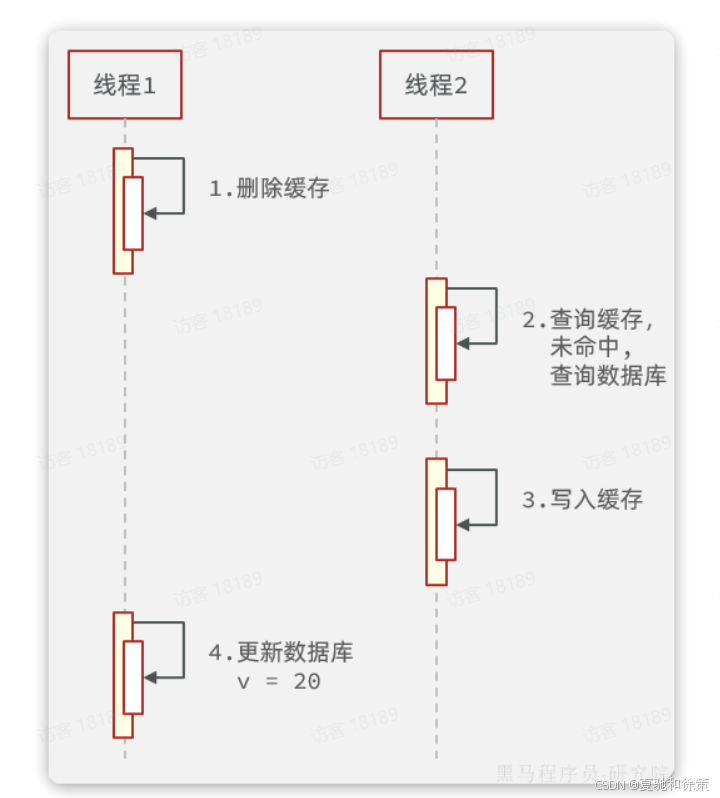
异常情况说明:
-
线程1删除缓存后,还没来得及更新数据库,
-
此时线程2来查询,发现缓存未命中,于是查询数据库,写入缓存。由于此时数据库尚未更新,查询的是旧数据。也就是说刚才的删除白删了,缓存又变成旧数据了。
-
然后线程1更新数据库,此时数据库是新数据,缓存是旧数据
由于更新数据库的操作本身比较耗时,在期间有线程来查询数据库并更新缓存的概率非常高。因此不推荐这种方案。
再来看策略2,先更新数据库再删除缓存:
正常情况
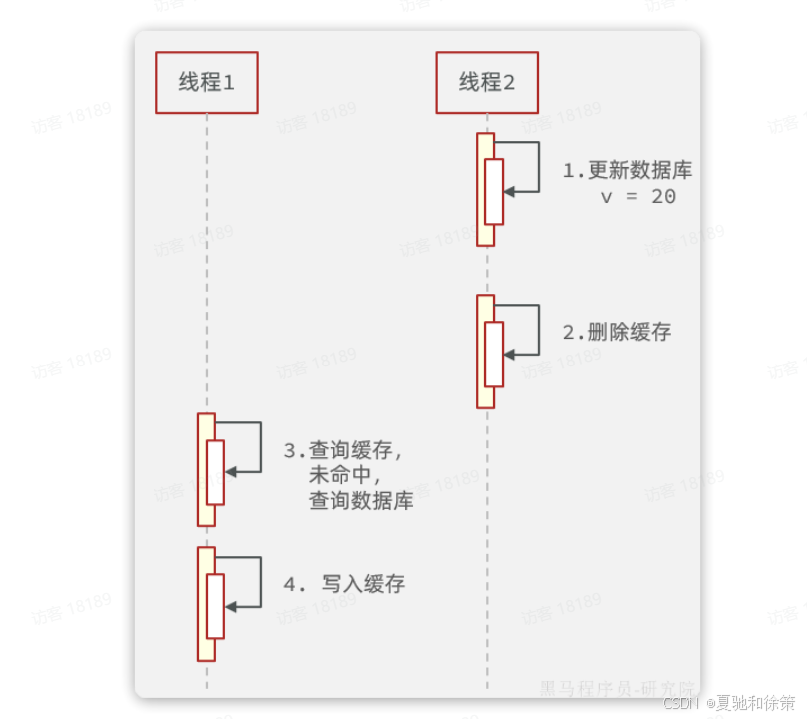
异常情况
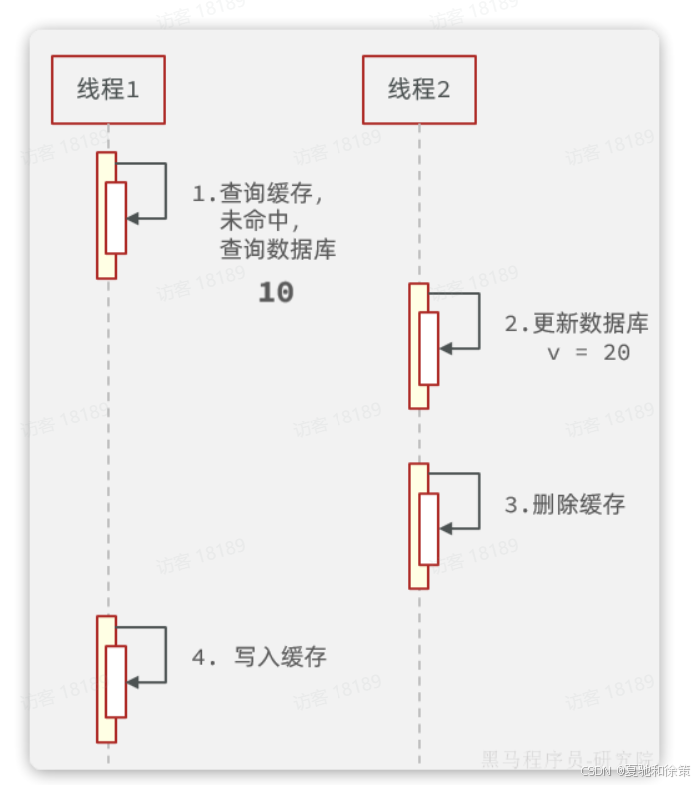
异常情况说明:
-
线程1查询缓存未命中,于是去查询数据库,查询到旧数据
-
线程1将数据写入缓存之前,线程2来了,更新数据库,删除缓存
-
线程1执行写入缓存的操作,写入旧数据
可以发现,异常状态发生的概率极为苛刻,线程1必须是查询数据库已经完成,但是缓存尚未写入之前。线程2要完成更新数据库同时删除缓存的两个操作。要知道线程1执行写缓存的速度在毫秒之间,速度非常快,在这么短的时间要完成数据库和缓存的操作,概率非常之低。
综上,添加缓存的目的是为了提高系统性能,而你要付出的代价就是缓存与数据库的强一致性。如果你要求数据库与缓存的强一致,那就需要加锁避免并行读写。但这就降低了性能,与缓存的目标背道而驰。
因此不管任何缓存同步方案最终的目的都是尽可能保证最终一致性,降低发生不一致的概率。我们采用先更新数据库再删除缓存的方案,已经将这种概率降到足够低,目的已经达到了。
同时我们还要给缓存加上过期时间,一旦发生缓存不一致,当缓存过期后会重新加载,数据最终还是能保证一致。这就可以作为一个兜底方案。
6.2.缓存穿透
什么是缓存穿透呢?
我们知道,当请求查询缓存未命中时,需要查询数据库以加载缓存。但是大家思考一下这样的场景:
如果我访问一个数据库中也不存在的数据。会出现什么现象?
由于数据库中不存在该数据,那么缓存中肯定也不存在。因此不管请求该数据多少次,缓存永远不可能建立,请求永远会直达数据库。
假如有不怀好意的人,开启很多线程频繁的访问一个数据库中也不存在的数据。由于缓存不可能生效,那么所有的请求都访问数据库,可能就会导致数据库因过高的压力而宕机。
解决这个问题有两种思路:
-
缓存空值
-
布隆过滤器
6.2.1.缓存空值
简单来说,就是当我们发现请求的数据即不存在与缓存,也不存在与数据库时,将空值缓存到Redis,避免频繁查询数据库。实现思路如下:
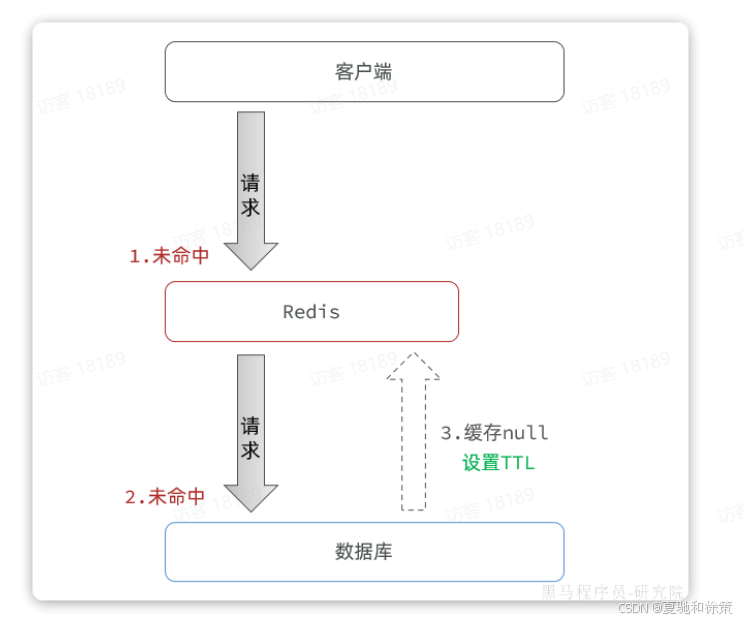
优点:
-
实现简单,维护方便
缺点:
-
额外的内存消耗
6.2.2.布隆过滤器
布隆过滤是一种数据统计的算法,用于检索一个元素是否存在一个集合中。
一般我们判断集合中是否存在元素,都会先把元素保存到类似于树、哈希表等数据结构中,然后利用这些结构查询效率高的特点来快速匹配判断。但是随着元素数量越来越多,这种模式对内存的占用也越来越大,检索的速度也会越来越慢。而布隆过滤的内存占用小,查询效率却很高。
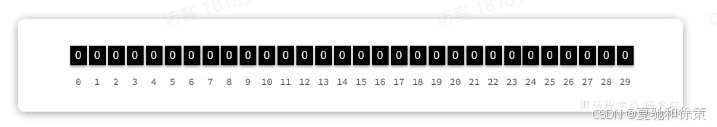
布隆过滤首先需要一个很长的bit数组,默认数组中每一位都是0.
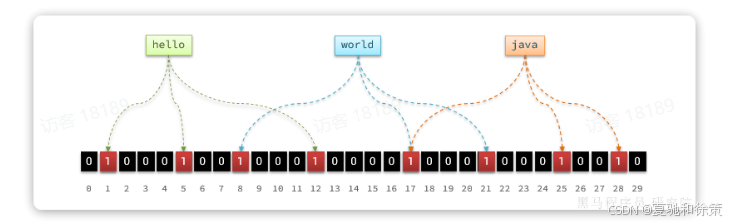
然后还需要K个hash函数,将元素基于这些hash函数做运算的结果映射到bit数组的不同位置,并将这些位置置为1,例如现在k=3:
-
hello经过运算得到3个角标:1、5、12 -
world经过运算得到3个角标:8、17、21 -
java经过运算得到3个角标:17、25、28
则需要将每个元素对应角标位置置为1:
此时,我们要判断元素是否存在,只需要再次基于K个hash函数做运算, 得到K个角标,判断每个角标的位置是不是1:
-
只要全是1,就证明元素存在
-
任意位置为0,就证明元素一定不存在
假如某个元素本身并不存在,也没添加到布隆过滤器过。但是由于存在hash碰撞的可能性,这就会出现这个元素计算出的角标已经被其它元素置为1的情况。那么这个元素也会被误判为已经存在。
因此,布隆过滤器的判断存在误差:
-
当布隆过滤器认为元素不存在时,它肯定不存在
-
当布隆过滤器认为元素存在时,它可能存在,也可能不存在
当bit数组越大、Hash函数K越复杂,K越大时,这个误判的概率也就越低。由于采用bit数组来标示数据,即便4,294,967,296个bit位,也只占512mb的空间
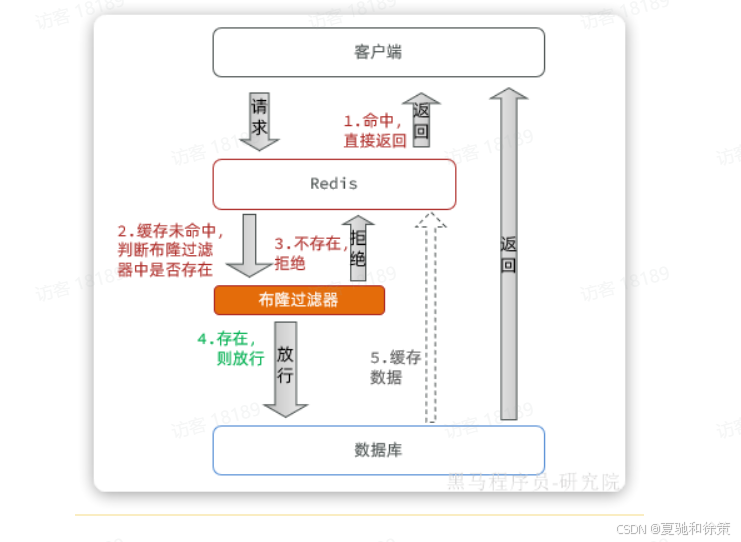
我们可以把数据库中的数据利用布隆过滤器标记出来,当用户请求缓存未命中时,先基于布隆过滤器判断。如果不存在则直接拒绝请求,存在则去查询数据库。尽管布隆过滤存在误差,但一般都在0.01%左右,可以大大减少数据库压力。
使用布隆过滤后的流程如下:
6.3.缓存雪崩
缓存雪崩是指在同一时段大量的缓存key同时失效或者Redis服务宕机,导致大量请求到达数据库,带来巨大压力。
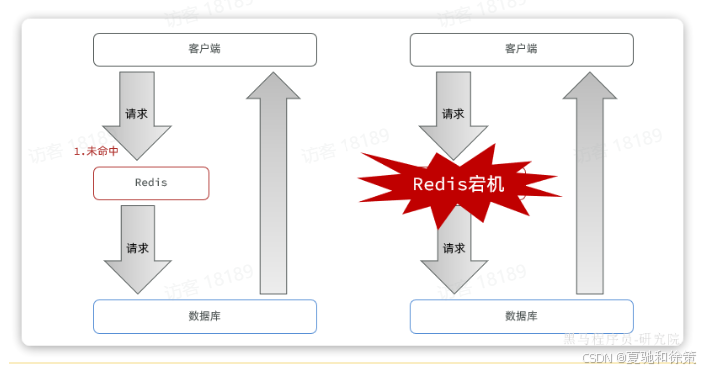
常见的解决方案有:
-
给不同的Key的TTL添加随机值,这样KEY的过期时间不同,不会大量KEY同时过期
-
利用Redis集群提高服务的可用性,避免缓存服务宕机
-
给缓存业务添加降级限流策略
-
给业务添加多级缓存,比如先查询本地缓存,本地缓存未命中再查询Redis,Redis未命中再查询数据库。即便Redis宕机,也还有本地缓存可以抗压力
6.4.缓存击穿
缓存击穿问题也叫热点Key问题,就是一个被高并发访问并且缓存重建业务较复杂的key突然失效了,无数的请求访问会在瞬间给数据库带来巨大的冲击。
由于我们采用的是Cache Aside模式,当缓存失效时需要下次查询时才会更新缓存。当某个key缓存失效时,如果这个key是热点key,并发访问量比较高。就会在一瞬间涌入大量请求,都发现缓存未命中,于是都会去查询数据库,尝试重建缓存。可能一瞬间就把数据库压垮了。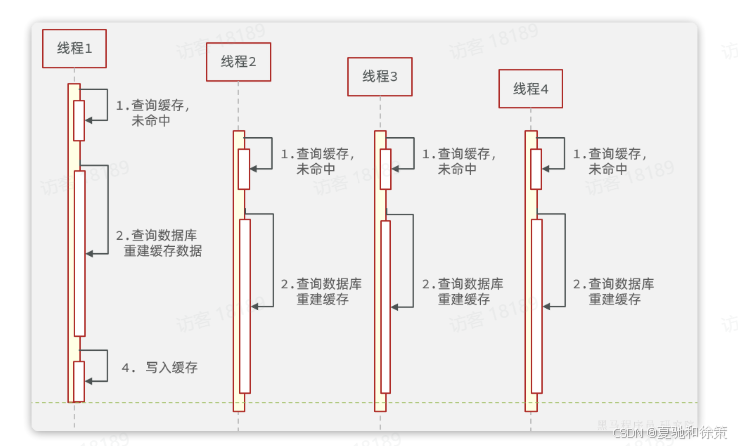
如上图所示:
-
线程1发现缓存未命中,准备查询数据库,重建缓存,但是因为数据比较复杂,导致查询数据库耗时较久
-
在这个过程中,一下次来了3个新的线程,就都会发现缓存未命中,都去查询数据库
-
数据库压力激增
常见的解决方案有两种:
-
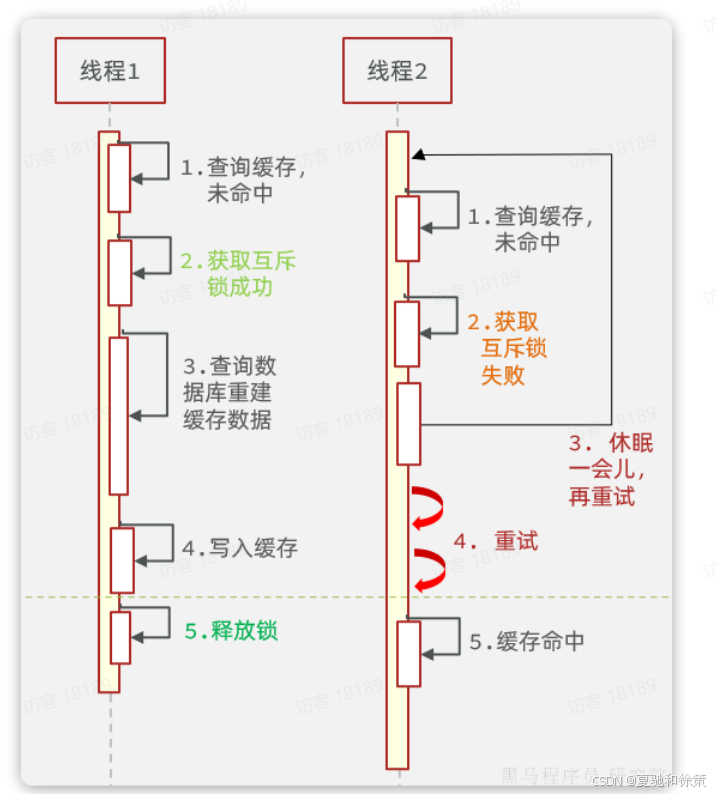
互斥锁:给重建缓存逻辑加锁,避免多线程同时指向
-
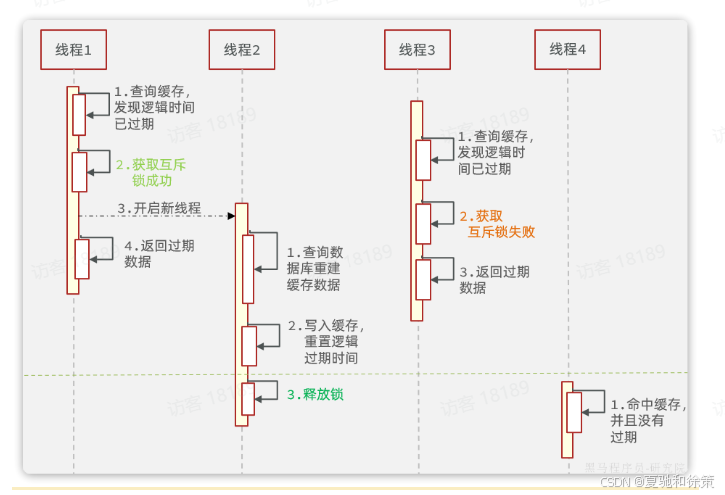
逻辑过期:热点key不要设置过期时间,在活动结束后手动删除。
基于互斥锁的方案如图:
逻辑过期的思路如图:
6.5.面试总结
面试题:如何保证缓存的双写一致性?
答:缓存的双写一致性很难保证强一致,只能尽可能降低不一致的概率,确保最终一致。我们项目中采用的是Cache Aside模式。简单来说,就是在更新数据库之后删除缓存;在查询时先查询缓存,如果未命中则查询数据库并写入缓存。同时我们会给缓存设置过期时间作为兜底方案,如果真的出现了不一致的情况,也可以通过缓存过期来保证最终一致。
追问:为什么不采用延迟双删机制?
答:延迟双删的第一次删除并没有实际意义,第二次采用延迟删除主要是解决数据库主从同步的延迟问题,我认为这是数据库主从的一致性问题,与缓存同步无关。既然主节点数据已经更新,Redis的缓存理应更新。而且延迟双删会增加缓存业务复杂度,也没能完全避免缓存一致性问题,投入回报比太低。
面试题:如何解决缓存穿透问题?
答:缓存穿透也可以说是穿透攻击,具体来说是因为请求访问到了数据库不存在的值,这样缓存无法命中,必然访问数据库。如果高并发的访问这样的接口,会给数据库带来巨大压力。
我们项目中都是基于布隆过滤器来解决缓存穿透问题的,当缓存未命中时基于布隆过滤器判断数据是否存在。如果不存在则不去访问数据库。
当然,也可以使用缓存空值的方式解决,不过这种方案比较浪费内存。
面试题:如何解决缓存雪崩问题?
答:缓存雪崩的常见原因有两个,第一是因为大量key同时过期。针对问这个题我们可以可以给缓存key设置不同的TTL值,避免key同时过期。
第二个原因是Redis宕机导致缓存不可用。针对这个问题我们可以利用集群提高Redis的可用性。也可以添加多级缓存,当Redis宕机时还有本地缓存可用。
面试题:如何解决缓存击穿问题?
答:缓存击穿往往是由热点Key引起的,当热点Key过期时,大量请求涌入同时查询,发现缓存未命中都会去访问数据库,导致数据库压力激增。解决这个问题的主要思路就是避免多线程并发去重建缓存,因此方案有两种。
第一种是基于互斥锁,当发现缓存未命中时需要先获取互斥锁,再重建缓存,缓存重建完成释放锁。这样就可以保证缓存重建同一时刻只会有一个线程执行。不过这种做法会导致缓存重建时性能下降严重。
第二种是基于逻辑过期,也就是不给热点Key设置过期时间,而是给数据添加一个过期时间的字段。这样热点Key就不会过期,缓存中永远有数据。
查询到数据时基于其中的过期时间判断key是否过期,如果过期开启独立新线程异步的重建缓存,而查询请求先返回旧数据即可。当然,这个过程也要加互斥锁,但由于重建缓存是异步的,而且获取锁失败也无需等待,而是返回旧数据,这样性能几乎不受影响。
需要注意的是,无论是采用哪种方式,在获取互斥锁后一定要再次判断缓存是否命中,做dubbo check. 因为当你获取锁成功时,可能是在你之前有其它线程已经重建缓存了。
理论理解
Redis,作为一个高效的内存数据存储系统,广泛应用于缓存、消息队列等场景,特别是在微服务架构中,常常被用于提升数据访问速度和系统性能。它的核心功能不仅仅包括高并发读写的支持,还包括数据的高可用性和分布式扩展能力。在 Redis 面试中,面试官往往关注的是其主从架构、哨兵机制、分片集群、数据结构以及内存管理等方面的深入理解。
1. Redis 主从架构
在 Redis 的主从架构中,主节点负责写入操作,从节点则负责读取操作。这种架构的主要优势是读写分离,能够显著提高数据访问的并发能力。然而,主从架构的实现也面临一些问题,例如如何确保主从数据的同步,如何处理主节点故障等。
主从同步主要通过两种方式实现:全量同步和增量同步。全量同步通常在从节点首次与主节点建立连接时发生,而增量同步则是主从节点间数据同步的常态,主要通过 repl_backlog(复制缓冲区)来实现高效的增量同步。
2. Redis 哨兵机制
Redis 的哨兵机制用于解决主从架构中主节点故障时的高可用性问题。当主节点发生故障时,哨兵机制能够自动进行 故障转移,选举一个新的主节点并将其他从节点指向新的主节点,从而保证集群的稳定性。哨兵机制通过心跳检测监控 Redis 节点状态,并在发现主节点不可用时,通过选举机制实现新的主节点的创建。
3. Redis 分片集群
Redis 分片集群解决了单节点 Redis 存储能力和并发能力的限制。通过将数据分散到多个节点,每个节点负责存储数据的一部分,Redis 集群能够横向扩展,提升存储容量和查询性能。Redis 的分片是基于 hash slot 来实现的,每个键值对会根据其哈希值分配到对应的槽,并存储在相应的节点上。
4. Redis 数据结构
Redis 提供了多种数据结构,如 String、List、Set、SortedSet、Hash 等。这些数据结构各自有不同的应用场景。例如,SortedSet 使用 跳表(SkipList) 来保证数据的有序性和高效的查询性能,而 Hash 则是通过哈希表来存储键值对,支持高效的插入和查找操作。
5. Redis 内存管理与回收
Redis 的性能非常依赖于其内存管理机制,尤其是在处理大规模数据时。Redis 提供了多种内存淘汰策略(如 LRU、LFU、TTL 过期等),可以确保在内存达到上限时,自动淘汰不必要的数据,从而保持系统的稳定性。
大厂实战理解
在大规模应用中,Redis 通常作为缓存层解决系统瓶颈,减少数据库的负载,并加速数据访问。大厂如阿里巴巴、京东和腾讯等,会利用 Redis 的 分布式缓存、主从架构、高可用性机制(哨兵和分片)来确保系统的高并发和高可用性。
在微服务架构中,Redis 被广泛应用于 Session 管理、消息队列、分布式锁、缓存一致性等多个场景。随着系统规模的增长,Redis 的高可用性和可扩展性也成为了企业架构设计的重要考虑因素。
Redis 主从架构的实战应用
在实际生产环境中,主从架构可以有效提高系统的 读吞吐量,特别是在 数据查询频繁 的场景下。在大厂的电商平台中,Redis 的主从架构广泛应用于商品信息的查询缓存,通过将热数据存储在从节点上,减轻主节点的负担,提升系统的响应速度。
Redis 哨兵机制的实战应用
对于高可用性至关重要的场景,如在线支付和社交平台,Redis 的 哨兵机制能够保证 主节点故障恢复 的快速响应。大厂会通过设置多个哨兵节点,确保一旦主节点发生故障,能够在最短时间内自动完成故障转移,避免系统出现单点故障。
Redis 分片集群的实战应用
分片集群通常应用于大规模的 数据存储 和 高并发场景,例如,在社交平台、即时通讯、视频流服务等场景中,Redis 分片集群能够实现 数据分布式存储,同时保证数据访问的高效性和可扩展性。
Redis 面试篇 - 大厂面试题
1. Redis 主从同步的工作原理是什么?
答:Redis 的主从同步通过全量同步和增量同步两种方式完成。在主从节点初次建立连接时,会进行全量同步,将主节点的数据完全复制到从节点。当数据发生变化时,主节点会将变更的数据同步到从节点,这个过程通过 增量同步 来实现。增量同步利用 repl_backlog(复制缓冲区)记录主节点的数据变动,保证从节点能同步到最新的数据。
面试考察点:
-
主从同步的过程
-
全量同步与增量同步的区别
-
repl_backlog的作用
2. Redis 如何实现主从架构的读写分离?
答:Redis 主从架构通过读写分离提高并发性能。主节点负责写操作(SET、DEL 等),从节点负责读操作(GET)。客户端需要根据操作类型路由请求,将写请求发送到主节点,将读请求发送到从节点。这样可以通过增加从节点来扩展系统的读取能力,减轻主节点的负担。
面试考察点:
-
读写分离的实现方式
-
读写分离对性能的提升
-
Redis 客户端如何路由请求
3. Redis 哨兵机制是如何实现高可用性的?
答:Redis 哨兵机制用于监控 Redis 节点的状态,当主节点发生故障时,哨兵会自动进行故障转移(failover)。哨兵通过心跳检测定期监控各个节点的状态,若发现主节点不可用,则通过选举机制选择一个从节点升级为新的主节点,并将其他从节点指向新的主节点,从而保证集群的高可用性。
面试考察点:
-
哨兵机制的工作原理
-
哨兵如何实现主节点故障检测与故障转移
-
哨兵节点如何选举新的主节点
4. Redis 分片集群是如何实现的?
答:Redis 分片集群通过将数据分散到多个 Redis 节点上,来实现水平扩展。Redis 使用 hash slot 将所有数据分成 16384 个槽,每个槽被分配给不同的节点。客户端在进行数据访问时,先根据键值计算出哈希值,并通过哈希值映射到对应的槽上,然后访问对应的节点。Redis 集群会自动管理分片的分配和数据的迁移。
面试考察点:
-
Redis 分片的工作原理
-
hash slot 和数据分配的关系
-
集群管理和节点间数据迁移的实现
5. Redis 如何保证数据的持久化?
答:Redis 提供了两种持久化机制:RDB(Redis 数据库快照)和 AOF(Append Only File)。RDB 会定期将数据快照保存到磁盘中,而 AOF 会记录每一个写操作并将其追加到日志文件中。通过这两种方式,Redis 能够在重启后恢复数据。
-
RDB:通过设置
save配置项来指定保存快照的条件,适用于对性能要求高的场景,但可能会丢失一些数据。 -
AOF:通过记录每个写操作来保证数据的完全持久化,可以通过配置
appendfsync策略来控制写入频率,适用于对数据一致性要求更高的场景。
面试考察点:
-
RDB 和 AOF 的区别与优缺点
-
数据持久化策略的选择依据
-
持久化对 Redis 性能的影响
6. Redis 是如何处理缓存雪崩问题的?
答:缓存雪崩是指大量缓存键在同一时间失效,导致大量请求直接访问数据库,给数据库带来巨大的压力。常见的解决方案有:
-
设置不同的 TTL:通过为不同缓存设置不同的过期时间,避免同一时刻大量缓存同时失效。
-
多级缓存:在 Redis 之上引入本地缓存,如本地内存缓存(如 Guava Cache),当 Redis 缓存失效时,首先尝试从本地缓存获取数据,减少对数据库的访问压力。
-
加锁机制:当缓存失效时,使用互斥锁(如 Redisson)避免多个请求同时去查询数据库。
面试考察点:
-
缓存雪崩的原因
-
缓解缓存雪崩的策略
-
Redis 高可用性设计
7. Redis 的 LRU 和 LFU 算法有何区别?
答:Redis 提供了两种内存淘汰策略:LRU(Least Recently Used) 和 LFU(Least Frequently Used)。
-
LRU:淘汰最近最少使用的键。每次访问一个键时,Redis 会更新其最近使用的时间戳,淘汰最近最少使用的键。
-
LFU:淘汰访问频率最低的键。每个键会记录访问次数,Redis 会根据访问频率来淘汰键,淘汰最少访问的键。
在实际使用中,LRU 适合频繁访问的缓存,LFU 适合长期缓存且访问较少的数据。
面试考察点:
-
LRU 和 LFU 的适用场景
-
Redis 内存淘汰策略的实现方式
-
选择淘汰策略时的考虑因素
8. Redis 如何解决缓存穿透问题?
答:缓存穿透是指查询不存在的数据,导致请求始终访问数据库。常见的解决方案有:
-
布隆过滤器:通过布隆过滤器判断某个键是否存在,若不存在,则直接拒绝请求,避免访问数据库。
-
缓存空值:当请求查询的值不存在时,将空值缓存到 Redis 中,避免同一请求频繁访问数据库。
面试考察点:
-
缓存穿透的定义
-
布隆过滤器的实现原理
-
缓存空值的优缺点
9. Redis 数据持久化的方式是什么?如何选择合适的持久化策略?
答:Redis 支持 RDB(快照) 和 AOF(追加文件) 两种持久化方式。选择合适的持久化策略取决于以下因素:
-
RDB:适用于需要高性能的场景,能够定期保存数据快照,但可能会丢失一定的数据。
-
AOF:适用于对数据持久化要求高的场景,可以记录每一个写操作,提供更高的数据可靠性,但可能会增加磁盘 IO 开销。
面试考察点:
-
RDB 和 AOF 的优缺点
-
持久化策略的选择依据
-
如何平衡数据可靠性与性能之间的关系
10. Redis 分片集群的容错机制是什么?
答:Redis 集群通过 数据分片 将数据分布到不同的节点上。集群通过 hash slots 将数据划分为 16384 个槽,每个槽由不同的主节点管理。为了保证容错性,每个主节点都有一个从节点,主节点宕机时,Redis 集群会自动将从节点提升为主节点,确保集群能够继续提供服务。
面试考察点:
-
Redis 分片集群的架构
-
如何处理主节点宕机
-
数据恢复机制
Redis 面试篇 - 大厂场景题
1. 场景一:电商平台的商品缓存
背景:假设你在一家电商平台工作,需要设计一个商品信息缓存系统。每个商品有一个详细信息页面,包括价格、库存、描述等信息。该页面访问量较大,查询商品详情的操作频繁。如何利用 Redis 缓存来提升系统性能?
问题:
-
如何设计 Redis 缓存来减少数据库访问压力?
-
如果商品信息更新,如何确保缓存中的数据是最新的?
-
如何避免缓存击穿、缓存雪崩和缓存穿透问题?
解答:
-
缓存设计:可以使用 Redis 存储商品信息的详情页缓存,设置合理的 TTL(过期时间),让缓存内容在一定时间后自动失效。商品信息的 ID 可以作为 Redis 的 key,商品的 详细信息 作为 value 存储。
-
更新缓存:当商品信息发生变更时(例如价格或库存变动),可以通过 发布订阅 或 消息队列(如 Kafka)来通知缓存更新。也可以在更新数据库的同时,删除缓存,确保下一次访问时缓存重新加载。
-
解决缓存问题:
-
缓存击穿:使用互斥锁来防止多个请求同时查询并修改缓存。
-
缓存雪崩:为每个商品设置不同的 TTL 时间,避免大量商品缓存同时失效。
-
缓存穿透:使用 布隆过滤器 来判断商品是否存在,避免无效请求访问数据库。
-
2. 场景二:社交平台的点赞功能
背景:假设你在一家社交平台工作,用户可以对帖子进行点赞。每个帖子都有一个 点赞数,你需要设计一个高效的 Redis 缓存系统来处理这个需求。如何设计 Redis 系统来高效地处理点赞数的增减操作?
问题:
-
如何使用 Redis 实现点赞数的高效增减?
-
如何保证点赞数的 准确性 和 实时性?
-
如何处理大量并发的点赞请求?
解答:
-
点赞数存储:使用 Redis 的 string 类型 来存储每个帖子的点赞数,使用帖子 ID 作为 Redis key。例如,
"post:<post_id>:likes"作为键,点赞数作为值。 -
点赞数操作:当用户点赞时,通过 Redis 提供的 INCR 命令(原子操作)增加点赞数;用户取消点赞时,可以使用 DECR 命令来减少点赞数。
-
并发控制:利用 Redis 的原子操作来保证多用户并发点赞时,数据的准确性。Redis 本身支持高并发,使用 INCR 和 DECR 操作可以有效地处理大量并发请求。
-
实时性:由于 Redis 是内存数据库,更新操作会立刻反映在缓存中,确保点赞数的实时性。
3. 场景三:限流控制
背景:你正在开发一个 API 服务,要求每个用户每秒只能访问该 API 一次。如果用户在短时间内多次访问,系统应该拒绝该请求并返回“请求过于频繁”的错误信息。如何使用 Redis 来实现这一限流策略?
问题:
-
如何使用 Redis 来限制用户的访问频率?
-
如何设计 Redis 数据结构来实现限流控制?
-
如何避免 Redis 被滥用?例如,当 Redis 服务宕机时,系统能否正常工作?
解答:
-
限流设计:使用 Redis 的 string 类型来记录每个用户最近一次请求的时间。每次用户请求时,通过
GET获取当前时间与上次请求时间的差值,如果小于设定的时间间隔(如 1 秒),则拒绝该请求。否则,通过SET操作更新用户的访问时间。 -
数据结构:键名可以是
"user:<user_id>:last_request_time",值是用户上次请求的时间戳。每次请求时,检查时间差是否符合要求。 -
优化:可以使用 Redis 的 HyperLogLog 或 ZSet 来管理多个用户的访问频率。 ZSet 可以更方便地管理用户请求的时间戳,并且支持按时间排序,便于检查某个时间窗口内的访问情况。
-
容错设计:为了避免 Redis 宕机影响系统的正常工作,可以设计一个 本地缓存 或 数据库回退方案,当 Redis 服务不可用时,暂时回退到数据库进行存储,保持系统的可用性。
4. 场景四:订单系统的库存管理
背景:假设你在一个电商平台的订单系统工作,平台上有多个商品的库存管理需求。你需要设计一个库存管理系统,确保库存的准确性,避免出现超卖的情况。如何利用 Redis 来设计这个库存管理系统?
问题:
-
如何通过 Redis 实现高效的库存扣减?
-
如何避免库存超卖问题?
-
如何保证并发环境下的库存一致性?
解答:
-
库存管理:每个商品的库存可以使用 Redis 的 string 类型 存储,键名是商品 ID,例如
"product:<product_id>:stock",值是库存数量。每次用户下单时,通过 Redis 的 DECR 命令原子性地减少库存数量,确保每次扣减库存时是独立且一致的。 -
超卖防范:使用 Redis 的 事务(MULTI/EXEC)或 乐观锁(通过 Redis 的 watch 命令)来确保在多用户并发下,只有库存充足时才能成功下单。库存不足时,可以返回“库存不足”的提示。
-
并发控制:在高并发的场景中,使用 Redis 的 原子操作(如 DECR 和 WATCH)来确保每次操作的原子性,避免并发请求对库存的修改造成冲突。
-
容错处理:如果 Redis 发生故障,可以考虑将库存同步到数据库中,确保系统即使在 Redis 宕机的情况下也能正常工作。
5. 场景五:社交平台的消息队列
背景:在一个社交平台上,你需要设计一个消息队列系统,支持用户之间的即时消息传递。如何使用 Redis 实现消息队列功能,保证消息的可靠性和及时性?
问题:
-
如何设计 Redis 来支持高效的消息传递?
-
如何确保消息不会丢失?
-
如何避免消息队列的阻塞?
解答:
-
消息队列设计:使用 Redis 的 List 数据结构(如 LPUSH 和 BRPOP)来实现消息队列。每当有新的消息产生时,将消息通过 LPUSH 命令推送到队列的左端;消费者通过 BRPOP 命令从队列的右端取出消息。这样可以实现生产者-消费者模型。
-
消息可靠性:为了防止消息丢失,可以使用 Redis 的 事务 或者通过 消息确认机制(例如消费者处理完消息后发出确认)来确保每条消息被正确处理。还可以使用 Redis 发布/订阅(Pub/Sub)来广播消息。
-
非阻塞处理:为了避免队列的阻塞,可以设置合理的超时限制,或者采用 Redis Streams 数据结构,支持多消费者消费并且更灵活地处理消息。
1. 场景一:实时视频流平台
背景:假设你在一个 在线视频流平台 工作,平台的用户可以实时观看和评论视频。你需要设计一个系统,能够处理大量用户的并发观看和评论请求。如何利用 Redis 来设计这个系统以确保 低延迟 和 高并发?
问题:
-
如何使用 Redis 高效存储和更新实时观看人数?
-
如何保证每个视频的实时评论能够快速响应用户的查询?
-
如何防止在高并发情况下 Redis 被过载?
解答:
-
实时观看人数:使用 Redis 的 String 类型 来存储每个视频的观看人数,键名可以是
"video:<video_id>:viewers",每当用户观看视频时,通过 Redis 的 INCR 操作来增加观看人数。 -
实时评论:利用 Redis 的 List 类型 存储每个视频的评论列表,用户每次发布评论时,通过 LPUSH 将评论推入队列。为了实现实时显示评论,可以通过 LRANGE 获取最新的评论。
-
防止过载:为了防止在高并发时 Redis 被过载,可以使用 Redis 限流(例如令牌桶或漏桶算法)来限制每秒访问次数,同时确保 缓存的高可用性,避免 Redis 单点故障。
2. 场景二:社交平台的消息通知系统
背景:假设你在一个 社交平台 上工作,平台用户每天会接收到不同类型的通知(如好友请求、点赞、评论、系统公告等)。为了确保消息的及时送达,你需要设计一个高效的通知系统。如何利用 Redis 来实现这个系统?
问题:
-
如何使用 Redis 来管理并发送用户通知?
-
如何处理高并发情况下的通知存储和消费?
-
如何保证通知不会丢失?
解答:
-
通知管理:使用 Redis 的 List 类型 来存储每个用户的通知队列。每个通知可以作为一个列表项,通过 LPUSH 命令将通知添加到队列,用户通过 LPOP 从队列中获取通知。
-
高并发处理:采用 Redis 发布/订阅(Pub/Sub) 机制,当有新的通知产生时,通过 Pub/Sub 广播消息给对应的用户订阅者,减少对 Redis 的访问压力。
-
消息不丢失:使用 Redis Streams 数据结构来存储通知,以保证消息的可靠性。消息会以日志的形式存储,消费者处理完消息后,调用 ACK 命令确认消息已被处理。
3. 场景三:实时竞赛和排行榜系统
背景:假设你在一个 在线教育平台 上工作,平台有多个实时竞赛,每个竞赛都会有排名。你需要设计一个系统,能够实时更新并查询竞赛的排行榜,确保排行榜数据的及时性和准确性。如何利用 Redis 来设计这个系统?
问题:
-
如何高效地更新和查询实时竞赛排行榜?
-
如何避免在高并发情况下对排行榜的读取性能造成影响?
-
如何保证竞赛数据的准确性?
解答:
-
实时排行榜:使用 Redis 的 SortedSet 数据结构存储每个竞赛的排行榜。竞赛中的每个用户可以用其 分数 作为 score,用 用户 ID 或 用户名 作为 member。每次用户提交分数时,使用 ZINCRBY 更新分数,保证排行榜的实时更新。
-
查询排行榜:使用 ZREVRANGE 来查询竞赛的前 N 名用户,从而实现实时展示。
-
并发优化:利用 Redis 的原子操作(如 ZINCRBY)保证多个并发请求下的数据一致性和正确性。为了避免并发查询带来的性能问题,可以设置 合理的 TTL,避免过期数据占用过多内存。
4. 场景四:实时位置跟踪系统
背景:假设你在一个 物流公司 上工作,需要设计一个系统,能够实时跟踪每辆车的位置,并且根据位置数据生成 路线规划 或 最近的车辆查询。如何利用 Redis 来实现这个实时位置跟踪系统?
问题:
-
如何使用 Redis 存储和更新车辆位置?
-
如何高效查询最近的车辆位置?
-
如何处理车辆数据的高并发和高可用性?
解答:
-
车辆位置存储:使用 Redis 的 Geo 数据结构存储每辆车的位置信息(经度和纬度)。每次车辆位置更新时,可以通过 GEOADD 将新的位置数据添加到 Redis 中。
-
最近车辆查询:利用 Redis 的 GEODIST 命令计算用户位置与各辆车的距离,通过 GEORADIUS 查询某个半径内的车辆,返回最近的车辆。
-
并发优化:使用 Redis 的 事务 和 发布/订阅机制 来保证数据的一致性和高并发访问。通过 Redis 集群 部署和分片来扩展存储能力和保证高可用性。
5. 场景五:缓存与会话管理系统
背景:假设你在一个 金融平台 工作,平台的用户登录信息需要管理和缓存。你需要设计一个高效的会话管理系统,能够处理成千上万的用户会话请求。如何利用 Redis 来管理这些会话数据?
问题:
-
如何使用 Redis 存储和管理用户的会话数据?
-
如何确保用户会话数据的安全性和过期管理?
-
如何保证高并发情况下 Redis 的性能和稳定性?
解答:
-
会话存储:使用 Redis 的 Hash 类型 来存储每个用户的会话数据,键名可以是
"session:<session_id>",字段可以存储用户信息(如用户名、权限、登录时间等)。用户每次登录时,使用 HSET 存储会话信息。 -
会话过期:为每个会话设置 TTL(过期时间),例如可以设置为 30 分钟,确保用户在一段时间内没有活动后,自动失效。使用 EXPIRE 或者 SETEX 来设置过期时间。
-
会话安全:确保会话数据的安全性,可以通过 加密存储(如 AES 加密会话信息)来增强安全性,同时通过 Redis Cluster 或 Replication 提高 Redis 的可用性和容错能力。
6. 场景六:分布式锁管理系统
背景:假设你在一个 分布式系统 中工作,需要确保多个微服务之间对某些共享资源的访问是互斥的。如何利用 Redis 来实现分布式锁?
问题:
-
如何使用 Redis 实现分布式锁?
-
如何保证分布式锁的 超时 和 锁的释放?
-
如何防止死锁问题?
解答:
-
分布式锁实现:使用 Redis 的 SETNX 命令来实现分布式锁。通过设置一个唯一的锁键(例如
"lock:<resource_id>"),如果该键不存在,则使用 SETNX 命令设置成功,表示获取到锁。如果键已经存在,则表示锁已经被占用。 -
锁的超时:为了防止死锁,设置锁的过期时间(如 30 秒),即便操作失败或者进程崩溃,锁也会自动释放。可以通过 SET 命令的
EX参数设置过期时间。 -
锁的释放:通过判断锁的拥有者(例如,存储一个 UUID),确保只有持有锁的进程可以释放锁。可以使用 Lua 脚本保证获取锁和释放锁的原子性。
更多推荐

 28
 0
- 0


 已为社区贡献3条内容

所有评论(0)