
搜广推校招面经一百零二
快手短视频推荐二面
一、Approximate Nearest Neighbor(ANN)算法了解哪些
在给定一个查询向量的情况下,从一个大型向量集合中找到与它最接近的 K 个向量。
由于高维空间中精确查找代价高,ANN 采用牺牲一定精度换取速度的策略。
1.1. LSH(Locality-Sensitive Hashing)局部敏感哈希
使用哈希函数将高维空间映射为低维,使相似向量落入相同桶中。
- 适用场景:欧几里得距离、余弦相似度。
- 优点:理论基础扎实,适用于大规模数据。
- 缺点:维度高时性能下降,召回率有限。
1.2. KD-Tree / Ball Tree(树结构)
将数据空间划分为子空间形成树结构。
递归地选择一个维度将数据划分为两部分,构建一颗二叉树,使得:
- 流使用每一维(也可以选方差最大的维度)。将该维度上中值作为分割点,保证树结构平衡。
- 左子树:该维度小于等于当前节点值
- 右子树:该维度大于当前节点值
- 适用场景:低维向量(< 20维)。
- 优点:查询速度快,结构清晰。
- 缺点:维度高时性能急剧下降(维度灾难)。
1.3. PQ(Product Quantization,乘积量化)
将向量分为多个子空间,每个子空间内做KMeans量化。
- 代表实现:Faiss 的 IndexIVFPQ。
- 优点:存储节省,查询速度快。
- 缺点:训练复杂,精度取决于量化效果。
1.4. HNSW(Hierarchical Navigable Small World)
构建分层图结构,从粗到细进行搜索。
- 优点:高精度、查询快、鲁棒性强。
- 缺点:构建图结构的内存与时间成本较高。
1.5. Faiss(Facebook AI Similarity Search)
- 开发者:Meta
- 支持算法:Flat, IVF, PQ, HNSW 等
- 优点:工业级性能,支持GPU,功能丰富。
- 适合:大规模相似搜索任务。
1.6. 主流ANN库推荐
| 库名称 | 支持算法 | 特点 |
|---|---|---|
| Faiss | IVF, PQ, HNSW | 支持 GPU,工业应用广泛,性能极高 |
| Annoy | 多棵随机树 | 适合磁盘读取,适合冷启动场景 |
| HNSWlib | HNSW | 高查询精度,适合中小型高质量索引 |
| ScaNN | L2 / 点积 | Google 开源,适合 TensorFlow 场景 |
二、讲一下召回 & 排序的评估指标
2.1. 召回阶段评估指标(是否把“正确的”召回回来)
2.1.1. Recall@K(召回率)
从用户真正感兴趣的物品中,有多少被系统召回了?
Recall@K
=
Relevant Items in Top K
Total Relevant Items
\text{Recall@K} = \frac{\text{Relevant Items in Top K}}{\text{Total Relevant Items}}
Recall@K=Total Relevant ItemsRelevant Items in Top K
用户对10个商品感兴趣,系统Top50中召回了5个 → Recall@50 = 5/10 = 0.5
2.1.2. Precision@K(准确率)
推荐Top K中有多少是相关的?
Precision@K
=
Relevant Items in Top K
K
\text{Precision@K} = \frac{\text{Relevant Items in Top K}}{K}
Precision@K=KRelevant Items in Top K
Top10中有3个是用户喜欢的 → Precision@10 = 3/10 = 0.3
2.1.3. Coverage(覆盖率)
推荐系统推荐的物品总数在全集中的比例。
Coverage
=
∣
⋃
u
∈
U
Rec
(
u
)
∣
∣
I
∣
\text{Coverage} = \frac{\left| \bigcup\limits_{u \in U} \text{Rec}(u) \right|}{|I|}
Coverage=∣I∣
u∈U⋃Rec(u)
- R e c ( u ) Rec(u) Rec(u):对用户u推荐的物品集合
- I I I:全体物品集合
2.1.4. Hit Rate(命中率)
Top K 是否至少命中了一个正样本。
Hit@K
=
{
1
,
if
∃
i
∈
TopK
,
i
is relevant
0
,
otherwise
\text{Hit@K} = \begin{cases} 1, & \text{if } \exists\, i \in \text{TopK},\ i \text{ is relevant} \\ 0, & \text{otherwise} \end{cases}
Hit@K={1,0,if ∃i∈TopK, i is relevantotherwise
2.2. 排序阶段评估指标(排序是否合理)
2.2.1. NDCG@K(归一化折损累积增益)
见【搜广推校招面经八十一】
正确的推荐排得越前得分越高。
DCG@K
=
∑
i
=
1
K
rel
i
log
2
(
i
+
1
)
NDCG@K
=
DCG@K
IDCG@K
\text{DCG@K} = \sum_{i=1}^{K} \frac{\text{rel}_i}{\log_2(i + 1)} \\\ \text{NDCG@K} = \frac{\text{DCG@K}}{\text{IDCG@K}}
DCG@K=i=1∑Klog2(i+1)reli NDCG@K=IDCG@KDCG@K
2.2.2. MAP(Mean Average Precision)
所有用户的平均准确率均值。
AP
(
u
)
=
1
∣
Rel
u
∣
∑
k
=
1
K
P
(
k
)
⋅
rel
(
k
)
MAP
=
1
∣
U
∣
∑
u
∈
U
AP
(
u
)
\text{AP}(u) = \frac{1}{|\text{Rel}_u|} \sum_{k=1}^{K} P(k) \cdot \text{rel}(k)\\\ \text{MAP} = \frac{1}{|U|} \sum_{u \in U} \text{AP}(u)
AP(u)=∣Relu∣1k=1∑KP(k)⋅rel(k) MAP=∣U∣1u∈U∑AP(u)
其中:
Rel_u是用户u的相关物品集合P(k)表示推荐列表前k个物品中的准确率rel(k)表示第k个位置是否为相关物品(1 表示相关,0 表示不相关)
2.2.3. MRR(Mean Reciprocal Rank)
衡量第一个相关物品出现在推荐列表中的位置,越靠前得分越高。
M
R
R
=
(
1
/
∣
U
∣
)
∗
Σ
(
1
/
r
a
n
k
u
)
MRR = (1 / |U|) * Σ (1 / rank_u)
MRR=(1/∣U∣)∗Σ(1/ranku)
其中:
U是用户集合rank_u是用户u的第一个相关物品在推荐列表中的排名(从 1 开始)
假设用户u1的第一个相关物品出现在推荐列表的第 3 位,则:
1 / rank_u1 = 1 / 3 ≈ 0.333
三、离线指标涨了线上没效果原因
离线评估指标(如 AUC、F1、Recall@K、NDCG@K、MAP 等)上涨,但模型上线后在实际业务中没有提升、甚至变差。
3.1. 离线评估和线上目标不一致
- 离线评估指标和线上关键业务指标(如点击率、转化率、停留时间等)不一致。
- 离线指标优化的是排序或准确率,线上业务关注的是用户行为或收入。
举例:- 离线用 Recall@50,但线上只曝光 Top10。
- 离线优化排序整体,线上只在首位展示,对首位排序更敏感。
3.2. 离线数据分布与线上数据不同
- 离线训练/验证用的是历史数据,但线上环境已经发生变化(概念漂移)。
- 用户兴趣、热点内容、上下文等变动导致模型效果不稳。
解决方向:- 引入时间窗样本抽样
- 使用近实时样本、在线学习
3.3. 离线实验配置与线上部署不一致
- 特征工程有差异:线上特征缺失或处理方式不同
- 模型结构/参数不一致:线上部署的是旧模型或调度有误
- 模型文件加载错误、版本错配等工程问题
3.4. 业务策略干预过多
- 线上存在兜底策略、打散机制、打分加权等业务规则干扰模型排序
- 离线评估的是“理想输出”,线上是“混合策略排序”
3.5. 流量质量与实验组设计问题
- 离线使用全量数据评估,线上实验组可能偏冷启动用户或样本少
- A/B 分流不均、样本量小或实验周期短 → 结果不稳定
3.6. 总结
| 问题方向 | 优化建议 |
|---|---|
| 指标不一致 | 设计更贴合业务的评估指标(如 Weighted NDCG) |
| 分布不一致 | 使用近线训练样本,引入在线特征、周期性更新模型 |
| 部署不一致 | 特征/模型/服务版本对齐,建立稳定部署流程 |
| 策略干扰 | 区分模型效果与策略干预效果,独立评估纯模型表现 |
| 数据不闭环 | 建立推荐结果与点击行为的闭环采样与再训练机制 |
四、33. 搜索旋转排序数组
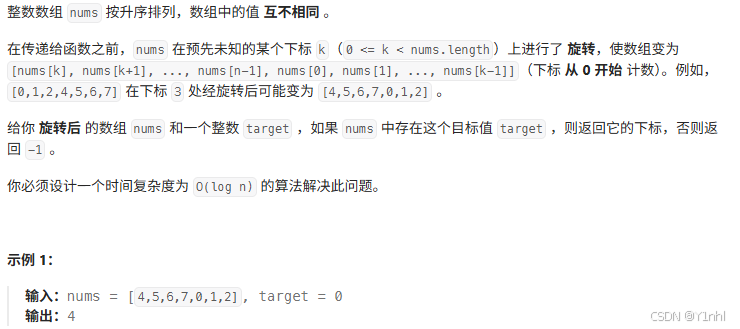
class Solution:
    # 153. 寻找旋转排序数组中的最小值(返回下标)
    def findMin(self, nums: List[int]) -> int:
        left, right = -1, len(nums) - 1  # 开区间 (-1, n-1)
        while left + 1 < right:  # 开区间不为空
            mid = (left + right) // 2
            if nums[mid] < nums[-1]:
                right = mid
            else:
                left = mid
        return right

    # 有序数组中找 target 的下标
    def lower_bound(self, nums: List[int], left: int, right: int, target: int) -> int:
        while left + 1 < right:  # 开区间不为空
            mid = (left + right) // 2
            # 循环不变量:
            # nums[right] >= target
            # nums[left] < target
            if nums[mid] >= target:
                right = mid  # 范围缩小到 (left, mid)
            else:
                left = mid   # 范围缩小到 (mid, right)
        return right if nums[right] == target else -1

    def search(self, nums: List[int], target: int) -> int:
        i = self.findMin(nums)
        if target > nums[-1]:  # target 在第一段
            return self.lower_bound(nums, -1, i, target)  # 开区间 (-1, i)
        # target 在第二段
        return self.lower_bound(nums, i - 1, len(nums), target)  # 开区间 (i-1, n)
更多推荐

 13
 0
- 0


 已为社区贡献7条内容

所有评论(0)