
【王树森推荐系统】排序02:Multi-gate Mixture-of-Experts (MMoE)
·
模型架构
- 本节课的模型是对上一节课模型(多目标模型)的改进
- 模型的输入是一个向量,包含用户特征,物品特征,统计特征,场景特征
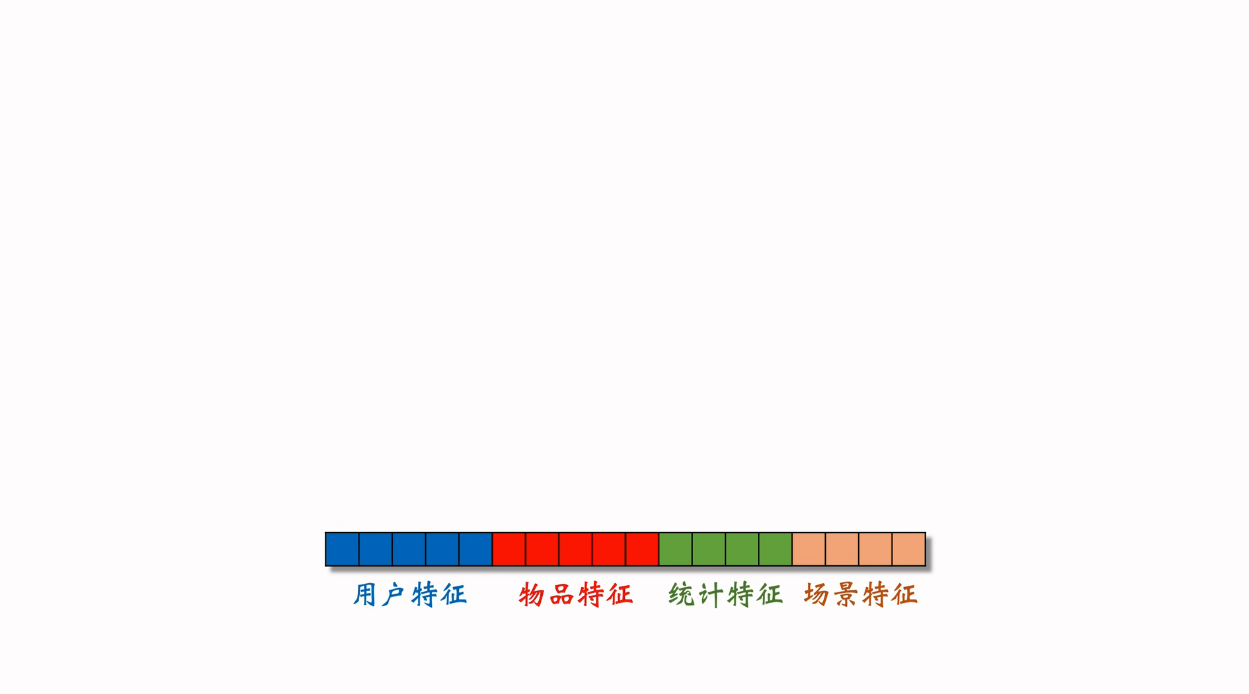
- 把向量输入 3 个神经网络,3 个神经网络结构相同,都是由很多全连接层组成。但是它们不共享参数,3 个神经网络各输出一个向量
- 这 3 个神经网络被叫做三个“专家”,实践中数量可能会更多
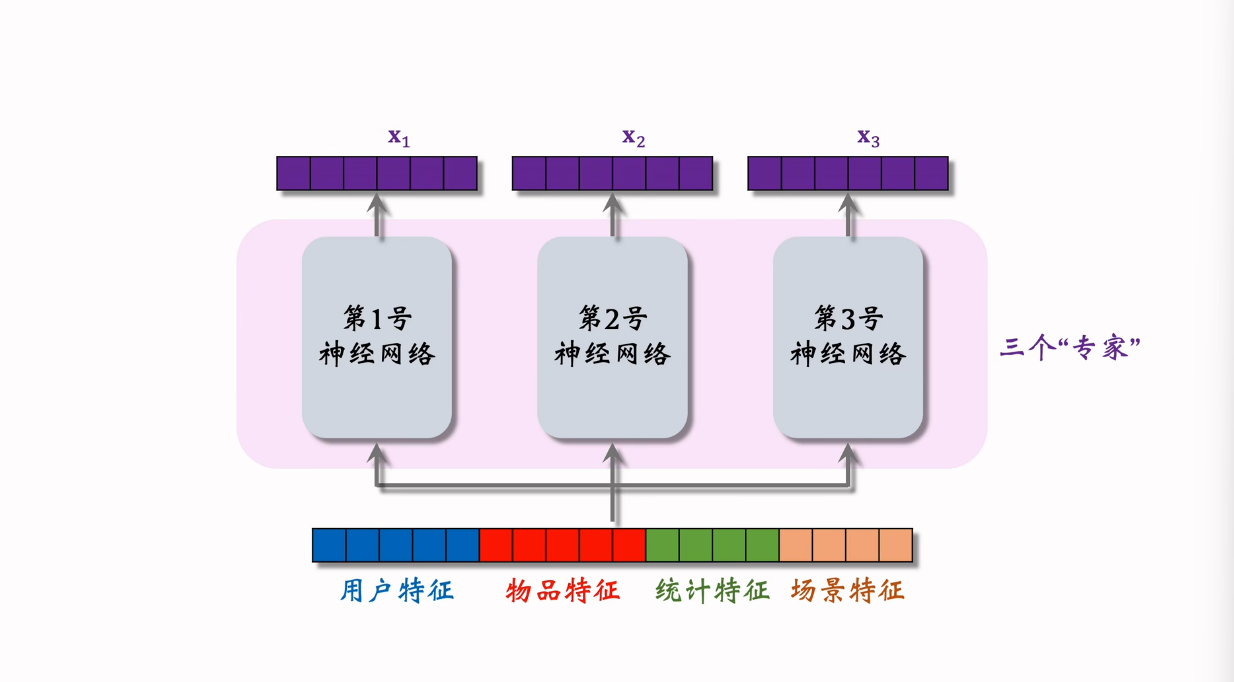
- 把下面的特征向量输入另一个神经网络,然后再接一个 softmax,输出一个 3 维的向量,由于接了softmax,所以向量的 3 个元素都在 0 到 1 之间并且加起来等于 1,之后会用到它们做加权平均
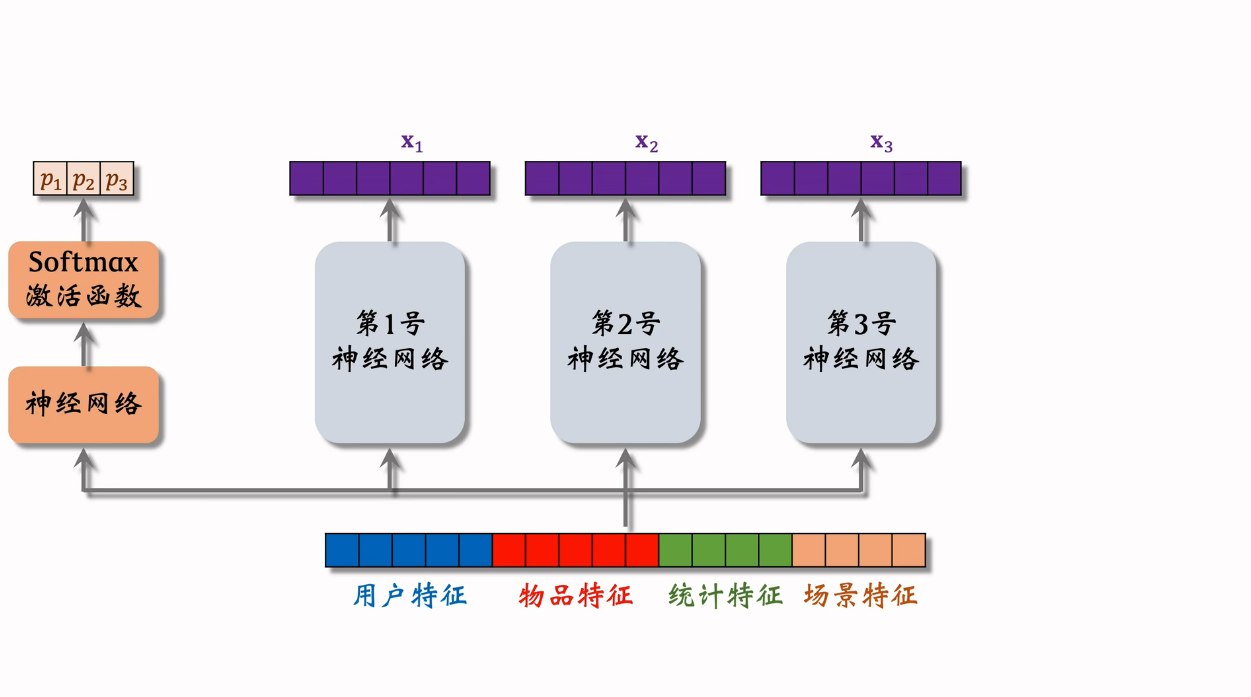
- 同样的方法,右边也接一个这样的,输出的三维向量也是之后做加权平均时的权重
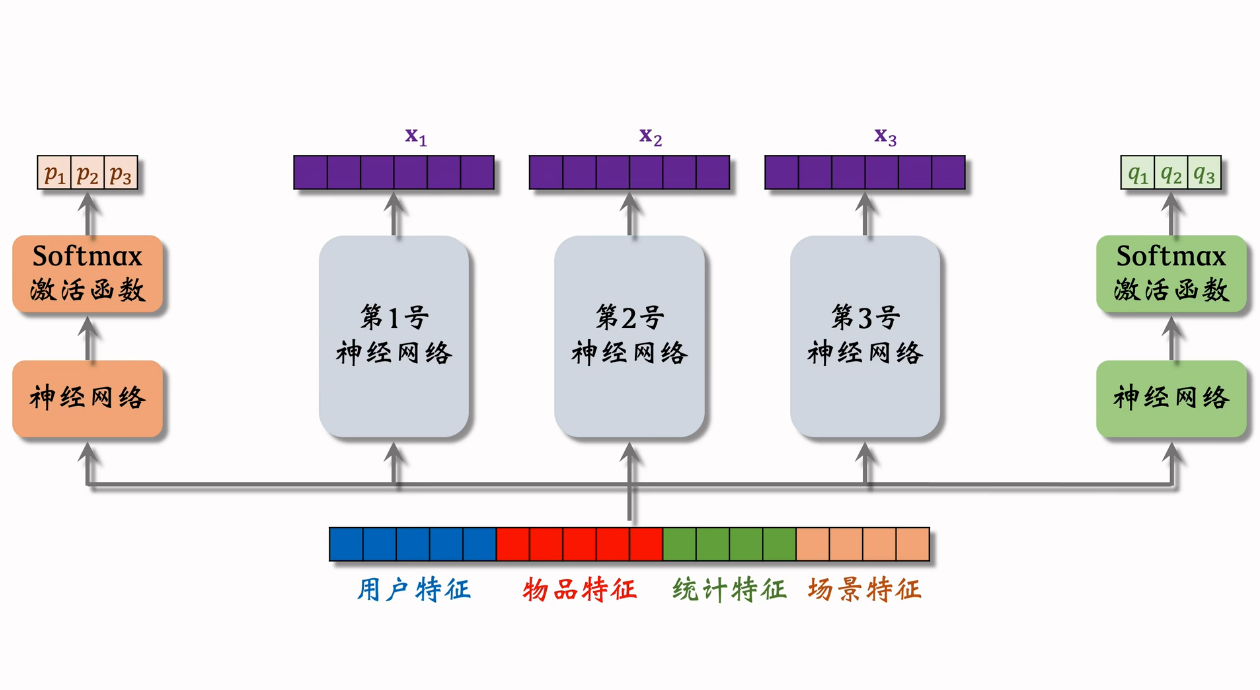
- 接下来研究更上层的结构
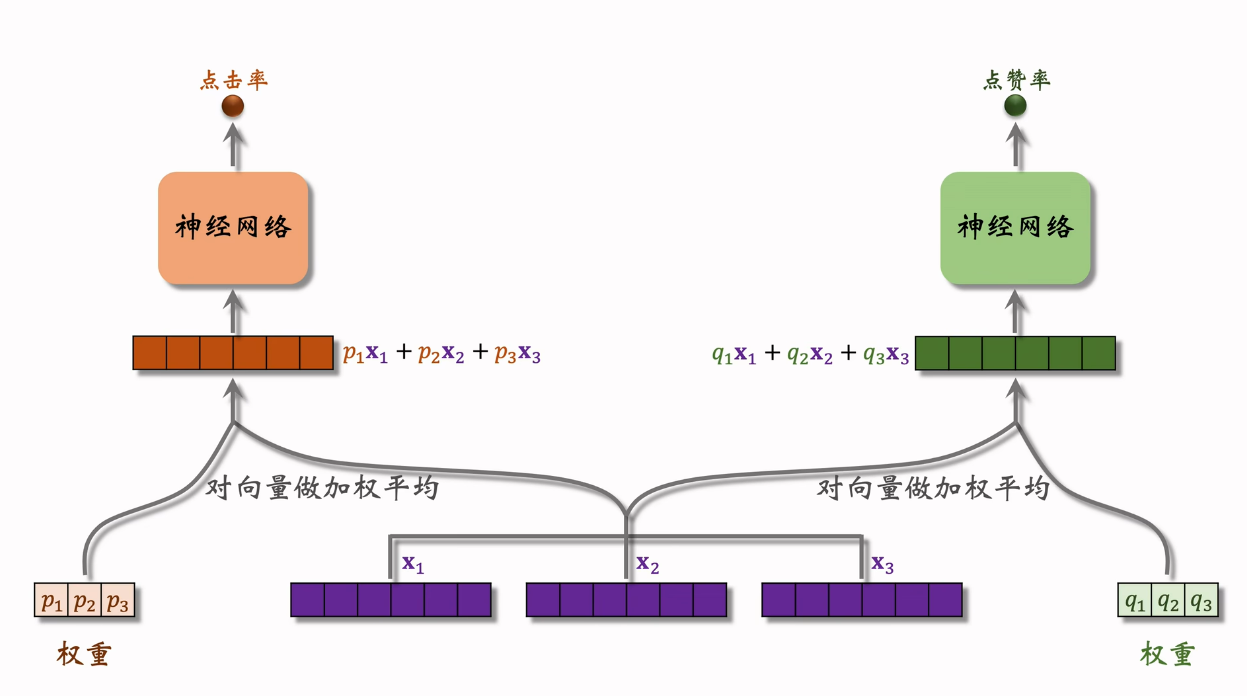
- 然后对这三个向量和刚刚求出来的权重做加权平均
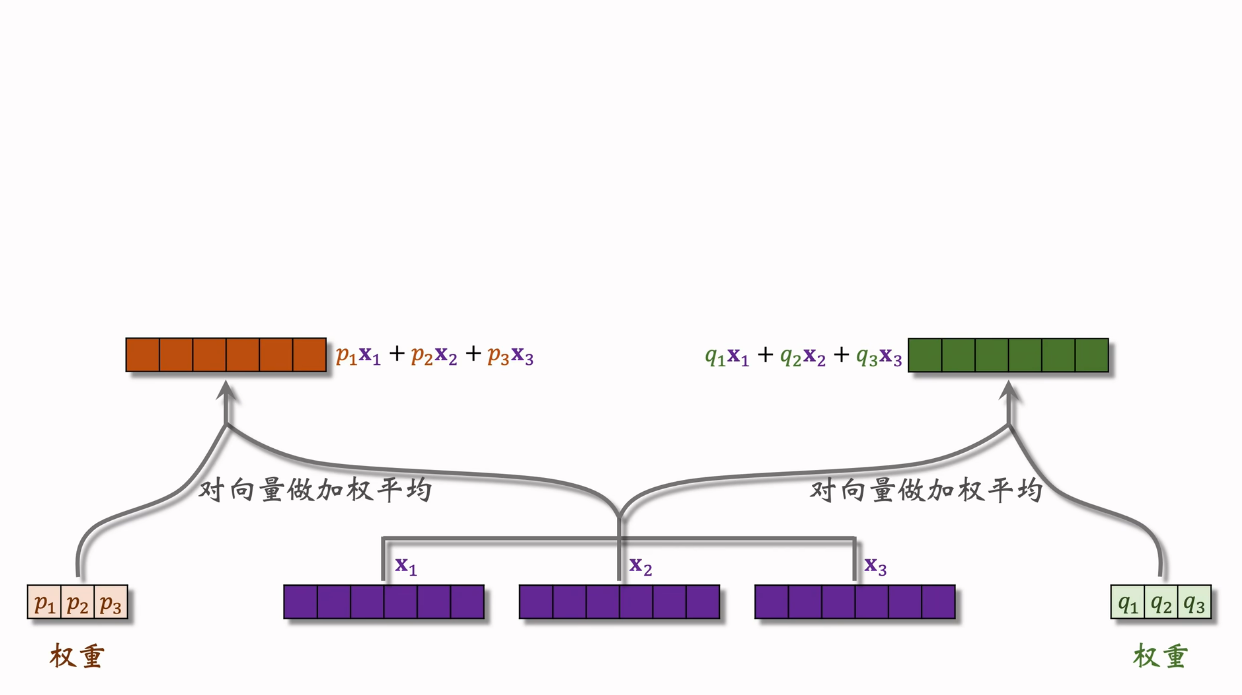
- 把左右两边的分别接入到一个神经网络,输出一种预估指标
- 这里是假设有点击率和点赞率两种目标,所以用了两种权重
- 专家神经网络的数量是个超参数,需要调
极化现象
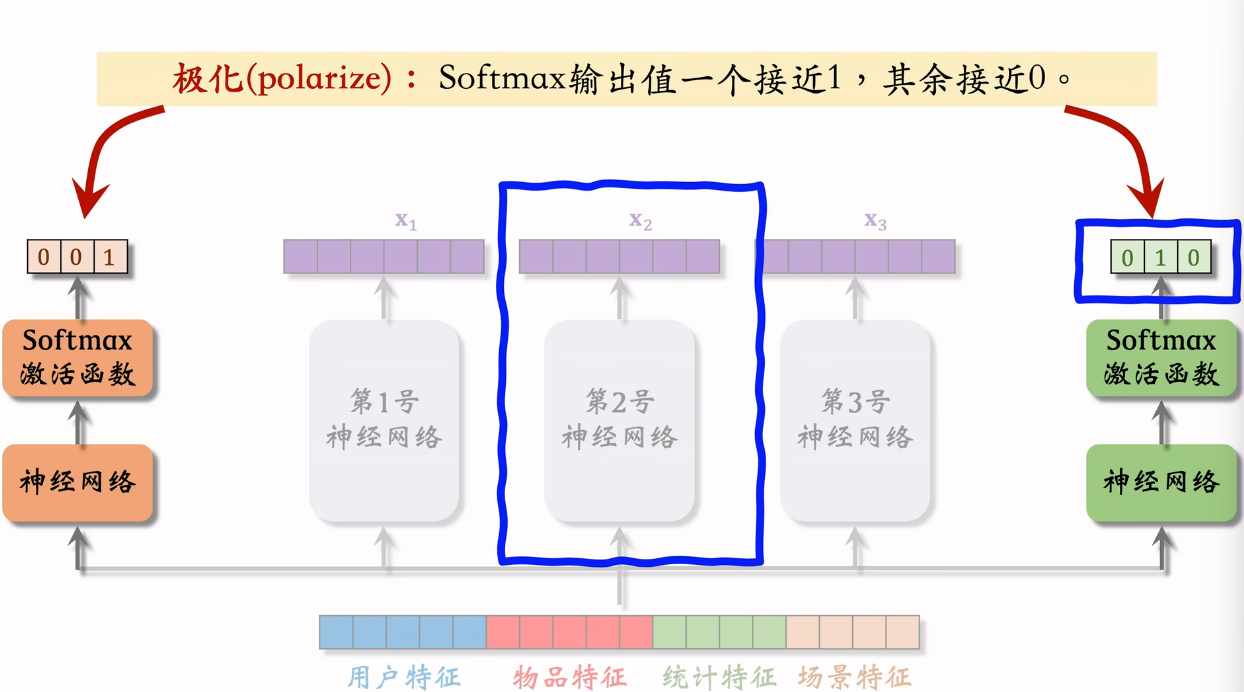
- 极化现象指的是 softmax 会极化
- 我们的例子中有两个 softmax函数,各自输出一个 3 维向量,每个向量都是概率分布,元素大于 0,相加等于 1
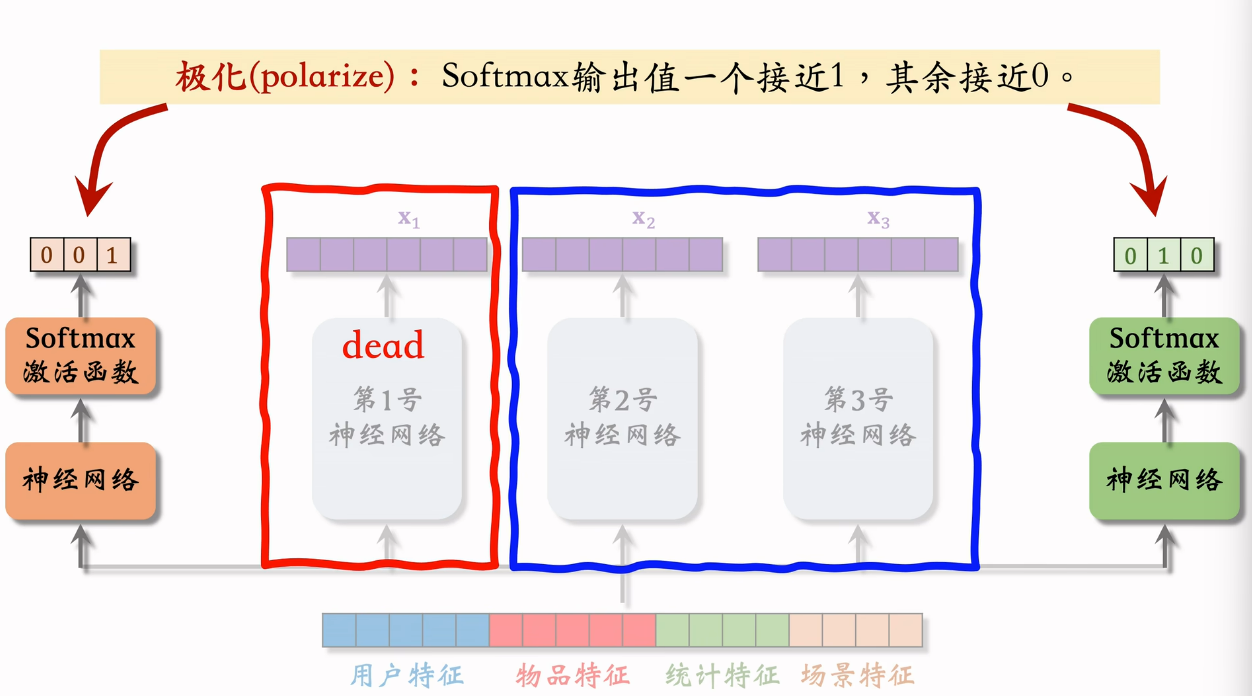
- 极化:softmax 输出值一个接近 1,其余接近 0
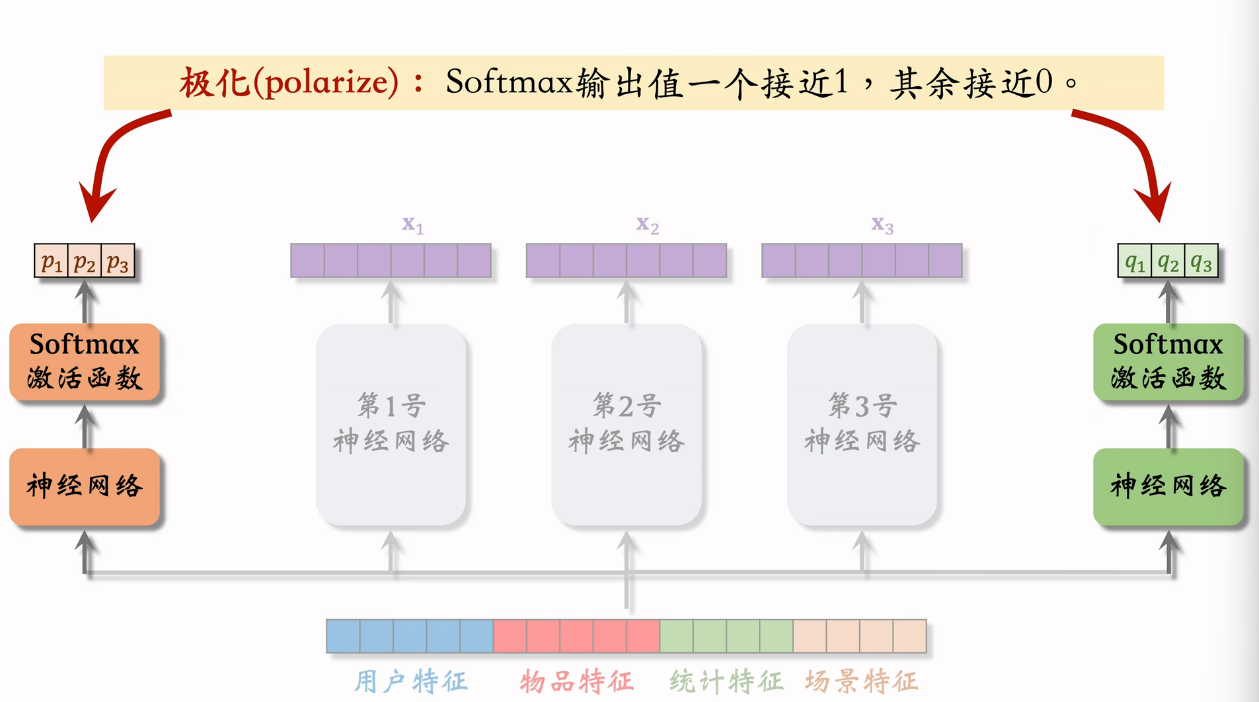
- 例子:左边的只使用了第 3 号神经网络,而没有使用其他两个专家神经网络
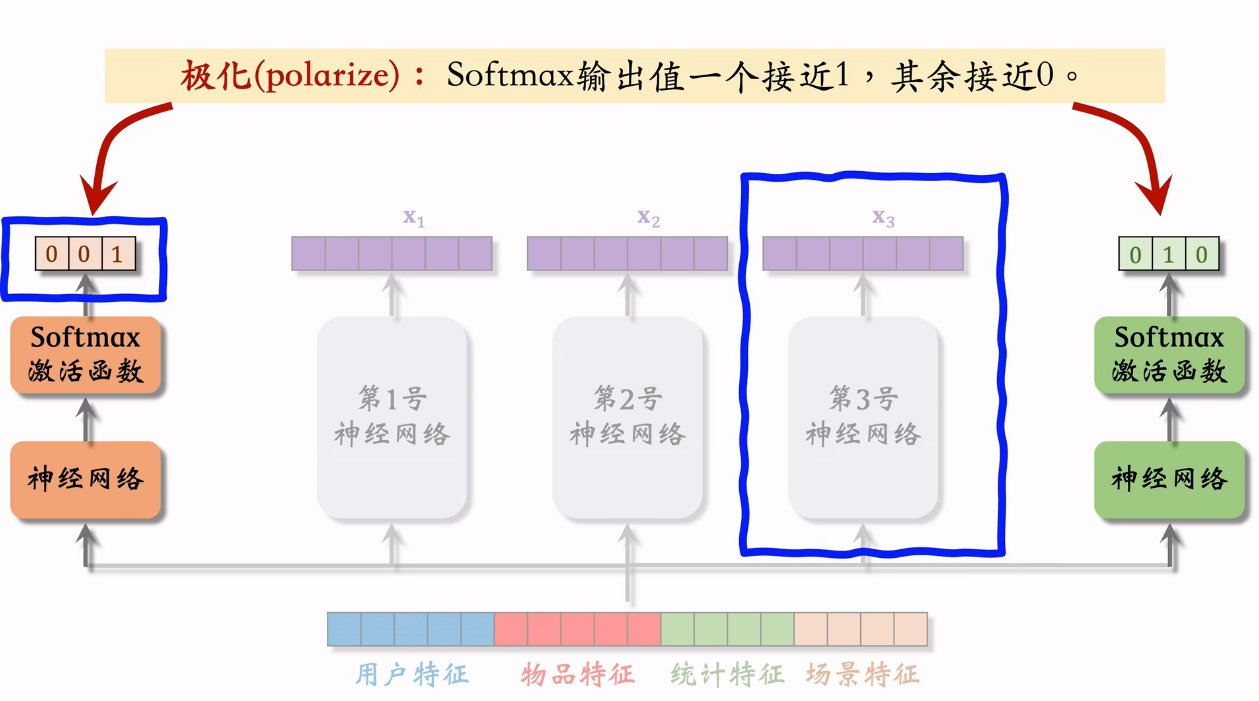
- 右边也是,只使用了第二号神经网络
- 这样就相当于第一个神经网络失效了,退化成了一个简单的多目标模型,不会对专家做融合,失去了 MMoE 的优势
解决极化问题
- 如果有 n 个专家,那么每个 softmax的输入和输出都是 n 维向量
- 在训练时,对 softmax的输出使用 dropout
- softmax 输出的 n 个数值被 mask 的概率都是 10%
- 每个专家被丢弃的概率都是 10%,这样会强迫每个任务根据部分专家做预测
- 如果用 dropout,不太可能会发生极化,否则预测的结果会特别差
- 假如发生极化,某个 softmax 输出的某个元素接近 1,如果这个被 mask,预测的结果肯定错的离谱。为了让预测尽量精准,神经网络会尽量避免极化的发生,避免 softmax 的某个输出接近 1
效果
- 用 MMoE不一定会有提升
- 有人用了有提升,有人用了没有
更多推荐



 4
 0
- 0


 已为社区贡献4条内容

所有评论(0)