
【王树森推荐系统】召回08:双塔模型——线上服务、模型更新
·
线上召回
模型在训练好之后就可以部署到线上进行召回。小红书的召回就是每次推荐快速找到用户感兴趣的一两百篇笔记,下面的内容就是双塔模型怎样做召回
离线存储
-
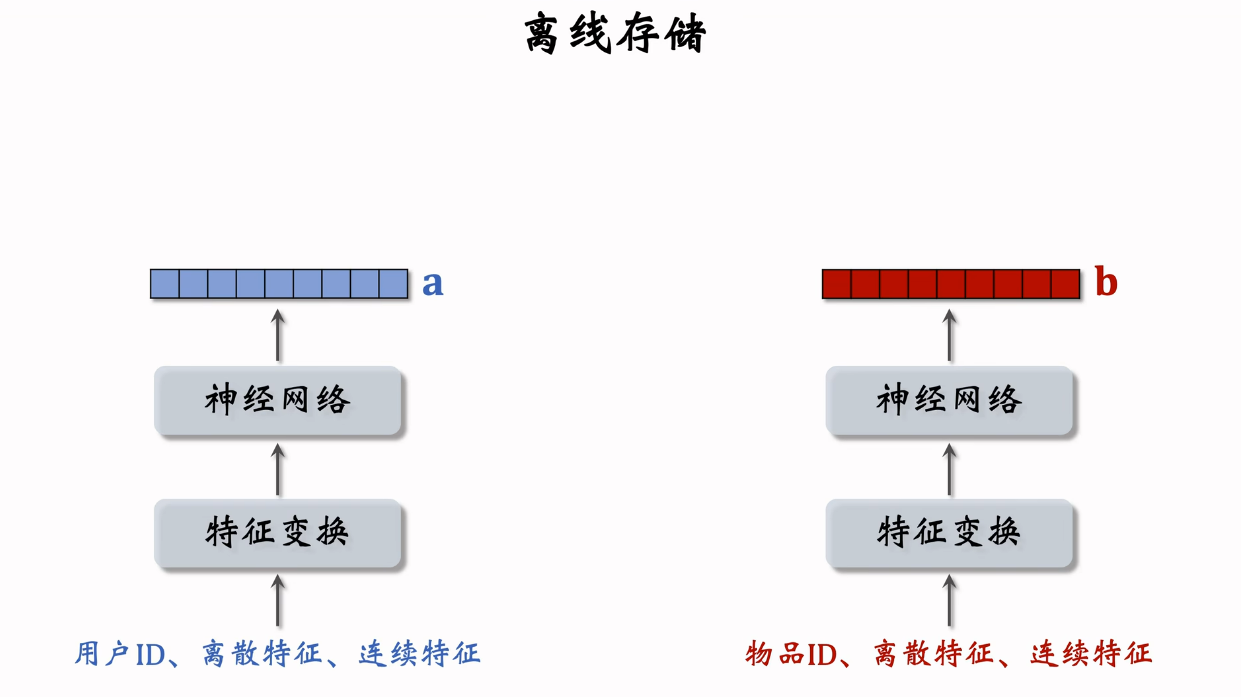
下图是训练好的两个塔,它们分别提取用户特征和物品特征
-
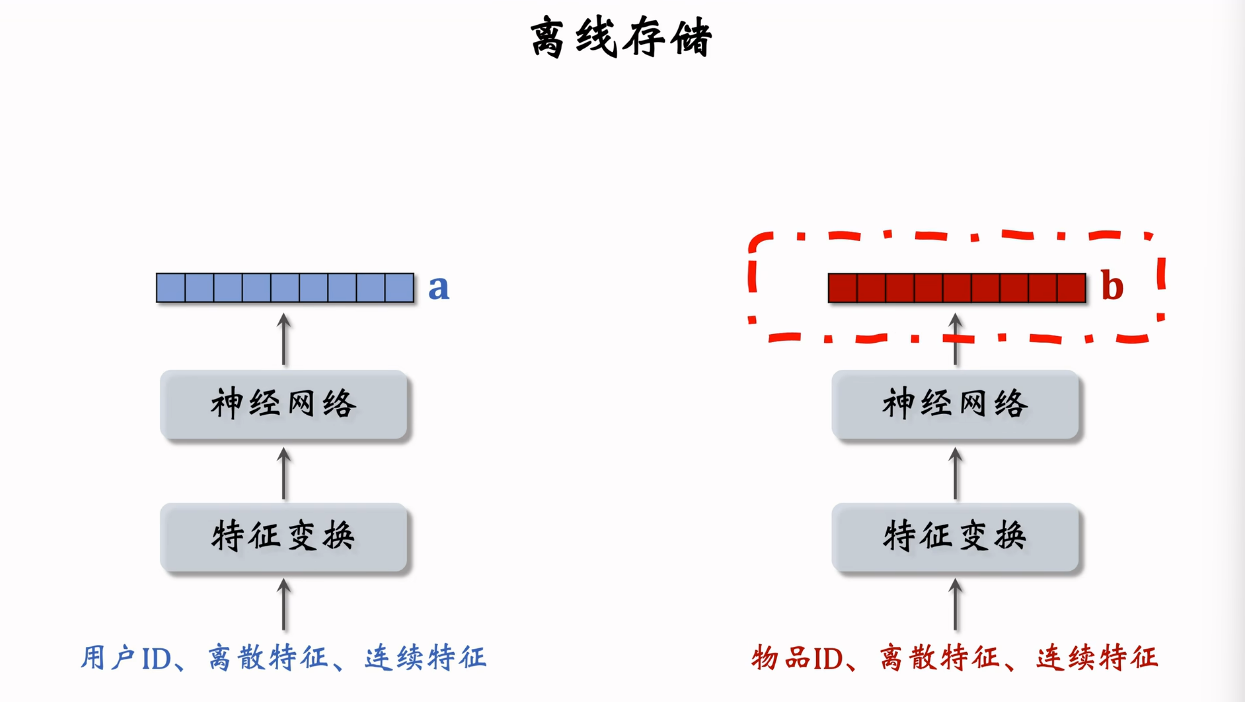
在训练好模型后,开始服务前,先用右边的物品塔提取物品的特征,把物品的特征记作 bbb,小红书有几亿物品的特征,那么就有几亿个向量 bbb
-
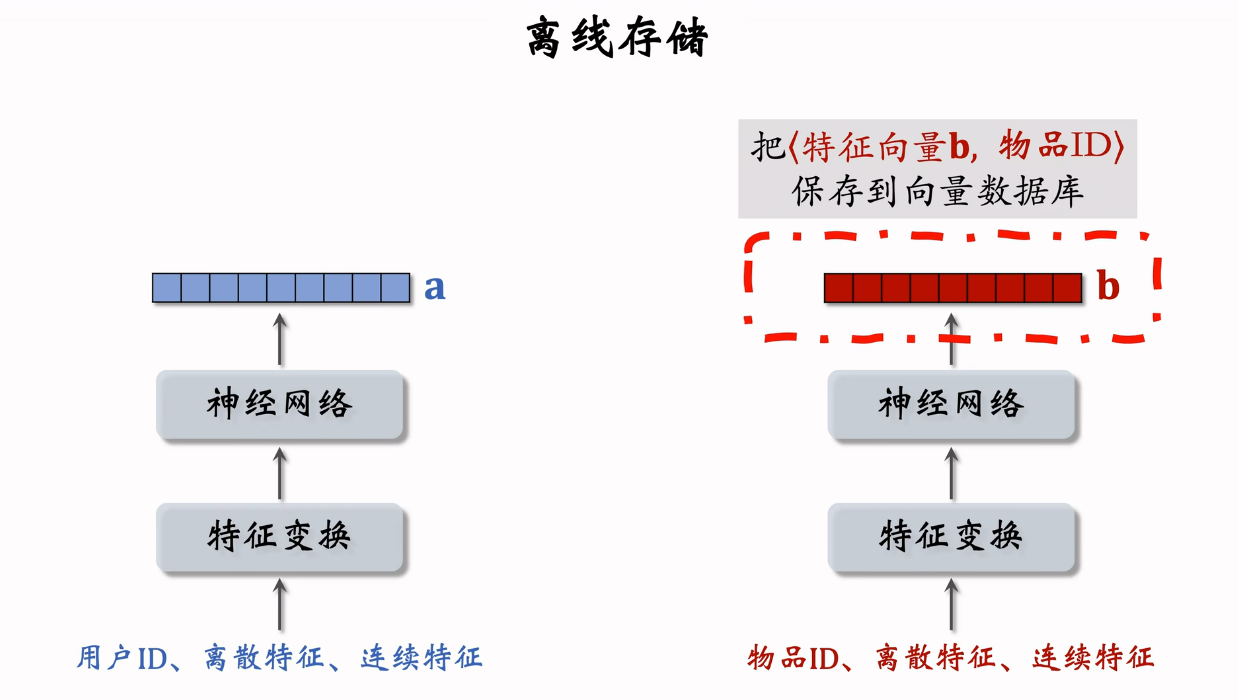
把物品特征向量 bbb 和物品ID这样的二元组保存到像Faiss这样的向量数据库
-
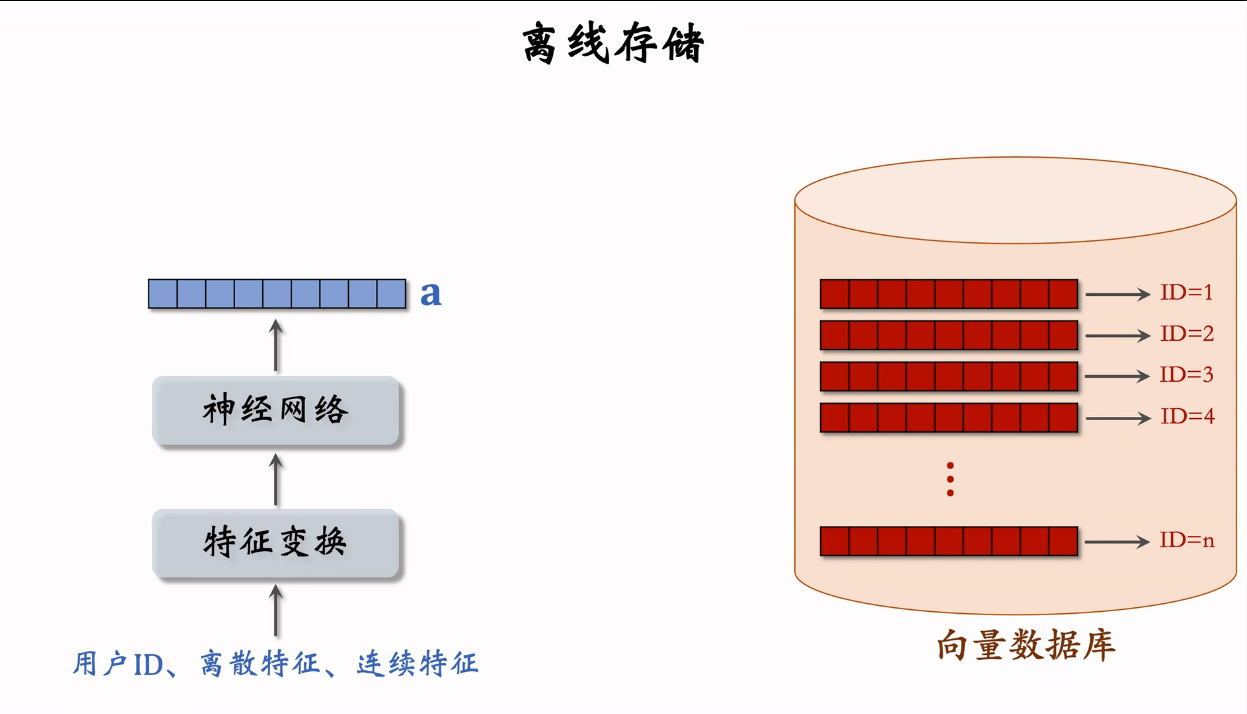
下面是物品的特征向量和对应的ID,有几亿个物品,所以有几亿个特征向量,向量数据库存储物品ID和向量的二元组用作最近邻查找
-
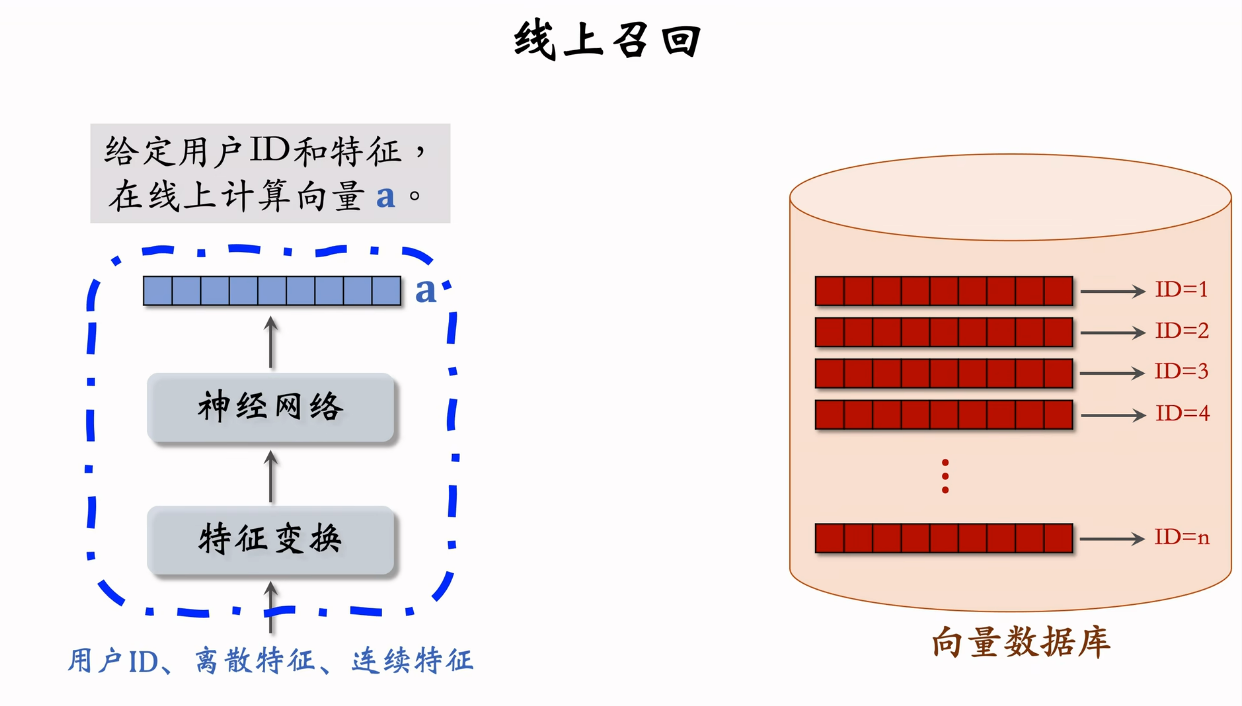
左边的用户塔处理方式则完全不同,不要事先计算和存储用户向量。而是当用户发起推荐请求时现算一个向量 aaa
-
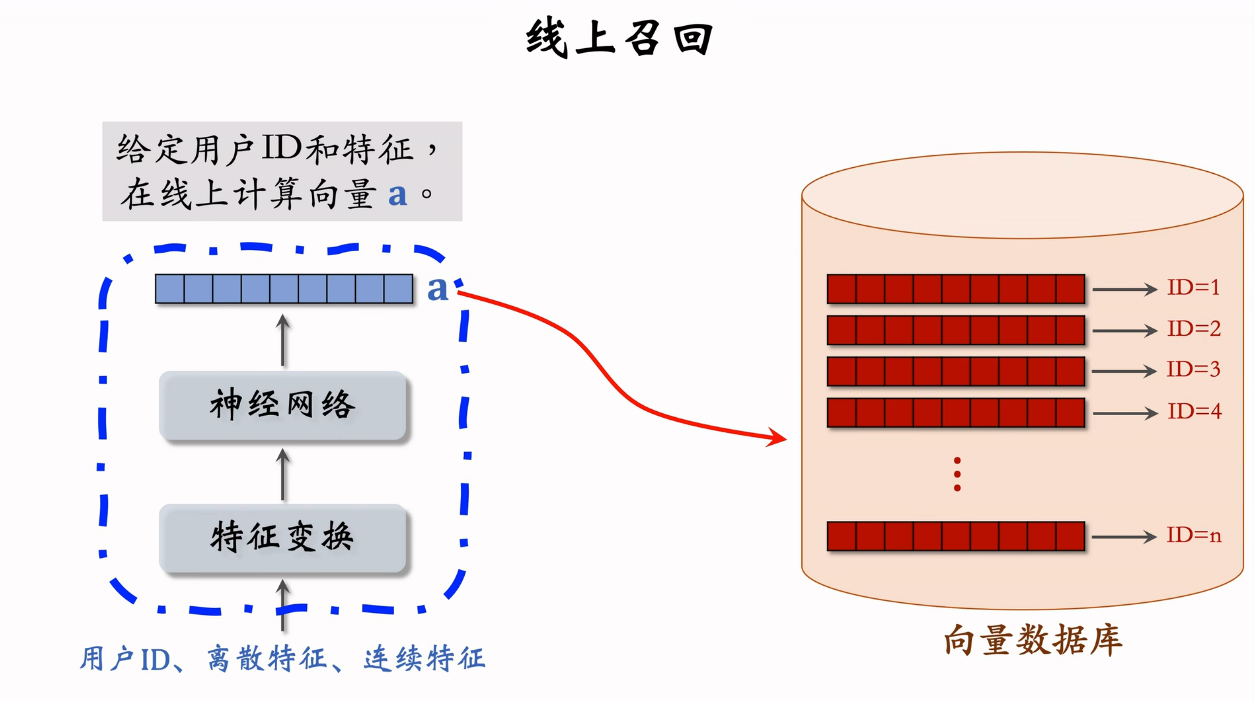
然后把向量 aaa 作为 query,去数据库中检索,查找最近邻,也就是跟向量 aaa 相似度最高的 k 个红色向量,一个红色向量对应一篇笔记。
-
k近邻查找一共召回了 k 篇笔记,作为这条召回通道的结果返回
双塔模型的召回
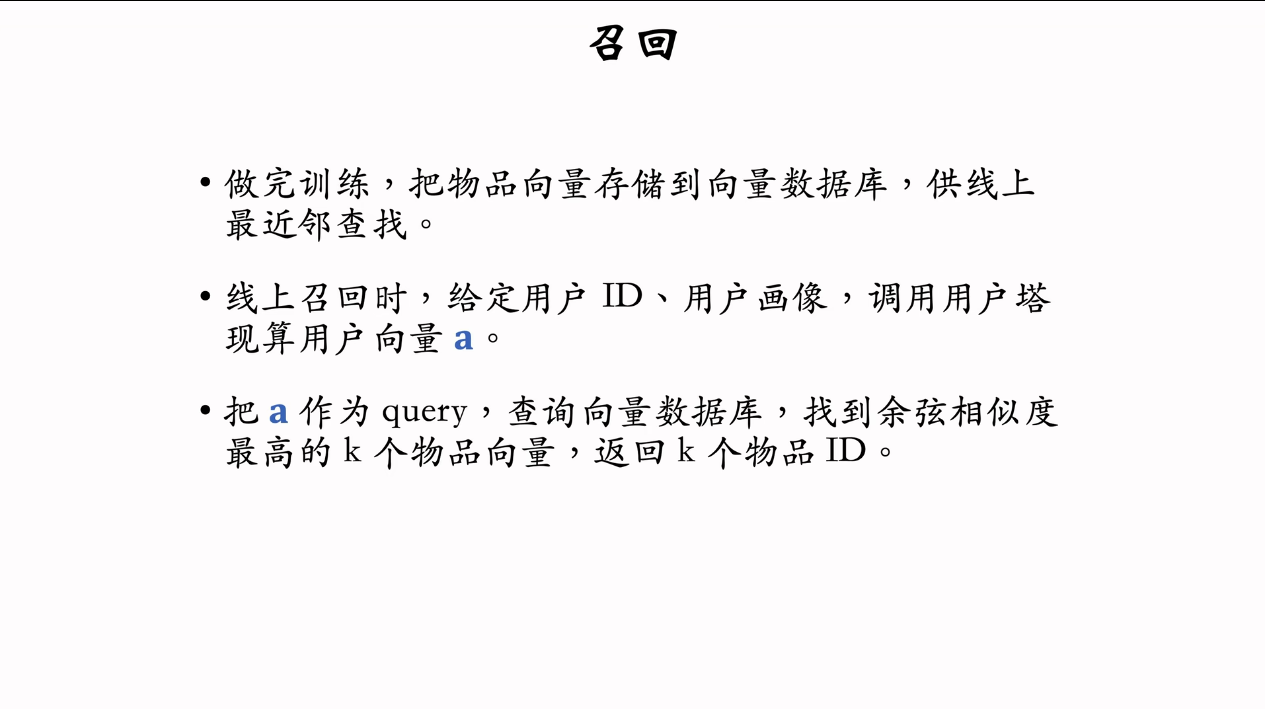
- 离线存储:把物品向量 bbb 存入向量数据库
- 完成训练之后,用物品塔计算每个物品的特征向量 bbb
- 把几亿个物品向量 bbb 存入向量数据库(比如 Milvus,Faiss,HnswLib)
- 向量数据库建立索引,以便加速最近邻查找
- 线上召回:查找用户感兴趣的 k 个物品
- 给定用户向量ID和画像,线上用神经网络算用户向量 aaa
- 最近邻查找:
- 把向量 aaa 作为 query,调用向量数据库做最近邻查找
- 返回余弦相似度最大的 k 个物品,作为召回结果。接下来这些召回结果会和itemCF或Swing和UserCF的召回结果融合后最终展示给用户
- 我们需要实现存储向量 bbb,线上现算用户向量 aaa,why?
- 每做一次召回,用到一个用户向量 aaa,几亿物品向量 bbb(线上算物品向量的代价过大)
- 那能不能把用户向量也提前算好呢?
- 当然可以!在早期技术力较弱的时候也这样做,工程实现很简单。
- 但是这样不利于推荐的效果,用户兴趣动态变化,而物品特征相对稳定(可以离线存储用户向量,但不利于推荐结果)
模型更新
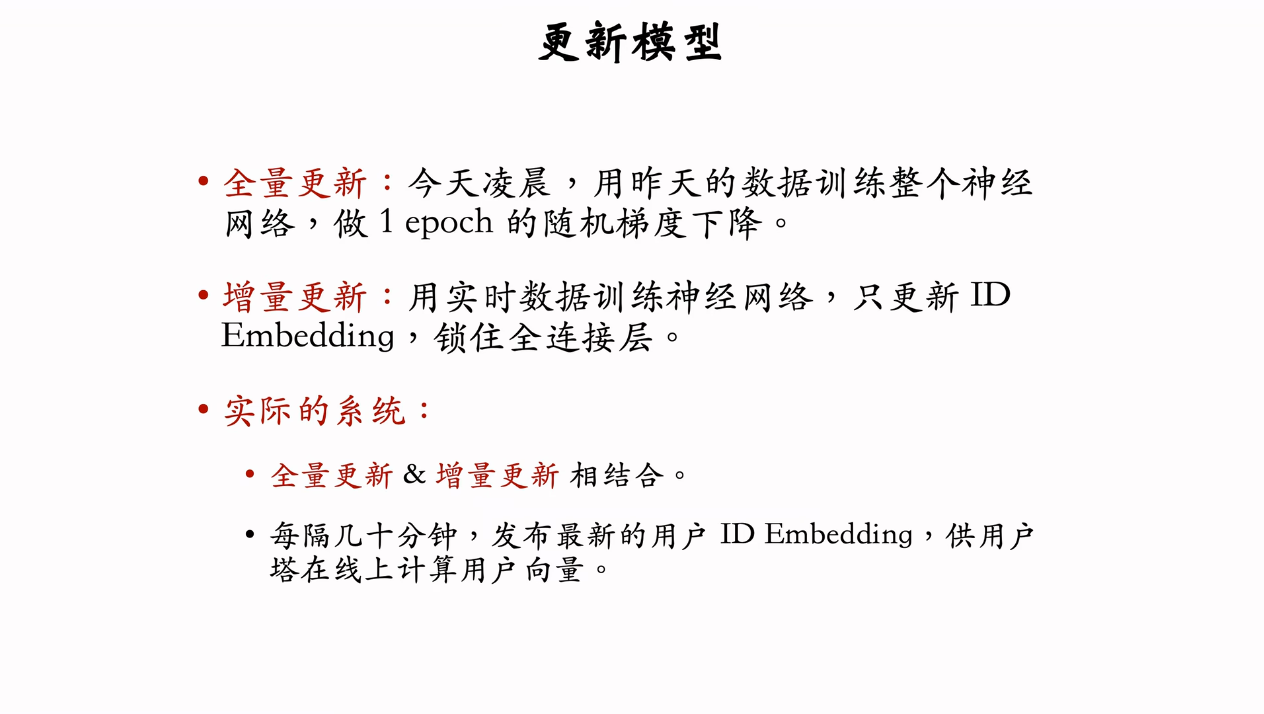
全量更新
- 含义:今天凌晨,用昨天全天的数据训练模型
- 在昨天模型参数的基础上做训练(而不是随机初始化)
- 用昨天的数据打包成TFRecord,训练 1 epoch,即每天数据只用一遍
- 发布新的用户塔神经网络和物品向量,供线上召回使用
- 全量更新对数据流,系统的要求比较低
- 实现比较容易
- 对实时性要求低,晚一两个小时也没关系
- 只需要把每天的数据落表,在凌晨做个批处理,把数据打包成TFRecord文件即可
- 每天发布一次就行
增量更新
- 含义:做 online learning 更新模型参数
- 用户兴趣会随时发生变化,想要让用户的兴趣变化在几小时之内就反应出来,就需要做到小时级别的增量更新
- 对数据流的要求很高,需要实时收集线上数据,做流式处理,实时生成TFRecord文件
- 对模型做 online learning,增量更新ID Embedding 参数(不更新神经网络其他部分的参数),只有做全量更新的时候才会更新全连接层。这主要是出于工程实现的考量
- 发布用户ID Embedding,供用户塔在线上计算用户向量。用户的ID Embedding 是一个哈希表的形式,给定用户ID,可以查出ID Embedding 向量。更新后可以实时反映出用户兴趣,对推荐很有帮助
- 发布用户ID Embedding会有一定延时
全量更新 vs 增量更新
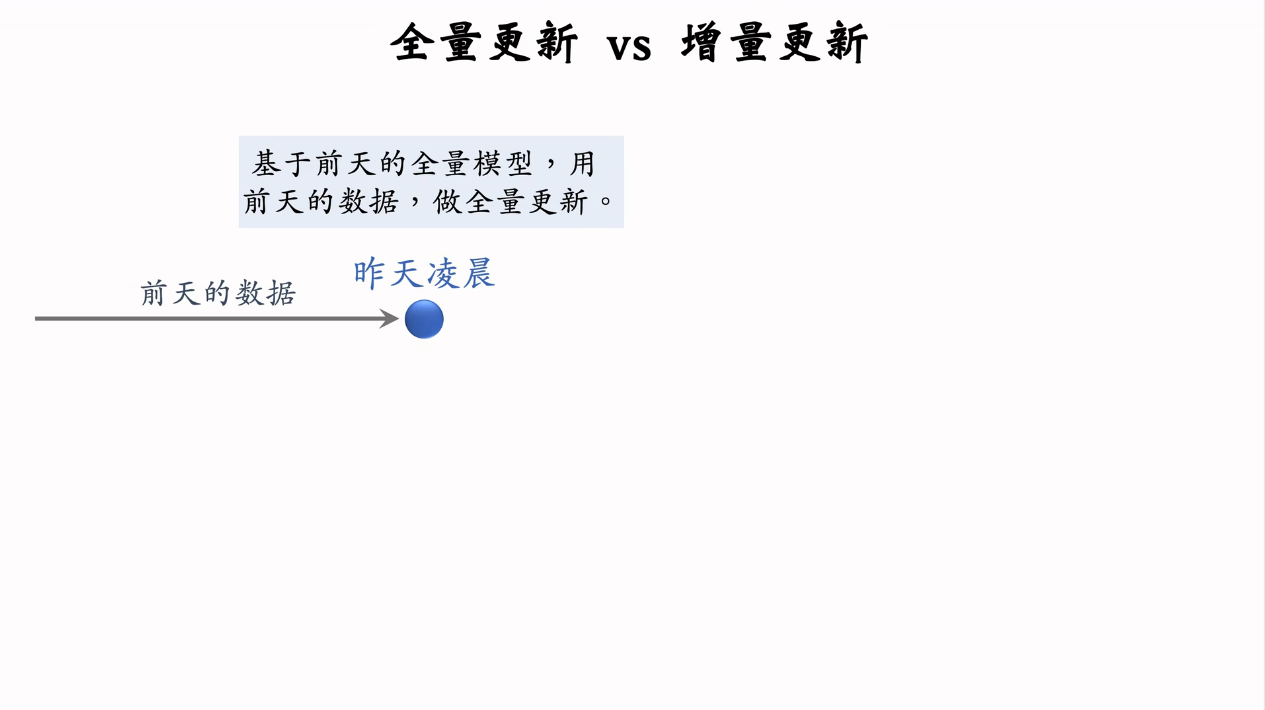
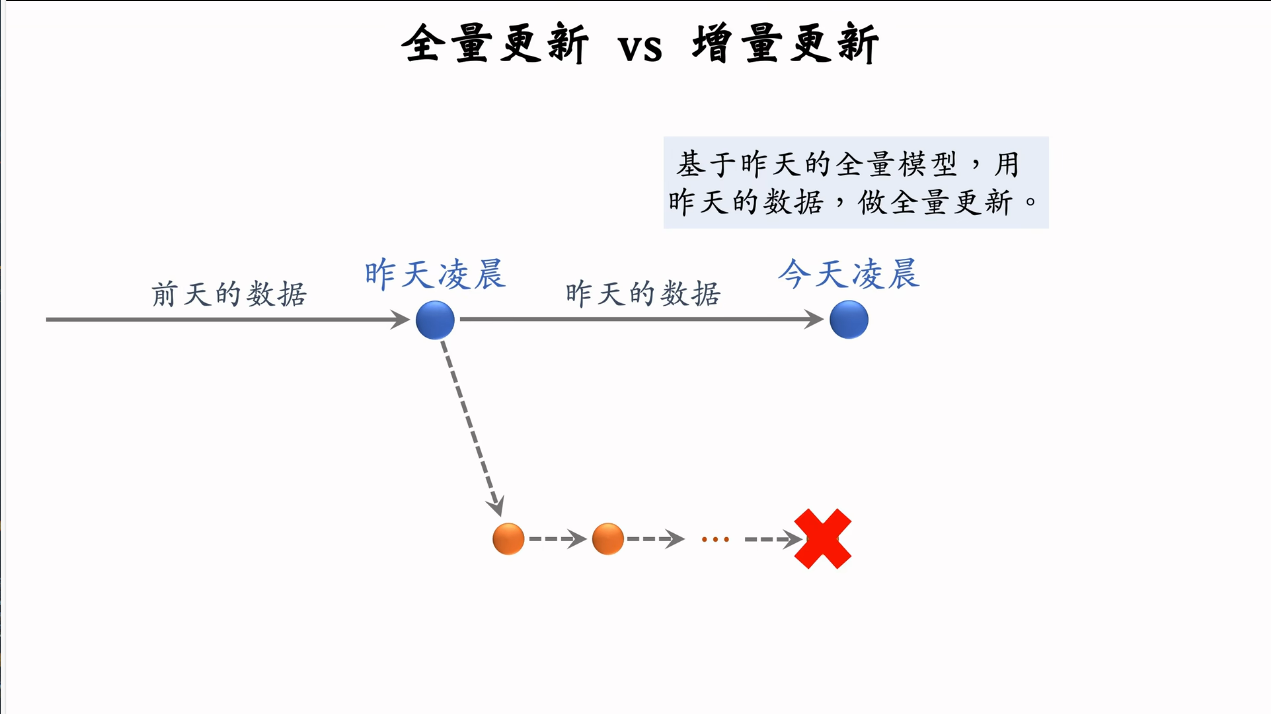
- 基于前天的全量模型,用前天的数据,做全量更新,训练 1 epoch,即每条数据只过一遍
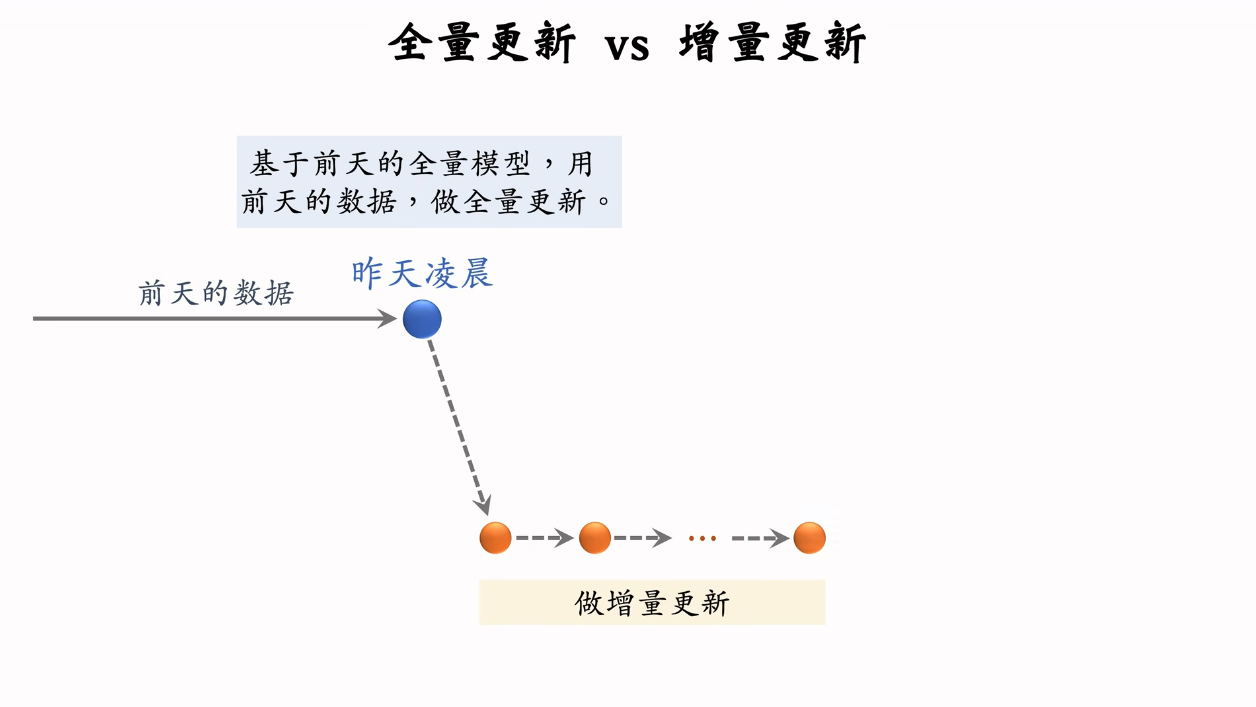
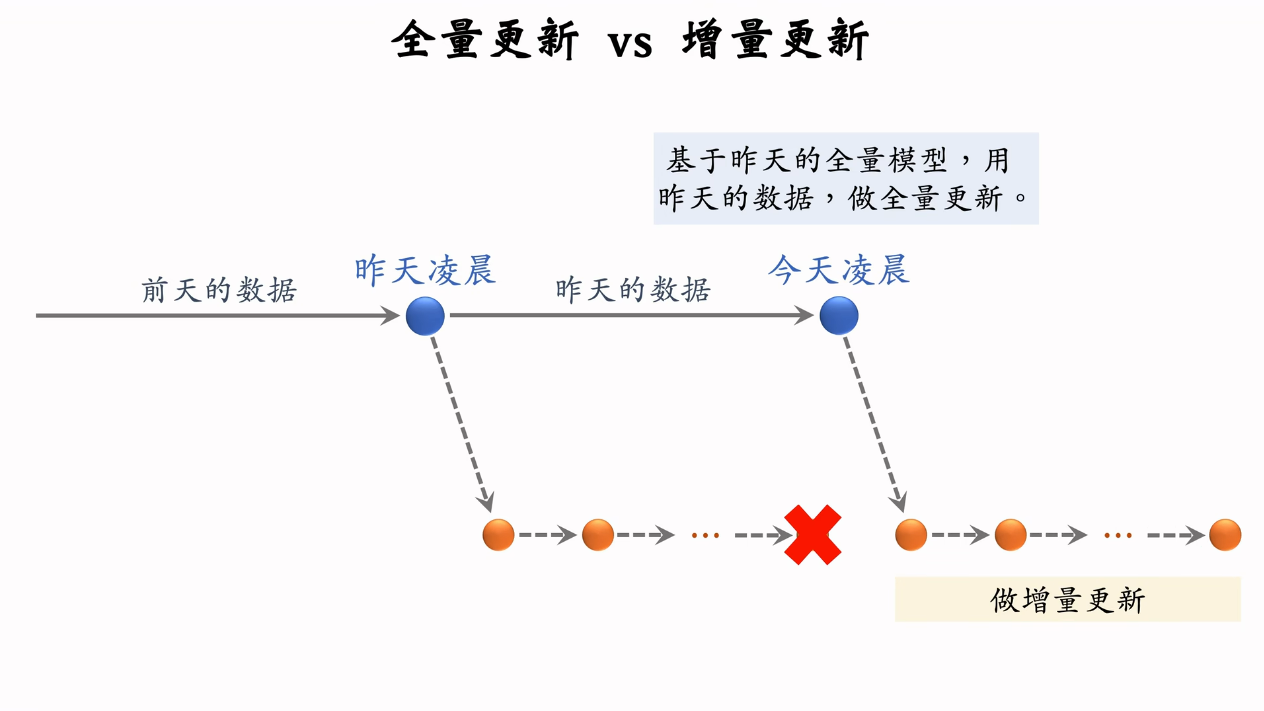
- 之后对全量更新出来的模型做分钟级别的增量更新,从昨天凌晨到今天凌晨,每隔几十分钟做一次 online learning,刷新用户塔的 embedding 层参数
- 在昨天我们又积累了一天的数据,到了今天凌晨,又该做一次全量更新
- 今天凌晨的全量更新是基于昨天全量更新训练出来的模型,而不是用下面增量训练出来的模型,在完成这次全量训练后,下面的增量训练的模型会被丢掉
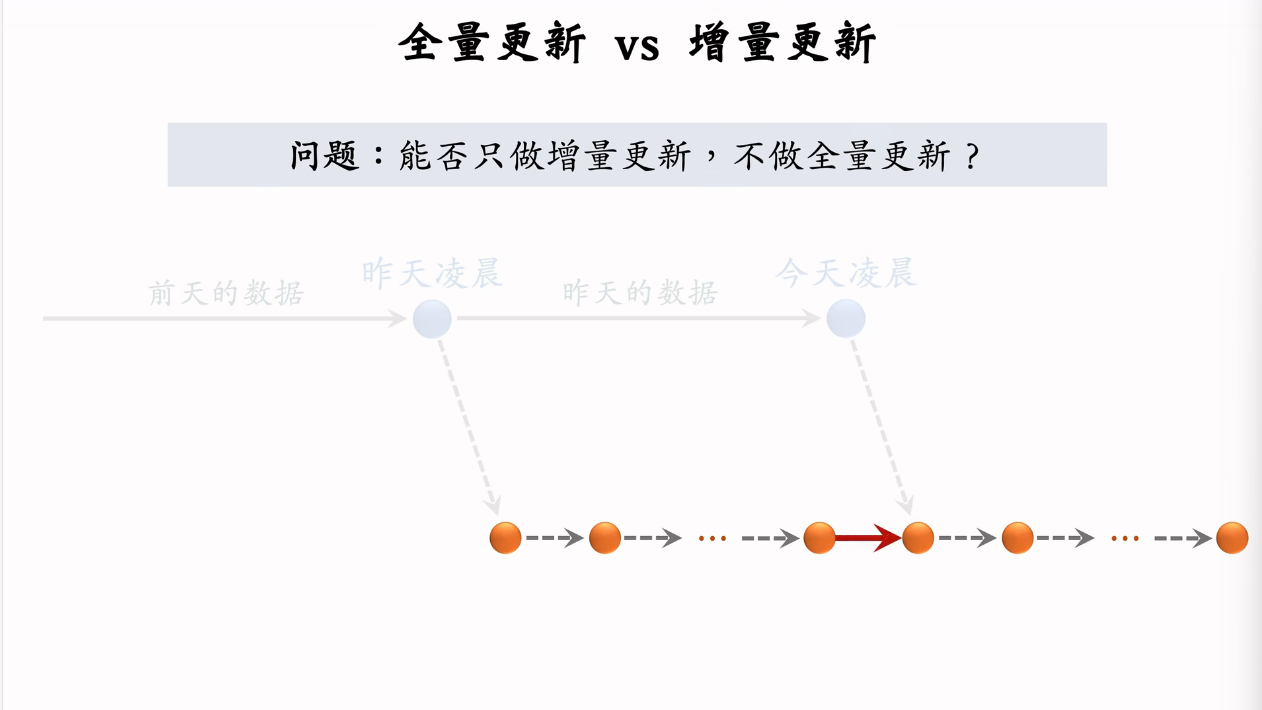
- 然后再对今天凌晨全量更新出来的模型做增量更新,从今天凌晨到每天凌晨,不停做 online learning,每隔几十分钟发布一次模型
- 问题:能够只做增量更新,不做全量更新?
- 只做增量更新,当然比既要做增量又要做全量简单,工程实现更容易,消耗的机器资源也更少
- 但是只做增量效果不好,最好还是都做
- 小时级的数据有偏,分钟级数据偏差更大。在不同的时间段用户的行为是不一样的,比如中午和傍晚会明显不一致
- 全量更新:random shuffle一天的数据,做 1 epoch 训练。random shuffle就是为了消除偏差
- 增量更新:按照数据从早到晚的顺序,做 1 epoch 训练
- 随机打乱优于按顺序排序数据,全量训练优于增量训练
- 全量训练更好,而增量训练可以捕捉用户的实时数据
总结
更多推荐



 12
 0
- 0


 已为社区贡献4条内容

所有评论(0)