
Tree-of-Traversals: A Zero-Shot Reasoning Algorithm for Augmenting Black-box Language Models with Kn
题目
遍历树:一种利用知识图谱增强黑盒语言模型的零样本推理算法
论文地址:https://arxiv.org/pdf/2407.21358
项目地址:https://github.com/amazon-science/tree-of-traversals
摘要
知识图谱 (KG) 通过提供可靠、结构化、领域特定和最新的外部知识来补充大型语言模型 (LLM)。然而,KG 和 LLM 通常是分开开发的,必须在训练后集成。我们引入了 Tree-of-Traversals,这是一种新颖的零样本推理算法,可以使用一个或多个 KG 来增强黑盒 LLM。该算法为 LLM 配备了与 KG 交互的操作,并使 LLM 能够对可能的想法和操作执行树搜索,以找到高置信度的推理路径。我们在两个流行的基准数据集上进行了评估。我们的结果表明,Tree-ofTraversals 显著提高了问答和 KG 问答任务的性能。代码可在 https://github.com/amazon-science/tree-of-traversals 获得
简介
大型语言模型 (LLM) 用于一系列知识密集型任务,例如信息检索 (Zhu et al, 2023b)、摘要 (Zhang et al, 2023) 和问答 (Tan et al, 2023)。这些模型经过大量文本数据的训练,可以学习广泛的信息。然而,LLM 有几个局限性——它们产生的信息是幻觉 (Ji et al, 2022; Bang et al, 2023),缺乏深度领域特定知识 (Pan et al, 2023b),并且在训练结束时具有静态知识截止。
知识图谱 (KG) 自然弥补了 LLM 的弱点。知识图谱包含最新信息,涵盖一般(Vrandeciˇc and Krötzsch ´ ,2014;Lehmann et al, 2015)和/或特定领域主题(Abu-Salih, 2020;Liu et al, 2019;Zhu et al, 2017;Choi and Lee, 2019;Farazi et al,2020) 以高度结构化和可解释的格式实现。利用外部 KG 的最新知识增强 LLM 以自然语言进行推理和响应的能力,为获得可靠且基于事实的 LLM 提供了一条途径。
具有新功能的强大 LLM 的兴起重新引起了人们对将 LLM 与 KGS 相结合的兴趣。最近,许多调查和立场文件强调了它们的综合潜力 (Pan et al, 2023a; Zhu et al, 2023a; Yang et al, 2023; Pan et al, 2023b)。现有研究通过多种方式使用 KG 增强 LLM,例如集成到预训练中 (Yasunaga et al, 2022)、微调 (Zhang et al, 2022) 或随后使用随后训练的组件进行调整 (Lin et al, 2019; Hu et al, 2022)。所有这些都有一些局限性。具体而言,训练或微调大规模 LLM 的计算成本非常高。在某些情况下,模型权重不公开提供。最后,最大的 KG 需要自己的服务器,无法与 LLM 集成在内存中。此外,以前的工作没有考虑使用多个 KG 进行增强的情况。
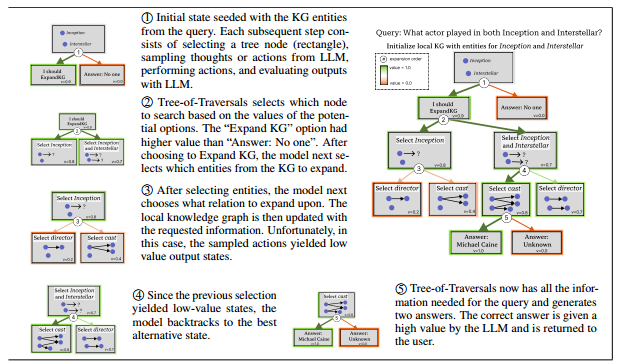
图 1:Tree-of-Traversals 使用 KG 接口进行查询的示例,“哪位演员同时出演了《盗梦空间》和《星际穿越》?”
一种允许使用任意数量的内部或外部 KG 增强强大的黑盒 LLM 而无需从头开始训练或微调模型的算法很有价值。这种零样本算法将实现几个创新用例,例如
- 客户将黑盒 LLM API 与内部特定领域的 KG 结合使用,
- 将个性化 KG 集成到 LLM 中,而无需承担使用此类个人数据训练模型的风险,
- 通过一系列可通过 API 访问的 KG(例如 IMDb1、MusicBrainz2)集成深度领域知识。我们引入了 Tree-of-Traversals,这是一种新颖的算法,它允许以零样本方式使用任意数量的 KG 来增强任何强大的 LLM,从而解决上述问题。它无需训练,可通过黑盒访问 LLM,并与任何可通过 API 访问的 KG 配合使用。
我们的贡献是:
- 遍历树:一种新颖的零样本算法,用于增强具有任意数量 KG 的任何强大 LLM,并使用树搜索实现高级 KG 推理。
- 在两个问答任务上评估遍历树:2WikiMultiHop 和 QALD-10 并与基线进行比较。
- 开发一个新数据集来测试通用和特定领域 KG 的组合推理,并评估该数据集上的遍历树。
我们对托管在 Amazon Bedrock 上的三种不同大小的模型进行了详细的实验,并介绍了详细的消融研究。遍历树算法维护一个本地 KG 子图,该子图会反复扩展,直到它包含 LLM 回答给定查询所需的所有信息。首先,初始化一个本地 KG 子图,以包含原始查询中存在的实体。然后使用树搜索算法对其进行扩展,以选择由 LLM 生成的动作和想法,以便使用 KG 接口从 KG 中获取相关知识。当 LLM 能够使用本地 KG 子图作为上下文回答原始查询时,算法将停止。遍历树由三个主要组件组成。 (1) 实现与一个或多个所需 KG 交互的知识图谱接口。 (2) 动作状态机 (ASM),它是一种有限状态机,当 LLM 与 KG 交互以扩展本地 KG 子图时,它定义动作、状态和提示模板的可行空间。 (3) 树搜索算法,它定义整体 LLM 搜索轨迹,例如最佳首次搜索、犯错时的回溯以及找到答案时的终止条件。
知识图谱接口允许 Tree-ofTraversals 与一个或多个 KG 交互。 假设 K = (E, R, T ) 为单个 KG。E 是实体集,其中每个实体由一个标识符、一个标签和一个可选描述组成(例如,Q35332,“克里斯托弗·诺兰”,“英裔美国电影制片人”)。R 是关系类型的集合,每个关系类型由一个标识符、一个标签和一个可选的逆标签组成(P57,“导演”,“是导演”)。T是 KG 中的边或事实集,其中每条边的形式为 (s, r, o),其中 s、o ∈ E 且 r ∈ R,例如 (‘Inception’、‘director’、‘Christopher Nolan’)。只要实现以下接口,就可以对 K 使用遍历树。
- 初始化 (q) → E0:它将查询 q 作为输入,从 q 中提取实体并返回链接实体 E0 ⊂ E,其中 E0 是 q 中引用的 K 中的实体。
- get_relations(Eselected) → Roptions:它接受一组实体 Eselected,并返回 Eselected 在 K 中的关系类型 Roptions ⊂ R:{r|(s, r, o) ∈ T , s ∈ Eselected} 3. get_edges(Eselected, r) → Tadded, Eadded:它接受一组实体和一个选定的关系类型,并返回 Eselected 中源实体的所有关系类型为 r 的边:{(s, r, o) ∈ T |s ∈ Eselected, r = r, o ∈ E}。它还返回通过 Tadded 到达的新实体 Eadded。此接口在可用时使用 SPARQL 查询实现;否则,我们使用可用于 KG 的图形 API。对于多个 KG,每个接口都是单独实现的。
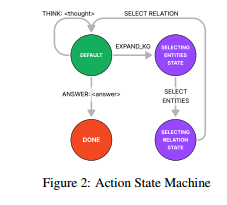
动作状态机 (ASM) 开发适用于任意 KG 的零样本 LLM 算法的挑战之一是 LLM 不知道图中有哪些关系,也不知道对于给定实体哪些关系有效。少样本或上下文学习方法只能覆盖少数可能的关系类型(例如,Wikidata 有超过 11,000 种关系类型)(Brown 等人,2020 年)。为了克服这些问题,我们将扩展局部 KG 子图的任务分解为多个子任务。我们使用具有以下动作的有限状态机:思考,回答、展开 KG、选择实体和选择关系,以及状态:默认、选择实体、选择关系和完成,如图 2 所示。这在整篇论文中被称为动作状态机 (ASM)。
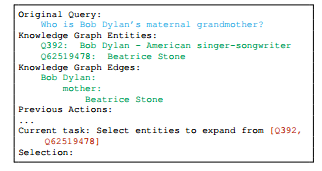
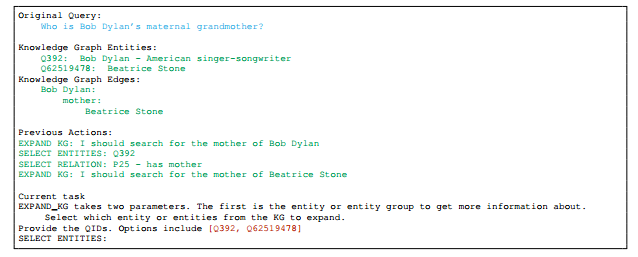
图 3:ASM 的“选择实体”状态提示。原始查询和本地 KG 子图是每个操作状态的提示的一部分,而“当前任务”则有所不同。实体选项显示可以根据当前本地 KG 子图选择哪些实体。如果模型在此处选择了 Q62519478:Beatrice Stone,那么在下一个操作状态(选择关系)中,动态提示将列出 Beatrice Stone 具有边的关系类型。
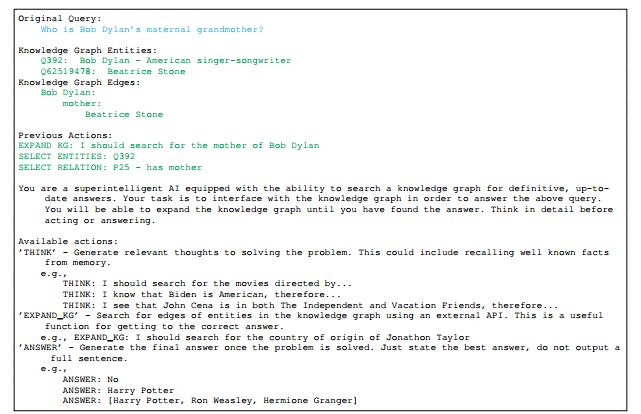
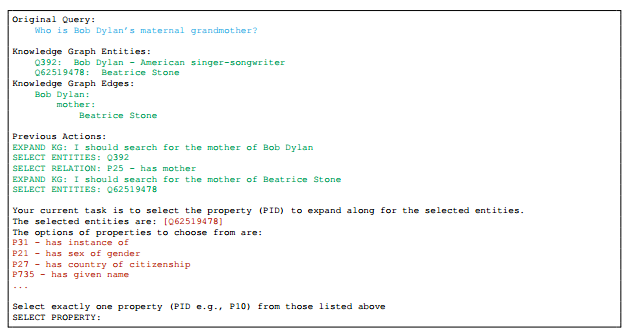
从默认状态开始,遍历树可以思考、回答或选择展开 KG。在遍历树选择展开 KG 后,首先会提示它选择需要更多信息的实体(例如,图 1 中的“Inception”)。然后会提示它从 KG 接口的 get_relations 方法提供的候选关系列表中选择关系。选择关系(例如,图 1 中的“演员”)后,所有包含所选实体之一作为源和所选关系作为关系的边都会添加到本地 KG 子图中。然后,遍历树可以再次回答、思考或展开 KG。提示模板。 ASM 中除“完成”状态之外的每个状态都与一个唯一的提示模板相关联。提示模板在呈现给 LLM 之前,会填充来自本地 KG 子图和 KG 接口的信息。
为每个状态定制提示使我们能够向 LLM 呈现精确且相关的信息以及针对每个状态的具体说明,从而简化 LLM 的任务。例如,“选择实体”的提示显示了本地 KG 子图中可供选择的实体选项(参见图 3)。所有状态的提示模板都在附录 F.1-F.3 中。本地 KG 子图使用高效的 YAML 格式表示,该格式可最大限度地减少同一实体上多个边的重复。调用 KG 接口。除了初始化之外,ASM 需要调用 KG 接口的情况有两次:(1) 构造选择关系提示时,算法调用 get_relations(Eselected) 来收集可用的关系选择。 (2) 在选择关系类型 r 后执行从选择关系到默认关系的转换时,算法调用 get_edges(Eselected, r),以便将新边和实体添加到本地子图中。
树搜索算法我们的方法从 Tree-ofThoughts 方法(Yao et al, 2023)中汲取灵感,其中 LLM 通过允许一次产生多个想法而获得了增强的推理能力,并且在生成的推理链上构建搜索树。我们扩展了这种方法,通过允许生成除了想法之外的动作并在其上构建搜索树,用 KG 增强 LLM。挑战的出现是因为 Tree-ofThoughts 并非设计用于合并动作,也不是为知识密集型问答任务而设计的。因此,我们引入了一些修改:通过 ASM 合并动作,使用略有不同的搜索程序和停止条件以更好地处理 QA,以及在进行约束采样时使用不同的采样程序来提高多样性。
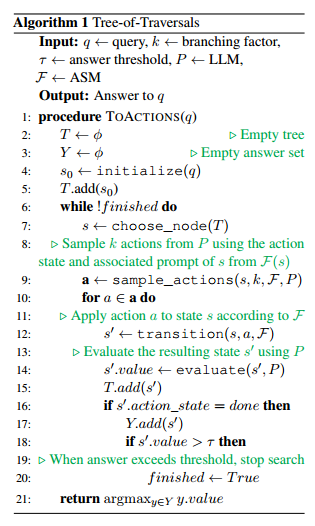
算法 1 提出了 Tree-of-Traversals 树搜索算法。给定一个查询 q,它首先使用第 2.1 节中所述的 initialize(q) 进行初始化。初始化后,它会通过以下方式进行搜索:(1) 根据值函数分配的节点值选择要扩展的未探索节点(最佳优先 → 深度优先作为决胜局),(2) 使用与 ASM 中所选节点状态相关的提示从 LLM 中采样 k 个动作(k 为分支因子),(3) 对于每个采样动作,应用转换函数,以及 (4) 使用 LLM 值函数评估结果节点的值。当找到节点值超过阈值 τ 的答案时,搜索停止。为了限制搜索空间,我们添加了两个超参数:树搜索的最大深度,此后算法被迫转换到完成状态(即回答查询),以及最大扩展,此后模型停止探索并返回“找不到答案”。
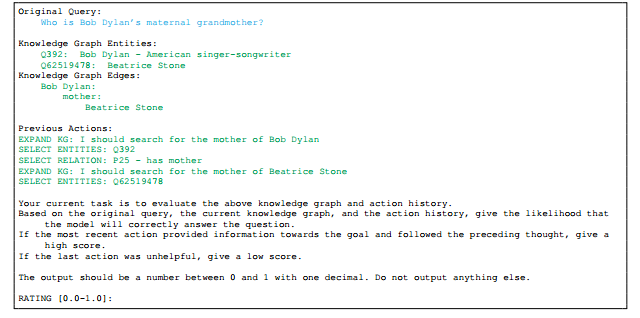
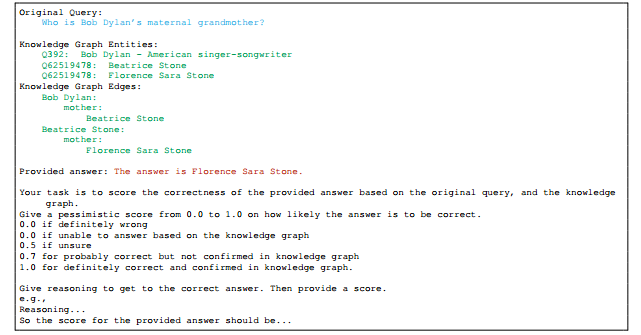
价值函数指导。遍历树计算节点的值以确定其效用。该值由 LLM 使用评估提示(算法 1 中的步骤评估)创建。该值可以在 0 到 1 之间,其中 1 表示最高效用。我们使用两种类型的评估提示:一种用于中间状态,一种用于答案状态。提示包括原始查询、本地 KG 子图、先前操作的轨迹,然后是评估节点的说明(参见附录 F.4 和 F.5)。然后使用这些值来指导对动作空间的探索。具体而言,choose_node 返回具有最高值的未探索节点(最佳优先)。如果有具有相同值的节点,则使用深度优先搜索。
遍历链。在某些情况下,我们可以使用 ASM 和 KG 接口通过单个想法和动作序列找到查询的答案。这相当于分支因子为 k = 1 的 Tree-of-Traversals。我们将其称为 Chain-of-Traversals。虽然对于比较有用,但随后,实验表明考虑多个分支的好处。具有多个 KG 的遍历树 使用多个 KG 扩充 LLM 主要涉及为每个添加的 KG 构建 KG 接口。该算法还有其他一些变化。
- 在 initialize(q) 中提取的实体与每个 KG 接口匹配。
- 在选择关系期间呈现关系选项时,在每个 KG 接口上调用 get_relations(Eselected)。
- 在向本地 KG 子图添加新实体时,我们会为其他 KG 接口调用实体链接函数。
我们允许实体链接函数成为 KG 接口中的单独函数,或者回退到 initialize(o),其中 o 是刚刚添加的实体的文本标签。这使得允许在公共 KG 之间使用显式链接(如果可用),而在没有链接的情况下仍能正常运行。
实验
我们使用 Amazon Bedrock3 上提供的三种不同模型评估 Tree-of-Traversals:ClaudeInstant (claude-instant-v1)、Llama2 70b (llama2-70b-chat-v1) 和 Llama2 13b (llama2-13b-chat-v1)。AWS Bedrock 通过单个 API 提供对各种基础模型的按需访问,包括开源模型和黑盒模型。这正是 Tree-of-Traversals 的设计用例。
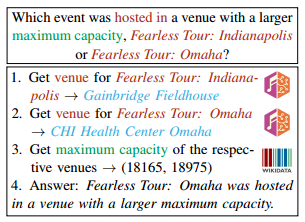
图 4:MusicBrainz-x-Wiki 的示例问题以及 Tree-of-Traversals 如何得出最终答案。
红色表示属于 MusicBrainz 的实体和关系。绿色表示仅在 Wikidata 中的关系。蓝色表示与两个 KG 都链接的实体。
我们首先在用于评估 LLM 知识的两个常见任务上评估 Tree-of-Traversals 算法:2WikiMultiHop 和 QALD-10。为了允许测试需要来自多个 KG 的知识的复杂问题,我们创建了一个需要来自多个 KG 的知识的新数据集。WikiMultiHop 数据集 (Ho et al, 2020) 是通过从 HotPotQA (Yang et al, 2018) 中提取多跳模板,组合模板得到复杂的推理问题,用 Wikidata 生成候选问题,然后确认每条边的实体提及出现在 Wikipedia 段落中而构建的。这些问题的答案可以从 Wikipedia 和 Wikidata 中得出 (Vrandeciˇ c and Krötzsch ´ , 2014)。我们按照 ReAct(Yao 等人,2022 年)中使用的方法从测试集中抽取 500 个问题,包括采样种子值 233。QALD-10 数据集(Usbeck 等人)是一个多语言知识图谱问答 (KGQA) 数据集,其中 395 个问题由人类创建,翻译成其他语言,然后构建为 Wikidata4 上的 SPARQL 查询。
这些问题在推理结构方面比 2WikiMultiHop 中的问题更加多样化(例如需要多个答案或聚合)。我们使用了英语问题。MusicBrainz-x-Wikidata 数据集 Tree-of-Traversals 的一个新用例是综合和推理多个知识图谱源。没有现有的数据集需要综合来自多个 KG 的信息来回答单个问题。因此,为了使用多个知识图谱测试推理能力,我们创建了一个新的数据集 MusicBrainz-x-Wikidata,其中包含 109 个需要使用 MusicBrainz 和 Wikidata 中的信息进行推理的问题。与包含一般知识的 Wikidata 不同,MusicBrainz 是一个关于音乐行业的深度领域特定数据库。
大型语言模型不太可能知道这些信息中的绝大部分。我们与人工注释者一起构建了 MusicBrainz-x-Wikidata 数据集,他们被提供指示以找到这两个知识图谱之间的推理路径、要关注的问题类型和一些示例问题。对精选的问题进行了模糊性和敏感性检查。根据设计,每个问题需要从两个知识图谱中提取信息才能成功回答。除了 2WikiMultiHop 中的推理类型之外,此数据集还包含涉及聚合、聚合比较、资格以及这些的复杂组合的问题。图 3.1 中可以看到一个示例。说明、问题类型和示例的详细信息见附录 A。
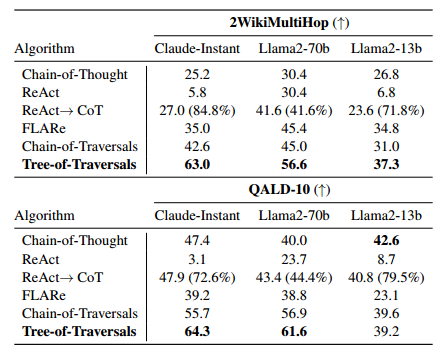
表 1:2WikiMultiHop 数据集上的 EM-in。→CoT 表示当没有给出答案时回退到 Chain-of-Thought。(%) 表示此类情况的数量。
我们使用精确匹配包含 (EM-in) 作为评估指标。如果基本事实答案在答案中的任何地方出现完全匹配,则 EM-in 为 1,否则为 0。这解释了 LLM 倾向于以具有不同语法的句子输出答案。这是一个常见的指标,但通常与精确匹配 (EM) 互换使用 (Sun et al, 2023)。当有多个答案时,我们计算所有标签的平均 EM-in。
我们针对三种可与任何黑盒 LLM 一起使用的相关方法进行了实验:(1) 思维链 (CoT) 提示 (Wei 等人,2022) (2) ReAct (Yao 等人,2022) 在生成想法和生成动作之间进行迭代,以便从 Wikipedia 等文本知识库中进行搜索和检索,以及 (3) 前瞻主动检索 (FLARe) (Jiang 等人,2023b) 在生成想法和从知识库中检索以纠正不准确之处之间进行迭代。
对于所有模型,当不需要多个样本时,我们对 LLM 使用 0.0 的采样温度,当需要多样化样本时,使用 1.0 的温度。我们在两种设置中测试了我们的方法:(1)分支因子为 k = 1,称为遍历链;(2)分支因子为 k = 3,称为遍历树。在这两种设置中,我们将最大深度设置为 7,这意味着在达到深度 7 以外的默认操作状态时,唯一可用的操作就是回答问题。对于遍历树,我们将最大总扩展设置为 20。答案阈值 τ 设置为 0.8,这对应于根据评估提示由 KG 支持的高置信度答案(附录 F.5)。
对于 2WikiMultiHop 和 QALD-10,我们使用 Wikidata 作为知识图谱(Vrandeciˇ c 和 ´ Krötzsch,2014)。对于 MusicBrainz-x-Wikidata,除了 Wikidata,我们还使用 MusicBrainz。我们使用 Wikidata SPARQL 查询5 为 Wikidata 实现 KG 接口,并使用 MusicBrainz KG 为 MusicBrainz 实现 KG 接口API .
结果与讨论
表 1 展示了我们在 2WikiMultiHop 和 QALD-10 上的实验结果。对于所有模型,Tree-of-Traversals 的表现都优于 2WikiMultiHop 上的基线,在零样本设置中为这些任务设定了最先进的结果。我们假设,这种收益大部分归因于 Tree-of-Traversals 通过提出的 KG 接口访问知识库以及其由 ASM 指导的思想行动过程。这是显而易见的,因为即使是不执行树遍历(包括多个想法/动作、回溯和节点值计算)的 Chain-ofTraversals 也明显优于 ReAct 的知识基础:在所有模型上平均时,2WikiMultiHop 上的 ReAct→CoT 准确率比 ReAct→CoT 高 8.7%。与 Chain-of-Traversals 相比,Tree-of-Traversals 进一步提高了性能。它平均使 2WikiMultiHop 的绝对准确率提高了 12.8%,QALD-10 的绝对准确率提高了 4.3%。我们注意到,模型表现越好,从 Tree-of-Traversals 中获得的收益就越多,正如 Llama-70b 和 Llama-13b 之间的差异所示。
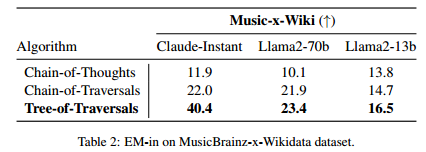
在 MusicBrainz-x-Wikidata(表 2)上,其中包含需要访问两个 KG 的具有挑战性的推理问题,Tree-of-Traversals 比 Chain-of-Traversals 平均相对提高了 37.4%,如表 2 所示。Chain-of-traversals 和 Tree-of-Traversals 在该数据集上的表现都优于 Chain-of-Thoughts。我们只与 Chain-of-Thoughts 相比,其他检索方法对 MusicBrainz 知识库的覆盖率较低。
Tree-of-Traversals 依靠价值函数的信号来选择最终的树轨迹。如果值是任意的,那么 Tree-of-Traversals 不会比 Chain-of-Traversals 做得更好。图 5 显示,所有模型的价值函数都有一个有意义的信号。答案值为 1.0 和 0.0 的准确率平均差异为 31.0%。这表示选择值为 1.0 的答案时,相对于值为 0.0 的答案,平均相对改进了 83.2%。有关每个模型的价值函数的单独配置文件,请参阅附录 C。
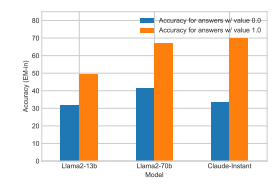
图 5:模型分配值为 0.0 或 1.0 的答案的 EM-in 准确率以及答案对应的真实 EM-in 分数。这包括所有建议的答案,而不仅仅是模型返回的最终答案。
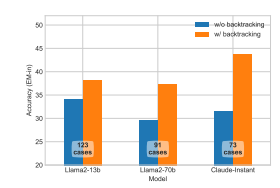
图 6:对需要回溯的 2WikiMultiHop 问题进行有回溯和无回溯的结果比较。
如果不允许回溯,性能将大幅下降。
为了确定 Treeof-Traversals 中回溯的效果,我们提出了一个反事实问题:如果模型无法回溯,其性能会如何(图 6)。我们将分析限制在 2WikiMultiHop 问题上,其中 Tree-of-Traversals 在子树上生成答案,并且模型最终在该子树上回溯(即,我们有反事实的情况)。因此,这些问题通常比问题的整体分布更具挑战性。在这些情况下,我们将从第一个搜索到的子树中获取最高价值答案的结果与回溯后的最终答案进行比较。我们发现回溯能力使 Tree-of-Traversals 的准确率显著提高,范围从 4.1% 到 12.3%。
在 MusicBrainz-x-Wikidata 上的表现。对于 MusicBrainz-x-Wikidata 数据集,我们仅与 Chain-of-Thought 进行比较,因为其他基线算法的实现无法访问类似的音乐特定知识库。尽管如此,我们还是观察到了一些有趣的结果。Chain-of-Thought 在 MusicBrainzx-Wikidata 上的表现远不如在仅基于 Wikipedia/Wikidata 的更通用数据集上的表现(10.1%-13.8% vs. 25.2%-47.4%)。这可能是因为 LLM 是在大量通用知识(例如 Wikipedia 中的知识)上进行训练的,但它们没有使用来自音乐等特定领域的大量数据进行训练。除了存在 KG 接口和带有 Tree-of-Traversals 的 ASM 之外,这可能是 Tree-of-Traversals 在 MusicBrainz-x-Wikidata 上的表现是 Chain-of-Thought 的 2.2 倍的另一个原因。这表明了使用领域特定 KG 和/或多个 KG 来增强 LLM 的重要性,而所提出的 Tree-of-Traversals 能够做到这一点。
ReAct 在大多数情况下表现不如 Chain-of-Thought。这种现象在原始 ReAct 论文中有所体现,该论文指出,尽管准确度较低,但他们的方法显着减少了幻觉(Yao 等人,2022 年)。因此,回归 Chain-of-Thought 可提高 Llama2-70b 和 Claude-Instant 的准确度。我们注意到,claude-instant 在 ReAct 上的表现远远低于 Llama2-70b。主要原因是 claude-instant 拒绝“搜索”人并在执行无效操作后道歉。尽管如此,ReAct→CoT 在 2WikiMultiHop 和 QALD-10 上仍然优于 CoT。FLARe 提高了 2WikiMultiHop 上的模型性能,但没有提高 QALD-10 上的模型性能。这可能是因为 2WikiMultiHop 的文本知识库之间有更好的重叠。
相关作品
知识库问答 有大量的研究历史,研究使用知识图谱来回答问题(Wu et al, 2019; Lan et al, 2021)。这些方法大致可以分为试图将问题解析为逻辑形式的方法(Berant and Liang, 2014; Luo et al, 2018; Zhu et al, 2022)和信息检索方法(Bordes et al, 2015; Chen et al, 2019) 知识增强。最近,研究人员研究了使用知识图谱增强预训练语言模型和 LLM。许多研究都致力于通过训练将知识图谱数据整合到 LLM 中,通常会对模型进行架构更改(Zhang 等人,2019 年;Wang 等人,2019 年;Peters 等人,2019 年;Yamada 等人,2020 年;He 等人,2021 年)。其中一些研究使用专门的图编码器层取得了成功(Yasunaga 等人,2021 年;Sun 等人,2021 年)。一些人试图将此过程与语言模型的预训练相结合(Yasunaga 等人,2022 年)。在 LLM 训练期间加入 KG 的局限性在于:模型无法在不重新训练的情况下整合 KG 更新,无法更改 KG 源(例如,特定领域的源),并且可能由于在模型权重中学习知识而不是显式检索而导致可解释性较低。
此外,这些方法增加了训练过程的复杂性,增加了成本,并且无法与无法访问模型权重的 LLM 一起使用。因此,扩展这些方法通常被视为风险太大。其他方法将 KG 视为更完整的事实来源,并使用 LLM 为 KG 生成结构化查询。Tianle 等人 (2023) 和 Choudhary 和 Reddy (2023) 教 LLM 生成逻辑 KG 查询,然后从 KG 返回匹配的实体。这些方法与基于语义解析的方法有相似之处前面提到的方法。然而,通过返回 KG 的逻辑查询,这些方法失去了 LLM 的推理和常识能力。
一些方法研究了将 KG 或知识库数据注入 LLM 提示。许多方法基于查询 (Lewis et al, 2020; Li et al, 2023) 使用检索机制(例如密集段落检索 (Karpukhin et al, 2020))进行一轮检索。这些方法无法回答更复杂的多跳问题,因为初始检索不太可能包含最终需要的次要或第三级信息。后来的方法使检索过程变得迭代。例如,FLARe (Jiang et al, 2023b) 使用对即将到来的句子的预测来检索相关文档并重新生成,直到句子包含高置信度标记。在 Wang et al (2023) 中,多轮 QA 格式用于多轮检索。ReAct (Yao et al, 2022) 进行多轮思考和行动来查询基于文本的知识库。Jiang et al (2023a) 反复与 KG 交互。在其他平行的工作中,(Sun et al, 2023; Wen et al, 2023) 探索使用基于路径和邻域的搜索方法为 LLM 构建 KG 上下文的方法。上述方法没有结合树搜索或超出 LLM 固有能力的高级推理形式。它们无法探索多种推理路径或解决方案,如果犯了错误也无法回溯。这导致功能较差。此外,上述方法均未探索多个 KG 上的推理。
多知识库 QA。一些工作研究了来自不同领域的问题的 QA。这些作品学习在不同的领域特定 QA 模型之间进行选择,每个模型都在单个知识库上进行训练(Puerto 等人,2021 年;Geigle 等人,2021 年;Puerto 等人,2023 年)。除了需要训练之外,这样的系统无法回答需要综合不同领域信息的问题(MusicBrainz-x-Wikidata)。
结论
Tree-of-Traversals 是一种强大的算法,它使 LLM 能够利用 KG 推理,而无需任何示例、没有模式依赖性、也无需训练。我们在多个 LLM 和数据集上通过实验证明了它的有效性。我们希望 Tree-ofTraversals 继续得到开发,并在研究与个性化用户 KG 的集成方面看到价值以及其他领域特定数据集。
限制
Tree-of-Traversals 比更简单的检索替代方案慢。改进值函数将通过避免沿着树探索的错误路径来减少 LLM 和 KG API 调用的数量。可以实施其他工程解决方案,例如托管图形服务器,以加速 LLM 和 KG 访问。就 token 成本而言,与使用非结构化知识库的许多检索方法相比,KG 文本表示是 token 高效的,因为后者倾向于最大限度地利用 LLM 上下文窗口。但是,与非检索基线相比,token 使用成本显着增加。可以回答的 KG 问题类型受上下文窗口、搜索深度和 LLM 的推理能力的限制。例如,一个非常大的聚合(“有多少座山的海拔超过 3500 米?”)将需要比 LLM 上下文中容纳的更多的实体。未来的工作可以考虑向 ASM 添加其他操作,例如聚合,以便将本地 KG 提炼为更相关的信息。
EM-in 也是一个不完善的指标。日期和数字格式、文本格式和别名的差异可能会导致假阴性。如果模型没有明确回答但在响应中包含正确答案,则可能会出现假阳性。
道德影响
我们预计 Tree-of-Traversals 不会引入新的风险领域,但它可能会对 LLM 或 KG 的现有风险产生未经研究的影响。我们重点介绍以下领域。(i) Tree-of-Traversals 在训练后为 LLM 提供了新功能。虽然在准确性方面具有积极意义,但我们尚未评估其对更广泛的安全指标的影响。(ii) 我们的评估仅限于 KG 和数据集的英文版。应该用其他语言评估 Tree-of-Traversals,以确保一致且公平的体验。 (iii) 我们没有在误导性或欺骗性的知识图谱下进行分析。使用可公开修改的知识图谱确实存在信息可能被欺骗性更改的风险。就积极的道德影响而言,将这项研究公开可以使知识增强型法学硕士的获取更加民主化,因为这种方法不需要大量的培训投资或拥有构建和定制的语言模型。
附录
MusicBrainz x Wiki 有关创建 MusicBrainz x Wiki 数据集的其他信息。
A.1 创建步骤 数据集由注释者以半自动支持的方式创建。我们开发了一个自动化工具来支持以下过程:
- 查找 MusicBrainz 和 Wikidata 中存在的各种类型的链接实体(艺术家、标签、地点、事件等)
- 查找可用于问题以完美识别上述实体的相关实体(例如,底特律老虎队拥有的地方 → 老虎体育场)
- 查找可用于问题以模糊识别链接实体的相关实体,以便可以添加限定符来消除链接实体的歧义。
- 计算 Wikidata 或 MusicBrainz 中实体具有的每种关系类型的边数。
我们使用这些工具创建一组初始的多跳问题,这些问题属于特定的推理类别。然后,我们让人工注释者检查每个问题的合理性(语法正确并且可以明确理解)和歧义性(KG 中只有一个正确答案)。如果可能的话,问题会被重新措辞或修复,以不包含歧义。然后我们剩下 109 个问题的最终集合。
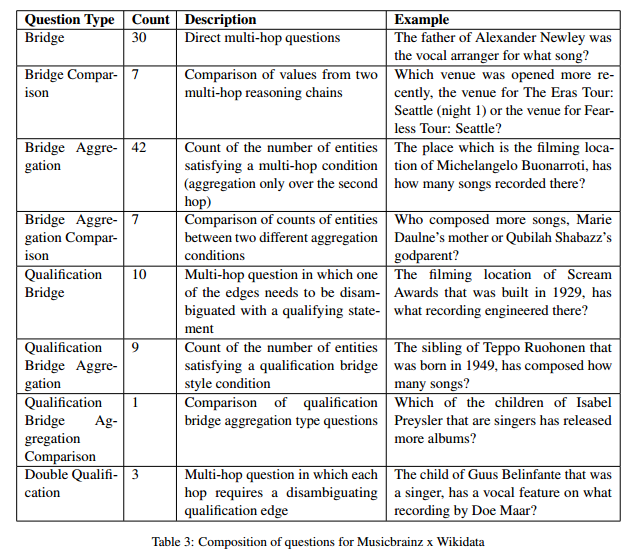
A.2 问题组成 Musicbrainz x Wiki 的问题组成可以在表 3 中找到。
A.3 注释者注释者由大约 10 名研究科学家和工程师组成,他们都说英语,并且居住在美国。
B 实施细节 B.1 多样性过采样。
思想树的一个问题是,当可供选择的选项有限时,LLM 会变得重复并且无法产生多样化的输出(Yao 等人,2023 年)。他们的解决方案使用了“提出提示”,并附加了提出多个不同想法的说明。然而,这为仅与正在完成的任务相关的目的增加了提示的复杂性。我们采用的一种更简单的方法是通过过采样来生成不同的操作。具体而言,如果分支因子为 k,我们从 LLM 中采样 2 ∗ k 个可能的操作,然后提取前 k 个唯一操作以供使用。我们仅将其用于选择实体和选择关系,因为操作选择有限并且需要多样性。此更改不会明显影响 Tree-of-Traversals 的计算成本,因为针对同一提示采样了多个操作,并且平均提示输入大小(100s-1000s 个标记)通常远大于这些操作的平均生成长度(<20 个标记)。由于并行采样多个操作,延迟保持相似。通过这种方式,我们在选择实体或选择关系时始终生成不同的选项。
B.2 超参数 Tree-of-Traversals 没有大量的超参数。大多数超参数都是通过分析选择的,但有些是基于初步实验选择的。我们分享了一些选择它们的信息。τ 是结合完成状态的评估提示(附录 F.5)通过分析选择的。选择为 0.8,以便 Tree-ofTraversals 仅在确信答案得到 KG 支持时才停止。温度选择为 1.0 以促进多样性。如果使用温度可能大于 1.0 的其他模型实施,我们建议进行超参数调整或使用每种类型的示例提示,并通过分析选择温度,以便输出多样化但合理的操作。分支因子 k = 3 是根据小规模实验选择的。较大的 k 使得模型花费更长的时间进行搜索,花费更长的时间并增加费用。较小的 k 不会产生那么多的多样性和选项。值得注意的是,即使使用 k = 3 和多样性采样,有时唯一输出的实际数量也小于 3。
最大深度是通过分析选择的,以使其最小,同时能够回答大多数问题。QALD-10 和 MusicBrainz-x-Wikidata 中的一些问题需要更大的深度才能回答。选择最大扩展截止值纯粹是为了确保模型不会在单个问题上停留太久。实际值有些随意,对准确性的影响很小。
B.3 KG 接口我们介绍了 KG 接口的一些其他细节。初始化函数是一个三步过程。首先,使用 LLM 调用和提示来提取命名实体。其次,对于每个提取的实体,使用 KG API 搜索候选。最后,使用另一个 LLM 调用将提取的实体与最佳候选者匹配。get_relations 和 get_edges 仅使用相应的 KG API 实现。对于 Wikidata,这些是一两个 SPARQL 查询(正向和反向边)。对于 MusicBrainz,它们每个都需要多个 API 调用,因为端点是针对不同实体类型分开的。例如,艺术家和录音有单独的端点。C 值函数配置文件我们对每个价值模型的价值函数进行分析以评估其特征。图 7 显示了 2WikiMultiHop 上每个模型的单个答案值与准确度配置文件。所有模型的答案值与答案的准确性之间都呈正相关。但是,正如预期的那样,存在差异,Llama2-13b 具有最低相关性,而 Claude-Instant 具有最高相关性。
图 7 仅查看最终答案状态的值函数响应,因为这些是唯一具有直接关联的准确度分数的响应。虽然准确评估答案状态更为重要,但我们也希望从中间状态的值中看到一些有用的信号。图 8 显示了搜索路径上节点的平均值答案,以答案得分是否正确为分界线。我们期望最终导致正确答案的操作比导致错误答案的操作具有更高的价值。我们清楚地看到,正确的分布比错误的分布更靠右。这对于 Llama2-13b 来说最不明显,这是可以预料的。我们还注意到 Llama2 模型和 Claude-Instant 之间的分布形状不同。这些结果表明,更大、更强大的模型可能会在价值函数中看到更多改进,因此 Tree-ofTraversals 的效用也更大。
D 提示工程在我们的方法和 ReAct 的模型之间切换时,需要进行一些提示重新工程。这种工程主要限于响应的格式。例如,Llama2 会以“所以下一个操作应该是”开头,而我们要求操作以“THINK”、“EXPAND_KG”或“ANSWER”开头。相反,我们将“所以下一个操作应该是:”合并到提示中,以便输出以所选操作开始。对于选择实体,我们添加了“您已选择以下要扩展的实体:”。对于选择属性,我们添加了“我建议选择属性:”。这些问题也可以通过更改所呈现提示的解析来解决。E 回退到思维链 (→CoT) 当深度 7 之后没有提供答案或答案中出现以下短语之一时,我们会回退到 ReAct 基线的思维链:’确定’、’无法’、’不能’、’未知’、’不确定’ 或 ’不可能’。虽然这些当然可以出现在有意的答案中,但我们发现它们始终且只出现在非答案风格的响应中。
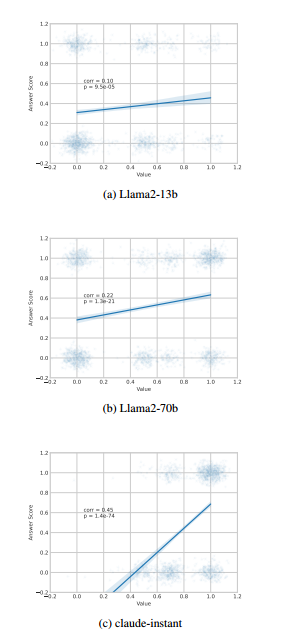
图 7:2Wiki 上所有 Treeof-Traversals 答案的 EM-in 准确度与价值函数。为了便于查看,点被抖动。趋势线表示相关性和 p 值
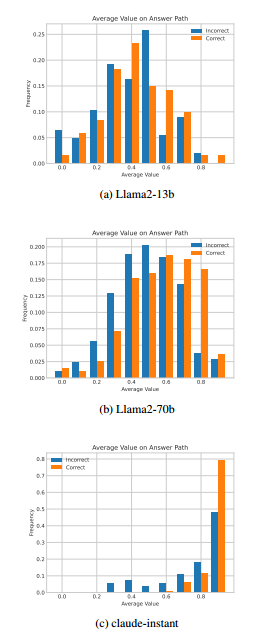
图 8:每个答案路径上的中间步骤的平均值函数,由答案被评为正确还是错误来区分。对于模型提出的每个答案,路径上的分数被平均,并绘制出结果分布。数据来自 2WikiMultiHop 结果。
提示 以下页面包含 Tree-of-Traversals 中使用的提示。根据查询、KG 状态、操作历史而变化的动态组件以颜色显示。F.1 默认操作状态的提示
F.2 选择实体操作状态的提示
F.3 选择关系动作状态提示
F.4 评估的一般提示
F.5 提示对答案进行评估(完成)
更多推荐


 10
 0
- 0


 已为社区贡献4条内容

所有评论(0)