
spark MLlib中分类算法的具体操作
一、逻辑斯蒂回归分类器
逻辑斯蒂回归(logistic regression)是统计学习中的经典分类方法,属于对数线性模型。logistic回归的因变量可以是二分类的,也可以是多分类的。


任务描述:以iris数据集(iris)为例进行分析(iris下载地址:http://dblab.xmu.edu.cn/blog/wp-content/uploads/2017/03/iris.txt)
iris以鸢尾花的特征作为数据来源,数据集包含150个数据集,分为3类,每类50个数据,每个数据包含4个属性,是在数据挖掘、数据分类中非常常用的测试集、训练集。为了便于理解,这里主要用后两个属性(花瓣的长度和宽度)来进行分类。
1、用二项逻辑斯蒂回归来解决二分类问题
首先我们先取其中的后两类数据,用二项逻辑斯蒂回归进行二分类分析
(1)导入需要的包
import org.apache.spark.sql.Row
import org.apache.spark.sql.SparkSession
import org.apache.spark.ml.linalg.{Vector,Vectors}
import org.apache.spark.ml.evaluation.MulticlassClassificationEvaluator
import org.apache.spark.ml.{Pipeline,PipelineModel}
import org.apache.spark.ml.feature.{IndexToString, StringIndexer, VectorIndexer,HashingTF, Tokenizer}
import org.apache.spark.ml.classification.LogisticRegression
import org.apache.spark.ml.classification.LogisticRegressionModel
import org.apache.spark.ml.classification.{BinaryLogisticRegressionSummary, LogisticRegression}
import org.apache.spark.sql.functions;
(2)读取数据,简要分析
import spark.implicits._
case class Iris(features: org.apache.spark.ml.linalg.Vector, label: String)
val data = spark.sparkContext.
      textFile("file:///home/GHL/software/spark/data/mllib/iris.txt").
      map(_.split(",")).
      map(p => Iris(| Vectors.dense(p(0).toDouble,p(1).toDouble,p(2).toDouble,p(3).toDouble,p(4).toString()))).toDF()
data.show()
因为我们现在处理的是2分类问题,所以我们不需要全部的3类数据,我们要从中选出两类的数据
首先把刚刚得到的数据注册成一个表iris,注册成这个表之后,我们就可以通过sql语句进行数据查询
data.createOrReplaceTempView("iris")
val df = spark.sql("select * from iris where label != 'Iris-setosa'")
df.map(t => t(1)+":"+t(0)).collect().foreach(println)
(3)构建ML的pipeline
1)分别获取标签列和特征列,进行索引,并进行了重命名
val labelIndexer = new StringIndexer().setInputCol("label").setOutputCol("indexedLabel").fit(df)
val featureIndexer = new VectorIndexer().setInputCol("features").setOutputCol("indexedFeatures").fit(df)
2)接下来,我们把数据集随机分成训练集和测试集,其中训练集占70%
val Array(trainingData, testData) = df.randomSplit(Array(0.7, 0.3))
trainingData:
val lr = new LogisticRegression().setLabelCol("indexedLabel").setFeaturesCol("indexedFeatures").setMaxIter(10).setRegParam(0.3).setElasticNetParam(0.8)
3)然后,我们设置logistic的参数,这里我们统一用setter的方法来设置,也可以用ParamMap来设置(具体的可以查看spark mllib的官网)。这里我们设置了循环次数为10次,正则化项为0.3等
val lr = new LogisticRegression().setLabelCol("indexedLabel").setFeaturesCol("indexedFeatures").setMaxIter(10).setRegParam(0.3).setElasticNetParam(0.8)
4)这里我们设置一个labelConverter,目的是把预测的类别重新转化成字符型的
val labelConverter = new IndexToString().setInputCol("prediction").setOut
putCol("predictedLabel").setLabels(labelIndexer.labels)
5)构建pipeline,设置stage,然后调用fit()来训练模型
val lrPipeline = new Pipeline().setStages(Array(labelIndexer, featureIndexer, lr, labelConverter))
val lrPipelineModel = lrPipeline.fit(trainingData)
6)pipeline本质上是一个Estimator,当pipeline调用fit()的时候就产生了一个PipelineModel,本质上是一个Transformer。然后这个PipelineModel就可以调用transform()来进行预测,生成一个新的DataFrame,即利用训练得到的模型对测试集进行验证
val lrPredictions = lrPipelineModel.transform(testData)
7)最后我们可以输出预测的结果,其中select选择要输出的列,collect获取所有行的数据,用foreach把每行打印出来。其中打印出来的值依次分别代表该行数据的真实分类和特征值、预测属于不同分类的概率、预测的分类
lrPredictions.select("predictedLabel", "label", "features", "probability").collect().foreach { case Row(predictedLabel: String, label: String, features: Vector, prob: Vector) => println(s"($label, $features) --> prob=$prob, predicted Label=$predictedLabel")}
(4)模型评估
创建一个MulticlassClassificationEvaluator实例,用setter方法把预测分类的列名和真实分类的列名进行设置;然后计算预测准确率和错误率
val evaluator = new MulticlassClassificationEvaluator().setLabelCol("indexedLabel").setPredictionCol("prediction")
val lrAccuracy = evaluator.evaluate(lrPredictions)
println("Test Error = " + (1.0 - lrAccuracy))
接下来我们可以通过model来获取我们训练得到的逻辑斯蒂模型。前面已经说过model是一个PipelineModel,因此我们可以通过调用它的stages来获取模型,具体如下:
val lrModel = lrPipelineModel.stages(2).asInstanceOf[LogisticRegressionModel]
> println("Coefficients: " + lrModel.coefficients+"Intercept: "+lrModel.intercept+"numClasses: "+lrModel.numClasses+"numFeatures: "+lrModel.numFeatures)
二、决策树分类器
决策树(decision tree)是一种基本的分类与回归方法,这里主要介绍用于分类的决策树。决策树模式呈树形结构,其中每个内部节点表示一个属性上的测试,每个分支代表一个测试输出,每个叶节点代表一种类别。学习时利用训练数据,根据损失函数最小化的原则建立决策树模型;预测时,对新的数据,利用决策树模型进行分类
决策树学习通常包括3个步骤:特征选择、决策树的生成和决策树的剪枝
(一)特征选择
特征选择在于选取对训练数据具有分类能力的特征,这样可以提高决策树学习的效率。通常特征选择的准则是信息增益(或信息增益比、基尼指数等),每次计算每个特征的信息增益,并比较它们的大小,选择信息增益最大(信息增益比最大、基尼指数最小)的特征
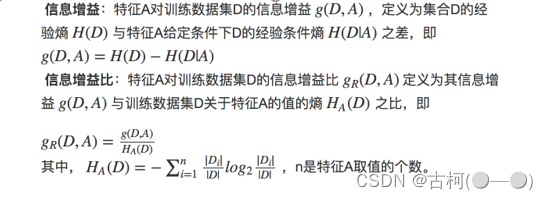
(二)决策树的生成
从根结点开始,对结点计算所有可能的特征的信息增益,选择信息增益最大的特征作为结点的特征,由该特征的不同取值建立子结点,再对子结点递归地调用以上方法,构建决策树;直到所有特征的信息增均很小或没有特征可以选择为止,最后得到一个决策树
决策树需要有停止条件来终止其生长的过程。一般来说最低的条件是:当该节点下面的所有记录都属于同一类,或者当所有的记录属性都具有相同的值时。这两种条件是停止决策树的必要条件,也是最低的条件。在实际运用中一般希望决策树提前停止生长,限定叶节点包含的最低数据量,以防止由于过度生长造成的过拟合问题
(三)决策树的剪枝
决策树生成算法递归地产生决策树,直到不能继续下去为止。这样产生的树往往对训练数据的分类很准确,但对未知的测试数据的分类却没有那么准确,即出现过拟合现象。解决这个问题的办法是考虑决策树的复杂度,对已生成的决策树进行简化,这个过程称为剪枝。
我们以iris数据集(iris)为例进行分析(iris下载地址:http://dblab.xmu.edu.cn/blog/wp-content/uploads/2017/03/iris.txt)
iris以鸢尾花的特征作为数据来源,数据集包含150个数据集,分为3类,每类50个数据,每个数据包含4个属性,是在数据挖掘、数据分类中非常常用的测试集、训练集。
1. 导入需要的包
import org.apache.spark.sql.SparkSession
import org.apache.spark.ml.linalg.{Vector,Vectors}
import org.apache.spark.ml.Pipeline
import org.apache.spark.ml.feature.{IndexToString, StringIndexer, VectorIndexer}
2. 读取数据,简要分析
import spark.implicits._
case class Iris(features: org.apache.spark.ml.linalg.Vector, label: String)
val data = spark.sparkContext.textFile("file:///usr/local/spark/iris.txt").map(_.split(",")).map(p => Iris(Vectors.dense(p(0).toDouble,p(1).toDouble,p(2).toDouble, p(3).toDouble),p(4).toString())).toDF()
data.createOrReplaceTempView("iris")
val df = spark.sql("select * from iris")
df.map(t => t(1)+":"+t(0)).collect().foreach(println)
3. 进一步处理特征和标签,以及数据分组
val labelIndexer = new StringIndexer().setInputCol("label").setOutputCol("indexedLabel").fit(df)
val featureIndexer = new VectorIndexer().setInputCol("features").setOutputCol("indexedFeatures").setMaxCategories(4).fit(df)
val labelConverter = new IndexToString().setInputCol("prediction").setOutputCol("predictedLabel").setLabels(labelIndexer.labels)
val Array(trainingData, testData) = data.randomSplit(Array(0.7, 0.3))
4. 构建决策树分类模型
//导入所需要的包
import org.apache.spark.ml.classification.DecisionTreeClassificationModel
import org.apache.spark.ml.classification.DecisionTreeClassifier
import org.apache.spark.ml.evaluation.MulticlassClassificationEvaluator
//训练决策树模型,这里我们可以通过setter的方法来设置决策树的参数,也可以用ParamMap来设置(具体的可以查看spark mllib的官网)。具体的可以设置的参数可以通过explainParams()来获取。
val dtClassifier = new DecisionTreeClassifier().setLabelCol("indexedLabel").setFeaturesCol("indexedFeatures")
//在pipeline中进行设置
val pipelinedClassifier = new Pipeline().setStages(Array(labelIndexer, featureIndexer, dtClassifier, labelConverter))
//训练决策树模型
val modelClassifier = pipelinedClassifier.fit(trainingData)
//进行预测
val predictionsClassifier = modelClassifier.transform(testData)
//查看部分预测的结果
predictionsClassifier.select("predictedLabel", "label", "features").show(20)
5. 评估决策树分类模型
val evaluatorClassifier = new MulticlassClassificationEvaluator().setLabelCol("indexedLabel").setPredictionCol("prediction").setMetricName("accuracy")
val accuracy = evaluatorClassifier.evaluate(predictionsClassifier)
println("Test Error = " + (1.0 - accuracy))
val treeModelClassifier = modelClassifier.stages(2).asInstanceOf[DecisionTreeClassificationModel]
println("Learned classification tree model:\n" + treeModelClassifier.toDebugString)
6. 构建决策树回归模型
//导入所需要的包
import org.apache.spark.ml.evaluation.RegressionEvaluator
import org.apache.spark.ml.regression.DecisionTreeRegressionModel
import org.apache.spark.ml.regression.DecisionTreeRegressor
//训练决策树模型
val dtRegressor = new DecisionTreeRegressor().setLabelCol("indexedLabel").setFeaturesCol("indexedFeatures")
//在pipeline中进行设置
val pipelineRegressor = new Pipeline().setStages(Array(labelIndexer, featureIndexer, dtRegressor, labelConverter))
//训练决策树模型
val modelRegressor = pipelineRegressor.fit(trainingData)
//进行预测
val predictionsRegressor = modelRegressor.transform(testData)
//查看部分预测结果
predictionsRegressor.select("predictedLabel", "label", "features").show(20)
7. 评估决策树回归模型
val evaluatorRegressor = new RegressionEvaluator().setLabelCol("indexedLabel").setPredictionCol("prediction").setMetricName("rmse")
val rmse = evaluatorRegressor.evaluate(predictionsRegressor)
println("Root Mean Squared Error (RMSE) on test data = " + rmse)
val treeModelRegressor = modelRegressor.stages(2).asInstanceOf[DecisionTreeRegressionModel]
println("Learned regression tree model:\n" + treeModelRegressor.toDebugString)
更多推荐

 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)