
spark RDD算子(十二)之RDD 分区操作上mapPartitions, mapPartitionsWithIndex
·
一、mapPartitions
mapPartition可以倒过来理解。先partition,再把每个partition进行map函数
适用场景:
如果再映射的过程中需要频繁创建额外的对象,使用mapPartitions要比map高效的多
比如,将RDD中的所有数据通过JDBC连接写入数据库,如果使用map函数,可能要为每一个元素都创建一个connection,这样开销很大,如果使用mapPartitions,那么只需要针对每一个分区建立一个connection。
案例:把每一个元素平方
Java版本
public class mapPartitionsJava {
    public static void main(String[] args) {
        SparkConf conf = new SparkConf().setMaster("local").setAppName("mapPartitions");
        JavaSparkContext sc = new JavaSparkContext(conf);

        JavaRDD<Integer> rdd = sc.parallelize(Arrays.asList(1, 2, 3, 4, 5, 6, 7, 8, 9, 10));
        JavaRDD<Integer> mapPartitionsRDD = rdd.mapPartitions(new FlatMapFunction<Iterator<Integer>, Integer>() {
            @Override
            public Iterator<Integer> call(Iterator<Integer> it) throws Exception {
                ArrayList<Integer> results = new ArrayList<>();
                while (it.hasNext()) {
                    int i = it.next();
                    results.add(i * i);
                }
                return  results.iterator();
            }
        });

        mapPartitionsRDD.foreach(new VoidFunction<Integer>() {
            @Override
            public void call(Integer integer) throws Exception {
                System.out.println(integer);
            }
        });
    }
}
案例:把每一个数字i变成一个map(i,i*i)的形式
Scala版本
object mapPartitionsScala {
  def main(args: Array[String]): Unit = {
    val conf = new SparkConf().setMaster("local").setAppName("mapPartitions")
    val sc = new SparkContext(conf)

    //把每一个元素变成map(i,i*i)
    val rdd = sc.parallelize(List(1,2,3,4,5,6,7),3)
    def mapPartFunc(iter:Iterator[Int]):Iterator[(Int,Int)]={
      var res=List[(Int,Int)]()
      while (iter.hasNext){
        val next = iter.next()
        res=res.::(next,next*next)
      }
      res.iterator
    }
    val mapPartitionsRDD = rdd.mapPartitions(mapPartFunc)
    mapPartitionsRDD.foreach(println)
  }
}

Java版本
JavaRDD<Integer> rdd = sc.parallelize(Arrays.asList(1, 2, 3, 4, 5, 6, 7, 8, 9, 10));
JavaRDD<Tuple2<Integer, Integer>> tuple2JavaRDD =
        rdd.mapPartitions(new FlatMapFunction<Iterator<Integer>, Tuple2<Integer, Integer>>() {
    @Override
    public Iterator<Tuple2<Integer, Integer>> call(Iterator<Integer> it) throws Exception {
        ArrayList<Tuple2<Integer, Integer>> tuple2s = new ArrayList<>();
        while (it.hasNext()) {
            Integer next = it.next();
            tuple2s.add(new Tuple2<Integer, Integer>(next, next * next));
        }
        return tuple2s.iterator();
    }
});

tuple2JavaRDD.foreach(new VoidFunction<Tuple2<Integer, Integer>>() {
    @Override
    public void call(Tuple2<Integer, Integer> tup2) throws Exception {
        System.out.println(tup2);
    }
});
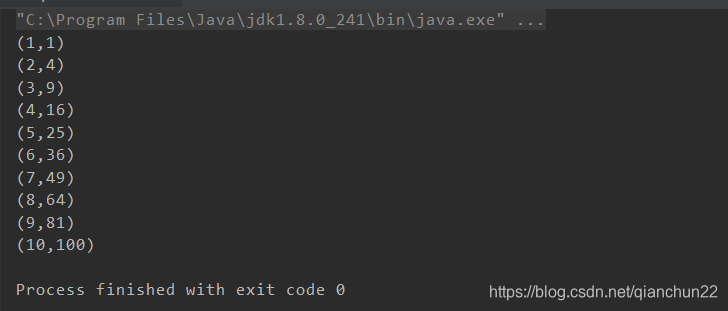
案例:mapPartitions操作键值对 把(i,j) 变成(i,j*j)
Scala版本
//mapPartitions操作键值对 把(i,j) 变成(i,j*j)
val rdd = sc.parallelize(List((1,1),(1,2),(1,3),(2,1),(2,2),(2,3)))
def mapPartFunc(iter:Iterator[(Int,Int)]):Iterator[(Int,Int)]={
  var res = List[(Int,Int)]()
  while (iter.hasNext){
    val next = iter.next()
    res=res.::(next._1,next._2*next._2)
  }
  res.iterator
}
val mapPartitionsRDD = rdd.mapPartitions(mapPartFunc)
mapPartitionsRDD.foreach(println(_))
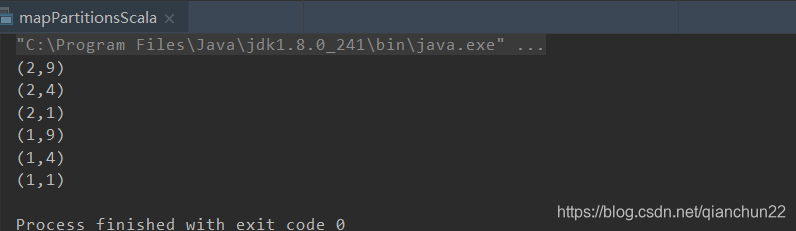
Java版本
//将JavaRDD转换成JavaPairRDD
JavaPairRDD<Integer, Integer> pairRDD = JavaPairRDD.fromJavaRDD(rdd1);
JavaRDD<Tuple2<Integer, Integer>> mapPartitionsRDD = pairRDD.mapPartitions(new FlatMapFunction<Iterator<Tuple2<Integer, Integer>>, Tuple2<Integer, Integer>>() {
    @Override
    public Iterator<Tuple2<Integer, Integer>> call(Iterator<Tuple2<Integer, Integer>> tup2It) throws Exception {
        ArrayList<Tuple2<Integer, Integer>> tuple2s = new ArrayList<>();
        while (tup2It.hasNext()) {
            Tuple2<Integer, Integer> next = tup2It.next();
            tuple2s.add(new Tuple2<Integer, Integer>(next._1, next._2 * next._2));
        }
        return tuple2s.iterator();
    }
});

mapPartitionsRDD.foreach(new VoidFunction<Tuple2<Integer, Integer>>() {
    @Override
    public void call(Tuple2<Integer, Integer> tup2) throws Exception {
        System.out.println(tup2);
    }
});
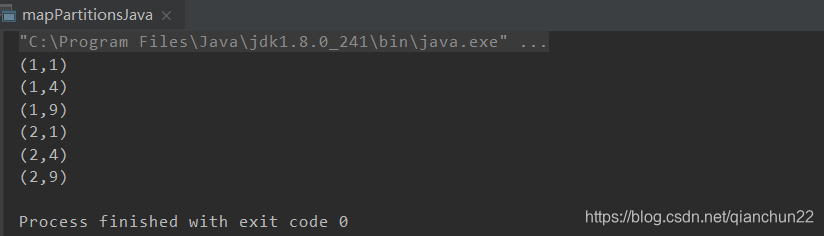
二、mapPartitionsWithIndex
与mapPartitionWithIndex类似,也是按照分区进行的map操作,不过mapPartitionsWithIndex传入的参数多了一个分区的值
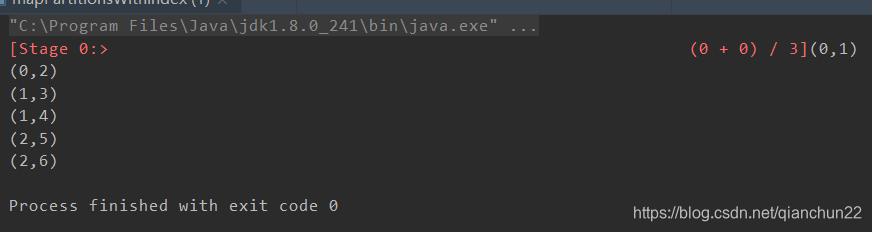
案例:统计各个分区中的元素 (稍加修改可以做统计各个分区的数量)
Scala版本
object mapPartitionsWithIndex {
  def main(args: Array[String]): Unit = {
    val conf = new SparkConf().setMaster("local").setAppName("mapPartitionsWithIndex")
    val sc = new SparkContext(conf)

    //统计各个分区中的元素
    val rdd = sc.parallelize(List(1,2,3,4,5,6),3)
    def mapPartWithIndexFunc(i1:Int, iter:Iterator[Int]):Iterator[(Int,Int)]={
      var res = List[(Int,Int)]()
      while (iter.hasNext){
        var next = iter.next()
        res=res.::(i1,next)
      }
      res.iterator
    }
    val mapPartitionsWithIndexRDD = rdd.mapPartitionsWithIndex(mapPartWithIndexFunc)
    mapPartitionsWithIndexRDD.foreach(println(_))
  }
}
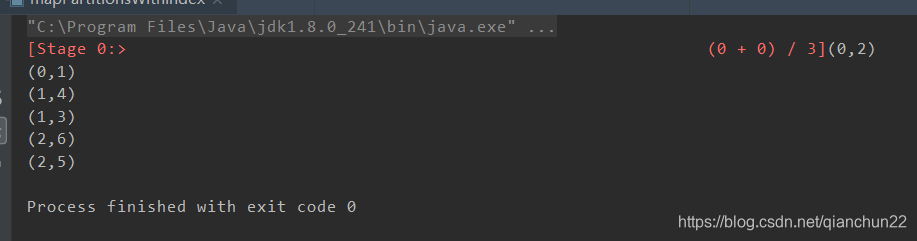
Java版本
public class mapPartitionsWithIndex {
    public static void main(String[] args) {
        SparkConf conf = new SparkConf().setMaster("local").setAppName("mapPartitionsWithIndex");
        JavaSparkContext sc = new JavaSparkContext(conf);

        //统计各个分区中的元素
        JavaRDD<Integer> rdd = sc.parallelize(Arrays.asList(1, 2, 3, 4, 5, 6), 3);
        JavaRDD<Tuple2<Integer, Integer>> mapPartitionsWithIndexRDD =
                rdd.mapPartitionsWithIndex(new Function2<Integer, Iterator<Integer>, Iterator<Tuple2<Integer, Integer>>>() {
            @Override
            public Iterator<Tuple2<Integer, Integer>> call(Integer partIndex, Iterator<Integer> it) throws Exception {
                ArrayList<Tuple2<Integer, Integer>> tuple2s = new ArrayList<>();
                while (it.hasNext()) {
                    Integer next = it.next();
                    tuple2s.add(new Tuple2<Integer, Integer>(partIndex, next));
                }
                return tuple2s.iterator();
            }
        }, false);
        mapPartitionsWithIndexRDD.foreach(new VoidFunction<Tuple2<Integer, Integer>>() {
            @Override
            public void call(Tuple2<Integer, Integer> tup2) throws Exception {
                System.out.println(tup2);
            }
        });
    }
}
案例:mapPartitionsWithIndex 统计键值对中的各个分区的元素
Scala版本
//mapPartitionsWithIndex 统计键值对中的各个分区的元素
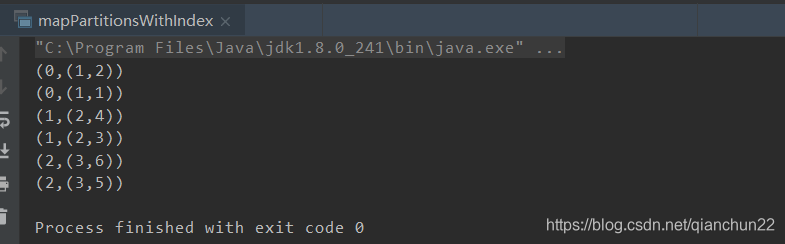
val rdd = sc.parallelize(List((1,1),(1,2),(2,3),(2,4),(3,5),(3,6)),3)
def mapPartIndexFunc(i1:Int,iter:Iterator[(Int,Int)]):Iterator[(Int,(Int,Int))]={
  var res = List[(Int,(Int,Int))]()
  while (iter.hasNext){
    var next = iter.next()
    res=res.::(i1,next)
  }
  res.iterator
}
val mapPartIndexRDD = rdd.mapPartitionsWithIndex(mapPartIndexFunc)
mapPartIndexRDD.foreach(println(_))
Java版本
//mapPartitionsWithIndex 统计键值对中的各个分区的元素
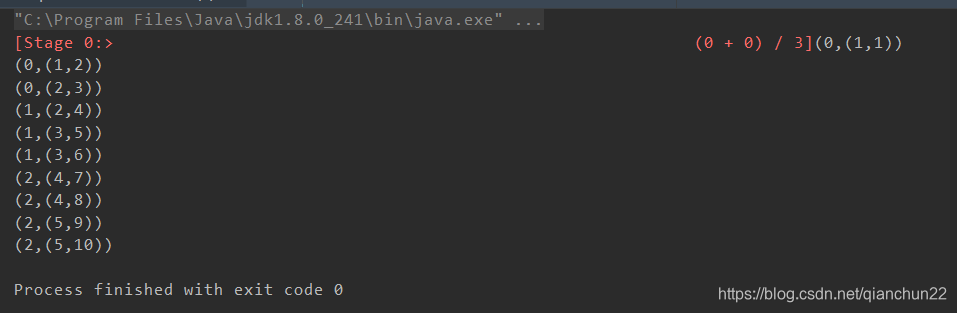
JavaRDD<Tuple2<Integer, Integer>> rdd1 = sc.parallelize(Arrays.asList(
        new Tuple2<>(1, 1), new Tuple2<>(1, 2),
        new Tuple2<>(2, 3), new Tuple2<>(2, 4),
        new Tuple2<>(3, 5), new Tuple2<>(3, 6),
        new Tuple2<>(4, 7), new Tuple2<>(4, 8),
        new Tuple2<>(5, 9), new Tuple2<>(5, 10)
), 3);

//将JavaRDD转换成JavaPairRDD
JavaPairRDD<Integer, Integer> PairRDD = JavaPairRDD.fromJavaRDD(rdd1);
JavaRDD<Tuple2<Integer, Tuple2<Integer, Integer>>> mapParIndexRDD =
        PairRDD.mapPartitionsWithIndex(new Function2<Integer, Iterator<Tuple2<Integer, Integer>>, Iterator<Tuple2<Integer, Tuple2<Integer, Integer>>>>() {
    @Override
    public Iterator<Tuple2<Integer, Tuple2<Integer, Integer>>> call(Integer partIndex, Iterator<Tuple2<Integer, Integer>> tuple2Iterator) throws Exception {
        ArrayList<Tuple2<Integer, Tuple2<Integer, Integer>>> tuple2s = new ArrayList<>();
        while (tuple2Iterator.hasNext()) {
            Tuple2<Integer, Integer> next = tuple2Iterator.next();
            tuple2s.add(new Tuple2<>(partIndex, next));
        }
        return tuple2s.iterator();
    }
}, false);

mapParIndexRDD.foreach(new VoidFunction<Tuple2<Integer, Tuple2<Integer, Integer>>>() {
    @Override
    public void call(Tuple2<Integer, Tuple2<Integer, Integer>> tup2) throws Exception {
        System.out.println(tup2);
    }
});
mapPartitionsWithIndex 中 第二个参数,true还是false
这篇文章有些探讨,http://stackoverflow.com/questions/38048904/how-to-use-function-mappartitionswithindex-in-spark/38049239
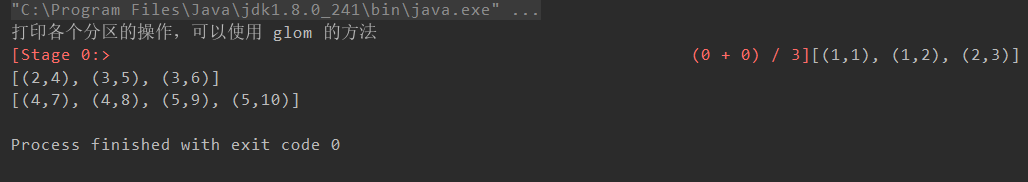
补充: 打印各个分区的操作,可以使用 glom 的方法
//补充: 打印各个分区的操作,可以使用 glom 的方法
JavaRDD<Tuple2<Integer, Integer>> rdd1 = sc.parallelize(Arrays.asList(
        new Tuple2<>(1, 1), new Tuple2<>(1, 2),
        new Tuple2<>(2, 3), new Tuple2<>(2, 4),
        new Tuple2<>(3, 5), new Tuple2<>(3, 6),
        new Tuple2<>(4, 7), new Tuple2<>(4, 8),
        new Tuple2<>(5, 9), new Tuple2<>(5, 10)
), 3);

JavaPairRDD<Integer, Integer> PairRDD = JavaPairRDD.fromJavaRDD(rdd1);
/*补充:打印各个分区的操作,可以使用 glom 的方法*/
System.out.println("打印各个分区的操作,可以使用 glom 的方法");
JavaRDD<List<Tuple2<Integer, Integer>>> glom = PairRDD.glom();
glom.foreach(new VoidFunction<List<Tuple2<Integer, Integer>>>() {
    @Override
    public void call(List<Tuple2<Integer, Integer>> tuple2s) throws Exception {
        System.out.println(tuple2s);
    }
});
更多推荐

 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)