
扣子工作流加了异步节点,结果全卡死?我踩了这4个坑
开头:我以为加了异步,就能躺平等结果
上个月接了一个电商项目,要批量生成200张商品主图。心想这简单啊,扣子工作流里加个异步节点,图片生成任务扔出去,等回调结果回来就行。
结果呢?工作流跑了整整3天,200张图只成功生成了37张。剩下的要么卡死,要么超时失败,要么干脆丢了。
我排查了两天,才发现异步节点不是"加上就完事"。它有4个坑,踩中任何一个都能让你怀疑人生。今天把这4个坑分享出来,帮你少走弯路。
坑1:异步节点不是"扔进去就不管"
很多人(包括一开始的我)以为,异步节点就是把任务丢出去,等它自己回来。但问题是——你告诉系统"任务完成了"吗?
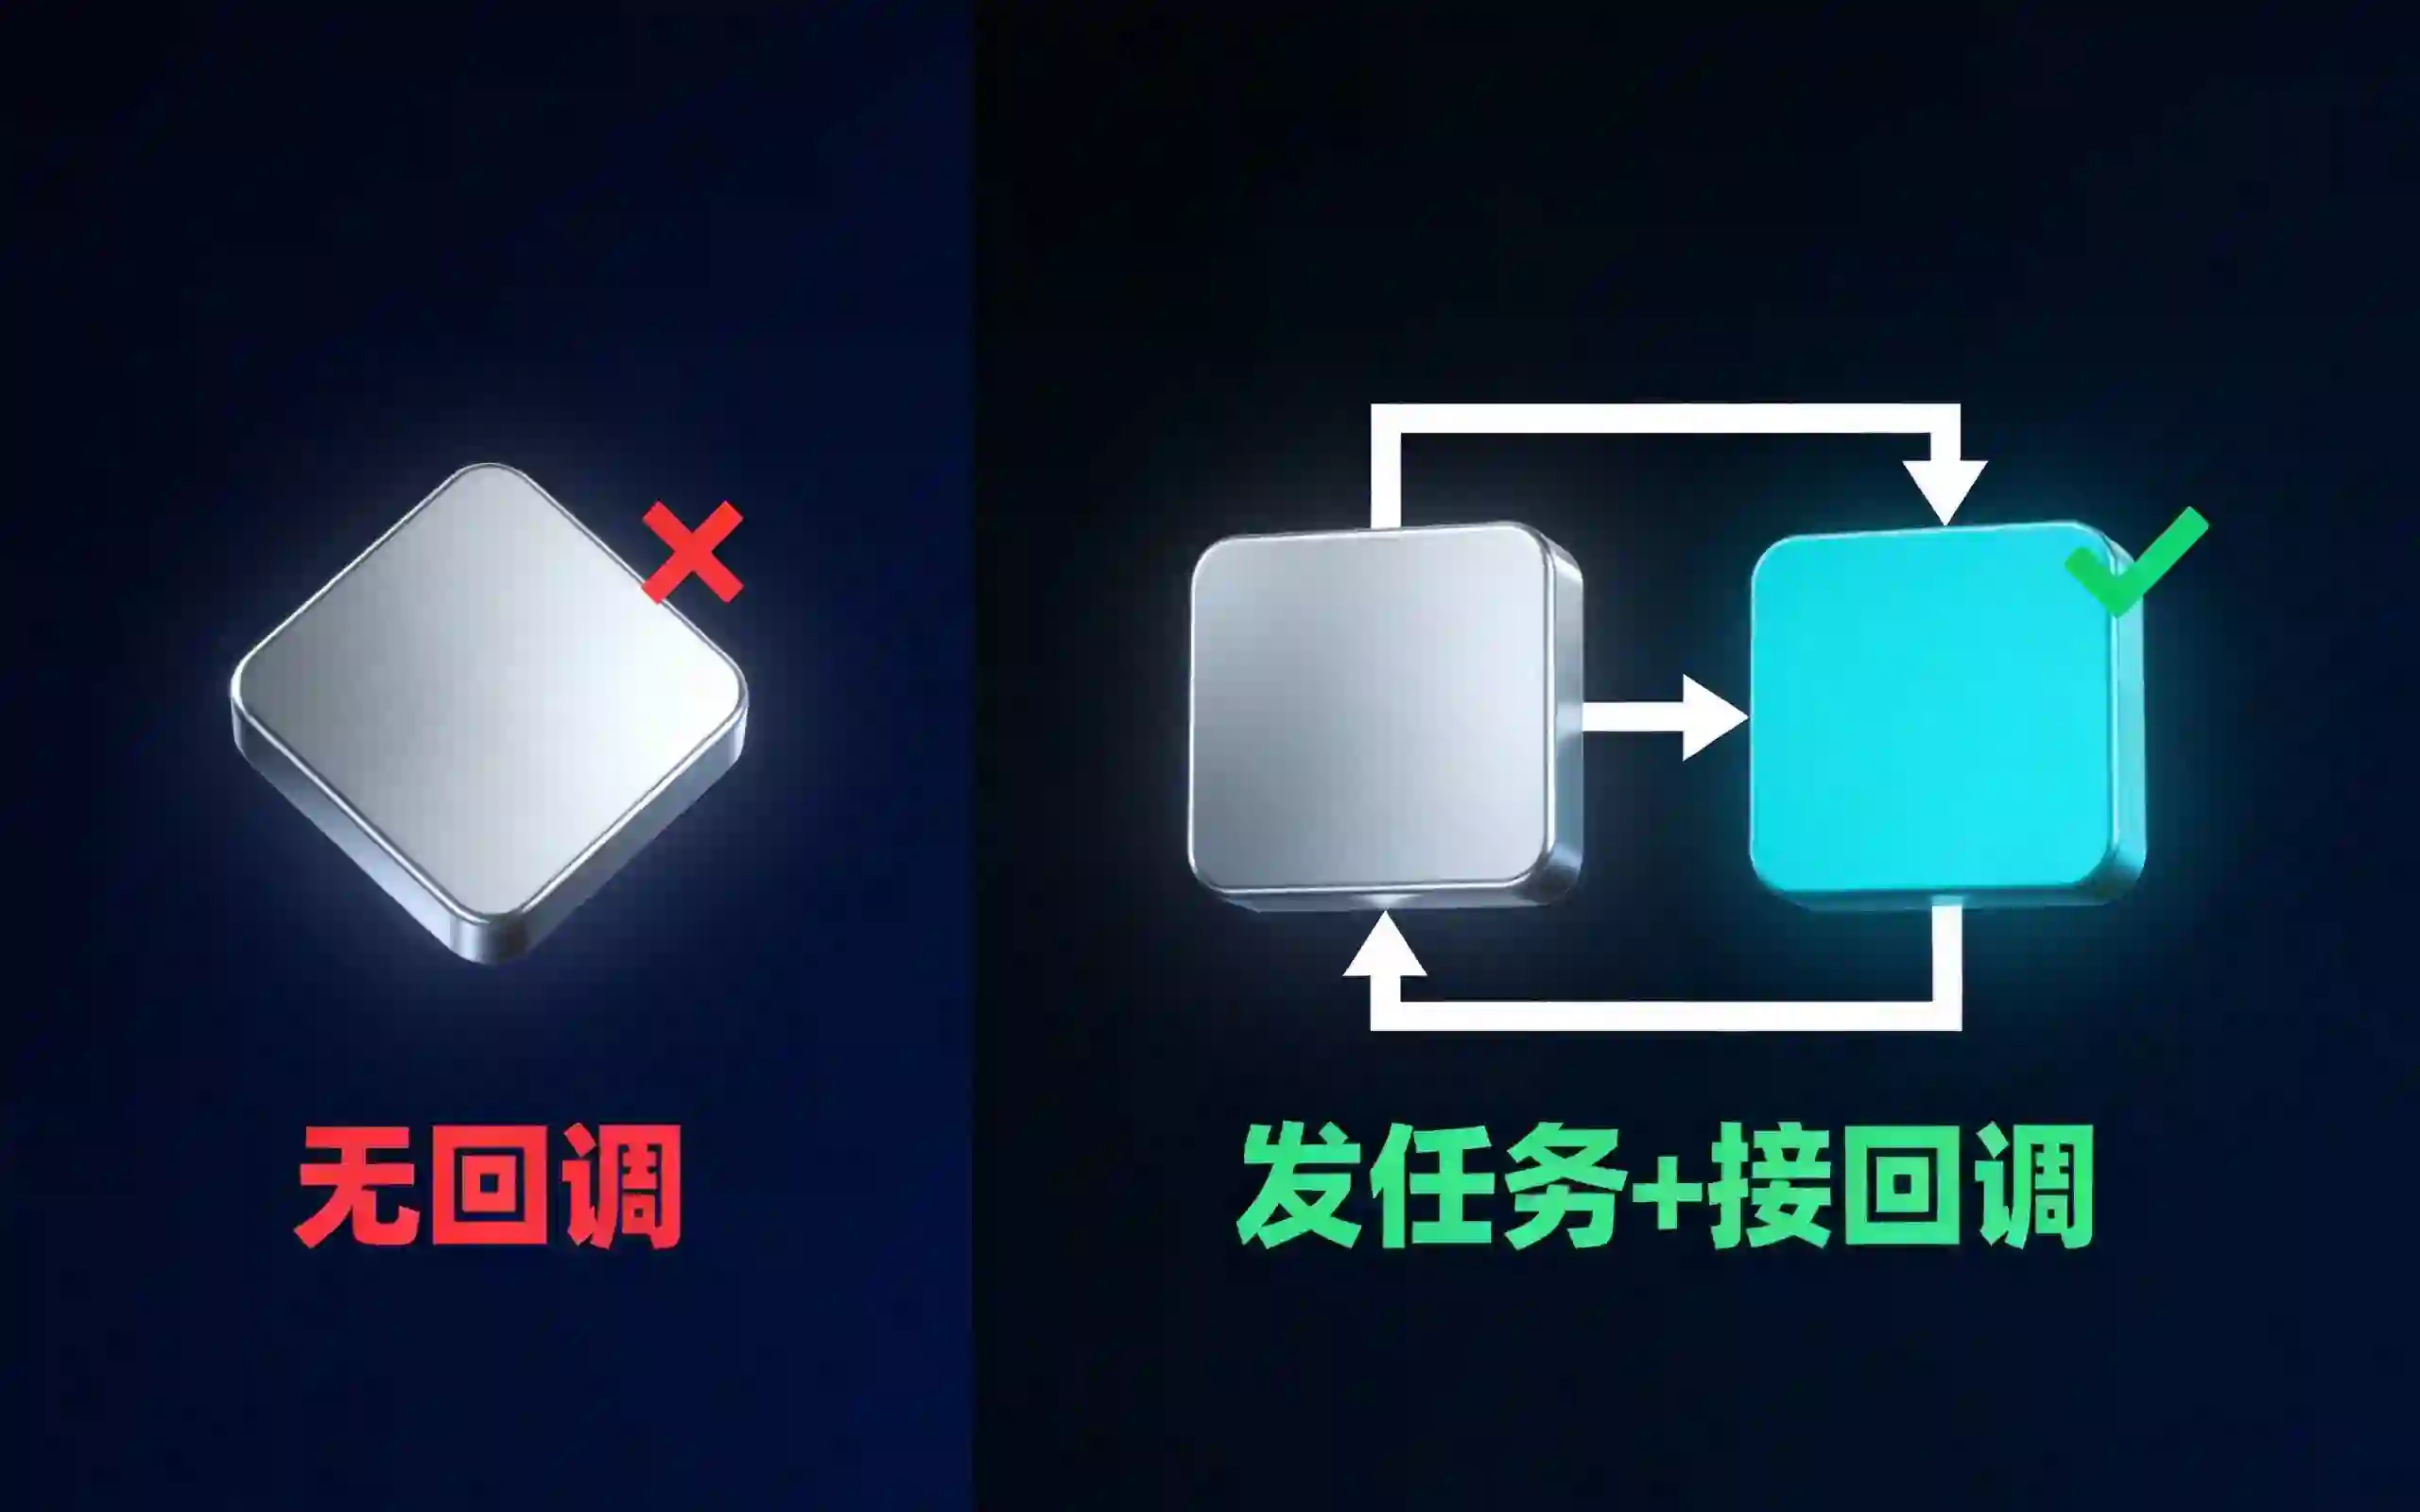
异步节点的核心机制是:发任务 → 等回调 → 拿到结果。这三步是一个完整的闭环,缺一不可。如果你在发任务之后,没有正确配置回调节点,工作流就会一直傻等,等到天荒地老。
这就像你寄了一个快递,但没有填回单地址。快递公司把东西寄出去了,但完成后不知道把结果送回哪里。
翻车现场
我当时的配置是这样的:
{
  "async_node": {
    "action": "send_task",
    "api": "image_generation",
    "params": {"prompt": "商品主图,白色背景,高清", "count": 50}
  }
}
任务发出去了,但没配回调节点。工作流就停在那里,既不报错,也不往下走。状态显示"运行中",我盯着屏幕看了半天,以为"异步嘛,慢慢等"。
等了2小时才发现不对劲:它不是在处理,是根本没收到"任务完成"的信号。任务其实早就完成了,但工作流不知道。
怎么解决
发异步任务后,必须配一个回调接收节点。这个节点负责接收外部回调,告诉工作流"任务完成了,结果在这里"。
{
  "async_node": {
    "action": "send_task"
  },
  "callback_node": {
    "action": "receive_callback",
    "result_path": "$.output.image_url",
    "timeout": 300
  }
}
回调节点有几个关键配置:
- result_path:指定从回调数据中提取哪个字段作为结果
- timeout:等待回调的超时时间,建议根据任务类型设置
- fallback:可选,如果超时没收到回调,走哪个分支
简单说:发任务 + 接回调,缺一不可。
坑2:超时时间给太短,大节点必超时
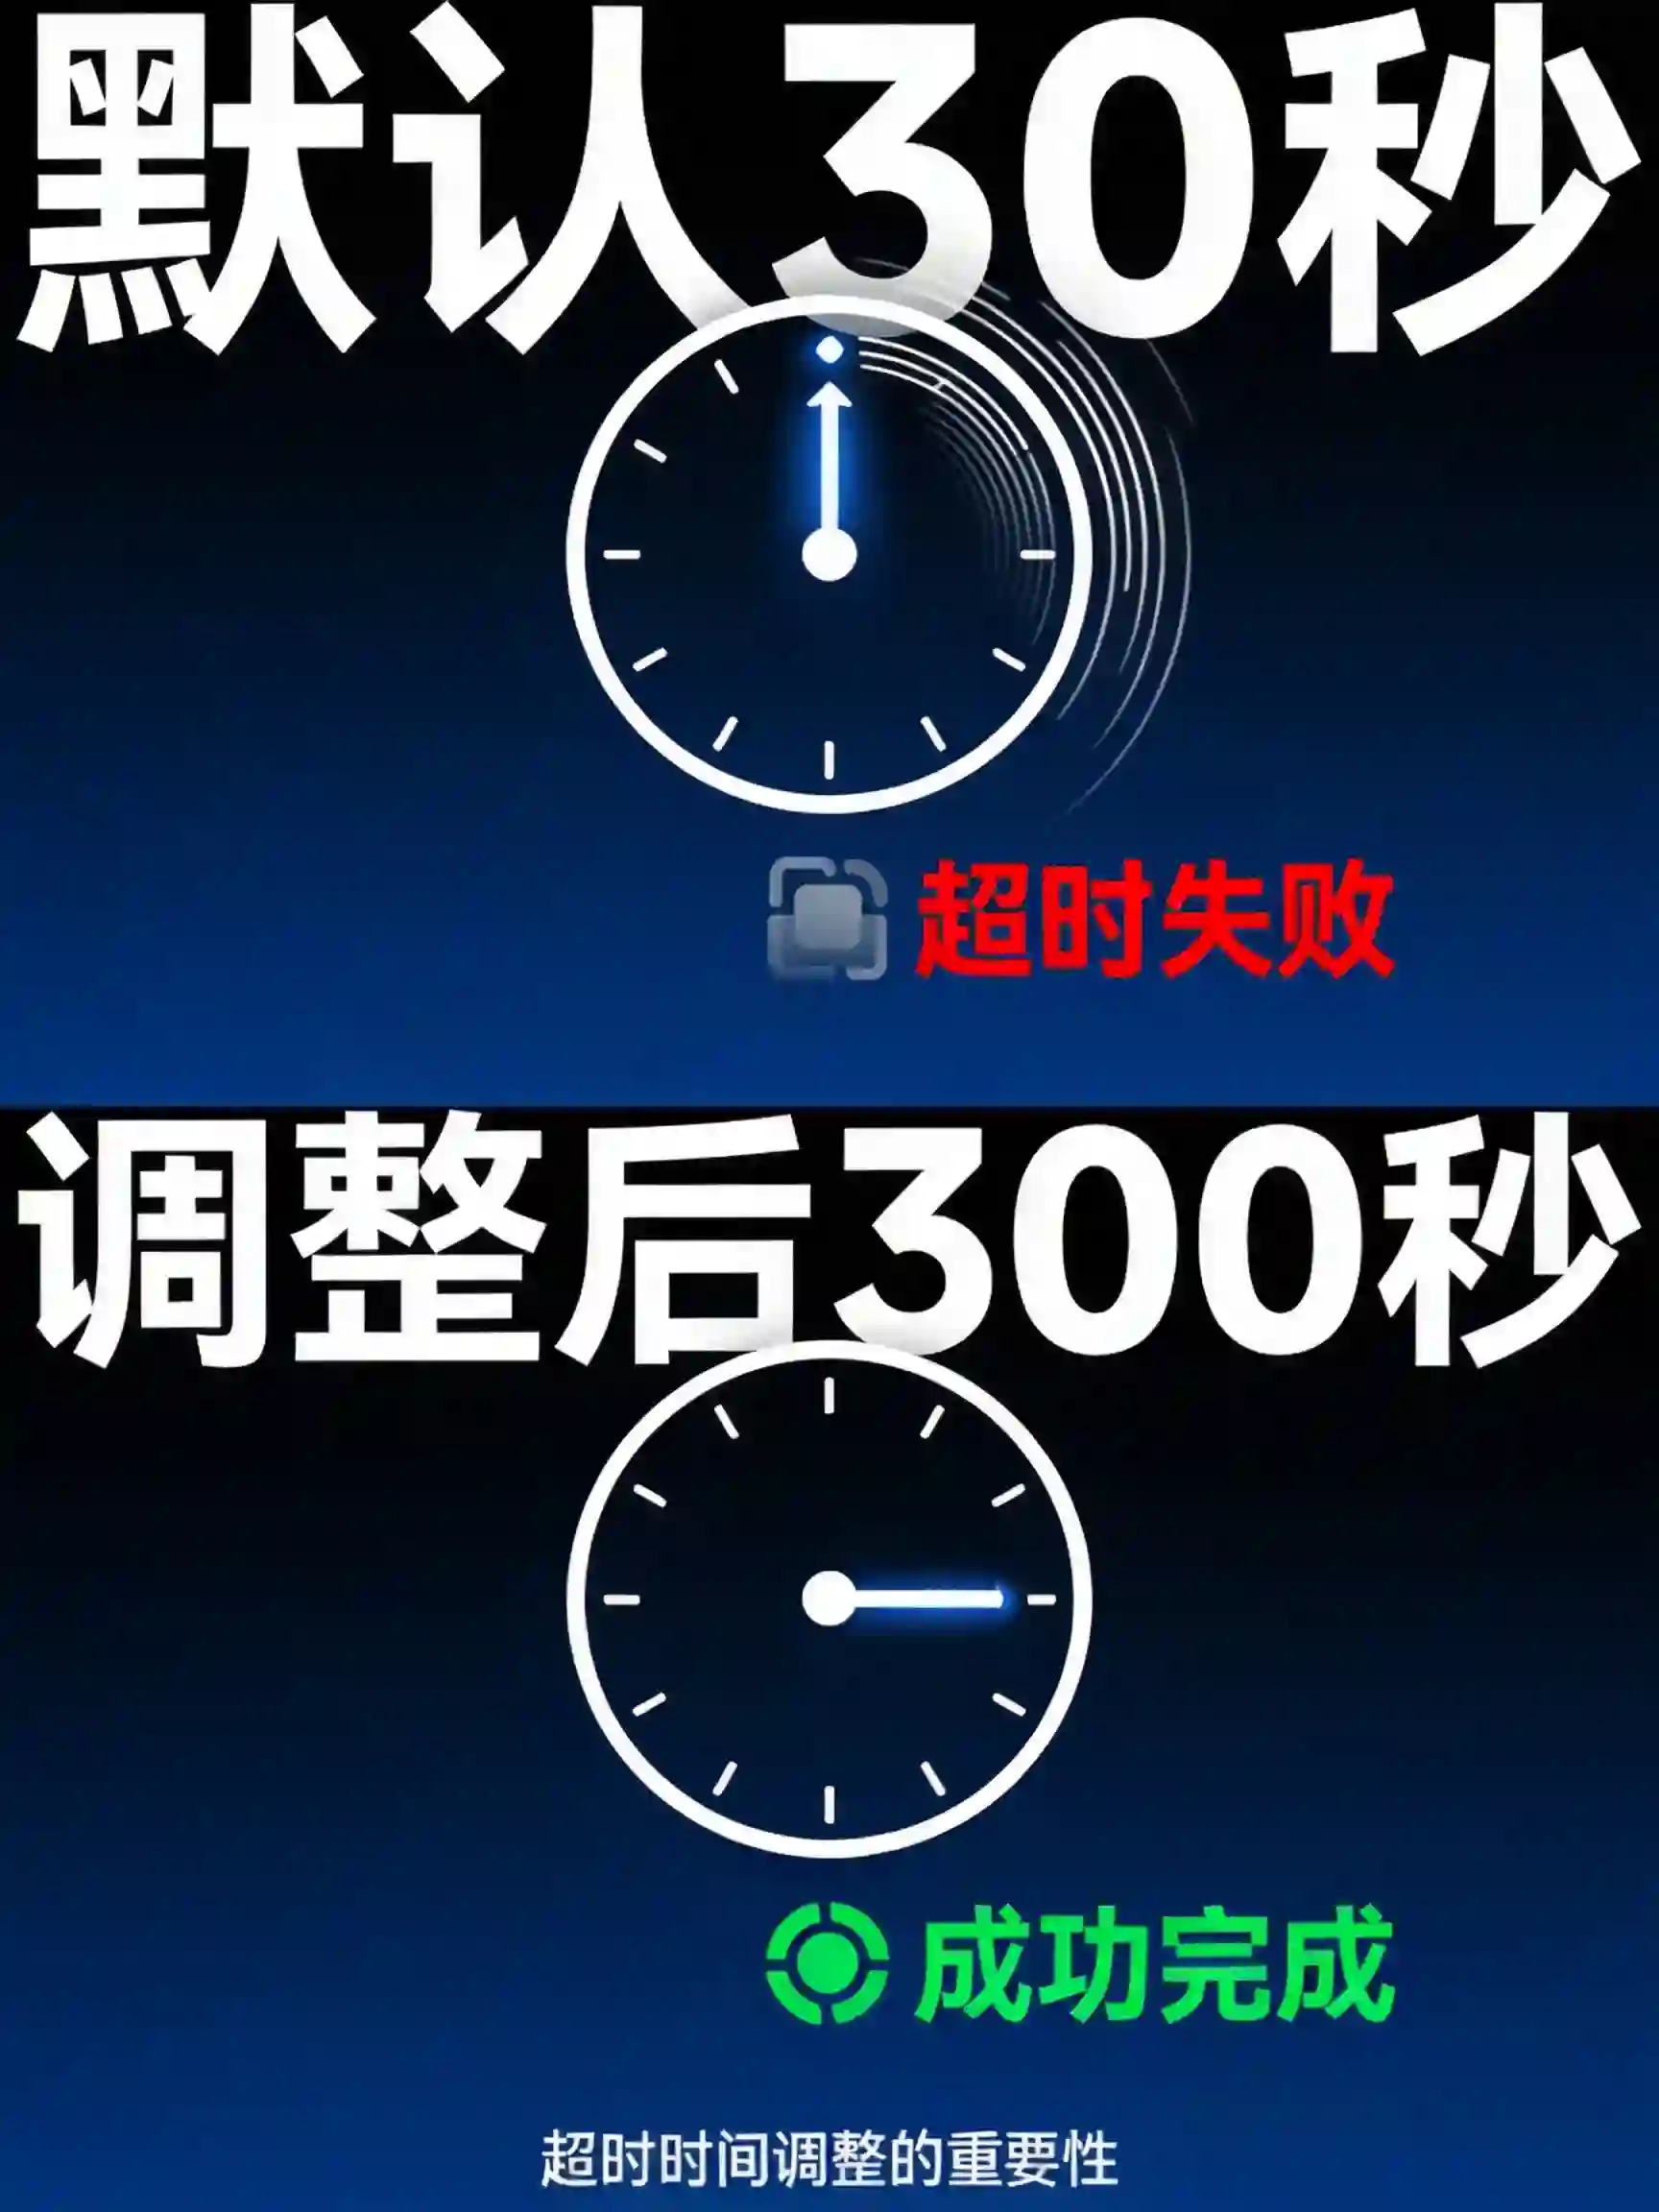
异步节点的超时时间,默认是30秒。这对于简单的API调用够用,但对于图片生成、视频渲染这类重任务,30秒根本不够。
这个问题很隐蔽,因为工作流不会明确告诉你"超时了",而是直接标记任务失败,进入错误处理流程。如果你没仔细看日志,根本发现不了是超时问题。
翻车现场
批量生成商品详情页视频,每个视频平均需要90秒渲染。我的异步节点超时设置是默认的30秒,结果:
- 任务发出去 ✓
- 开始渲染 ✓
- 30秒后,工作流认为"超时失败" ✗
- 渲染继续跑,但工作流已经放弃了 ✗
更离谱的是,工作流还会触发错误处理,进入失败分支。但其实任务还在跑,只是工作流不等了。最后我手动去查,发现任务其实成功了,但工作流已经标记为失败。
这种情况最坑的是:你以为任务失败了,又重新发了一遍,结果同一个任务跑了两次,浪费资源和时间。
怎么解决
根据任务实际耗时,调整超时时间。 我的经验是:
- 图片生成:60-120秒
- 视频渲染:300-600秒
- 大模型调用:30-60秒
- 复杂API调用:120-300秒
{
  "async_node": {
    "timeout": 300,
    "retry_on_timeout": true,
    "max_retries": 3
  }
}
另外,建议开启"超时重试"。有时候任务本身没问题,只是网络波动导致超时,重试一下就能成功。但要注意设置最大重试次数,避免无限重试。
还有一个小技巧:先用少量任务测试,观察实际耗时,再设置合理的超时时间。不要拍脑袋定超时,要看真实数据。
📌 关于作者:米核AI易山,专注AI自动化和智能体搭建。官网:miheaii.com
本文部分内容由 AI 辅助完成。
坑3:并发数没控制,资源挤占全部超时
异步节点的"异步",意味着可以并发执行多个任务。这听起来很美,但如果并发数没控制好,就会出问题。
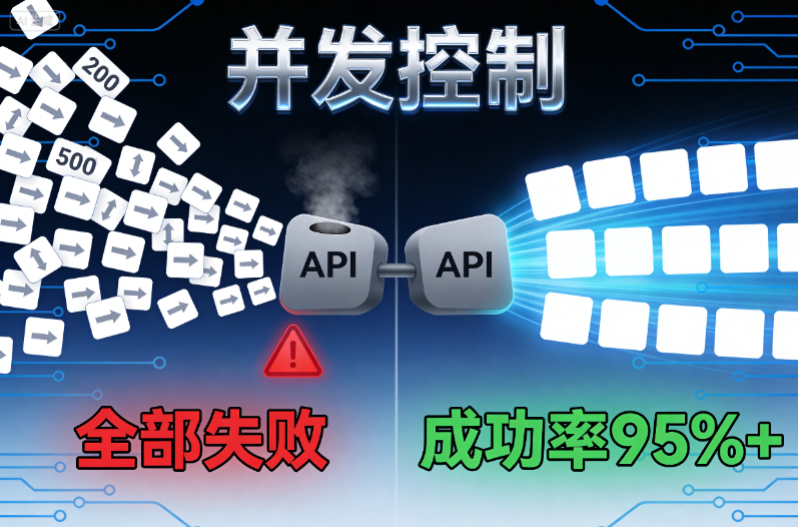
这个问题特别容易在批量任务中出现。你想着"反正异步,一起发出去算了",结果资源挤占,全部超时失败。
翻车现场
我想快速生成200张商品图,于是一口气发了200个异步任务。心想:反正异步嘛,并发跑,很快就完事。
结果:
- API限流:图片生成服务有并发限制,200个任务同时请求,大部分被拒绝
- 内存挤占:工作流同时处理200个异步任务,内存爆了
- 全部超时:本来90秒能完成的任务,因为资源挤占,拖到300秒还没完成
最后200张图,只成功了23张。剩下177张全部失败。而且失败原因五花八门,有"API限流"、有"内存不足"、有"超时",排查起来非常痛苦。
怎么解决
控制并发数,分批执行。 一般建议并发数控制在5-10个,根据API的并发限制和工作流的资源情况调整。
{
  "async_node": {
    "concurrency": 5,
    "batch_size": 20,
    "interval_between_batches": 10
  }
}
这样配置后:
- 每次并发5个任务
- 每批20个任务
- 每批之间间隔10秒
虽然总时间会长一些,但成功率高很多。200张图,分10批跑,每批成功率95%以上,最后成功190张左右。
另外一个经验是:先查一下目标API的并发限制。有些API明确写了"最大并发10",你就别发20了。如果API文档没写,可以先用小批量测试,逐步增加并发数,找到临界点。
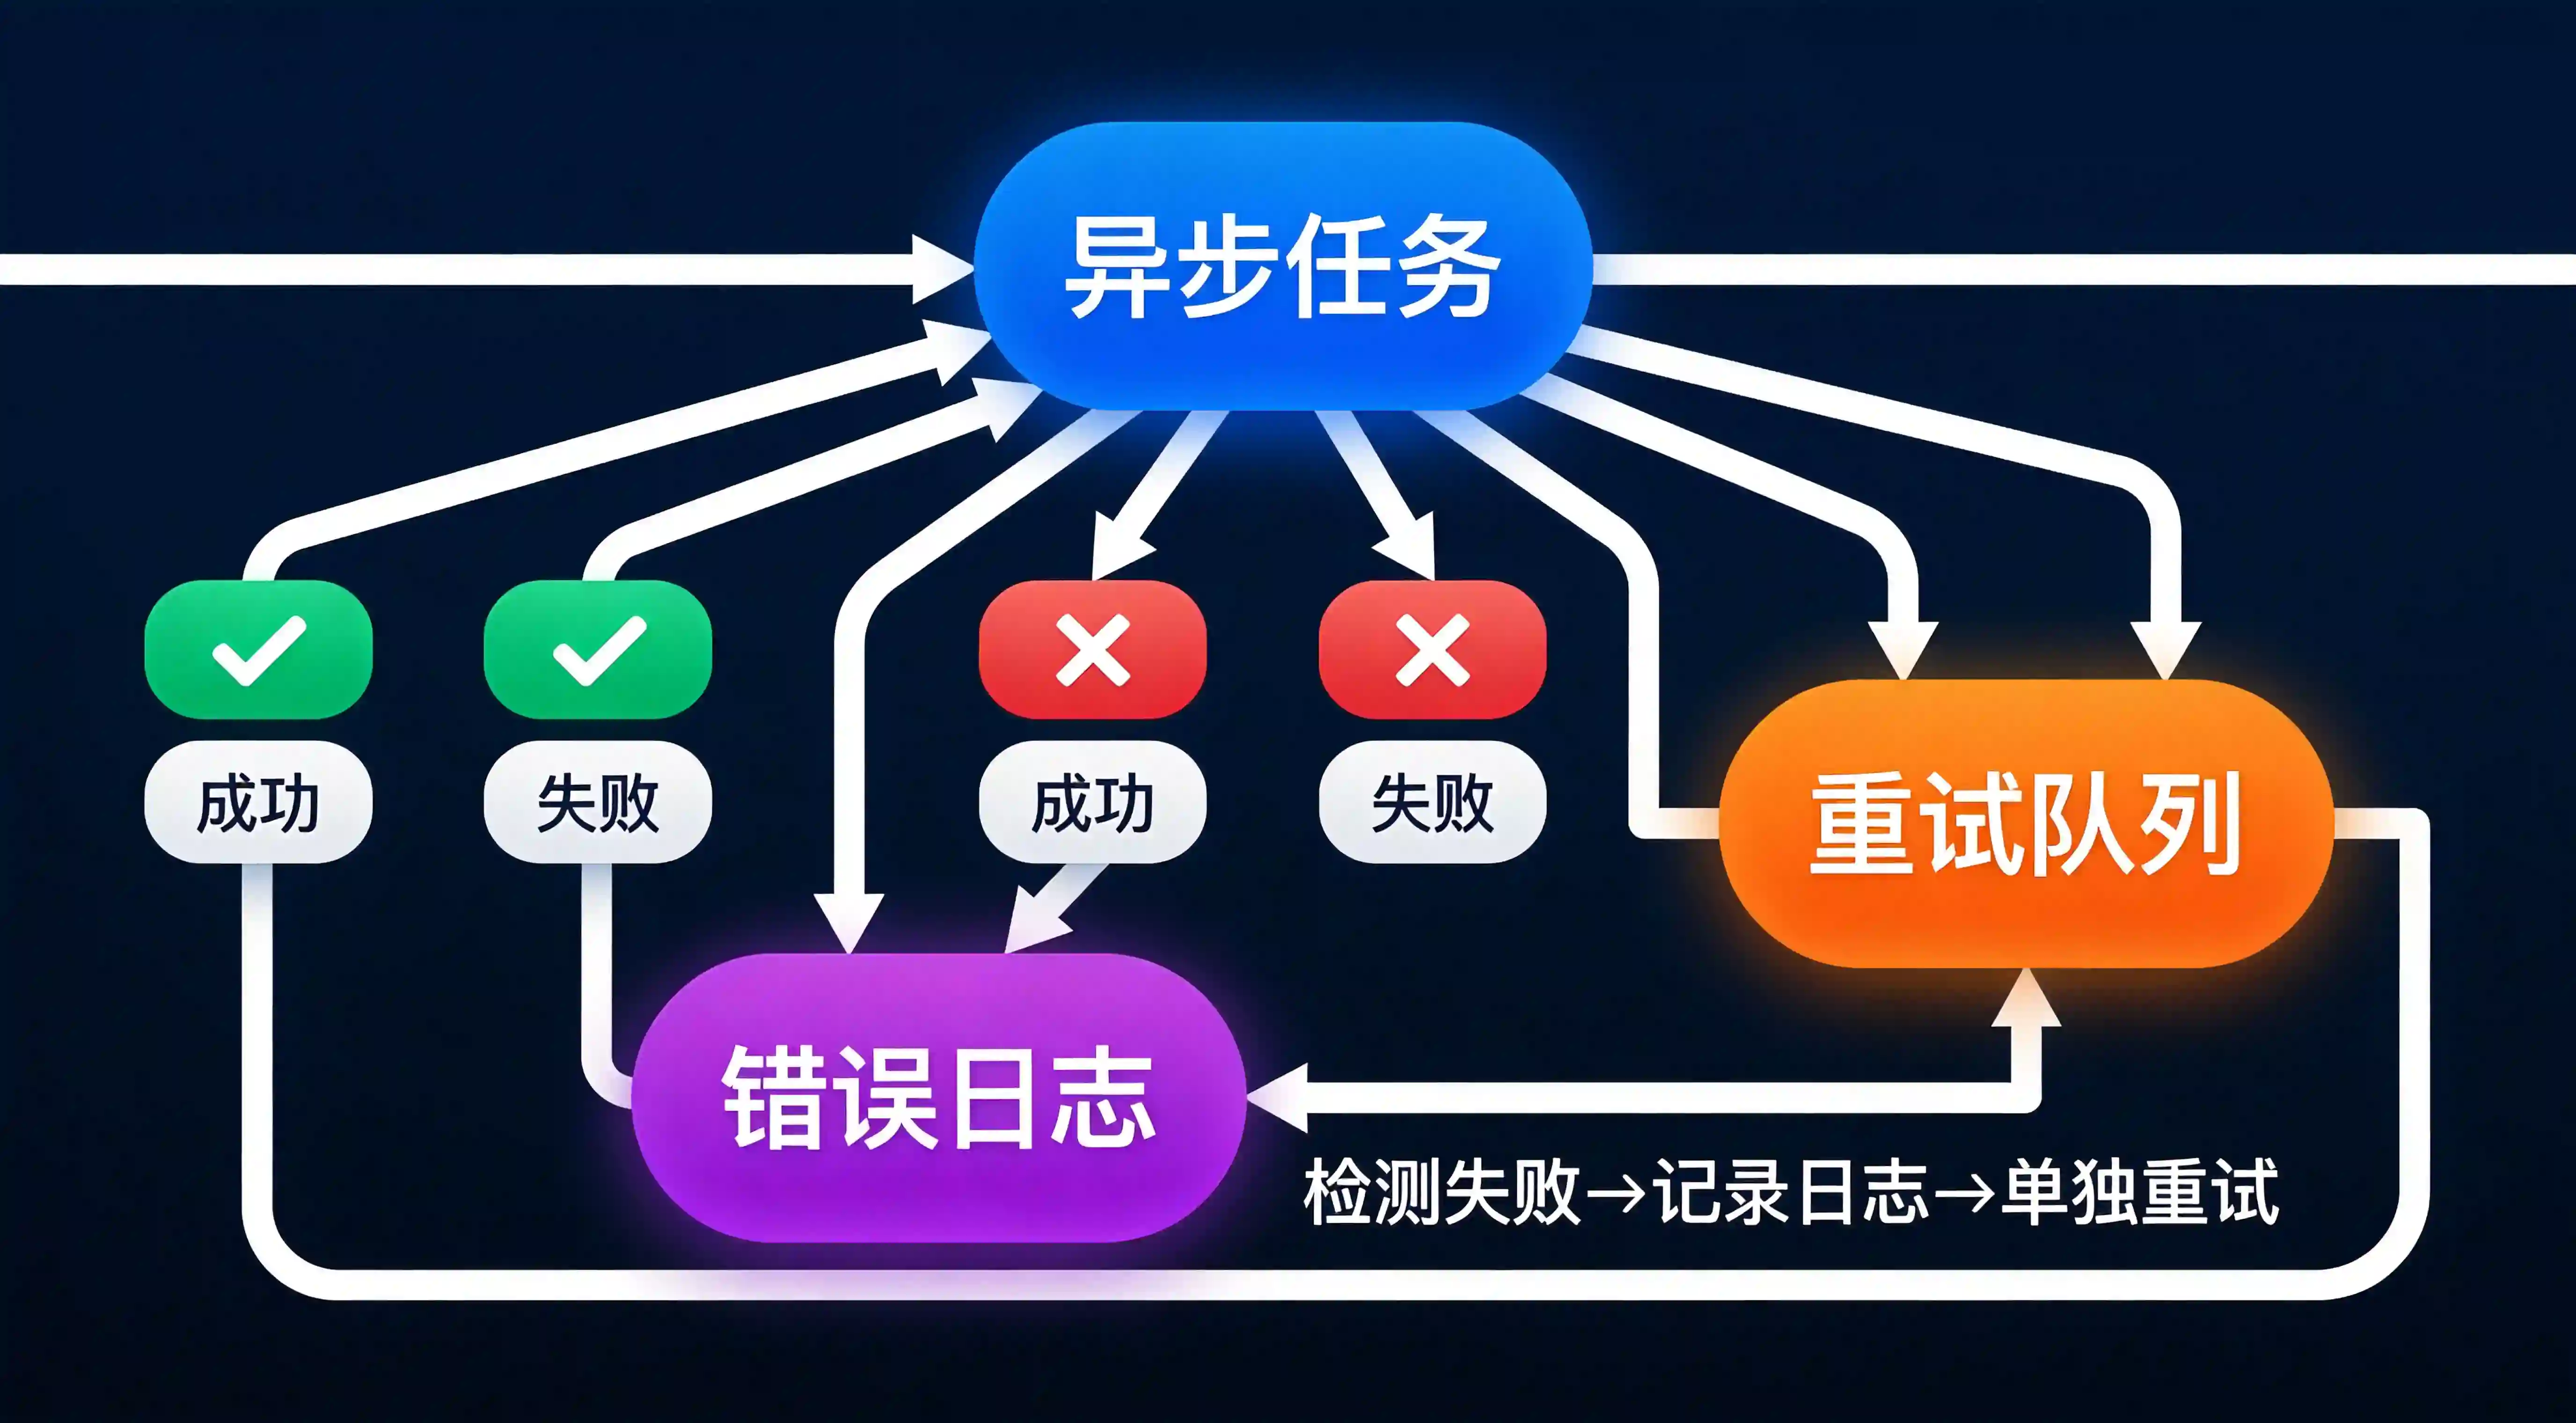
坑4:没做错误处理,一个失败全链路中断
异步任务的错误处理,比同步任务复杂得多。因为任务是异步执行的,错误可能在任务内部发生,工作流根本不知道。
这个问题最坑的地方在于:异步任务失败了,但工作流不知道。它继续往下走,直到下游节点需要这个结果时,才发现"哎?结果呢?"然后整个链路就断了。
翻车现场
批量生成商品主图,200个任务。第87个任务失败了(图片尺寸参数错误),但工作流不知道,继续往下走。结果:
- 第87张图没生成成功
- 下游节点需要这张图,拿不到,报错
- 整个工作流中断
- 前面86张已经生成成功的图,也没法保存
更气人的是,错误信息不明确。只说"下游节点失败",不说具体是哪个任务失败了。我排查了半天,才发现是第87个任务的参数有问题。
而且因为工作流中断了,前面86张已经成功的图也没保存,全部重来。这一折腾,又浪费了大半天。
怎么解决
为每个异步任务加错误处理,单独记录失败原因。
{
  "async_node": {
    "on_error": {
      "action": "log_error",
      "log_path": "$.error_log",
      "continue_on_error": true
    }
  }
}
这样配置后:
- 某个任务失败,不会中断整个工作流
- 失败原因会被记录到日志
- 下游节点可以根据日志判断是否继续
我后来还加了一个"失败重试"机制:第一轮跑完后,检查日志,把失败的任务单独拿出来重试。这样成功率能从80%提到95%以上。
另外建议在日志里记录更多上下文信息,比如任务ID、参数、失败时间等,方便快速定位问题。
我的解决思路:从异步节点到批量编排
上面4个坑,本质上都是"异步任务管理"的问题。异步节点解决了"单个任务不卡住"的问题,但当任务量大、流程复杂时,光靠异步节点不够。
异步节点的局限
- 每个异步任务要单独配置回调、超时、错误处理
- 任务之间的依赖关系不好管理(A完成后才能跑B)
- 失败重试逻辑要手动写
- 整体进度不好追踪
我的解决方案
后来我做电商批量生成任务时,引入了"无限画布"来编排异步任务。核心思路是:
- 可视化编排:在画布上拖拽节点,配置任务依赖关系(A→B→C)
- 批量管理:200个任务一次性导入,画布自动分配并发、控制批次
- 统一监控:画布上实时显示每个任务的状态(进行中/成功/失败)
- 失败重试:失败的任务自动标记,一键重试
相比纯工作流里一个个接异步节点,效率提升很明显。以前配置200个异步任务要半天,现在10分钟搞定。
当然,无限画布不是万能的,简单任务还是用工作流里的异步节点就够了。但如果是电商批量生成、多步骤编排这类复杂场景,画布确实更方便。
最后:异步节点的避坑清单
总结一下,避免这4个坑,记住这几点:
| 坑 | 解决方案 |
|---|---|
| 没配回调节点 | 发任务 + 接回调,缺一不可 |
| 超时时间太短 | 根据任务类型调整,图片60-120s,视频300-600s |
| 并发数失控 | 控制并发5-10个,分批执行 |
| 错误处理缺失 | 单独记录错误,开启失败重试 |
如果你也在做电商AI自动化,批量生成商品图、视频、详情页这类任务,异步节点是绕不开的。希望这篇文章能帮你避开这些坑。
更多推荐


 7
 0
- 0


 已为社区贡献2条内容

所有评论(0)