
大厂面试官揭秘:RAG简历怎么写才不会被秒拒?这几点写出含金量,面试官都想深聊!
前段时间跟一个在大厂做技术面试官的朋友吃饭,聊到最近面试的感受,他说了一句让我印象很深的话:
“现在十个候选人里有八个简历上写了 RAG 项目,但大部分一看就是包装的——写了一句’负责 RAG 知识问答系统的开发与维护’,然后就没了。我问他检索用的什么方案,他说向量检索;我问用的什么 Embedding 模型,他说 BGE;我问效果怎么评估的,他说……还不错。”
他说到这儿笑了一下:“这种简历我基本 30 秒就翻过去了。不是说他一定没做过,而是他写的东西完全看不出深度。”
我追问他:“那什么样的 RAG 简历你会多看两眼?”
他说:“我想看到你做了什么具体决策。用了混合检索——为什么不只用向量检索?做了 Embedding 微调——训练数据哪来的、用了什么损失函数?加了 Rerank——对前多少条做精排、效果提升了多少?有这些东西,我才觉得这个人真干过,面试值得深聊。”
今天专门讲这个怎么把这些技术落到简历上,让面试官一眼觉得"这个人值得聊"。
一、先说一个最常见的错误写法
很多人简历上这样写:
★
负责公司 RAG 知识问答系统的开发与维护。
这句话等于什么都没说。面试官看到这一行,脑子里的反应是:“所以你到底做了什么?解析?检索?生成?全做了还是打酱油?”
简历的核心原则是让面试官一眼看出你做了什么、用了什么技术、达到了什么效果。RAG 系统那么多模块,你不可能每个都写,要挑你最深入的 2-3 个模块,每个用一条 bullet point 写清楚。
下面我按模块给出写法示例和面试追问应对。
二、离线解析模块怎么写?
简历写法(一条 bullet point)
★
文件解析: 设计并实现多格式文档解析 pipeline,结合 OCR 与深度学习模型识别表格、图片并保留层级布局信息,对文本进行规则+语义分块,为 RAG 检索提供高保真语料。
这一条信息量已经很大了:多格式(说明你处理过复杂场景)、OCR + 深度学习(说明你不是只用 PyPDF 提取文本)、层级布局(说明你理解文档结构的重要性)、规则+语义分块(说明你的分块策略不是无脑固定长度)。
面试官会怎么追问?
“你处理过哪些格式?最难的是什么?”
答:PDF(多栏排版、扫描版)、PPT、Word、纯文本。最难的是 PDF 多栏排版,传统按行解析会把左右栏内容错误拼接,导致语义混乱。我们引入了版面分析技术,先识别物理布局再按逻辑顺序提取。
“分块策略具体怎么做的?”
答:三层策略。第一层基于文档结构(章节标题、段落边界)做规则切分,表格和代码块整段保留不截断;第二层检查相邻 chunk 的语义连贯性,过短的合并、跨页的拼接;第三层控制长度平衡,配合 chunk overlap 保持连续性。
“chunk 大小怎么定的?”
答:不是拍脑袋定的,要配合 LLM 上下文窗口。块太大 LLM 放不下几个片段,块太小语义残缺。我们通过实验在 300-500 token 之间找到了平衡点,同时设了 50 token 的 overlap。
三、在线召回模块怎么写?
简历写法(可以拆成 2-3 条)
★
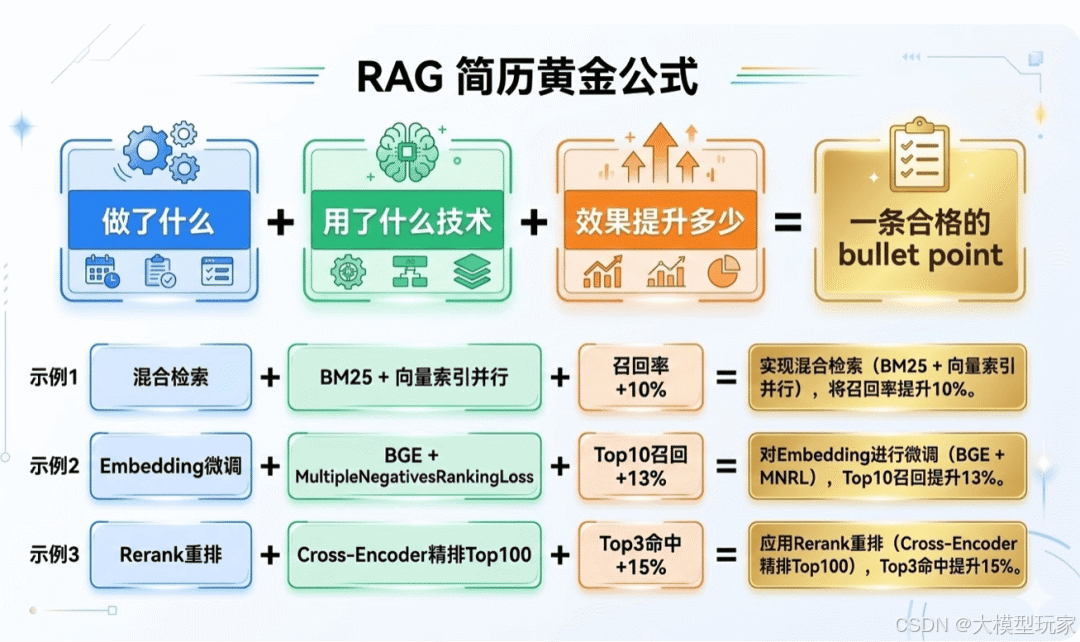
混合检索: 针对金融保险领域 2 万条文本片段,同时构建 BM25 关键词索引与向量索引进行并行检索,融合后系统整体召回率提升约 10%,短查询命中率显著提高。
★
Embedding 模型微调: 基于约 1000 条领域问答对,对 BGE 预训练模型进行有监督微调(MultipleNegativesRankingLoss),专业术语相关查询的 Top10 召回率提高约 13%。
★
Rerank 重排: 对初步检索的前 100 条候选结果,使用 Cross-Encoder 模型精排,关键信息 Top3 命中率较未重排前提升约 15%。
注意每一条都有具体数字——2 万条、1000 条、提升 10%/13%/15%。面试官就爱看这些。数字不需要精确到小数点,但一定要有。
面试官会怎么追问?
“BM25 和向量检索的结果怎么融合的?”
答:我们用的 RRF(Reciprocal Rank Fusion),不看分数只看排名,公式是 1/(k+rank),k 取 60。相比加权求和,RRF 不需要处理量纲不统一的问题,调参成本也更低。(如果面试官继续追问 RRF 和加权的区别,参考这个系列第五篇文章的内容。)
“Embedding 微调的训练数据怎么来的?”
答:两个渠道。一是从已有的客服 QA 对中提取问题和对应的正确答案段落;二是让业务同事给关键文档段落各写 3-5 个可能的用户提问。总共准备了大约 1000 条,覆盖了主要的专业术语和不同表述方式。
“为什么用 MultipleNegativesRankingLoss 而不是 Triplet Loss?”
答:因为我们只有正例对,没有手动构造负例。MultipleNegativesRankingLoss 会在 batch 内自动把其他样本当负例,省去了负例构造的工作量。batch/_size 设 16,训练 2-3 轮就够了,关键是避免过拟合。
“Rerank 用的什么模型?为什么只排前 100 条?”
答:用的 BGE-reranker-base。Cross-Encoder 的计算成本高,每条候选都要做一次 Transformer 前向推理,100 条已经是效率和效果的平衡点了。再多延迟就不可接受了。另外我们做了分页优化——只对前 3 页做精排,第 4 页之后跳过 Rerank,直接用初始排序。
四、数字从哪来?——一个大家不好意思问的问题
写到这里,估计很多人心里在想://“我的项目没有严格做过 A/B 测试,这些 10%、13%、15% 的数字从哪来?”//
说实话,大多数项目确实没有严格的对照实验。但简历上的数字不是论文数据,不需要精确到小数点后两位。你需要的是一个合理的量级估计。
怎么估?
方法一:做一个小规模对比测试。 准备 50 条测试查询,跑一遍优化前的系统和优化后的系统,手动看看 Top 3 的结果哪个更准。数 50 条里有多少条"变好了",除以 50,就是一个大致的提升比例。这不需要多复杂的评估框架,一下午就能搞定。
方法二:基于指标推算。 如果你做了前面文章里讲的 MRR、NDCG、P@K 评估,直接用指标的变化量就行。MRR 从 0.58 提到 0.82,提升 41%——这就是可以写在简历上的数字。
方法三:业务侧反馈。 比如上线后客服人工介入率降了多少、用户满意度评分涨了多少。如果有,这比技术指标更有说服力。
核心原则是:数字要有,但不要虚得离谱。 写"提升约 10%"比写"提升 200%“可信得多。面试官都是老手,一看数字不合理就会追问"这个数字怎么得到的”,到时候圆不回来就尴尬了。
五、写简历时的几个实用建议
关键词要命中。 简历筛选越来越多靠机器过滤,确保你的简历里出现这些高频词:RAG、向量检索、Embedding、BM25、Rerank、Cross-Encoder、Milvus/FAISS、OCR、语义分块、混合检索。不是堆砌,而是自然地嵌入在你的描述中。
挑你最深的 2-3 个点写,不要贪多。 宁可把混合检索和 Rerank 写得很深(含技术细节和数据),也不要把离线解析、在线召回、Prompt 构建、多轮对话全列上去但每个都只有一句话。简历不是 feature list,而是展示你的深度。
为面试官"留钩子"。 好的简历描述会让面试官忍不住追问。比如你写了"规则+语义分块",面试官一定会问"具体怎么做的";你写了"召回率提升 10%“,他一定会问"怎么评估的”。这些追问的答案你提前准备好,面试就变成了你引导面试官往你擅长的方向走。
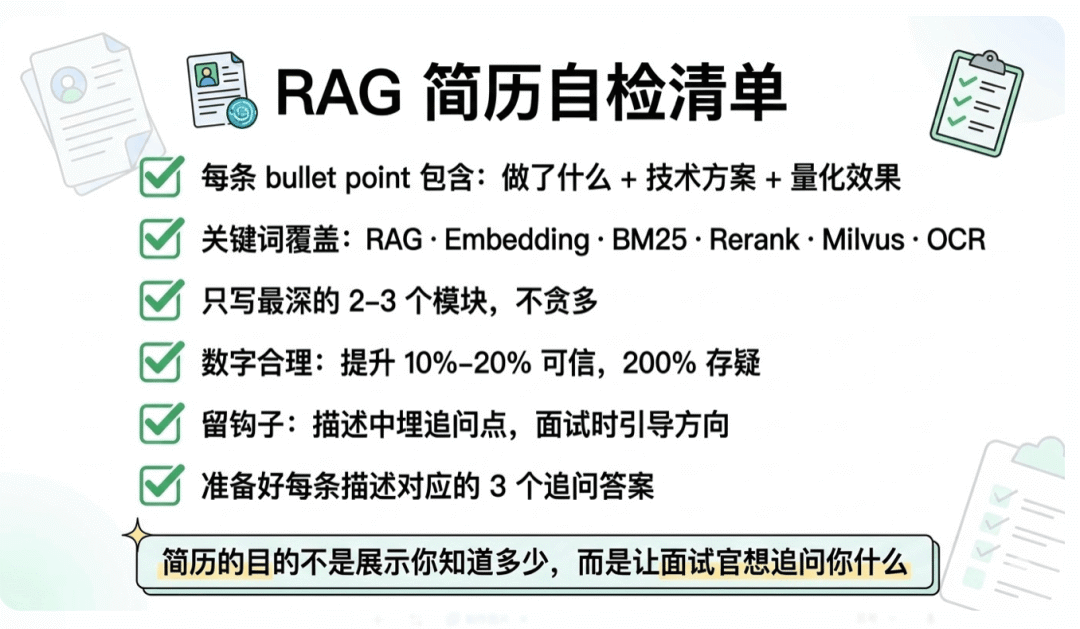
六、一个完整的 RAG 项目简历示例
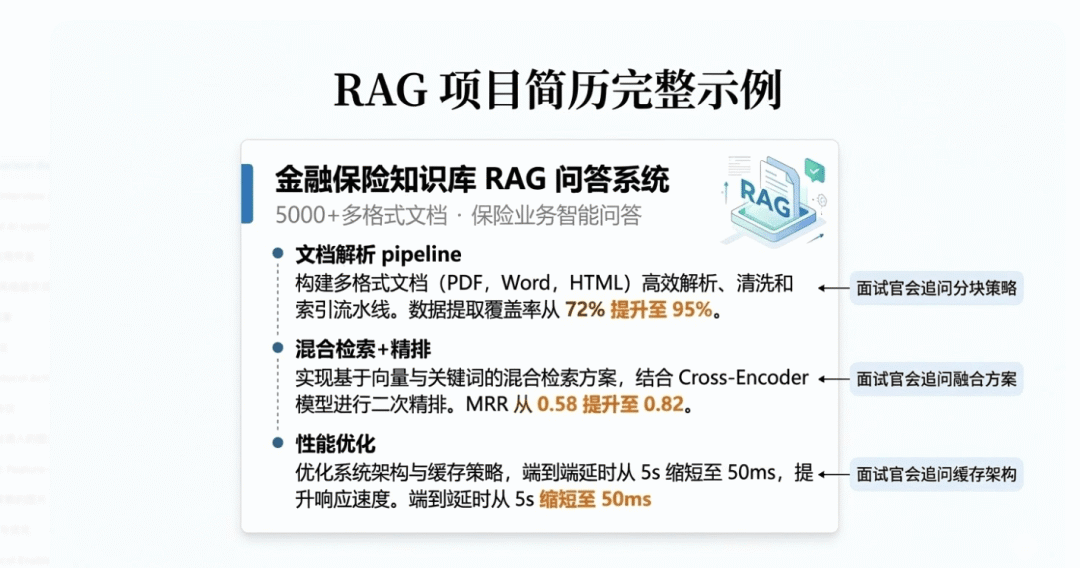
最后给一个完整示例,把前面讲的串起来:
项目名称: 金融保险知识库 RAG 问答系统
项目背景: 面向保险业务的智能问答系统,知识库包含 5000+ 份多格式文档(PDF/PPT/扫描件),服务内部员工的制度查询、产品咨询和理赔流程等场景。
我的职责:
- 文档解析 pipeline: 设计多格式文档解析流程,结合版面分析与 OCR 处理多栏 PDF 和扫描件,采用规则+语义三层分块策略并保留层级元数据,解析覆盖率从 72% 提升至 95%。
- 混合检索+精排: 构建 BM25 + 向量索引并行检索架构,使用 RRF 融合策略;对 BGE 模型进行领域微调(1000 条问答对 + MultipleNegativesRankingLoss),并引入 Cross-Encoder 重排 Top 100 候选,MRR 从 0.58 提升至 0.82,Precision@3 从 0.47 提升至 0.71。
- 性能优化: 设计三级缓存架构(Embedding/检索结果/答案缓存),配合全链路异步和 HNSW 索引调优,热门查询首字响应时间从 5s 降至 50ms 以内。
三条 bullet point,分别覆盖离线解析、在线召回、性能优化三个模块。每条都有技术方案和量化结果。面试官看到任何一条都可以展开追问 10-15 分钟,而你已经把答案准备好了。
写在最后
技术文章看了再多,最终要落到简历上才有用。
这篇文章的核心其实就一句话:简历不是技术文档,而是面试的路线图。 你写什么,面试官就问什么。所以不是把所有技术点都堆上去,而是挑你最能聊深的几个点,写得让面试官"忍不住追问",然后把追问的答案全部提前准备好。
普通人如何抓住AI大模型的风口?
领取方式在文末
为什么要学习大模型?
目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
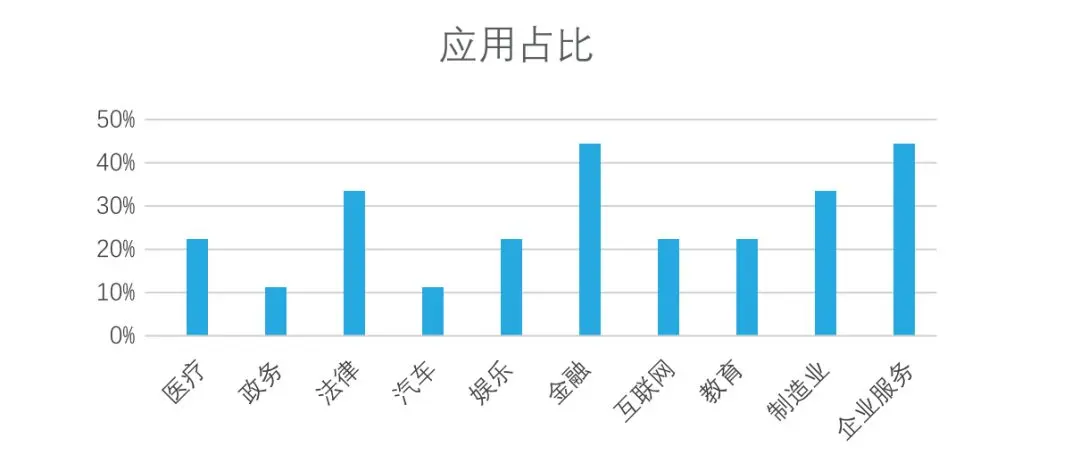
目前,开源人工智能大模型已应用于医疗、政务、法律、汽车、娱乐、金融、互联网、教育、制造业、企业服务等多个场景,其中,应用于金融、企业服务、制造业和法律领域的大模型在本次调研中占比超过 30%。
随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:
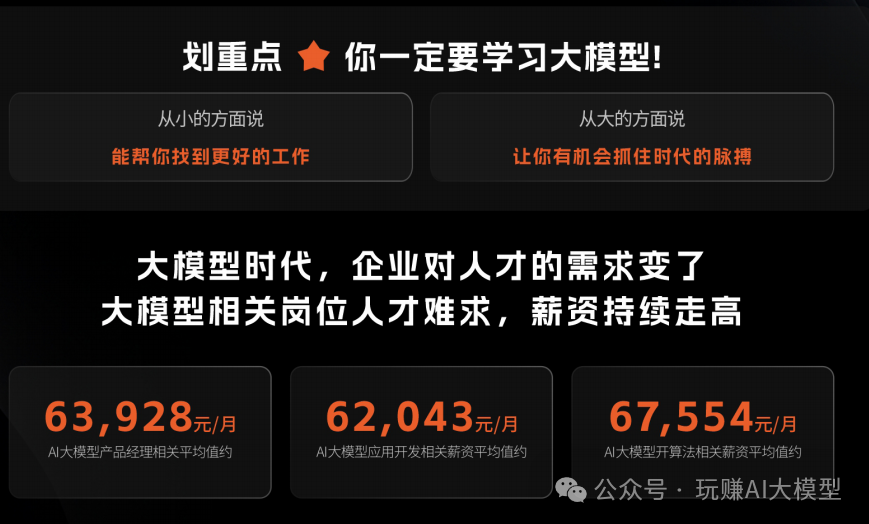
人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!
最后
只要你真心想学习AI大模型技术,这份精心整理的学习资料我愿意无偿分享给你,但是想学技术去乱搞的人别来找我!
在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
【附赠一节免费的直播讲座,技术大佬带你学习大模型的相关知识、学习思路、就业前景以及怎么结合当前的工作发展方向等,欢迎大家~】
大模型全套学习资料展示
自我们与MoPaaS魔泊云合作以来,我们不断打磨课程体系与技术内容,在细节上精益求精,同时在技术层面也新增了许多前沿且实用的内容,力求为大家带来更系统、更实战、更落地的大模型学习体验。
希望这份系统、实用的大模型学习路径,能够帮助你从零入门,进阶到实战,真正掌握AI时代的核心技能!
01 教学内容
-
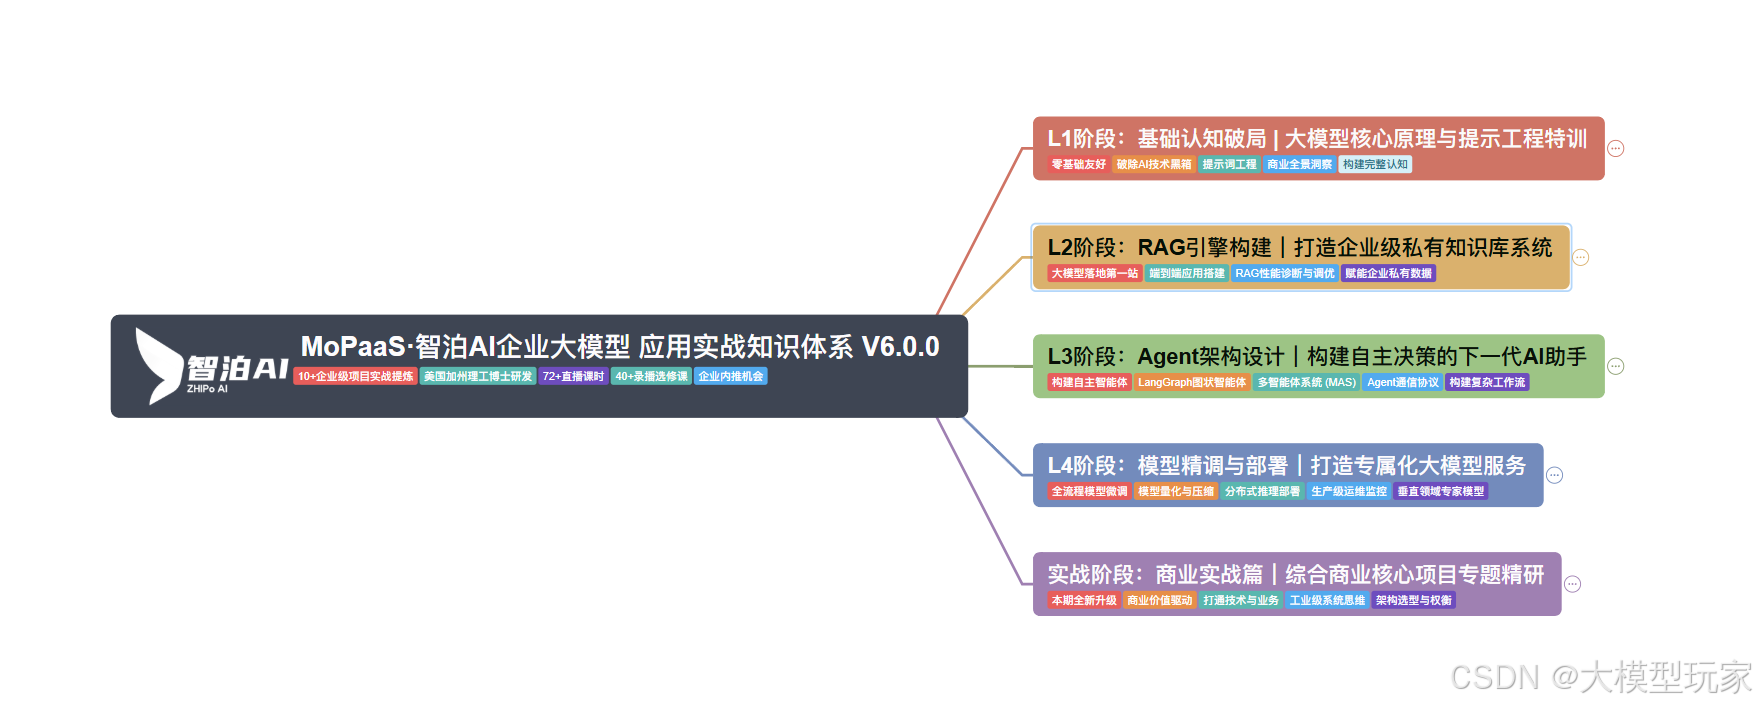
从零到精通完整闭环:【基础理论 →RAG开发 → Agent设计 → 模型微调与私有化部署调→热门技术】5大模块,内容比传统教材更贴近企业实战!
-
大量真实项目案例: 带你亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事!
02适学人群
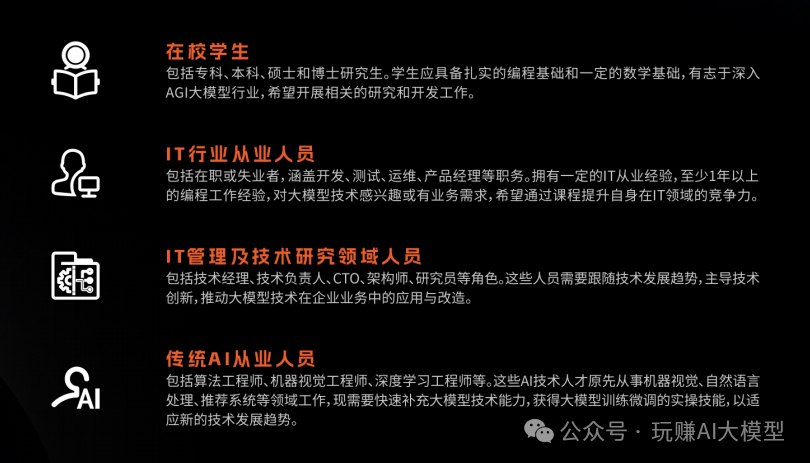
应届毕业生: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。
零基础转型: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界。
业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型。
vx扫描下方二维码即可
【附赠一节免费的直播讲座,技术大佬带你学习大模型的相关知识、学习思路、就业前景以及怎么结合当前的工作发展方向等,欢迎大家~】
本教程比较珍贵,仅限大家自行学习,不要传播!更严禁商用!
03 入门到进阶学习路线图
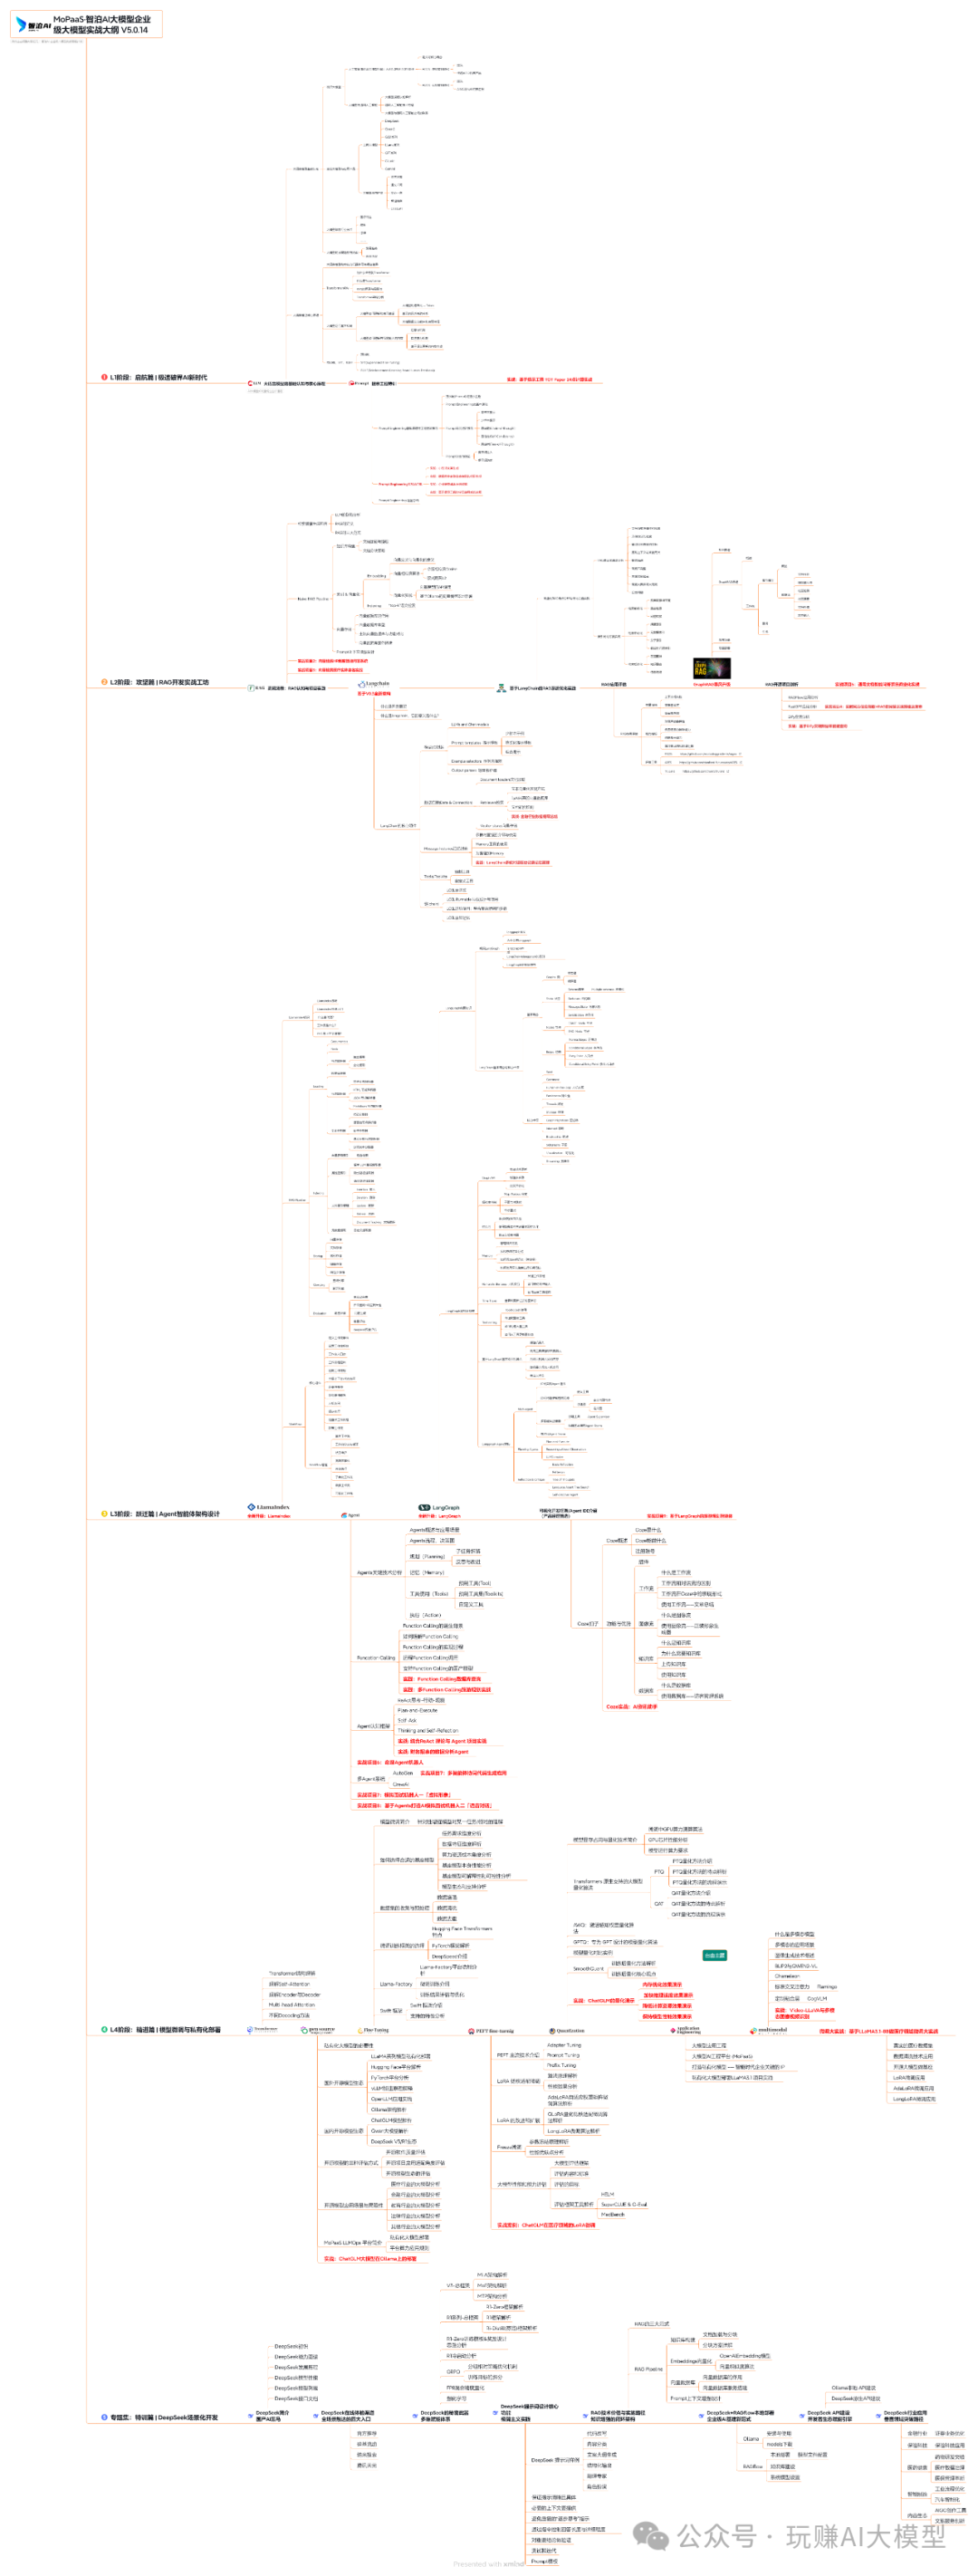
大模型学习路线图,整体分为5个大的阶段:
04 视频和书籍PDF合集
从0到掌握主流大模型技术视频教程(涵盖模型训练、微调、RAG、LangChain、Agent开发等实战方向)
新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路(不吹牛,真有用)
05 行业报告+白皮书合集
收集70+报告与白皮书,了解行业最新动态!
06 90+份面试题/经验
AI大模型岗位面试经验总结(谁学技术不是为了赚$呢,找个好的岗位很重要)
07 deepseek部署包+技巧大全
由于篇幅有限
只展示部分资料
并且还在持续更新中…
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
【附赠一节免费的直播讲座,技术大佬带你学习大模型的相关知识、学习思路、就业前景以及怎么结合当前的工作发展方向等,欢迎大家~】
更多推荐



 10
 0
- 0


 已为社区贡献8条内容

所有评论(0)