
linux 安装rocketmq和springboot rocketmq实战
⼀、MQ简介
MessageQueue,消息队列。是在互联⽹中使⽤⾮常⼴泛的⼀系列服务中间件。 这个词可以分两个部分 来看,⼀是Message:消息。消息是在不同进程之间传递的数据。这些进程可以部署在同⼀台机器上,也可以 分布在不同机器上。⼆是Queue:队列。队列原意是指⼀种具有FIFO(先进先出)特性的数据结构,是⽤来缓存 数据的。对于消息中间件产品来说,能不能保证FIFO特性,尚值得考量。但是,所有消息队列都是需要具备存 储消息,让消息排队的能⼒。 ⼴义上来说,只要能够实现消息跨进程传输以及队列数据缓存,就可以称之为消息队列。例如我们常⽤的 QQ、微信、阿⾥旺旺等就都具备了这样的功能。只不过他们对接的使⽤对象是⼈,⽽我们这⾥讨论的MQ产品 需要对接的使⽤对象是应⽤程序
异步
例⼦:快递员发快递,直接到客户家效率会很低。引⼊菜⻦驿站后,快递员只需要把快递放到菜⻦驿站, 就可以继续发其他快递去了。客户再按⾃⼰的时间安排去菜⻦驿站取快递。 作⽤:异步能提⾼系统的响应速度、吞吐量
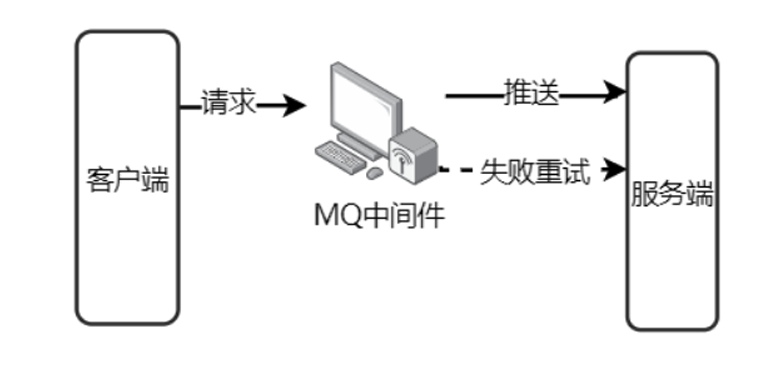
解耦
例⼦:《Thinking in JAVA》很经典,但是都是英⽂,我们看不懂,所以需要编辑社,将⽂章翻译成其他 语⾔,这样就可以完成英语与其他语⾔的交流。 作⽤: 1、服务之间进⾏解耦,才可以减少服务之间的影响。提⾼系统整体的稳定性以及可扩展性。 2、另外,解耦后可以实现数据分发。⽣产者发送⼀个消息后,可以由⼀个或者多个消费者进⾏消费,并 且消费者的增加或者减少对⽣产者没有影响
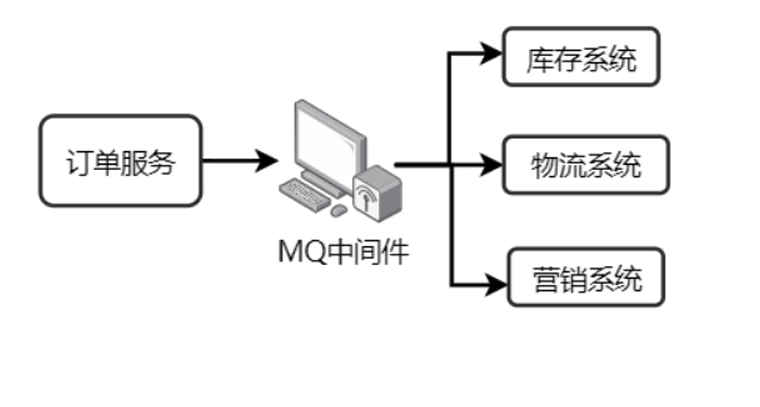
削峰
例⼦:⻓江每年都会涨⽔,但是下游出⽔⼝的速度是基本稳定的,所以会涨⽔。引⼊三峡⼤坝后,可以把 ⽔储存起来,下游慢慢排⽔。 作⽤:以稳定的系统资源应对突发的流量冲击
⼆、RocketMQ产品特点
RocketMQ是阿⾥巴巴开源的⼀个消息中间件,在阿⾥内部历经了双⼗⼀等很多⾼并发场景的考验,能够处理 亿万级别的消息。2016年开源后捐赠给Apache,现在是Apache的⼀个顶级项⽬。 早期阿⾥使⽤ActiveMQ,但是,当消息开始逐渐增多后,ActiveMQ的IO性能很快达到了瓶颈。于是,阿⾥开 始关注Kafka。但是Kafka是针对⽇志收集场景设计的,他的⾼级功能并不是很贴合阿⾥的业务场景。尤其当他 的Topic过多时,由于Partition⽂件也会过多,这就会加⼤⽂件索引的耗时,会严重影响IO性能。于是阿⾥才决 定⾃研中间件,最早叫做MetaQ,后来改名成为RocketMQ。最早他所希望解决的最⼤问题就是多Topic下的IO 性能压⼒。但是产品在阿⾥内部的不断改进,RocketMQ开始体现出⼀些不⼀样的优势。 2、RocketMQ特点 当今互联⽹MQ产品众多,其中,影响⼒和使⽤范围最⼤的当数Apache Kafka、RabbitMQ
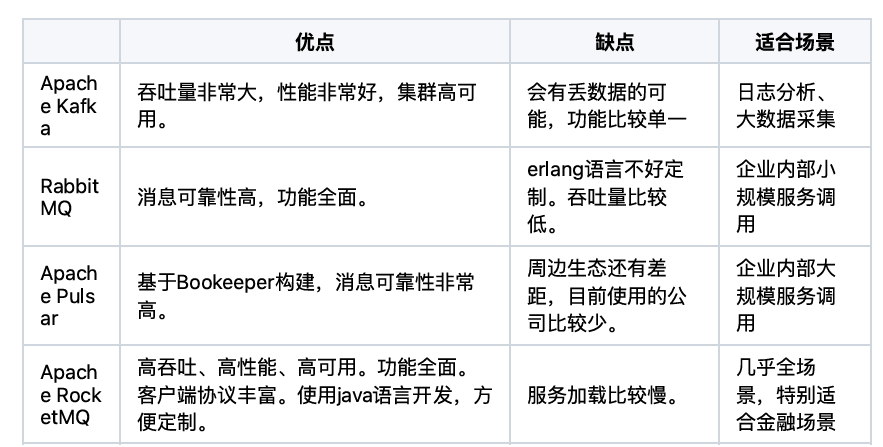
这些是官网的介绍。
三、RocketMQ快速实战
1、快速搭建RocketMQ服务 RocketMQ的官⽹地址: http://rocketmq.apache.org 。在下载⻚⾯可以获取RocketMQ的源码包以及运⾏ 包。下载⻚⾯地址:https://rocketmq.apache.org/download
上面下载太慢了,直接去阿里云镜像去下载:
https://mirrors.aliyun.com/apache/rocketmq/5.2.0/
下载速度很快。下载后解压:
使⽤vi runserver.sh指令,编辑这个脚本,找到下⾯的⼀⾏配置,调整Java进程的内存⼤⼩
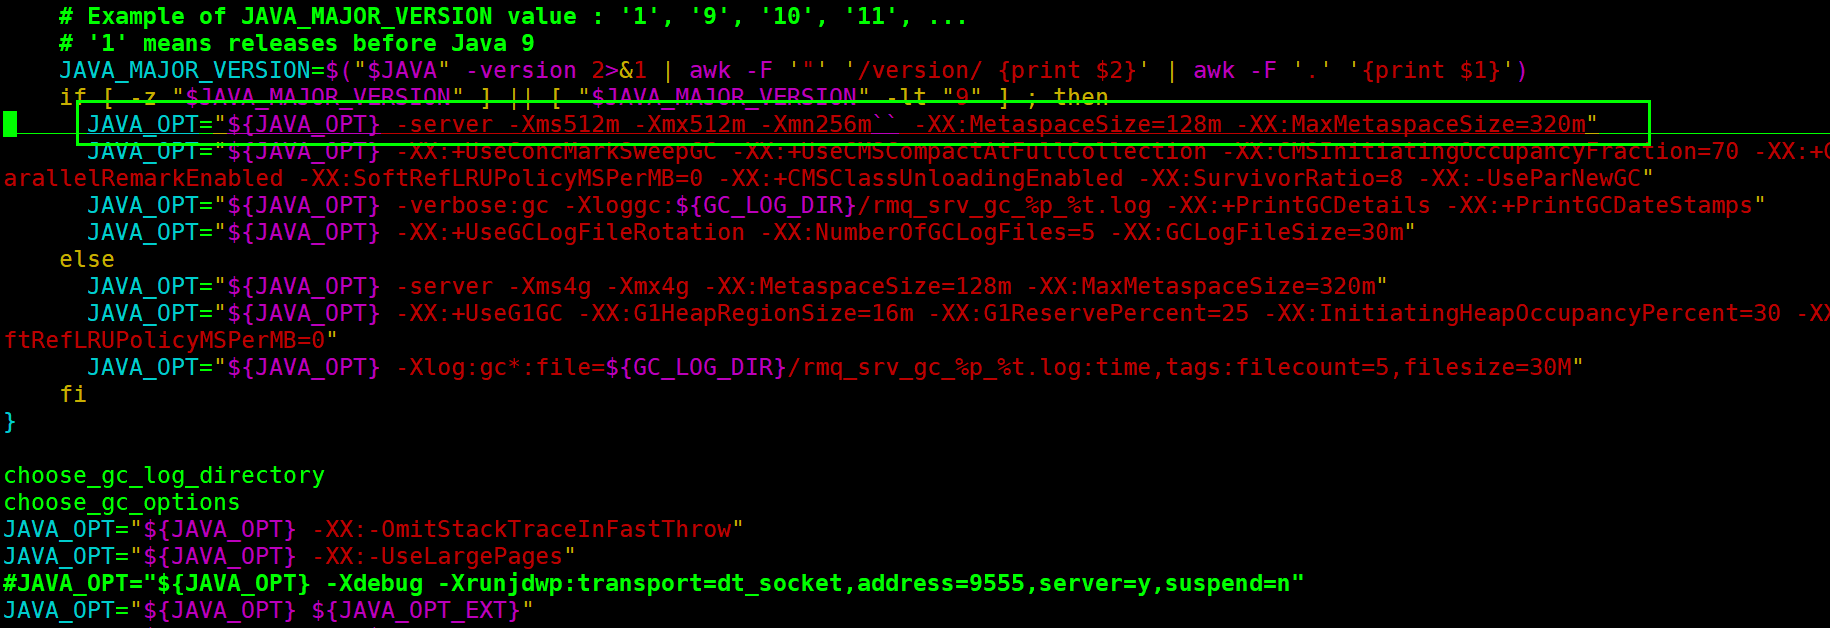
接下来,同样调整runbroker.sh中的内存⼤⼩。
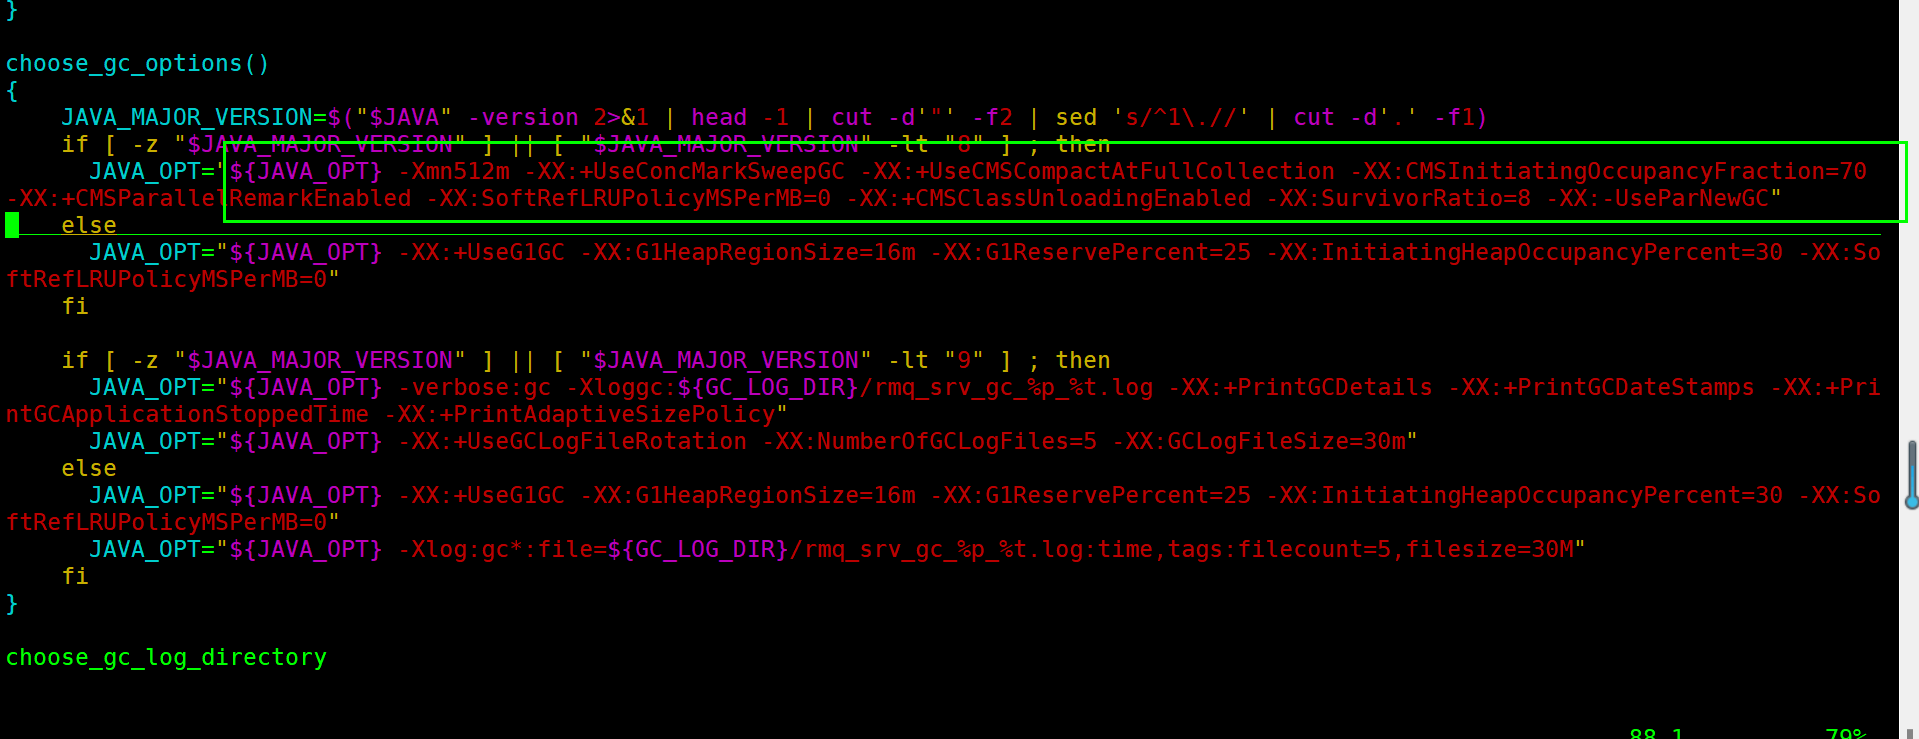
修改配置时,注意要根据你的JDK版本调整对应的配置⾏。RocketMQ是⼀个典型的Java应⽤,所以需要 提前安装JDK。我们这⾥采⽤的是1.8版本。JDK的安装过程略。 ⽣产环境不建议调整。这⼀系列参数实际上就是RocketMQ的JVM调优结果。 RocketMQ的后端服务分为nameserver和broker两个服务,关于他们的作⽤,后⾯会给你分享。接下来我们 先将这两个服务启动起来。
第⼀步:启动nameserver服务。
cd /htdocs/share/tool/rocketmq-all-5.2.0-bin-release nohup bin/mqnamesrv & 这个是运行在后台,当然我们可以直接运行在控制台:
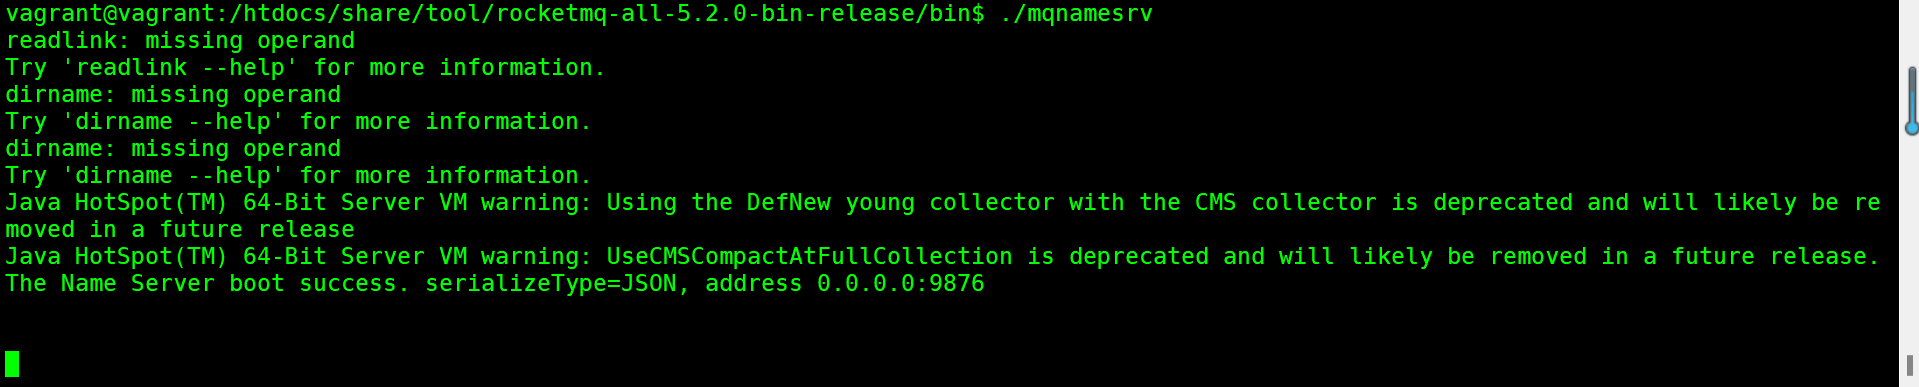
可以看到已经启动了。
第⼆步:启动broker服务
broker也是⼀个Java服务,只需要调整conf⽬录下的broker.conf⽂件,进⾏⼀些定制。然后就可以启动了。 具体配置项参⻅官⽅⽂档,这⾥尽量⾛默认配置。 如果你的服务器配置了多张⽹卡,建议配置brokerIP1属性。⽐如阿⾥云,腾讯云这样的云服务器,他们 通常有内⽹⽹卡和外⽹⽹卡两张⽹卡,那么需要增加配置brokerIP1属性,指向服务器的外⽹IP 地址,这 样才能确保从其他服务器上访问到RocketMQ 服务。 在启动broker服务前,需要先指定NameServer的服务地址。RocketMQ可以使⽤⼀个NAMESRV_ADDR的环 境变量指定NameServer服务地址。 通过vi ~/.bash_profile添加以下配置。然后使⽤source ~/.bash_profile让配置⽣效。 export NAMESRV_ADDR='192.168.33.10:9876'
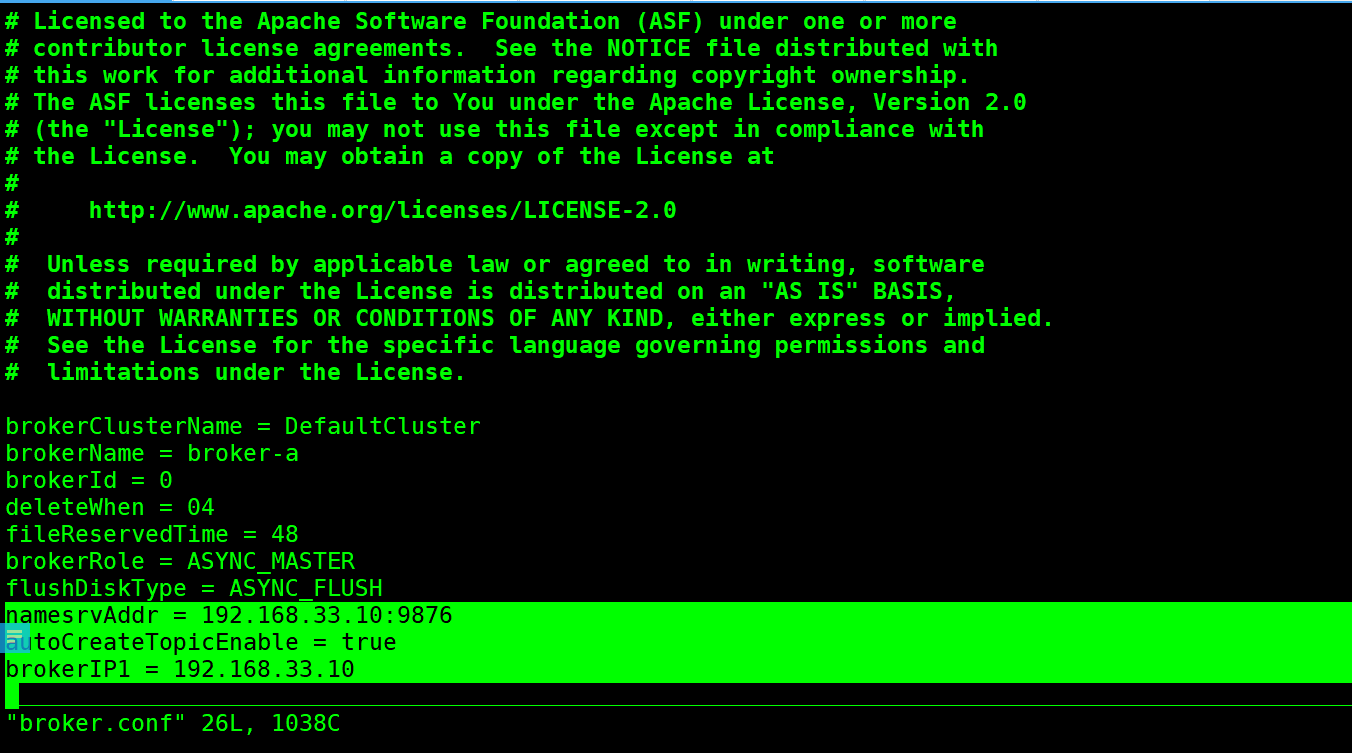
namesrvAddr = 192.168.33.10:9876 //nameserver 地址
autoCreateTopicEnable = true //自动创建主题
brokerIP1 = 192.168.33.10 //broker ip
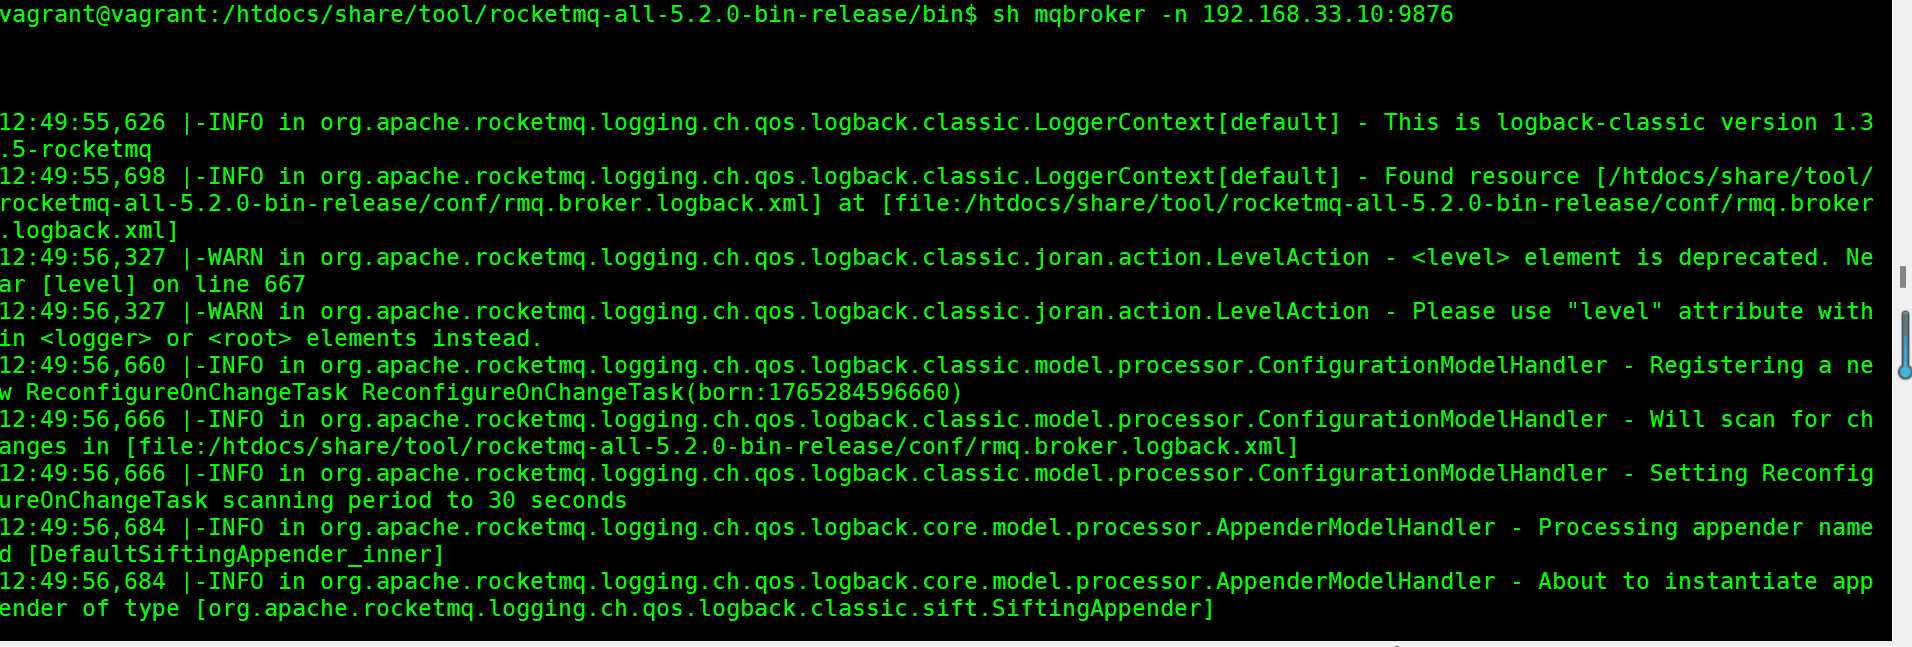
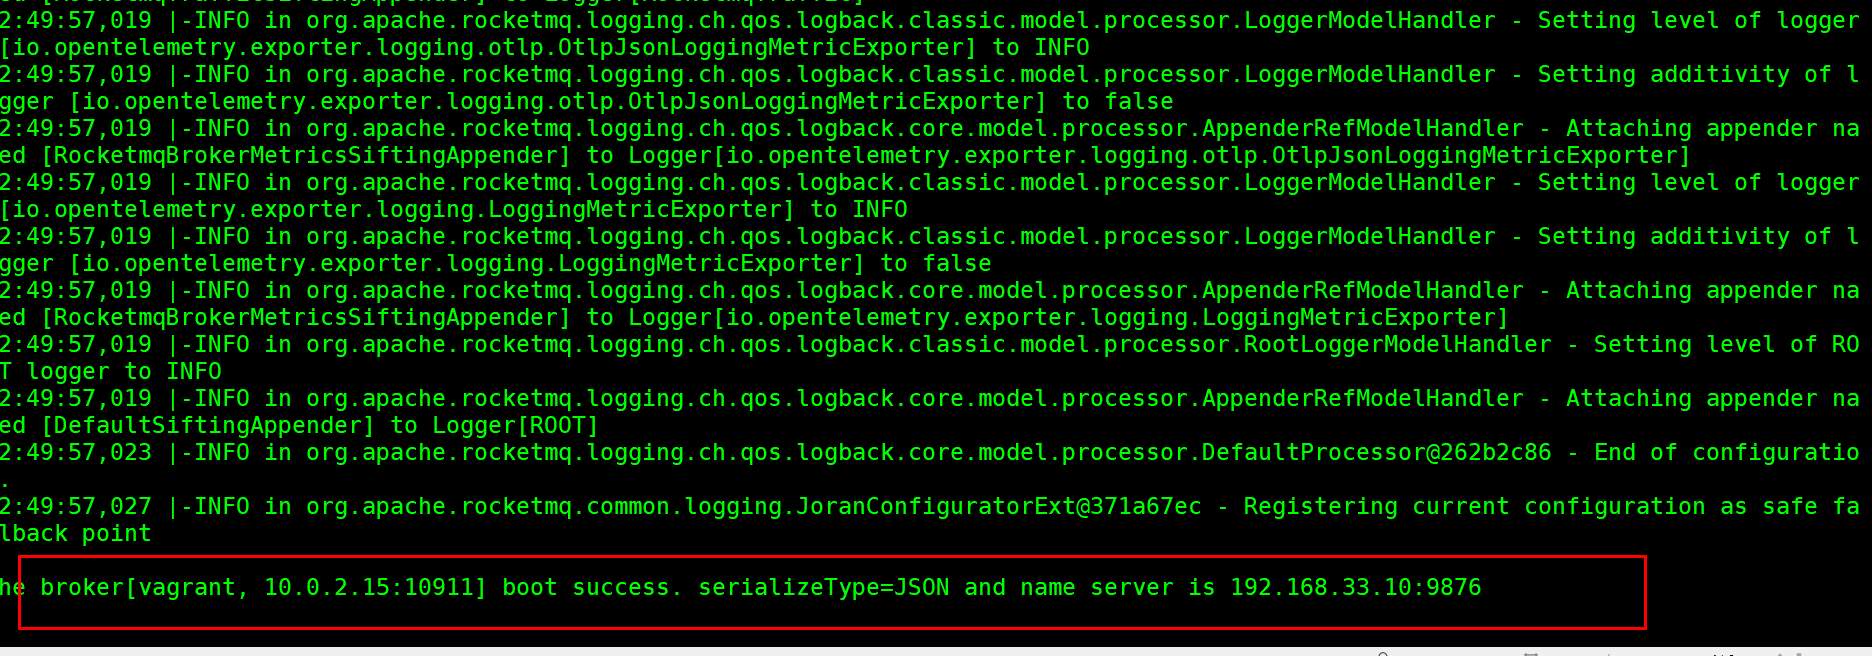
也可以指定broker文件启动
sh bin/mqbroker -n 192.168.33.10:9876 -c ./conf/broker.conf
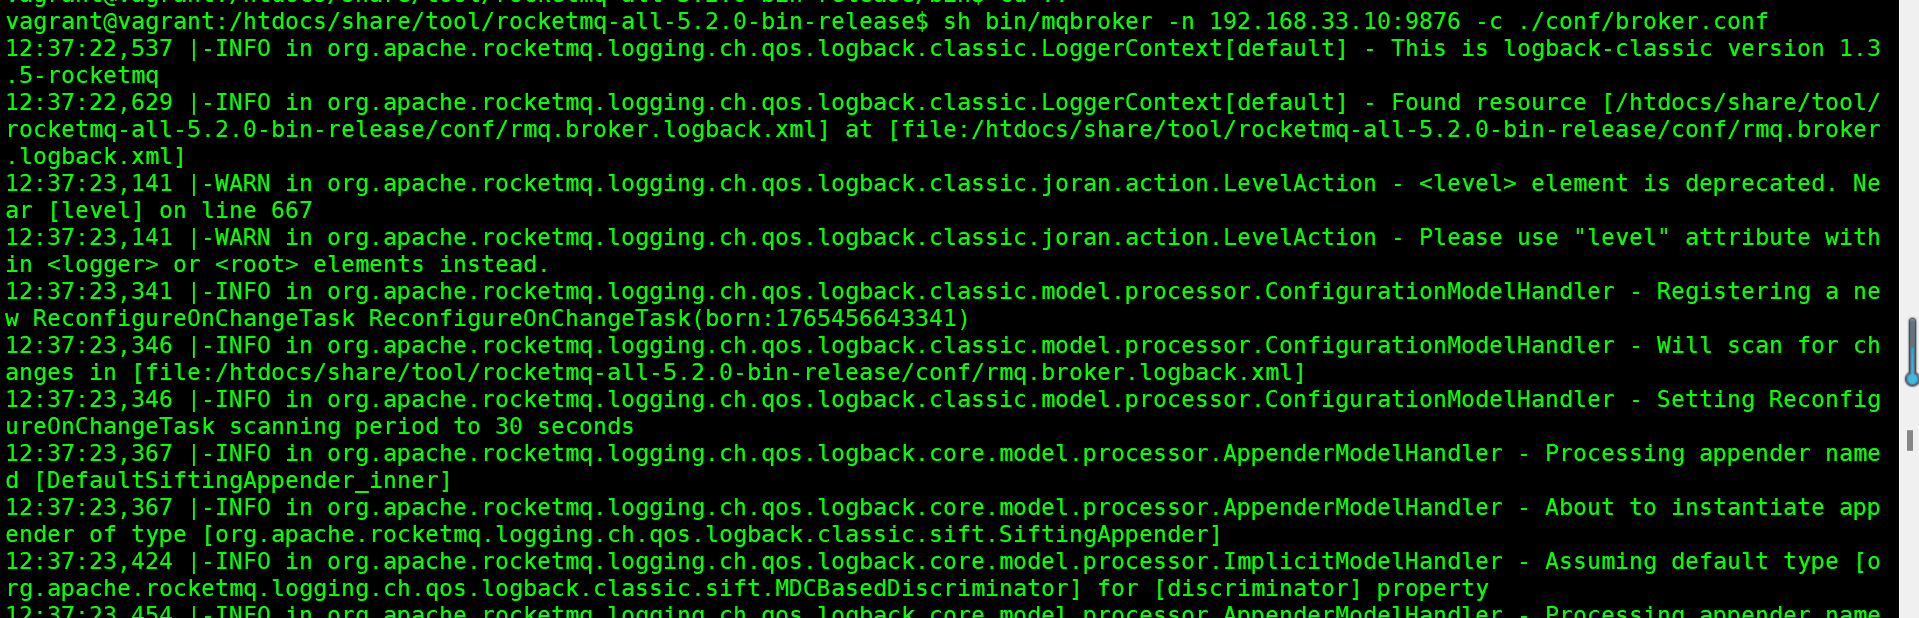
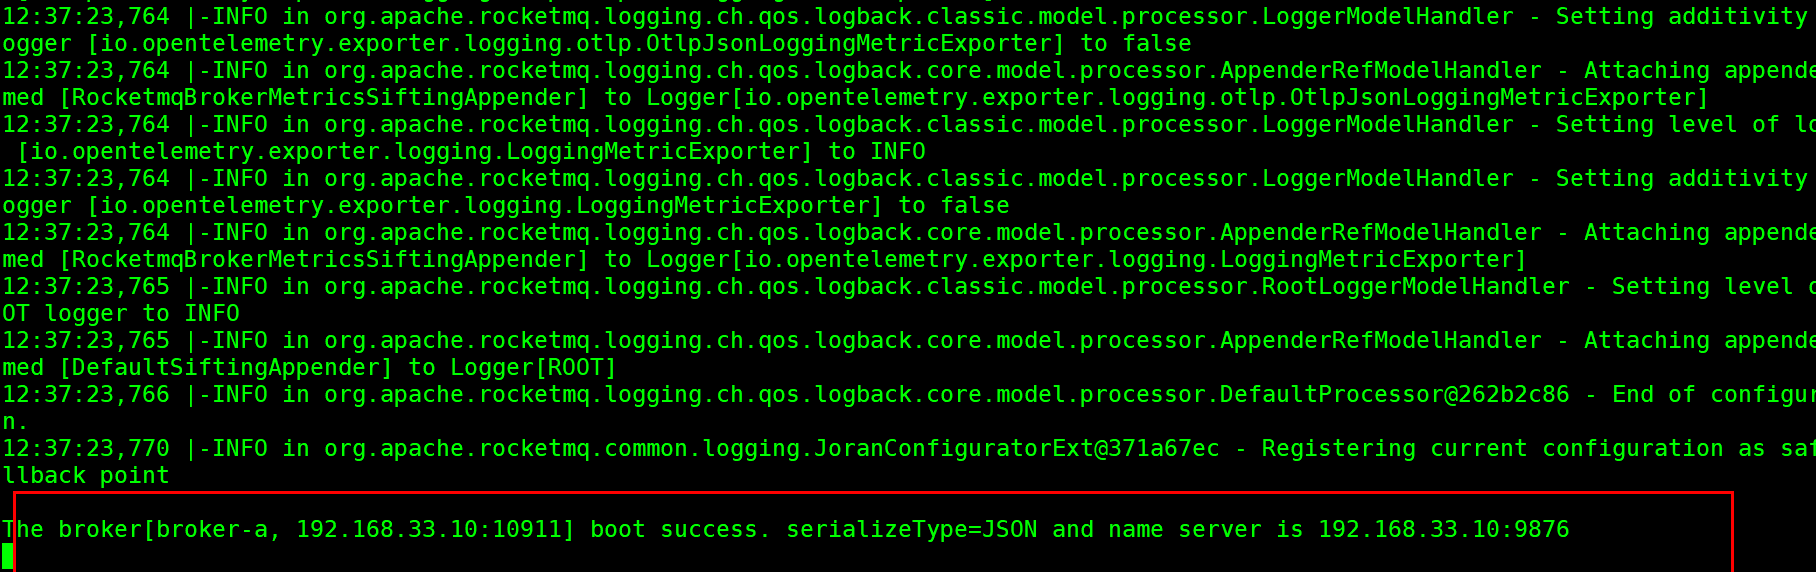
可以看到已经启动了。
2、搭建RocketMQ可视化管理服务
在之前的简单实验中,RocketMQ都是以后台服务的⽅式在运⾏,我们并不很清楚RocketMQ是如何运⾏的。 RocketMQ的社区就提供了⼀个图形化的管理控制台Dashboard,可以⽤可视化的⽅式直接观测并管理 RocketMQ的运⾏过程。 Dashboard服务并不在RocketMQ的运⾏包中,需要到RocketMQ的官⽹下载⻚⾯单独下载
下载后的jar包,指定端口和nameserver 的IP端口:
java -jar rocketmq-console-ng-1.0.1.jar --server.port=8089 --rocketmq.config.namesrvAddr=192.168.33.10:9876
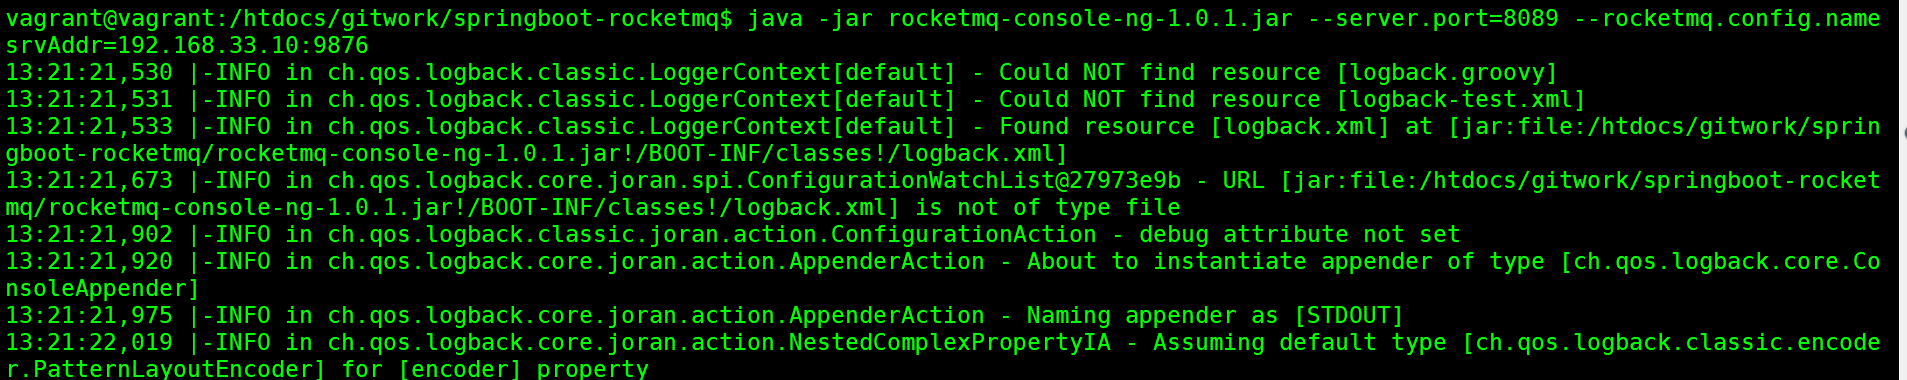
已经启动成功。
接着打开控制台面板,浏览器输入http://192.168.33.10:8089/#/:
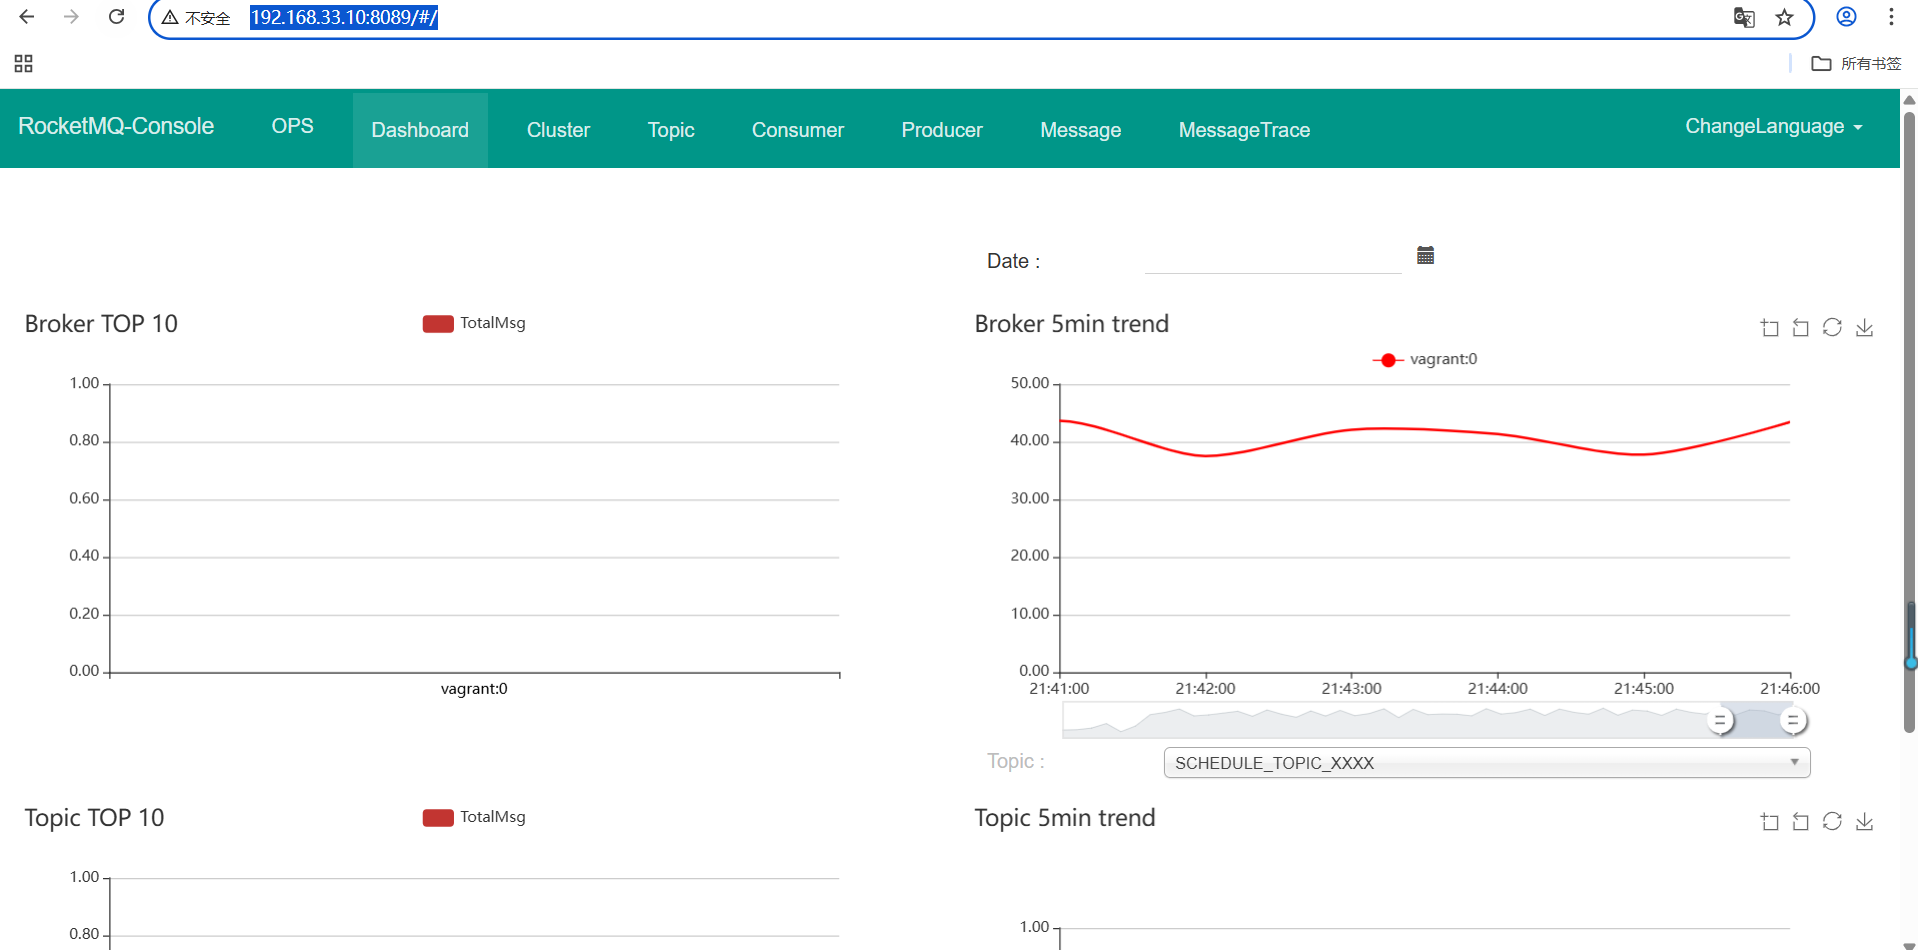
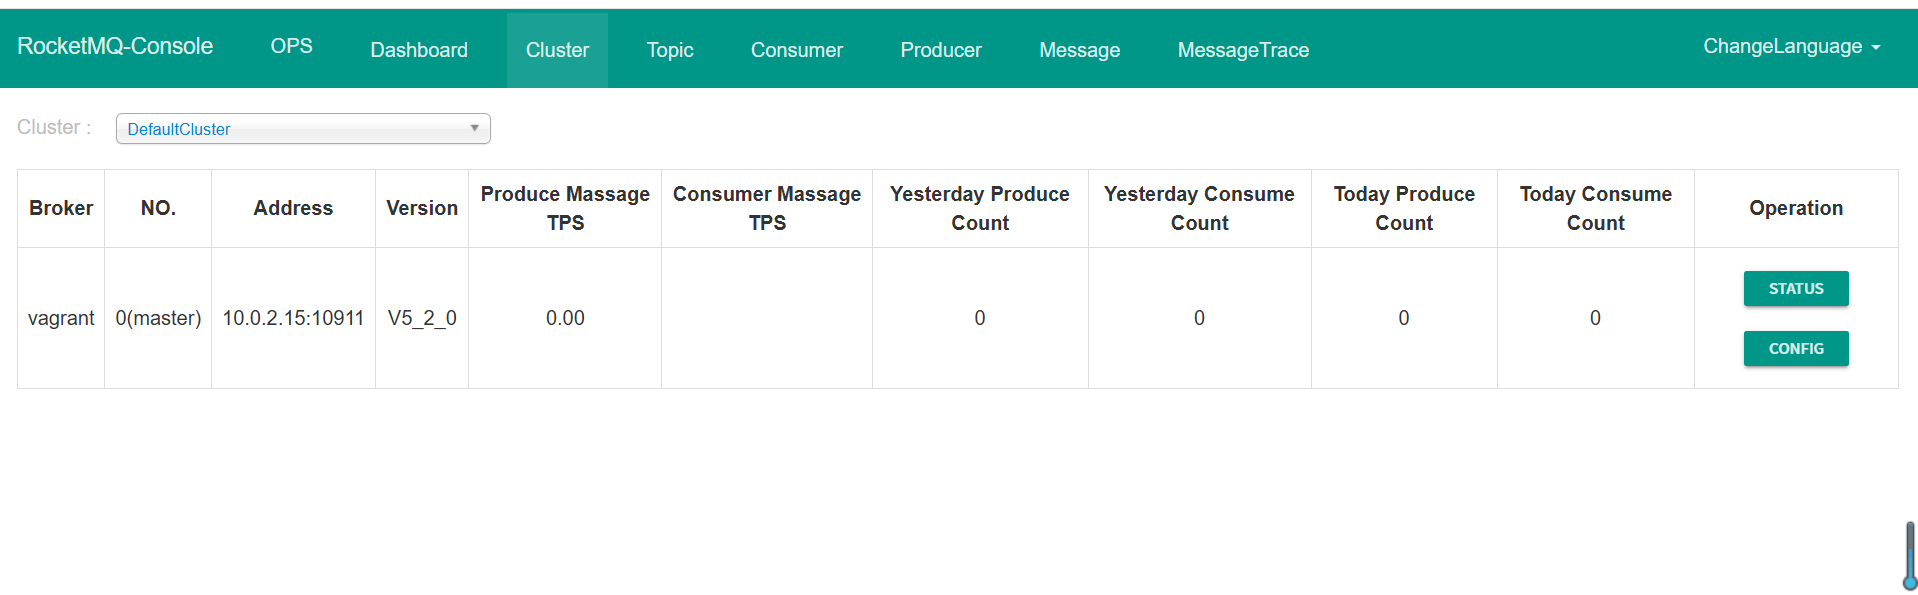
以上环境就搭建好了,我们现在用代码来实现生产者和消费者。
四、springboot 整合RocketMQ快速实战
1.pom引入 RocketMQ坐标
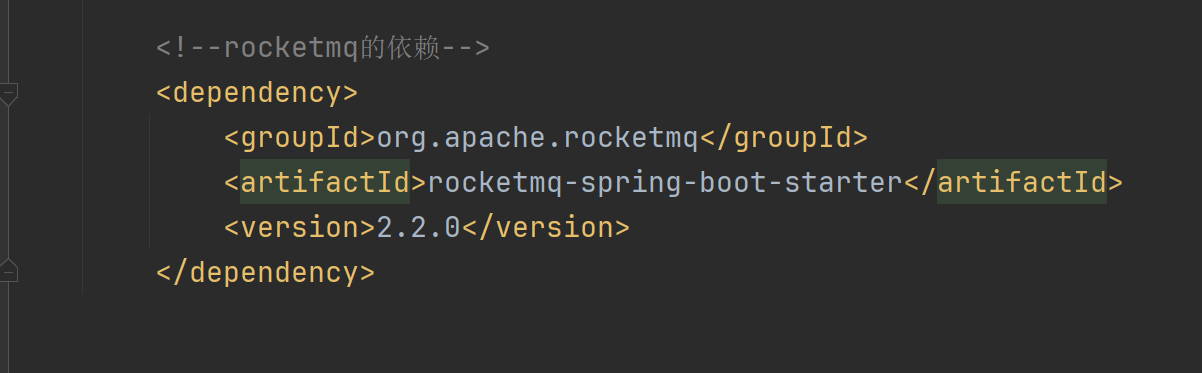
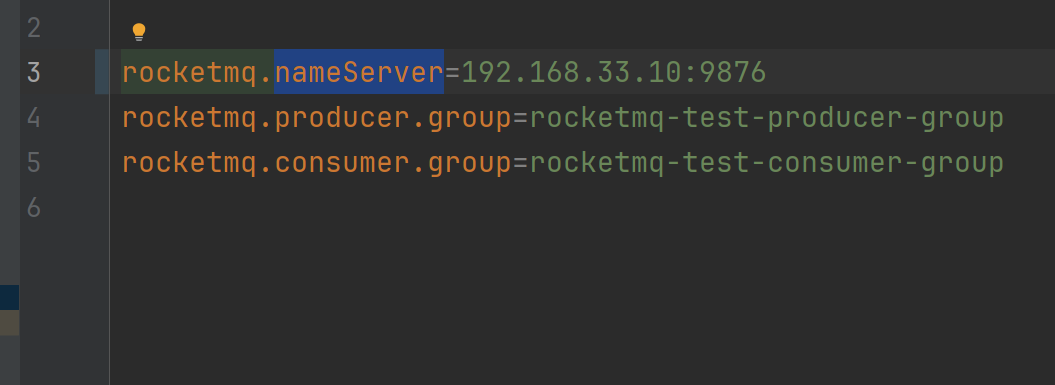
2. application.properties 配置RocketMQ nameServer 以及生产者消费者组。
3. 注入消费者监听
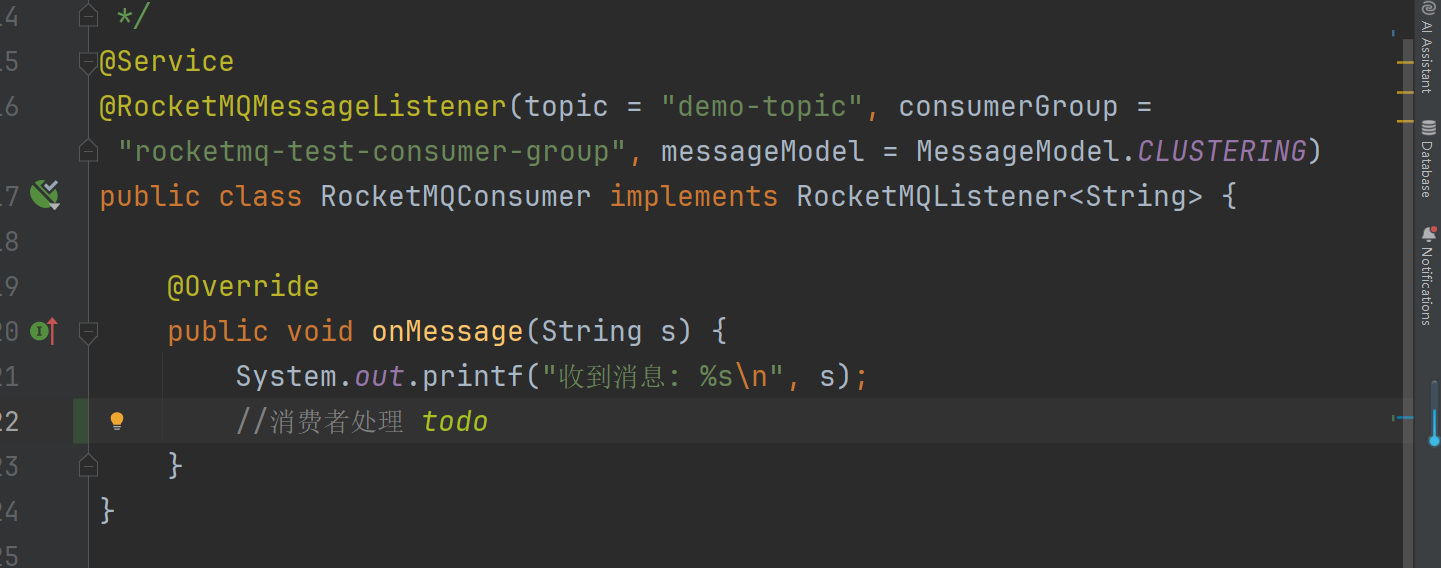
4.同步发送消息:
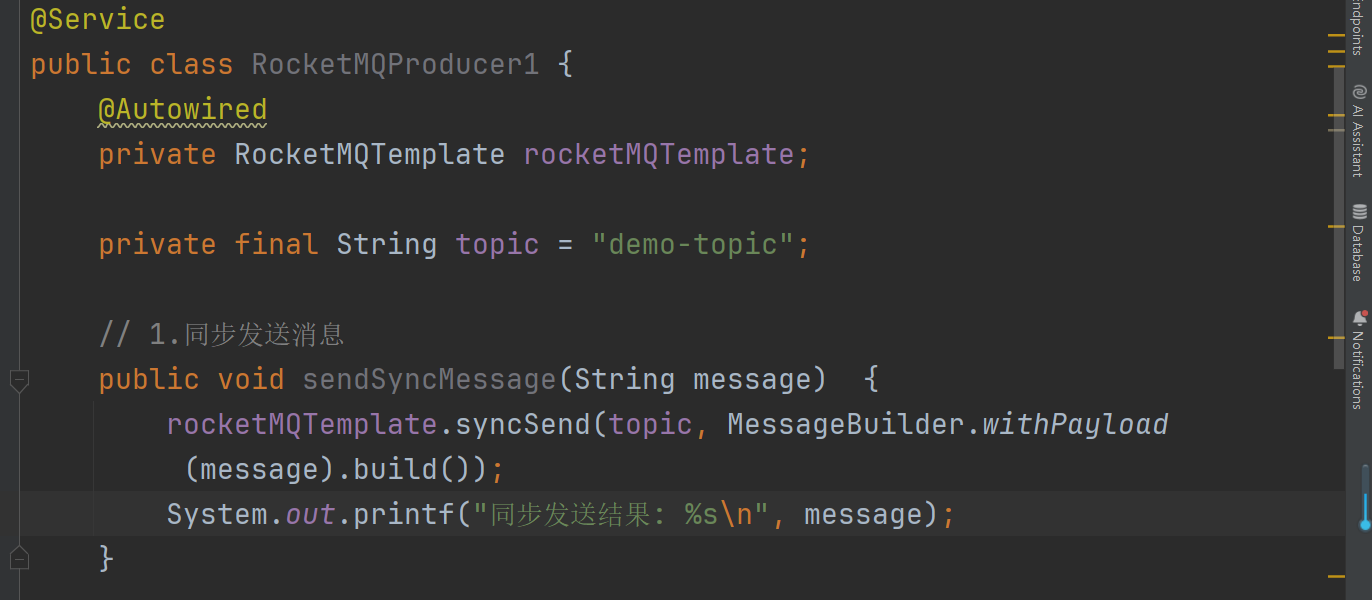
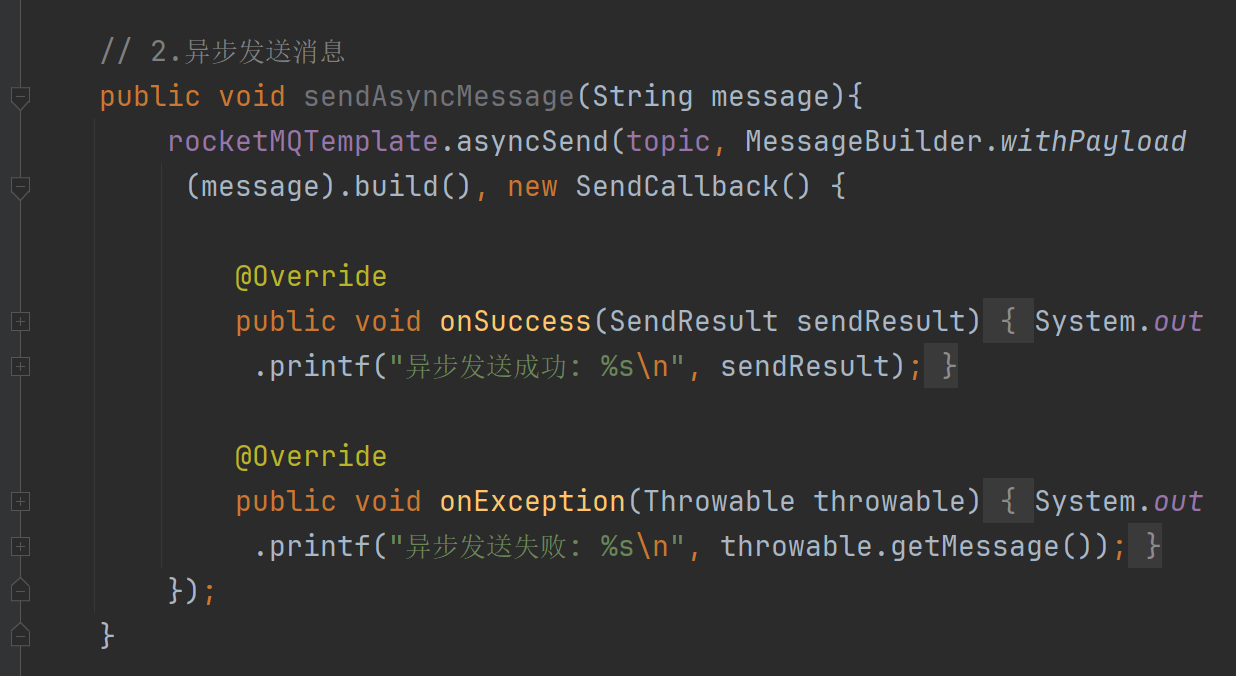
也可以异步发送消息:
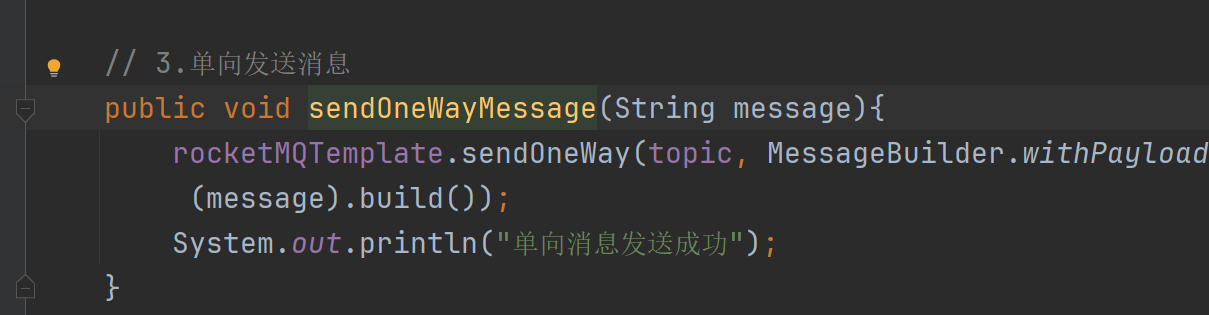
单向发消息,不管结果:
5.写个接口:
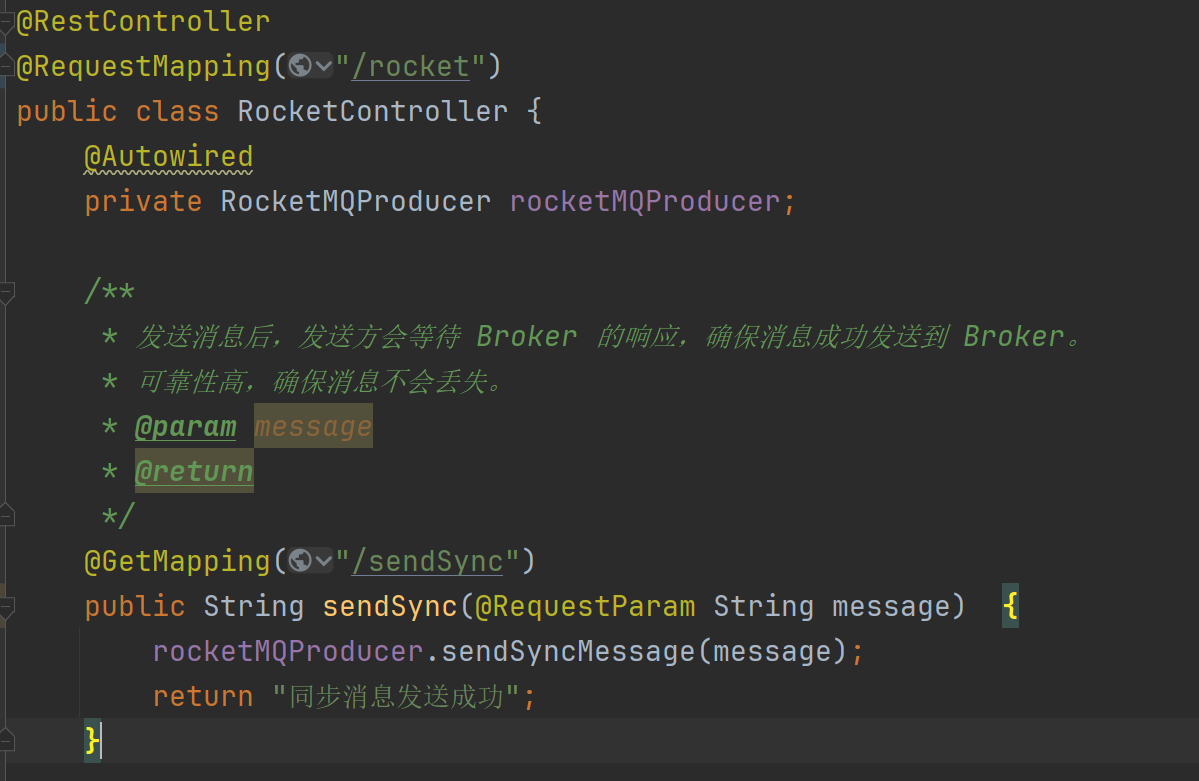
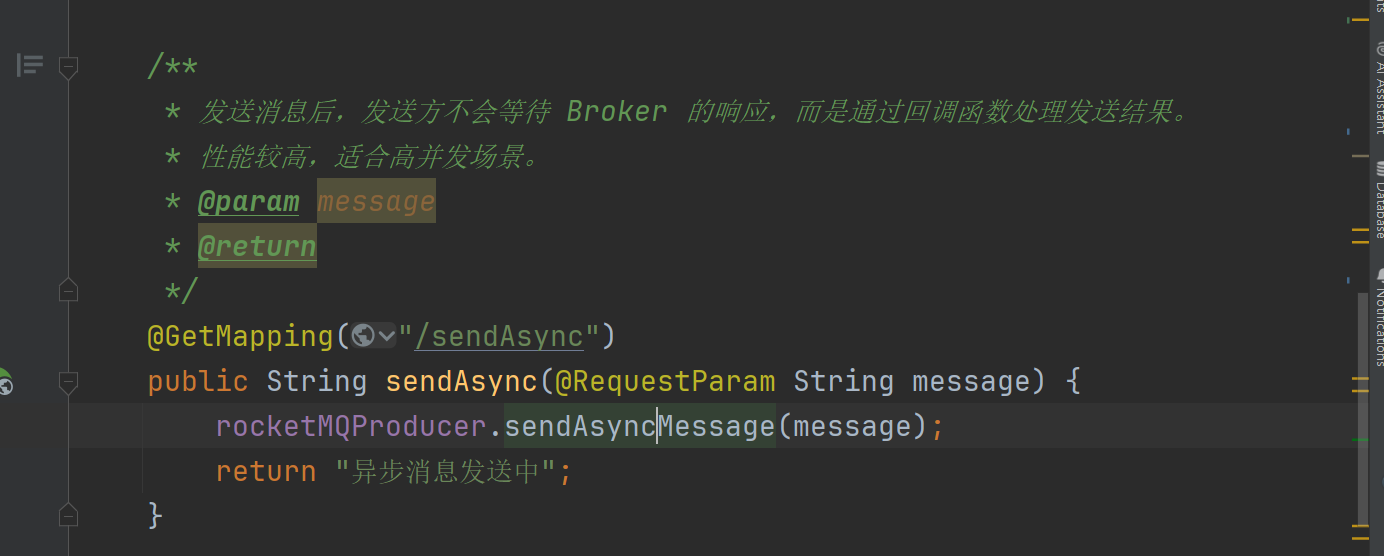
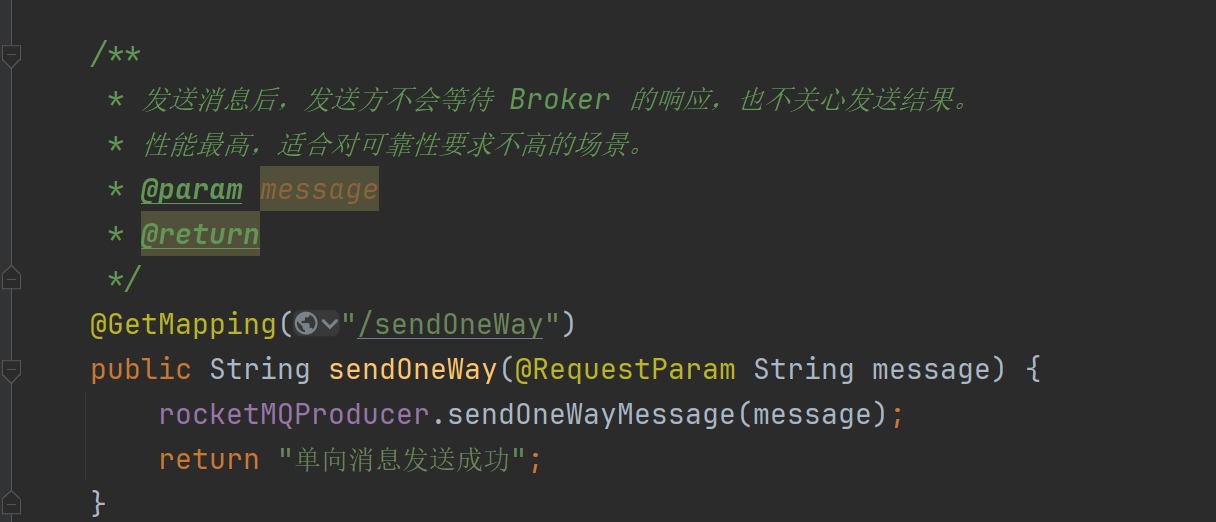
接下来我们请求接口:
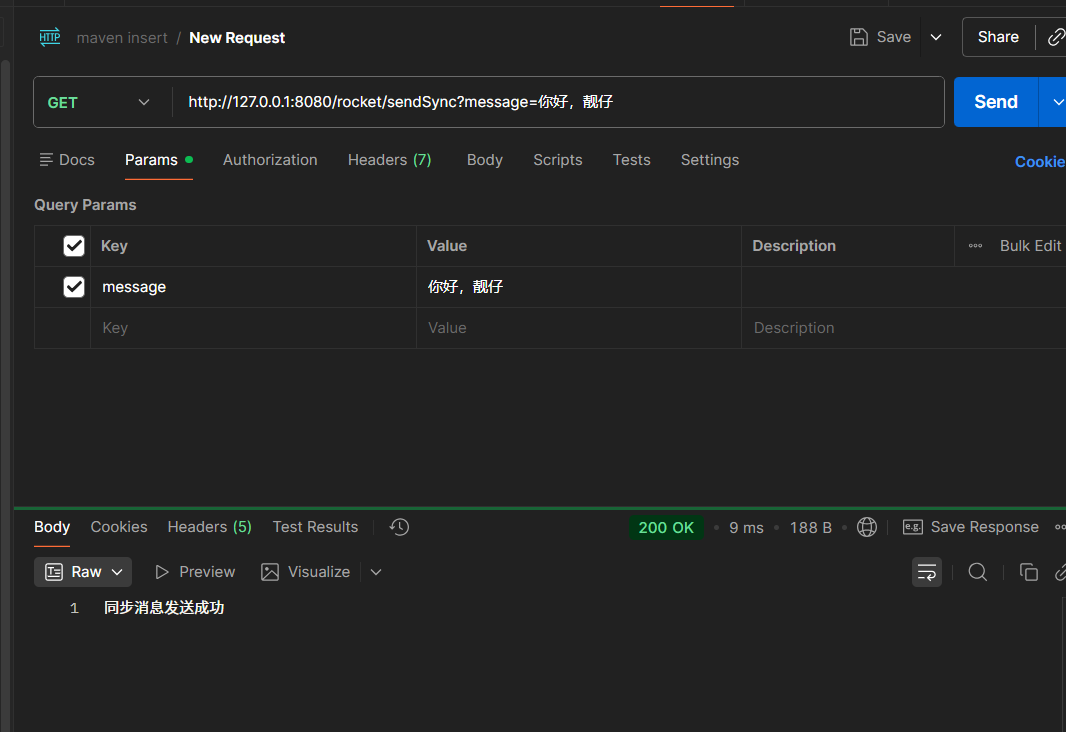
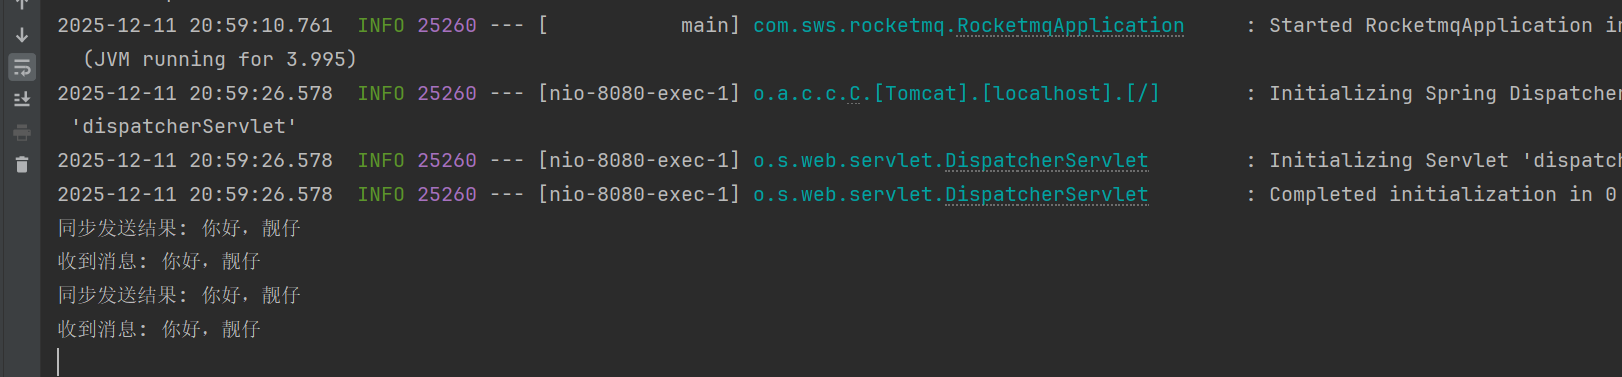
异步发送消息:
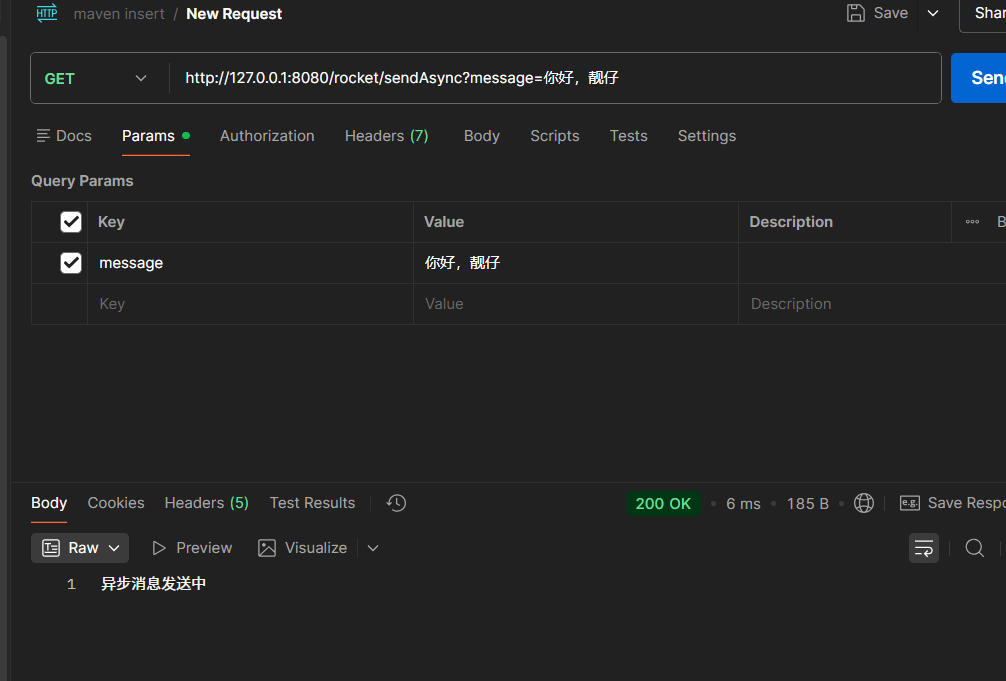
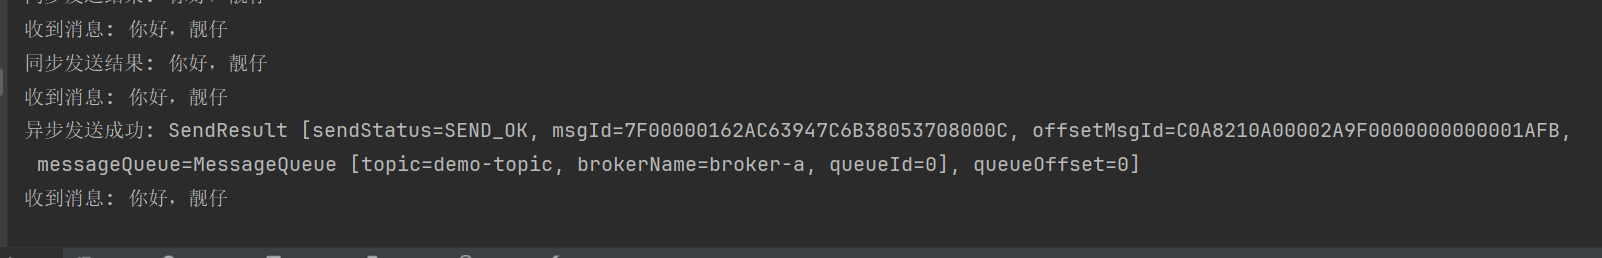
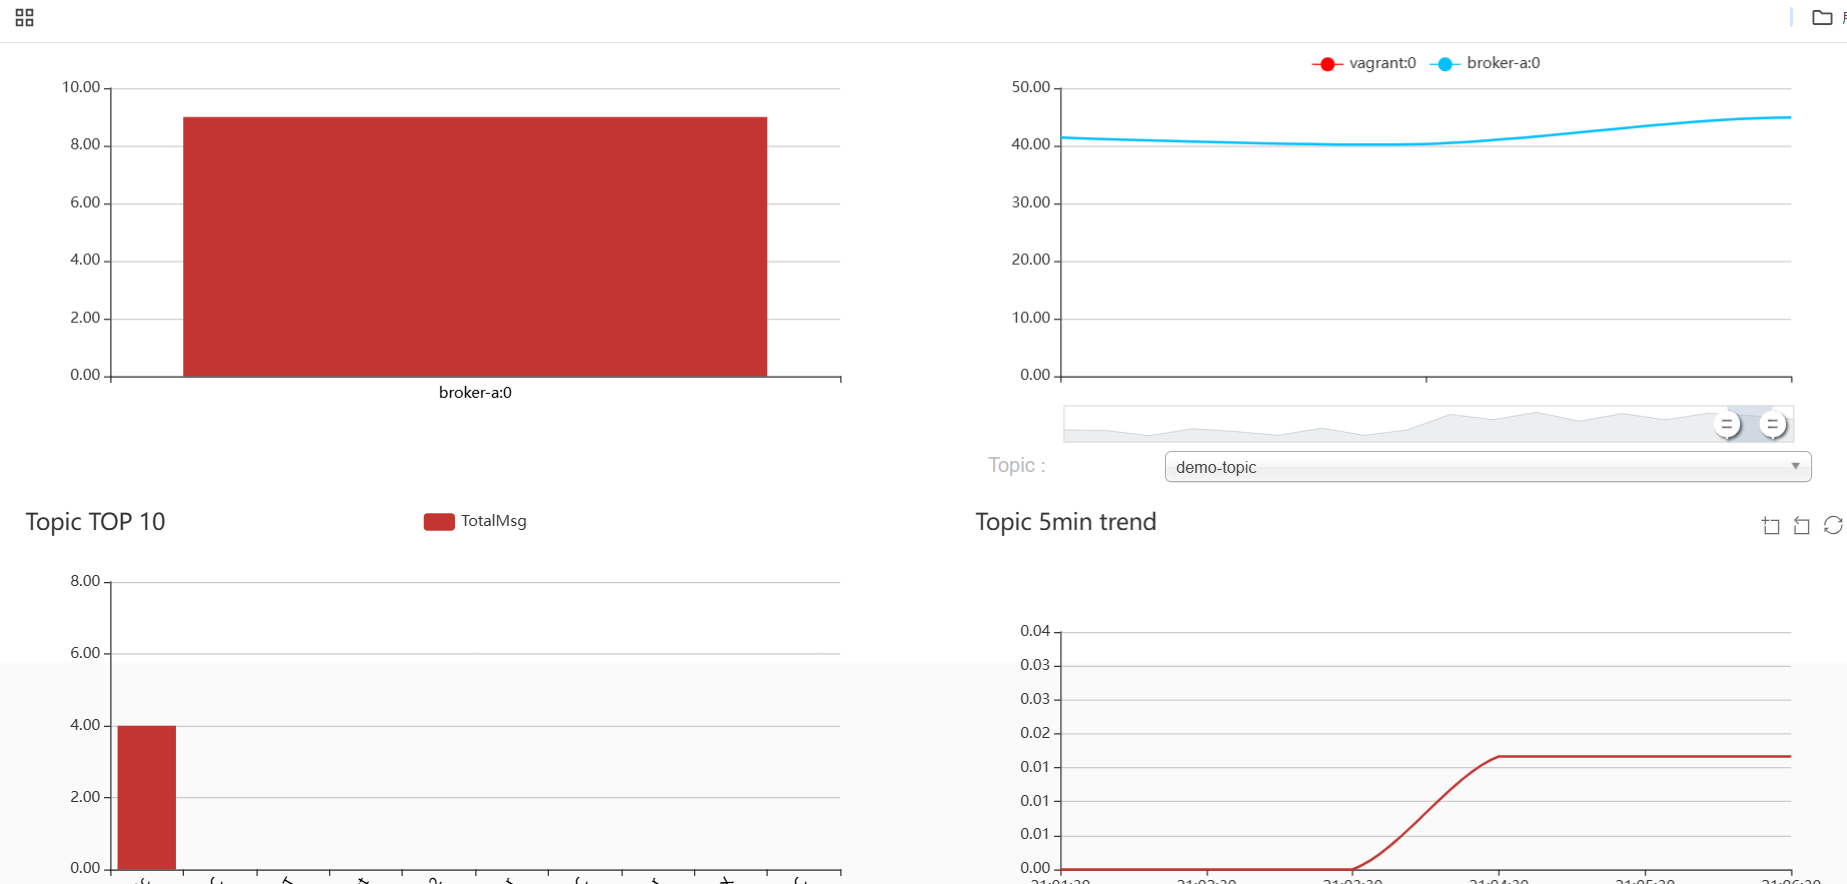
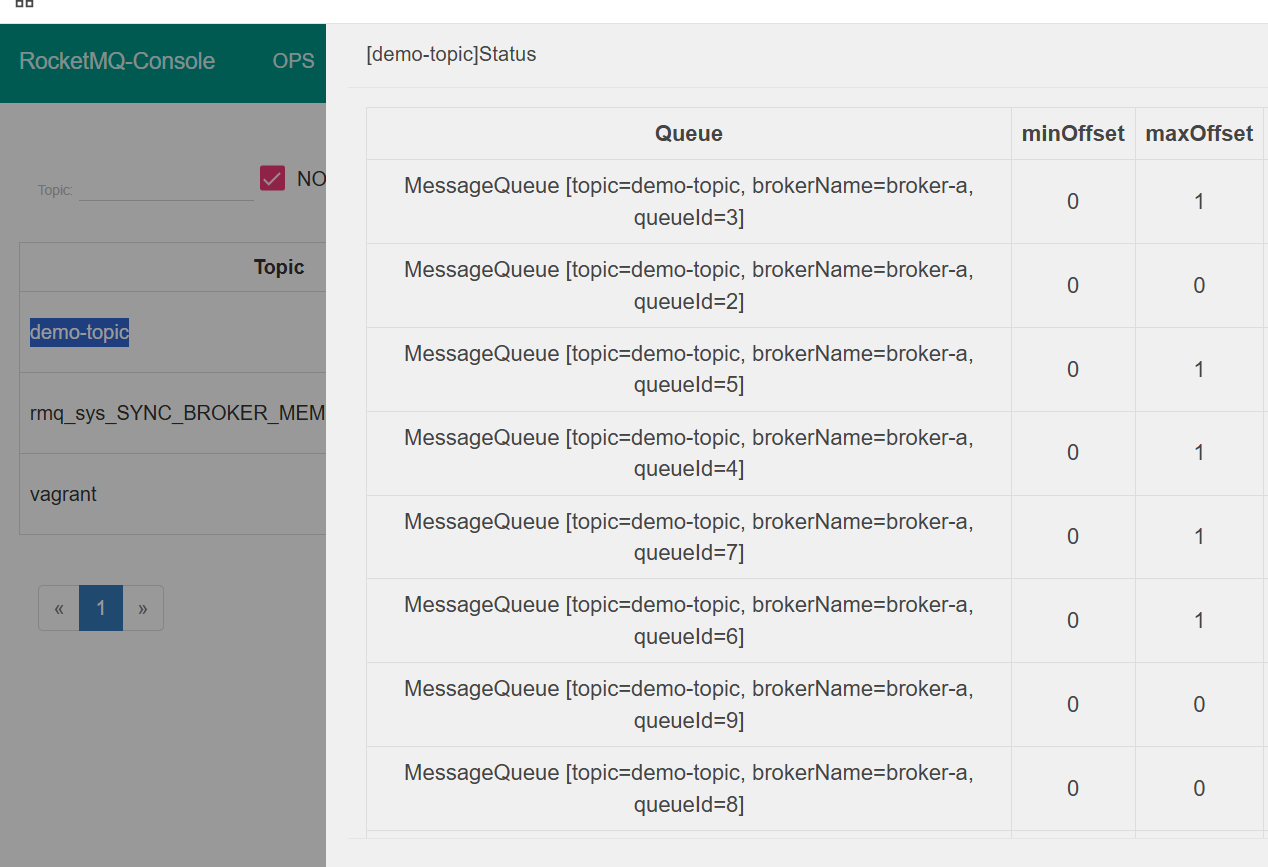
控制面板可以看到demo-topic消息和消费情况:
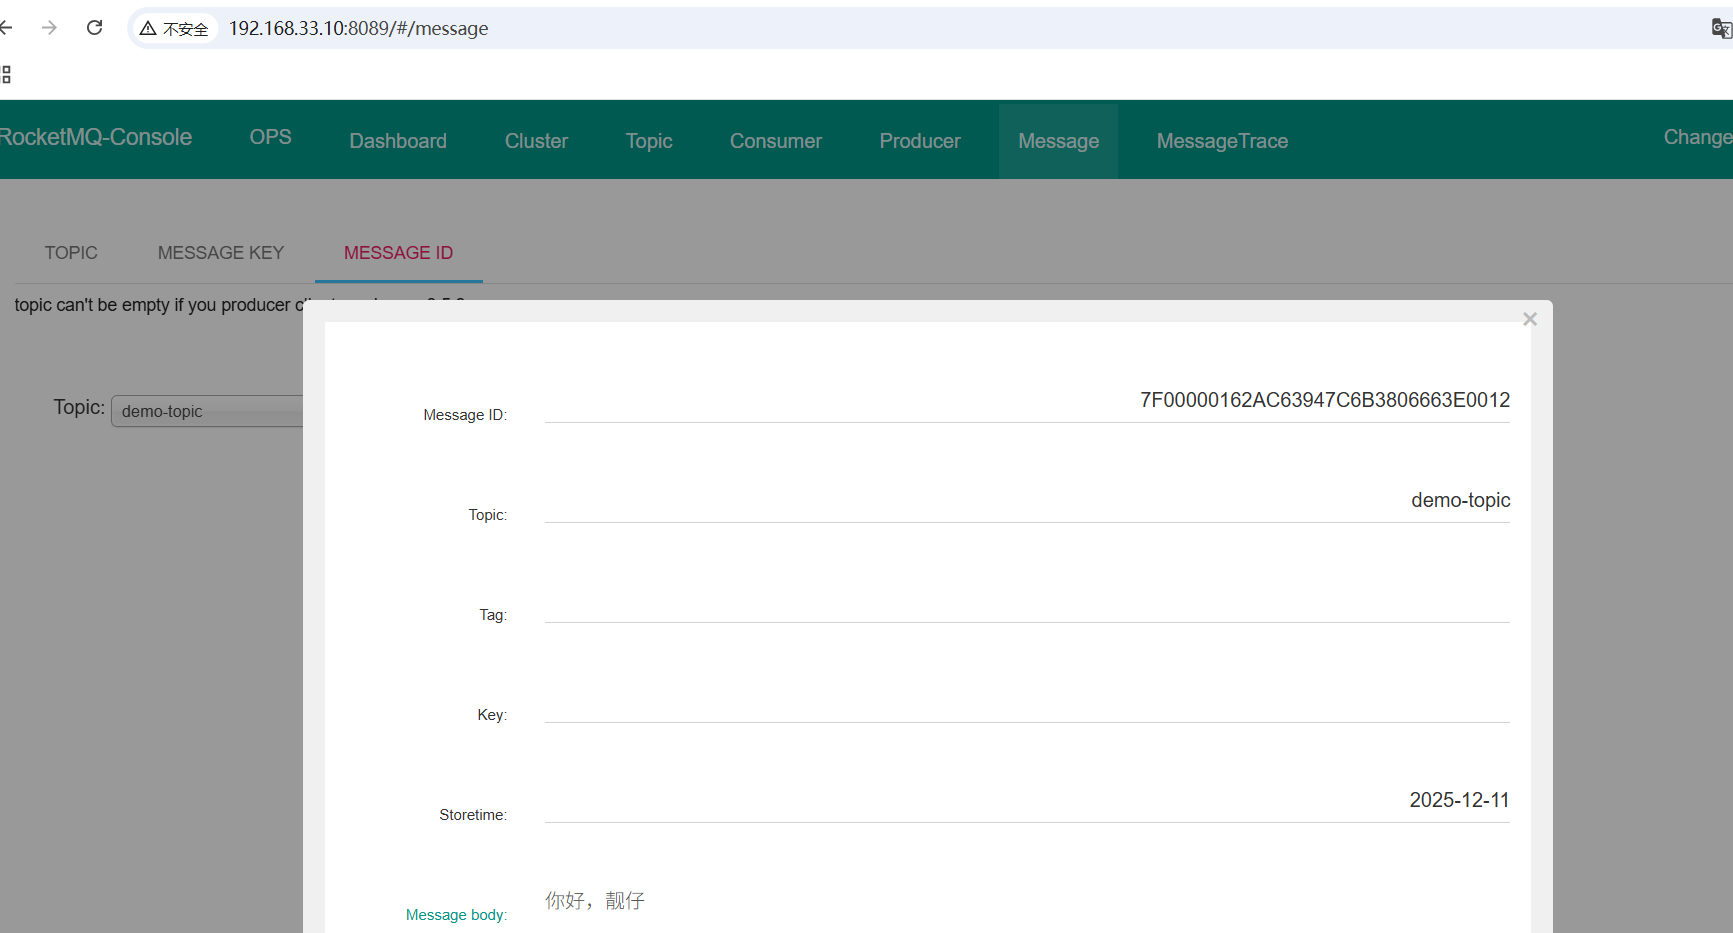
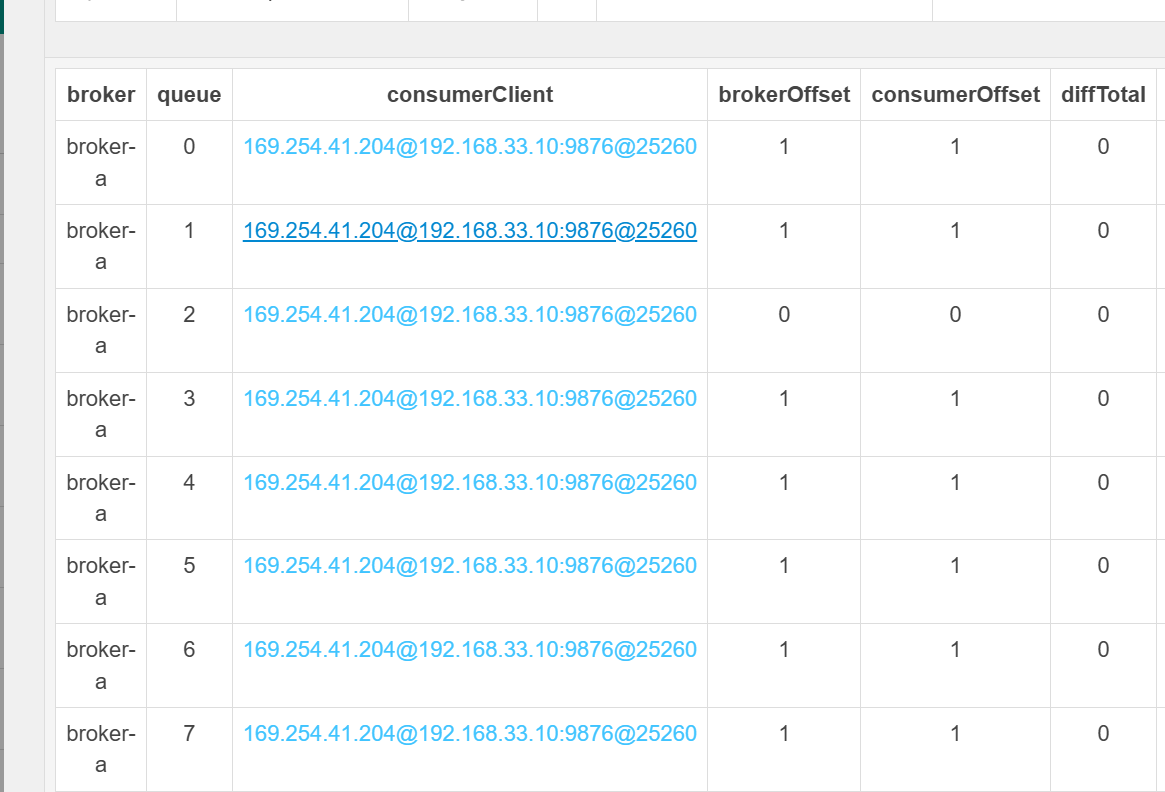
以上的就是RocketMQ的单机安装和springboot 整合实战,实际应用过程中我们使用的是集群。
RocketMQ的分布式集群基于主从架构搭建。在多个服务器组成的集群中,指定⼀部分节点作为Master节点, 负责响应客户端的请求。指令另⼀部分节点作为Slave节点,负责备份Master节点上的数据,这样,当Master 节点出现故障时,在Slave节点上可以保留有数据备份,⾄少保证数据不会丢失。
主从架构的RocketMQ集群,由于给每个broker服务配置了⼀个或多个slave备份服务,可以保证当broker服务 出现问题时,broker上的消息不会丢失。但是,这种主从架构的集群却也有⼀个不⾜的地⽅,那就是不具备服 务⾼可⽤。
这⾥所说的服务⾼可⽤,并不是并不是指整个RocketMQ集群就不能对外提供服务了,⽽是指集群中的消息就 不完整了。实际上,当RocketMQ集群中的broker宕机后,整个集群会⾃动进⾏broker状态感知。后续客户端 的各种请求,依然可以转发到其他正常的broker上。只不过,原本保存在当前broker上的消息,就⽆法正常读 取了,需要等到当前broker服务重启后,才能重新被消息消费者读取。 当⼀个broker上的服务宕机后,我们可以从对应的slave服务上找到broker上所有的消息。但是很可惜,主从 架构中各个服务的⻆⾊都是固定了的,slave服务虽然拥有全部的数据,但是它没办法升级成为master服务去 响应客户端的请求,依然只是傻傻等待master服务重启后,继续做它的数据备份⼯作。 这时,我们⾃然就希望这个slave服务可以升级成为master服务,继续响应客户端的各种请求,这样整个集群 的消息服务就不会有任何中断。⽽RocketMQ提供的Dledger集群,就是具备⻆⾊⾃动转换功能的⾼可⽤集 群。 后面我们讲Dledger⾼可⽤集群。在Dledger集群中,就不再单独指定各个broker的服务,⽽是由这些broker服务⾃⾏进⾏选举,产⽣⼀个 Leader⻆⾊的服务,响应客户端的各种请求。⽽其他的broker服务,就作为Follower⻆⾊,负责对Leader上的 数据进⾏备份。当然,Follower所要负责的事情,⽐主从架构中的SLAVE⻆⾊会要复杂⼀点,因为这种节点选 举是在后端不断进⾏的,他们需要随时做好升级成Leader的准备。 Dledger集群的选举是通过Raft协议进⾏的,Raft协议是⼀种多数同意机制。也就是每次选举需要有集群中超 过半数的节点确认,才能形成整个集群的共同决定。同时,这也意味着在Dledger集群中,只要有超过半数的 节点能够正常⼯作,那么整个集群就能正常⼯作。因此,在部署Dledger集群时,通常都是部署奇数台服务, 这样可以让集群的容错性达到最⼤。需要源代码的,可以打开下面连接https://mp.weixin.qq.com/s/dH6GatiY8AZE6or0oxxkew添加微信公众号,回复 “代码” 来获取源代码
更多推荐

 28
 0
- 0


 已为社区贡献2条内容

所有评论(0)