
面试必考!如何设计高可用RAG?掌握灾备、冗余、熔断,轻松拿下架构师Offer!
在当今AI工程化落地加速的背景下,RAG(Retrieval-Augmented Generation)系统已成为企业知识服务、智能客服和BI问答的核心基础设施。然而,高可用性(High Availability)是RAG落地过程中不可忽视的挑战。一个不可靠的向量检索服务或不稳定的模型推理接口,将直接导致用户体验下降甚至业务中断。
本文将围绕构建99.95%可用性的RAG系统,从向量库高可用、LLM服务冗余、熔断机制、备份策略与故障演练五个维度,系统性分享在云原生环境下的工程实践。内容面向SRE工程师、云原生架构师及AI基础设施开发者,兼顾技术深度与可操作性。
一、向量库高可用:从Standalone到Cluster的演进
向量库是RAG系统的“记忆中枢”。若其宕机或响应延迟,整个RAG链路将失效。以Milvus为例,Standalone模式虽部署简单,但存在单点故障风险,无法满足99.95%可用性要求(全年停机时间需小于4.38小时)。
解决方案是升级至Milvus Cluster模式,其架构天然支持高可用:
- 计算与存储分离:Query Node、Index Node、Data Node等组件可独立扩缩容;
- 元数据协调依赖ZooKeeper(或etcd):保障集群成员状态一致;
- 支持自动故障转移:当某Query Node宕机,协调器会将流量重分配至健康节点。
关键配置点包括:
- 使用Kubernetes StatefulSet部署Data Node,保障持久化数据有序;
- 为Root Coord、Query Coord等关键组件配置
replicas: 3,防止单点失效; - 启用读写分离:高频查询走Query Node,写入通过Data Node异步持久化。
通过Cluster模式,Milvus可在单节点故障时秒级切换,避免服务中断。
二、LLM服务冗余:多实例 + 负载均衡保障推理连续性
大语言模型(LLM)服务是RAG的“大脑”,但其推理过程计算密集、响应时间波动大。若仅部署单实例,一旦Pod重启或节点OOM,将导致服务雪崩。
多实例冗余 + 负载均衡是基础防线:
- 在K8s中通过Deployment部署LLM服务,设置
replicas: 3或更高; - 配置K8s Service(ClusterIP或NodePort)作为统一入口;
- 结合Ingress Controller(如Nginx Ingress)实现外部流量分发;
- 启用HPA(Horizontal Pod Autoscaler),基于CPU或QPS自动扩缩容。
示例Deployment配置片段:
apiVersion: apps/v1kind: Deploymentmeta name: llm-servicespec: replicas: 3 selector: matchLabels: app: llm template: meta labels: app: llm spec: containers: - name: llm-inference image: your-llm-image:v1 ports: - containerPort: 8080 resources: requests: cpu: "2" memory: "8Gi" limits: cpu: "4" memory: "16Gi"---apiVersion: autoscaling/v2kind: HorizontalPodAutoscalermeta name: llm-hpaspec: scaleTargetRef: apiVersion: apps/v1 kind: Deployment name: llm-service minReplicas: 3 maxReplicas: 10 metrics: - type: Resource resource: name: cpu target: type: Utilization averageUtilization: 70
该配置确保在流量高峰时自动扩容,低谷时缩容,兼顾稳定性与成本。
三、熔断机制:防止级联失败的最后一道防线
RAG系统中,向量库、LLM、知识源等多个服务相互依赖。若向量库响应变慢,LLM服务因等待超时而堆积请求,可能引发级联失败(Cascading Failure)。
此时需引入熔断机制(Circuit Breaker):
- 当错误率或延迟超过阈值,自动“熔断”依赖调用;
- 进入熔断状态后,直接返回fallback响应(如缓存结果或默认提示);
- 经过冷却期后尝试半开恢复,逐步试探服务是否可用。
在Go生态中,可使用Sentinel(阿里开源)或自研基于滑动窗口的熔断器。关键策略包括:
- 错误率阈值:如5秒内错误率>50%则熔断;
- 最小请求量:避免低流量时误判;
- 熔断时长:如30秒后尝试恢复。
注意:Hystrix虽经典,但已停止维护,不建议新项目使用。Sentinel或Resilience4j(Java)是更现代的选择。
四、备份与异地容灾:向量数据不能丢
向量数据是企业知识资产,不可再生。必须建立可靠的备份机制:
- 每日快照:Milvus支持通过MinIO/S3定期导出向量数据与元数据;
- 异地容灾:将快照同步至另一可用区或Region,如北京→上海;
- 版本快照:结合RAG更新机制,保留知识库迭代的历史版本,便于回滚。
建议自动化流程:
- 每日凌晨2点触发备份Job;
- 压缩后上传至对象存储;
- 校验MD5确保完整性;
- 保留最近7天快照,每月归档一次。
一旦主集群数据损坏,可从备份快速重建,RTO(恢复时间目标)。
五、故障演练:用Chaos Engineering验证高可用
“未经验证的高可用等于不可用”。必须通过混沌工程(Chaos Engineering)主动注入故障,验证系统韧性:
- 使用Chaos Mesh或LitmusChaos,在K8s中模拟:
- Pod随机Kill(模拟节点故障);
- 网络延迟/丢包(模拟跨AZ通信异常);
- CPU压力注入(验证HPA是否及时扩容)。
- 监控指标包括:
- P99延迟是否超过阈值;
- 错误率是否激增;
- 熔断器是否正常触发。
通过定期演练,可暴露隐藏的单点依赖或配置缺陷,将故障发现从“线上”前移到“预发”。
系统高可用架构全景图
下图展示了99.95%可用RAG系统的整体架构:
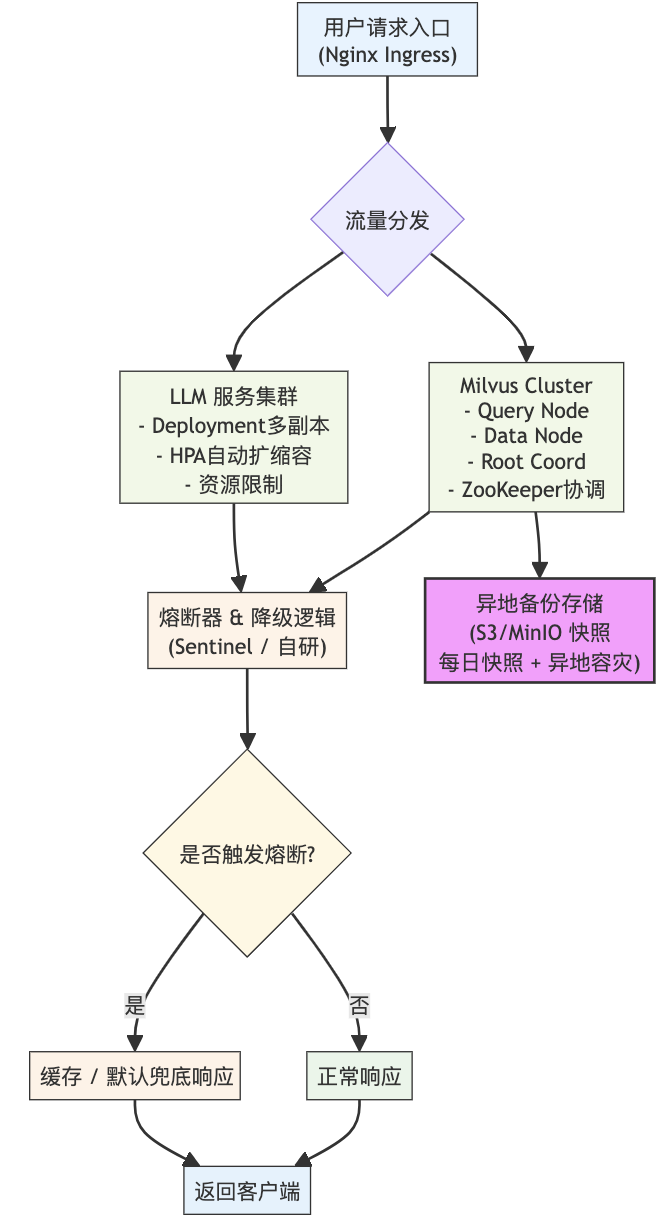
该架构实现了:
- 计算冗余:LLM与向量库均无单点;
- 故障隔离:熔断器阻断级联;
- 数据安全:每日快照+异地容灾;
- 弹性伸缩:HPA应对流量波动。
结语
构建99.95%可用的RAG系统,不是堆砌技术,而是系统性工程:从基础设施(K8s)、中间件(Milvus)、到服务治理(熔断、降级)、再到运维保障(备份、演练),每一环都需精心设计。
高可用的背后,是对故障的敬畏与韧性的追求。希望本文能为正在搭建AI基础设施的你,提供一份可落地的参考蓝图。
如何高效转型Al大模型领域?
作为一名在一线互联网行业奋斗多年的老兵,我深知持续学习和进步的重要性,尤其是在复杂且深入的Al大模型开发领域。为什么精准学习如此关键?
- 系统的技术路线图:帮助你从入门到精通,明确所需掌握的知识点。
- 高效有序的学习路径:避免无效学习,节省时间,提升效率。
- 完整的知识体系:建立系统的知识框架,为职业发展打下坚实基础。
AI大模型从业者的核心竞争力
- 持续学习能力:Al技术日新月异,保持学习是关键。
- 跨领域思维:Al大模型需要结合业务场景,具备跨领域思考能力的从业者更受欢迎。
- 解决问题的能力:AI大模型的应用需要解决实际问题,你的编程经验将大放异彩。
以前总有人问我说:老师能不能帮我预测预测将来的风口在哪里?
现在没什么可说了,一定是Al;我们国家已经提出来:算力即国力!
未来已来,大模型在未来必然走向人类的生活中,无论你是前端,后端还是数据分析,都可以在这个领域上来,我还是那句话,在大语言AI模型时代,只要你有想法,你就有结果!只要你愿意去学习,你就能卷动的过别人!
现在,你需要的只是一份清晰的转型计划和一群志同道合的伙伴。作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。

第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。
如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

更多推荐



 4
 0
- 0


 已为社区贡献4条内容

所有评论(0)