
Java数据结构:优先级队列(堆)——PriorityQueue
队列是一种先进先出(FIFO)的数据结构,但有些情况下,操作的数据可能带有优先级,一般出队 列时,可能需要优先级高的元素先出队列,在该中场景下,使用队列显然不合适。数据结构应该提供两个最基本的操作,一个是返回最高优先级对象,一个是添加新的对象。这种数据结构就是优先级队列(Priority Queue)。
1.优先级队列的模拟实现
PriorityQueue底层使用了堆这种数据结构,而堆实际就是在完全二叉树的基础上进行了一些调整。
因此,想要模拟实现优先级队列,那么需要先学习什么是堆。
堆的性质
- 堆中某个节点的值总是不大于或不小于其父节点的值
- 堆总是一棵完全二叉树
如果有一个关键码的集合K = {k0,k1, k2,…,kn-1},把它的所有元素按完全二叉树的顺序存储方式存储在一 个一维数组中,并满足:Ki <= K2i+1且 Ki <= K2i+2 (Ki >= K2i+1 且 Ki >= K2i+2)
i = 0,1,2…,则称为 小堆(或大堆)。将根节点最大的堆叫做最大堆或大根堆,根节点最小的堆叫做最小堆或小根堆。
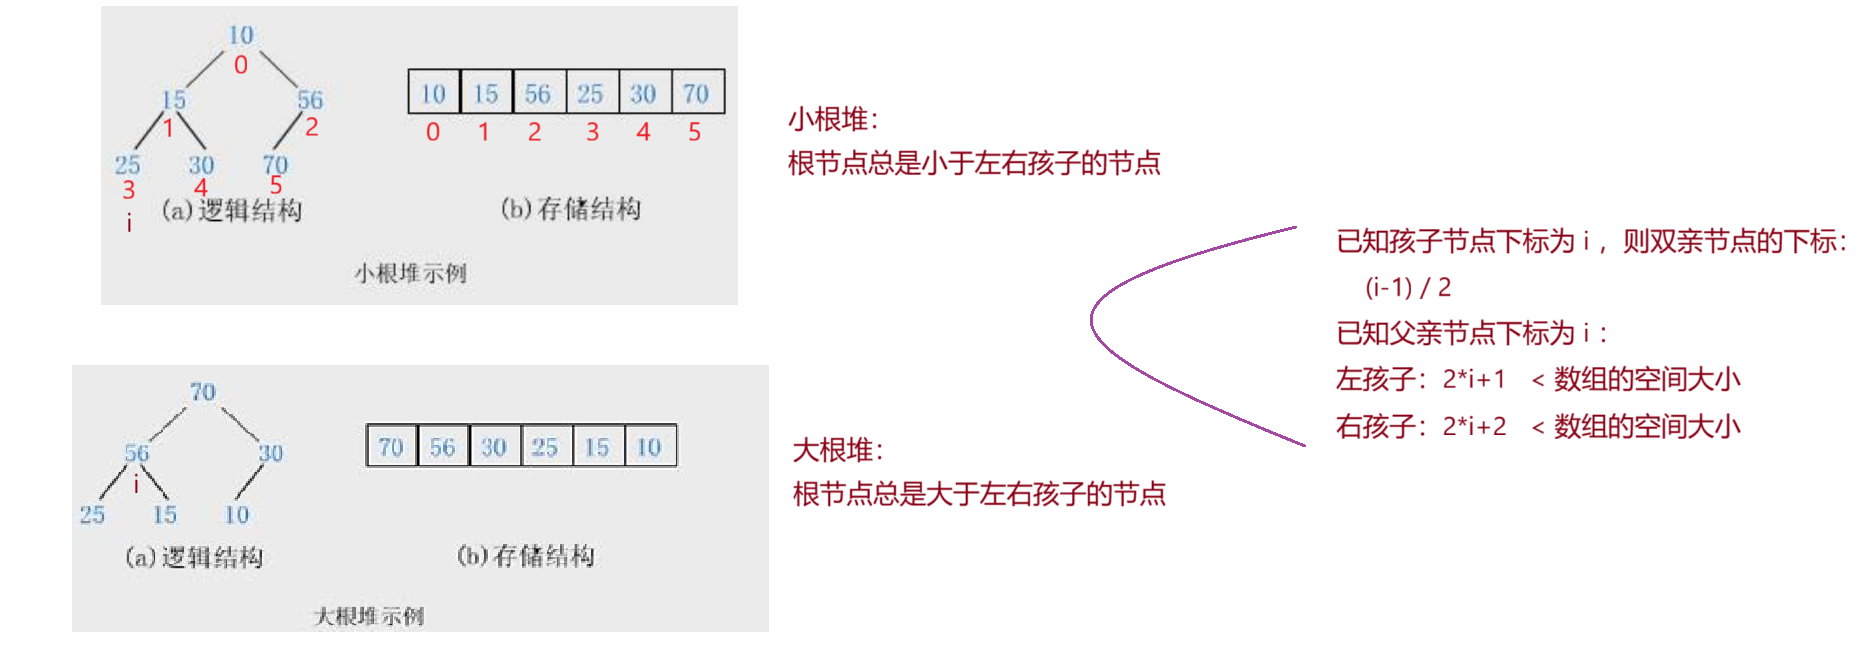
堆的存储方式
从堆的概念可知,堆是一棵完全二叉树,因此可以层序的规则采用顺序的方式来高效存储,
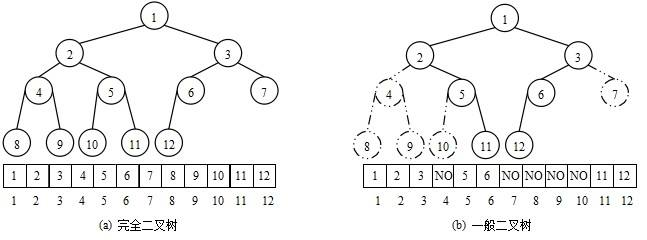
注意:对于非完全二叉树,则不适合使用顺序方式进行存储,因为为了能够还原二叉树,空间中必须要存储空节点,就会导致空间利用率比较低。
将元素存储到数组中后,假设i为节点在数组中的下标,则有:
- 如果 i 为0,则 i 表示的节点为根节点,否则i节点的双亲节点为 (i - 1)/2
- 如果2 * i + 1 小于节点个数,则节点 i 的左孩子下标为2 * i + 1,否则没有左孩子
- 如果2 * i + 2 小于节点个数,则节点 i 的右孩子下标为2 * i + 2,否则没有右孩子
堆的创建
向下调整
对于集合{ 27,15,19,18,28,34,65,49,25,37 }中的数据,如果将其创建成堆呢?
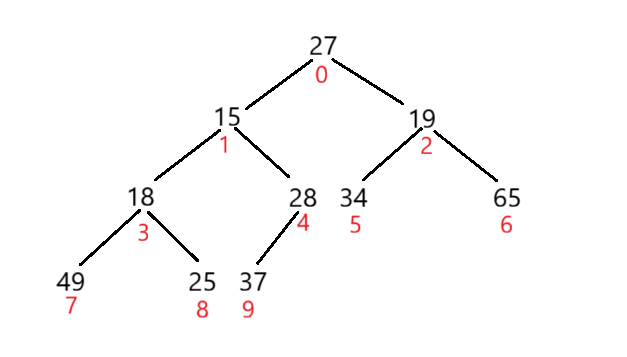
我们以创建大根堆为例,就是要保持每个根节点的值都比它的左右孩子节点的值大,那么将上图中的堆/完全二叉树 调整成大根堆的结构,采用 向下调整 的方法,所谓向下调整就是将整个无序数组视为一个完全二叉树,从最后一个非叶子节点开始(即最后一棵子树开始),向前遍历并对每个节点执行向下调整(最后一个非叶子节点开始,从右到左);从当前节点向下与子节点比较并交换。
如下图,就是采用 向下调整 思路来 创建大根堆 的思路图:

堆的创建(大根堆为例)
根据上图,我们可以得出,创建堆(大根堆为例)的代码思路:
- 在createHeap方法中,使用for循环调整堆,先确定最后一个非叶子节点parent双亲节点的位置,该位置为起始位置,在parent大于等于根节点下标(0)时,即parent合法时,从当前节点parent向下与其左右子节点child比较并交换:
- 在siftDown方法中(向下调整方法),先确定parent的左孩子child的下标位置,在左孩子存在的情况下(child<usedSize),进入循环,如果parent的右孩子存在(child+1<usedSize),将左右孩子进行比较,找到两者之间较大的,如果左孩子大,则child下标位置不变(原先就是确定的左孩子的位置),如果右孩子大,则child++,走到右孩子的位置,此时的child标记的就是最大孩子的下标。接着比较parent和child,如果elem[child]>elem[parent],即需要将parent与较大的child交换(使用临时变量tmp辅助交换),交换完成之后parent往下移动,即走到此时较大的child位置,然后继续确定此时新的parent的左孩子的下标位置(注意,parent中小的元素往下移动,可能会造成子树不满足大根堆的性质,因此需要继续向下调整);如果elem[child]<elem[parent],即parent比最大的child还大,说明该结构已经满足大根堆的性质,直接break跳出循环。
- 再次回到createHeap方法中,parent--,走到倒数第二个非叶子节点处,再次开始让当前parent与左右孩子child比较,即进入siftDown方法中。
//创建堆
public void createHeap() {
    //找倒数第一个非叶子节点,从该节点位置开始往前一直到根节点,遇到一个节点,应用向下调整方法
    for(int parent = (usedSize-1-1)/2; parent >= 0; parent--) {
        siftDown(parent,usedSize);
    }
}

//向下调整方法
//parent 表示每棵子树调整的时候的起始位置
//usedSize 表示判断每棵子树什么时候调整结束(usedSize为数组/堆的长度,如果超出长度,则代表调整结束)
private void siftDown(int parent,int usedSize) {
    //确定左孩子位置
    int child = 2*parent+1;

    //找到左右孩子中的最大值
    while(child < usedSize) {
        if(child+1 < usedSize && elem[child] < elem[child]) {
            child++;//如果右孩子存在并且比左孩子大,那么child++走到右孩子的位置
        }
        if(elem[child] > elem[parent]) {
            //将双亲与较大的孩子交换
            swap(elem,child,parent);
            //parent中小的元素往下移动,可能会造成子树不满足堆的性质,因此需要继续向下调整
            parent = child;
            child = 2*parent+1;
        }else {
            //如果双亲比其最大的孩子还大,说明该结构已经满足堆的特性了,跳出循环
            break;
        }
    }
}

//交换位置
public void swap(int[] elem,int i,int j) {
    int tmp = elem[i];
    elem[i] = elem[j];
    elem[j] = tmp;
}注意:在调整以parent为根的二叉树时,必须要满足parent的左子树和右子树已经是堆了才可以向下调整。向下调整时间复杂度分析:最坏的情况如下图所示,从根一路比较到叶子,比较的次数为完全二叉树的高度,即时间复杂度为。

建堆的时间复杂度
因为堆是完全二叉树,而满二叉树也是完全二叉树,此处为了简化使用满二叉树来证明(时间复杂度本来看的就是 近似值,多几个节点不影响最终结果):
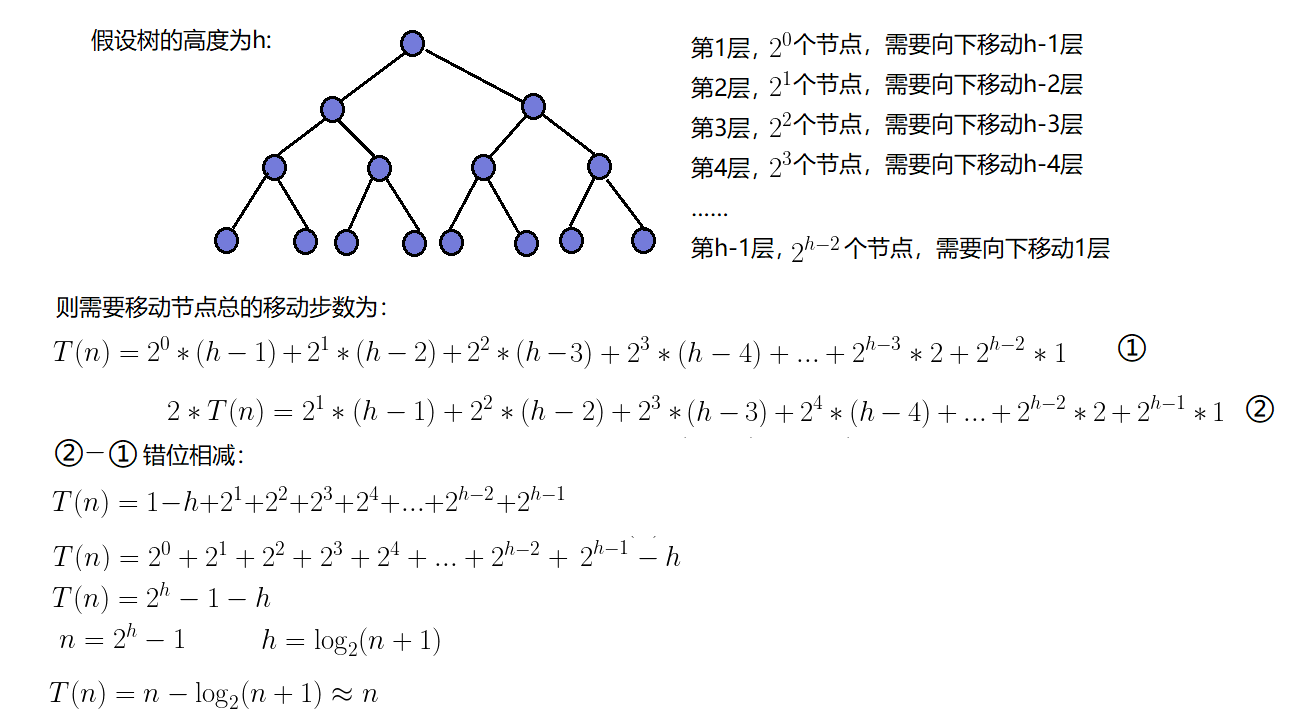
因此:建堆的时间复杂度为O(N)。
堆的插入和删除
堆的插入
堆的插入总共需要两个步骤:
- 1.先将元素插入到堆的末尾,即最后一个孩子的后面(空间不够时需要扩容)
- 2.将最后新插入的节点向上调整,直到满足堆的性质
注意:这里插入新节点后,要用的是 向上调整 的方法来将该节点顺着其双亲节点往上调整到合适的位置。
向上调整
所谓向上调整就是从空堆开始,逐个插入元素。每插入一个,就对该元素执行向上调整(第一个元素开始,从左到右);从新插入的叶子节点向上与父节点比较并交换。
以集合{ 27,15,19,18,28,34,65,49,25,37 }为例,如下图,就是采用 向下调整 思路来进行堆的插入思路图(以大根堆调整为例):

堆的插入(大根堆调整)
根据上图,我们可以得出,堆的插入(大根堆调整为例)的代码思路:
- 在offer方法中,先判断堆是否已满,如果满了,则需要扩容;往堆的末尾usedSize处插入新节点,即插入新孩子节点child,
- 进入siftUp方法(向上调整方法):在该方法中,首先确定child的双亲节点parent,在child合法的情况下,即child大于根节点下标(0)时(child=0时已是根节点,无需再调整),进入循环,如果elem[child]>elem[parent],则两者进行交换,交换完成之后,child走到parent的位置,然后确定新的parent的下标位置(交换完成之后,大的元素向上走,小的元素向下移动,可能会造成子树不满足堆的性质,因此需要继续向上调整),如果elem[child]<elem[parent],即parent比child大,parent满足堆的性质,调整结束,跳出循环。
- 回到offer方法中,此时的新child插入并向上调整结束,usedSize++。
//堆的插入
public void offer(int val) {
    if(isFull()) {
        elem = Arrays.copyOf(elem,2*elem.length);
    }
    elem[usedSize] = val;
    siftUp(usedSize);
    usedSize++;
}

//判满
public boolean isFull() {
    return usedSize == elem.length;
}

//向上调整方法
public void siftUp(int child) {
    //确定child新节点的双亲节点的下标位置
    int parent = (child-1)/2;
    while(child > 0) {
        if(elem[child] > elem[parent]) {
            //如果child大于parent,将两者进行交换
            swap(elem,child,parent);
            //交换完成之后,大的元素向上走,小的元素向下移动,可能会造成子树不满足堆的性质,因此需要继续向上调整
            child = parent;
            parent = (child-1)/2;
        }else {
            //如果child<parent,parent满足堆的性质(是大堆或者是小堆),调整结束
            break;
        }
    }
}
堆的删除
注意:堆的删除一定删除的是堆顶元素,即完全二叉树的根节点/数组中的第一个元素。堆的删除采用的是向下调整的方法。
具体做法:
- 1.将堆顶元素与堆中最后一个元素进行交换
- 2.删除堆中最后一个元素(将堆中有效元素个数减少一个即可表示删除)
- 3.将堆顶元素进行向下调整直到满足堆的特性为止
如下图,是删除堆顶元素的思路图(大根堆向下调整):
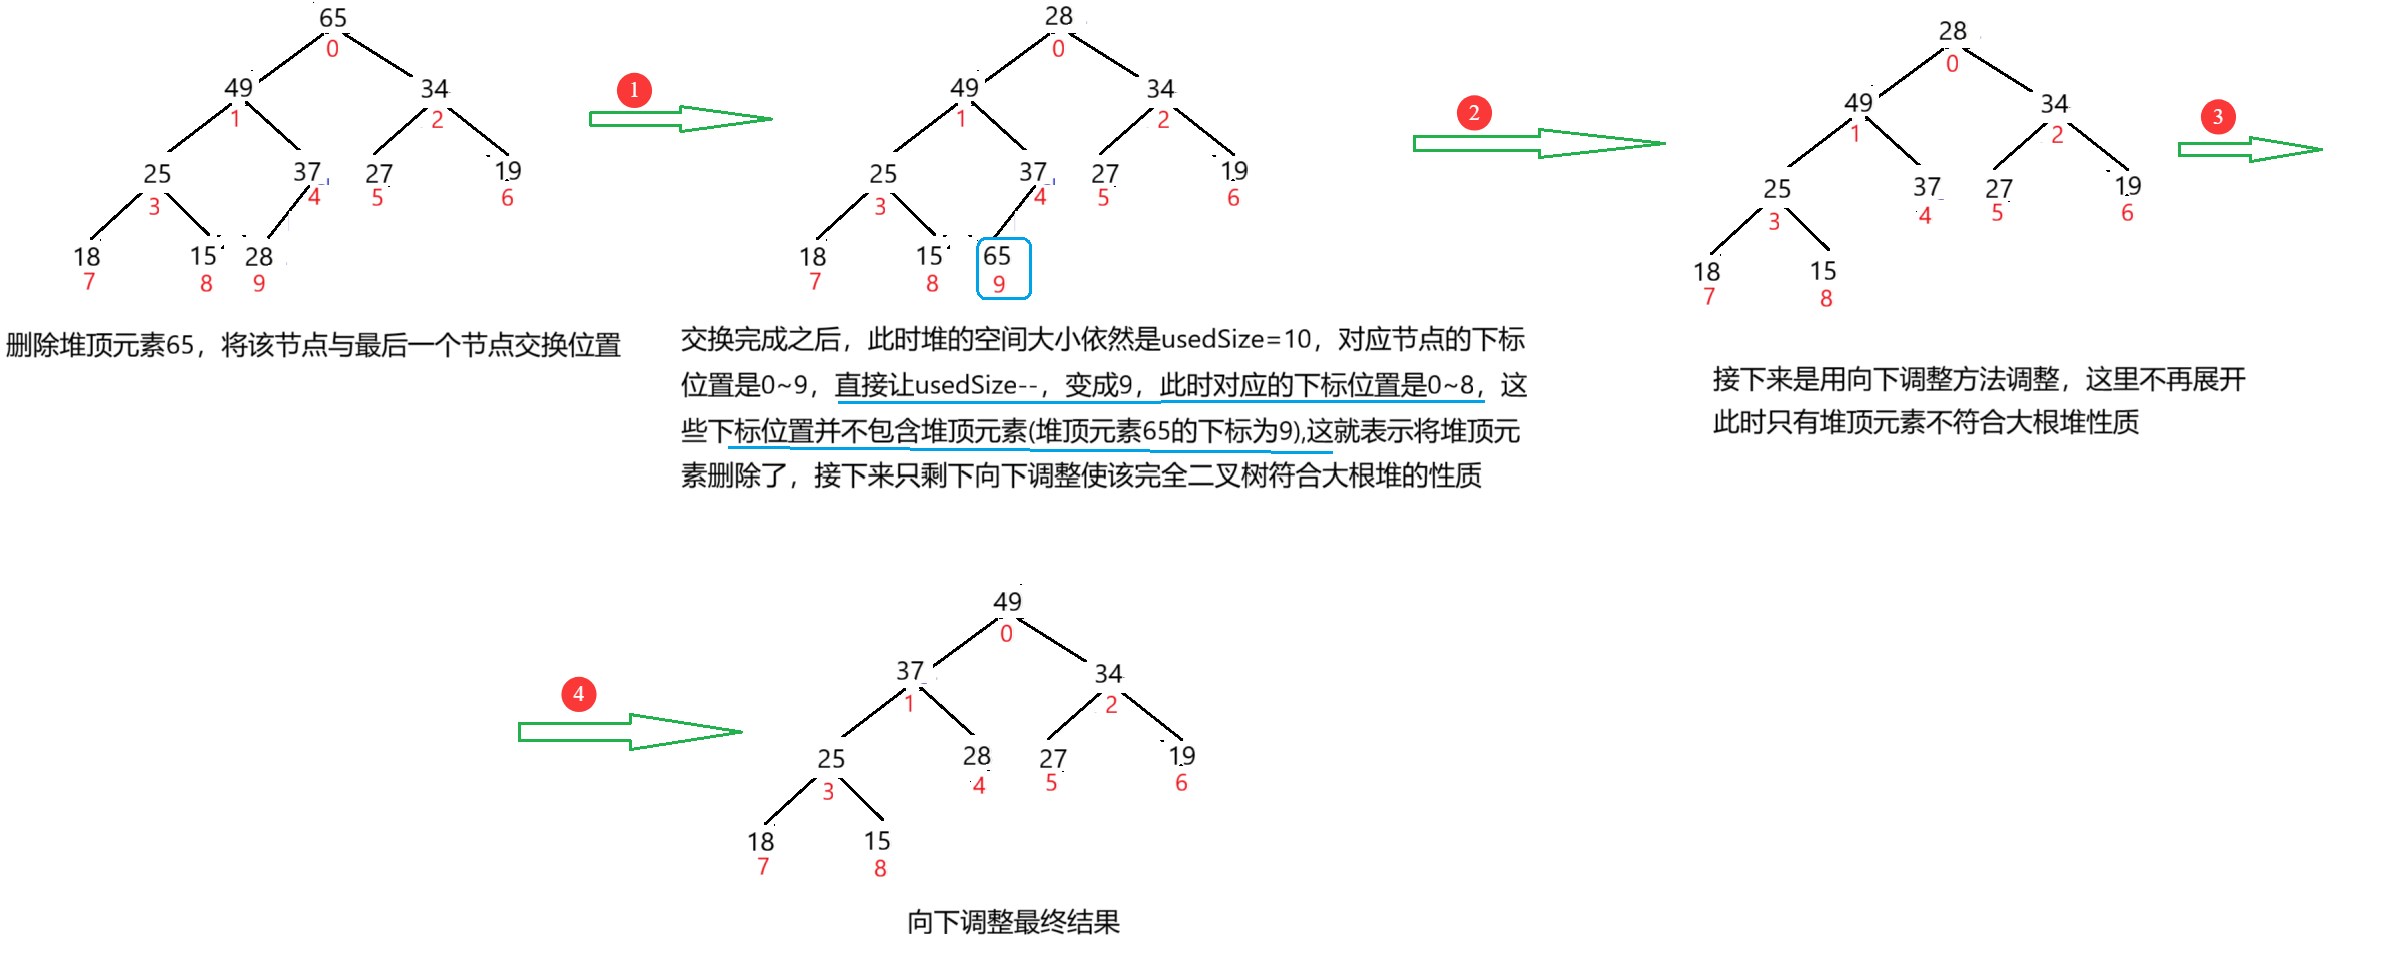
堆的删除(大根堆调整)
根据上图,我们可以得出,堆的删除(大根堆调整为例)的代码思路:
首先对堆进行判空,如果为空,返回-1;否则执行删除堆顶元素操作:使用变量val先将堆顶元素elem[0]保存起来,然后将堆顶元素与堆中最后一个元素交换位置,让usedSize--,此时表示删除堆顶元素成功。接下来最后一步就是对堆进行向下调整siftDown,由于前面的交换,只有此时的堆顶元素不符合大根堆的性质,因此,应该从堆顶元素开始向下调整,直到符合大根堆的性质。最后返回一下堆顶元素val。
//堆的删除
public int poll() {
    if(isEmpty()) {
        return -1;//空堆处理
    }
    int val = elem[0];//保存堆顶元素
    swap(elem,0,usedSize-1);//堆顶与最后一个元素交换
    usedSize--;//堆大小减1
    siftDown(0,usedSize);//从堆顶开始向下调整

    return val;//返回删除的元素
}

//判空
public boolean isEmpty() {
    return usedSize == 0;
}
向上调整建堆和向下调整建堆的区别
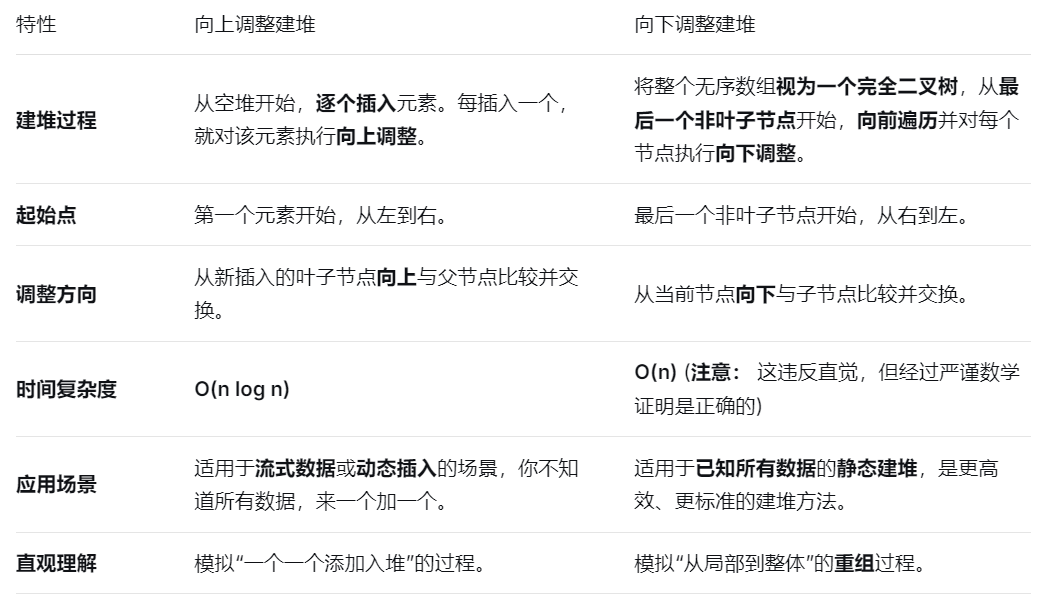
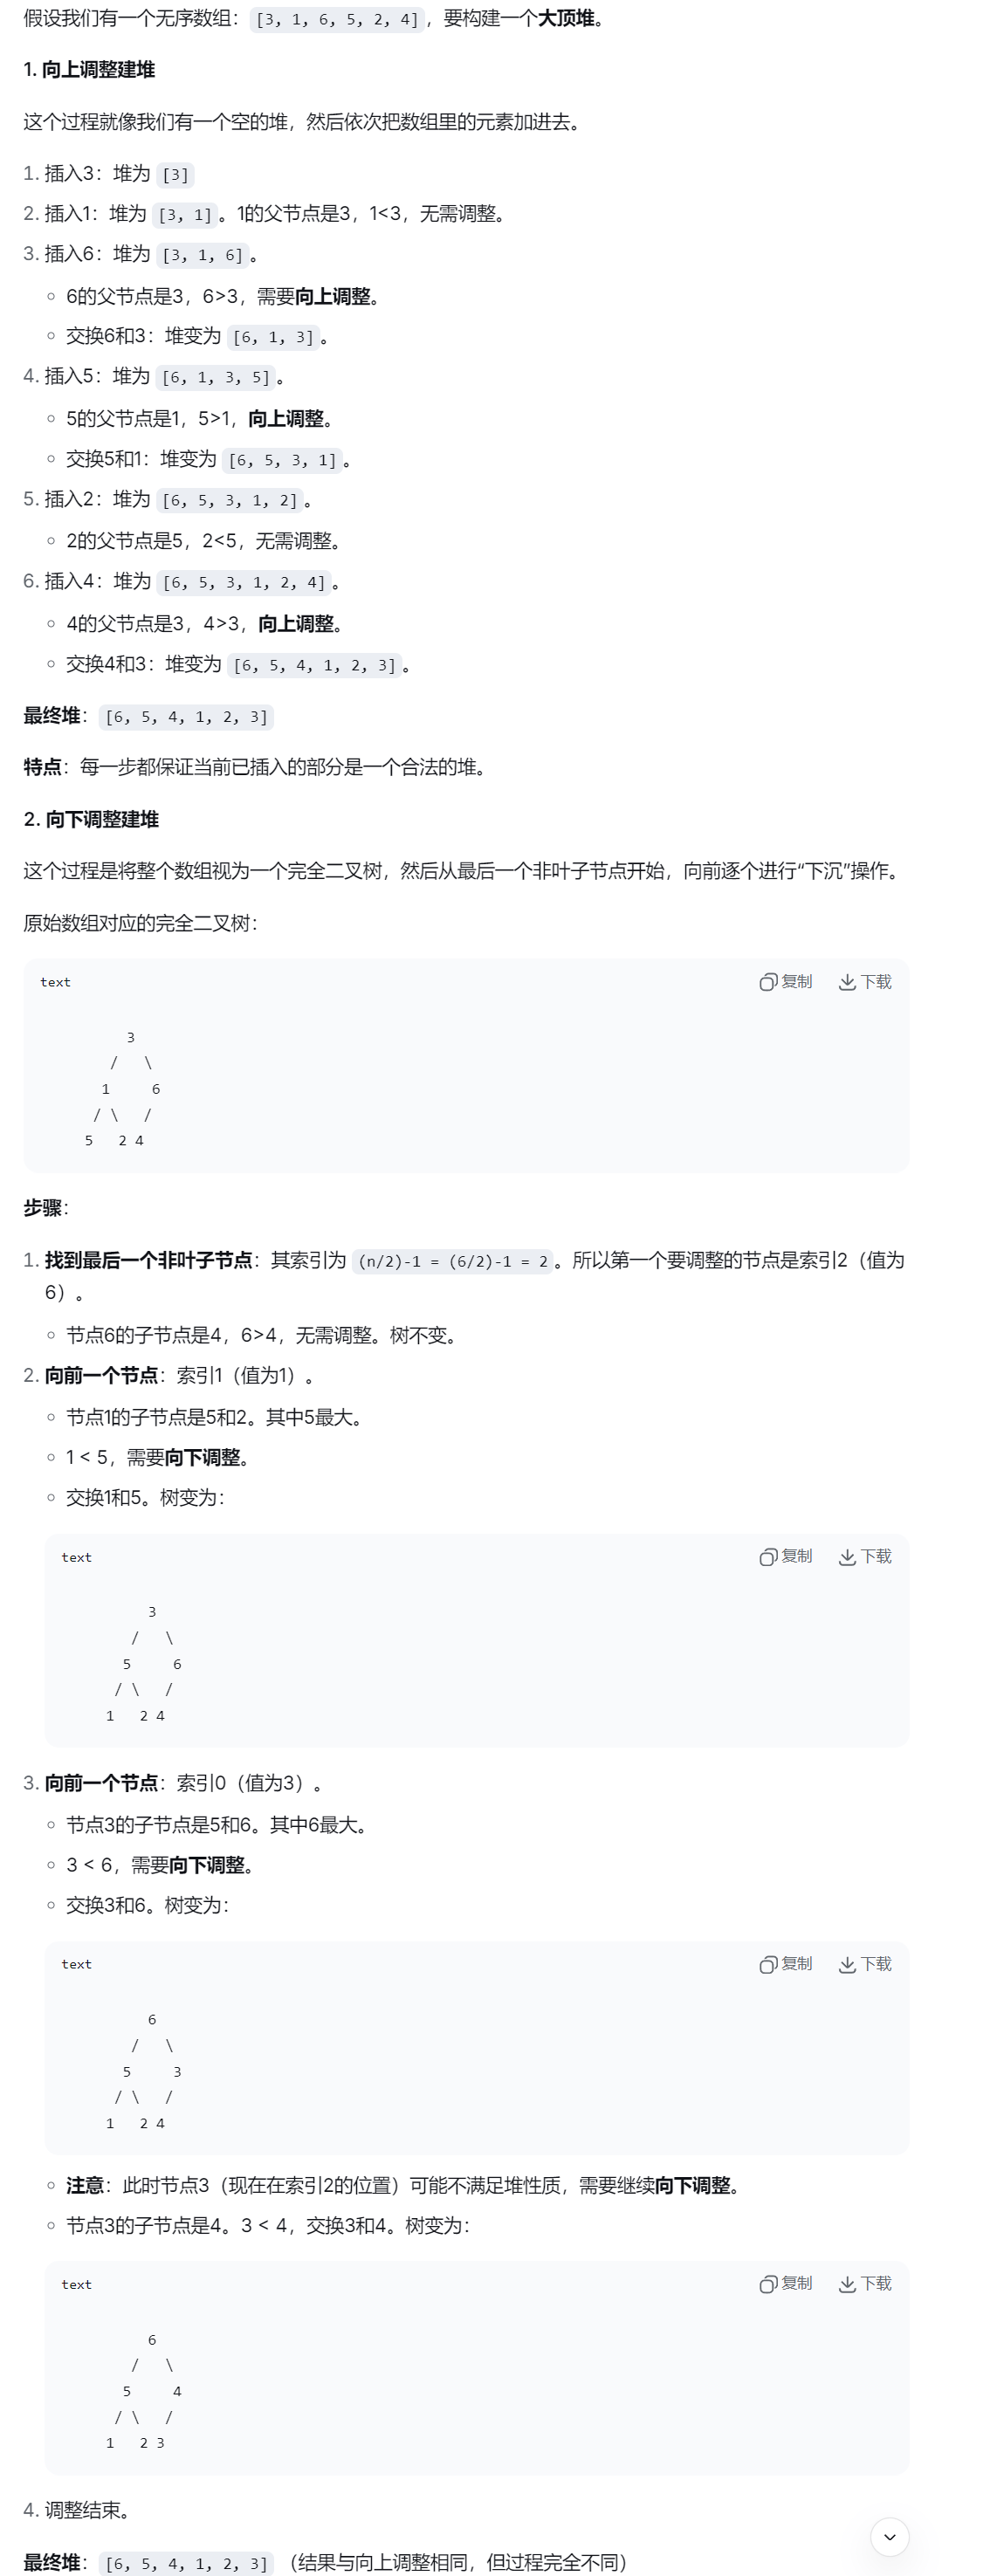
##用堆模拟实现优先级队列
堆是一棵完全二叉树,以层序的规则采用顺序的方式来高效存储,也就是说可以用数组进行存储。
思路:创建PriorityQueueByHeap类,表示一个优先级队列,在该类中,定义一个数组elem,存储堆的元素,定义一个变量usedSize,实时记录堆的大小。写一个构造方法,用来指定elem的空间大小(假设初始时大小为10),写一个initElem方法,表示用来初始化elem。接下来就是使用堆来模拟实现优先级队列中的插入、删除等方法。
public class PriorityQueueByHeap {
    public int[] elem;
    public int usedSize;

    public PriorityQueueByHeap() {
        thiselem = new int[10];
    }

    public void initElem(int[] array) {
        for(int i = 0; i < array.length; i++) {
            this.elem[i] = array[i];
            usedSize++;
        }
    }

    //交换位置
    private void swap(int[] elem,int i,int j) {
        int tmp = elem[i];
        elem[i] = elem[j];
        elem[j] = tmp;
    }

    //向下调整
    private void siftDown(int parent,int usedSize) {
        int child = 2*parent+1;
        while(child < usedSize) {
            if(child+1 < usedSize && elem[child] < elem[child+1]) {
                child++;
            }
            if(elem[child] > elem[parent]) {
                swap(elem,child,parent);
                parent = child;
                child = 2*parent+1;
            }else {
                break;
            }
        }
    }

    //向上调整
    private void siftUp(int child) {
        int parent = (child-1)/2;
        while(child > 0) {
            if(elem[child] > elem[parent]) {
                swap(elem,child,parent);
                child = parent;
                parent = (child-1)/2;
            }else {
                break;
            }
        }
    }

    //堆的插入
    public void offer(int val) {
        if(isFull) {
            elem = Arrays.copyOf(elem,2*elem.length);
        }
        elem[usedSize] = val;
        siftUp(usedSize);
        usedSize++;
    }

    //判满
    public boolean isFull() {
        return usedSize == elem.length;
    }

    //堆的删除(删除堆顶元素)
    public int poll() {
        if(ifEmpty()) {
            return -1;
        }
        int val = elem[0];
        swap(elem,0,usedSize-1);
        usedSize--;
        siftDown(0,usedSize);

        return val;
    }

    //判空
    public boolean isEmpty() {
        return usedSize == 0;
    }

    //获取堆顶元素
    public int peek() {
        if (isEmpty()) {
            return -1;
        }
        return elem[0];
    }

    //获取堆的大小
    public int size() {
        return usedSize;
    }
}
堆排序
堆排序即利用堆的思想来进行排序,总共分为两个步骤:
- 1.建堆:如果想将堆变成升序排序-建大堆、想将堆变成降序排序-建小堆
- 2.利用堆删除的思想进行排序:建堆和堆删除中都用到了向下调整,因此掌握了向下调整,就可以完成堆排序。
思路(以大根堆为例):建立完大根堆后,将堆顶元素与堆中最后一个元素end交换位置,然后从此时的堆顶元素开始向下调整,直到重新符合堆的性质,接着让end--,走到堆中倒数第二个元素的位置end,再让重新调整好后的堆顶元素与此时的end交换位置,然后从此时的堆顶元素开始向下调整,直到重新符合堆的性质;重复上述的操作,直到end走到根节点的位置(0),停止,说明堆已经调整完成,此时的堆是一个升序排序的堆。
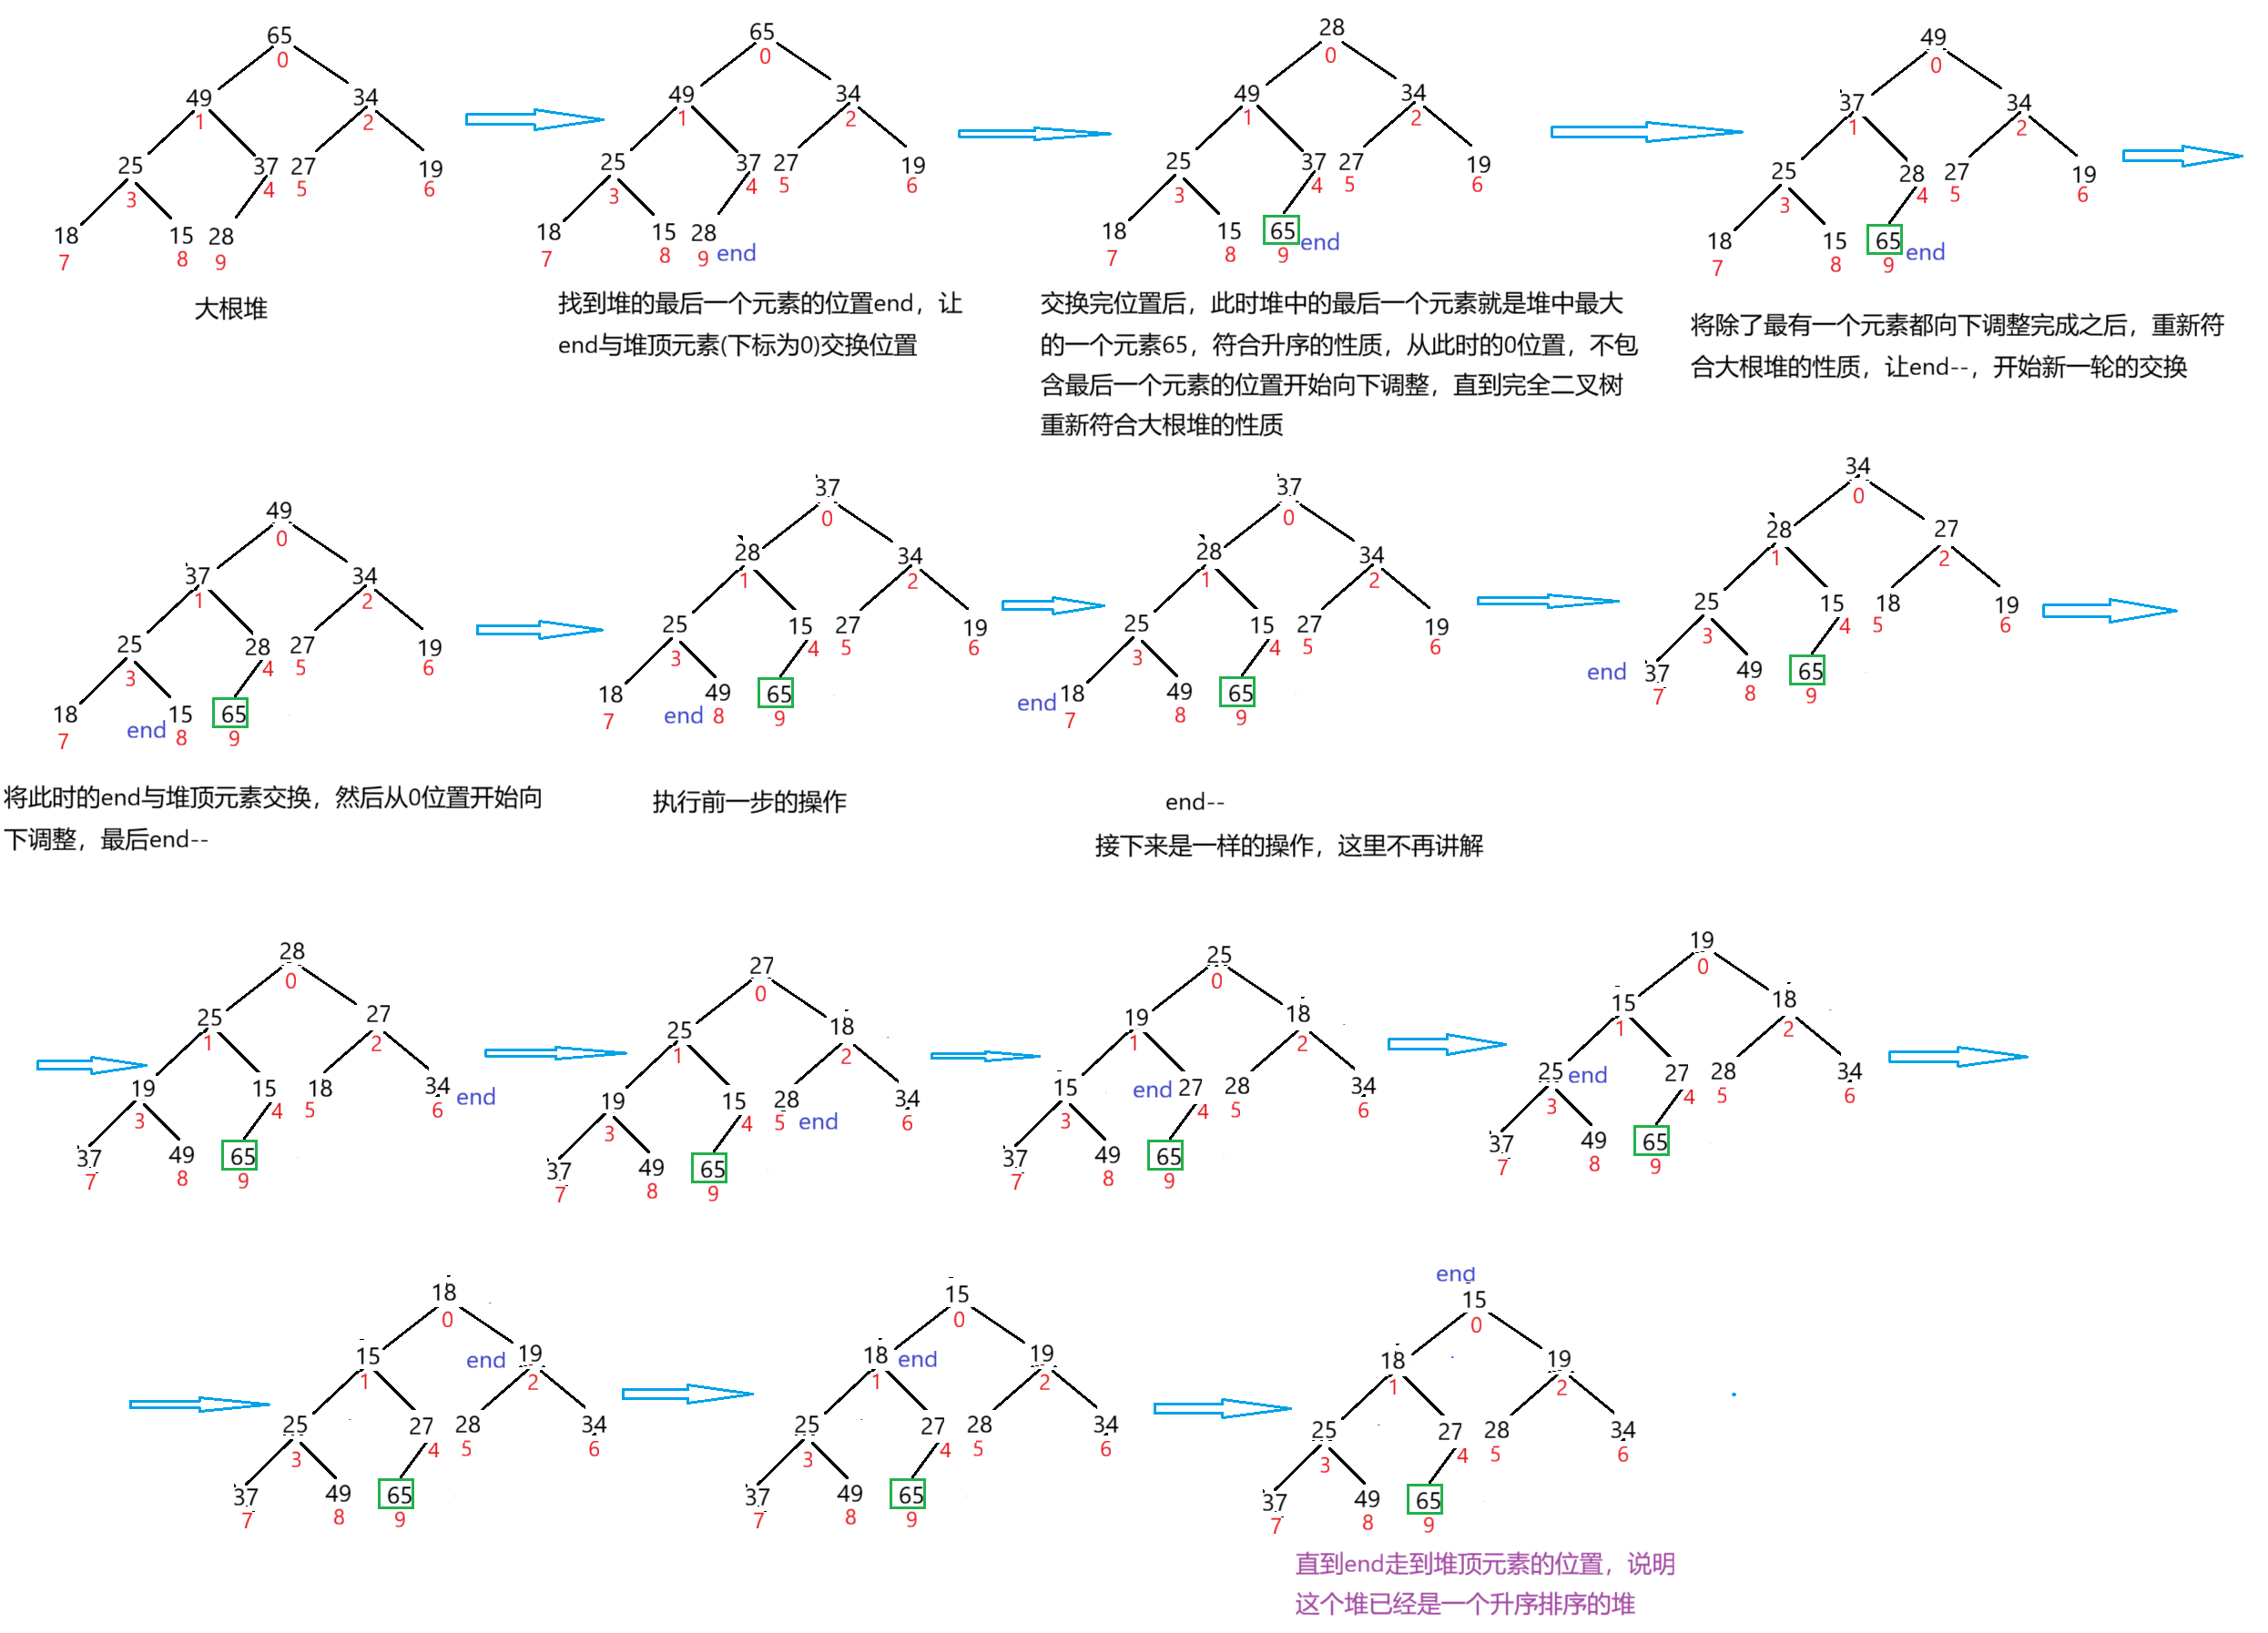
public void HeapSort() {
    int end = usedSize-1;
    while(end > 0) {
        swap(elem,0,end);
        siftDown(0,end);
        end--;
    }
}
2.PriorityQueue介绍
前面我们学习完优先级队列用堆的模拟实现,现在正式学习Java中的优先级队列。
Java集合框架中提供了PriorityQueue和PriorityBlockingQueue两种类型的优先级队列,PriorityQueue是线 程不安全的,PriorityBlockingQueue是线程安全的,本文主要介绍PriorityQueue。
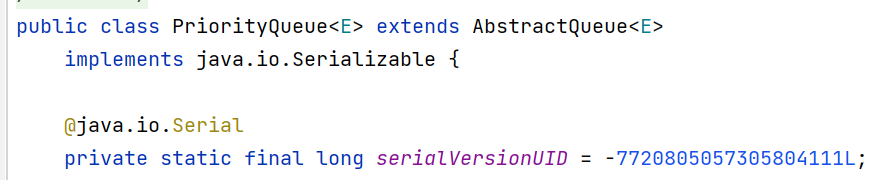
看一看PriorityQueue的源码,可以知道它是一个泛型类:
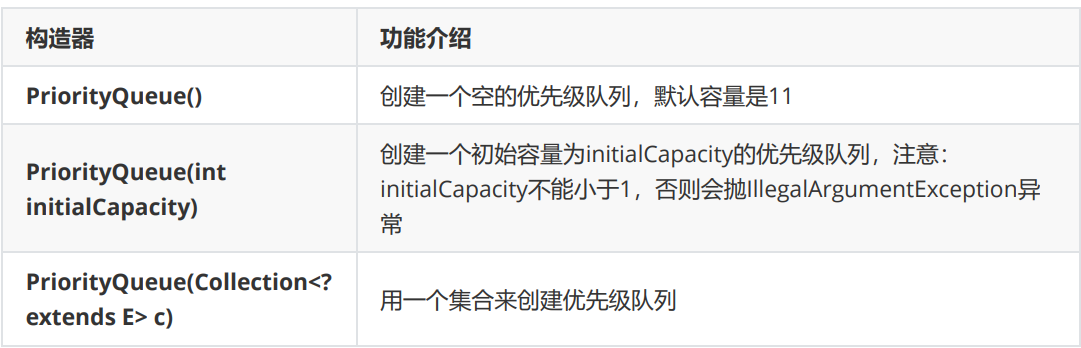
PriorityQueue的构造方法
此处只是列出了PriorityQueue中常见的几种构造方式
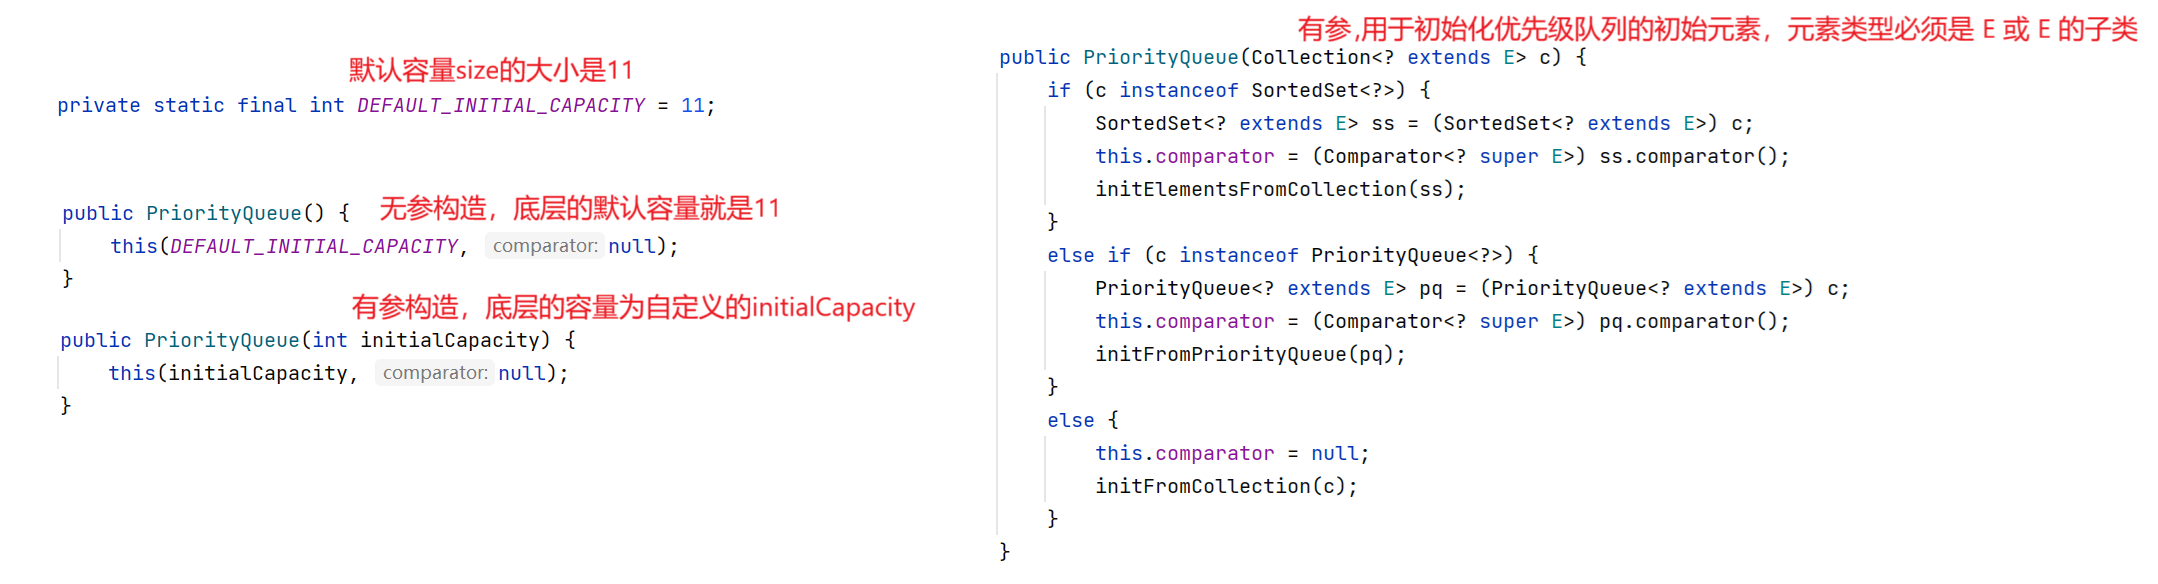
看看这些构造方法的源码:
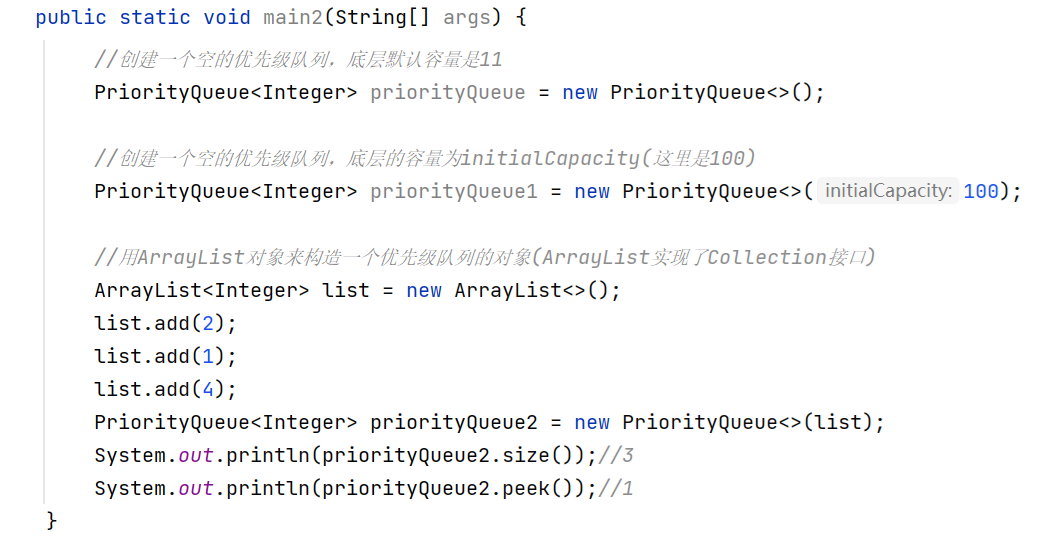
PriorityQueue中的方法:插入/删除/获取优先级最高的元素
| 方法名 | 功能介绍 |
| boolean offer(E e) | 插入元素e,插入成功返回true,如果e对象为空,抛出NullPointerException异常,时间复杂度 |
| E peek() | 获取优先级最高的元素,如果优先级队列为空,返回null |
| E poll() | 移除优先级最高的元素并返回,如果优先级队列为空,返回null |
| int size() | 获取有效元素的个数 |
| void clear() | 清空 |
| boolean isEmpty() | 检测优先级队列是否为空,空返回true |
PriorityQueue的使用要注意:
- 1. 使用时必须导入PriorityQueue所在的包,即:
import java.util.PriorityQueue;
- 2. PriorityQueue中放置的元素必须要能够比较大小,不能插入无法比较大小的对象,否则会抛出 ClassCastException异常
因为优先级队列中的元素是要比较大小的,也就是说它的元素的类型必须是实现Comparable接口或者 在创建优先级队列时提供Comparator接口的一个实例化对象,否则会有异常。
(Comparable接口中有CompareTo抽象方法,定义自然/默认排序-从小到大;而Comparator接口中有compare抽象方法,用于自定义排序。关于这两个接口的更多细节请看:
https://blog.csdn.net/Zzzzmo_/article/details/150931694?spm=1001.2014.3001.5502)
- 3. 不能插入null对象,否则会抛出NullPointerException
priorityQueue.offer(null); //错误❌
- 4. 没有容量限制,可以插入任意多个元素,其内部可以自动扩容
- 5. 插入和删除元素的时间复杂度为
- 6. PriorityQueue底层使用了堆数据结构
- 7. PriorityQueue默认情况下是小堆---即每次获取到的元素都是最小的元素
实例化一个PriorityQueue对象,向队列中插入元素,获取一下堆顶元素,确实获取的是最小的元素,因此,PriorityQueue在Java中默认是一个小根堆。
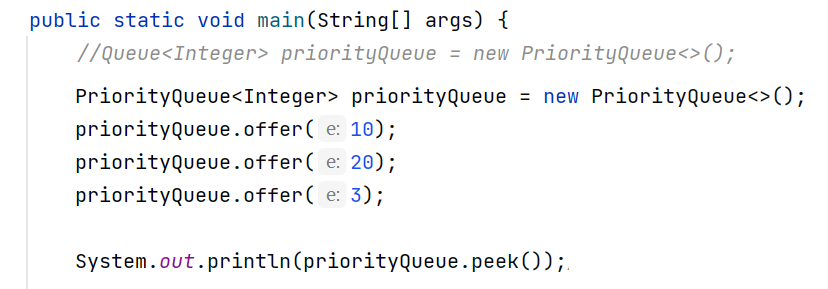
运行结果:
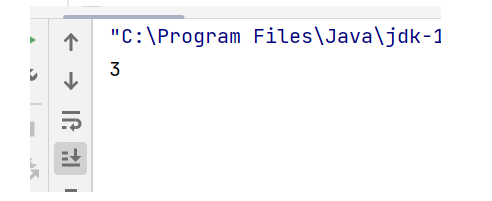
PriorityQueue变成大根堆方法
我们知道优先级队列默认是一个小根堆,我们先看看PriorityQueue中的默认构造方法(无参数):
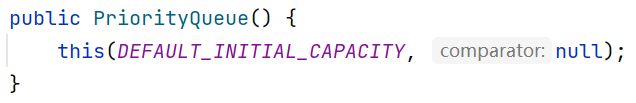
该构造方法还调用了另一个构造方法:可以看到默认构造方法中指定了默认容量11,而另一个参数则是一个null,看一下它调用的构造方法的源码:这个构造方法自定义了容量并且指定了使用Comparator这个比较器比较元素大小。
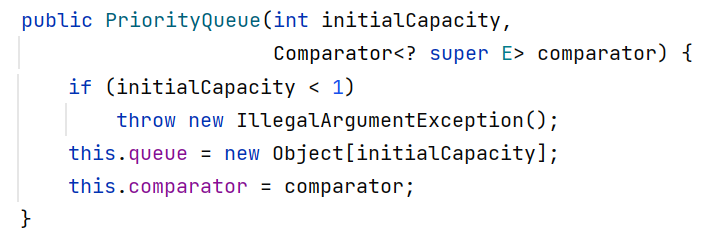
默认构造方法中指定了PriorityQueue的默认容量为11,而另一个参数为null,则说明默认构造方法不使用Comparator接口比较元素,而前面我们说过PriorityQueue的元素必须实现Comparable接口或者 在创建队列时提供一个Comparator接口的实例化对象引用,既然不是使用Comparator比较,那么默认构造方法(无参数构造)就是使用Comparable接口比较元素的,即使用自然排序,就是从小到大排序,因此PriorityQueue在Java中默认是小根堆。
//默认构造方法/无参构造方法 - 默认使用Comparable接口(自然排序)比较元素
PriorityQueue<E> priorityQueue = new PriorityQueue<>();
我们再看另一个构造方法,这个构造方法同样也调用了和默认构造的同一个方法,只不过以下的这个构造方法指定了使用Comparator接口比较元素:
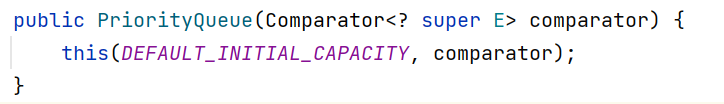
这个构造方法的作用是:创建一个使用指定比较器(Comparator)的优先级队列,使用默认的初始容量(11)。也就是说,如果想要将PriorityQueue变成一个大根堆,那么需要创建一个实现了Comparator接口的类,然后让该类去重写compare抽象方法,然后实例化一下该类的对象,将这个对象作为参数传递给PriorityQueue的构造方法。
//通过给构造方法传入一个实现Comparator接口的类的引用对象,实现指定Comparator比较元素 - 自定义排序
PriorityQueue<E> priorityQueue = new PriorityQueue<>(new 实现Comparator的类类名);
总结
PriorityQueue的默认构造方法创建一个使用自然排序(Comparable)的小根堆。当比较器参数为null时,队列要求元素必须实现Comparable接口。如果想要创建大根堆或其他自定义排序的队列,可以通过传入Comparator对象来实现,而不需要元素实现Comparable接口。
——————————————————————————————————————————
以Integer类(E 为 Integer)为例,Integer类实现了Comparable接口,重写了compareTo方法,其中定义了自然顺序(从小到大),不可改变,通过创建一个实现了Comparator(用于自定义排序规则)接口的类,来反转Integer的自然排序顺序,从而达到大根堆的效果。
(因为自然顺序是o1.compareTo(o2),即从小到大,在compare方法中,使用o2.compareTo(o1),这相当于反转了自然顺序。)
class BigHeap implements Comparator<Integer> {
    @Override
    public int compare(Integer o1,Integer o2) {
        return o2.compareTo(o1);
    }
}
public class Test {
    public static void main(String[] args) {
        //Comparator接口比较 - 大根堆
        PriorityQueue<Integer> priroityQueue = new PriorityQueue<>(new BigHeap());
        priorityQueue.offer(11);
        priorityQueue.offer(12);

        System.out.println(priorityQueue.peek());//12
    }

    public static void main1(String[] args) {
        //Comparable接口比较 - 小根堆
        PriorityQueue<Integer> priroityQueue = new PriorityQueue<>();
        priorityQueue.offer(11);
        priorityQueue.offer(12);

        System.out.println(priorityQueue.peek());//11
    }
}
3.Top-K问题
TOP-K问题:即求数据集合中前K个最大的元素或者最小的元素(求数据中第K大/第K小的数据),一般情况下数据量都比较大,但是k一般比较小。
对于Top-K问题,能想到的最简单直接的方式就是排序,但是:如果数据量非常大,排序就不太可取了。最佳的方式就是用堆来解决,基本思路如下:
1. 用数据集合中前K个元素来建堆
- 前k个最大的元素,则建小堆
- 前k个最小的元素,则建大堆
2. 用剩余的N-K个元素依次与堆顶元素来比较,不满足(最大 / 最小)则替换堆顶元素
将剩余N-K个元素依次与堆顶元素比完之后,堆中剩余的K个元素就是所求的前K个最小或者最大的元素。
(以上的求前K个最大/最小元素的思路,也适用于求第K个最大/最小的元素-堆顶元素就是第K个最大/最小的元素)
示例:有N个元素,找出前K个最小的元素
输入: arr = [1,3,5,7,2,4,6,8], k = 4
输出: [1,2,3,4]
力扣原题:https://leetcode.cn/problems/smallest-k-lcci/description/
- 方法1 - 整体排序
- 方法2 - 整体建立一个大小为N的小根堆
- 方法3 - 把前k个元素创建为大根堆,遍历剩下的N-K个元素,和堆顶元素比较,如果比堆顶元素小,则堆顶元素删除,当前元素入堆(最好的做法)
(1)使用方法2的做法
由于要找出有N个元素的数组中前k个最小的元素,那么可以将这个数组整体建立一个大小为N的小根堆,那么堆中的前k个元素就是要找的最小的元素。
public class Top_K {
    public int[] smallestK(int[] arr,int k) {
        //整体建立一个小根堆
        PriorityQueue<Integer> priorityQueue = new PriorityQueue<>();
        for(int i = 0; i < arr.length; i++) {
            priorityQueue.offer(arr[i]);
        }
        //实例化一个数组ret,存放堆中前k个最小的元素
        int[] ret = new int[k];
        for(int i = 0; i < k; i++) {
            ret[i] = priorityQueue.poll();//将前k个堆顶元素出堆,存放到ret中
        }
        return ret;//返回ret数组
    }
}
(2)使用方法3的做法
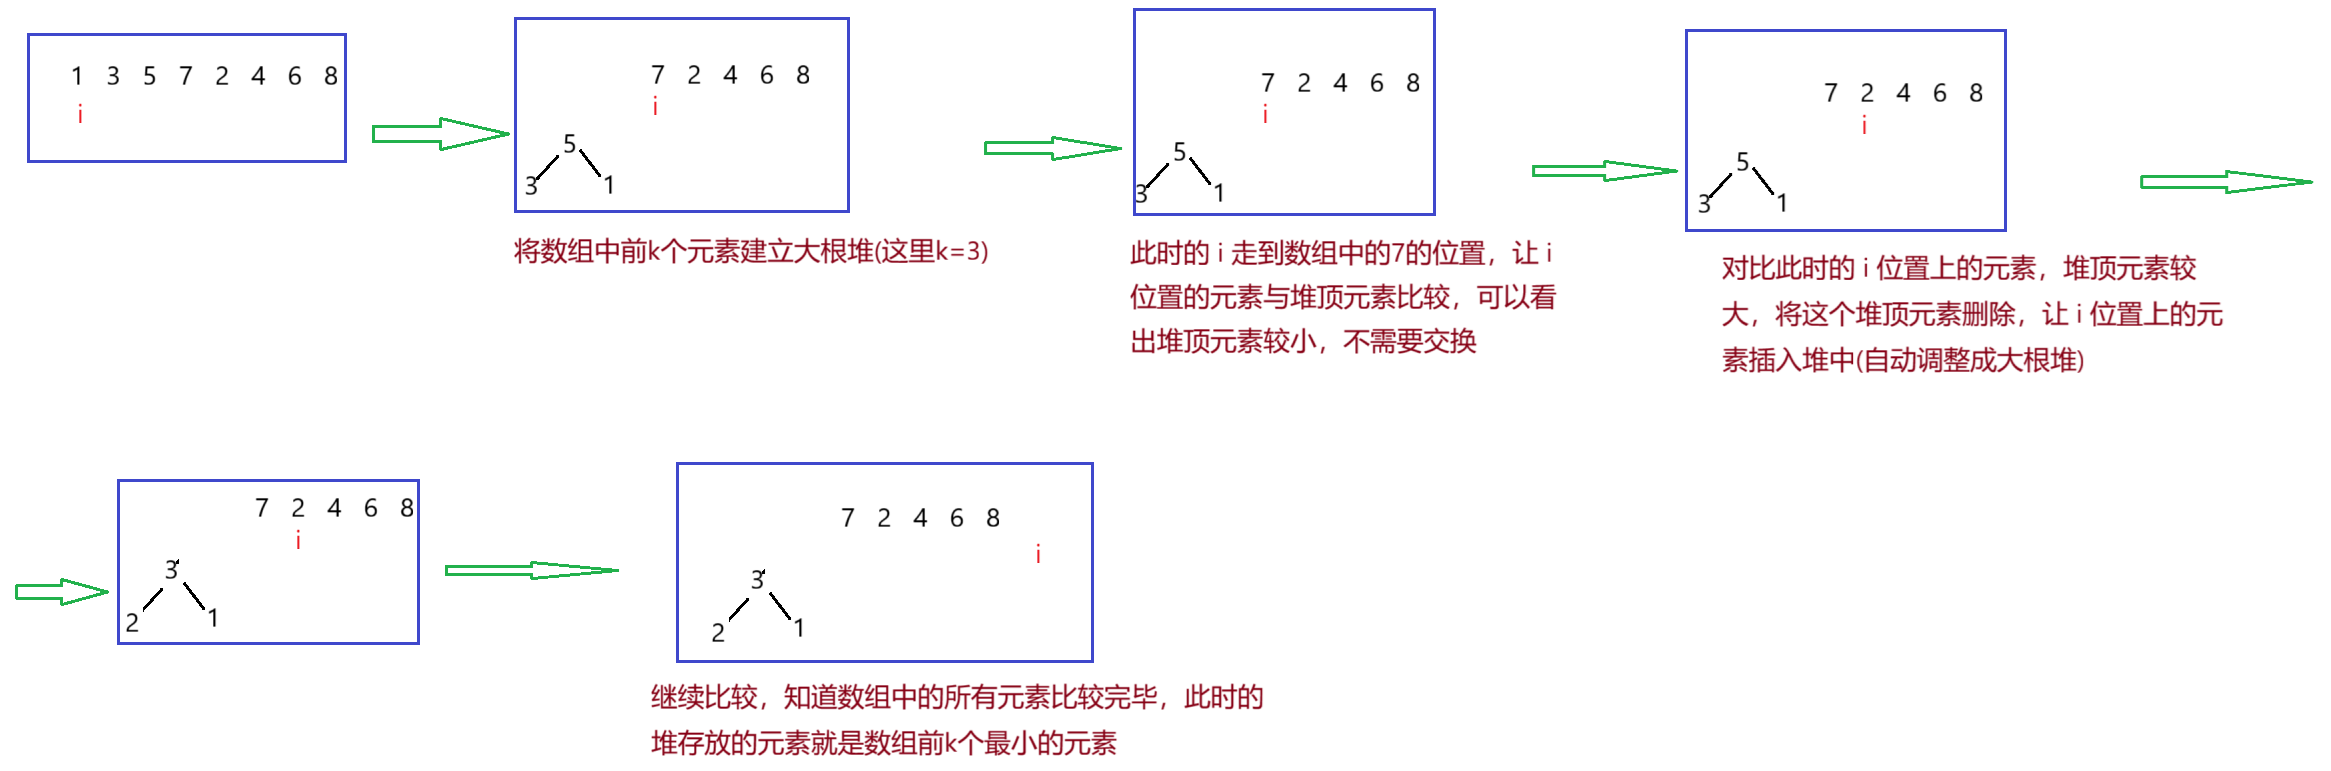
将数组中的前k个元素单独拿出来建立一个大根堆,将除了数组前k个之外的所有元素与大根堆的堆顶元素比较,如果元素比堆顶元素小,则将堆顶元素删除,将此时的元素插入到堆中,此时会自动将其重新调整成大根堆,然后继续让数组中的下一个元素与新的堆顶元素比较,直到数组中的元素全部与堆顶元素比较完成,此时的堆中存放的就是数组中前k个最小的元素。
class BigHeap implements Comparator<Integer> {
    public int compare(INteger o1,INteger o2) {
        return o2.compareTo(o1);
    }
}
public class Top_K {
    public int[] ret smallestK(int[] arr,int k) {
        //实例化一个数组ret,存放堆中前k个最小的元素
        int[] ret = new int[k];
        //判空
        if(arr == null || k == 0) {
            return ret;
        }
        //将数组中前k个元素建立成一个大根堆
        PriorityQueue<Integer> priorityQueue = new PriorityQueue<>(new BigHeap());
        for(int i = 0; i < k; i++) {
            priorityQueue.offer(arr[i]);
        }
        //将数组中剩余的元素与堆顶元素比较
        for(int i = k; i < arr.length; i++) {
            int peekVal = priorityQueue.peek();
            if(arr[i] < peekVal) {
                priorityQueue.poll();
                priorityQueue.offer(arr[i]);
            }
        }
        //将前k个堆顶元素出堆,存放到ret中
        for(int i = 0; i < k; i++) {
            ret[i] = priorityQueue.poll();
        }
        return ret;//返回ret数组
    }
}
示例:求数组中第k个最小的元素
思路和方法3的思路一样,只不过最后只需要返回数组中第k个最小的元素即可。
class BigHeap implements Comparator<Integer> {
    public int compare(Integer o1,Integer o2) {
        return o2.compareTo(o1);
    }
}
public class Top_K {
    public int the_K_smallest(int[] arr,int k) {
        PriorityQueue<Integer> priorityQueue = new PriorityQueue<>(new BigHeap());
        for(int i = 0; i < k; i++) {
            priorityQueue.offer(arr[i]);
        }
        for(int i = k; i < arr.length; i++) {
            int peekVal = priorityQueue.peek();
            if(arr[i] < peekVal) {
                priorityQueue.poll();
                priorityQueue.offer(arr[i]);
            }
        }
        return priorityQueue.poll();
    }
} 更多推荐


 7
 0
- 0


 已为社区贡献1条内容

所有评论(0)