
【推荐系统7】多目标建模
目录
(Multi-Task Learning, MTL)通过联合优化多个相关任务,在推荐系统中实现用户体验与商业目标的协同提升。
本文为funrec推荐系统学习笔记,整合自己的理解和网络其他资料写成。
基础结构演进
Shared-Bottom
Shared-Bottom 模型作为多目标建模的奠基性架构,采用“共享地基+独立塔楼”的设计范式。
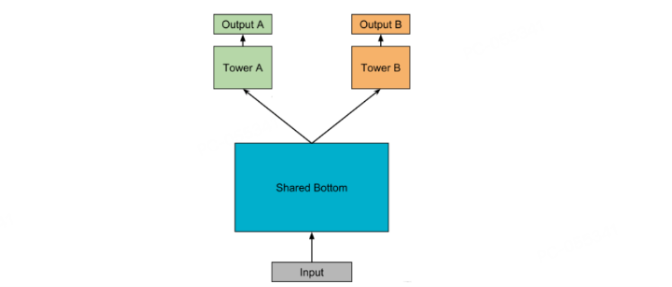
- 共享底层(Shared Bottom):所有任务共用同一组特征转换层,负责学习跨任务的通用特征表示;
- 任务特定塔(Task-Specific Towers):每个任务拥有独立的顶层网络,基于共享表示学习任务特定决策边界。
该模型存在负迁移现象:一旦任务目标之间出现冲突,参数优化就会陷入方向性的矛盾。
MMoE 多门控混合专家模型
针对负迁移现象的优化:MMoE(Multi-gate Mixture-of-Experts)
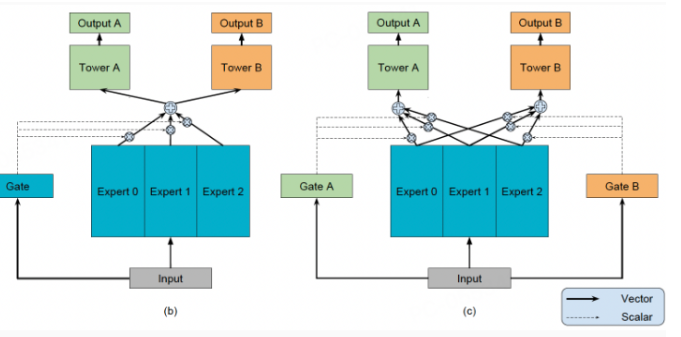
- Multi-gate:多门控,指模型包含多个独立的 “门控网络”,用于分别控制不同任务对 “专家网络” 的权重分配。
- Mixture-of-Experts:混合专家,核心思想是搭建多个 “专家网络”(负责处理不同类型的特征或任务),再通过 “门控网络” 对专家的输出进行加权融合,得到最终结果。
代码api(pytorch版本)
使用 `pytorch-lightning-bolts` 中的 `BBBMMoE`(或社区库 `mmoe-pytorch`)
from mmoe import MMoE # 初始化:输入维度128,8个专家,2个任务,专家隐藏层64
mmoe = MMoE(input_dim=128, num_experts=8, num_tasks=2, expert_out_dim=64)
x = torch.randn(32, 128) task_feats = mmoe(x) # (click_feat: 32x64, order_feat: 32x64)
PLE
MMoE存在的隐患是所有专家对所有任务门控可见,尽管规定了专属门控对应专家的组合,仍然有风险
提出CGC:通过硬性结构强制分离专家,严格限制门控输入
PLE则是多层CGC的堆叠
任务依赖建模
ESMM
解决曝光→点击→转化这一两阶段行为链路的样本偏差问题(样本偏差问题:只用 “曝光且点击” 的样本训练,完全忽略了 “曝光但未点击” 的样本)
ESM2
扩展了用户的行为链路
如图为简化后的用户下单链路图:
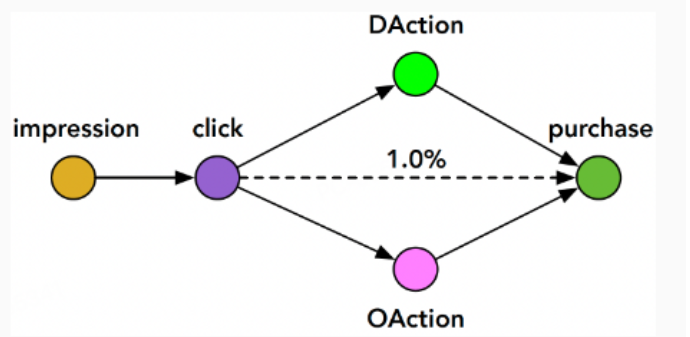
将加入购物车、加入心愿单为决定行为(Deterministic Action,DAction),
其余行为归并为其他行为(Other Action,OAction)
ESM2有四个塔,分别预测y1,y2,y3和y4:
- 点击曝光y1=p(点击|曝光)
- 决定行为点击y2=p(决定行为|点击)
- 购买决定行为y3=p(购买|决定行为)
- 购买其他行为y4=p(购买|其他行为)
ESM2提供了一种通用的建模思路,可以灵活扩展到更长的行为链路和更多样化的用户决策路径中。
多目标损失融合
多目标往往伴随着多个损失的联合优化,这类优化方法更多的考虑的是在模型结构已经确定的条件下,结合任务的特点对模型进行训练和参数优化。简单的多目标Loss优化,是通过手工结合业务经验设定不同损失的权重,**将多个损失加权为一个进行优化**,如下所示:
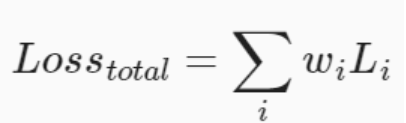
其中,Li和wi分别表示第i个任务的损失及对应的权重。
传统的手工加权的缺陷:
- 量级失衡:大损失主导优化方向
- 收敛异步问题:稀疏任务收敛慢,密集任务收敛快,造成过拟合与欠拟合并存
- 梯度冲突问题:任务梯度方向不一致时产生抵消效应
Uncertainty Weight(UWL)
Uncertainty Weighted Loss, UWL,基于不确定性的自适应加权
UWL的核心思想是根据**任务的不确定性**动态调整不同任务在联合训练时的损失权重,具体来说,任务的损失越大,分配的权重越小。(就是说模型不会让任务往不确定性较大的方向大幅更新参数)
这个任务的不确定性(uncertainty),就是模型可学习的参数
GradNorm:梯度标准化方法
在模型优化过程中除了正常的任务loss外,还引入了一个gradient loss,该loss通过梯度下降的方式来更新不同任务的loss权重。这两个loss是单独优化的
最终的 gradient loss 定义:
当某个loss的梯度非常大时,该loss的值也会较大进而会将该loss的权重降的更小,避免了梯度大的loss主导了模型的学习。同理当某个任务学习的速度较快时,梯度loss也会变得更大,进而使得该loss的权重会变得更小,阻止某个任务过快的收敛。
Pareto Optimization:帕累托优化框架
针对梯度冲突问题提出的优化方案
主要步骤:
1. 固定权重,更模型参数:用梯度下降最小化 “加权损失”,和常规模型训练一致。
2. 固定模型,更新权重:通过求解二次规划问题,让 “加权梯度的二范数最小化”(满足 KKT 条件);求解时会先处理约束,再对结果投影确保权重非负。
更多推荐


 11
 0
- 0


 已为社区贡献4条内容

所有评论(0)