
【推荐系统5】Wide & Deep模型与特征交叉
本篇为阅读funrec的读书笔记,融合网络资料与自己的理解写成。
记忆与泛化:Wide & Deep模型
记忆:模型能够学习并记住那些在历史数据中频繁共同出现的特征组合。
泛化:模型能够发掘特征之间更深层次的关联,探索那些在数据中从未或很少出现过的全新特征组合。例如,模型通过学习发现“物品A和物品C都属于某个抽象类别,而用户喜欢该类别的物品”,从而向喜欢A的用户推荐了他们从未见过的C。
如图,Wide & Deep模型提出了联合训练(将模型拆分成两部分,承担记忆和泛化两种职责),来使模型可以同时兼具两种能力:

记忆:Wide部分
线性模型
含大量人工设计的(下一节的优化点)交叉特征:比如`AND(installed_app=photo_editor, impression_app=filter_pack)`,它代表用户已经安装了“照片编辑器”应用,并且现在看到了“滤镜包”应用的推荐
泛化:Deep部分
前馈神经网络
稀疏特征-》嵌入层-》特征拼接-》输入神经网络进行前向传播
一个值得注意的工程细节是,由于两部分处理的特征类型不同,它们通常会采用不同的优化器。
- Wide部分的输入特征非常稀疏,常使用带L1正则化的FTRL等优化器。L1正则化可以产生稀疏的权重,相当于自动进行特征选择,让模型只“记住”最重要的规则。
- Deep部分的参数是稠密的,更适合使用像AdaGrad或Adam这样的优化器。
特征交叉
如何实现特征交叉自动化
FM
召回章节中的FM作为双塔模型的雏形,这里也用到FM:为每个特征学习低维隐向量,用向量内积参数化二阶交叉项权重。
通过参数共享,即使特征未共同出现,也能通过各自隐向量泛化交叉效应,例子:
特征 A 是 “喜欢篮球”,特征 B 是 “喜欢球鞋”,特征 C 是 “喜欢运动”。
>- 训练数据里没有 “喜欢篮球 + 喜欢球鞋” 的样本,但有 “喜欢篮球 + 喜欢运动”“喜欢球鞋 + 喜欢运动” 的样本。
>- 模型通过前两组样本,分别摸清了 “喜欢篮球”(A)和 “喜欢运动”(C)的关联、“喜欢球鞋”(B)和 “喜欢运动”(C)的关联,相当于间接知道了 A 和 B 的 “共同属性”(都和运动相关)。
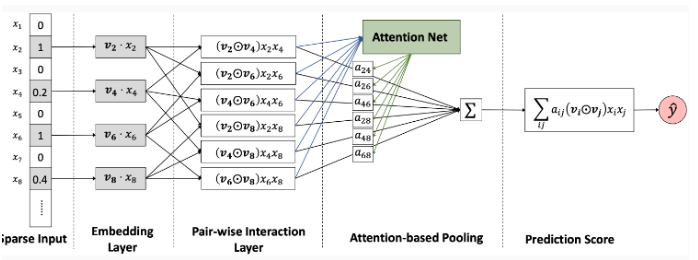
AFM:引入注意力机制
FM 对所有特征交叉给予了相同的权重,AFM引入注意力机制为不同的特征交叉分配权重,提升模型的表达能力
先对隐向量(表征特征的潜在交互信息)运用元素积(两个维度相同的隐向量,对应位置的元素分别相乘)而不是直接求内积(两个同维度向量对应位置元素相乘,再将所有乘积相加)
这样做保留了交叉特征的向量信息
AFM模型如图
NFM:深度利用交叉信息
将 FM 的二阶交叉结果作为输入,送入一个深度神经网络(DNN),从而在 FM 的基础上学习更高阶、更复杂的非线性关系。
PNN
在内积的基础上增加了外积(增加乘积层)
乘积层输出线性信号(直接来自 Embedding)和二次信号(来自 Embedding 交互),二次信号分 IPNN(用内积,经矩阵分解优化复杂度)和 OPNN(用外积,经 “叠加” 近似优化复杂度)两种变体。最后合并两类信号,送入全连接层继续变换
FiBiNET
PNN仍然将所有特征视为同等重要,FiBiNET在进行二阶特征交叉之前,先动态地学习每个特征的重要性权重,然后再通过双线性交互来捕捉更精细的特征关系
主要的创新:
- SENET 特征重要性学习:能够自适应地为不同特征分配不同的权重
- 双线交互:对原始嵌入 E 和加权嵌入 V 进行双线性交互,然后将这两组交互结果、原始特征以及一个深度神经网络的输出结合起来,共同做出最终的预测。
DeepFM
对 Wide & Deep 架构的改进
改进点:
- WideDeep中需要大量人工特征工程的 Wide 部分,直接替换为了一个无需任何人工干预的 FM 模型
- FM 组件和 Deep 组件共享同一份特征嵌入(Embedding)
组件:
FM 和 DNN 组件并行:
- FM 组件: 负责学习一阶特征和二阶特征交叉。
- Deep 组件: 负责学习高阶的非线性特征交叉。
DCN
通过一个创新的Cross Network来替代Wide & Deep模型中的Wide部分,每一层都让当前层输入与原始输入进行显式交叉
Deep Network(深度网络):弥补 Cross Network 在非线性表达上的不足
xDeepFM: 向量级别的特征交互
DCN的交叉方式是 元素级别(bit-wise) 上进行的。这意味着Embedding向量中的每一个元素都会独立地与其他特征的Embedding元素进行交互,这在一定程度上忽略了Embedding向量作为一个整体所代表的特征场的概念。
为了解决这个问题,引入 xDeepFM 模型
xDeepFM的整体架构同样由三部分组成:一个传统的线性部分、一个用于隐式高阶交叉的DNN,以及创新的CIN网络用于显式高阶交叉。
AutoInt
借鉴了Transformer 架构的核心思想,通过多头自注意力机制来自动、自适应地学习任意阶数的特征交互。(AutoInt 中的高阶交互不是通过固定的数学公式构建的,而是通过注意力权重动态决定的)
代码练习:pytorch框架下搭建简单的DeepFM
库
import torch
import torch.nn as nn
import torch.nn.functional as F
DeepFM框架
class DeepFM(nn.Module):
    def __init__(self, feature_num, embed_dim, hidden_dims):
        super(DeepFM, self).__init__()
        self.feature_num = feature_num  # 特征数量
        self.embed_dim = embed_dim      # Embedding维度

        # 1. 一阶特征权重(线性部分)
        self.first_order = nn.Embedding(feature_num, 1)

        # 2. 二阶特征Embedding(FM和DNN共享)
        self.embedding = nn.Embedding(feature_num, embed_dim)

        # 3. DNN部分(高阶特征交叉)
        dnn_layers = []
        input_dim = feature_num * embed_dim  # DNN输入维度:特征数×Embedding维度
        for dim in hidden_dims:
            dnn_layers.append(nn.Linear(input_dim, dim))
            dnn_layers.append(nn.ReLU())
            input_dim = dim
        self.dnn = nn.Sequential(*dnn_layers)

        # 4. 输出层(结合FM和DNN结果)
        self.output = nn.Linear(hidden_dims[-1] + 1, 1)  # +1是FM的二阶输出

    def forward(self, x):
        # x: 输入特征索引,shape=[batch_size, feature_num]

        # FM一阶部分
        first = self.first_order(x).sum(dim=1)  # [batch_size, 1]

        # FM二阶部分(隐向量内积)
        embed = self.embedding(x)  # [batch_size, feature_num, embed_dim]
        square_sum = embed.sum(dim=1).square()  # (sum v_i)^2
        sum_square = embed.square().sum(dim=1)  # sum v_i^2
        second = 0.5 * (square_sum - sum_square).sum(dim=1, keepdim=True)  # [batch_size, 1]
        fm_out = first + second  # FM总输出

        # DNN部分(高阶交叉)
        dnn_in = embed.view(embed.shape[0], -1)  # 展平为[batch_size, feature_num*embed_dim]
        dnn_out = self.dnn(dnn_in)  # [batch_size, hidden_dims[-1]]

        # 结合FM和DNN输出
        total = torch.cat([fm_out, dnn_out], dim=1)
        return torch.sigmoid(self.output(total)).squeeze()  # 二分类场景输出概率
更多推荐


 19
 0
- 0


 已为社区贡献4条内容

所有评论(0)