
【推荐系统11】阿里天池新闻推荐赛:赛题理解与baseline
目录
此次比赛是以新闻APP中的新闻推荐为背景, 目的是要求根据用户历史浏览点击新闻文章的数据信息预测用户未来的点击行为, 即用户的最后一次点击的新闻文章。
想着练手试一试,重在理解大致流程,增加自己的代码能力
参赛地址
零基础入门推荐系统 - 新闻推荐_学习赛_天池大赛-阿里云天池的提交 (aliyun.com)
赛题理解
目标: 根据用户历史浏览点击新闻的数据信息预测用户最后一次点击的新闻文章。
目标上:预测的是文章
数据上:给的是点击日志
开始大致的思路
预测问题转换为监督学习问题(特征+标签)-> 如何转成一个监督学习问题呢? 转成一个什么样的监督学习问题呢? 我们能利用的特征又有哪些呢? 又有哪些模型可以尝试呢?
特征标签:分类的标签就是用户是否会点击某篇文章,分类问题的特征中会有用户和文章
什么样的监督学习?-> 多分类问题-> 预测最大概率
关于评价指标
假如article1就是真实的用户点击文章,也就是article1命中, 则s(user1,1)=1, s(user1,2-4)都是0, 如果article2是用户点击的文章, 则s(user,2)=1/2,s(user,1,3,4,5)都是0。也就是score(user)=命中第几条的倒数。
我们希望的就是命中的结果尽量靠前, 而此时分数正好比较高。
数据集(在报名参赛的md文档里面有下载链接)
train_click_log.csv:训练集用户点击日志
testA_click_log.csv:测试集用户点击日志
articles.csv:新闻文章信息数据表
articles_emb.csv:新闻文章embedding向量表示
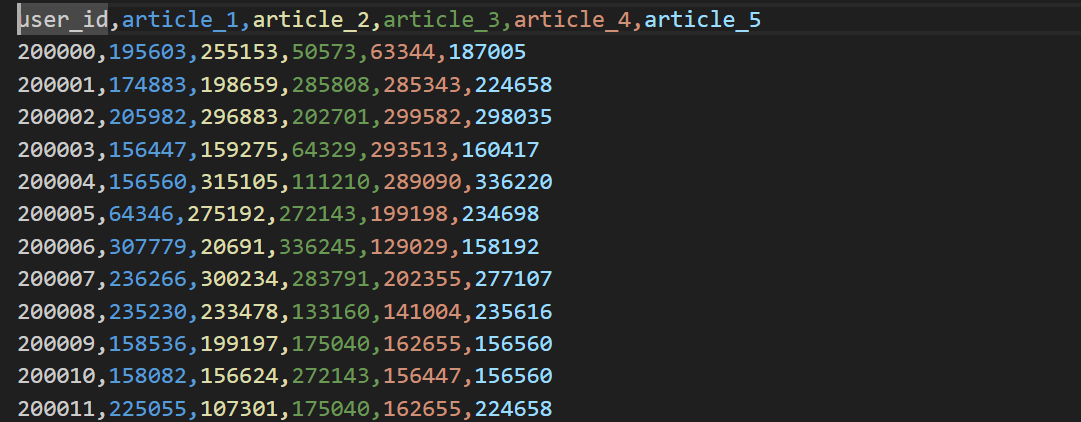
sample_submit.csv:提交结果示例
字段表
Field Description
user_id 用户id
click_article_id 点击文章id
click_timestamp 点击时间戳
click_environment 点击环境
click_deviceGroup 点击设备组
click_os 点击操作系统
click_country 点击城市
click_region 点击地区
click_referrer_type 点击来源类型
article_id 文章id,与click_article_id相对应
category_id 文章类型id
created_at_ts 文章创建时间戳
words_count 文章字数
emb_1,emb_2,…,emb_249 文章embedding向量表示
Baseline
代码
# import packages
import time, math, os
from tqdm import tqdm
import gc
import pickle
import random
from datetime import datetime
from operator import itemgetter
import numpy as np
import pandas as pd
import warnings
import collections
from collections import defaultdict
warnings.filterwarnings('ignore')

data_path = './data/'
save_path = './temp_results/'
# df节省内存函数
def reduce_mem(df):
    starttime = time.time()
    numerics = ['int16', 'int32', 'int64', 'float16', 'float32', 'float64']
    start_mem = df.memory_usage().sum() / 1024**2
    for col in df.columns:
        col_type = df[col].dtypes
        if col_type in numerics:
            c_min = df[col].min()
            c_max = df[col].max()
            if pd.isnull(c_min) or pd.isnull(c_max):
                continue
            if str(col_type)[:3] == 'int':
                # 尝试转换为最小整数类型
                if c_min > np.iinfo(np.int8).min and c_max < np.iinfo(np.int8).max:
                    df[col] = df[col].astype(np.int8)
                # 依次尝试更大的整数类型
                elif c_min > np.iinfo(np.int16).min and c_max < np.iinfo(np.int16).max:
                    df[col] = df[col].astype(np.int16)
                elif c_min > np.iinfo(np.int32).min and c_max < np.iinfo(np.int32).max:
                    df[col] = df[col].astype(np.int32)
                elif c_min > np.iinfo(np.int64).min and c_max < np.iinfo(np.int64).max:
                    df[col] = df[col].astype(np.int64)
            else:
                # 转换浮点数
                if c_min > np.finfo(np.float16).min and c_max < np.finfo(np.float16).max:
                    df[col] = df[col].astype(np.float16)
                elif c_min > np.finfo(np.float32).min and c_max < np.finfo(np.float32).max:
                    df[col] = df[col].astype(np.float32)
                else:
                    df[col] = df[col].astype(np.float64)
    # 计算优化后的最小内存占用
    end_mem = df.memory_usage().sum() / 1024**2
    print('-- Mem. usage decreased to {:5.2f} Mb ({:.1f}% reduction),time spend:{:2.2f} min'.format(end_mem,
                                                                                                           100*(start_mem-end_mem)/start_mem,
                                                                                                           (time.time()-starttime)/60))
    # 返回优化后的 DataFrame
    return df
# debug模式:从训练集中划出一部分数据来调试代码
def get_all_click_sample(data_path, sample_nums=10000):
    """
        训练集中采样一部分数据调试
        data_path: 原数据的存储路径
        sample_nums: 采样数目(这里由于机器的内存限制,可以采样用户做)
    """
    all_click = pd.read_csv(data_path + 'train_click_log.csv')
    all_user_ids = all_click.user_id.unique()

    sample_user_ids = np.random.choice(all_user_ids, size=sample_nums, replace=False)
    all_click = all_click[all_click['user_id'].isin(sample_user_ids)]

    all_click = all_click.drop_duplicates((['user_id', 'click_article_id', 'click_timestamp']))
    return all_click

# 读取点击数据,这里分成线上和线下,如果是为了获取线上提交结果应该讲测试集中的点击数据合并到总的数据中
# 如果是为了线下验证模型的有效性或者特征的有效性,可以只使用训练集
def get_all_click_df(data_path='./data/', offline=True):
    if offline:
        all_click = pd.read_csv(data_path + 'train_click_log.csv')
    else:
        trn_click = pd.read_csv(data_path + 'train_click_log.csv')
        tst_click = pd.read_csv(data_path + 'testA_click_log.csv')

        all_click = pd.concat([trn_click, tst_click], ignore_index=True)

    all_click = all_click.drop_duplicates((['user_id', 'click_article_id', 'click_timestamp']))
    return all_click
# 选择使用全量训练集
all_click_df = get_all_click_df(offline=False)


# 根据点击时间获取用户的点击文章序列
def get_user_item_time(click_df):
    click_df = click_df.sort_values('click_timestamp')
    def make_item_time_pair(df):
        return list(zip(df['click_article_id'], df['click_timestamp']))
    # 多列选择用列表 [] 包裹
    user_item_time_df = click_df.groupby('user_id')[['click_article_id', 'click_timestamp']].apply(lambda x: make_item_time_pair(x))\
                                                            .reset_index().rename(columns={0: 'item_time_list'})
    user_item_time_dict = dict(zip(user_item_time_df['user_id'], user_item_time_df['item_time_list']))

    return user_item_time_dict

# 获取近期点击最多的文章
def get_item_topk_click(click_df, k):
    topk_click = click_df['click_article_id'].value_counts().index[:k]
    return topk_click
# 文章之间的相似性矩阵计算
def itemcf_sim(df):
    """
        文章与文章之间的相似性矩阵计算
        :param df: 数据表
        :item_created_time_dict:  文章创建时间的字典
        return : 文章与文章的相似性矩阵
        思路: 基于物品的协同过滤(详细请参考上一期推荐系统基础的组队学习), 在多路召回部分会加上关联规则的召回策略
    """
    user_item_time_dict = get_user_item_time(df)
    # 计算物品相似度
    i2i_sim = {}
    item_cnt = defaultdict(int)
    for user, item_time_list in tqdm(user_item_time_dict.items()):
        # 在基于商品的协同过滤优化的时候可以考虑时间因素
        for i, i_click_time in item_time_list:
            item_cnt[i] += 1
            i2i_sim.setdefault(i, {})
            for j, j_click_time in item_time_list:
                if(i == j):
                    continue
                i2i_sim[i].setdefault(j, 0)
                i2i_sim[i][j] += 1 / math.log(len(item_time_list) + 1)
    i2i_sim_ = i2i_sim.copy()
    for i, related_items in i2i_sim.items():
        for j, wij in related_items.items():
            i2i_sim[i][j] = wij / math.sqrt(item_cnt[i] * item_cnt[j])
    # 关键修改:检查并创建保存文件夹
    if not os.path.exists(save_path):
        os.makedirs(save_path)

    pickle.dump(i2i_sim_, open(save_path + 'itemcf_i2i_sim.pkl', 'wb'))

    return i2i_sim_


i2i_sim = itemcf_sim(all_click_df)
# 基于商品的召回i2i
def item_based_recommend(user_id, user_item_time_dict, i2i_sim, sim_item_topk, recall_item_num, item_topk_click):
    """
        基于文章协同过滤的召回
        :param user_id: 用户id
        :param user_item_time_dict: 字典, 根据点击时间获取用户的点击文章序列{user1: [(item1, time1), (item2, time2)..]...}
        :param i2i_sim: 字典,文章相似性矩阵
        :param sim_item_topk: 整数, 选择与当前文章最相似的前k篇文章
        :param recall_item_num: 整数, 最后的召回文章数量
        :param item_topk_click: 列表,点击次数最多的文章列表,用户召回补全
        return: 召回的文章列表 [item1:score1, item2: score2...]
        注意: 基于物品的协同过滤(详细请参考上一期推荐系统基础的组队学习), 在多路召回部分会加上关联规则的召回策略
    """
    # 获取用户交易历史的文章
    user_hist_items = user_item_time_dict[user_id]# 注意,此时获取得到的是一个元组列表,需要将里面的user_id提取出来
    user_hist_items_ = {user_id for user_id, _ in user_hist_items}

    item_rank = {}
    # 遍历用户历史交互的每个物品
    for loc, (i, click_item) in enumerate(user_hist_items):
        for j, wij in sorted(i2i_sim[i].items(), key=lambda x: x[1], reverse=True)[:sim_item_topk]:
            if j  in user_hist_items_:
                continue
            item_rank.setdefault(j, 0)
            item_rank[j] +=  wij
    # 不足10个,用热门商品补全
    if len(item_rank) < recall_item_num:  # 如果用户历史记录的长度小于recall_item_num,则将 Popularity_based_recall_item_num 填充到 item_rank 中
        for i, item in enumerate(item_topk_click):
            if item in item_rank.items(): # 填充的item应该不在原来的列表中
                continue
            item_rank[item] = - i - 100 # 随便给个负数就行
            if len(item_rank) == recall_item_num:
                break
    item_rank = sorted(item_rank.items(), key=lambda x: x[1], reverse=True)[:recall_item_num]

    return item_rank

# 定义
user_recall_items_dict = collections.defaultdict(list)
# 获取用户-文章-点击时间的字典
user_item_time_dict = get_user_item_time(all_click_df)
# 去除文章相似度
i2i_sim = pickle.load(open(save_path + 'itemcf_i2i_sim.pkl', 'rb'))
# 相似度文章的数量
sim_item_topk = 10
# 召回文章的数量
recall_item_num = 10
# 用户热度补全
item_topk_click = get_item_topk_click(all_click_df, k=5)
for user in tqdm(all_click_df['user_id'].unique()):
    user_recall_items_dict[user] = item_based_recommend(user, user_item_time_dict, i2i_sim,
                                                        sim_item_topk, recall_item_num, item_topk_click)
# 将字典的形式转换成df
user_item_score_list = []
for user, items in tqdm(user_recall_items_dict.items()):
    for item, score in items:
        user_item_score_list.append([user, item, score])
recall_df = pd.DataFrame(user_item_score_list, columns=['user_id', 'click_article_id', 'pred_score'])

# 生成提交文件
def submit(recall_df, topk = 5, model_name = None):
    recall_df = recall_df.sort_values(by=['user_id', 'pred_score'])
    recall_df['rank'] = recall_df.groupby('user_id')['user_id'].rank(ascending=False, method='first')
    # 判断是不是每个用户都有5篇文章及以上
    tmp = recall_df.groupby('user_id').apply(lambda x: x['rank'].max())
    assert tmp.min() >= topk

    del recall_df['pred_score']
    submit = recall_df[recall_df['rank'] <= topk].set_index(['user_id', 'rank']).unstack(-1).reset_index()
    submit.columns = [int(col) if isinstance(col, int) else col for col in submit.columns.droplevel(0)]
    # 按照提交格式定义列名
    submit = submit.rename(columns={'': 'user_id', 1: 'article_1', 2: 'article_2',
                                                  3: 'article_3', 4: 'article_4', 5: 'article_5'})

    save_name = save_path + model_name + '_' + datetime.today().strftime('%m-%d') + '.csv'
    submit.to_csv(save_name, index=False, header=True)

# 获取数据集
tst_click = pd.read_csv(data_path + 'testA_click_log.csv')
tst_users = tst_click['user_id'].unique()
# 从所有的召回数据中将测试集中的用户选出来
tst_recall = recall_df[recall_df['user_id'].isin(tst_users)]

# 生成提交文件
submit(tst_recall, topk=5, model_name='itemcf_baseline')
理解
baseline将重点实现ItemCF(基于物品的协同过滤)算法作为召回策略
reduce_mem(df)
通过动态判断每列数值的范围,将其转换为最小兼容的整数或浮点数类型(如`int64`转`int8`、`float64`转`float32`),从而显著减少 DataFrame 的内存占用,尤其适合处理大型数据集时提升效率。
debug模式与全量数据采样
get_all_click_sample(data_path, sample_nums=10000)
在调试代码时,由于原始训练数据可能非常大(比如百万级用户),直接加载会占用大量内存、拖慢调试速度。因此通过随机采样部分用户的点击数据,用小数据集快速验证代码逻辑是否正确。
get_all_click_df
根据场景(线下验证 / 线上部署)加载不同范围的点击数据:
- 线下模式(`offline=True`):仅用训练集数据。用于模型训练、验证(比如划分训练集和验证集,评估模型效果),避免测试集数据 “泄露” 影响评估准确性。
- 线上模式(`offline=False`):合并训练集和测试集 A 的数据。用于最终生成线上提交结果(此时需要用所有可用数据训练模型,提升推荐效果)。
get_user_item_time
通过按时间排序、分组聚合,将原始的点击日志数据转换为结构化的 “用户 - 历史点击序列(含时间)” 字典
最终得到的字典:每个键是用户 ID,对应的值是该用户按时间先后排序的点击记录列表。
itemcf_sim(df)
基于物品的协同过滤(Item-Based Collaborative Filtering)算法,计算文章之间的相似度矩阵,保存为temp_results下的itemcf_i2i_sim.pkl
item_based_recommend
根据用户历史交互过的物品,推荐与之相似的其他物品。代码通过循环为每个用户执行基于物品协同过滤的召回逻辑,生成推荐列表,最终将所有用户的推荐结果整理成结构化数据表 `recall_df`。这个数据表可以作为推荐系统的中间结果,供后续的排序阶段
submit
生成提交文件
将推荐结果按用户 ID 和推荐分数排序,为每个用户选择分数最高的前 5 个物品,按指定格式整理成提交文件。
运行结果与测试得分
本地跑了一下,大概运行了30分钟左右

生成的预测用户最后点击的前五名,csv文件如下:
在阿里天池提交并评测,查看得分:
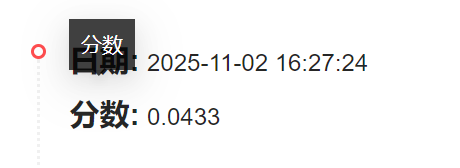
确实命中率不高,还需要继续优化
更多推荐

 14
 0
- 0


 已为社区贡献4条内容

所有评论(0)