
双向循环链表
双向循环链表
文章目录
一、前言
本篇迎来了表的最后一种结构——双向循环链表。
首先,请允许我引入一个重要的代码思想——“逻辑完备性”。它指的是代码能够准确、无遗漏地处理所有可能的输入情况、执行路径和边界条件,确保程序在任何预期(甚至某些非预期但可能发生)的场景下都能行为正确、可控,不会因为未处理的逻辑分支而陷入不可知或错误的状态。
单向链表的操作常常需要遍历和判断边界条件,难免有些不便,于是双向循环链表应运而生,它牺牲了一定的空间复杂度,但却带来了操作的巨大便利,是逻辑完备性的重要体现。C++ S T L STL STL中的list亦是使用此原理,接下来我将对它进行一个深入解读~
二、双向循环链表概述
2.1 定义
每个节点包含数据域、指向前驱节点的指针 (prev) 和指向后继节点的指针 (next)。头节点的prev指向尾节点,尾节点的next指向头节点,形成一个首尾相连的闭环。
保留了链表的特性,增加了双向的特点
如图:
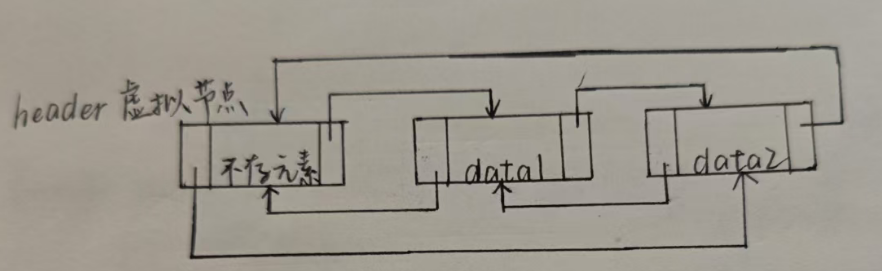
代码:
// 定义节点结构
typedef int Element;
typedef struct _node
{
    Element val;
    struct node* prev;
    struct node* next;
} DNode, DList;
2.2 存储空间
和链表一样,存储在堆空间
2.3 优点
- 双向遍历:可从任意节点向前或向后遍历。
- 操作高效:在已知节点位置时,插入、删除效率高,无需整体移动元素。(链表优点)
- 操作统一:首尾节点的操作逻辑与中间节点一致,无需特殊边界处理。
- 动态结构:无需连续内存,可动态调整长度。(链表优点)
2.4 缺点
- 空间开销大:每个节点需存储两个指针,占用更多内存。
- 不支持随机访问:无法通过下标直接访问元素,需从头或尾开始遍历。(链表缺点)
- 实现稍复杂:插入、删除需维护更多指针关系,易出错。
- 缓存不友好:节点非连续存储,缓存命中率可能较低。(链表缺点)
2.5 应用
-
关于循环的场景对于双向循环链表同样适用。
-
特定数据结构的基础:可用于实现队列、双端队列、栈等。
-
需要频繁在任意位置增删的场景:如实现 L R U LRU LRU缓存淘汰算法。
双向的特性虽然牺牲了空间,但却带来了增删等操作的巨大灵活性。
三、双向循环链表逻辑
3.1 头结构
在这里,同样是以带头节点的双向循环链表为代表进行解析(头指针进一步发展就是头节点)
和前面链表的头结构一样,直接将虚拟节点封装进头结构。虚拟节点的*next就是原来的尾指针,*prev指向头节点。这里的头结构其实就是一个虚拟节点,虚拟节点的value充当计数器(count)不再封装其他的成员。
优点:虚拟节点的引入使得整个链表所有非虚拟节点的的插入和删除操作在逻辑上得到了统一(操作是相同的)
如图:
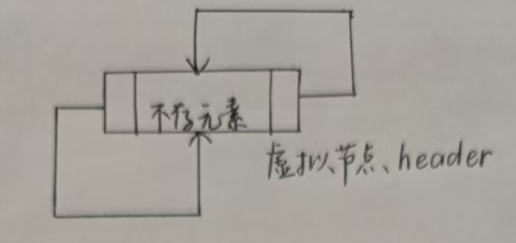
代码:
// 这里的头结构和普通节点没区别,因此它的定义就是普通节点的定义(见上文)
3.2 初始化和释放
如图:
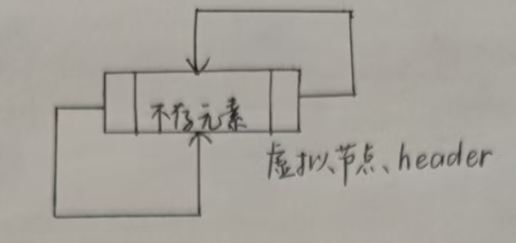
代码:
// 初始化
void initDList(DList* header)       			// header里面的element都要初始化
{
    header->val = 0;
    header->prev = header->next = header;       //自己指自己
}
// 释放
void releaseDList(DList* header)
{   // 设一个辅助节点,表示要删除的位置
    DNode *pos = header->next;      // pos永远指向待删的节点
    DNode *tmp = NULL;      		// pos在哪就删哪,删完要跑到下一个去,因此想到要备份
    while (pos != header)
    {
        tmp = pos;
        delDNode(pos->prev, pos->next);
        pos = pos->next;
        free(tmp);
        --header->val;          	// 虚拟节点的value充当计数器,递减计数
    }
}
3.3 插入
有两种方法:头插和尾插。
因为所有的节点的插入操作一致,可以对其单独封装一个统一的添加元素的接口。(双向循环链表的灵魂)
因为该接口只能在函数接口内部访问,可以想到利用**
static修饰函数接口**,表示该函数的作用域仅限于当前定义它的源文件(.c文件),无法被其他源文件通过extern声明调用,即该函数仅对当前文件可见。
如图:
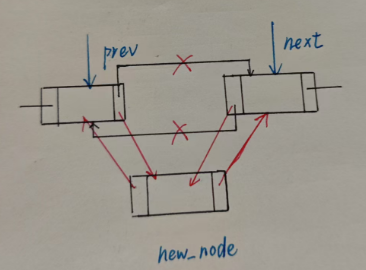
尽量从后往前依次更新。因为前面的更新,会导致后面的节点丧失它的目标。
双向的特点,使得修改指向的过程有两层屏障,不用担心插入位置前面的链表和后面的链表失去链接。但是必须是逆时针更新指向,一旦修改了顺序的指向(前面节点指向后面节点),就会导致链接断裂。这里定义了两个指针,是为了用于标记操作位置的左右边界。
代码:
static void addDNode(DNode *new_node, DNode *prev, DNode *next)
{
    next->prev = new_node;
    new_node->next = next;
    new_node->prev = prev;
    prev->next = new_node;
}
3.3.1 头插
如图:
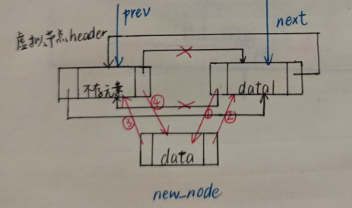
代码:
void insertDListHeader(DList* header, Element val)
{
    DNode *new_node = malloc(sizeof(DNode));        // 分配内存
    new_node->val = val;
    addDNode(new_node, header, header->next);
    ++header->val;
}
3.3.2 尾插
如图:
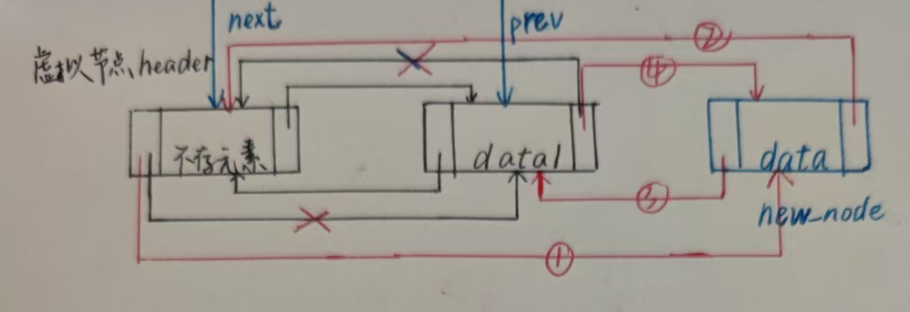
代码:
void insertDListRear(DList* header, Element val)
{
    DNode *new_node = malloc(sizeof(DNode));
    new_node->val = val;
    addDNode(new_node, header->prev, header);
    ++header->val;
}
3.4 删除
在这里,因为删除的操作也是统一的,同样可以写一个**static修饰的删除元素的接口**。(双向循环链表的灵魂)
销毁的本质是东西(里面的元素)还在,但是不受保护了(其他)。
逆时针更新(和插入一样)。站在自己删自己(不需要前置的辅助指针)。
如图:
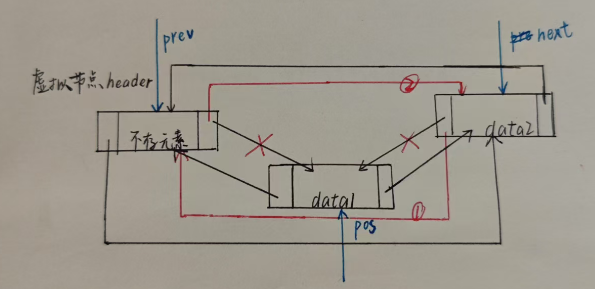
代码:
static void delDNode(DNode *prev, DNode *next)
{
    next->prev = prev;
    prev->next = next;
}
void delDList(DList* header, Element e) // 1. 找到这个元素,就可以就地删除,不需要再找到前置节点
{
    DNode *pos = header->next;
    while (pos != header && pos->val != e)
    {
        pos = pos->next;
    }
    // 2. 找到没有?
    if (pos != header)  //找到
    {
        delDNode(pos->prev, pos->next);
        pos->prev = pos->next = NULL;
        free(pos);
        --header->val;
    }
    else
    {
        printf("Not find %d element!\n", e);
    }
}
四、小结
链表的路任重道远。在今后的学习中,根据具体的问题选择合适的表结构是尤为重要的~
一个人的认知是渺小的,希望各位读者批评指正~
更多推荐



 22
 0
- 0


 已为社区贡献1条内容

所有评论(0)