
【简单易懂论文阅读|2018】DeblurGAN: Blind Motion Deblurring Using Conditional Adversarial Networks
从零开始学习计算机视觉,记录每篇读过的文章来慢慢积累自己的知识库,如果有说的不准确的地方请见谅,主要给和我一样的朋友大致说一下这篇论文,想更深入学习还是推荐去看原文章的哈!里面对重要的专业名词说明我会放在最后!
目录
生成对抗网络(GAN/Generative adversarial networks)
条件对抗网络(Conditional adversarial networks)
摘要
摘要部分讲述了这篇论文实现了以端到端(输入模糊图像,直接输出清晰图像)的学习方法,采用条件GAN(生成对抗网络)和内容损失来指导学习,DeblurGAN对模糊的图像实现了视觉外观和结构相似性的质量提升,同时性能比DeepDeblur高了五倍。
同时还提出了一种新的评估方法:去模糊后图像的目标检测结果基准。
最后提供了一种新的生成模糊图像的方法,以此来增强数据。
介绍
这项工作是对单照片的去模糊处理,通过GAN(生成对抗网络)以图像到图像的处理细节的启发。创新了DeblurGAN--条件生成对抗网络和多组件损失函数。同时采用WassersteinGAN的梯度惩罚和感知损失,这里不采用MSE(L2 Loss/均方误差)和MAE(L1 Loss/平均绝对误差)是感知损失能有更丰富的细节和纹理,让图像视觉上更清晰。
最后作者做出了三点贡献:
- 第一是提出来更好的损失和架构,提升去模糊的结果
- 第二是生成模糊图像的方法,以此来增强数据集
- 第三是增加基于目标检测来对去模糊算法的评估
相关工作
在这一章节是简单介绍以前的方法,还有概述一下需要用到的技术。
图像去模糊
在以往有一个典型的非均匀去模糊公式:
:模糊的图像(blurred image)
:模糊核(blur kernels),由运动场M确定。(可以理解为根据M运动造成模糊的函数)
:卷积运算符。
:清晰的潜在图像(sharp latent image)
:加性噪声(additive noise)
根据模糊核是否已知分为:盲去模糊和非盲去模糊
在早期的去模糊处理的时候都采用上面的公式去得到一个清晰的图像,假设模糊核已知,通过经典的算法(Lucy-Richardson algorithm)和滤波器(Wiener or Tikhonov filter)来进行反卷积操作得到。这就是非盲去模糊。
但是通常这个模糊核我们是不知道的,同时为每一个图像中的像素找到对应的模糊函数(模糊核)也是不恰当的,所以通常用启发式、图像统计和对模糊来源的假设,这些方法通过考虑模糊在图像中的均匀性来解决相机抖动引起的模糊。
传统方法(深度学习之前)
在早期主要思路:先模糊核估计,后非盲去卷积算法。
方法一:基于迭代优化的方法
先随机确定一个模糊核和模糊图像,然后循环交替优化:已知模糊核优化模糊图像;已知模糊图像优化模糊核,同时为了防止病态优化会加入先验模型进行约束,比如自然图像和模糊核应该是什么样的。
方法一的迭代时间很长且无法确定什么时候可以停止优化,同时先验模型的影响很大。
方法二:基于快速启发式的方法
由此提出了方法二,即基于一些简化的假设,最常见的就是局部线性模糊。假设图像一个小区域内的模糊是均匀的、可以用一个简单的线性运动核来近似。将每个小部分估算出简单的模糊核之后再合并。
方法二对小部分处理很好,但是现实中是非均匀模糊不是均匀模糊,所以整体处理不好。
近年来的方法(深度学习之后)
方法一:CNN辅助模糊核估计
该方法对传统方法的优化策略,采用CNN来估计模糊核或者傅里叶系数或者运动流。这些方法仍是重点估计模糊核。
方法二:端到端的模糊核无关方法
这类方法是重大的转变,跳过了模糊核的估计,直接学习从模糊图像到清晰图像的映射。
多尺度CNN: 使用一个多尺度的卷积神经网络。网络首先在低分辨率上粗略地恢复图像,然后逐步到更高分辨率上恢复细节。DeepDeblur便是这种方法,也是本文对比的一个参照。
Pix2Pix + DenseNet:Pix2Pix是一个著名的基于条件GAN的图像到图像翻译框架,非常适合“图像转换”类任务。DenseNet是一种网络结构,其中每一层都直接连接到所有后续层。这种结构能极大地促进梯度流动和特征重用,让网络更高效、更强大。
本文就是借鉴方法二端到端的思想和Pix2Pix框架!
生成对抗网络(GAN/Generative adversarial networks)
标准的GAN
GAN定义了判别器D和生成器G,生成器接收噪声来输出一个图像样本,判别器接受生成的样本和真实的样本并区分他们。通过两者互相博弈来不断优化直至判别器无法区分生成器生成的图像样本。具体公式如下:
其中
是数据分布,
是模型分布。
这个公式是判别器和生成器的博弈,是真实照片,
表示来自于真实数据的分布
是随机噪声(随机向量),
表示
来自一个简单的随机分布(生成器的种子)。
表示期望值,所有真实图片判断的期望和对生成图片判断的期望。
:生成器产生的数据,接收噪声
并输出一张生成照片 。
:判别器对真实数据的判断。判别器看到一张真实图片 x,输出一个0到1之间的概率值,表示它认为这张图是“真实”的置信度。越接近1,判别器越肯定它是真的。
:判别器对生成数据的判断。判别器看到生成器造的假图 G(z),输出一个概率值,表示它认为这张假图是“真实”的置信度。
训练判断器D(max最大化):让判断器百分百区别真假。D(x)是判断器对真实图片的判断,我们希望越大越好,同样对于D(G(x))能越准确的判断假图片,他的值越小,那么1-D(G(x))越接近1,所以最大化D就是鼓励对真图片的高分和对假图片的低分。
训练生成器G(min最小化):让生成器能骗过判别器,最小化这个公式。因为G只能影响第二项G(x),所以要做到最小化就是尽力让D(G(z))变大,也就是骗过生成器,让生成器以为是真图片。
总结:在生成器和判别器的博弈中,判别器会努力给真图片打高分然后努力给判别器生成的图片打低分,而判别器为了最小化会努力让生成的图片被打高分,这样就让两者不断优化。
问题:这个原始的损失函数在训练中非常不稳定,容易出现“模式崩溃”(生成器只生成几种样子的图片)或梯度消失(无法训练)等问题,而这些问题是JS散度的缺失导致的。
WGAN
Wasserstein距离(推土机距离):为了防止梯度消失,采用推土机距离:即使两个分布没有重叠也可以平滑的变化(从P到Q需要多少工作量),生成器越接近真实图片,W越小,优势是它的梯度始终有效。
根据JS散度导致GAN难以训练有提出了WGAN(采用Wasserstein-1的GAN),其具体公式如下:
其中:是所有 1-Lipschitz 函数的集合(保证平滑性)
现在这个是一个“批评家”(Critic),用来给真实数据打高分,给生成数据打低分。为了避免
给真实数据打无穷大分,给生成数据打无穷小分,要对
进行约束,它的评分必须满足 1-Lipschitz连续,即它的输出变化不能比输入变化快。即
。这个所产生的最大分差就是Wasserstein距离。
在实施Lipschitz约束方面,最初WGAN采用对Critic网络的权重进行硬裁剪(比如限制在[-0.01, 0.01])来近似满足Lipschitz约束。但是这种做法会使网络受限制,难以施展身手,梯度容易爆炸或消失,不稳定,于是采用梯度惩罚(Gradient Penalty),这就是WGAN-GP。
WGAN-GP
使用梯度惩罚(GP)它不再对权重进行粗暴的裁剪,而是在损失函数中直接添加一个正则项,来软性地强制Critic的梯度范数接近1。梯度惩罚项如下:
其中是采样点,通过真实数据分布和生成数据分布之间随机插值(混合图像)来得到。
:这是Critic网络 D在采样点
处的输出关于其输入
的梯度范数。它衡量了Critic在该点的“敏感度”或“变化率”。
-1是因为我们希望这个梯度范数尽可能接近1,如果远大于1则违反了Lipschitz约束;如果它远小于1,虽然满足约束,但限制了Critic的能力。
梯度范数:梯度范数 = 梯度向量的长度 = 最陡方向上的“陡峭程度”,梯度范数远大于1表示Critic的评分变化太剧烈了。图片像素的一丁点微小改动,就可能导致评分发生天翻地覆的变化。梯度范数远小于1表示Critic对输入图片完全不敏感。无论图片怎么变,它的评分都几乎不变。
是为了控制梯度惩罚项在损失函数中的权重。
条件对抗网络(Conditional adversarial networks)
普通的GAN是从随机噪声生成图片(比如生成一张猫的图片)。而这里的条件是输入一张模糊图片,要求生成器基于这个条件生成对应的清晰图片。这就是“图像到图像的翻译”。条件生成对抗网络架构也被称为pix2pix。
提出方法
该方法输入模糊图片直接生成清晰图片因此直接跳过模糊核估计,去模糊模型由训练好的生成器CNN ,对于每个
都会估计一个
,在训练阶段引入
批评者网络,以对抗的方式训练两个模型。
损失函数
损失函数由对抗损失和内容损失
组合,其中
的值是100(平衡两个损失函数的权重)。公式如下:
原来的条件对抗判别器不仅要判断生成器生成的样本图像,还要看生成器的输入样本,但在这里作者确定了生成器输入样本与输出样本的一致,不采用这种方法,简化了判别器。
作者使用WGAN-GP作为批评方法,即使用Wasserstein距离来衡量生成的数据分布和真实数据分布之间的差异。这个距离即使两个分布没有重叠也能提供有效的梯度,使得训练过程非常稳定。同时提出了一个更聪明的“梯度惩罚”方法来代替权重裁剪,进一步提升了训练的稳定性和效果。同时作为评判而不是判别器就从原本只判断真假而变成打分数,这样可以确定优化的方向。
对抗损失函数:图像处理的好不好就要看判别器是否能被生成器生成的图片所骗过,而让生成器生成的图片通过判别器,就是对抗损失。相较于原始GAN使用的损失函数(vanilla),采用最小平方GAN(least aquare GAN)来得到更稳定的结果。公式如下:
:生成器
接受模糊图像
后生成的假清晰图像。
:批评家对这张图的打分,分数代表真实值,分数越高批评家越觉得是真的。
负号(-):生成器的目标是最大化这个分数,在训练中常执行最小化操作,所以加符号反过来。即
.
:对所有批次中的样本损失求和。
内容损失:一般的内容损失是MAE(L1)和MSE(L2),这些会为了平均而导致一些模糊,作者采用了感知损失(Perceptual loss),他本质是一个简单的L2损失,但基于基于生成的CNN特征图与目标图像的差异,也就是只关注真实图和生成图的特征差异。这样在视觉上更能产生清晰的效果具体公式如下:
:代表预训练的VGG19网络。下标表示第
个池化层之前的第
个卷积层(经过激活函数后)的输出。论文中使用conv3_3层的输出。
:真实的清晰图像。
:生成器生成的图像。
和
:将真实图像和生成图像分别输入VGG19,并提取指定中间层的特征图。
:该层特征图的宽高。(作者使用的是
)
总结:计算真实图像和生成图像在VGG19网络conv3_3层输出的特征图之间的均方误差(L2损失/MSE)。
附加正则化:在GoPro数据集上加入正则化性能会更差,故没有加入附加正则化。
网络架构
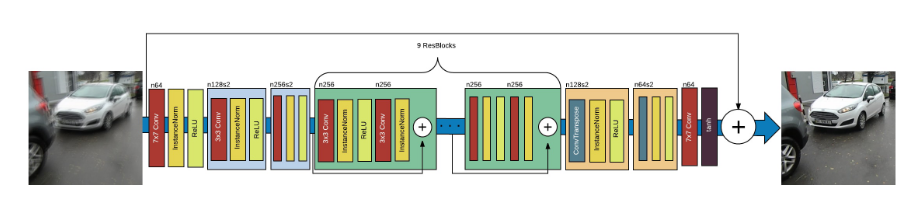
其核心思想是残差学习:它不是直接生成一张清晰的图片,而是生成模糊图像和清晰图像直接的差异图(残差图)即,通过CNN学习了残差校正
。这样训练速度会更快且效果会更好。
生成器架构如下:
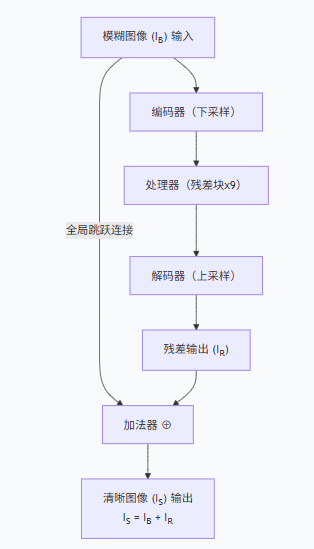
结构:生成器是“编码-解码”结构,中间加了残差块(ResBlock)(可以理解为让网络更容易学习细节)
跳跃连接(Skip Connection):让网络只学习“模糊”和“清晰”之间的差异(残差),这样训练更稳定、更快。它将最原始的输入直接连接到输出端,与学习到的残差
相加。这是实现残差学习的关键。
下采样(Downsampling):使用2个步长为2的卷积层(Strided Convolution) 来降低特征图的分辨率(H和W变小),同时增加通道数(C变大)。目的是为了在更深层扩大感受野,捕获图像的全局信息。
残差块 (Residual Blocks - ResBlocks): 这是网络的核心。论文使用了9个连续的残差块。 残差块的作用: 解决深层网络的梯度消失问题,允许网络构建得更深,从而拥有更强的表达能力。
实例归一化 (Instance Normalization): 对每个样本的每个通道的特征图进行归一化。
ReLU激活函数: 引入非线性,让网络能够学习复杂模式。
Dropout: 在训练时,以0.5的概率随机“关闭”一部分神经元,是一种正则化技术,防止网络过拟合。
上采样 (Upsampling): 使用2个转置卷积层(Transposed Convolution),有时也称为“反卷积”。它将特征图的分辨率逐步上采样回原始输入尺寸。
在训练阶段还有一个与生成器“对抗”的评论家网络。
评论家 (Critic) 架构如下:
普通的判别器为整张图像输出一个“真/假”值。而PatchGAN为图像中的每一个NxN的小块(Patch)输出一个真伪判断,最终形成一个二维矩阵。
-
优点:
-
关注局部纹理: 可以精细地判断图像不同局部区域的真伪,特别适合捕捉纹理和细节的高频信息。
-
参数更少: 可以设计得更轻量。
-
适用于任意大小图像: 因为是全卷积结构,可以处理训练时没见过尺寸的图像。
-
-
内部结构:
-
由多个卷积层组成。
-
除了最后一层,每个卷积层后面都跟着:
-
实例归一化
-
LeakyReLU激活函数: 斜率
α=0.2。与ReLU不同,LeakyReLU允许负值以一个小斜率通过,这有助于梯度在判别器中更好地流动,防止训练停滞。
-
-
运动模糊的生成
传统方法: 用高速摄像机拍视频,取中间帧为清晰图,前后帧平均为模糊图。缺点: 费时费力,数据量有限。
J.sun的方法:通过将干净的自然图像与73个可能的线性运动核中的一个卷积来创建合成模糊图像。
Chakrabarti的方法:在图像上随机取6个点,然后用一条样条曲线将这些点连接起来。这条曲线就被当作相机的运动轨迹,从而生成一个模糊核。(缺点是过于平滑,现实更复杂)
DeblurGAN的方法:
生成随机运动轨迹:利用复数,它的实部代表x坐标,虚部代表y坐标,完美地描述2D平面上的连续位置。再使用一个马尔可夫过程,下一个点的位置只取决于当前点的状态,再加上一些随机扰动。影响因素分为以下四点:
- 上一时刻的位置和速度:这是运动的基础,保证了轨迹的连续性。
-
高斯扰动: 一个随机的、微小的抖动,模拟手部非常细微的自然颤抖。
-
脉冲扰动: 一个随机的、幅度较大的突然抖动,模拟相机按下快门时或遇到障碍物时的突然移动。
-
确定性惯性分量: 一个保持之前运动趋势的力,模拟运动的连贯性。
通过调整这些参数的权重,可以生成成千上万条形态各异、非常接近真实运动的轨迹,有的平滑,有的急促,有的带有突然的拐弯。
将轨迹转换为模糊核:上一步生成的轨迹是一条在连续空间中的路径,但图像是离散的像素组成的。通过插值算法(如线性插值)得到模糊核。
合成模糊图像:得到模糊核之后可以通过卷积操作将清晰的图像变成模糊的图像。
训练细节
使用Pytorch框架实现所有模型,训练硬件采用单块 Maxwell 架构的 GTX Titan-X GPU,有3个不同的数据集。
作者训练了3个模型验证不同的效果:(针对真实户外照片)、
(使用清晰的MS COCO图片,用本文提出的随机轨迹方法生成合成模糊,再裁剪成256x256的块)、
(混合使用上述两种数据,合成数据 : 真实数据 = 2 : 1。)
模型采用全卷积且在图像块上训练的,可以应用于任何大小的图像。
优化问题:采用Adam优化算法(这是一种常用的、自适应学习率的梯度下降算法,通常能获得很好的收敛效果。)
训练策略:遵循WGAN-GP,对评论家(Critic/D)进行5次梯度更新后,才对生成器(Generator/G)进行1次更新。这是因为评论家的任务更复杂(要评估图像的真实性),需要更多步骤来达到最优,从而为生成器提供更好的指导信号。
学习率:对于Generator和Critic初始值为:0.0001,在前150个周期(epoch)保持0.0001不变,然后在接下来的150个周期内线性地逐渐减少到0。这种策略在训练后期有助于模型收敛到更优的点,而不是在最优点附近震荡。
在测试阶段应用dropout和实例规范化(instance normalization),通过引入少量随机性,可能会让输出结果更加多样化或稳定
最后作者发现模型以Batch Size=1(模型在每次更新内部参数(权重)之前所处理的训练样本的数量)进行训练表现的结果会更好。
实验评估
GoPro数据集
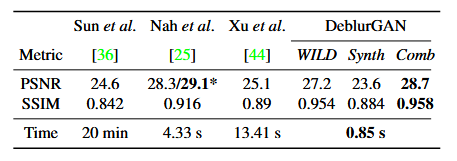
使用GoPro数据测试发现DeblurGAN在结构自相似性、峰值信噪比和视觉外观上取得不错的结果,同时与其他神经模型相比,它可以不用估计模糊核来处理图像,和多尺度CNN相比,它的参数会更少运行得更快。下图就是DeblurGAN与其他模型的对比。
-
PSNR (峰值信噪比): 衡量像素级别的准确性。值越高越好。缺点: 有时与人的视觉感受不符。
-
SSIM (结构相似性): 衡量结构相似性。更符合人眼感知。值越接近1越好。
Kohler数据集
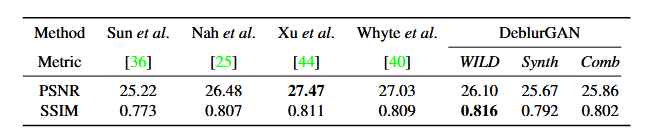
在Kohler数据集中的效果如下图:
目标在YOLO上的检测基准
作者根据现在计算机视觉实际场景中展示了新的方法评估,通过YOLO目标检测的结果来判断去模糊的质量。各模型测试结果如下图:
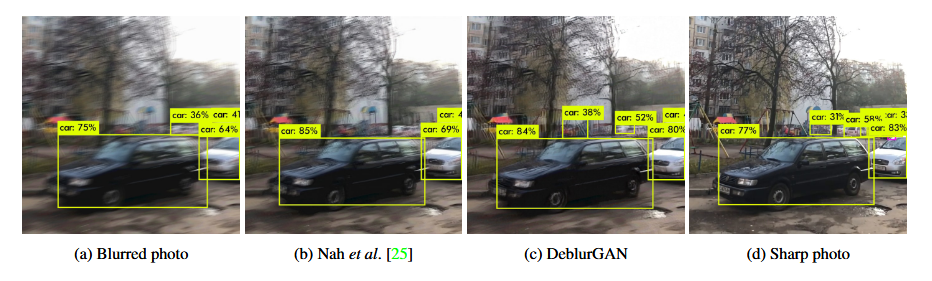
结论
在这里作者总结了自己的三个创新点:DeblurGAN、合成运动模糊的新方法、提出了一个基于目标检测质量的新评估方法。
最后论文中项目复现可以去:DeblurGAN论文代码复现
重要专业名词解释:
JS散度及梯度消失的原因:
JS散度公式:
KL散度公式:
注意:P表示第一个分布,Q表示第二个分布,M=(P+Q)/2表示P和Q的中间分布(平均分布)
JS散度:JS散度是一种距离,用来衡量两者有多相似,JS散度越小表示两者越相似,反之。它是对称的JS(P || Q)=JS(Q || P)。值域为[0,1]。
KL散度:KL散度也叫相对熵,也是用来衡量两个分布差异的方法,但是它的问题是不对称,对于KL(A || B)和KL(B || A)的计算结果是不一样的,所以他是单向的。
当两者完全不同的时候,这里有三种情况,当在分布P时;在分布Q时
;其他地方
,所以
,
,故
通过以上公式我们得到两个互不重叠的JS散度等于常数log2. 在机器学习中,我们是通过梯度下降来更新模型参数的。我们需要计算损失函数关于参数的梯度(导数),然后沿着梯度方向更新模型,使得损失函数值降低。 损失函数:在GAN中,生成器G的目标是最小化JS(真实图片分布||生成图片分布),而这个损失函数是常数,即JS(P || Q). 在这里我们发现损失函数是常数,所以导致生成器不知道该往哪个方向调整,就导致梯度消失。
更多推荐

 43
 0
- 0


 已为社区贡献1条内容

所有评论(0)