
PyTorch实战实现DeepFM模型:CTR推荐系统开发详解

简介:DeepFM是一种结合因子分解机(FM)与深度神经网络(DNN)的点击率(CTR)预测模型,广泛应用于推荐系统中。本文通过PyTorch框架实现DeepFM,详细讲解其模型结构与实现流程。内容涵盖FM与DNN的核心原理、特征嵌入与交互计算、数据预处理方法、模型构建与训练技巧,并提供完整项目结构与模块说明。通过本项目实战,开发者可掌握如何在PyTorch中高效实现CTR预测模型,提升推荐系统的准确性与智能化水平。
1. 推荐系统与CTR预测基础
推荐系统是现代互联网平台的核心技术之一,其核心任务是通过分析用户行为与兴趣,精准匹配内容与用户,从而提升用户体验与平台转化率。点击率(CTR)预测作为推荐系统中的关键环节,旨在预估用户对某一物品(如广告、商品、新闻)的点击概率,直接影响排序与推荐效果。CTR预测广泛应用于广告推荐、内容分发、电商平台等多个场景,是衡量推荐系统性能的重要指标。相较于传统推荐模型,如协同过滤与逻辑回归,深度学习模型具备更强的特征交互建模能力与泛化性能。其中,DeepFM作为融合因子分解机(FM)与深度神经网络(DNN)的代表性模型,兼具高阶与低阶特征交互建模能力,成为CTR预测任务中的主流方案之一。
2. DeepFM模型结构解析
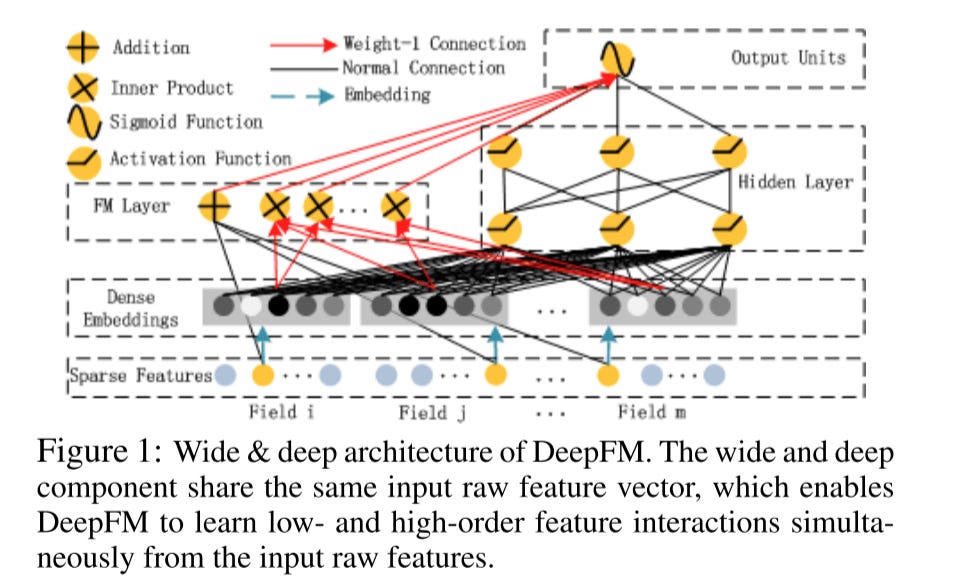
DeepFM 是一种融合因子分解机(Factorization Machine, FM)和深度神经网络(Deep Neural Network, DNN)的推荐系统模型。其设计初衷是结合 FM 在低阶特征交互建模上的高效性,以及 DNN 在高阶特征组合建模上的非线性表达能力。通过双路径结构,DeepFM 能够同时建模一阶特征和高阶特征之间的复杂交互关系,从而提升点击率(CTR)预测的准确率。
2.1 DeepFM的整体架构
DeepFM 的核心结构由两个并行的子模型组成: 因子分解机(FM)部分 和 深度神经网络(DNN)部分 。最终的预测结果是这两个部分输出的加权求和。
2.1.1 模型的双路径结构设计
DeepFM 的架构图如下所示(使用 Mermaid 流程图展示):
graph TD
    A[输入特征] --> B(FM部分)
    A --> C(DNN部分)
    B --> D[加权求和]
    C --> D
    D --> E[输出预测值]
- 输入特征 :通常为稀疏的高维向量,包含离散特征(如用户ID、物品ID)和连续特征(如评分、时间戳等)。
- FM部分 :负责建模一阶和二阶特征交互。
- DNN部分 :负责提取高阶非线性特征组合。
- 加权求和 :将 FM 和 DNN 的输出进行线性叠加,最终输出点击率预测值。
这种双路径结构的优势在于: FM 能快速捕捉特征之间的线性与二阶关系,而 DNN 能学习更高阶的抽象特征组合 ,从而提升整体模型的泛化能力。
2.1.2 FM部分与DNN部分的协同机制
DeepFM 的协同机制体现在两个方面:
-
共享特征 Embedding :
- 在 DeepFM 中,FM 部分和 DNN 部分共享同一组特征 Embedding 向量。也就是说,每一个离散特征在输入模型时都会被映射为一个低维稠密向量(Embedding),这些向量同时用于 FM 的二阶交叉项和 DNN 的输入层。
- 这种设计大大减少了模型参数数量,同时提升了特征表示的泛化能力。 -
输出融合方式 :
- DeepFM 的最终输出为:
$$
y = \sigma(y_{FM} + y_{DNN})
$$
其中,$y_{FM}$ 是 FM 的输出,$y_{DNN}$ 是 DNN 的输出,$\sigma$ 是 sigmoid 函数(用于二分类任务如点击预测)。
这种方式确保了模型在不增加复杂度的前提下,能够同时捕捉低阶和高阶特征交互。
2.2 模型的优势与应用场景
DeepFM 在推荐系统中表现优异,主要得益于其对特征交互的建模能力。下面我们从与传统 FM 和 DNN 的对比出发,分析其优势,并探讨其在典型推荐场景中的应用。
2.2.1 相较于传统FM模型的改进
| 对比维度 | 传统FM模型 | DeepFM模型 |
|---|---|---|
| 特征交互建模 | 仅支持一阶和二阶交互 | 支持一阶、二阶以及高阶非线性交互 |
| 模型表达能力 | 线性 + 二阶组合 | 非线性 + 多阶组合 |
| Embedding共享 | 无 | 有(FM 与 DNN 共享) |
| 高维稀疏特征适应 | 优秀 | 更优秀(结合 DNN 的非线性表达) |
| 模型训练效率 | 快速收敛 | 收敛速度略慢但精度更高 |
例如,在传统 FM 中,若特征之间存在非线性组合(如用户点击行为与物品属性的组合),模型无法很好地捕捉这些关系。而 DeepFM 引入 DNN 后,可以自动学习这些高阶组合,从而显著提升预测精度。
2.2.2 相较于纯DNN模型的优势
| 对比维度 | 纯DNN模型 | DeepFM模型 |
|---|---|---|
| 特征交互建模 | 需要大量数据和层数来隐式学习 | 显式建模一阶和二阶特征交互 |
| 训练稳定性 | 容易陷入局部最优 | FM 部分提供稳定梯度信号 |
| 模型泛化能力 | 对低维特征依赖较强 | FM 部分增强泛化能力 |
| 稀疏特征处理 | 效果一般 | 结合 Embedding 和 FM 效果更佳 |
| 可解释性 | 较差 | FM 部分具有可解释性 |
纯 DNN 模型虽然具备强大的非线性建模能力,但在特征交互建模上较为隐式,需要大量训练数据和复杂的结构设计。而 DeepFM 利用 FM 的结构显式建模低阶特征交互,有助于 DNN 更好地学习高阶组合。
2.2.3 在广告推荐与电商点击预测中的典型应用
广告推荐系统
在广告推荐中,用户和广告的特征往往高维且稀疏(如用户ID、广告类别、地理位置等)。DeepFM 能够有效处理这些特征,建模用户-广告之间的复杂交互关系,从而提升点击率预测的准确性。
电商点击预测
电商平台中的点击预测任务中,用户历史行为(如点击、收藏、加购)与当前商品特征的组合对点击率影响显著。DeepFM 的双路径结构能够同时建模这些低阶和高阶特征交互,帮助系统更精准地预测用户行为。
例如,在一次电商活动中,某商品的点击率预测中,FM 部分可能捕捉到“用户性别=女”与“商品类别=化妆品”的二阶组合,而 DNN 部分则可以学习“用户历史点击商品=口红”与“当前商品品牌=兰蔻”的高阶组合。
2.3 模型输入与特征表示
DeepFM 的输入通常是高维稀疏的特征向量,包括离散特征和连续特征。为了适配模型结构,这些特征需要经过 Embedding 编码和拼接处理。
2.3.1 特征向量的构造方式
DeepFM 的输入向量由两部分组成:
- 离散特征 :通过 One-Hot 编码后,使用 Embedding 向量表示。
- 连续特征 :通常直接归一化后输入模型。
例如,假设我们有如下特征:
| 特征名 | 类型 | 示例值 |
|---|---|---|
| 用户ID | 离散 | 1001, 1002 |
| 广告类别 | 离散 | 0, 1, 2 |
| 用户年龄 | 连续 | 25, 34 |
| 上次点击时间 | 连续 | 12000, 30000 |
我们可以将这些特征构造为如下输入格式:
import torch

# 假设 Embedding 维度为 8
embedding_dim = 8

# 离散特征 Embedding 表
user_embedding = torch.nn.Embedding(num_embeddings=10000, embedding_dim=embedding_dim)
item_embedding = torch.nn.Embedding(num_embeddings=100, embedding_dim=embedding_dim)

# 输入示例
user_ids = torch.tensor([1001, 1002])
item_ids = torch.tensor([0, 1])

# 获取 Embedding 向量
user_emb = user_embedding(user_ids)  # shape: (batch_size, embedding_dim)
item_emb = item_embedding(item_ids)  # shape: (batch_size, embedding_dim)

# 连续特征归一化
continuous_features = torch.tensor([[25, 12000], [34, 30000]], dtype=torch.float32)
continuous_features = (continuous_features - continuous_features.mean(dim=0)) / (continuous_features.std(dim=0) + 1e-8)

# 拼接所有特征
final_input = torch.cat([user_emb, item_emb, continuous_features], dim=1)
print(final_input.shape)  # 输出:torch.Size([2, 32])
代码逻辑分析
-
Embedding层定义 :
- 使用torch.nn.Embedding构建离散特征的 Embedding 层。
- 每个离散特征被映射为一个低维向量(如 8 维)。 -
特征 Embedding 提取 :
- 将用户ID和广告ID转换为 Embedding 向量。 -
连续特征归一化 :
- 对连续特征进行标准化处理(均值为0,标准差为1),避免梯度爆炸。 -
特征拼接 :
- 所有特征向量在dim=1上拼接,形成最终输入向量。
参数说明
-
num_embeddings:特征的类别总数(如用户数、广告类别数)。 -
embedding_dim:每个特征 Embedding 的维度。 -
continuous_features:连续特征的原始值。 -
final_input:最终输入模型的特征向量,维度为[batch_size, total_dim]。
2.3.2 输入格式与特征交互的处理流程
整个 DeepFM 的输入处理流程如下:
-
特征编码 :
- 离散特征使用 One-Hot 编码或 Hash 编码。
- 连续特征进行标准化处理。 -
Embedding映射 :
- 所有离散特征被映射为 Embedding 向量。 -
特征拼接 :
- 将所有 Embedding 向量和连续特征拼接成一个向量。 -
FM部分处理 :
- 计算一阶和二阶特征交互。 -
DNN部分处理 :
- 将拼接后的向量输入全连接网络,提取高阶特征组合。 -
输出融合 :
- 将 FM 和 DNN 的输出加权求和,通过 sigmoid 函数输出点击率预测值。
该流程确保了 DeepFM 能够在处理高维稀疏特征的同时,有效建模低阶和高阶特征交互,从而实现高精度的点击率预测。
本章从模型结构、优势分析、输入处理三个方面深入解析了 DeepFM 的核心机制。下一章我们将深入探讨因子分解机(FM)的数学原理及其在推荐系统中的表达能力。
3. 因子分解机(FM)数学原理
因子分解机(Factorization Machines, FM)是一种通用的预测模型,尤其适用于高维稀疏数据场景,如推荐系统、广告点击率(CTR)预测等。其核心思想是通过引入隐向量(Embedding)来建模特征之间的二阶交叉项,从而有效捕捉特征之间的交互关系。相比传统的线性模型,FM不仅能够处理线性关系,还能自动建模特征之间的非线性组合,提升了模型的表达能力和泛化能力。
3.1 因子分解机的基本形式
FM的基本形式是一种广义的回归模型,可以用于分类和回归任务。其核心在于将特征之间的交叉项用隐向量的内积表示,从而避免了传统多项式回归中特征组合爆炸的问题。
3.1.1 线性回归与二阶交叉项的引入
传统的线性回归模型如下所示:
\hat{y} = w_0 + \sum_{i=1}^{n} w_i x_i
其中:
- $w_0$ 是偏置项;
- $x_i$ 是第 $i$ 个特征的取值;
- $w_i$ 是对应的线性权重。
这种模型只能建模线性关系,无法捕捉特征之间的交互作用。为了建模特征之间的组合关系,可以引入二阶交叉项:
\hat{y} = w_0 + \sum_{i=1}^{n} w_i x_i + \sum_{i=1}^{n} \sum_{j=i+1}^{n} w_{ij} x_i x_j
但这样的交叉项数量是 $O(n^2)$,在高维稀疏数据下计算不可行,且容易过拟合。
FM的解决方案是将每个特征 $x_i$ 映射为一个 $k$ 维的隐向量 $\mathbf{v}_i$,并用隐向量之间的内积来表示交叉项的权重:
\hat{y} = w_0 + \sum_{i=1}^{n} w_i x_i + \sum_{i=1}^{n} \sum_{j=i+1}^{n} (\mathbf{v}_i \cdot \mathbf{v}_j) x_i x_j
这样,模型参数数量变为 $O(nk)$,大大降低了参数规模。
3.1.2 隐向量(Embedding)的概念与作用
隐向量(Embedding)是FM模型中最重要的概念之一。每个特征 $x_i$ 都对应一个 $k$ 维的隐向量 $\mathbf{v}_i$,该向量可以理解为该特征在低维空间中的表示。
例如,假设特征是离散的类别型变量,如用户ID、商品ID等,FM会为每个ID分配一个隐向量。在训练过程中,这些隐向量通过梯度下降不断更新,从而学习到特征之间的潜在关系。
隐向量的作用在于:
- 降低参数数量,提升模型训练效率;
- 捕捉特征之间的潜在交互关系;
- 在高维稀疏场景下仍能保持良好的泛化能力。
例如,在推荐系统中,用户ID和商品ID之间的隐向量点积可以表示用户对商品的偏好程度,从而用于预测点击率。
3.2 FM在推荐系统中的表达能力
FM模型因其能够建模特征之间的二阶交叉项,在推荐系统中表现出色,尤其适用于高维稀疏的场景。
3.2.1 如何建模特征之间的交互关系
在推荐系统中,特征通常包括用户特征(如用户ID、性别、年龄)、物品特征(如物品ID、类别、价格)、上下文特征(如时间、地点)等。FM通过隐向量之间的点积建模这些特征之间的交互关系。
例如,用户 $u$ 和物品 $i$ 的特征可以表示为:
x = [\text{user}_u, \text{item}_i, \text{context}]
然后,FM模型可以自动学习用户与物品之间的交互:
\hat{y} {ui} = w_0 + w {\text{user} u} + w {\text{item} i} + \mathbf{v} {\text{user} u} \cdot \mathbf{v} {\text{item}_i}
这种建模方式使得模型能够自动捕捉用户和物品之间的潜在匹配关系。
3.2.2 高维稀疏特征下的泛化能力
推荐系统中常常面临高维稀疏数据的问题,例如用户-物品交互矩阵可能有上亿个特征维度,但每个样本只包含少量非零值。
FM通过以下方式提升泛化能力:
- 使用隐向量建模特征交互,减少参数数量;
- 隐向量之间共享信息,增强稀疏特征的表达;
- 通过正则化防止过拟合。
例如,在一个电商推荐场景中,若某个新商品从未被用户点击过,传统协同过滤无法给出推荐结果,而FM可以通过商品的特征(如类别、价格、品牌)与用户的隐向量进行匹配,给出合理的推荐。
3.3 FM的训练方法与梯度推导
3.3.1 损失函数的选择与优化目标
FM模型的训练目标是最小化损失函数。在CTR预测任务中,通常使用交叉熵损失函数(Cross-Entropy Loss):
\mathcal{L} = -\frac{1}{N} \sum_{i=1}^N \left[ y_i \log \hat{y}_i + (1 - y_i) \log (1 - \hat{y}_i) \right]
其中:
- $y_i$ 是样本的真实标签(0或1);
- $\hat{y}_i$ 是模型输出的概率预测值;
- $N$ 是样本总数。
在回归任务中,可以使用均方误差(MSE)损失函数:
\mathcal{L} = \frac{1}{2N} \sum_{i=1}^N (y_i - \hat{y}_i)^2
3.3.2 参数更新的梯度计算方式
FM模型的参数包括:
- 偏置项 $w_0$;
- 一阶权重 $w_i$;
- 二阶隐向量 $\mathbf{v}_i$。
以交叉熵损失为例,对各参数的梯度计算如下:
偏置项 $w_0$ 的梯度:
\frac{\partial \mathcal{L}}{\partial w_0} = -\frac{1}{N} \sum_{i=1}^N (y_i - \hat{y}_i)
一阶权重 $w_i$ 的梯度:
\frac{\partial \mathcal{L}}{\partial w_i} = -\frac{1}{N} \sum_{i=1}^N (y_i - \hat{y}_i) x_i
二阶隐向量 $\mathbf{v}_i$ 的梯度:
\frac{\partial \mathcal{L}}{\partial \mathbf{v} i} = -\frac{1}{N} \sum {i=1}^N (y_i - \hat{y} i) \left( x_i \sum {j=1}^n \mathbf{v}_j x_j - \mathbf{v}_i x_i^2 \right)
在实际训练中,通常使用随机梯度下降(SGD)或Adam优化器进行参数更新。
3.4 FM与协同过滤的联系与区别
3.4.1 用户-物品交互矩阵的建模方式
协同过滤(Collaborative Filtering, CF)是推荐系统中的一种经典方法,主要基于用户-物品交互矩阵,通过矩阵分解建模用户和物品的隐向量。
协同过滤的矩阵分解模型如下:
\hat{r}_{ui} = \mu + b_u + b_i + \mathbf{p}_u \cdot \mathbf{q}_i
其中:
- $\mu$ 是全局平均评分;
- $b_u, b_i$ 是用户和物品的偏置;
- $\mathbf{p}_u, \mathbf{q}_i$ 是用户和物品的隐向量。
FM可以看作是矩阵分解的扩展,它不仅建模用户和物品的隐向量,还能建模其他特征之间的交互关系。
3.4.2 与矩阵分解的异同点
| 特性 | 协同过滤(矩阵分解) | 因子分解机(FM) |
|---|---|---|
| 输入特征 | 仅用户和物品ID | 支持任意特征(如上下文、行为) |
| 交互建模 | 用户-物品隐向量点积 | 所有特征之间的隐向量点积 |
| 泛化能力 | 无法处理新特征 | 可处理新特征 |
| 参数规模 | $O(U + I)$ | $O(nk)$ |
| 适用场景 | 纯协同数据 | 多特征融合场景 |
从表中可以看出,FM在特征建模能力和泛化能力上优于协同过滤,尤其适合多特征融合的推荐场景。
代码示例:FM模型的核心计算逻辑
下面是一个使用NumPy实现的FM模型预测函数,展示了FM模型中特征交互的计算方式:
import numpy as np

def fm_predict(X, w0, w, V):
    """
    FM模型预测函数
    :param X: 输入特征向量 (n,)
    :param w0: 偏置项
    :param w: 一阶权重 (n,)
    :param V: 二阶隐向量矩阵 (n, k)
    :return: 预测值
    """
    linear_terms = w0 + np.dot(X, w)
    # 二阶交叉项计算
    interactions = 0.5 * np.sum(
        (np.dot(X, V))**2 - np.dot(X**2, V**2),
        axis=0
    )
    return linear_terms + interactions
代码逐行解读与逻辑分析:
-
linear_terms = w0 + np.dot(X, w)
- 计算线性部分,即偏置项加上特征与一阶权重的点积。 -
np.dot(X, V)
- 计算特征向量 $X$ 与隐向量矩阵 $V$ 的乘积,得到每个特征的隐向量加权和。 -
(np.dot(X, V))**2
- 对每个隐向量加权和进行平方,用于后续计算特征之间的点积。 -
np.dot(X**2, V**2)
- 计算特征平方与隐向量平方的点积,避免重复计算特征交叉项。 -
0.5 * np.sum(...)
- 根据FM的二阶交叉项公式,使用平方差公式计算所有特征之间的点积和。 -
return linear_terms + interactions
- 返回最终预测值,即线性项与交叉项之和。
参数说明:
-
X:输入特征向量,形状为(n,); -
w0:标量,偏置项; -
w:一阶权重向量,形状(n,); -
V:隐向量矩阵,形状(n, k),其中k是隐向量维度。
图表展示:FM模型结构与特征交互流程图
graph TD
    A[输入特征 x] --> B[线性部分 w0 + Σw_i x_i]
    A --> C[隐向量 V]
    C --> D[交叉项 ΣΣ(v_i·v_j)x_i x_j]
    B --> E[输出预测值 ŷ]
    D --> E
该流程图展示了FM模型的两个主要组成部分:线性部分和交叉项部分。输入特征经过线性变换和隐向量映射后,分别进入线性项和交叉项计算,最终合并为最终预测值。
表格:FM与协同过滤的对比分析
| 项目 | 协同过滤(CF) | 因子分解机(FM) |
|---|---|---|
| 输入特征 | 仅用户和物品ID | 支持任意特征 |
| 交互建模 | 用户-物品隐向量 | 所有特征之间的隐向量 |
| 新特征处理 | 无法处理 | 可以建模新特征 |
| 参数规模 | O(U + I) | O(nk) |
| 训练方式 | 矩阵分解 | 隐向量优化 |
| 应用场景 | 纯协同数据 | 多特征融合场景 |
通过本章的深入分析,我们可以看到,因子分解机(FM)以其对特征交互的有效建模能力和在高维稀疏数据下的良好泛化表现,成为推荐系统中不可或缺的重要模型。其与协同过滤的关系也体现了从单一特征建模到多特征融合的演进过程。下一章我们将进一步探讨深度神经网络(DNN)如何与FM结合,构建更强大的推荐模型。
4. 深度神经网络(DNN)设计实现
深度神经网络(DNN)是DeepFM模型中用于学习高阶非线性特征交互的重要组成部分。与传统的因子分解机(FM)相比,DNN能够自动提取特征之间的复杂组合关系,增强模型的表达能力与泛化性能。本章将围绕DNN部分的设计与实现展开,深入探讨其输入处理、网络结构、参数初始化策略、优化方法以及训练流程等关键内容。
4.1 DNN部分的输入与特征处理
在DeepFM中,DNN部分的输入来源于特征的Embedding向量拼接。这种输入方式不仅保留了特征之间的原始信息,还为后续的非线性建模提供了丰富的语义表示。
4.1.1 特征拼接与Embedding层的使用
为了构建DNN的输入层,通常会将离散特征通过Embedding映射为低维稠密向量,然后将这些向量进行拼接。例如,假设有三个离散特征:用户ID、物品ID、上下文ID,每个特征的Embedding维度为8,则最终的输入向量维度为 $8 \times 3 = 24$。
import torch
import torch.nn as nn

class EmbeddingLayer(nn.Module):
    def __init__(self, num_features, embedding_dim):
        super(EmbeddingLayer, self).__init__()
        self.embedding = nn.Embedding(num_embeddings=num_features, embedding_dim=embedding_dim)

    def forward(self, x):
        return self.embedding(x)  # shape: (batch_size, embedding_dim)

# 示例使用
user_ids = torch.tensor([10, 20, 30])  # 假设有三个用户
item_ids = torch.tensor([15, 25, 35])
context_ids = torch.tensor([5, 15, 25])

user_emb = EmbeddingLayer(100, 8)(user_ids)
item_emb = EmbeddingLayer(100, 8)(item_ids)
context_emb = EmbeddingLayer(50, 8)(context_ids)

# 拼接特征向量
input_vector = torch.cat([user_emb, item_emb, context_emb], dim=1)
print(input_vector.shape)  # 输出: torch.Size([3, 24])
代码逻辑分析:
-
EmbeddingLayer是一个封装的Embedding模块,接收特征的编号(如用户ID)作为输入,输出其对应的Embedding向量。 -
torch.cat函数用于在第1维上拼接三个Embedding向量,形成最终的输入向量。 -
dim=1表示在特征维度上进行拼接,而非样本维度。
参数说明:
- num_features :表示该特征种类的总数,如用户总数、物品总数等。
- embedding_dim :Embedding向量的维度大小,通常设置为8、16或32。
4.1.2 输入向量的维度与归一化处理
拼接后的输入向量通常维度较高,为了防止模型训练过程中出现梯度爆炸或收敛缓慢的问题,通常需要对输入进行归一化处理。
import torch.nn.functional as F

# 对输入向量进行L2归一化
normalized_input = F.normalize(input_vector, p=2, dim=1)
print(normalized_input.shape)  # 输出: torch.Size([3, 24])
逻辑说明:
- F.normalize 函数用于对向量进行归一化, p=2 表示使用L2范数。
- dim=1 表示对每个样本的输入向量进行归一化。
表格:不同归一化方法对比
| 方法 | 适用场景 | 优点 | 缺点 |
|---|---|---|---|
| L1归一化 | 特征稀疏场景 | 鲁棒性强,抗异常值 | 无法反映特征的分布密度 |
| L2归一化 | 多维稠密特征 | 向量方向保留,适合余弦相似度 | 对异常值较敏感 |
| BatchNorm | 深层网络训练 | 加快训练速度,提升稳定性 | 增加计算开销 |
4.2 神经网络的结构设计
DNN部分的结构设计决定了模型对高阶特征交互的学习能力。一个典型的DNN结构由多个全连接层(MLP)、激活函数以及Dropout层组成。
4.2.1 多层感知机(MLP)的构建
以下是一个典型的MLP结构示例:
class DNN(nn.Module):
    def __init__(self, input_dim, hidden_units, dropout_rate=0.5):
        super(DNN, self).__init__()
        layers = []
        for units in hidden_units:
            layers.append(nn.Linear(input_dim, units))
            layers.append(nn.ReLU())
            layers.append(nn.Dropout(dropout_rate))
            input_dim = units
        self.mlp = nn.Sequential(*layers)

    def forward(self, x):
        return self.mlp(x)
逻辑分析:
- hidden_units 是一个列表,表示每一层神经元的数量,例如 [128, 64, 32] 。
- 每一层由线性变换( Linear )+ ReLU激活函数 + Dropout组成。
- Sequential 用于将这些操作按顺序组合成一个完整的网络结构。
参数说明:
- input_dim :输入层维度,即拼接后的特征维度。
- hidden_units :各隐藏层的神经元数量。
- dropout_rate :Dropout的比例,用于防止过拟合。
4.2.2 激活函数与Dropout层的选择
激活函数的选择直接影响网络的非线性表达能力,而Dropout则用于控制模型的复杂度。
激活函数对比
| 激活函数 | 公式 | 优点 | 缺点 |
|---|---|---|---|
| ReLU | $ f(x) = \max(0, x) $ | 计算简单,缓解梯度消失 | 神经元可能“死亡” |
| LeakyReLU | $ f(x) = \max(0.01x, x) $ | 缓解ReLU死亡问题 | 需要调参 |
| Sigmoid | $ f(x) = \frac{1}{1 + e^{-x}} $ | 输出范围[0,1],适合二分类 | 梯度消失严重 |
| Tanh | $ f(x) = \tanh(x) $ | 输出范围[-1,1],中心对称 | 梯度消失严重 |
Dropout原理图
graph TD
    A[输入] --> B[线性变换]
    B --> C[ReLU]
    C --> D[Dropout]
    D --> E[输出]
图示说明:
- Dropout层在训练阶段以一定概率(如0.5)随机“关闭”神经元,强制网络学习冗余特征表示。
- 在测试阶段,Dropout不起作用,所有神经元都参与预测。
4.3 网络参数初始化与优化策略
良好的参数初始化和优化策略对于模型的训练效率和收敛性能至关重要。
4.3.1 初始化方法(如Xavier、He)
def init_weights(m):
    if isinstance(m, nn.Linear):
        nn.init.xavier_normal_(m.weight)
        m.bias.data.fill_(0.01)

dnn = DNN(input_dim=24, hidden_units=[128, 64])
dnn.apply(init_weights)
逻辑分析:
- xavier_normal_ 是一种基于输入输出维度的初始化方法,适用于ReLU以外的激活函数。
- he_normal_ 更适合ReLU类激活函数,能缓解梯度消失问题。
4.3.2 学习率调度与正则化设置
from torch.optim.lr_scheduler import StepLR
import torch.optim as optim

optimizer = optim.Adam(dnn.parameters(), lr=0.001, weight_decay=1e-5)
scheduler = StepLR(optimizer, step_size=10, gamma=0.1)
逻辑说明:
- Adam 是当前主流的优化器,兼顾SGD与RMSProp的优点。
- weight_decay 是L2正则化项,防止模型过拟合。
- StepLR 是一种学习率衰减策略,每隔10个epoch将学习率乘以0.1。
表格:不同学习率调度器对比
| 调度器 | 说明 | 适用场景 |
|---|---|---|
| StepLR | 固定步长衰减 | 简单任务 |
| ReduceLROnPlateau | 根据验证损失调整 | 需要早停 |
| CosineAnnealingLR | 余弦退火 | 大规模训练 |
4.4 DNN部分的训练过程
DNN的训练过程主要包括反向传播、梯度下降、Batch训练与GPU加速等关键步骤。
4.4.1 反向传播与梯度下降流程
反向传播(Backpropagation)是DNN训练的核心机制。其流程如下:
graph LR
    A[输入特征] --> B[Embedding拼接]
    B --> C[MLP前向传播]
    C --> D[输出预测值]
    D --> E[计算损失]
    E --> F[反向传播]
    F --> G[梯度更新]
    G --> H[下一轮训练]
流程说明:
1. 输入特征经过Embedding拼接,形成输入向量;
2. 输入向量传入MLP进行前向传播,得到预测值;
3. 使用损失函数(如交叉熵、MSE)计算预测值与真实值的误差;
4. 误差通过反向传播计算梯度;
5. 使用优化器更新网络参数;
6. 循环迭代,直到收敛。
4.4.2 Batch训练与GPU加速的实现
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
dnn.to(device)

# 模拟一个batch数据
batch_x = normalized_input.to(device)
batch_y = torch.tensor([1, 0, 1]).to(device)

# 前向传播
output = dnn(batch_x)

# 损失计算
loss_fn = nn.BCEWithLogitsLoss()
loss = loss_fn(output.squeeze(), batch_y.float())

# 反向传播
optimizer.zero_grad()
loss.backward()
optimizer.step()
逻辑分析:
- to(device) 将模型和数据加载到GPU上,实现加速;
- BCEWithLogitsLoss 是带Sigmoid的交叉熵损失函数,适合二分类CTR任务;
- zero_grad() 清除上一轮的梯度缓存;
- loss.backward() 自动计算梯度;
- optimizer.step() 更新参数。
代码扩展:
- 使用 DataLoader 实现批量训练;
- 添加早停机制(Early Stopping);
- 使用混合精度训练(AMP)提升训练速度。
本章系统地介绍了DeepFM模型中DNN部分的设计与实现流程,从特征处理到网络结构、参数初始化、训练策略等方面进行了深入分析,并通过代码示例和流程图辅助理解。下一章将继续介绍如何在PyTorch中完整实现DeepFM模型,并涵盖训练、评估与部署等实战内容。
5. PyTorch实现DeepFM全流程
5.1 数据预处理:特征编码与标准化
在构建DeepFM模型之前,数据预处理是至关重要的一步。DeepFM模型能够同时处理离散特征和连续特征,因此我们需要对原始数据进行适当的编码和标准化处理。
5.1.1 离散特征的One-Hot与Embedding编码
对于类别型特征(如用户ID、物品ID、性别等),通常采用One-Hot编码或Embedding编码方式处理:
- One-Hot编码 :将类别特征转换为稀疏向量,适用于类别数量较少的情况。
- Embedding编码 :将类别特征映射为低维稠密向量,适用于类别数量较多的场景。
在PyTorch中,可以使用 nn.Embedding 来实现离散特征的嵌入编码。例如:
import torch
import torch.nn as nn

# 假设有1000个不同的用户ID
embedding_dim = 16
num_users = 1000
user_embedding = nn.Embedding(num_users, embedding_dim)

# 输入是用户ID张量,例如 [10, 20, 30]
user_ids = torch.LongTensor([10, 20, 30])
embedded_users = user_embedding(user_ids)  # 输出形状: (3, 16)
5.1.2 连续特征的归一化处理
对于连续型特征(如用户的年龄、物品价格等),需要进行归一化处理,使得不同量纲的特征具有可比性。
常见的归一化方法包括:
- Min-Max归一化 :将数据缩放到[0, 1]区间。
- Z-Score标准化 :将数据标准化为均值为0、方差为1的分布。
示例:使用 sklearn 对连续特征进行Z-Score标准化:
from sklearn.preprocessing import StandardScaler

scaler = StandardScaler()
continuous_features = [[25], [30], [40]]  # 假设是用户年龄
scaled_features = scaler.fit_transform(continuous_features)
5.2 PyTorch构建FM组件
DeepFM的FM部分负责建模特征之间的二阶交互关系。其数学表达式如下:
\hat{y} {FM} = w_0 + \sum {i=1}^n w_i x_i + \sum_{i=1}^{n} \sum_{j=i+1}^n \langle \mathbf{v}_i, \mathbf{v}_j \rangle x_i x_j
其中,$\mathbf{v}_i$ 是特征 $i$ 的隐向量。
5.2.1 FM模型的权重与隐向量定义
在PyTorch中,我们可以通过自定义模块实现FM组件:
class FactorizationMachine(nn.Module):
    def __init__(self, input_dim, embed_dim):
        super(FactorizationMachine, self).__init__()
        self.w0 = nn.Parameter(torch.zeros(1))  # 全局偏置
        self.w = nn.Parameter(torch.zeros(input_dim))  # 一阶权重
        self.V = nn.Parameter(torch.randn(input_dim, embed_dim))  # 二阶隐向量

    def forward(self, x):
        linear_terms = self.w0 + torch.matmul(x, self.w)  # 一阶项
        square_of_sum = torch.pow(torch.matmul(x, self.V), 2)
        sum_of_square = torch.matmul(x.pow(2), self.V.pow(2))
        interactions = 0.5 * torch.sum(square_of_sum - sum_of_square, dim=1)  # 二阶项
        return linear_terms + interactions
5.2.2 二阶交叉项的高效实现
上述代码中, square_of_sum 和 sum_of_square 的计算利用了向量运算,避免了双重循环,实现了高效的特征交互计算。
5.3 PyTorch构建DNN组件
DeepFM的DNN部分是一个多层感知机(MLP),用于捕捉高阶非线性特征交互。
5.3.1 全连接网络的定义与模块封装
DNN部分通常由多个全连接层组成,使用ReLU激活函数和Dropout防止过拟合:
class DeepNetwork(nn.Module):
    def __init__(self, input_dim, hidden_dims, dropout_prob=0.5):
        super(DeepNetwork, self).__init__()
        layers = []
        prev_dim = input_dim
        for hidden_dim in hidden_dims:
            layers.append(nn.Linear(prev_dim, hidden_dim))
            layers.append(nn.ReLU())
            layers.append(nn.Dropout(dropout_prob))
            prev_dim = hidden_dim
        self.mlp = nn.Sequential(*layers)

    def forward(self, x):
        return self.mlp(x)
5.3.2 Dropout与激活函数的配置
在DNN中,我们通常使用ReLU作为激活函数,Dropout作为正则化手段。例如,可以将DNN设置为三层结构:
dnn = DeepNetwork(input_dim=32, hidden_dims=[64, 32, 16])
5.4 模型训练与优化
5.4.1 损失函数选择(如交叉熵损失)
CTR预测任务通常使用 交叉熵损失函数(Binary Cross Entropy) :
criterion = nn.BCEWithLogitsLoss()
5.4.2 优化器选择(如Adam)
推荐使用Adam优化器进行参数更新:
optimizer = torch.optim.Adam(model.parameters(), lr=0.001, weight_decay=1e-5)
5.4.3 训练过程中的监控与日志记录
训练过程中可以打印每轮的损失值,并记录验证集的AUC等指标:
for epoch in range(epochs):
    model.train()
    for batch in train_loader:
        x, y = batch
        output = model(x)
        loss = criterion(output, y)
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

    # 验证阶段
    model.eval()
    with torch.no_grad():
        val_outputs = model(val_x)
        val_loss = criterion(val_outputs, val_y)
    print(f"Epoch {epoch+1}, Loss: {loss.item():.4f}, Val Loss: {val_loss.item():.4f}")
5.5 模型评估与部署
5.5.1 评估指标:AUC、LogLoss、准确率
常用的CTR模型评估指标包括:
| 指标 | 说明 |
|---|---|
| AUC | 曲线下面积,衡量排序能力 |
| LogLoss | 二分类对数损失,衡量预测概率准确性 |
| Accuracy | 准确率,适用于类别均衡的情况 |
使用 sklearn.metrics 进行评估:
from sklearn.metrics import roc_auc_score, log_loss, accuracy_score

preds = torch.sigmoid(model(val_x)).detach().numpy()
auc = roc_auc_score(val_y, preds)
logloss = log_loss(val_y, preds)
acc = accuracy_score(val_y, (preds > 0.5))
print(f"AUC: {auc:.4f}, LogLoss: {logloss:.4f}, Accuracy: {acc:.4f}")
5.5.2 推荐系统的实战部署流程与调优技巧
模型训练完成后,进入部署阶段,常见流程如下:
graph TD
    A[训练完成的DeepFM模型] --> B{是否满足上线指标?}
    B -->|是| C[导出ONNX模型或TorchScript]
    B -->|否| D[调整超参数/特征工程]
    C --> E[模型服务化部署]
    E --> F[实时特征获取与预处理]
    F --> G[模型推理]
    G --> H[返回点击概率]
调优技巧包括:
- 特征工程增强 :引入交叉特征、时间衰减因子等。
- 模型蒸馏 :使用更小的模型来模仿大模型的输出。
- 模型压缩 :使用量化、剪枝等技术减小模型体积。
- 在线学习 :持续更新模型以适应数据漂移。
注:下一章节可继续探讨模型在实际业务中的调参策略、线上AB测试方法等内容。
简介:DeepFM是一种结合因子分解机(FM)与深度神经网络(DNN)的点击率(CTR)预测模型,广泛应用于推荐系统中。本文通过PyTorch框架实现DeepFM,详细讲解其模型结构与实现流程。内容涵盖FM与DNN的核心原理、特征嵌入与交互计算、数据预处理方法、模型构建与训练技巧,并提供完整项目结构与模块说明。通过本项目实战,开发者可掌握如何在PyTorch中高效实现CTR预测模型,提升推荐系统的准确性与智能化水平。
更多推荐


 27
 0
- 0


 已为社区贡献9条内容

所有评论(0)