
【王树森推荐系统】推荐系统涨指标的方法02:召回
·
召回模型 & 召回通道
- 推荐系统有几十条召回通道,它们的召回总量是固定的。总量越大,指标越好,粗排的计算量越大
- 双塔模型和 item-to-item 是最重要的两类召回模型,占据召回的大部分配额
- 有很多小众的模型,占据的配额很少。在召回总量不变的前提下,添加某些召回模型可以提升核心指标,同时不会增加粗排的计算量
- 有很多内容池,比如 30 天物品,1 天物品,6 小时物品,新用户优质内容池,分人群内容池
- 同一个模型可以同时用于多个内容池,得到多条召回通道
- 每条召回通道都有一定的配额,无论是一个还是多个内容池,都只训练一个双塔模型,不会增加训练的计算量。但是每个内容池都需要一个 ANN 索引,还需要在线上做 ANN 检索,需要增加少量的计算成本
改进双塔模型
方向 1:优化正样本和负样本
- 简单正样本:有点击的(用户,物品)二元组
- 简单负样本:随机组合的(用户,物品)二元组
- 困难负样本:排序靠后的(用户,物品)二元组
方向 2:改进神经网络结构
- Baseline:用户塔,物品塔分别是全连接网络,各输出一个向量,分别作为用户,物品的表征
- 改进:用户塔,物品塔分别用 DCN 代替全连接网络
- 改进:在用户塔使用用户行为序列 (last-n)
- 改进:使用多向量模型代替单向量模型(标准的双塔模型也叫单向量模型)
多向量模型
- 物品塔无区别,输出一个向量作为物品的标准
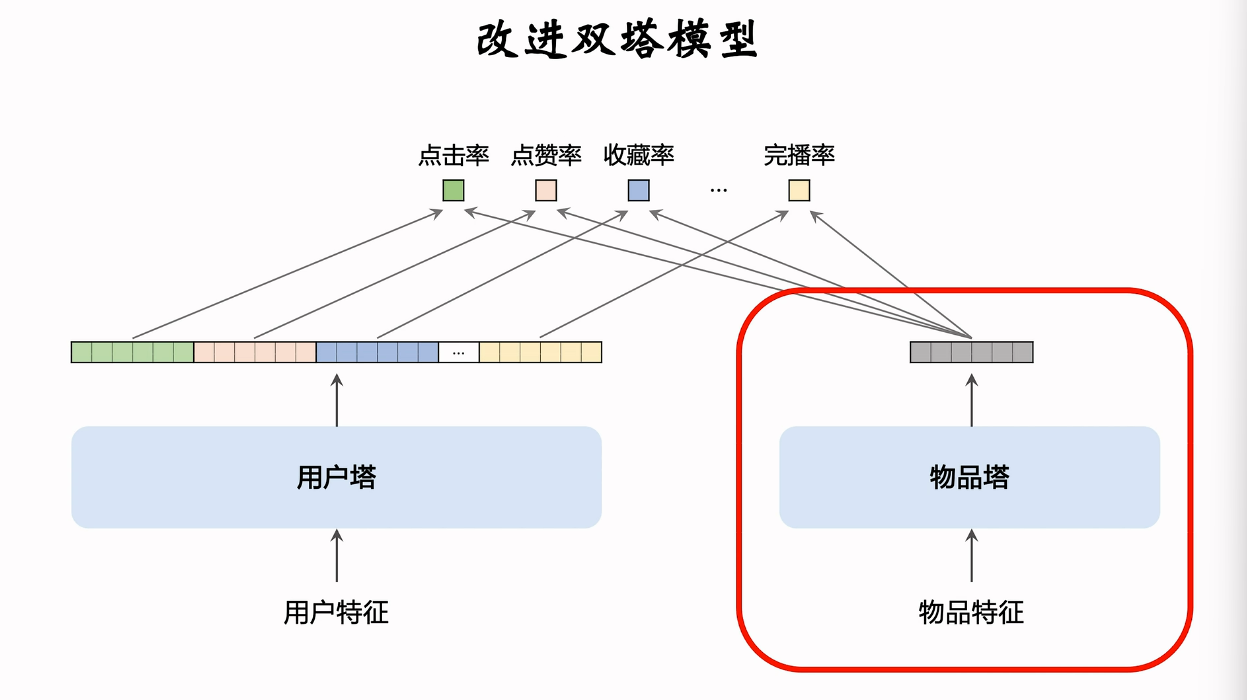
- 用户塔输出多个向量,所以叫多向量模型
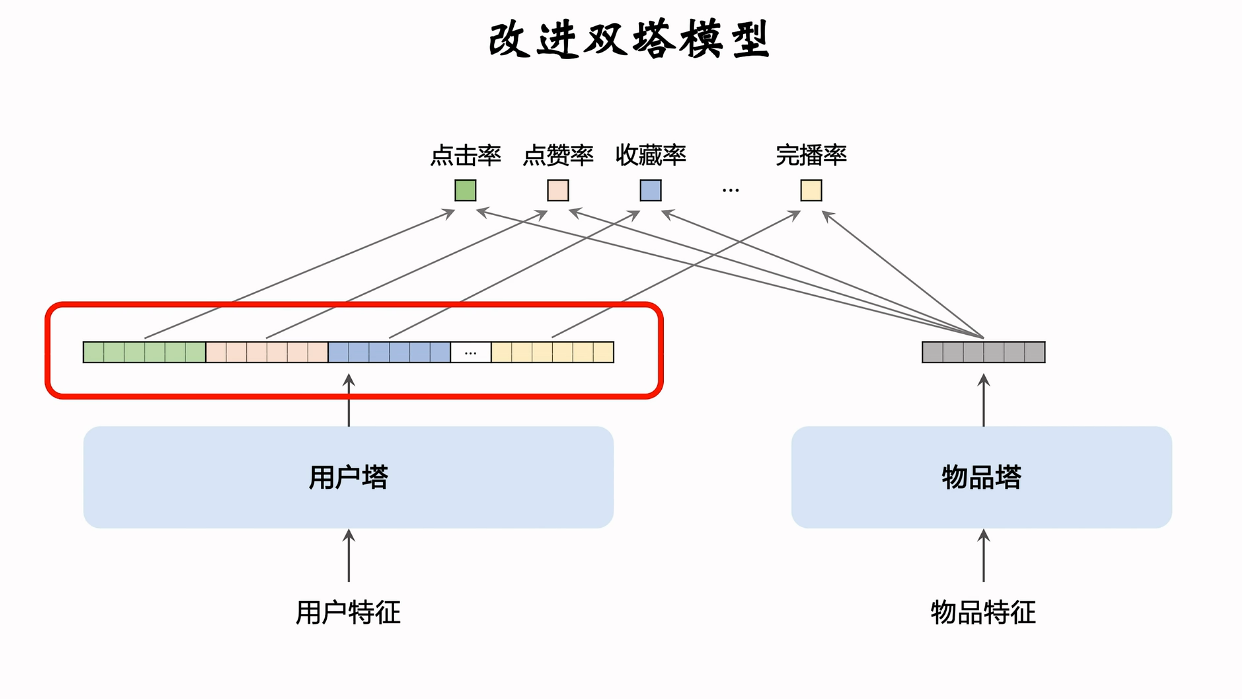
- 这个向量与物品塔的向量形状相同,计算内积或余弦相似度即可得到点击率
- 类似的,有多少个预估目标用户塔就输出多少个向量,分别去和物品塔输出的向量比较和计算
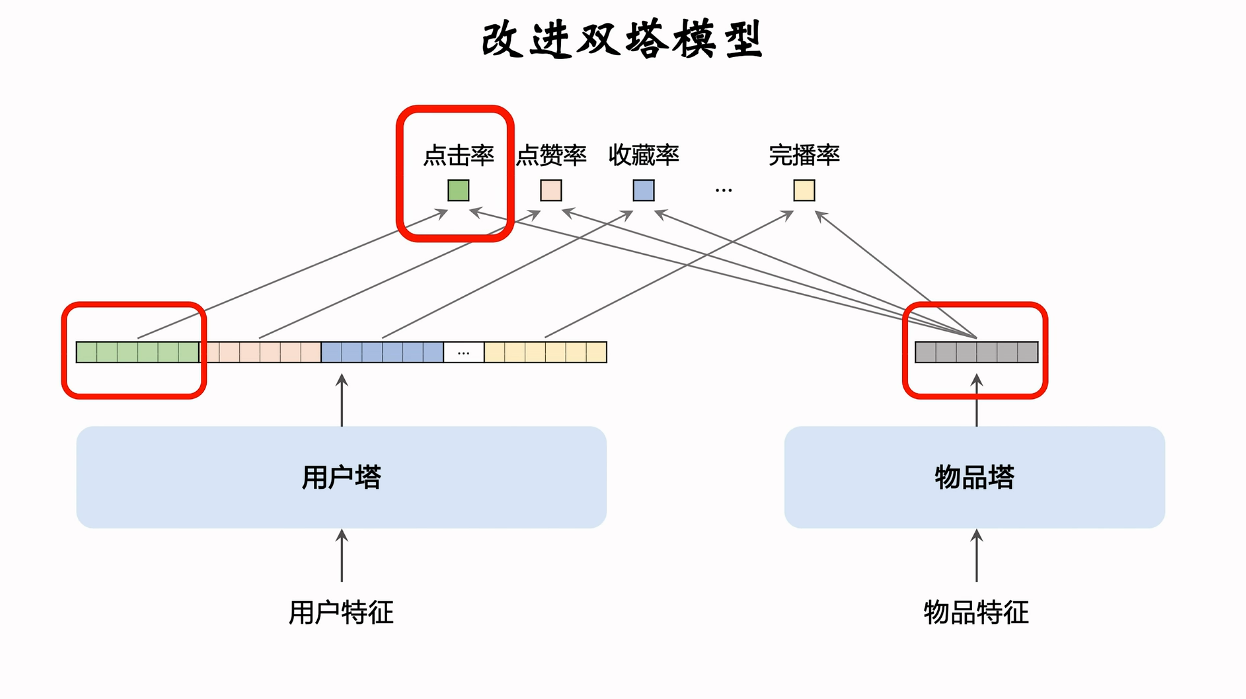
- 多向量模型类似于排序中的多目标模型,会预估点击率,点赞率等多个目标
- 为什么让用户塔输出多个向量而物品塔只输出一个向量?
- 物品塔需要提前算出来存到向量数据库,如果是物品塔来输出多向量的话那么代价就很大了(比如十个指标就需要十个向量数据库和十套 ANN 索引)
方向 3:改进模型的训练方法
- Baseline:做二分类,让模型学会区分正样本和负样本
- 改进:结合二分类,batch 内负采样(对于 batch 内负采样,需要做纠偏)
- 改进:使用自监督学习方法,让冷门物品的 embedding 学的更好。冷门物品的点击次数太少而导致冷门物品学的不好,用自监督学习对冷门物品的提升有帮助
Item-to-Item(I2I)
- I2I 是一大类,基于相似物品做召回
- 最常见的用法是 U2I2I(user → item → item)
- 用户 uuu 喜欢物品 i1i_1i1(用户历史上交互过的物品)
- 寻找 i1i_1i1 的相似物品 i2i_2i2
- 将 i2i_2i2 推荐给 uuu
- 如何计算物品相似度?
- 方法 1:ItemCF 及其变体
- 一些用户同时喜欢物品 i1i_1i1 和 i2i_2i2,则认为 i1i_1i1 和 i2i_2i2 相似,靠用户的行为来判断有多相似
- ItemCF,Online ItemCF,Swing,Online Swing 都是基于相同的思想,只是细节不同
- 线上同时使用上述 4 中 I2I 模型,各分配一定配额。比只是用一两种好。比如让 Swing 召回 1000 个物品不如让四种各召回 250 个好
- 方法 2:基于物品向量表征,计算向量相似度(双塔模型,图神经网络均可计算物品向量表征)
小众的召回模型
类似 I2I 的模型
- U2U2I(user → user → item):已知用户 u1u_1u1 和 u2u_2u2 相似,且 u2u_2u2 喜欢物品 iii,那么给用户 u1u_1u1 推荐物品 iii
- U2A2I(user → author → item):已知用户 uuu 喜欢作者 aaa,且 aaa 发布物品 iii,那么给用户 uuu 推荐物品 iii
- U2A2A2I(user → author → author → item):已知用户 uuu 喜欢作者 a1a_1a1,且 a1a_1a1 和 a2a_2a2 相似,a2a_2a2 发布物品 iii,那么给用户 uuu 推荐物品 iii
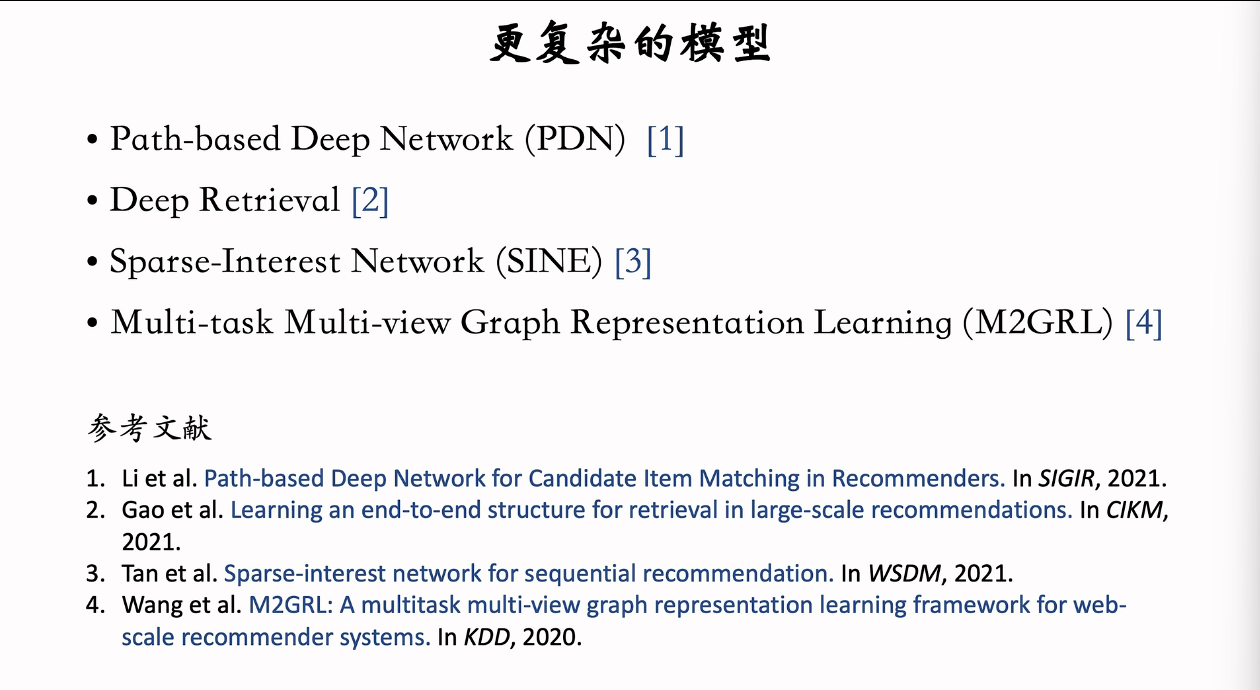
更复杂的模型
- 配额小,但是有效果
总结:改进召回模型
- 双塔模型:优化正负样本,改进神经网络结构,改进训练的方法。重要性最高
- I2I 模型:同时使用 ItemCF 及其变体,使用物品向量表征计算物品相似度。是另一类重要的模型,基于相似度做推荐
- 添加小众的召回模型,比如 PDN,Deep Retrieval,SINE,M2GRL 等模型。配额小,但是有作用
- 在召回总量不变的情况下,调整各召回通道的配额(可以用各用户群体用不同的配额)
更多推荐



 28
 0
- 0


 已为社区贡献4条内容

所有评论(0)