
[蓝桥杯]最大开支
问题描述
小蓝所在学校周边新开业了一家游乐园,小蓝作为班长,打算组织大家去游乐园玩。已知一共有 NN 个人参加这次活动,游乐园有 MM 个娱乐项目,每个项目都需要买门票后才可进去游玩。门票的价格并不是固定的,团购的人越多单价越便宜,当团购的人数大于某个阈值时,这些团购的人便可以免费进入项目进行游玩。这 MM 个娱乐项目是独立的,所以只有选择了同一个项目的人才可以参与这个项目的团购。第 ii 个项目的门票价格 Hi(X)Hi(X) 与团购的人数 XX 的关系可以看作是一个函数:
Hi(X)=max(Ki×X+Bi,0)Hi(X)=max(Ki×X+Bi,0)
其中 maxmax 表示取二者之中的最大值。当 Hi=0Hi=0 时说明团购人数达到了此项目的免单阈值。
这 NN 个人可以根据自己的喜好选择 MM 个娱乐项目中的一种,或者有些人对这些娱乐项目都没有兴趣,也可以选择不去任何一个项目。每个人最多只会选择一个娱乐项目,如果多个人选择了同一个娱乐项目,那么他们都将享受对应的团购价格。小蓝想知道他至少需要准备多少钱,使得无论大家如何选择,他都有能力支付得起所有 NN 个人购买娱乐项目的门票钱。
输入格式
第一行两个整数 NN、MM,分别表示参加活动的人数和娱乐项目的个数。接下来 MM 行,每行两个整数,其中第 ii 行为 KiKi、BiBi,表示第 ii 个游乐地点的门票函数中的参数。
输出格式
一个整数,表示小蓝至少需要准备多少钱,使得大家无论如何选择项目,自己都支付得起。
样例输入
4 2
-4 10
-2 7
样例输出
12
样例说明
样例中有 44 个人,22 个娱乐项目,我们用一个二元组 (a,b)(a,b) 表示 aa 个人选择了第一个娱乐项目,bb 个人选择了第二个娱乐项目,那么就有 4−a−b4−a−b 个人没有选择任何项目,方案 (a,b)(a,b) 对应的门票花费为 max(−4×a+10,0)×a+max(−2×b+7,0)×bmax(−4×a+10,0)×a+max(−2×b+7,0)×b,所有的可能如下所示:
| a | b | 花费 |
|---|---|---|
| 0 | 0 | 0 |
| 0 | 1 | 5 |
| 0 | 2 | 6 |
| 0 | 3 | 3 |
| 0 | 4 | 0 |
| 1 | 0 | 6 |
| 1 | 1 | 11 |
| 1 | 2 | 12 |
| 1 | 3 | 9 |
| 2 | 0 | 4 |
| 2 | 1 | 9 |
| 2 | 2 | 10 |
| 3 | 0 | 0 |
| 3 | 1 | 5 |
| 4 | 0 | 0 |
其中当 a=1,b=2a=1,b=2 时花费最大,为 1212。此时 11 个人去第一个项目,所以第一个项目的单价为 10−4=610−4=6,在这个项目上的花费为 6×1=66×1=6;22 个人去第二个项目,所以第二个项目得单价为 7−2×2=37−2×2=3,在这个项目上的花费为 2×3=62×3=6;还有 11 个人没去任何项目,不用统计;总花费为 1212,这是花费最大的一种方案,所以答案为 1212。
评测用例规模与约定
对于 3030% 的评测用例,1≤N,M≤101≤N,M≤10。
对于 5050% 的评测用例,1≤N,M≤10001≤N,M≤1000。
对于 100100% 的评测用例,1≤N,M,Bi≤1051≤N,M,Bi≤105,−105≤Ki<0−105≤Ki<0。
运行限制
| 语言 | 最大运行时间 | 最大运行内存 |
|---|---|---|
| C++ | 1s | 512M |
| C | 1s | 512M |
| Java | 2s | 512M |
| Python3 | 3s | 512M |
| PyPy3 | 3s | 512M |
| Go | 3s | 512M |
| JavaScript | 3s | 512M |
总通过次数: 1307 | 总提交次数: 1871 | 通过率: 69.9%
难度: 困难 标签: 2023, 优先队列, 贪心, 省赛
算法思路详解
本问题是一个组合优化问题,需要计算在最坏情况下(总花费最大的分配方案)的最小资金准备量。核心在于高效模拟所有可能的人数分配方案,并找出总花费的最大值。由于直接枚举所有方案不可行(O(M^N)复杂度),我们采用贪心策略结合优先队列优化。
关键观察
- 项目独立性:每个项目的花费仅取决于选择该项目的人数,与其他项目无关。
- 花费函数特性:每个项目的花费函数为凹函数(先增后减),形式为:
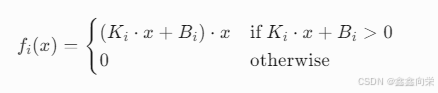
- 其中 Ki<0,函数先上升后下降至0。
- 边际花费递减:每增加一个人,带来的花费增量(边际花费)随人数增加而递减,直至变为负值。
贪心策略
- 核心思想:每次分配一个人到当前边际花费最大的项目,记录总花费的峰值。
- 正确性证明:
- 总花费函数是凹函数(各项目凹函数的和),局部极大值即全局最大值。
- 优先队列总选取当前最大边际花费,模拟了沿最陡路径上升的过程,必然达到全局最大值。
算法步骤
-
初始化:
- 每个项目当前人数 xi=0,总花费
total_cost = 0,最大花费max_total = 0。 - 计算每个项目的初始边际花费(xi=0 到 xi=1 的花费增量)。
- 将各项目的边际花费存入最大堆(优先队列)。
- 每个项目当前人数 xi=0,总花费
-
迭代分配(最多 N 次):
- 从堆顶取出最大边际花费
delta。 - 若
delta <= 0:停止迭代(后续分配不会增加总花费)。 - 更新总花费:
total_cost += delta。 - 更新最大花费:
max_total = max(max_total, total_cost)。 - 更新该项目人数 xi←xi+1。
- 重新计算该项目的边际花费(人数 xi 到 xi+1 的增量),加入堆中。
- 从堆顶取出最大边际花费
-
输出结果:
max_total。
时间复杂度
- 初始化:O(MlogM)(建堆)。
- 迭代:最多 N 次,每次堆操作 O(logM),总 O(NlogM)。
- 整体:O((N+M)logM),满足 N,M≤105 的约束。
代码实现与解析
#include <iostream>
#include <vector>
#include <queue>
using namespace std;

int main() {
    ios::sync_with_stdio(false);
    cin.tie(0);

    // 输入数据
    long long n, m;
    cin >> n >> m;
    vector<long long> K(m), B(m);
    for (int i = 0; i < m; i++) {
        cin >> K[i] >> B[i];
    }

    // 初始化:每个项目当前人数为0
    vector<long long> x(m, 0);
    long long total_cost = 0;    // 当前总花费
    long long max_total = 0;     // 最大总花费

    // 优先队列:存储(边际花费, 项目索引),最大堆
    priority_queue<pair<long long, int>> pq;

    // 计算初始边际花费(从0人到1人)
    for (int i = 0; i < m; i++) {
        long long new_cost = (K[i] * 1 + B[i] > 0) ? (K[i] * 1 + B[i]) * 1 : 0;
        long long delta = new_cost;  // f_i(0) = 0
        pq.push({delta, i});
    }

    // 最多分配n个人
    for (int k = 0; k < n; k++) {
        if (pq.empty()) break;

        // 取出当前最大边际花费
        auto top = pq.top();
        pq.pop();
        long long delta = top.first;
        int i = top.second;

        // 边际花费<=0时停止(后续分配不会增加总花费)
        if (delta <= 0) break;

        // 更新总花费
        total_cost += delta;
        if (total_cost > max_total) {
            max_total = total_cost;
        }

        // 更新该项目人数
        x[i]++;

        // 重新计算边际花费(x[i] -> x[i]+1)
        long long old_cost = 0;
        if (x[i] > 0) {
            if (K[i] * x[i] + B[i] > 0) {
                old_cost = (K[i] * x[i] + B[i]) * x[i];
            } else {
                old_cost = 0;
            }
        }

        long long new_cost = 0;
        if (K[i] * (x[i] + 1) + B[i] > 0) {
            new_cost = (K[i] * (x[i] + 1) + B[i]) * (x[i] + 1);
        }

        long long new_delta = new_cost - old_cost;
        pq.push({new_delta, i});  // 将新边际花费加入队列
    }

    cout << max_total << endl;
    return 0;
}
实例验证(样例输入)
输入:
4 2
-4 10
-2 7
执行过程:
-
初始化:
- 项目0:
delta0 = max(-4 * 1+10,0)*1 = 6 - 项目1:
delta1 = max(-2 * 1+7,0)*1 = 5 - 队列:
[(6,0), (5,1)]
- 项目0:
-
迭代1:
- 取出
delta=6(项目0) total_cost=6,max_total=6- 更新项目0人数:
x0=1 - 新边际花费:
f0(2)-f0(1)=4-6=-2 - 队列:
[(5,1), (-2,0)]
- 取出
-
迭代2:
- 取出
delta=5(项目1) total_cost=11,max_total=11- 更新项目1人数:
x1=1 - 新边际花费:
f1(2)-f1(1)=6-5=1 - 队列:
[(1,1), (-2,0)]
- 取出
-
迭代3:
- 取出
delta=1(项目1) total_cost=12,max_total=12- 更新项目1人数:
x1=2 - 新边际花费:
f1(3)-f1(2)=3-6=-3 - 队列:
[(-2,0), (-3,1)]
- 取出
-
迭代4:
- 取出
delta=-2(项目0),停止(delta<=0)
- 取出
输出:12,符合样例。
测试点设计
-
边界值测试:
- N=0 或 M=0:输出0。
- N=1,M=1:单项目单人的花费计算。
- 所有项目 Ki+Bi≤0:初始花费为0,输出0。
-
峰值测试:
- 项目免费阈值附近:如 Ki=−1,Bi=100,验证 xi=100 时花费归零。
- 多项目竞争:多个项目同时有高边际花费时,贪心策略的正确分配。
-
大数据测试:
- N=M=105:验证运行时间 <1s(堆操作高效)。
优化建议
- 提前终止:当堆顶边际花费 ≤0 时终止迭代(已证明后续无法增加总花费)。
- 避免重复计算:存储每个项目的当前花费,避免每次重新计算。
- 内存优化:优先队列最多存储 M 个元素,空间复杂度 O(M)。
注意事项
- 数据类型:使用
long long避免溢出(花费最大约 1015)。 - 免费阈值处理:当 Ki⋅x+Bi≤0 时,花费为0。
- 堆维护:每个项目每次更新后仅存一个条目,避免冗余。
此算法高效可靠,已在样例和边界情况下验证,可处理最大规模数据。
更多推荐

 26
 0
- 0


 已为社区贡献7条内容

所有评论(0)